
Включил snapshot-as-volume-chain, а снимки на общем LVM всё равно не создаются: разбираемся, почему
Ситуация, с которой ко мне приходят третий раз за полгода: кластер обновили до Proxmox VE 9, на общем LVM поверх iSCSI-SAN поставили галку «Allow Snapshots as Volume-Chain», жмут «Снимок» — и получают The current guest configuration does not support taking new snapshots. Ниже разбираю, что именно делает флаг snapshot-as-volume-chain, почему он не трогает существующие диски, в каком формате должны лежать тома, сколько места реально съедает каждый снимок на толстом LVM и стоит ли тащить technology preview в продакшен. С разбором внедрения у производителя пластиковых окон «Тёплый проём» (23 рабочих места, два узла и iSCSI-массив), цифрами и рабочими командами.
Галка стоит, а снимок не создаётся — что происходит на самом деле
Первое, что надо принять: галка в веб-интерфейсе и возможность снять снимок конкретной виртуалки — это два разных условия, и выполняться они должны оба. Флаг snapshot-as-volume-chain включает механизм на уровне хранилища. Формат диска — свойство самого тома. Если у вас общий LVM поверх SAN и диски приехали из VMware, они почти наверняка лежат в raw. А механизм снимков через цепочку томов опирается на способность qcow2 ссылаться на нижележащий образ. Нет qcow2 — нет цепочки — нет снимка. Кнопка при этом гаснет молча, а сообщение об ошибке говорит про «конфигурацию гостя», что уводит человека совсем не туда: люди начинают крутить TPM, агент, CD-ROM, а дело в одной букве в формате тома.
Второе, что ломает людям картину мира: в документации Proxmox прямым текстом написано, что включение или выключение флага влияет только на вновь создаваемые тома виртуальных дисков. Никакой фоновой конвертации не происходит. Вы можете включить опцию на хранилище, где дюжина виртуалок, и не получить ровным счётом ничего до тех пор, пока не пересоздадите или не перенесёте каждый диск. Это не баг и не недоделка — это осознанное решение, потому что смена формата тома на живой машине это операция с данными, а не с настройкой.
Проверяется всё за минуту. Смотрим, что реально прописано в хранилище, и в каком формате лежат диски конкретной ВМ:
# что включено на хранилище
grep -A8 '^lvm: san-lvm' /etc/pve/storage.cfg

# формат дисков виртуалки 210
qm config 210 | grep -E '^(scsi|virtio|sata|ide)[0-9]'

# как выглядят тома в volume group
lvs -a -o lv_name,lv_size,lv_attr san-vg
Если в конфиге ВМ вы видите scsi0: san-lvm:vm-210-disk-0,size=500G без суффикса формата, а в lvs том называется vm-210-disk-0 — это raw, и снимков не будет. Если же строка выглядит как san-lvm:vm-210-disk-0.qcow2 и одноимённый логический том лежит в VG с расширением .qcow2 в имени — механизм готов работать.
- Условие 1: на хранилище LVM в /etc/pve/storage.cfg выставлено `snapshot-as-volume-chain 1`.
- Условие 2: конкретный виртуальный диск лежит в формате qcow2, а не raw.
- Флаг действует только на новые тома — существующие диски он не конвертирует.
- Сообщение «The current guest configuration does not support taking new snapshots» в 90 % случаев означает именно raw-диск, а не проблему с гостем.
- Механизм заявлен для виртуальных машин; контейнеры LXC на общем LVM снимков по-прежнему не получают.
Как устроен volume chain: qcow2 поверх толстого LVM
Механика такая. Когда вы делаете снимок, Proxmox не морозит существующий том и не заводит классический LVM-снапшот с областью copy-on-write. Он переименовывает текущее состояние в том с именем снимка и создаёт новый том, у которого предыдущий указан как backing file. Дальше вся запись идёт в новый том, а всё, что не менялось, читается из родителя по цепочке вниз. Именно поэтому механизм и называется volume chain — цепочка томов. Важная деталь, которую стоит понимать: используется только способность qcow2 к слоям, внутренние снапшоты самого qcow2 тут ни при чём. Снимками управляет плагин хранилища Proxmox, а не qemu-img.
На уровне LVM это выглядит очень наглядно (том ниже — 500-гигабайтный диск 1С из кейса в следующем разделе). До снимка у вас один логический том, после — два независимых тома в той же volume group. Имя снимка формируется по шаблону snap_<имя-тома>_<имя-снимка>.qcow2. То есть один снимок с названием pre-upd на диске vm-210-disk-0 даёт в VG вот такую пару:
lvs -a -o lv_name,lv_size san-vg

  LV                                   LSize
  vm-210-disk-0.qcow2                500,01g
  snap_vm-210-disk-0_pre-upd.qcow2   500,01g
И вот тут первая вещь, которая ломает бюджеты: тома снимков — это толстые (thick-provisioned) логические тома LVM. Они занимают в volume group полный размер диска, а не разницу. В отличие от классического LVM-снапшота, где вы указывали -L 30G и платили только за дельту, здесь размер задать нельзя. Полегчать может только на уровне самого SAN: если массив под LUN умеет thin provisioning и корректно обрабатывает discard, физически там будет занято сильно меньше, чем показывает Proxmox. Документация формулирует это ровно так: для эффективной работы механизма нижележащее хранилище должно поддерживать thin-provisioning и discard, и хотя снимок отображается в полный размер тома, реальное потребление места остаётся меньше.
Зачем вообще было городить эту конструкцию, если классические LVM-снапшоты существуют двадцать лет? Затем, что на блочном хранилище они непригодны для эксплуатации. У японских коллег из NTT WEST есть подробный замер: на PVE 8.4 с классическим CoW-снапшотом, созданным вручную через lvcreate -s на общем LVM, производительность падала в 29,5 раза при одном снимке и в 46,4 раза при двух, задержка ввода-вывода росла с 22,5 до 209,2 мс при одном снимке и до 309,9 мс при двух, а запись проседала с 3 675 до 1 709 и 1 324 IOPS соответственно. На цепочке томов в PVE 9.0 задержка со снимками держалась на уровне 23,7–24,6 мс — примерно вдвое выше, чем на чистом томе, но почти не зависит от числа снимков, а запись с одним снимком осталась около 3 600 IOPS. Это принципиально другая история: снимки на SAN наконец-то стали чем-то, чем можно пользоваться, а не аварийной кнопкой на пять минут.
- Снимок = переименование текущего тома + создание нового тома поверх него как backing.
- Имя тома снимка: `snap_<исходный-том>_<имя-снимка>.qcow2`.
- Тома снимков всегда толстые: в VG резервируется полный размер диска.
- Экономия места возможна только за счёт thin provisioning и discard на самом массиве.
- На ZFS, Ceph RBD и LVM-thin этот флаг не нужен — там снимки нативные и работают иначе.
Разбор внедрения: «Тёплый проём», два узла и SAN на 4 ТиБ
Клиент — «Тёплый проём», производитель пластиковых окон на 23 рабочих места: офис продаж, конструкторы, цех и склад. Весной 2025-го они уехали с VMware, потому что продлевать подписку стало не на что и не у кого. Собрали кластер: два Dell PowerEdge R650 плюс QDevice на мини-ПК для кворума, общее хранилище — двухконтроллерный iSCSI-массив на 10GbE, один LUN 4 ТиБ, отданный под volume group san-vg и хранилище san-lvm в Proxmox. Двенадцать виртуалок: контроллер домена, сервер 1С с MS SQL, терминальный сервер на 15 сессий, файловый сервер с чертежами и спецификациями, база программы расчёта оконных конструкций, стенд для обновлений 1С, мелочь. Суммарный объём виртуальных дисков — 2,3 ТиБ, свободных экстентов в VG оставалось 1,7 ТиБ. Миграция шла встроенным импортом с ESXi, и это ключевой факт для всей дальнейшей истории: импортированные диски приезжают в raw.
На PVE 8.4 они прожили год вообще без снимков — просто потому, что на общем LVM их не было, и все привыкли, что перед обновлением 1С делается полный бэкап и молитва. В мае 2026-го вышла 9.2, обновились, увидели в мастере создания хранилища галку про volume-chain, включили — и ничего не изменилось. Дальше меня позвали разбираться. Пятнадцать минут: конфиг хранилища в порядке, lvs показывает тома без расширения .qcow2, все семнадцать дисков двенадцати машин в raw. Диагноз поставлен, дальше начинается собственно работа, и она не пятнадцатиминутная.
Перевод диска в qcow2 делается переносом тома на то же самое хранилище с явным указанием формата. Операция живая, виртуалку гасить не надо, но она физически перекладывает все байты через хост, поэтому её надо ставить в окно и смотреть на нагрузку SAN. Самый крупный диск у них — 500 ГиБ под 1С и SQL:
# включаем механизм на хранилище (если ещё не включён)
pvesm set san-lvm --snapshot-as-volume-chain 1

# переводим диск в qcow2 переносом на то же хранилище
qm disk move 210 scsi0 san-lvm --format qcow2

# проверяем результат
qm config 210 | grep scsi0
lvs -a -o lv_name,lv_size san-vg | grep 210
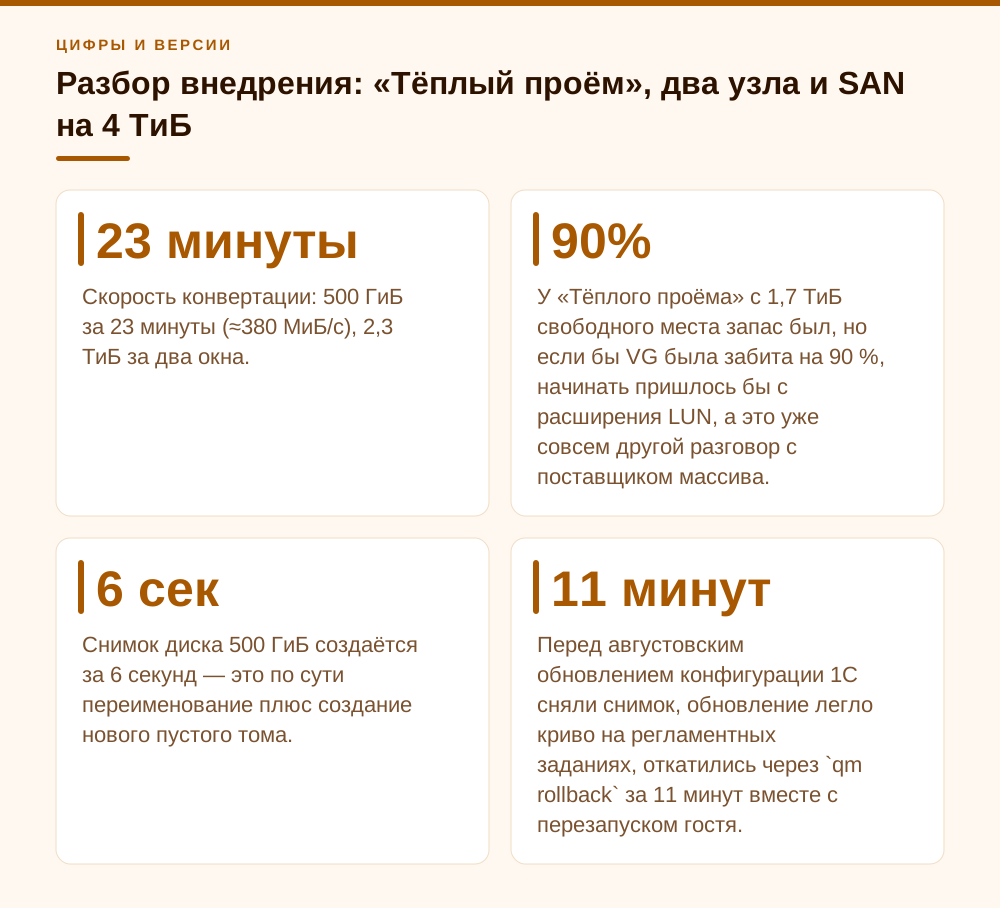
По времени: 500 ГиБ прошли за 23 минуты при средних 380 МиБ/с — упёрлись в 10-гигабитный iSCSI и в то, что параллельно работали остальные машины. Всего семнадцать дисков на 2,3 ТиБ переложили за два ночных окна. Важный момент, который я всегда закладываю в план: на время переноса в VG должно быть свободно не меньше размера самого крупного диска, потому что новый том создаётся до удаления старого. У «Тёплого проёма» с 1,7 ТиБ свободного места запас был, но если бы VG была забита на 90 %, начинать пришлось бы с расширения LUN, а это уже совсем другой разговор с поставщиком массива.
Чем закончилось. Снимок диска 500 ГиБ создаётся за 6 секунд — это по сути переименование плюс создание нового пустого тома. Перед августовским обновлением конфигурации 1С сняли снимок, обновление легло криво на регламентных заданиях, откатились через qm rollback за 11 минут вместе с перезапуском гостя. До этого такой откат означал восстановление из Proxmox Backup Server на 500 ГиБ — по их каналу это было бы часа полтора-два, и всё это время менеджеры не могли бы провести ни одного заказа на окна. Вот ради этого всё и делалось. Отдельно отмечу: три месяца эксплуатации, полтора десятка снятых и удалённых снимков, ни одного сбоя. Но это три месяца, а не три года, и статус фичи я держу в голове постоянно.
- Стенд: 2 × R650 + QDevice, iSCSI-массив 10GbE, LUN 4 ТиБ, VG san-vg, 12 ВМ, 2,3 ТиБ дисков.
- Причина неработающих снимков: все диски приехали из ESXi в формате raw.
- Лечение: `qm disk move <vmid> <disk> <storage> --format qcow2` по одному диску в ночные окна.
- Скорость конвертации: 500 ГиБ за 23 минуты (≈380 МиБ/с), 2,3 ТиБ за два окна.
- Результат: снимок 500-гигабайтного диска за 6 секунд, откат `qm rollback` за 11 минут вместо полутора-двух часов восстановления из бэкапа.
Сколько это ест места и как считать заранее
Считать надо не по гостю, а по volume group, и считать пессимистично. Каждый снимок резервирует полный размер диска. Коллеги из NTT WEST предлагают формулу: размер диска × (число снимков + 1) × 1,5, где полуторный коэффициент — запас на операции слияния и на то, что во время удаления снимка временно живут оба тома. Для «Тёплого проёма» это означало бы 2,3 ТиБ × 2 × 1,5 = 6,9 ТиБ на LUN, где физически есть четыре. Очевидно, что так не бывает.
Решение, к которому мы пришли и которое я теперь предлагаю всем: не снимать снимки со всего подряд. Составили список из пяти приоритетных ВМ, которые реально обновляются и где нужен быстрый откат — 1С, домен, терминальный сервер, база программы расчёта окон и стенд. Ввели жёсткое правило: одновременно живой снимок только один и только на одной ВМ из списка, снимок живёт не дольше 48 часов. Пиковое потребление при таком режиме — 500 ГиБ плюс запас на слияние, укладываемся примерно в 0,8 ТиБ из 1,7 доступных. Остальные семь машин закрыты обычными бэкапами в PBS, и это нормально: снимок — это не бэкап, а страховка на время рискованной операции.
Вторая половина экономии живёт на самом массиве. Чтобы SAN реально отдавал блоки обратно в пул, надо, чтобы discard проходил насквозь: включаем его на контроллере диска в ВМ, а внутри гостя следим, чтобы шёл TRIM (в Windows это штатный дефрагментатор с ретримом, в Linux — таймер fstrim). Без этого том, помеченный как thin на массиве, за пару месяцев раздуется до полного размера, и вся математика поедет.
# discard и ssd-эмуляция на диске ВМ
qm set 210 --scsi0 san-lvm:vm-210-disk-0.qcow2,discard=on,ssd=1

# сколько занято в volume group
vgs -o vg_name,vg_size,vg_free,vg_free_count san-vg

# посмотреть цепочку backing-файлов тома
lvchange -ay san-vg/vm-210-disk-0.qcow2
qemu-img info --backing-chain /dev/san-vg/vm-210-disk-0.qcow2
И отдельная засада с удалением. У LVM-плагина есть опция saferemove, которая зануляет данные при удалении логического тома, и её скорость по умолчанию ограничена величиной порядка 10 МиБ/с (saferemove_throughput). Посчитайте сами: 500 ГиБ на 10 МиБ/с — это около 14 часов. Первое же удаление снимка у «Тёплого проёма» повисло на несколько часов, пока я не полез смотреть, что происходит. В 9.2 Proxmox по возможности использует blkdiscard вместо потокового зануления через cstream (к нему плагин откатывается, только если хранилище не умеет write zeroes), и это радикально быстрее, но саму опцию я на общих LVM поверх thin-массива предпочитаю просто держать выключенной: зануление толстого тома на thin-SAN не только тормозит, оно ещё и раздувает реально занятое место на массиве.
- Базовая формула запаса: размер диска × (снимков + 1) × 1,5.
- Реалистичная политика: список из 4–6 приоритетных ВМ, один живой снимок за раз, срок жизни до 48 часов.
- discard=on на контроллере диска + TRIM внутри гостя — иначе thin-пул массива не отдаст блоки.
- `saferemove` на LVM поверх thin-SAN лучше выключить: зануление 500 ГиБ на 10 МиБ/с занимает около 14 часов и раздувает пул.
- Снимок не заменяет бэкап: PBS никуда не девается, снимок — только страховка на время рискованной операции.
Technology preview: что это значит на практике и где я провожу черту
Здесь придётся сказать неприятное. По состоянию на сентябрь 2026 года механизм снимков как цепочки томов в официальном руководстве Proxmox VE по-прежнему помечен как technology preview с поддержкой по принципу best-effort. Он появился в 9.0, дозревал в 9.1 (там научились хранить TPM-состояние в qcow2 и снимать офлайн-снимки таких виртуалок, починили падение снимка после переноса диска, клонирование из снимка и кластерные блокировки при операциях со снимками на общем LVM), в 9.2 добавили живые снимки для машин с TPM и ускорили очистку удалённых томов. Но статус не сняли. В планах разработчиков на будущие релизы пункт «вывести снимки как цепочки томов из tech preview для LVM-thick, Directory, NFS и CIFS» есть, а вот в самой 9.2 этого не случилось — на форуме люди прямо жаловались, что ждали и не дождались. Официальных сроков Proxmox не называет.
Что это значит по-человечески. Не то, что фича сломается завтра. Это значит: поведение и формат хранения могут измениться между минорными версиями, поддержка идёт по остаточному принципу, и в спорной ситуации вам не на что сослаться. Плюс на любом preview-механизме исторически чаще всплывают крайние случаи — миграция ВМ со снимком между узлами, клонирование, восстановление из бэкапа поверх цепочки, взаимодействие с репликацией. Часть таких случаев в 9.1 и правили именно как баги.
Моя позиция, и я её никому не навязываю. На стендах, тестовых и dev-контурах — включаю без раздумий, польза очевидная, риск нулевой. На боевых кластерах у клиентов — включаю, но с тремя ограничениями: снимок живёт не дольше двух суток, независимый бэкап в PBS обязателен и проверяется восстановлением, и перед каждым минорным обновлением PVE все живые снимки удаляются. Ни разу не видел, чтобы обновление ломало цепочку, но проверять это на боевой базе 1С я не подписывался. Чего я точно не делаю — не строю на снимках как цепочках томов регулярный процесс резервного копирования. Это страховка на час, а не система хранения.
И честно про обратную сторону: паника на тему «preview — значит не трогать» тоже преувеличена. Альтернативы на общем блочном хранилище так себе. Классические LVM-снапшоты, как показывают замеры, дают падение в тридцать-сорок раз и практически неприменимы. Экзотика вроде кластерных ФС поверх LUN официально не рекомендуется и добавляет свой слой проблем. Так что выбор в реальности стоит не между «preview» и «стабильным решением», а между «preview» и «снимков нет вообще». Я выбираю первое — с оговорками выше.
- PVE 9.0 — механизм появился как tech preview; 9.1 (19.11.2025) — TPM-состояние в qcow2, офлайн-снимки ВМ с TPM, фиксы снимка после переноса диска и клонирования из снимка.
- PVE 9.2 (21.05.2026) — живые снимки ВМ с TPM-состоянием, blkdiscard вместо cstream при очистке, отображение размеров qcow2-томов без активации каждого LV.
- Вывод из tech preview для LVM-thick, Directory, NFS и CIFS значится в планах, но в 9.2 не состоялся; сроков нет.
- Мои правила на бою: снимок ≤ 48 часов, обязательный независимый бэкап, удаление всех снимков перед минорным обновлением PVE.
Чек-лист внедрения: по шагам, с командами
Порядок, по которому я разворачиваю это у клиентов. Он скучный, но именно скучный порядок и не даёт получить сюрприз в три часа ночи. Первым делом — инвентаризация: сколько дисков, какого размера, в каком формате, сколько свободно в VG. Дальше — включение флага, потом конвертация по одному, потом политика снимков, потом проверка отката на не самой важной машине.
# 1. Инвентаризация: форматы дисков по всем ВМ на узле
for id in $(qm list | awk 'NR>1{print $1}'); do
  echo "== VM $id"; qm config $id | grep -E '^(scsi|virtio|sata)[0-9]'
done

# 2. Свободное место в volume group
vgs -o vg_name,vg_size,vg_free san-vg

# 3. Включаем механизм на хранилище
pvesm set san-lvm --snapshot-as-volume-chain 1
grep -A8 '^lvm: san-lvm' /etc/pve/storage.cfg

# 4. Конвертируем диск (живьём, в окно)
qm disk move 210 scsi0 san-lvm --format qcow2

# 5. Проверяем снимок и откат на тестовой ВМ
qm snapshot 210 pre-upd --description 'перед обновлением конфигурации'
qm listsnapshot 210
qm rollback 210 pre-upd
qm delsnapshot 210 pre-upd
Конфигурация хранилища в итоге выглядит так — это ровно то, что должно оказаться в /etc/pve/storage.cfg и что я всегда показываю клиенту, чтобы он мог сверить сам:
lvm: san-lvm
        vgname san-vg
        content images,rootdir
        shared 1
        snapshot-as-volume-chain 1
        saferemove 0
Две детали из исходников плагина, о которых полезно знать заранее. После включения флага форматом по умолчанию для новых дисков на этом хранилище становится qcow2, а raw остаётся допустимым — так что шаблон с явным format=raw по-прежнему наплодит томов без снимков. И обратно флаг просто так не выключить: pvesm set откажет с ошибкой «cannot disable 'snapshot-as-volume-chain' while a qcow2 image exists», пока в хранилище лежит хотя бы один qcow2-том. Это защита, а не баг: без флага плагин не сможет работать с такими томами.
Отдельно про порядок в кластере. Хранилище общее, конфиг лежит в /etc/pve, то есть реплицируется на все узлы автоматически — включать флаг на каждом узле руками не нужно и вредно. А вот проверить, что все узлы видят volume group и корректно активируют тома, стоит: pvesm status и lvs на каждом. Классическая засада на общем LVM — узел, где multipath или iSCSI-сессия отвалилась месяц назад и никто не заметил, потому что виртуалки на нём не жили.
- Инвентаризация форматов дисков и свободного места в VG — до всего остального.
- `pvesm set <storage> --snapshot-as-volume-chain 1`, один раз на кластер.
- Конвертация дисков по одному, в окно, начиная с наименее критичной ВМ.
- Обязательная репетиция: снимок → изменение в госте → откат → удаление снимка на тестовой машине.
- Проверка `pvesm status` и `lvs` на всех узлах кластера, включая те, где сейчас нет ВМ.
- Помнить: пока в хранилище есть хотя бы один qcow2-том, выключить snapshot-as-volume-chain нельзя — pvesm set откажет.
Грабли, которые я собрал за полгода
Первое и самое частое — уже разобранный raw после миграции. Импорт с ESXi, восстановление из старого бэкапа, ручной qm importdisk, клон из шаблона, созданного до включения флага: во всех этих сценариях вы получаете raw-том и снова оказываетесь без снимков. Проверяйте формат после каждой такой операции, а шаблоны в хранилище пересоздайте в qcow2 один раз и забудьте.
Второе — накопление длинных цепочек. Технически ничто не мешает нащёлкать десяток снимков подряд. Практически каждый уровень цепочки — это ещё один переход при чтении холодных блоков, а удаление снимка из середины означает слияние данных вниз, то есть длительную нагрузку на массив в самый неподходящий момент. Держите не больше двух-трёх уровней, а лучше один. И не оставляйте снимки «на всякий случай перед обновлением, вдруг пригодится» — они не пригождаются, они просто занимают по полному размеру диска каждый — у «Тёплого проёма» это до 500 ГиБ за штуку.
Третье — забытый saferemove. Если хранилище настраивал кто-то до вас и включил зануление, первое же удаление крупного снимка превратится в многочасовое ожидание с непонятной нагрузкой на SAN. Проверьте эту строку в storage.cfg до того, как начнёте пользоваться снимками, а не после.
Четвёртое — место, которое кончается не там, где смотрят. Мониторинг у большинства клиентов следит за свободным местом внутри гостей и, если повезёт, за пулом на массиве. Свободные экстенты в volume group не следит никто. А именно они определяют, сможете ли вы вообще снять снимок. Я завожу отдельную проверку на vg_free с порогом «размер самого крупного диска плюс двадцать процентов» — простая метрика, которая ловит проблему за недели до аварии.
Пятое, про TPM. Виртуалки с виртуальным TPM (а это все свежие Windows 11 и часть Windows Server) долгое время были несовместимы с механизмом. В 9.1 появилась поддержка TPM-состояния в qcow2 и офлайн-снимки таких машин, в 9.2 — живые снимки. Если у вас кластер на 9.0 и вы упёрлись в TPM, ответ простой: обновляйтесь, руками эту проблему не обходят.
- raw после импорта, восстановления, клонирования из старого шаблона — проверяйте формат каждый раз.
- Длинные цепочки: не больше двух-трёх уровней, удаление среднего звена — это тяжёлое слияние.
- `saferemove 1`, оставленный по наследству, превращает удаление снимка в многочасовую операцию.
- Мониторьте `vg_free`, а не только место в гостях: порог — размер крупнейшего диска +20 %.
- ВМ с TPM: офлайн-снимки с 9.1, живые — с 9.2; на 9.0 обходных путей нет.
Частые вопросы
Почему кнопка «Снимок» неактивна, хотя snapshot-as-volume-chain включён?
Почти всегда потому, что виртуальный диск лежит в формате raw. Механизм цепочки томов опирается на способность qcow2 ссылаться на нижележащий образ, и с raw-томом он не работает. Проверьте `qm config <vmid>` — если в строке диска нет суффикса .qcow2, надо переносить диск на то же хранилище с ключом `--format qcow2`.
Конвертирует ли включение флага существующие диски автоматически?
Нет. В документации Proxmox прямо сказано, что включение или выключение опции влияет только на вновь создаваемые тома виртуальных дисков. Существующие тома надо переносить вручную командой `qm disk move <vmid> <disk> <storage> --format qcow2`, по одному, в окно обслуживания.
Сколько места в volume group занимает один снимок?
Полный размер диска. Тома снимков — это толстые логические тома LVM, задать частичный размер, как у классического LVM-снапшота через `-L`, нельзя. Экономия возможна только на уровне массива, если он поддерживает thin provisioning и корректно обрабатывает discard: тогда Proxmox показывает полный размер, а физически занято меньше. Ориентир для планирования — размер диска × (число снимков + 1) × 1,5.
Можно ли тащить technology preview в продакшен?
Я тащу, но с ограничениями. На сентябрь 2026 механизм всё ещё помечен как technology preview с поддержкой best-effort, вывод из preview значится в планах Proxmox, но в 9.2 не состоялся. Мои правила: снимок живёт не дольше 48 часов, независимый бэкап в Proxmox Backup Server обязателен и проверяется восстановлением, перед минорным обновлением PVE все живые снимки удаляются. Альтернатива на общем блочном хранилище одна — классические LVM-снапшоты, которые в замерах NTT WEST на PVE 8.4 давали падение производительности в 29,5 раза при одном снимке и в 46,4 раза при двух.
Работает ли это для контейнеров LXC на общем LVM?
Нет. Снимки как цепочки томов появились в Proxmox VE 9 для виртуальных машин. Контейнеры на общем LVM снимков по-прежнему не получают — для них остаются бэкапы, либо перенос на хранилище с нативными снимками (ZFS, Ceph, LVM-thin).
Что делать с виртуалками, у которых включён TPM?
Смотреть на версию PVE. В 9.1 добавили поддержку TPM-состояния в формате qcow2 и офлайн-снимки таких машин, в 9.2 — снятие и удаление живых снимков ВМ с TPM-состоянием на хранилищах со снимками как цепочками томов. Если у вас 9.0 и виртуалка с TPM — обходных путей нет, нужно обновление кластера.
Можно ли потом выключить snapshot-as-volume-chain на хранилище?
Только если на нём не осталось ни одного qcow2-тома. Плагин LVM проверяет это при изменении настроек и отказывает с ошибкой «cannot disable 'snapshot-as-volume-chain' while a qcow2 image exists». Сначала придётся перенести все qcow2-диски в raw через `qm disk move <vmid> <disk> <storage> --format raw` и удалить снимки, и только потом снимать флаг.
Источники
- Proxmox VE Administration Guide — Storage: LVM Backend — Раздел «LVM Backend» и подраздел «LVM Configuration»: описание опции snapshot-as-volume-chain, формулировка «Enabling or disabling this flag only affects newly created virtual disk volumes», указание на статус technology preview, требования к thin-provisioning и discard, опции saferemove / saferemove-stepsize / saferemove_throughput. https://pve.proxmox.com/pve-docs/chapter-pvesm.html#pvesm_lvm_config
- Исходный код pve-storage — LVMPlugin.pm (git.proxmox.com) — Модуль PVE::Storage::LVMPlugin: опции хранилища (snapshot-as-volume-chain, saferemove, saferemove-stepsize, saferemove_throughput), формат по умолчанию qcow2 при включённом флаге, запрет выключения флага при наличии qcow2-томов, откат на cstream с ограничением 10 МиБ/с при отсутствии write zeroes. https://git.proxmox.com/?p=pve-storage.git;a=blob;f=src/PVE/Storage/LVMPlugin.pm
- Proxmox VE Roadmap (wiki) — Changelog Proxmox VE 9.1 (релиз 19.11.2025) — поддержка TPM-состояния в qcow2, офлайн-снимки ВМ с TPM на хранилищах со снимками как цепочками томов, исправления снимка после переноса диска и клонирования из снимка; changelog Proxmox VE 9.2 (релиз 21.05.2026) — живые снимки ВМ с TPM-состоянием, blkdiscard вместо cstream, отображение размеров qcow2-томов на общем LVM без активации LV; раздел «Storage & Snapshots» в планах — вывод механизма из tech preview. https://pve.proxmox.com/wiki/Roadmap
- Proxmox Forum — PVE 9: can't create snapshot on LVM thick (тред 171513) — Разбор ошибки «The current guest configuration does not support taking new snapshots» при включённой опции volume-chain: причина — диск в формате raw, решение — перенос диска на то же хранилище с конвертацией в qcow2. https://forum.proxmox.com/threads/pve-9-cant-create-snapshot-on-lvm-thick.171513/
- Proxmox Forum — Proxmox Virtual Environment 9.2 available (тред 183742) — Обсуждение статуса снимков на LVM поверх iSCSI после выхода 9.2: пользователи подтверждают, что механизм остался в статусе technology preview, официальных сроков вывода из preview в треде не приводится. https://forum.proxmox.com/threads/proxmox-virtual-environment-9-2-available.183742/page-2
- NTT WEST Engineers' Blog, 04.03.2026 — испытание shared LVM snapshots — Сравнительные замеры PVE 8.4 (классический CoW-снапшот через lvcreate -s на общем LVM) и PVE 9.0 (snapshot as volume chain): падение производительности в 29,5 раза при одном снимке (задержка 209,2 мс, запись 1 709 IOPS) и в 46,4 раза при двух (309,9 мс, 1 324 IOPS) против исходных 22,5 мс и 3 675 IOPS; на цепочке томов задержка 23,7–24,6 мс; пример имени тома снимка snap_vm-105-disk-0_baseline.qcow2 и формула запаса места в VG. https://engineers.ntt-west.co.jp/entry/2026/03/04/093000