
Место в thin-pool есть, а виртуалки в ошибках ввода-вывода: смотрите не на Data%, а на Meta%
Эта статья для тех, кто держит виртуалки или контейнеры на LVM thin-pool — на Proxmox, на голом Debian, на чём угодно. Разберу, почему пул умирает при двадцати процентах занятого места, как посчитать нужный размер метаданных заранее, почему авторасширение у большинства просто не работает, и что делать руками, когда Meta% уже показывает 100,00. С разбором реального выезда, командами и цифрами.
«Диск не кончился» — а пул уже read-only
Звонок в 09:40: в музыкальной школе встали все виртуальные машины — 1С у бухгалтера, электронный журнал у преподавателей, общая папка с нотами и записями концертов. При этом на гипервизоре свободно больше терабайта. Захожу по ssh, смотрю lvs — колонка Data% показывает семнадцать процентов. И тут же рядом колонка Meta% со значением 100,00. Всё, приехали. Пул ушёл в read-only, гости ловят ошибки ввода-вывода, а свободный терабайт к делу не относится вообще.
Тонкий пул LVM — это не один объём, а три сущности в одном флаконе: область данных (_tdata), область метаданных (_tmeta) и запасной том под ремонт (_pmspare). Метаданные — это карта: какой блок тонкого тома лежит на каком блоке физической области, кто с кем делит блоки после снапшота, что уже освобождено. Карта живёт в отдельном логическом томе фиксированного размера. Когда карта заканчивается, писать больше некуда, даже если сама область данных пустая на три четверти. Это ровно та развилка, которую большинство админов не видит, потому что глазами читает только «сколько свободно».
Показывает всё одна команда, и её надо знать наизусть. Обратите внимание на флаг -a — без него служебные тома _tmeta и _pmspare спрятаны, а именно они здесь интересны:
lvs -a -o lv_name,lv_size,data_percent,metadata_percent,chunksize,segtype pve

  LV              LSize    Data%  Meta%  Chunk  Type
  data            1,70t    17,40  100,00 64,00k thin-pool
  [data_tdata]    1,70t                         linear
  [data_tmeta]  256,00m                         linear
  [lvol0_pmspare] 256,00m                       linear
  vm-101-disk-0   120,00g  58,30                thin
В man-странице lvmthin(7) это сформулировано максимально сухо: если пространство метаданных тонкого пула исчерпано (или операция с метаданными завершилась ошибкой), на операции ввода-вывода тонких томов будут возвращаться ошибки, а lvs покажет 100 в колонке Meta%. И дальше важное: исчерпание метаданных ведёт к несогласованности метаданных пула и файловых систем внутри тонких томов. То есть это не «подождём, само рассосётся», это состояние, из которого выходят офлайн и с проверкой файловых систем.
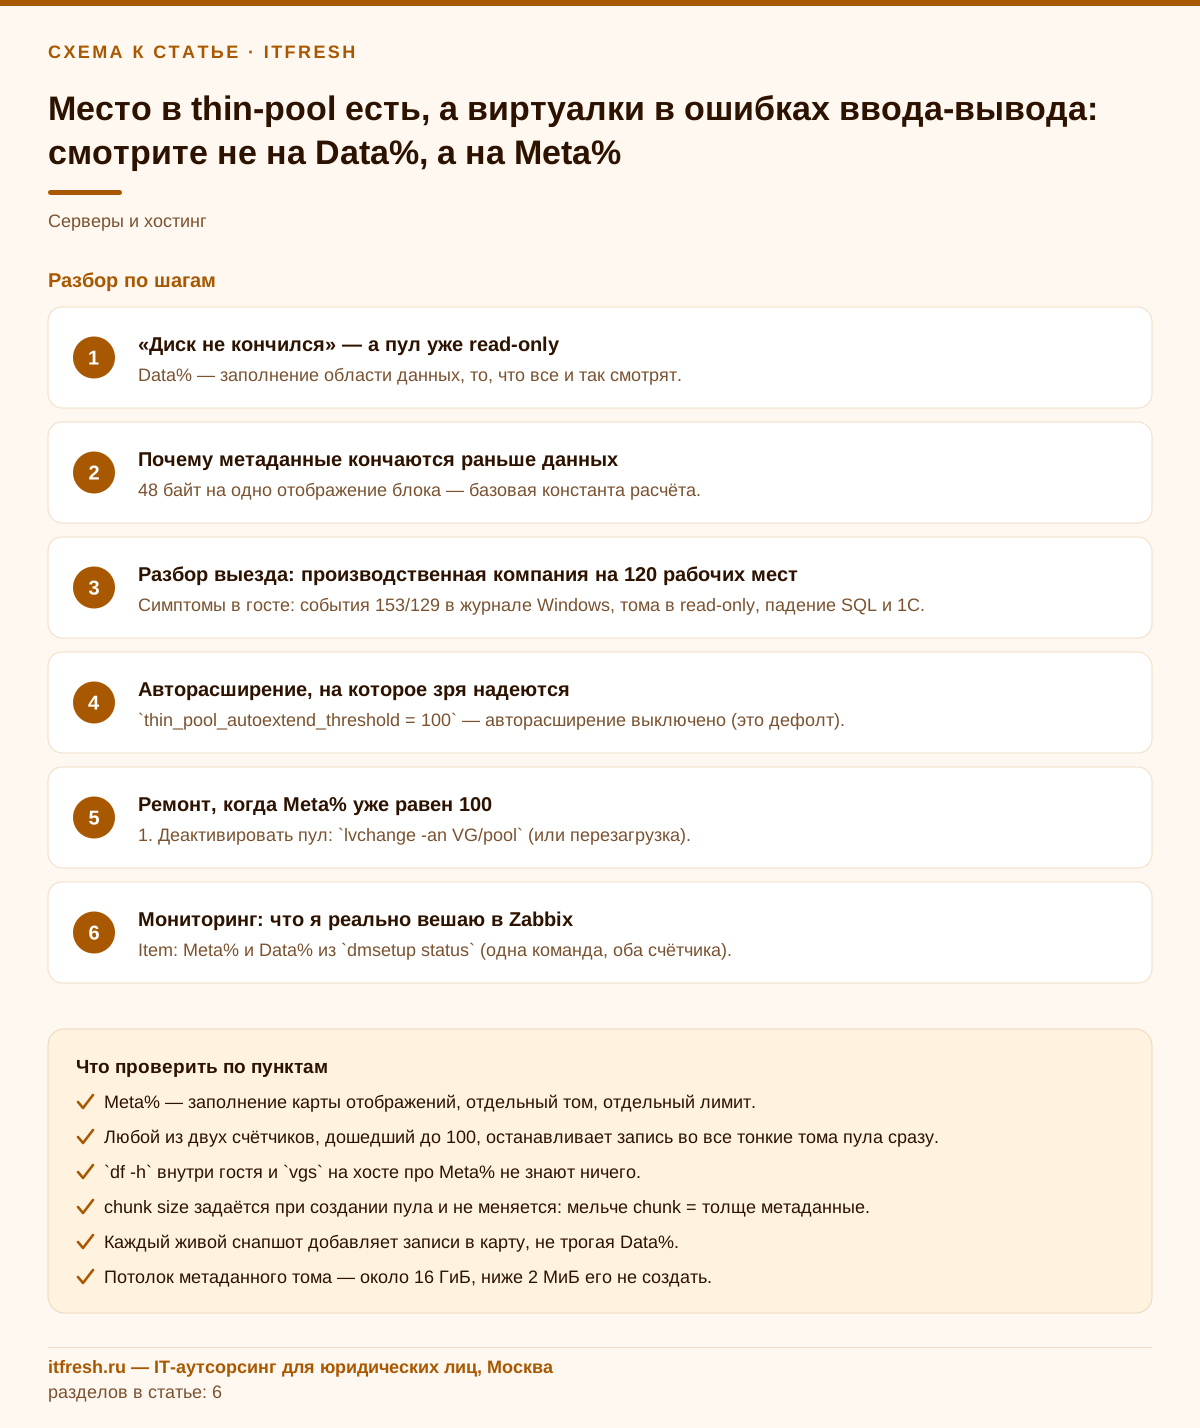
- Data% — заполнение области данных, то, что все и так смотрят.
- Meta% — заполнение карты отображений, отдельный том, отдельный лимит.
- Любой из двух счётчиков, дошедший до 100, останавливает запись во все тонкие тома пула сразу.
- `df -h` внутри гостя и `vgs` на хосте про Meta% не знают ничего.
Почему метаданные кончаются раньше данных
Механика простая. Каждое отображение «блок тонкого тома → блок области данных» стоит примерно 48 байт метаданных. Документация ядра по device-mapper прямо даёт формулу для размера метаданного устройства: 48 × размер_области_данных / размер_блока. Размер блока — это chunk size пула, он задаётся при создании и потом не меняется. Отсюда весь расчёт: чем мельче chunk, тем больше отображений на тот же терабайт, тем жирнее нужна карта.
Посчитаем на примере выше. Пул 1,70 ТиБ, chunk 64 КиБ — это около 28,5 миллиона блоков. Умножаем на 48 байт — выходит примерно 1,3 ГиБ метаданных на полностью залитый пул. А выделено было 256 МиБ, то есть карта с самого начала была рассчитана примерно на пятую часть ёмкости пула. Мелкий chunk 64 КиБ прошлый подрядчик выбрал «под снапшоты», а размер метаданных задал руками, не пересчитав. Именно поэтому Meta% упёрся в потолок при Data% в семнадцать процентов — арифметика сошлась ровно так, как и должна была.
Второй множитель — снапшоты. Тонкий снапшот сам по себе места в области данных не занимает, и это его главная продажная фича. Но каждое расхождение снапшота с оригиналом — это новая запись в карте, а сама карта хранит счётчики совместного владения блоками. Семь живых снапшотов на пуле — и Meta% растёт при неизменном Data%. Классический сценарий: скрипт делает qm snapshot перед каждым обновлением, но не удаляет старые, плюс пара ручных снапшотов «на всякий случай перед обновлением 1С», и через месяц карта кончилась. Данные при этом не выросли ни на гигабайт.
Считать вручную не обязательно, в пакете thin-provisioning-tools есть готовый калькулятор. Он принимает размер блока, размер пула и максимальное число тонких томов:
# сколько метаданных нужно пулу 1,70 ТиБ (≈1740 ГиБ) с chunk 64K на 64 тонких тома
thin_metadata_size -b 64k -s 1740g -m 64 -u M

# посмотреть текущий chunk size и размер метаданных у своих пулов
lvs -o vg_name,lv_name,chunksize,lv_metadata_size -S 'segtype=thin-pool'
Про верхнюю границу: метаданный том по спецификации бывает от 2 МиБ до примерно 16 ГиБ, всё сверх этого просто не используется и пропадает зря. Практический ориентир из lvmthin(7) — начинать с 1 ГиБ, этого хватает для всех практических целей; если размер не задан явно, LVM сам подбирает его исходя из размера данных и chunk size, и опасность начинается как раз тогда, когда кто-то задал его руками «на глаз». Я на серверах клиентов ставлю 4 ГиБ и больше об этом не думаю: даже на самом жирном пуле это меньше промилле от объёма, а нервов экономит вагон.
- 48 байт на одно отображение блока — базовая константа расчёта.
- chunk size задаётся при создании пула и не меняется: мельче chunk = толще метаданные.
- Каждый живой снапшот добавляет записи в карту, не трогая Data%.
- Потолок метаданного тома — около 16 ГиБ, ниже 2 МиБ его не создать.
- Разумный дефолт на 2026 год для гипервизора: 4 ГиБ метаданных, chunk 256–512 КиБ.
Разбор выезда: музыкальная школа «Вдохновение», 10 рабочих мест
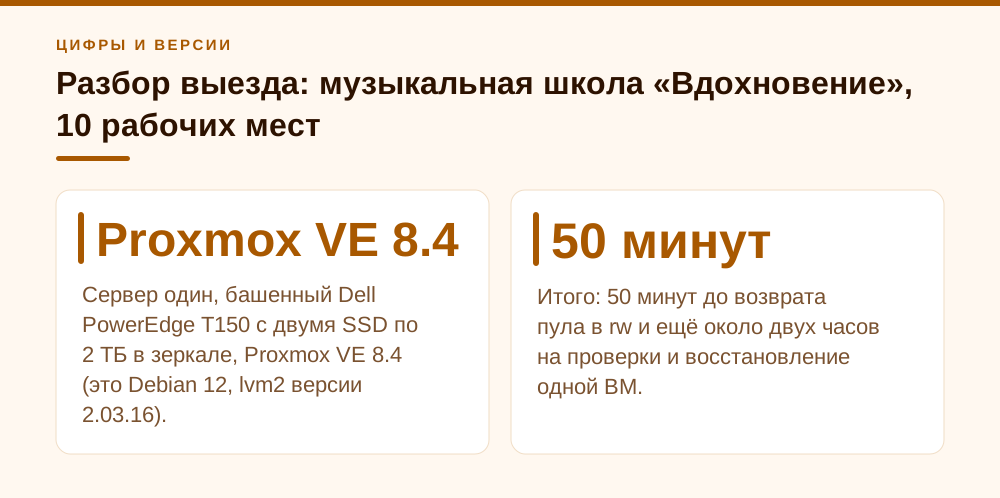
Клиент — музыкальная школа «Вдохновение», 10 рабочих мест: администраторы, бухгалтерия, преподавательская. Сервер один, башенный Dell PowerEdge T150 с двумя SSD по 2 ТБ в зеркале, Proxmox VE 8.4 (это Debian 12, lvm2 версии 2.03.16). Volume group pve на 1,82 ТиБ, тонкий пул pve/data на 1,70 ТиБ, пять виртуальных машин: 1С:Бухгалтерия, файловый сервер с нотами и записями концертов, электронный журнал, сервер печати и учебная ВМ для компьютерного класса. Ставили гипервизор не мы: прошлый подрядчик после установки удалил штатный пул и пересоздал его вручную с chunk 64 КиБ и метаданными 256 МиБ. Школа пришла к нам на обслуживание уже с работающим сервером, и это, как всегда, обошлось дороже, чем если бы ставили с нуля.
Утром понедельника гостевая Windows с 1С начала сыпать в журнал события 153 от disk и 129 от драйвера контроллера, потом том с базами ушёл в read-only, и 1С перестала открываться. Файловый сервер встал следом, преподаватели остались без нот к занятиям. На хосте в dmesg картина была недвусмысленная: сначала reached low water mark for metadata device: sending event, затем metadata operation 'dm_thin_insert_block' failed: error = -28, затем aborting current metadata transaction и switching pool to read-only mode. Минус двадцать восемь — это ENOSPC, «нет места». На метаданных.
Дальше по цифрам. lvs дал Data% 17,40 при Meta% 100,00, chunk 64 КиБ, data_tmeta — 256,00 МиБ, lvol0_pmspare — те же 256,00 МиБ. В VG оставалось свободно 16,00 ГиБ нераспределённых экстентов — это резерв minfree, который установщик Proxmox по умолчанию оставляет в группе pve на дисках больше 128 ГБ, и прошлый подрядчик его не тронул. Вот это нас и спасло: если бы пулу отдали вообще всё, расширять метаданные было бы некуда, и разговор шёл бы уже про новый диск и простой на полдня. На пуле висели семь снапшотов: пять создал скрипт перед еженедельным обновлением 1С и так и не удалил, два оставили руками, самому старому было пять месяцев.
Порядок действий был такой. Сначала остановил все ВМ через qm stop и деактивировал пул. Затем — и это я делаю всегда, до любого ремонта — снял побайтовую копию метаданных на внешний USB-диск. Для этого метаданный том при неактивном пуле активируется отдельно как компонент, только на чтение (так умеют lvm2 ветки 2.03), читается через dd и снова деактивируется: 256 мегабайт, несколько секунд. Копия нужна не для восстановления, а на случай, если ремонт сделает хуже: испорченный оригинал ещё можно отдать в разбор, а перезаписанный — уже нет. Прогнал thin_check /root/tmeta.img — предупреждения по счётчикам ссылок, но структура жива. Потом lvconvert --repair pve/data, который собрал исправленную копию в _pmspare и подменил ею метаданный том. Старый том LVM оставил рядом под именем pve/data_meta0 — его я не трогал ещё неделю.
После ремонта удалил пять забытых снапшотов, расширил метаданные до 2 ГиБ (с запасом к расчётным 1,3 ГиБ, больше не позволял резерв в VG) и только потом поднимал машины. Расширять надо именно после ремонта: если сделать наоборот, вы получите большой том с всё той же поломанной картой. Затем — проверка файловых систем внутри гостей, и вот тут вылезла цена простоя: на томе NTFS с базами 1С chkdsk нашёл битые записи MFT, на ext4 файлового сервера — двенадцать осиротевших inode, а ВМ электронного журнала пришлось разворачивать из Proxmox Backup Server, потому что её база после ремонта не открывалась. Итого: 50 минут до возврата пула в rw и ещё около двух часов на проверки и восстановление одной ВМ. Занятия в тот день начались с опозданием, но без потери расписания.
# 1. Гасим всё, что пишет в пул
qm stop 101 102 103 104 105
lvchange -an pve/data

# 2. Снимаем копию метаданных ДО ремонта
#    (компонентная активация tmeta — только чтение, пул должен быть неактивен)
lvchange -ay pve/data_tmeta
dd if=/dev/pve/data_tmeta of=/root/tmeta.img bs=1M status=progress
lvchange -an pve/data_tmeta
thin_check /root/tmeta.img

# 3. Ремонт (создаёт исправленную копию через pmspare)
lvconvert --repair pve/data

# 4. Только теперь расширяем метаданные
lvextend --poolmetadatasize 2G pve/data
lvchange -ay pve/data

# 5. Проверяем файловые системы внутри гостей — обязательно
Вывод, который я озвучил директору школы в отчёте: авария была заложена в конфигурацию в день пересоздания пула и просто ждала своей даты. Никакой деградации железа, никакого «диск умер». Проблема была ровно в двух цифрах — 256 мегабайт метаданных при chunk 64 КиБ на пул в 1,7 терабайта.
- Симптомы в госте: события 153/129 в журнале Windows, тома в read-only, 1С и общая папка недоступны.
- Симптомы на хосте: в dmesg `error = -28`, `aborting current metadata transaction`, `switching pool to read-only mode`.
- Ключевые цифры: Data% 17,40 при Meta% 100,00, chunk 64 КиБ, tmeta 256 МиБ на пул 1,70 ТиБ.
- Что спасло: 16 ГиБ свободных экстентов в VG — резерв `minfree` установщика Proxmox.
Авторасширение, на которое зря надеются
Второй по частоте разговор, который у меня случается на эту тему: «да там же авторасширение включено, пул сам вырастет». Как правило — нет, не вырастет. В стандартном lvm.conf порог activation/thin_pool_autoextend_threshold равен 100, а сто по документации означает, что авторасширение выключено. Минимальное значение — 50: всё, что ниже, LVM трактует как 50. Второй параметр, thin_pool_autoextend_percent, задаёт, на сколько процентов от текущего размера пул увеличится за один раз.
Но даже правильно выставленные пороги — это только половина. Авторасширение выполняет демон dmeventd, который следит за пулом и в нужный момент дёргает lvextend --use-policies. Если пул не под наблюдением, пороги никто не прочитает. И третье условие, о котором забывают чаще всего: расти пулу некуда, если в volume group нет свободных экстентов. Установщики многих дистрибутивов отдают тонкому пулу всё место без остатка — и тогда авторасширение будет исправно срабатывать, исправно пытаться и исправно писать в лог отказ.
Проверяется всё тремя командами. lvs -o+seg_monitor покажет, стоит ли пул под наблюдением dmeventd; vgs покажет свободное место в группе; конфиг покажет пороги:
# /etc/lvm/lvm.conf
activation {
    thin_pool_autoextend_threshold = 70
    thin_pool_autoextend_percent = 20
}
lvs -o lv_name,data_percent,metadata_percent,seg_monitor pve
vgs -o vg_name,vg_free,vg_free_count
lvchange --monitor y pve/data # включить наблюдение, если not monitored
systemctl status lvm2-monitor.serviceОтдельно скажу про важный нюанс: авторасширение растит и область данных, и область метаданных, но опираться на него как на единственную защиту я не советую. У него есть жёсткое ограничение — свободные экстенты VG кончаются, и на этом всё. Я закладываю в VG резерв заранее (обычно 5–10 % ёмкости под пул; штатные 16 ГиБ minfree у Proxmox — это минимум, а не норма), выставляю порог 70 и одновременно вешаю алерт на 75, чтобы человек узнал о росте раньше, чем автоматика доест резерв. Автоматика — это отсрочка, а не решение.
- `thin_pool_autoextend_threshold = 100` — авторасширение выключено (это дефолт).
- Минимальное значение порога — 50, меньшие значения считаются как 50.
- Без dmeventd (`lvs -o+seg_monitor` = not monitored) пороги не работают вообще.
- Без свободных экстентов в VG расширяться некуда — проверяйте `vgs -o vg_free`.
- Резерв в VG под будущий рост — 5–10 % ёмкости пула, не отдавайте установщику всё.
Ремонт, когда Meta% уже равен 100
Порядок из lvmthin(7) короткий и его надо соблюдать буквально: деактивировать тонкий пул (или, если не получается, перезагрузить хост), выполнить lvconvert --repair VG/ThinPool, расширить метаданные через lvextend --poolmetadatasize, проверить файловые системы. Ни один шаг не переставляется. Особенно не пытайтесь чинить пул, в который кто-то ещё пишет — thin_repair не работает на живых метаданных, это написано в его man-странице прямым текстом.
Как устроен --repair изнутри: LVM запускает thin_repair, создаёт исправленную копию метаданных в запасном томе _pmspare и подменяет ею рабочий метаданный том, а старый, повреждённый, становится видимым под именем ThinPool_metaN (N = 0, 1, …). Отсюда практический вывод — запасной том должен существовать и быть не меньше метаданных. LVM создаёт один _pmspare на VG при создании первого тонкого пула; если в какой-то момент метаданные выросли, а запасной том отстал или был отключён, ремонт может не пройти. Проверяется тем же lvs -a, управляется ключом --poolmetadataspare y|n.
Здесь начинается место, где гарантий нет, и я скажу честно. Ни lvmthin(7), ни документация ядра не обещают, что ремонт вернёт всё как было: thin_repair восстанавливает согласованную структуру карты, но оборванная транзакция и записи, которые не успели лечь в метаданные, никуда не возвращаются, а при серьёзном повреждении ремонт может выбросить часть отображений. Практика говорит, что в подавляющем большинстве случаев штатный ремонт проходит успешно. Разрешается это просто: снимаете dd-копию метаданного тома, чините штатно, а если стало хуже — у вас на руках нетронутый оригинал, с которым можно пробовать thin_repair в файл, звать поддержку дистрибутива или специалистов по восстановлению. Без копии совет «чините аккуратно» превращается в лотерею.
И последнее по ремонту, самое неприятное. Ядро в документации по device-mapper предупреждает: при исчерпании метаданных текущая транзакция обрывается, пул уходит в read-only, а завершения ввода-вывода, которые уже подтверждены вышележащим кэшам, могут не соответствовать реальному состоянию на диске. Перевод на человеческий: файловые системы внутри тонких томов после такого инцидента считаются подозрительными по умолчанию. Прогнать fsck в Linux-гостях и chkdsk /f в Windows — не паранойя, а обязательный пункт. Мы у клиента на этом шаге и нашли битые записи MFT, которые иначе всплыли бы через неделю в самый неудобный момент.
# что должно быть видно перед ремонтом
lvs -a -o lv_name,lv_size,lv_role vg0 | egrep 'tmeta|pmspare'

# нештатный путь, если lvconvert --repair отказался:
# чиним в файл, смотрим результат, только потом заливаем
thin_dump  -r /root/tmeta.img -o /root/tmeta.xml
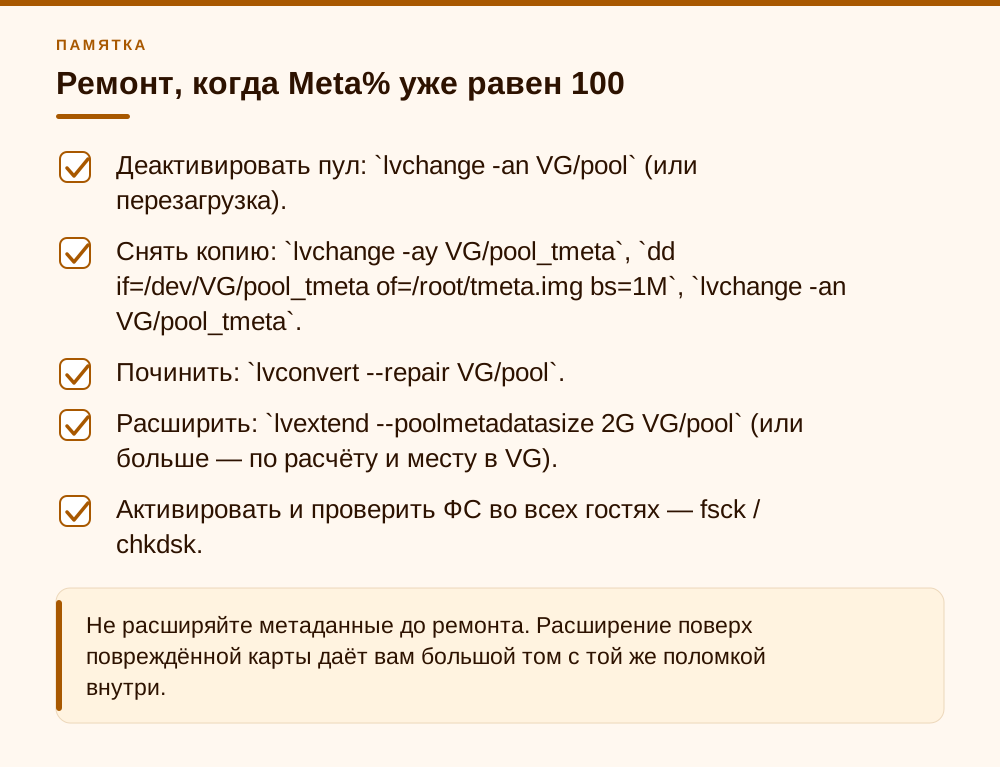
thin_repair -i /root/tmeta.img -o /root/tmeta.fixed- 1. Деактивировать пул: `lvchange -an VG/pool` (или перезагрузка).
- 2. Снять копию: `lvchange -ay VG/pool_tmeta`, `dd if=/dev/VG/pool_tmeta of=/root/tmeta.img bs=1M`, `lvchange -an VG/pool_tmeta`.
- 3. Починить: `lvconvert --repair VG/pool`.
- 4. Расширить: `lvextend --poolmetadatasize 2G VG/pool` (или больше — по расчёту и месту в VG).
- 5. Активировать и проверить ФС во всех гостях — fsck / chkdsk.
- 6. Старый том `VG/pool_meta0` не удалять минимум неделю.
Мониторинг: что я реально вешаю в Zabbix
Самый дешёвый и надёжный источник данных — не парсинг lvs, а статусная строка целевого устройства. dmsetup status отдаёт для thin-pool использованные и общие блоки метаданных и данных, режим (rw, ro или out_of_data_space), политику при нехватке места (error_if_no_space или queue_if_no_space) и флаг needs_check. Этот флаг — отдельная ценность: он загорается, когда пул требует проверки, и его наличие само по себе повод разбудить дежурного.
# формат: <txn id> <used_meta>/<total_meta> <used_data>/<total_data> ... rw|ro|out_of_data_space ... needs_check|-
dmsetup status /dev/mapper/pve-data

# в проценты, для item'а мониторинга
dmsetup status /dev/mapper/pve-data | awk '{split($4,m,"/"); split($5,d,"/"); printf "meta=%.1f data=%.1f\n", m[1]*100/m[2], d[1]*100/d[2]}'
Пороги я ставлю такие: предупреждение на Meta% ≥ 60 и Data% ≥ 75, авария на Meta% ≥ 80 и Data% ≥ 90, плюс отдельный триггер на появление в статусе слов out_of_data_space, ro или needs_check. Почему для метаданных порог ниже — потому что метаданные растут скачками при работе со снапшотами, а расширить их без остановки пула получается не всегда, и запас времени нужен больше. Плюс отдельная проверка раз в сутки: количество снапшотов на пуле и возраст самого старого. Забытый снапшот — самая частая причина, по которой Meta% уезжает без роста Data%.
Ещё один рычаг, о котором мало кто знает: поведение пула при нехватке места настраивается. По умолчанию dm-thin ставит запросы ввода-вывода в очередь и держит их до истечения таймаута — параметр модуля no_space_timeout у dm-thin-pool, по умолчанию 60 секунд, ноль отключает таймаут совсем. Для баз данных и 1С мне ближе честная быстрая ошибка (lvchange --errorwhenfull y), чем шестьдесят секунд молчаливого зависания всего гипервизора: приложение падает предсказуемо, а не размазывает недописанные транзакции. Решение спорное и зависит от нагрузки — на файловой помойке я бы, наоборот, оставил очередь.
И про версии, чтобы не гадать. В Debian 13 (trixie) едет lvm2 2.03.31, в Debian 12 — 2.03.16; thin-provisioning-tools в bookworm — 0.9.0, в trixie — 1.1.0 (ветка 1.x переписана на Rust, но имена утилит и основные ключи thin_check, thin_dump, thin_repair -i/-o сохранены). Синтаксис ключей --poolmetadatasize, --repair, --errorwhenfull и параметров lvm.conf во всех этих версиях одинаковый, так что рецепты выше переносятся между Proxmox VE 8 и 9 без правок. Полный список параметров lvm.conf с комментариями на своей версии смотрите командой lvmconfig --typeconfig default --withcomments.
- Item: Meta% и Data% из `dmsetup status` (одна команда, оба счётчика).
- Триггер warning: Meta% ≥ 60, Data% ≥ 75.
- Триггер disaster: Meta% ≥ 80, Data% ≥ 90, либо `ro` / `out_of_data_space` / `needs_check` в статусе.
- Ежедневно: число снапшотов и возраст самого старого.
- Ежемесячно: `vgs -o vg_free` — не съел ли резерв автоэкстенд.
Что делать сегодня, а на что можно забить
Приоритет номер один и он же единственный срочный: зайти на каждый хост с тонкими пулами и посмотреть три числа — Meta%, размер метаданного тома и свободные экстенты VG. Это пять минут на сервер. Если метаданных меньше гигабайта на пуле от терабайта — планируйте окно и расширяйте, пока пул живой и здоровый; онлайн-расширение метаданных штатно поддерживается и на активном пуле обычно проходит без остановки, но окно я всё равно беру, потому что если оно понадобится, то понадобится внезапно.
Приоритет два: свободное место в VG. Если установщик отдал тонкому пулу все экстенты до последнего — вы лишены и авторасширения, и возможности спокойно нарастить метаданные. Лечится либо добавлением диска в группу, либо (на этапе установки) резервированием 5–10 % сразу. Приоритет три: мониторинг обоих счётчиков и флага needs_check. Приоритет четыре: ревизия снапшотов и правило «снапшот живёт не дольше суток, кроме тех, что делает система бэкапа».
А теперь про то, на что можно забить, потому что риск здесь регулярно преувеличивают. Не надо в панике мигрировать с thin на thick или на ZFS: тонкое выделение — нормальная зрелая технология, проблема не в ней, а в дефолтном размере карты и в отсутствии наблюдения. Не надо гнаться за максимальными 16 ГиБ метаданных, если у вас пул на терабайт с chunk от 256 КиБ — одного-двух гигабайт хватит с запасом на годы, а при chunk 64 КиБ считайте по формуле. Не надо каждый день руками бегать по lvs, если настроен алерт. И совершенно точно не надо трогать chunk size на работающем пуле: он не меняется, менять его — это пересоздание пула и перенос всех данных, а выигрыш в большинстве случаев не стоит риска.
Резюмируя одной фразой: тонкий пул ломается не когда кончается место, а когда кончается карта. Смотрите на Meta%, держите резерв в VG, чините строго по порядку и всегда снимайте копию метаданных перед ремонтом. Всё остальное — детали.
- Сегодня: `lvs -a -o +metadata_percent,chunksize` на всех хостах, `vgs -o vg_free`.
- На этой неделе: пересчитать метаданные по формуле и расширить там, где их меньше расчётного объёма (ориентир — не меньше 1 ГиБ).
- На этой неделе: триггеры на Meta%, Data%, `needs_check`.
- В следующем окне: ревизия снапшотов и регламент их жизни.
- Не делать: менять chunk size на живом пуле, срочно бежать с thin на ZFS, ставить метаданные «на максимум ради максимума».
Частые вопросы
Можно ли расширить метаданные тонкого пула без остановки виртуальных машин?
Если пул жив и Meta% ещё не 100 — да, `lvextend --poolmetadatasize 2G VG/pool` (или с плюсом: `--poolmetadatasize +1G`) штатно отрабатывает на активном пуле, VM останавливать не нужно. Требуется только свободное место в volume group. А вот если пул уже ушёл в read-only из-за исчерпания метаданных, расширять надо после ремонта и с деактивированным пулом: сначала `lvchange -an`, потом `lvconvert --repair`, и только затем `lvextend --poolmetadatasize`.
Сколько метаданных закладывать при создании пула?
Считайте по формуле из документации ядра: 48 × размер_пула / chunk_size. Для пула 1,70 ТиБ с chunk 64 КиБ выходит около 1,3 ГиБ на полностью залитый пул, для того же пула с chunk 512 КиБ — всего около 170 МиБ. Со снапшотами закладывайте кратный запас, а для проверки есть `thin_metadata_size`. Практический ориентир из lvmthin(7) — не меньше 1 ГиБ; на гипервизорах с крупным пулом или мелким chunk я ставлю 2–4 ГиБ: это доли процента от ёмкости и снимает вопрос на годы. Верхний предел тома метаданных — около 16 ГиБ, больше создавать бессмысленно.
Почему авторасширение не сработало, хотя я его включил?
Три типовые причины. Первая: порог остался равным 100 — а это по документации и есть «выключено», минимальное значение 50 (всё ниже трактуется как 50). Вторая: пул не под наблюдением dmeventd, проверьте `lvs -o+seg_monitor` и включите `lvchange --monitor y VG/pool`, а также убедитесь, что запущен `lvm2-monitor.service`. Третья и самая частая: в volume group нет свободных экстентов, расти пулу физически некуда — смотрите `vgs -o vg_free`.
Что делать, если `lvconvert --repair` не помог?
Не перезапускать его по кругу. Взять снятую заранее `dd`-копию метаданного тома, прогнать `thin_dump` и `thin_repair -i файл -o файл` в отдельный файл, посмотреть результат и только потом решать, заливать ли его обратно. Оригинальный повреждённый том LVM после ремонта оставляет рядом под именем `VG/pool_meta0` — не удаляйте его, пока не убедились, что всё работает. Если данные критичны, а ремонт в файл не даёт результата, дальше идёт восстановление из резервной копии: это быстрее и предсказуемее любых экспериментов с картой.
Влияет ли chunk size на расход метаданных и можно ли его поменять потом?
Влияет напрямую: чем мельче chunk, тем больше отображений на тот же объём и тем толще карта. Диапазон допустимых значений — от 64 КиБ до 1 ГиБ; мелкий chunk выгоден при интенсивной работе со снапшотами, крупный — при обычном тонком выделении. Поменять chunk size у существующего пула нельзя: он фиксируется при создании. Единственный путь — создать новый пул с нужным chunk и перенести тома, что на боевом гипервизоре редко оправдано.
Нужно ли проверять файловые системы внутри виртуалок после исчерпания метаданных?
Да, обязательно. Документация ядра прямо предупреждает: при исчерпании метаданных текущая транзакция обрывается, а подтверждённые вышележащим кэшам завершения ввода-вывода могут не соответствовать тому, что реально легло на диск. Практически это значит, что любая ФС в тонких томах после инцидента подозрительна. `fsck -f` в Linux-гостях и `chkdsk /f` в Windows — обязательный шаг, а базы данных стоит дополнительно проверить средствами СУБД.
Источники
- lvmthin(7), man-pages Linux — Разделы Automatic extend (thin_pool_autoextend_threshold: минимум 50, 100 отключает; thin_pool_autoextend_percent), Metadata space exhaustion (ошибки I/O, Meta% = 100, порядок lvconvert --repair → lvextend --poolmetadatasize), Spare metadata LV (_pmspare), Metadata size (от 2 MiB до ~16 GiB, рекомендация 1 GiB), chunk size 64 KiB – 1 GiB, старый метаданный том после ремонта — ThinPool_metaN, --errorwhenfull и no_space_timeout. https://man7.org/linux/man-pages/man7/lvmthin.7.html
- Linux Kernel Documentation — Device Mapper: Thin provisioning — Формула размера метаданных 48 × data_dev_size / data_block_size, максимум 16 GiB, формат строки dmsetup status (transaction id, used/total metadata blocks, used/total data blocks, held metadata root, rw|ro|out_of_data_space, error_if_no_space|queue_if_no_space, needs_check), параметр модуля no_space_timeout (по умолчанию 60 с). https://docs.kernel.org/admin-guide/device-mapper/thin-provisioning.html
- thin_repair(8) / thin_metadata_size(8), thin-provisioning-tools — Синтаксис thin_repair -i {device|file} -o {device|file}, запрет запуска на живых метаданных; калькулятор thin_metadata_size -b <blocksize> -s <pool size> -m <max thins> -u <unit>. https://manpages.debian.org/testing/thin-provisioning-tools/thin_repair.8.en.html
- Proxmox VE Wiki — Logical Volume Manager (LVM) — Устройство тонкого пула pve/data на инсталляции Proxmox VE, команда lvresize --size +… --poolmetadatasize +… <VG>/<LVThin_pool> и требование расширять метаданные вместе с пулом. https://pve.proxmox.com/wiki/Logical_Volume_Manager_(LVM)
- Debian packages — lvm2 и thin-provisioning-tools — lvm2: trixie 2.03.31, bookworm 2.03.16; thin-provisioning-tools: bookworm 0.9.0-2, trixie 1.1.0. https://packages.debian.org/search?keywords=thin-provisioning-tools&searchon=names&exact=1&suite=all§ion=all
- Red Hat Enterprise Linux 9 — Configuring and managing logical volumes — Разделы «Extending a thin pool metadata segment» и «Automatically extending a thin pool» (thin_pool_autoextend_threshold = 70, thin_pool_autoextend_percent = 20). https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/9/html/configuring_and_managing_logical_volumes/basic-logical-volume-management_configuring-and-managing-logical-volumes
- Proxmox VE Administration Guide — Installation, Advanced LVM Configuration Options — Параметры установщика hdsize, swapsize, maxroot, maxvz, minfree (по умолчанию 16 ГБ свободного места в VG pve при диске больше 128 ГБ). https://pve.proxmox.com/pve-docs/chapter-pve-installation.html