
Почему ВМ в Proxmox HA не запускается после отказа узла, хотя память на соседе свободна
Узел упал, HA отработал, большинство машин поднялось — а одна-две висят в recovery. Администратор смотрит на соседний узел: там 40 гигабайт свободной памяти и половина простаивающих ядер. Ресурсы есть, машина не стартует. В девяти случаях из десяти виноваты не ресурсы, а правила размещения в /etc/pve/ha/rules.cfg. Ниже — как это устроено в Proxmox VE 9, живой разбор аварии на трёхузловом кластере и порядок действий, который сокращает простой с получаса до трёх минут.
Свободная память ничего не решает: кандидатов выбирает не она
Типичная картина ночного звонка. Отказал узел, watchdog его отстрелил, кластер сохранил кворум, HA-менеджер разложил ресурсы по живым узлам. Из семи HA-ресурсов пять поднялись за пару минут, а сервер 1С и сервер учётной системы ресторанов висят. Первое, что делает администратор, — открывает сводку по узлам и видит: свободно 41 ГБ, загрузка CPU 18 %. Дальше начинается получасовое исследование стораджа, мультипаса и сети, потому что «ресурсы же есть».
Ресурсы действительно есть. Только HA-менеджер выбирает узел не так, как вам кажется. Внутри он формирует список узлов-кандидатов, прогоняет его через скомпилированные правила размещения и только потом взвешивает оставшихся по загрузке. Если после фильтрации список пуст — взвешивать нечего. Ресурс остаётся в состоянии recovery и будет там сидеть, пока не вернётся исходный узел или пока в конфигурацию не вмешается человек. Ни одного сообщения о том, что именно правило выкинуло кандидатов, в журнале не появится: фильтрация происходит внутри функции выбора узла молча.
С Proxmox VE 9.0 вся эта механика переехала в новое место. Прежние HA Groups объявлены устаревшими и автоматически мигрированы в правила Node Affinity, к ним добавились правила Resource Affinity, и всё это лежит в /etc/pve/ha/rules.cfg. Обновление прошло гладко, конфигурация переехала сама — а понимание не переехало. Люди продолжают думать категориями старых групп с их «приоритетами и restricted», и ловят сюрприз ровно в тот момент, когда ловить его дороже всего.
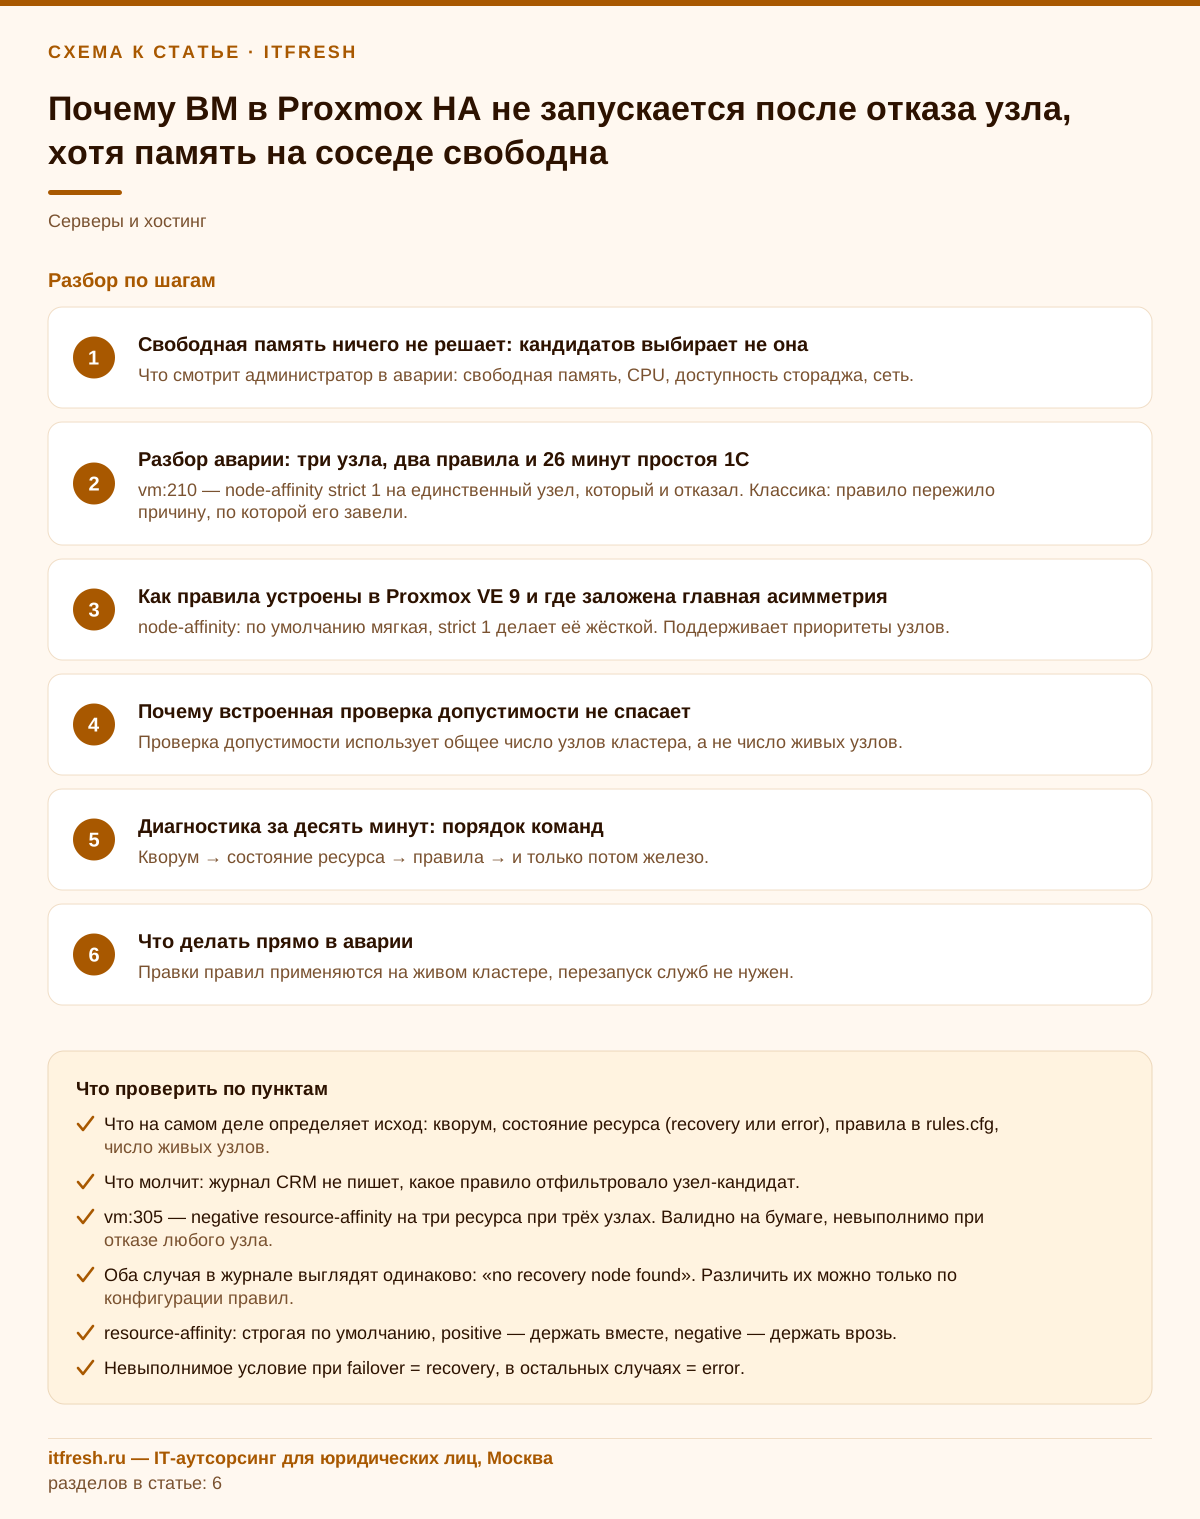
- Что смотрит администратор в аварии: свободная память, CPU, доступность стораджа, сеть.
- Что на самом деле определяет исход: кворум, состояние ресурса (recovery или error), правила в rules.cfg, число живых узлов.
- Что молчит: журнал CRM не пишет, какое правило отфильтровало узел-кандидат.
Разбор аварии: три узла, два правила и 26 минут простоя 1С
Ресторанная группа «Точка вкуса»: несколько заведений, офис с бухгалтерией и закупками, 36 рабочих мест. Кластер Proxmox VE 9.1 из трёх узлов pve-01, pve-02, pve-03, на каждом один Xeon Silver и 96 ГБ памяти, общее хранилище — LUN на СХД по iSCSI с мультипасом, 19 виртуалок, из них 7 заведены в HA: 1С, сервер учётной системы ресторанов, терминальный сервер офиса, контроллер домена и пара вспомогательных сервисов. Кластер собирали не мы, мы подхватили его на обслуживание, и первый же реальный отказ показал, что именно там было заложено.
В 03:41 на pve-02 умерла материнская плата. Кворум сохранился (два узла из трёх), watchdog отстрелил узел примерно через минуту, HA начал восстановление. Пять ресурсов встали на pve-01 и pve-03 за две-три минуты. Два — нет. Сервер 1С vm:210 и сервер учётной системы ресторанов vm:305 остались в recovery, и каждые десять секунд в журнале повторялось одно и то же:
journalctl -u pve-ha-crm --since -30min | tail -5
# recovering service 'vm:210' from fenced node 'pve-02' failed, no recovery node found
# recovering service 'vm:305' from fenced node 'pve-02' failed, no recovery node found
Причины оказались разные, и это важно — их два разных класса. У vm:210 стояло правило node-affinity со strict 1 и единственным узлом pve-02. Родом оно было из эпохи Proxmox VE 8: два года назад в pve-02 воткнули USB-ключ HASP, машину загнали в HA Group с restricted 1 и единственным узлом, а при обновлении на 9.0 группа честно превратилась в строгое правило node affinity. Ключ давно переехал на сетевой менеджер лицензий, а правило осталось: оно никому не мешало ровно до момента, когда pve-02 перестал существовать. У vm:305 было отрицательное resource-affinity правило на три виртуалки — сервер учётной системы, его резервный экземпляр и сервер отчётов разводили по разным узлам, чтобы не потерять весь контур разом. Три ресурса, три узла, всё сходилось. Пока узлов не стало два.
Дальше — арифметика. Снятие strict у первого правила и удаление второго заняло сорок секунд, обе машины поднялись сами. Но до этого мы двенадцать минут смотрели не туда, а до нас админ клиента смотрел не туда ещё четырнадцать. Итог: 26 минут простоя 1С и учётной системы вместо трёх, которые технически были возможны; ночные закрытия смен в двух заведениях, работающих до утра, пришлось досчитывать вручную. Ни память, ни диски, ни сеть тут ни при чём — ошибка была заложена в конфигурации задолго до аварии.
- vm:210 — node-affinity strict 1 на единственный узел, который и отказал. Классика: правило пережило причину, по которой его завели.
- vm:305 — negative resource-affinity на три ресурса при трёх узлах. Валидно на бумаге, невыполнимо при отказе любого узла.
- Оба случая в журнале выглядят одинаково: «no recovery node found». Различить их можно только по конфигурации правил.
Как правила устроены в Proxmox VE 9 и где заложена главная асимметрия
Конфигурация живёт в /etc/pve/ha/rules.cfg — это pmxcfs, файл автоматически одинаков на всех узлах. Типов правил два, и ведут они себя принципиально по-разному.
Node Affinity привязывает ресурсы к узлам. Аффинность бывает положительной (ресурсы должны или обязаны быть на перечисленных узлах) и отрицательной (должны или обязаны их избегать), а ключевой параметр — strict. По умолчанию правило нестрогое: если ни один из перечисленных узлов недоступен, ресурс разрешено поднять где угодно. Со strict 1 это уже жёсткое ограничение: нет доступного узла из списка — ресурс не запускается вообще. Узлам можно задавать веса, тогда CRM предпочтёт более приоритетный: --nodes "pve-01:2,pve-02:1,pve-03:1". Для отрицательного node-affinity приоритеты не поддерживаются, и перечислить в нём все узлы кластера тоже нельзя.
Resource Affinity описывает отношения между ресурсами: положительная держит их на одном узле, отрицательная разводит по разным. И вот тут заложена та самая асимметрия, из-за которой ломаются кластеры: в отличие от node affinity, правила resource affinity строгие по умолчанию. Никакого мягкого отступления «ну, если совсем некуда — пусть живут вместе» там нет. Формулировка разработчиков прямая: отрицательные правила означают жёсткое условие «эти ресурсы не должны оказаться на одном узле никогда».
# /etc/pve/ha/rules.cfg
node-affinity: pin-1c-to-pve02
	resources vm:210
	nodes pve-02
	strict 1

resource-affinity: split-app-tier
	affinity negative
	resources vm:301,vm:305,vm:307
Когда ограничение выполнить невозможно, поведение зависит от контекста: при failover ресурс уходит в recovery, в остальных ситуациях — в error. Разница практическая. Из recovery машина поднимется сама, как только появится подходящий узел. Из error — нет, там нужно ручное вмешательство. В error ресурс попадает и после исчерпания попыток перезапуска и релокации (max_restart и max_relocate, по умолчанию 1 и 1), и при невыполнимом правиле вне failover — например, при запуске или миграции.
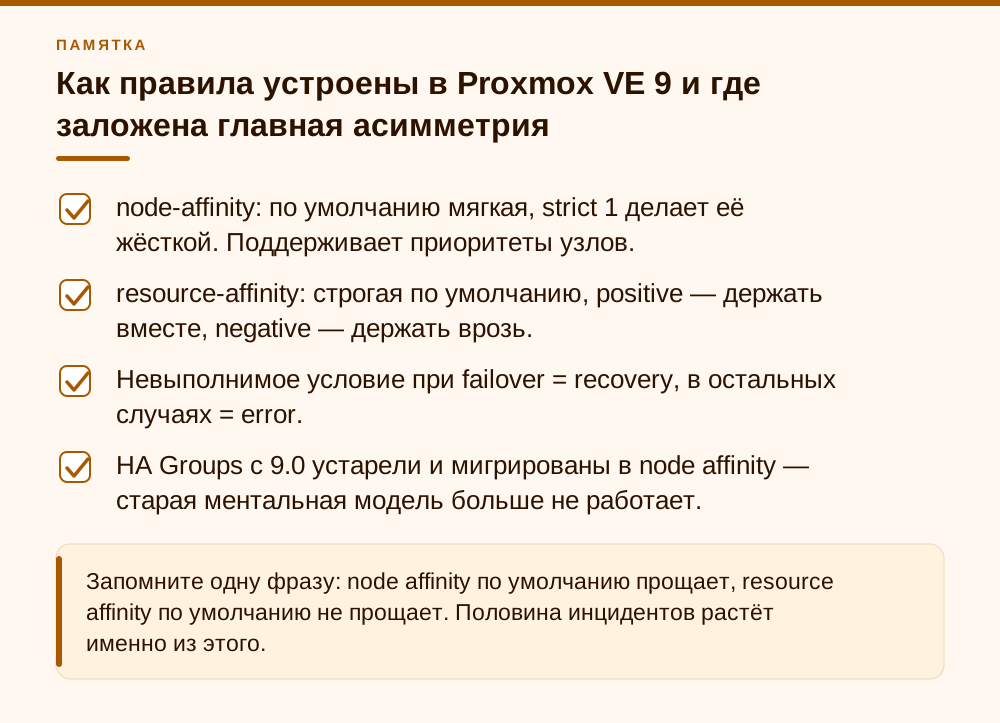
- node-affinity: по умолчанию мягкая, strict 1 делает её жёсткой. Поддерживает приоритеты узлов.
- resource-affinity: строгая по умолчанию, positive — держать вместе, negative — держать врозь.
- Невыполнимое условие при failover = recovery, в остальных случаях = error.
- HA Groups с 9.0 устарели и мигрированы в node affinity — старая ментальная модель больше не работает.
Почему встроенная проверка допустимости не спасает
У Proxmox есть проверка допустимости правил: перед применением конфигурация тестируется, и правила, не прошедшие проверку, отключаются. Проверок несколько: у ресурса может быть только одно node-affinity правило; в правиле resource affinity должно быть минимум два ресурса; отрицательное resource-affinity не может содержать больше ресурсов, чем узлов в кластере; конфликтующие положительные и отрицательные правила на одни и те же ресурсы запрещены. Звучит так, будто вас подстрахуют.
Не подстрахуют, и вот почему. Проверка считает узлы кластера, а не узлы онлайн. Три виртуалки в отрицательном правиле при трёх узлах — конфигурация абсолютно валидная, она пройдёт любую проверку и будет годами работать. Ровно до отказа одного узла: живых становится два, развести три ресурса по двум узлам невозможно, и правило превращается в блокиратор. Проверка допустимости — это защита от синтаксически невозможных конструкций, а не от невозможных сценариев отказа. Отказоустойчивость правил вы считаете сами.
Второй момент — молчание. В журнале вы увидите только «no recovery node found». Ни строчки о том, что кандидаты были и их отфильтровало конкретное правило. Фильтрация выполняется внутри функции выбора узла и в лог не пишется. Поэтому в аварии смотреть надо не в лог, а в конфигурацию правил, и делать это надо до того, как вы полезли проверять сторадж.
Третий момент — изменение размера кластера. Вывели узел на длительное обслуживание, списали старую машину, добавили новую — и набор правил, который вчера был выполнимым, сегодня тихо перестал им быть. Никто вас об этом не уведомит, ошибка проявится только при следующем реальном отказе, то есть в худший из возможных моментов. Ревизия правил должна быть обязательным пунктом любой процедуры изменения состава кластера.
- Проверка допустимости использует общее число узлов кластера, а не число живых узлов.
- Отрицательное resource-affinity на N ресурсов переживает отказ узла только при N+1 узлах в кластере.
- Причина фильтрации кандидатов в журнал не пишется — ищите её в rules.cfg.
- Любое изменение числа узлов может молча сделать правило невыполнимым.
Диагностика за десять минут: порядок команд
Порядок важнее самих команд. Сначала кворум — если кластер потерял кворум, все рассуждения о правилах бессмысленны, HA просто не имеет права ничего запускать. Потом состояние ресурсов. Потом правила. И только потом, если всё чисто, — ресурсы узлов, сторадж и сеть. Обратный порядок и есть та ловушка, в которую попадают почти все.
# 1. Кворум и состав кластера
pvecm status

# 2. Состояние HA-ресурсов и менеджера
ha-manager status
ha-manager config

# 3. Правила размещения — здесь ответ в большинстве случаев
ha-manager rules list
ha-manager rules config
cat /etc/pve/ha/rules.cfg

# 4. Что говорил CRM в момент восстановления
journalctl -u pve-ha-crm -u pve-ha-lrm --since '-30min' --no-pager
Читайте вывод ha-manager status внимательно: recovery и error — это разные диагнозы. Recovery означает, что менеджер ищет узел и не находит; ресурс поднимется сам, как только подходящий узел появится, и лечится это правкой правил. Error означает, что попытки исчерпаны и нужно ручное вмешательство: сначала устраняем причину, потом переводим ресурс в disabled и обратно в started, иначе он так и останется лежать.
Отдельно проверьте, не отключено ли правило проверкой допустимости — такое случается после ручной правки rules.cfg. И сверьте список ресурсов в правилах с реальным списком HA-ресурсов: ссылки на давно удалённые ВМ встречаются регулярно и мешают читать конфигурацию свежим взглядом в три часа ночи.
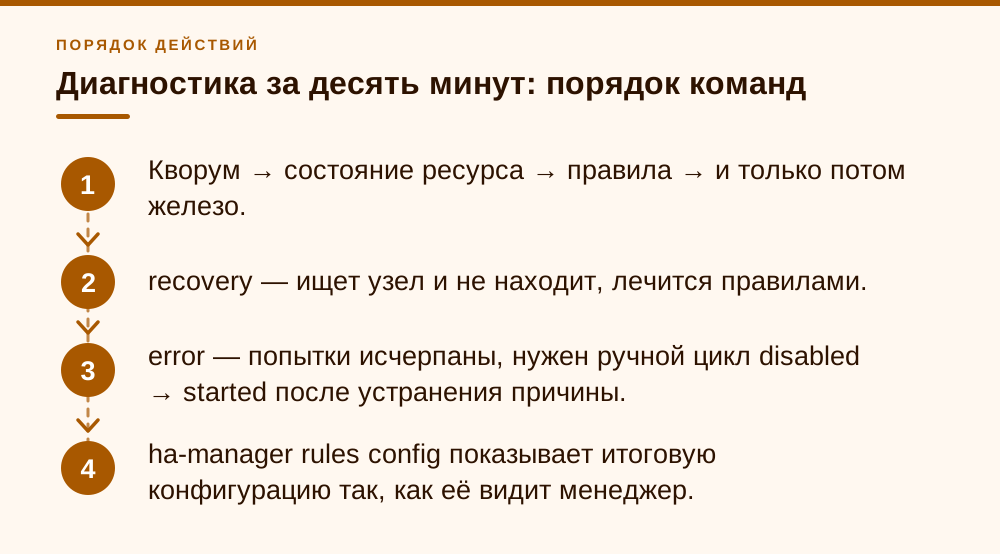
- Кворум → состояние ресурса → правила → и только потом железо.
- recovery — ищет узел и не находит, лечится правилами.
- error — попытки исчерпаны, нужен ручной цикл disabled → started после устранения причины.
- ha-manager rules config показывает итоговую конфигурацию так, как её видит менеджер.
Что делать прямо в аварии
Задача одна: снять ограничение, которое блокирует запуск, минимально изменив конфигурацию. Не переписывать всю схему правил, не перекраивать кластер — только убрать блокиратор и вернуться к нормальной работе. Правила меняются на живом кластере и применяются менеджером сразу.
# Снять жёсткость с привязки к узлу — ВМ поднимется на любом доступном
ha-manager rules set node-affinity pin-1c-to-pve02 --strict 0

# Или удалить правило целиком, если повод для него давно исчез
ha-manager rules remove pin-1c-to-pve02

# Отрицательное resource-affinity, которое не влезает в число живых узлов
ha-manager rules remove split-app-tier

# Ресурс в error: устранили причину — вернули в работу
ha-manager set vm:305 --state disabled
ha-manager set vm:305 --state started
Есть соблазн вместо правки правил запустить ВМ руками через qm start на нужном узле. Это не сработает так, как ожидается: для ВМ под управлением HA qm start не запускает машину напрямую, а лишь выставляет запрошенное состояние started и передаёт запрос в HA-стек. Менеджер снова упрётся в то же правило. Выводить же ресурс из HA ради ручного старта — значит в разгар аварии потерять автоматику для машины, которая и так в беде. Чините причину, а не симптом — это буквально одна команда.
И зафиксируйте изменение. Правило, снятое ночью «на время», превращается в постоянное состояние кластера, о котором через полгода никто не помнит. Заведите короткую запись: что сняли, почему, когда вернуть или чем заменить. Если правило было завязано на реальную физическую привязку — проброс PCI, локальный NVMe, лицензию на конкретное железо — то после аварии его надо вернуть осознанно, а заодно ответить на вопрос, почему такая ВМ вообще числится в HA.
- Правки правил применяются на живом кластере, перезапуск служб не нужен.
- Не подменяйте починку правил ручным qm start — HA всё равно вмешается.
- Для планового обслуживания используйте штатный режим: ha-manager crm-command node-maintenance enable <узел>.
- В Proxmox VE 9.2 появилась возможность временно разоружить HA на всём кластере: ha-manager crm-command disarm-ha freeze (или ignore) и обратно arm-ha — вочдоги отпускаются, фенсинга при обслуживании не будет.
Как проектировать правила, чтобы это не повторилось
Моя рабочая позиция простая: правил должно быть мало, и каждое обязано иметь документированный повод. Каждое лишнее правило — это минус один сценарий отказа, который кластер переживает автоматически. Красивая схема размещения не стоит ни одной лишней минуты простоя.
Арифметика для отрицательного resource-affinity: чтобы правило на N ресурсов пережило отказ одного узла, узлов в кластере нужно N+1. Три ВМ, которые нельзя держать вместе, требуют четырёх узлов, а не трёх. Если четвёртого узла нет — значит, разводить надо две ВМ из трёх, а третью оставить свободной. Да, при аварии две машины окажутся на одном узле. Это лучше, чем одна не окажется нигде. Здесь нет единого правильного ответа, это осознанный выбор между двумя видами риска, и выбирать его должен владелец сервиса, а не тот, кто настраивал кластер полтора года назад.
strict 1 в node affinity я ставлю только там, где привязка физическая и неустранимая: проброшенное PCI-устройство, ключ на конкретном узле, лицензия, привязанная к железу. И сразу задаю второй вопрос — а нужен ли такой ВМ вообще HA? Машина, которая не может подняться нигде, кроме одного узла, отказоустойчивой не является, и держать её в HA — самообман, который к тому же портит статистику восстановления. Во всех остальных случаях — нестрогое правило с приоритетами узлов: предпочтение соблюдается в норме и не мешает в аварии.
Дальше — режим планировщика. Базовый CRS (basic) считает просто количество активных гостей на узле, static учитывает выделенные ВМ CPU и память, и на смешанной нагрузке это заметно честнее; в 9.2 добавился dynamic, который смотрит на фактическое потребление. Опция ha-rebalance-on-start при запуске ресурса выбирает лучший узел и при необходимости сразу переносит туда ВМ. Настраивается в Datacenter → Options или строкой в /etc/pve/datacenter.cfg, для кластеров с неоднородными ВМ я включаю static по умолчанию. Учтите: правила размещения планировщик не отменяет — он взвешивает только тех кандидатов, которых пропустили правила.
# /etc/pve/datacenter.cfg
crs: ha=static,ha-rebalance-on-start=1
И последнее, самое неудобное: учения. Раз в квартал выключаем один узел кнопкой в нерабочее время и смотрим, что реально произошло. В «Точке вкуса» после инцидента мы так и сделали — и на втором прогоне нашли ещё одно мёртвое правило, о котором никто не помнил. Двадцать минут запланированного простоя раз в квартал стоят несопоставимо дешевле получаса внезапного в три часа ночи.
- Отрицательное resource-affinity на N ресурсов → минимум N+1 узлов в кластере.
- strict 1 — только под физическую привязку; такие ВМ пересмотрите на предмет участия в HA.
- Ревизия правил — обязательный пункт при добавлении, выводе или списании узла.
- CRS static (или dynamic в 9.2) вместо basic для неоднородной нагрузки, плюс ha-rebalance-on-start.
- Плановые учения раз в квартал: выключить узел и проверить фактическое время восстановления.
Частые вопросы
Как быстро понять, что ВМ не стартует именно из-за правила, а не из-за ресурсов?
Посмотрите состояние ресурса в ha-manager status. Если он в recovery, а в журнале pve-ha-crm повторяется «no recovery node found» при живых и квориумных узлах со свободной памятью — почти наверняка сработала фильтрация по правилам. Причину смотрите в ha-manager rules config: менеджер не пишет в лог, какое именно правило отсекло кандидатов.
Чем recovery отличается от error и что делать в каждом случае?
Recovery — менеджер ищет подходящий узел и не находит; как только узел появится или вы поправите правило, ресурс поднимется сам. Error — попытки перезапуска и релокации исчерпаны, автоматика больше ничего не сделает: нужно устранить причину и провести ресурс через ha-manager set vm:NNN --state disabled, затем --state started.
Сколько узлов нужно, чтобы отрицательное правило resource affinity пережило отказ?
На N ресурсов, которые нельзя держать вместе, нужно N+1 узлов. Проверка допустимости пропустит правило и при N узлах — она считает узлы кластера, а не живые, — но при отказе любого узла условие станет невыполнимым и ресурс уйдёт в recovery. Если лишнего узла нет, разводите на один ресурс меньше.
Мои старые HA Groups пропали после обновления на Proxmox VE 9. Куда они делись?
HA Groups объявлены устаревшими начиная с 9.0 и автоматически мигрированы в правила Node Affinity. Конфигурация лежит в /etc/pve/ha/rules.cfg, смотреть её удобно через ha-manager rules config. Настоятельно рекомендую сразу после обновления перечитать перенесённые правила: старая группа с restricted превращается в правило со strict 1, которое ведёт себя ровно так же жёстко, как раньше, а свойство nofailback переезжает в параметр failback самого ресурса. Миграция срабатывает только после того, как обновлены все узлы кластера.
Можно ли вместо правки правил просто запустить ВМ вручную через qm start?
Не выйдет: для ВМ под управлением HA команда qm start не запускает машину напрямую, а только выставляет состояние started и передаёт запрос HA-стеку, который упрётся в то же правило. Правильнее снять или ослабить конкретное правило: ha-manager rules set node-affinity <имя> --strict 0 либо ha-manager rules remove <имя>. Это одна команда и предсказуемый результат.
Как безопасно вывести узел кластера на обслуживание, чтобы HA не устроил фенсинг?
Используйте штатный режим обслуживания: ha-manager crm-command node-maintenance enable <узел> — ресурсы будут корректно уведены, а после работ включается disable. В Proxmox VE 9.2 добавили ещё и возможность временно разоружить HA на всём кластере: ha-manager crm-command disarm-ha freeze или ignore, после работ — ha-manager crm-command arm-ha. Это для случаев, когда обслуживание затрагивает сразу несколько узлов или сеть кластера.
Источники
- Proxmox VE Administration Guide — HA Manager, разделы «HA Rules», «Node Affinity Rules», «Resource Affinity Rules», «Rule Conflicts and Errors» — Официальная документация Proxmox VE 9.x: расположение /etc/pve/ha/rules.cfg, синтаксис node-affinity и resource-affinity, параметр strict, нестрогое поведение node affinity по умолчанию и строгое поведение resource affinity, проверки допустимости, переход в recovery при failover и в error в остальных случаях, устаревание HA Groups с 9.0. https://pve.proxmox.com/pve-docs/ha-manager.html (исходник: https://github.com/proxmox/pve-docs/blob/master/ha-manager.adoc)
- pve-ha-manager — исходный код менеджера, PVE/HA/Manager.pm и PVE/CLI/ha_manager.pm — Точные тексты сообщений журнала («recovering service '<sid>' from fenced node '<node>' failed, no recovery node found», «recover service ... to node ...»), выбор узла восстановления в select_service_node() с фильтрацией по правилам без записи в лог, полный набор подкоманд CLI: rules list/config/add/set/remove, crm-command node-maintenance, crm-command disarm-ha freeze|ignore / arm-ha. https://github.com/proxmox/pve-ha-manager ; справка CLI: https://pve.proxmox.com/pve-docs/ha-manager.1.html
- Proxmox Forum — «Negative affinity moved both VMs», ответ разработчика dakralex — Подтверждение строгости отрицательных resource-affinity правил в PVE 9 («hard constraint to never run on the same node»), объяснение, почему при нарушении переезжают оба ресурса, и поведение менеджера при нехватке узлов. https://forum.proxmox.com/threads/negative-affinity-moved-both-vms.182362/
- Proxmox VE Roadmap — релизы 9.0, 9.1, 9.2 — Введение HA Rules и миграция HA Groups в node affinity в 9.0; в 9.2 — проверка ручных миграций на соответствие правилам node affinity и возможность снятия/возврата HA-взвода для обслуживания кластера. https://pve.proxmox.com/wiki/Roadmap
- RunBook Academy — курс по Proxmox, урок «HA Rules: node-affinity, PVE 9» — Практический разбор синтаксиса ha-manager rules add node-affinity, приоритетов узлов вида pve-01:2,pve-02:1, различия strict и нестрогого режима как выбора между двумя режимами отказа, предупреждение о молчаливой потере выполнимости правил при изменении размера кластера. https://runbook.academy/courses/proxmox/lessons/xii-ha-rules/