
Снимок LVM переполнился и стал invalid: почему добавление места уже не спасает откат
Больше всего звонков «мы обновились, что-то пошло не так, откатите» заканчивается одинаково: снимок LVM, сделанный перед обновлением, уже мёртв. В lvs у него стоит буква I, lvconvert --merge отказывается работать, а lvextend, которым админ пытается спасти положение, ничего не возвращает: добавленное место не восстанавливает уже потерянные чанки. Дальше — восстановление из бэкапа и полдня простоя вместо пятнадцати минут отката. В статье разбираю, почему так происходит на уровне механики copy-on-write, как правильно считать размер снимка, как настроить автоматическое расширение и что делать, если снимок уже помечен как invalid.
Что на самом деле означает «снимок заполнен на 100 %»
Обычный снимок толстого логического тома — это не копия данных. Когда вы делаете lvcreate -s, LVM создаёт устройство, которое в момент создания целиком ссылается на блоки исходного тома. Место, которое вы задали ключом -L, не хранит данные оригинала. Оно нужно только под exception store — область, куда ядро складывает копии тех чанков, которые начали меняться уже после создания снимка. Пока в оригинал никто не пишет, снимок занимает практически ноль. Как только идёт запись, device-mapper сначала копирует старый чанк в область снимка, и только потом пропускает новую запись в оригинал. Это и есть copy-on-write.
Из этой механики следует главное практическое правило, которое почему-то мало кто держит в голове: размер снимка — это не «сколько данных влезет», а «сколько данных на оригинале успеет измениться, пока снимок жив». Дефолтный размер чанка для снимков по lvcreate(8) — 4 КиБ (допустимый диапазон 4 КиБ — 512 КиБ, степень двойки). То есть при типичной для СУБД записи страницами по 8 КиБ расход идёт примерно один к одному по объёму перезаписанных данных, без большого мультипликатора. Если операция переписывает 200 ГБ, снимок под неё нужен около 200 ГБ, и никакой размер базы или свободное место внутри файловой системы этого числа не меняют.
Когда область снимка заполняется до конца, ядро больше не может разместить очередное исключение. В dmesg появляется строка вида «device-mapper: snapshots: Invalidating snapshot: Unable to allocate exception», а сам снимок помечается как недействительный. Документация Red Hat формулирует это без оговорок: если снимок достигает 100 % выделенного пространства, он становится invalid. В выводе lvs пятый символ поля lv_attr меняется с a на I — вместо swi-a-s--- вы видите swi-I-s---. Команда dmsetup status для такого устройства вместо счётчика «занято/всего» возвращает слово Invalid. Дальше lvconvert --merge просто откажется работать с сообщением «Unable to merge invalidated snapshot LV» — сливать нечего, снимок битый.
И вот тут ключевой момент, ради которого написана статья. Инвалидация — это не пауза и не «переполнение буфера, который можно расширить». В ту секунду, когда ядро не смогло сохранить старый чанк, запись в оригинал всё равно прошла — иначе встала бы вся файловая система и следом сервис. Старое содержимое чанка не сохранено нигде. С этого момента снимок перестаёт быть согласованным состоянием на момент T: часть блоков в нём относится к времени T, часть безвозвратно потеряна. Добавить места можно, но потерянные чанки не восстановит никто. Именно поэтому merge и отказывается: он бы собрал заведомо повреждённый том, и это было бы хуже, чем честный отказ.
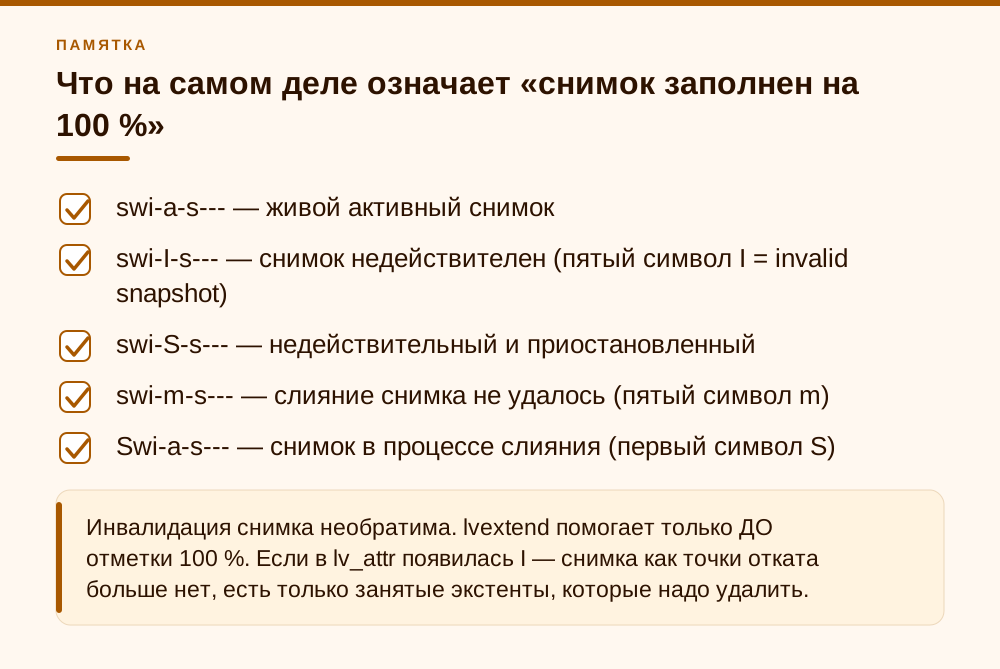
- swi-a-s--- — живой активный снимок
- swi-I-s--- — снимок недействителен (пятый символ I = invalid snapshot)
- swi-S-s--- — недействительный и приостановленный
- swi-m-s--- — слияние снимка не удалось (пятый символ m)
- Swi-a-s--- — снимок в процессе слияния (первый символ S)
- owi-a-s--- / Owi-a-s--- — исходный том, во втором случае со слиянием снимка
Главная путаница: свободное место в ФС и запас снимка — это разные вещи
Самый частый сценарий, который я вижу у клиентов, выглядит так. Админ смотрит df -h, видит на разделе с базой 62 % занято и 400 ГБ свободных, и спокойно уходит запускать обновление. Логика понятная: места вагон, что может пойти не так. А снимок живёт этажом ниже — на уровне LVM, под файловой системой, и ему совершенно всё равно, сколько байт свободно внутри ext4 или XFS. Ему важно ровно одно: сколько блоков оригинала перезаписано с момента создания снимка.
Отсюда вылезают вещи, которые с непривычки выглядят контринтуитивно. Удаление 200 ГБ старых логов при живом снимке не освобождает место в снимке, а наоборот, немного его подъедает: файловая система переписывает метаданные, битовые карты, журнал — и каждый такой изменённый чанк уходит в exception store. Сам объём удалённых файлов при этом не копируется, но массовое удаление миллионов мелких файлов даёт вполне ощутимую запись в метаданные. Дефрагментация, VACUUM FULL, REINDEX, реструктуризация таблиц при обновлении конфигурации, пересборка индексов после миграции — всё это чистая запись, и вся она идёт в счётчик снимка. То есть попытка «освободить место в ФС, чтобы снимок не переполнился» ничего не даёт, а тяжёлые перестроения данных ускоряют его смерть.
Вторая часть путаницы — арифметическая. «Снимок 40 ГБ, значит, у меня есть 40 ГБ на откат» — так это не работает. У вас есть окно, в котором оригинал может измениться на 40 ГБ. Если процесс обновления перезаписывает 3 ГБ в минуту, окно составляет тринадцать минут, и совершенно неважно, база у вас 100 ГБ или 2 ТБ. Соответственно, считать надо не от размера тома, а от скорости и объёма записи конкретной операции, ради которой вы делаете снимок.
Третий источник неприятных сюрпризов — несколько снимков одного тома. Классические LVM-снимки не делят между собой exception store: у каждого свой. Два снимка на одном оригинале означают, что каждая запись копируется дважды, и расход места удваивается. Плюс к этому просаживается производительность: любая запись в оригинал превращается в чтение старого чанка, запись его в область снимка и только потом запись новых данных. На нагруженной СУБД под живым снимком это заметно, и на большом объёме отставания уже становится частью проблемы — операция идёт дольше, снимок живёт дольше, места надо больше.
- Реструктуризация и обновление конфигураций 1С — самый прожорливый сценарий
- VACUUM FULL, REINDEX, pg_repack, ALTER TABLE с перезаписью
- Массовое удаление мелких файлов и чистка логов (запись в метаданные ФС)
- Дефрагментация и перенос данных внутри ФС
- Ротация журналов и любая массовая запись, которую вы «не считали за нагрузку»
Как смотреть заполнение и не проспать момент
Заполнение обычного снимка видно в поле data_percent. Базовый набор команд, который я держу в шпаргалке и который стоит выполнить до, во время и после любой рискованной операции:
# состояние всех томов группы, с процентом заполнения снимков
lvs -o lv_name,vg_name,lv_attr,lv_size,data_percent,origin,lv_time vgdata

# только снимки и их заполнение — то, что вешают в мониторинг
lvs --noheadings --nosuffix -o lv_name,data_percent,origin

# низкоуровневое состояние: used/total в секторах, либо слово Invalid
dmsetup status /dev/vgdata/pgdata_snap

# живое наблюдение во время обновления
watch -n 30 'lvs -o lv_name,lv_attr,data_percent,origin --noheadings'
Отдельно — про lv_attr, потому что его читают неправильно чаще всего. Первый символ отвечает за тип тома: s — снимок, S — снимок в процессе слияния, o и O — исходный том. Пятый символ отвечает за состояние: a — активен, I — недействительный снимок, S — недействительный и приостановленный, m — слияние снимка не удалось, M — то же для приостановленного тома. То есть swi-a-s--- — это рабочий снимок, а swi-I-s--- — уже труп, даже если data_percent красиво показывает 100,00 и кажется, что «просто заполнился». Проверять надо именно attr, а не только процент.
Мониторинг тут не роскошь, а условие того, что вы вообще успеете что-то сделать. И порог алерта я ставлю на 50 %, а не на 90 %. Причина простая: путь от 50 к 100 при активном обновлении сервер проходит за считанные минуты, а вам надо успеть проверить свободные экстенты в VG, принять решение и выполнить lvextend. На 90 % вы уже никуда не успеете. Простейший UserParameter для Zabbix выглядит так:
# /etc/zabbix/zabbix_agent2.d/lvm_snapshot.conf
UserParameter=lvm.snap.pct[*],/sbin/lvs --noheadings --nosuffix -o data_percent $1 2>/dev/null | tr -d ' '
UserParameter=lvm.snap.attr[*],/sbin/lvs --noheadings -o lv_attr $1 2>/dev/null | tr -d ' '
Триггер вешаем на два условия сразу: data_percent больше 50 и пятый символ attr, равный I. Первое даёт время среагировать, второе фиксирует факт смерти снимка — чтобы вы узнали об этом не через два часа от пользователей, а сразу, и успели пересобрать план работ.
- lvs -o data_percent — процент заполнения exception store
- lvs -o lv_attr — пятый символ I означает invalid
- lvs -o seg_monitor — мониторит ли dmeventd конкретный том
- vgs -o vg_name,vg_free — есть ли чем расширять
- dmsetup status — сырое состояние, включая слово Invalid
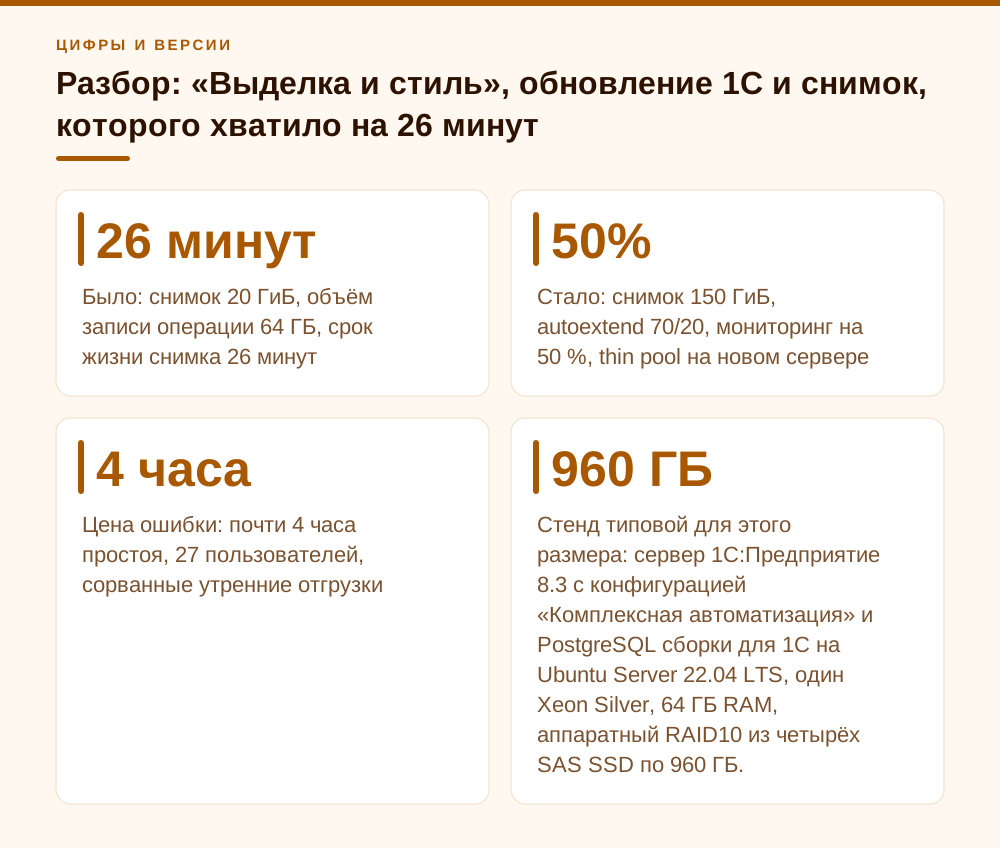
Разбор: «Выделка и стиль», обновление 1С и снимок, которого хватило на 26 минут
Кожевенное производство «Выделка и стиль», 27 рабочих мест: цех выделки, склад кожи и фурнитуры, офис с бухгалтерией и отделом продаж. К нам компания пришла уже после инцидента — разбирать, что произошло, и приводить хозяйство в порядок. Стенд типовой для этого размера: сервер 1С:Предприятие 8.3 с конфигурацией «Комплексная автоматизация» и PostgreSQL сборки для 1С на Ubuntu Server 22.04 LTS, один Xeon Silver, 64 ГБ RAM, аппаратный RAID10 из четырёх SAS SSD по 960 ГБ. Поверх — LVM: группа vgdata на 1,7 ТиБ, том pgdata на 800 ГиБ, база на диске 180 ГБ, свободных экстентов в группе — около 500 ГиБ. То есть места было с запасом, и это, как выяснилось, сыграло злую шутку: раз места много, никто не считал.
План работ был правильный по структуре: окно с 22:00 до 02:00, обновление конфигурации с реструктуризацией таблиц, откат — через снимок LVM. Приходящий админ перед стартом выполнил:
lvcreate -s -L 20G -n pgdata_snap /dev/vgdata/pgdataДвадцать гигабайт на базу в 180 ГБ. Логика — «примерно десять процентов, как в мануалах». В документации Red Hat действительно есть ориентир: 10–15 % для томов с небольшим темпом изменений и 30 % и больше для активно меняющихся. Вот только база в момент реструктуризации — это не «небольшое изменение данных», это самый интенсивный по записи режим, который вообще бывает у 1С.
Дальше по хронологии. Старт в 22:14. В 22:26 data_percent показывал 41 %. В 22:40 — 100 %, и в dmesg легла строка «device-mapper: snapshots: Invalidating snapshot: Unable to allocate exception». Снимок прожил 26 минут. Никто этого не заметил: мониторинга на data_percent не было, консоль с реструктуризацией смотрели, lvs — нет. Реструктуризация тем временем шла дальше и в 00:50 упала с ошибкой на одном из регистров накопления. Вот тогда админ и полез откатываться.
Попытка спасения выглядела ровно так, как её обычно и делают. Сначала lvextend -L +150G vgdata/pgdata_snap — размер увеличился, но снимок остался invalid: attr как был swi-I-s---, так и остался, а в dmsetup status по-прежнему значилось Invalid. Потом lvconvert --merge vgdata/pgdata_snap — отказ с сообщением о недействительном снимке. На это ушло сорок минут, которые можно было потратить на восстановление. Дальше оставался только ночной логический дамп.
Итог по цифрам: восстановление базы 180 ГБ из pg_dump заняло 2 часа 50 минут, повторный прогон обновления — ещё около полутора часов, склад и бухгалтерия вышли в работу в 11:40 следующего дня вместо 08:00. Почти четыре часа простоя на 27 человек, включая отгрузки со склада. Отдельно замечу: сам исходный том при этом не пострадал ни на байт — инвалидация снимка не портит оригинал. Потеряли не данные, потеряли возможность быстрого отката, и это обошлось в половину рабочего дня.
Что мы поменяли после разбора. Первым делом замерили реальный объём записи: повторный прогон реструктуризации на копии переписал 64 ГБ за 1 час 50 минут, пиковая скорость — около 1,2 ГБ/мин. То есть исходных 20 ГБ не хватило бы ни при каком раскладе, разрыв больше чем в три раза. Снимок под такие работы теперь делаем на 150 ГиБ — свободные экстенты в VG это позволяют. Включили автоматическое расширение с порогом 70 и шагом 20 %, проверили, что lvm2-monitor активен и том реально мониторится, поставили триггер в Zabbix на 50 %. И на новом сервере, который закупили следующим бюджетом, том под базу сразу сделали тонким в thin pool, чтобы снимки перестали требовать угадывания размера заранее.
- Было: снимок 20 ГиБ, объём записи операции 64 ГБ, срок жизни снимка 26 минут
- Стало: снимок 150 ГиБ, autoextend 70/20, мониторинг на 50 %, thin pool на новом сервере
- Цена ошибки: почти 4 часа простоя, 27 пользователей, сорванные утренние отгрузки
- Данные оригинала не пострадали — это важно понимать, чтобы не паниковать
Автоматическое расширение: lvm.conf, dmeventd и почему оно у половины не работает
LVM умеет сам расширять снимок при приближении к пределу. Настраивается это двумя параметрами в секции activation файла /etc/lvm/lvm.conf. В примере Red Hat порог 70 запускает попытку расширения при заполнении на 70 %, а параметр процента, равный 20, добавляет 20 % от текущего размера снимка. Значение порога 100 отключает автоматическое расширение — и именно оно стоит по умолчанию в upstream lvm2 (шаг по умолчанию — 20 %), дистрибутивы этот дефолт обычно не трогают. Минимальное осмысленное значение — 50; всё, что меньше, трактуется как 50.
# /etc/lvm/lvm.conf
activation {
    monitoring = 1
    snapshot_autoextend_threshold = 70
    snapshot_autoextend_percent = 20
}
# посмотреть значение по умолчанию и текущее
lvmconfig --type default activation/snapshot_autoextend_threshold
lvmconfig activation/snapshot_autoextend_threshold activation/snapshot_autoextend_percent
# переподключить мониторинг томов группы и проверить службы
vgchange --monitor y vgdata
systemctl status lvm2-monitor dm-event.socketТеперь о том, почему у половины админов это не срабатывает, хотя параметры прописаны. Причина первая: dmeventd не мониторит конкретный том. Настройка в lvm.conf — это только политика, а следит за томом демон событий, и он должен быть подключён именно к этому LV. Проверяется через lvs -o lv_name,seg_monitor, включается через lvchange --monitor y vgdata/pgdata_snap. Если в колонке пусто или not monitored — расширения не будет, сколько ни правь конфиг.
Причина вторая: в группе томов нет свободных экстентов. Автоматическое расширение не создаёт место из воздуха, оно берёт его из VG. Смотрим vgs -o vg_name,vg_size,vg_free. Если free равен нулю, dmeventd честно попробует, честно не сможет и напишет об этом в syslog — а вы этого не увидите, потому что грепа по «Unable to extend» в мониторинге, скорее всего, нет. Заведите его, это две минуты работы.
Причина третья, самая обидная: автоматическое расширение просто не успевает. Посчитайте на цифрах «Выделки и стиля». Снимок 20 ГБ, порог 70 % — это 14 ГБ, при скорости записи 1,2 ГБ/мин путь от порога до предела занимает пять минут. Шаг расширения 20 % — это всего 4 ГБ, ещё три с небольшим минуты. Один раз догонит, второй раз — если dmeventd не отработал мгновенно — уже нет. Поэтому скажу прямо, хоть это и спорная позиция: автоматическое расширение я считаю страховкой, а не заменой правильному размеру. На снимках под ночной бэкап, где запись предсказуема и невелика, оно отлично работает. На снимке под обновление СУБД полагаться на него в одиночку я бы не стал.
- lvmconfig --type default activation/snapshot_autoextend_threshold — проверить дефолт (обычно 100 = выключено)
- lvchange --monitor y vg/snap — подключить dmeventd к конкретному тому
- lvs -o lv_name,seg_monitor — убедиться, что монитор реально висит
- vgs -o vg_free — держать запас свободных экстентов в группе
- Грепать syslog на «Unable to extend» и «Invalidating snapshot»
Thin-снимки: чем лучше и чем опаснее
Тонкие тома снимают саму проблему угадывания размера. Снимок тонкого тома не требует заранее выделять область под исключения: блоки берутся из общего пула по мере записи, и отдельного «100 % заполнения снимка» с последующей инвалидацией просто не существует. Снимок делается без ключа -L и стоит по сути ноль до первой записи. Для сценария «снимок перед обновлением, откат за минуту» это принципиально удобнее.
# пул + тонкий том + снимок перед работами
lvcreate --type thin-pool -L 1.2T --poolmetadatasize 4G -n tp vgdata
lvcreate -V 800G -T vgdata/tp -n pgdata
lvcreate -s -n pgdata_pre_upgrade vgdata/pgdata

# тонкий снимок по умолчанию помечен skip activation — активировать с -K
lvchange -ay -K vgdata/pgdata_pre_upgrade

# контроль
lvs -o lv_name,lv_attr,data_percent,metadata_percent,lv_when_full vgdata
Но платить за удобство приходится другим риском, и он серьёзнее. Переполняется не снимок, а пул — и плохо становится сразу всем томам, которые в нём лежат. По умолчанию thin_pool_autoextend_threshold тоже равен 100, то есть автоматическое расширение пула выключено. Поведение при переполнении задаётся ключом --errorwhenfull, по умолчанию он равен n: записи ставятся в очередь в расчёте на скорое расширение пула, ждут около 60 секунд, и только потом начинают возвращаться ошибки ввода-вывода. Для базы данных эта минута очереди — уже инцидент.
activation {
    thin_pool_autoextend_threshold = 70
    thin_pool_autoextend_percent = 20
}
Отдельно про метаданные пула. metadata_percent надо мониторить наравне с data_percent, а по-хорошему — жёстче: по lvmthin(7) исчерпание метаданных может привести к несогласованным метаданным пула и повреждённым файловым системам, а лечение — это деактивация пула, lvconvert --repair, lvextend --poolmetadatasize и проверка ФС. Я закладываю метаданные с запасом сразу при создании пула и держу свободные экстенты в VG именно под аварийное расширение.
Где я на чём стою по итогу. Все новые серверы клиентов, где предполагаются регулярные обновления с откатом, поднимаю на thin pool — снимки там становятся штатным рабочим инструментом, а не разовым героическим мероприятием. Старые толстые тома ради красоты не переделываю: там достаточно нормально посчитанного толстого снимка, включённого мониторинга и понимания, что запас надо брать от объёма записи. Переделка живого продакшена ради «более правильной» схемы хранения — это отдельный риск, который надо обосновывать, а не делать по инерции.
- Толстый снимок: переполнение убивает только снимок, оригинал цел
- Тонкий снимок: переполнение пула бьёт по всем томам пула
- thin_pool_autoextend_threshold по умолчанию 100 — выключено
- --errorwhenfull по умолчанию n: очередь записей до 60 секунд, потом ошибки I/O
- metadata_percent мониторить обязательно, не только data_percent
- Тонкий снимок создаётся с флагом skip activation (k в десятом символе lv_attr) — для активации нужен -K
Порядок действий: до работ, во время и если снимок уже invalid
До работ. Замерьте объём записи операции — на тестовой копии, или по прошлому такому же обновлению, или хотя бы по /proc/diskstats за аналогичное окно. Возьмите двойной запас от замера; для баз данных под реструктуризацию я не опускаюсь ниже 30 % от размера тома, даже если замер обещает меньше. Проверьте vgs -o vg_free — расширять снимок будет нечем, если группа забита. Включите монитор через lvchange --monitor y. Поставьте наблюдение на data_percent с порогом 50. И держите независимый от снимка бэкап: снимок не является резервной копией, он лежит на тех же дисках и умирает вместе с массивом.
# сколько записано на устройство: поле «секторов записано» в /proc/diskstats
awk '/ dm-3 /{printf "%.1f GiB\n", $10*512/1024/1024/1024}' /proc/diskstats
# или наблюдение в реальном времени
iostat -dm 60 /dev/mapper/vgdata-pgdata
Во время работ. Не ждите порога 90 %. Увидели 60 % — расширяйте сразу, пока есть чем: lvextend -L +100G vgdata/pgdata_snap отрабатывает мгновенно и ничего не ломает. Если свободные экстенты в группе подходят к концу, а обновление ещё в середине — принимайте решение раньше, а не позже. Остановить процедуру контролируемо, пока откат ещё возможен, почти всегда дешевле, чем доводить её до конца без страховки и потом восстанавливаться из дампа.
Если снимок уже помечен как invalid. Не тратьте время на lvextend и lvconvert --merge: первое в лучшем случае добавит место, но не вернёт потерянные чанки и не снимет признак Invalid, второе откажется. Снимок надо просто удалить — он больше не выполняет никакой функции, только занимает экстенты и продолжает тормозить запись в оригинал:
lvs -o lv_name,lv_attr,data_percent,origin vgdata   # убедиться, что attr = swi-I-s---
umount /mnt/snap 2>/dev/null                        # если он был смонтирован
lvremove vgdata/pgdata_snap
И то, ради чего стоит выдохнуть. Исходный том при инвалидации снимка не повреждается. Данные на месте, файловая система в порядке, сервис жив. Вы потеряли план отката — неприятно, дорого по времени, но это не потеря данных. Не надо в панике перезагружать сервер, не надо пытаться «починить» снимок утилитами восстановления. Спокойно удаляете снимок, оцениваете, в каком состоянии осталось обновление, и выбираете: доводить вперёд или откатываться из бэкапа. Второе решение всегда принимается на трезвую голову и с калькулятором времени восстановления в руках, а не в час ночи наугад.
Если совсем коротко, на что забить и на что нет. Забить можно на тонкую настройку размера чанка, на выбор между 10 и 15 процентами в мануальных рекомендациях и на переделку старых толстых томов в тонкие. Не забивать нельзя на трёх вещах: реальный замер объёма записи, мониторинг data_percent с низким порогом и наличие бэкапа, который не зависит от снимка. Этих трёх пунктов достаточно, чтобы история «Выделки и стиля» у вас не повторилась.
- Замерить объём записи операции и взять двойной запас
- Проверить свободные экстенты: vgs -o vg_free
- lvchange --monitor y и autoextend 70/20 как страховка
- Алерт на data_percent > 50 и на lv_attr с буквой I
- Независимый бэкап — обязательно, снимок его не заменяет
- Invalid-снимок — только lvremove, ничего больше
Частые вопросы
Можно ли восстановить снимок LVM, который стал invalid?
Нет. В момент, когда область исключений заполнилась, ядро пропустило запись в оригинал, не сохранив старый чанк. Эти данные потеряны, поэтому снимок больше не представляет согласованное состояние на момент создания. Даже если lvextend добавит место, признак Invalid он не снимет, а lvconvert --merge откажется сливать недействительный снимок («Unable to merge invalidated snapshot LV»). Единственное правильное действие — lvremove.
Пострадает ли исходный том, если снимок переполнился?
Нет, исходный логический том остаётся целым. Инвалидация касается только снимка. Вы теряете возможность отката, но данные, файловая система и работающий сервис не повреждаются. Перезагружать сервер в панике не нужно — достаточно удалить мёртвый снимок и спокойно решить, доводить обновление вперёд или восстанавливаться из бэкапа.
Какого размера делать снимок перед обновлением базы?
Считайте не от размера тома, а от объёма записи, который породит сама операция, и берите двойной запас. Документация Red Hat ориентирует на 10–15 % для томов с низким темпом изменений и 30 % и больше для активных. Для реструктуризации 1С или тяжёлой миграции СУБД я закладываю не менее 30 % размера тома, а перед этим замеряю реальную запись на тестовом прогоне через /proc/diskstats или iostat.
Почему не срабатывает snapshot_autoextend_threshold, хотя он прописан в lvm.conf?
Три типовые причины. Первая — dmeventd не мониторит конкретный том: проверьте lvs -o lv_name,seg_monitor и включите lvchange --monitor y. Вторая — в группе томов нет свободных экстентов, расширять просто нечем: смотрите vgs -o vg_free. Третья — расширение физически не успевает за скоростью записи: шаг в 20 % от маленького снимка при 3 ГБ/мин выигрывает всего несколько минут.
Тонкие снимки надёжнее обычных?
Для сценария отката — удобнее, потому что не требуют угадывать размер заранее и не инвалидируются по отдельности. Но риск смещается на пул: при его переполнении плохо становится всем томам сразу, автоматическое расширение пула по умолчанию выключено (порог 100), а --errorwhenfull по умолчанию n даёт очередь записей примерно на 60 секунд, после чего идут ошибки ввода-вывода. И не забудьте, что тонкий снимок по умолчанию не активируется без ключа -K. Мониторить надо и data_percent, и metadata_percent пула.
Снимок LVM можно считать резервной копией?
Нет. Снимок лежит на тех же физических дисках, зависит от исходного тома и исчезает вместе с группой томов при отказе массива. Это инструмент быстрого отката в рамках короткого окна работ, а не резервное копирование. Полноценный бэкап должен быть независимым: отдельное хранилище, проверенное восстановление, известное время развёртывания.
Источники
- Red Hat Enterprise Linux 8 — Configuring and managing logical volumes — Глава 5 «Advanced logical volume management», разделы про thick LV snapshots: инвалидация при 100 %, lvextend, lvs -o lv_name,data_percent,origin, snapshot_autoextend_threshold=70 и snapshot_autoextend_percent=20, lvconvert --merge. https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/8/html/configuring_and_managing_logical_volumes/advanced-logical-volume-management_configuring-and-managing-logical-volumes
- Linux kernel documentation — Device-mapper snapshot support — Admin guide, device-mapper/snapshot: цель snapshot хранит изменённые чанки в COW device «at least until the COW device fills up», формат статуса <sectors_allocated>/<total_sectors>. https://docs.kernel.org/admin-guide/device-mapper/snapshot.html
- lvcreate(8), man-страница lvm2 — Опция -c|--chunksize: для снимков — степень двойки от 4 КиБ до 512 КиБ, по умолчанию 4 КиБ. Синтаксис lvcreate --snapshot --size --name. https://man7.org/linux/man-pages/man8/lvcreate.8.html
- lvs(8), man-страница lvm2 — Расшифровка lv_attr: бит 1 — (o)rigin, (O)rigin with merging snapshot, (s)napshot, merging (S)napshot; бит 5 — (a)ctive, (I)nvalid snapshot, invalid (S)uspended snapshot, snapshot (m)erge failed. https://man7.org/linux/man-pages/man8/lvs.8.html
- lvm.conf(5) и example.conf из исходников lvm2 — activation/snapshot_autoextend_threshold (по умолчанию 100 — автоматическое расширение выключено), snapshot_autoextend_percent (по умолчанию 20), thin_pool_autoextend_threshold (100), monitoring (1); просмотр через lvmconfig --type default. https://man7.org/linux/man-pages/man5/lvm.conf.5.html и https://github.com/lvmteam/lvm2/blob/main/conf/example.conf.in
- lvmthin(7) — LVM thin provisioning — thin_pool_autoextend_threshold (100 отключает автоматическое расширение, минимум 50), --errorwhenfull n с очередью записей до 60 секунд, флаг skip activation у тонких снимков и ключ -K, восстановление после исчерпания метаданных через lvconvert --repair. https://man7.org/linux/man-pages/man7/lvmthin.7.html
- Исходный код lvm2 — tools/lvconvert.c — Сообщение «Unable to merge invalidated snapshot LV %s.» при попытке lvconvert --merge для недействительного снимка. https://github.com/lvmteam/lvm2/blob/main/tools/lvconvert.c
- Исходный код ядра Linux — drivers/md/dm-snap.c — DM_MSG_PREFIX "snapshots", сообщение «Invalidating snapshot: Unable to allocate exception.» и строка статуса «Invalid» для недействительного снимка. https://github.com/torvalds/linux/blob/master/drivers/md/dm-snap.c