
Как вывести старый диск из LVM без размонтирования томов
`pvmove` остановился на 40 %, терминал закрылся, а сервер продолжает работать. Главный вопрос в этот момент не «как снова запустить команду», а «на каком диске теперь лежат данные». Я, Семёнов Евгений Сергеевич, обычно отвечаю коротко: пока исходный PV не удалён из VG командой `vgreduce`, отключать его нельзя. Ни процент выполнения, ни наличие копии на новом диске этого разрешения не дают. Ниже покажу, как LVM переживает прерывание и перезагрузку, что делать, если диск действительно отказал (`vgreduce --removemissing`, `vgcfgrestore` и архив метаданных в `/etc/lvm/archive`), как увидеть реальное размещение экстентов и закончить перенос без размонтирования рабочих томов.
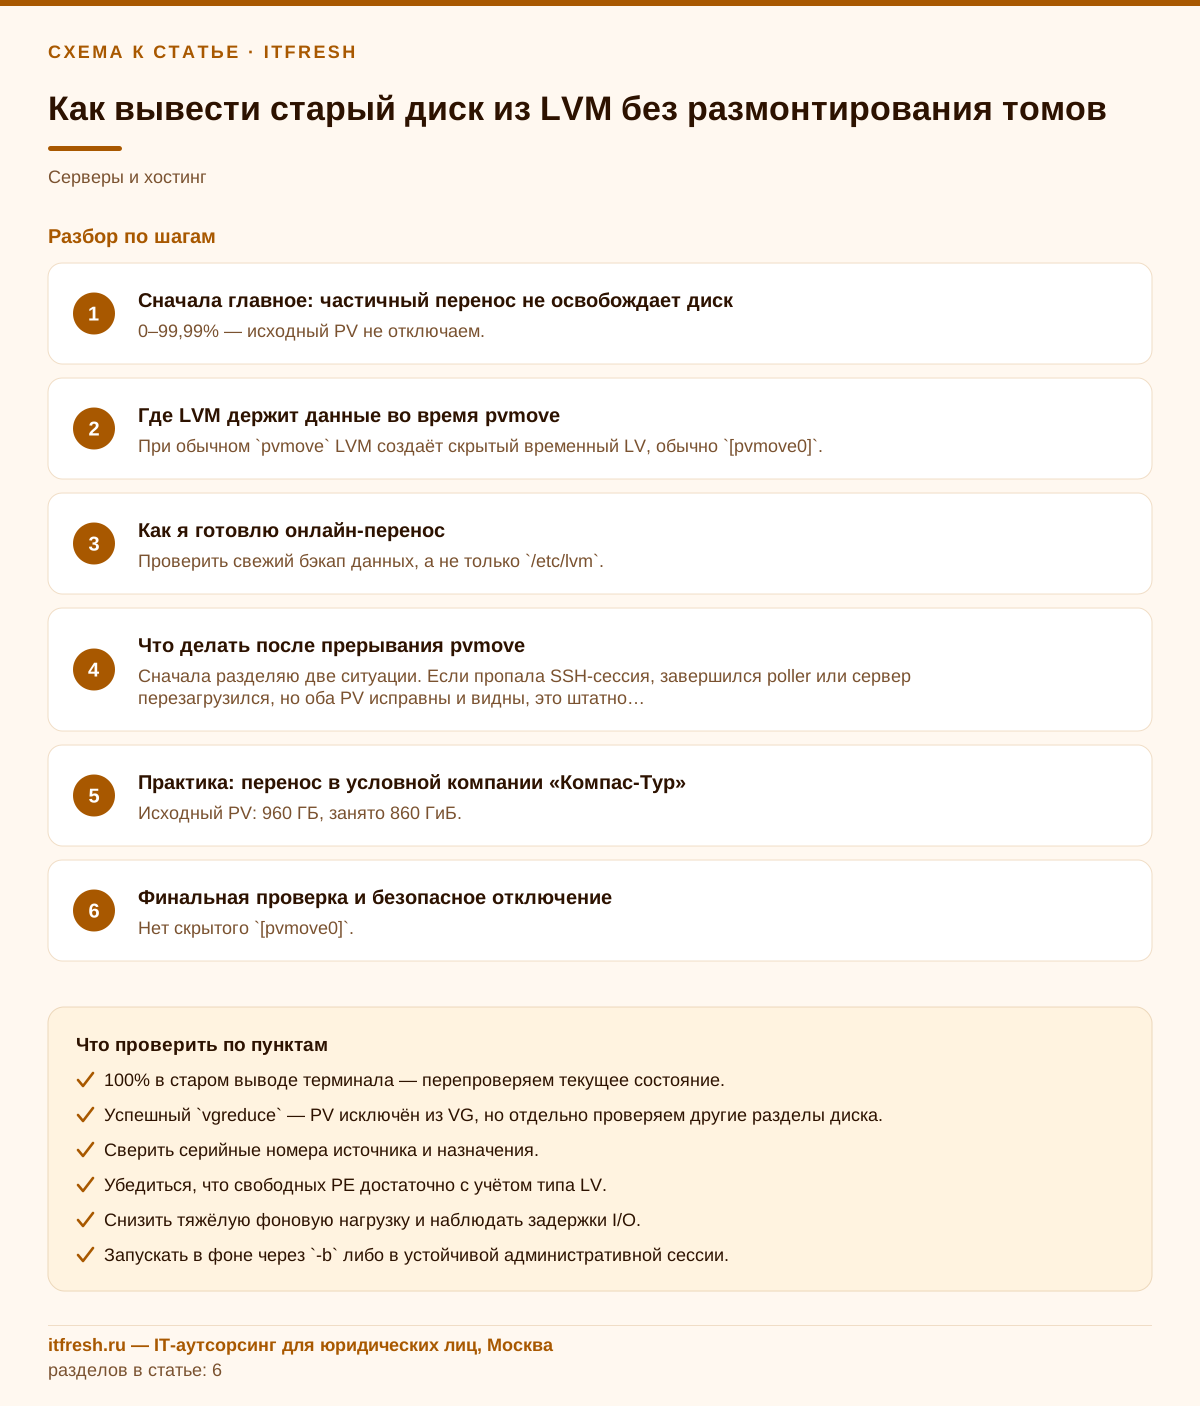
Сначала главное: частичный перенос не освобождает диск
Если pvmove прервался, это ещё не авария с данными. LVM переносит не файлы, а физические экстенты — PE, из которых собраны сегменты логических томов. Уже завершённые сегменты могут находиться на новом PV, ещё не обработанные — на старом, а текущий сегмент может быть подключён через временное зеркало. Файловая система при этом видит тот же LV и продолжает читать и записывать данные через device-mapper. Именно поэтому обычные линейные тома можно переносить онлайн, не останавливая пользователей и не размонтируя файловые системы.
Но старый диск после частичного переноса остаётся частью действующей схемы. Даже если утилита показала 99,9 %, последний незавершённый сегмент всё ещё может от него зависеть. Отключение такого PV превращает штатно восстанавливаемую операцию в работу с отсутствующим устройством. В лучшем случае часть LV станет недоступна. В худшем администратор затем выполнит vgreduce --removemissing --force и сам удалит из метаданных тома, которым не хватает экстентов.
Мой критерий готовности жёсткий: скрытый LV pvmove отсутствует, значение PUsed исходного PV равно нулю, а vgreduce успешно исключил PV из группы. Только сочетание этих трёх признаков означает, что VG больше не ссылается на старый диск. До этого момента кабель, виртуальный диск или LUN не трогаю.
- 0–99,99 % — исходный PV не отключаем.
- 100 % в старом выводе терминала — перепроверяем текущее состояние.
- Успешный `vgreduce` — PV исключён из VG, но отдельно проверяем другие разделы диска.
Где LVM держит данные во время pvmove
При обычном pvmove LVM создаёт скрытый временный LV, обычно [pvmove0]. Для перемещаемого сегмента строится временное зеркало: одна сторона указывает на исходные экстенты, другая — на выделенное место назначения. После синхронизации LVM разрывает зеркало в пользу нового размещения и записывает контрольную точку в метаданные VG. Затем переходит к следующему сегменту. После завершения последнего сегмента временный LV удаляется.
Отсюда точный ответ на вопрос о частичном переносе. Сегменты до последней записанной контрольной точки уже закреплены на целевом PV. Не начатые сегменты остаются на исходном PV. Текущий сегмент обслуживается временной зеркальной картой, и самостоятельно выбирать «правильную копию» на дисках нельзя. Метаданные VG и активная таблица device-mapper являются источником истины.
Один pvs во время операции может сбить с толку: место назначения резервируется заранее, а освобождение исходных экстентов идёт по контрольным точкам. Сумма PUsed временно может выглядеть больше размера пользовательских LV. Я смотрю одновременно PV, скрытые LV и их сегменты:
pvs --units g -o pv_name,pv_uuid,vg_name,pv_size,pv_used,pv_free,pv_attr
lvs -a --segments -o vg_name,lv_name,lv_attr,lv_size,segtype,copy_percent,devices
pvs --segments -o pv_name,pvseg_start,pvseg_size,lv_name,segtype
Строка [pvmove0], атрибут типа p и две стороны в колонке Devices означают, что операция ещё существует, даже если процесса с привычной командной строкой уже нет.
- `lvs -a` показывает скрытый `[pvmove0]` — операция не завершена, оба PV обязательны.
- Первый символ `lv_attr` у временного тома — `p` (pvmove).
- `copy_percent` у `[pvmove0]` — прогресс текущей операции, а не доля данных, которые уже можно не хранить на источнике.
- Колонка `devices` у пользовательских LV показывает, какие сегменты уже переадресованы на `[pvmove0]`.
- `pvs --segments` на источнике — где именно остались используемые экстенты.
Как я готовлю онлайн-перенос
Сначала фиксирую идентичность устройств. Имена /dev/sdb и /dev/sdc могут поменяться после перезагрузки, поэтому сверяю модель, серийный номер, WWN, разделы и точки монтирования. На SAN работаю с multipath-устройством, а не с отдельной дорожкой /dev/sd*. Заодно проверяю, нет ли на выводимом диске EFI-раздела, /boot, swap, mdraid или обычной файловой системы вне LVM: pvmove их не переносит.
lsblk -e7 -o NAME,PATH,SIZE,TYPE,FSTYPE,MOUNTPOINTS,MODEL,SERIAL,WWN
findmnt -o TARGET,SOURCE,FSTYPE,OPTIONS
pvs -o pv_name,pv_uuid,vg_name,pv_size,pv_used,pv_free
lvs -a -o vg_name,lv_name,lv_attr,segtype,devices
Ошибка, которую вижу из раза в раз: администратор освобождает PV, но после его отключения сервер не загружается, потому что EFI System Partition находился на том же физическом диске.
Далее проверяю свободные экстенты и типы LV. Для простого линейного тома целевому PV нужно не меньше места, чем занято на источнике. У striped, RAID, cache, thin pool и VDO есть дополнительные внутренние устройства и ограничения размещения — там я не запускаю перенос по универсальной памятке, пока не изучу вывод lvs -a --segments. Если исходный накопитель сыпет I/O errors, сначала решаю вопрос с резервной копией или блочным клоном: многочасовое чтение через pvmove способно добить деградирующий диск.
Перед изменениями сохраняю метаданные и проверяю восстановление данных. vgcfgbackup не копирует содержимое LV — это всего лишь описание VG. Новый PV создаю только после повторной проверки пути устройства:
vgcfgbackup vg_data
pvcreate /dev/sdc1
vgextend vg_data /dev/sdc1
pvmove -b /dev/sdb1 /dev/sdc1
Для вывода старого диска я выбираю обычный, неатомарный режим: завершённая работа не пропадает при осознанном --abort. --atomic оставляю для ситуации, где нужен принцип «перенести всё или после отмены оставить всё на источнике». От поломки диска этот флаг не защищает.
- Проверить свежий бэкап данных, а не только `/etc/lvm`.
- Сверить серийные номера источника и назначения.
- Убедиться, что свободных PE достаточно с учётом типа LV.
- Снизить тяжёлую фоновую нагрузку и наблюдать задержки I/O.
- Запускать в фоне через `-b` либо в устойчивой административной сессии.
Что делать после прерывания pvmove
Сначала разделяю две ситуации. Если пропала SSH-сессия, завершился poller или сервер перезагрузился, но оба PV исправны и видны, это штатно возобновляемое прерывание. Если физически исчез исходный либо целевой диск, это уже отказ хранилища. Команда возобновления не материализует отсутствующие экстенты. Сначала возвращаем устройство, восстанавливаем multipath или устраняем ошибку контроллера.
После загрузки я ничего не отменяю вслепую. Проверяю наличие обоих PV, состояние VG, временный LV и сообщения ядра:
pvs -o pv_name,pv_uuid,vg_name,pv_attr,pv_used,pv_free
vgs -o vg_name,vg_attr,pv_count,lv_count,vg_size,vg_free
lvs -a --segments -o lv_name,lv_attr,segtype,copy_percent,devices vg_data
journalctl -k -b --no-pager | tail -n 100
Если в выводе есть unknown device, missing или ошибки чтения, я останавливаюсь на диагностике железа. Особенно опасна попытка «починить метаданные» через vgreduce --removemissing --force: эта команда удаляет логические тома, использовавшие потерянный PV, а не восстанавливает их.
Когда оба устройства доступны и [pvmove0] виден, сначала смотрю, не продолжился ли перенос сам. По man vgchange незавершённое преобразование, прерванное перезагрузкой или сбоем, перезапускается от последней контрольной точки при активации VG с --poll y, поэтому на многих системах после загрузки copy_percent снова начинает расти без вмешательства. Если значение стоит на месте, штатное продолжение запускается командой pvmove без аргументов PV — man pvmove так и описывает перезапуск операций, которые были в процессе. Это важно: не надо повторять исходную команду с /dev/sdb1 /dev/sdc1 и тем самым пытаться организовать ещё один перенос.
pvmove -b
watch -n 10 'lvs -a -o lv_name,lv_attr,copy_percent,devices vg_data'
LVM продолжит незавершённую операцию от последней сохранённой контрольной точки. Текущий недокопированный сегмент может синхронизироваться заново — это ожидаемо и не означает, что весь перенос начался с нуля.
Если перенос нужно прекратить, сначала обеспечиваю доступность обоих дисков и только затем выполняю:
pvmove --abort
lvs -a --segments -o lv_name,lv_attr,segtype,devices vg_data
pvs -o pv_name,vg_name,pv_used,pv_free
В обычном неатомарном режиме завершённые сегменты останутся на назначении, а неперенесённые — на источнике. Следовательно, исходный диск после отмены почти наверняка всё ещё нужен. Если операция изначально запускалась с --atomic, после отмены затронутые LV остаются на источнике. Это полезное различие, но решение об отключении всё равно принимается по фактическому размещению.
- Оба PV видны в `pvs` без `unknown device` и `missing` — только тогда возобновляем или отменяем.
- `copy_percent` у `[pvmove0]` растёт сам — повторно ничего не запускаем.
- Не растёт — `pvmove -b` без путей к PV.
- Нужно остановить — `pvmove --abort`, затем снова смотрим сегменты: без `--atomic` данные будут на обоих дисках.
- Одно из устройств пропало — никаких `pvmove`, `vgreduce` и `vgcfgrestore` до выяснения причины.
Практика: перенос в условной компании «ЭкоГрад»
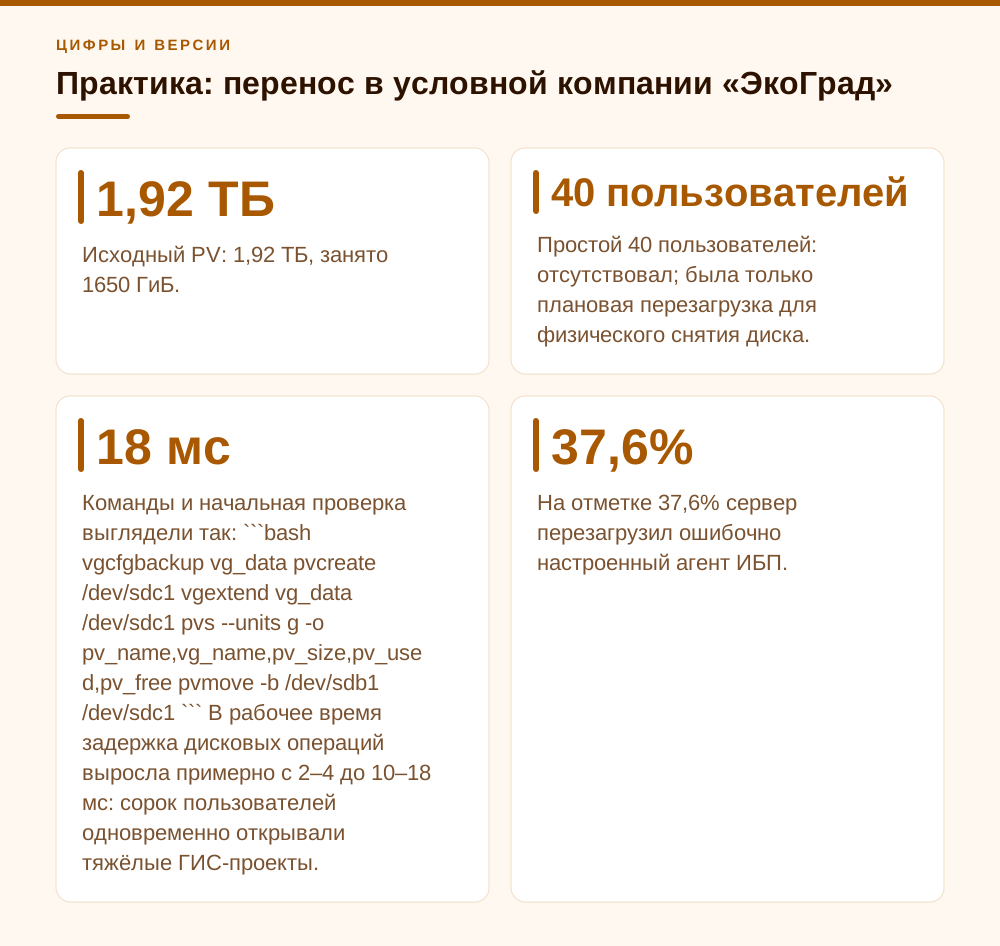
Приведу обезличенный проект; «ЭкоГрад» — условное название. У компании экологического консультирования было 40 рабочих мест и один сервер Ubuntu Server 24.04 LTS с ядром 6.8 и пакетом LVM2 2.03.16-3ubuntu3.2. На SATA SSD 1,92 ТБ располагался PV /dev/sdb1 группы vg_data: lv_files 1100 ГиБ с XFS (проекты ОВОС, результаты замеров, ГИС-слои и сканы заключений), lv_pgsql 300 ГиБ с ext4 под базу лабораторных данных и lv_archive 250 ГиБ с XFS. Занято было 1650 ГиБ из примерно 1788 доступных. Цель — перейти на enterprise SSD 3,84 ТБ /dev/sdc1, не останавливая файловые ресурсы и PostgreSQL.
После проверки резервной копии мы создали PV, добавили его в vg_data и запустили обычный неатомарный перенос. PE в группе имел стандартный для этого стенда размер 4 МиБ. Команды и начальная проверка выглядели так:
vgcfgbackup vg_data
pvcreate /dev/sdc1
vgextend vg_data /dev/sdc1
pvs --units g -o pv_name,vg_name,pv_size,pv_used,pv_free
pvmove -b /dev/sdb1 /dev/sdc1
В рабочее время задержка дисковых операций выросла примерно с 2–4 до 10–18 мс: сорок пользователей одновременно открывали тяжёлые ГИС-проекты. Поэтому ночную выгрузку архива и пересчёт отчётов перенесли, а сам перенос не останавливали. Пользователей не отключали, файловые системы не размонтировали.
На отметке 37,6 % сервер перезагрузил ошибочно настроенный агент ИБП. После загрузки приложения поднялись, но [pvmove0] остался в lvs -a. На новом PV уже было зарезервировано место, а на старом сохранялись используемые экстенты. Это тот момент, когда легко решить, будто данные «уже скопированы на новый SSD». Нет: таблица сегментов показывала обе стороны временного зеркала, поэтому оба устройства были обязательны. Мы проверили журнал на I/O errors, пять минут понаблюдали за copy_percent — после загрузки он не рос — и продолжили именно pvmove -b без путей к PV.
Возобновлённый перенос занял 2 часа 50 минут; суммарное время активного копирования составило около 4 часов 30 минут. После завершения [pvmove0] исчез, а /dev/sdb1 показал PUsed 0. Мы выполнили vgck vg_data, исключили старый PV через vgreduce, перезагрузили сервер в согласованное окно и только тогда физически сняли диск. XFS и ext4 оставались смонтированными весь перенос. Контрольные выгрузки базы лабораторных данных, выборочная сверка файлов и суточный мониторинг ошибок расхождений не обнаружили.
- Исходный PV: 1,92 ТБ, занято 1650 ГиБ.
- Целевой PV: 3,84 ТБ.
- Прерывание: перезагрузка на 37,6 %, автоматического продолжения не было.
- Простой 40 пользователей: отсутствовал; была только плановая перезагрузка для физического снятия диска.
- Результат: исходный PV исключён из VG, данные и сервисы остались доступны.
Если диск отказал: vgreduce --removemissing и vgcfgrestore
Бывает, что исходный или целевой диск действительно умер посреди переноса. Тогда pvs показывает unknown device, у VG появляется флаг частичности, а часть LV не активируется. Первое, что я делаю, — копирую /etc/lvm/backup и /etc/lvm/archive в безопасное место и сохраняю вывод диагностики. В архиве лежат автоматические копии метаданных до каждого изменения VG, в том числе до vgextend и pvmove; список для конкретной группы даёт vgcfgrestore --list:
cp -a /etc/lvm/archive /etc/lvm/backup /root/lvm-meta-$(date +%F)/
vgcfgrestore --list vg_data
pvs -o pv_name,pv_uuid,vg_name,pv_attr
lvs -a -o lv_name,lv_attr,devices vg_data
Из файла архива по разделу physical_volumes видно UUID пропавшего PV. Это пригодится, если диск удастся вернуть или заменить устройством с той же подписью.
Команда vgreduce --removemissing vg_data без --force удаляет из группы только те отсутствующие PV, на которых не размещено ни одного LV. Если тома на пропавшем диске есть, man vgreduce прямо предупреждает: с --force будут полностью удалены все LV и зависимые снапшоты, частично лежавшие на отсутствующих дисках, включая их части на исправных устройствах. Поэтому сначала запускаю пробный прогон, как в документации Red Hat, и читаю, что именно LVM собирается удалить:
vgchange --activate y --partial vg_data
vgreduce --removemissing --test vg_data
Невредимые тома после частичной активации копирую на отдельный носитель. Только когда нужные данные спасены или есть проверенный бэкап, принимаю решение о vgreduce --removemissing --force.
Если метаданные повреждены, а сам диск физически цел (или его заменили клоном), помогает vgcfgrestore. PV с прежним UUID создаётся из архивного файла, затем восстанавливается описание группы:
pvcreate --uuid <UUID-из-архива> --restorefile /etc/lvm/archive/vg_data_00012-1234567890.vg /dev/sdb1
vgcfgrestore -f /etc/lvm/archive/vg_data_00012-1234567890.vg vg_data
vgchange -ay vg_data
Эта процедура перезаписывает только области метаданных LVM, а не данные. Red Hat отдельно предупреждает не выполнять её на работающем томе: неверный UUID означает потерю данных. Для групп с thin pool vgcfgrestore требует --force, и изменения тонких метаданных откатить уже нельзя.
Главная ловушка с архивом при прерванном переносе — выбор версии метаданных. Файл, сохранённый до pvmove, указывает все сегменты на старый диск. Но после контрольных точек новые записи файловой системы шли уже на целевой PV, и возврат к старому описанию подсунет LV устаревшие экстенты. Поэтому при отказе посреди pvmove я беру самую свежую копию, сверяю её с фактическим набором устройств и лучше потрачу время на восстановление из резервной копии, чем рискну смонтировать том со смесью старых и новых блоков.
- Сначала скопировать `/etc/lvm/archive` и `/etc/lvm/backup`, потом что-то менять.
- `vgcfgrestore --list VG` — только просмотр, ничего не восстанавливает.
- `vgreduce --removemissing` без `--force` безопасен: удаляет лишь пустые отсутствующие PV.
- Перед `--force` — `--test` и копия всех томов, которые удалось активировать с `--partial`.
- `pvcreate --uuid --restorefile` — только на заменяющем устройстве, никогда на рабочем PV.
Финальная проверка и безопасное отключение
После сообщения о 100 % я выполняю контроль заново, в новой оболочке. Старый вывод терминала доказательством не считается:
lvs -a --segments -o lv_name,lv_attr,segtype,copy_percent,devices vg_data
pvs --units g -o pv_name,pv_uuid,vg_name,pv_used,pv_free /dev/sdb1
vgck vg_data
vgreduce vg_data /dev/sdb1
pvs -o pv_name,pv_uuid,vg_name,pv_used,pv_free /dev/sdb1
Ожидаю отсутствие [pvmove0], нулевой PUsed до удаления и пустое поле VG после успешного vgreduce. Если vgreduce сообщает, что PV ещё используется, не добавляю --force, а возвращаюсь к lvs -a --segments и ищу оставшийся внутренний или пользовательский сегмент.
pvremove /dev/sdb1 нужен только если диск будет повторно использоваться и LVM-подпись следует стереть. Для простого физического снятия после vgreduce он не обязателен. Горячее удаление выполняю средствами конкретного контроллера, гипервизора или SAN. Универсальная запись в sysfs здесь опасна: легко удалить не тот SCSI-путь или единственную дорожку multipath-устройства.
Перед выключением ещё раз просматриваю lsblk, findmnt, /etc/fstab, конфигурацию загрузчика и EFI-записи. LVM может быть полностью освобождён, но отдельный раздел старого диска всё ещё нужен при старте системы. Если hot-swap не отработан на этом железе, я не геройствую и назначаю короткое выключение. Размонтировать LV для самого pvmove не требовалось; безопасно обесточить корзину — другая задача.
После удаления проверяю активацию VG, монтирование файловых систем, состояние приложений и журнал ядра. Вот на что действительно стоит потратить время. На попытки вычислить безопасность по проценту pvmove можно забить: процент показывает ход копирования, но не является разрешением на демонтаж.
- Нет скрытого `[pvmove0]`.
- Исходный PV имеет `PUsed 0`.
- `vgreduce` завершился успешно.
- На диске нет нужных разделов вне LVM.
- Способ hot-remove поддерживается платформой либо сервер корректно выключен.
Частые вопросы
Можно ли отключить исходный диск, если pvmove дошёл до 99,9 %?
Нет. Последний сегмент может всё ещё обслуживаться с исходного PV. Ждите завершения, проверьте отсутствие `[pvmove0]`, убедитесь в `PUsed 0` и выполните `vgreduce`.
Как продолжить pvmove после перезагрузки?
Сначала проверьте, не продолжился ли перенос сам: при активации VG с `--poll y` незавершённый `pvmove` возобновляется от последней контрольной точки. Если `copy_percent` у `[pvmove0]` не растёт, а оба PV доступны, выполните `pvmove -b` без путей к источнику и назначению.
Вернёт ли pvmove --abort все данные на старый диск?
Только если операция изначально запускалась с `--atomic`. В обычном режиме уже перенесённые сегменты останутся на назначении, а остальные — на источнике.
Нужно ли размонтировать файловые системы?
Для штатного переноса простых активных LV не нужно: `pvmove` работает на уровне device-mapper. Но это не отменяет резервную копию, контроль производительности и отдельную проверку загрузочных разделов.
Что делать, если один из дисков пропал во время переноса?
Сначала вернуть устройство или восстановить доступ к LUN и multipath. Не применять `vgreduce --removemissing --force`: эта команда может удалить из метаданных зависимые LV. Если устройство физически погибло, переходите к восстановлению из резервной копии.
Можно ли откатить неудачный pvmove через vgcfgrestore из /etc/lvm/archive?
Штатный откат — `pvmove --abort`, а не восстановление метаданных. Архив до переноса указывает все сегменты на старый диск, хотя часть новых записей уже ушла на целевой PV, поэтому такой откат может дать устаревшие данные. `vgcfgrestore` применяют при повреждённых метаданных или замене PV с тем же UUID (`pvcreate --uuid --restorefile`), выбирая самую свежую подходящую копию.
Достаточно ли vgcfgbackup перед переносом?
Нет. `vgcfgbackup` сохраняет только метаданные группы томов. Пользовательские данные, файловые системы и базы данных он не резервирует.
Источники
- LVM2 pvmove(8) — Upstream manual page, LVM TOOLS 2.03.42: временный pvmove LV и зеркало, контрольные точки, перезапуск командой pvmove без PV-аргументов, --abort с --atomic и без. https://man7.org/linux/man-pages/man8/pvmove.8.html
- LVM2 vgreduce(8) — Upstream manual page, LVM TOOLS 2.03.42: --removemissing, --force и предупреждение об удалении частичных LV. https://man7.org/linux/man-pages/man8/vgreduce.8.html
- LVM2 vgcfgrestore(8) — Upstream manual page: --list, --file, --force для thin pool, замена PV через pvcreate --restorefile --uuid. https://man7.org/linux/man-pages/man8/vgcfgrestore.8.html
- LVM2 vgchange(8) — Опция --poll: перезапуск прерванного перезагрузкой pvmove от последней контрольной точки при активации. https://man7.org/linux/man-pages/man8/vgchange.8.html
- Red Hat Enterprise Linux 9: Configuring and managing logical volumes — Раздел 3.6 Removing physical volumes from a volume group (pvmove, vgreduce). https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/9/html/configuring_and_managing_logical_volumes/managing-lvm-volume-groups_configuring-and-managing-logical-volumes
- Red Hat Enterprise Linux 9: Troubleshooting LVM — Разделы 13.3 Removing lost LVM physical volumes from a volume group, 13.4 Finding the metadata of a missing LVM physical volume (/etc/lvm/archive), 13.5 Restoring metadata on an LVM physical volume. https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/9/html/configuring_and_managing_logical_volumes/troubleshooting-lvm_configuring-and-managing-logical-volumes
- LVM2 WHATS_NEW и config_settings.h — Официальный репозиторий LVM team: allocation/pvmove_max_segment_size_mb добавлен в 2.03.36. https://gitlab.com/lvmteam/lvm2/-/raw/main/WHATS_NEW
- Ubuntu lvm2 package (Launchpad) — Noble: release 2.03.16-3ubuntu3, updates 2.03.16-3ubuntu3.2. https://launchpad.net/ubuntu/+source/lvm2
- LVM2 vgcfgbackup(8) — Upstream manual page: резервирование метаданных VG, содержимое LV не копируется. https://man7.org/linux/man-pages/man8/vgcfgbackup.8.html