
Как я проектирую LVM на Linux-сервере небольшой компании, чтобы место не кончалось внезапно
LVM нужен не ради красивой схемы, а чтобы расширять рабочие тома без ночного копирования сотен гигабайт. Главное в нём — правильная раскладка с первого дня: RAID под низом, отдельные тома под разные данные и 15–20 % резерва в группе. Ниже схема, команды и кейс архитектурного бюро с расширением без простоя.
Что даёт LVM и чего он не умеет
Когда я принимаю Linux-сервер на обслуживание, первым делом смотрю, как размечены диски. Если диск разбит обычными разделами, границы между ними быстро становятся проблемой. На разделе с системой свободно 50 ГБ, раздел с документами переполнен, но передать ему место без перемещения разделов трудно. LVM добавляет промежуточный слой. Физический диск, раздел, RAID-массив или виртуальный диск становится physical volume, PV. Один или несколько PV объединяются в volume group, VG. Из общего пространства нарезаются logical volumes, LV, на которых уже размещаются XFS, ext4, swap или данные приложения. По умолчанию пространство распределяется экстентами по 4 МиБ, но в обычной инфраструктуре это знать достаточно на уровне принципа.
Практический смысл простой: LV можно увеличить за счёт свободных экстентов VG. Если свободного места в группе уже нет, я расширяю виртуальный диск либо добавляю новый защищённый носитель, включаю его в VG и только затем увеличиваю нужный том. Приложение продолжает обращаться к прежнему пути, например /srv/projects. Для растущей файловой базы это гораздо спокойнее, чем передвигать границы GPT-разделов на работающем сервере.
Но LVM не создаёт отказоустойчивость сам по себе. Линейный LV, растянутый на два одиночных SSD, зависит сразу от обоих: отказ одного носителя может повредить часть тома и всю файловую систему. LVM также не заменяет резервную копию и не предсказывает рост данных. Я ставлю его поверх аппаратного RAID, mdraid, защищённого хранилища гипервизора или другого слоя с понятной избыточностью. Для одного маленького системного диска, который никогда не будут расширять, LVM иногда вообще не нужен — дополнительный слой должен решать задачу, а не украшать схему. И ещё одно: LVM не шифрует данные. Если на томе лежат проекты с персональными данными заказчиков или сервер стоит не в охраняемой серверной, поверх LV я кладу LUKS — как это сделать, я показывал в статье про шифрование дисков LUKS.
- PV — физический носитель пространства: диск, раздел, RAID-устройство или виртуальный диск.
- VG — общий пул пространства из одного или нескольких PV.
- LV — блочное устройство нужного размера, создаваемое внутри VG.
- Файловая система — отдельный слой поверх LV; возможности её изменения нужно проверять отдельно.
Какую схему LVM выбрать для компании до 50 рабочих мест
В небольшой компании я предпочитаю толстые, обычные LV и оставляю внутри VG резерв. Для файлового сервера разумная отправная точка — выдать томам 70–80 % доступной ёмкости, а остальное не форматировать и не монтировать. Это пространство можно за несколько минут направить туда, где возник дефицит, либо временно использовать под снимок. Делить весь диск до последнего гигабайта — привычная ошибка установщика. Через год свободные 200 ГБ внутри огромного архива не помогут переполненному рабочему тому без рискованного уменьшения файловой системы.
Отдельные LV я создаю не для каждого каталога, а для данных с разным режимом роста и восстановления: рабочие документы, данные приложения, архив. Корневой том ОС держу отдельно. Такая граница не даёт журналам или неожиданной выгрузке забить весь сервер и позволяет восстанавливать только нужный набор. Десять микротомов по 20 ГБ мне не нравятся: они создают постоянную работу по расширению, но не добавляют реальной безопасности.
Для файловых хранилищ, которые предполагается только увеличивать, я часто выбираю XFS. Он хорошо растёт в смонтированном состоянии, а вот штатного уменьшения у него нет: в xfs_growfs реализовано лишь ограниченное уменьшение последней группы выделения, и рабочим административным сценарием это не назовёшь. Если размер XFS придётся уменьшать, я создаю новый LV и копирую данные с проверкой. ext4 умеет расти онлайн, а уменьшаться — офлайн, после размонтирования и e2fsck. Даже с ext4 я не уменьшаю производственный том без проверенной резервной копии: цена освобождённых 50 ГБ несопоставима с ценой восстановления.
Для небольшого сервера моя базовая раскладка такая: отдельный системный диск или LV на 60–100 ГБ, один LV для активных данных, отдельный LV для приложения и не менее 15–20 % VG в резерве. Если прогноз роста неизвестен, сначала собираю статистику хотя бы за месяц. Когда сервер крутится на гипервизоре, отдельный вопрос — где делать снимки: на уровне ВМ или внутри гостя. На Proxmox с общим LVM у снимков свои ограничения, я разбирал их в статье про snapshot-as-volume-chain.
- Сначала обеспечиваю RAID и резервное копирование.
- Затем разделяю ОС, активные данные и данные приложения.
- Оставляю свободные экстенты непосредственно в VG.
- Настраиваю оповещения до ввода сервера в эксплуатацию.
Кейс: файловый сервер архитектурного бюро «АрхГрад»
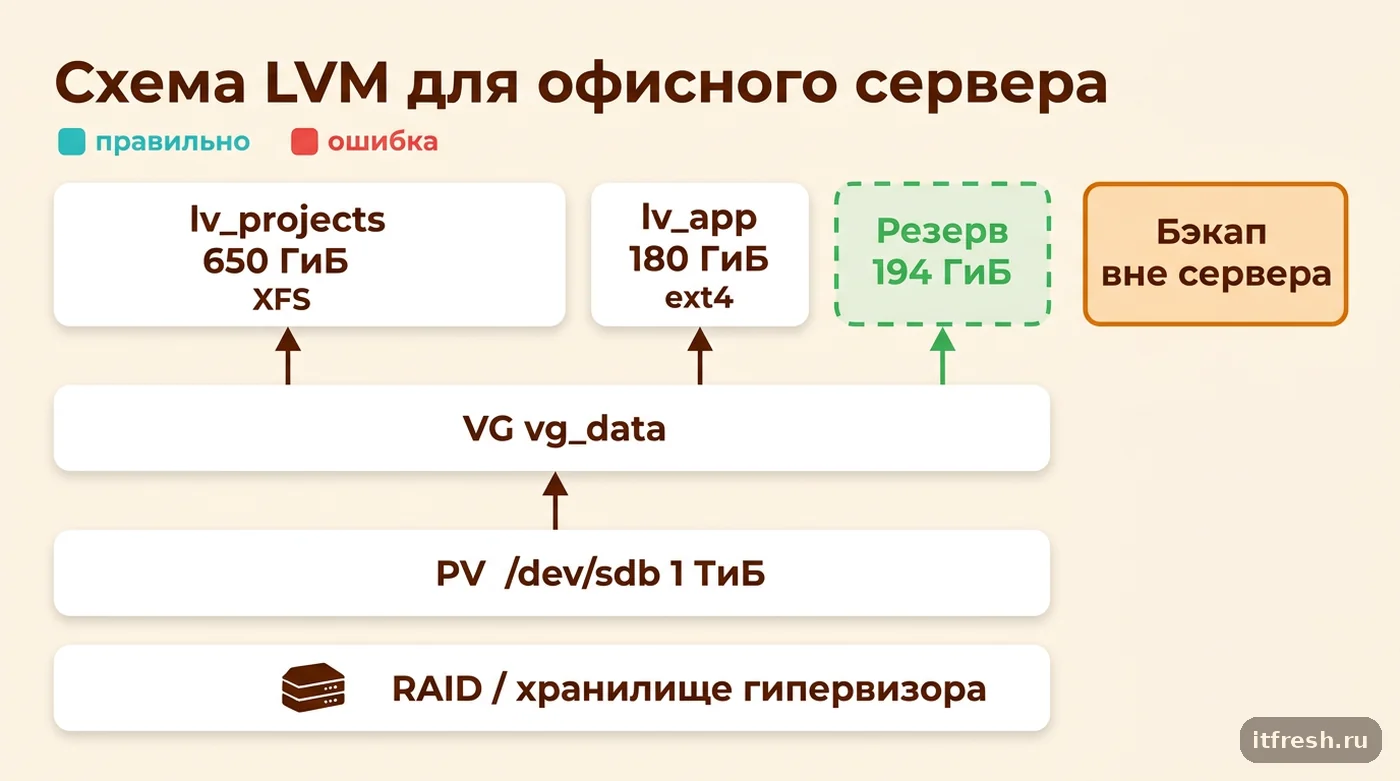
Покажу на живом примере. «АрхГрад» — архитектурное проектирование, 32 рабочих места: архитекторы, конструкторы, визуализаторы и небольшая администрация. Их данные — это тяжёлые файлы моделей, чертежей и рендеров, которые растут скачками: один крупный объект легко добавляет 30–40 ГиБ за месяц. Файловый сервер — виртуальная машина с Ubuntu Server 24.04 LTS (lvm2 2.03.16) на хосте с зеркальными корпоративными SSD. Гостю выдали 80 ГиБ под ОС и отдельный виртуальный SCSI-диск /dev/sdb на 1 ТиБ под данные. Внутри гостевой системы отказоустойчивость не дублировали: её уже обеспечивали хранилище гипервизора и резервные копии.
На момент переезда у бюро было около 430 ГиБ проектов и 90 ГиБ данных внутреннего сервиса учёта версий проектов на PostgreSQL, средний прирост — 12 ГиБ в месяц. Я создал VG vg_data, отдал 650 ГиБ тому lv_projects, 180 ГиБ — lv_app, а 194 ГиБ оставил свободными. Для проектов выбрал XFS: большие файлы, только рост. Для приложения — ext4, потому что там допустима офлайн-проверка и теоретически возможно уменьшение. Точки монтирования закрепили в /etc/fstab по UUID, а не по имени /dev/sdb: буквенное имя диска после изменения оборудования может поменяться.
Разметку выполняли только после проверки серийного номера и отсутствия сигнатур на целевом диске. В сокращённом виде:
sudo lsblk -o NAME,SIZE,TYPE,FSTYPE,SERIAL,MOUNTPOINTS
sudo wipefs -n /dev/sdb
sudo pvcreate /dev/sdb
sudo vgcreate vg_data /dev/sdb
sudo lvcreate -L 650G -n lv_projects vg_data
sudo lvcreate -L 180G -n lv_app vg_data
sudo mkfs.xfs /dev/vg_data/lv_projects
sudo mkfs.ext4 /dev/vg_data/lv_app
sudo mkdir -p /srv/projects /srv/app
sudo blkid /dev/vg_data/lv_projects /dev/vg_data/lv_app
После добавления UUID в /etc/fstab я проверил конфигурацию через sudo findmnt --verify, sudo mount -a, findmnt и тестовую перезагрузку. Команда wipefs -n только показывает найденные сигнатуры и ничего не стирает. А вот pvcreate уже изменяет носитель, поэтому имя устройства перепроверяется непосредственно перед запуском.
- VG `vg_data`: 1 ТиБ.
- `lv_projects`: 650 ГиБ, XFS, `/srv/projects`.
- `lv_app`: 180 ГиБ, ext4, `/srv/app`.
- Резерв VG после развёртывания: 194 ГиБ.
- Рабочие данные на старте: около 520 ГиБ, прирост 12 ГиБ в месяц.
Как расширить том LVM без простоя: пошагово
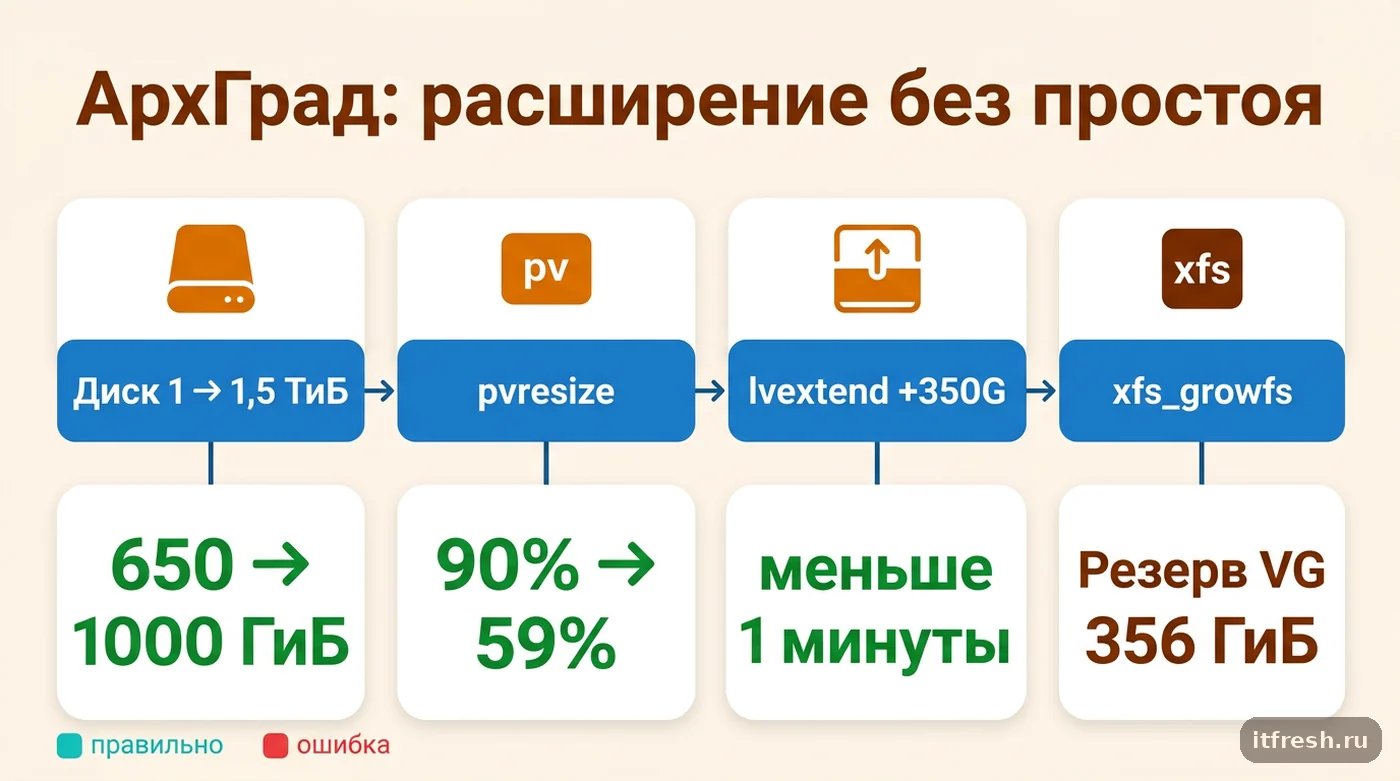
Через одиннадцать месяцев проекты заняли 585 ГиБ из 650 — около 90 %. Прирост оказался выше плана: бюро взяло два крупных жилых комплекса, и визуализаторы начали хранить промежуточные рендеры на сервере. Это ещё не авария, но новые файлы и временные копии при сохранении моделей могли остановиться в самый неудобный день перед сдачей. Сначала я проверил df -hT, затем vgs и увидел 194 ГиБ резерва. Отдать его целиком проектам было бы легко, но неправильно — мы потеряли бы место для аварийного манёвра и снимков. Поэтому в гипервизоре увеличили виртуальный диск с 1 до 1,5 ТиБ, а lv_projects запланировали увеличить на 350 ГиБ.
После резервного копирования и контрольного восстановления отдельного файла действия внутри гостевой машины выглядели так:
echo 1 | sudo tee /sys/class/block/sdb/device/rescan
sudo lsblk -b /dev/sdb
sudo pvresize /dev/sdb
sudo pvs
sudo vgs --units g
sudo lvextend -L +350G /dev/vg_data/lv_projects
sudo xfs_growfs /srv/projects
sudo lvs -o lv_name,vg_name,lv_size,devices
df -hT /srv/projects
PV занимал весь виртуальный диск, поэтому раздел GPT расширять не понадобилось. Если PV лежит в разделе, перед pvresize нужно отдельно и аккуратно увеличить сам раздел, например growpart. xfs_growfs работает только на смонтированной XFS и без параметров забирает всё доступное пространство LV. Я сознательно разделяю lvextend и рост файловой системы на два шага: так в журнале видно, на каком слое возникла ошибка. Вариант lvextend -r тоже допустим — он сразу вызывает расширение ФС.
Окно работ зарезервировали на 30 минут вечером. Фактическая операция заняла меньше минуты, открытые у архитекторов файлы не закрывались, сессии не прерывались. lv_projects вырос с 650 до 1000 ГиБ, в VG осталось 356 ГиБ, заполнение XFS снизилось примерно до 59 %. Через три месяца мы сверили темп роста — около 14 ГиБ в месяц, то есть запаса хватит больше чем на два года даже не трогая резерв. Для бизнеса результат не в том, что «LVM сработал», а в том, что расширение прошло предсказуемо, с сохранённым резервом и без ночного переноса почти 600 ГиБ данных.
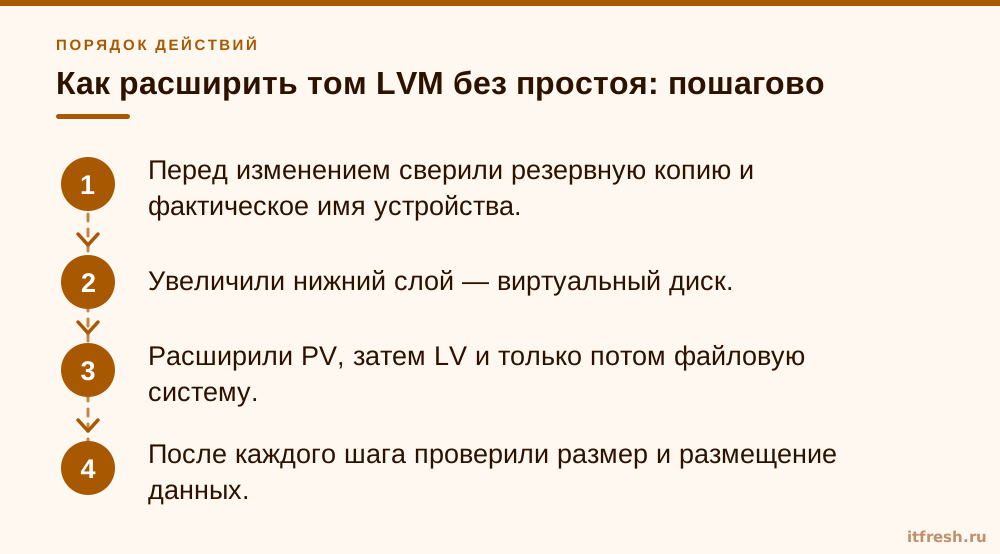
- Перед изменением сверили резервную копию и фактическое имя устройства.
- Увеличили нижний слой — виртуальный диск.
- Расширили PV, затем LV и только потом файловую систему.
- После каждого шага проверили размер и размещение данных.
Снимок LVM полезен, но резервной копией не является
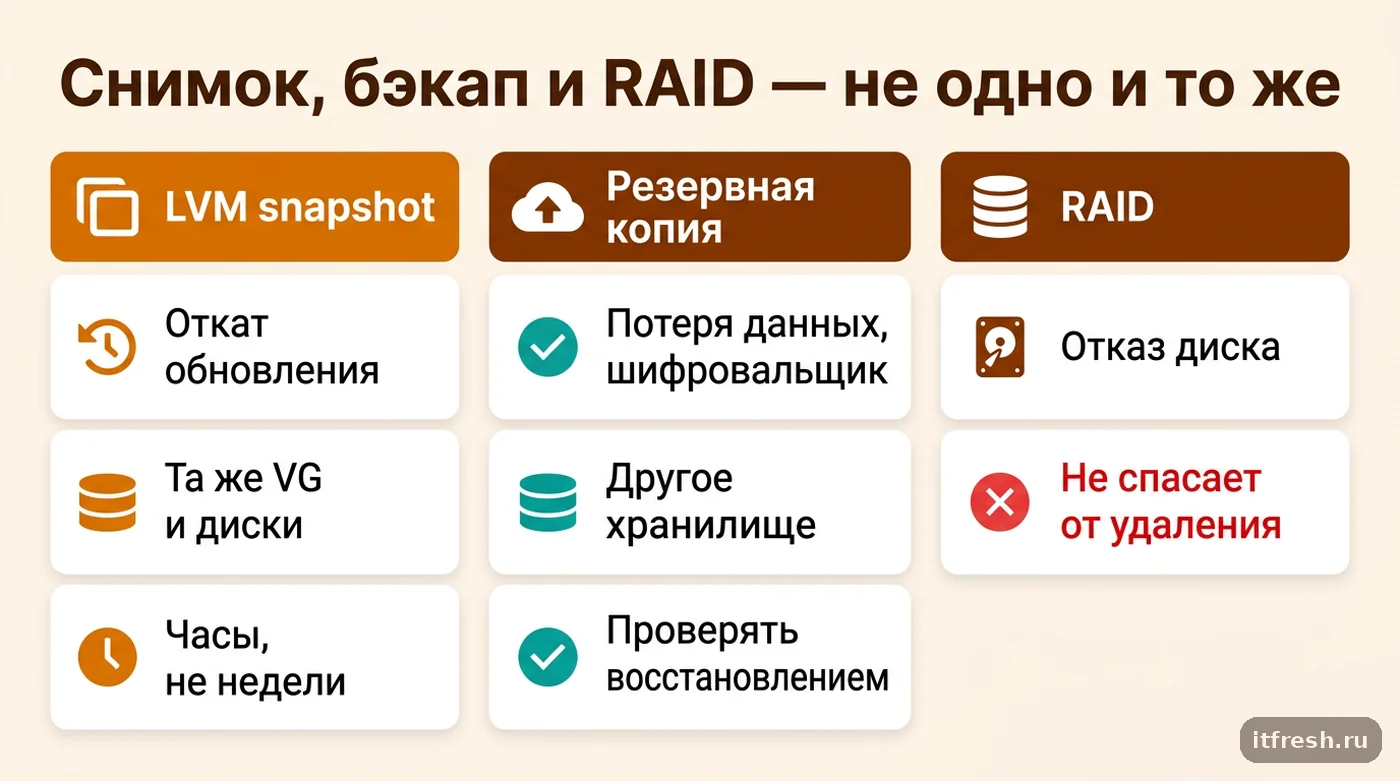
Классический LVM snapshot фиксирует состояние LV на момент создания и сохраняет старые блоки по мере изменения оригинала. Это удобно перед обновлением приложения или для получения стабильной точки чтения. Но снимок обычно находится в той же VG и зависит от тех же дисков. Поломка массива, удаление VG или ошибка оператора уничтожит и оригинал, и снимок. Если выделенное под снимок пространство заполнится на 100 %, снимок станет недействительным (invalid), и откатиться к нему уже нельзя. Поэтому я использую его как короткий технический ремень безопасности, а не как архив.
Перед обновлением сервиса учёта версий у «АрхГрада» мы остановили его службу, дождались завершения операций и создали снимок ext4-тома на 40 ГиБ:
sudo systemctl stop arch-app
sync
sudo lvcreate -L 40G -s -n lv_app_preupdate /dev/vg_data/lv_app
sudo systemctl start arch-app
sudo lvs -o lv_name,origin,lv_size,data_percent
Пауза сервиса заняла 45 секунд. За 22 минуты обновления изменилось около 7,6 ГиБ блоков, выделенного места хватило с запасом. После функциональной проверки и отдельной резервной копии снимок удалили: sudo lvremove /dev/vg_data/lv_app_preupdate. Держать такие снимки неделями я не советую: они занимают место, добавляют копирование при записи и требуют постоянного контроля заполнения.
С работающей базой данных одного sync недостаточно для гарантированной логической согласованности. Нужен штатный механизм базы: остановка сервиса, режим резервирования, checkpoint или поддерживаемая процедура backup. Ночью мы отдельно копировали проекты и данные приложения на независимое сетевое хранилище, а ещё одну копию держали вне офиса. После изменений LVM выполняли vgcfgbackup vg_data и забирали /etc/lvm/backup/vg_data вместе с системной конфигурацией. Этот файл содержит метаданные VG, но не содержимое LV — восстановить из него чертежи нельзя. Для небольших офисов таким независимым хранилищем часто становится NAS — о том, как его правильно встроить, я писал в статье про сетевое хранилище вместо флешек.
- Снимок подходит для короткого отката обновления.
- Резервная копия должна находиться на другом устройстве или в другом хранилище.
- Состояние базы нужно согласовывать средствами самой базы.
- Заполнение snapshot контролируется через `lvs` до его удаления.
Что ломают чаще всего и что контролировать
Самая опасная привычка — копировать команду из инструкции, не проверяя, на каком слое закончилось место. Бывает заполнена файловая система, но в VG есть резерв. Бывает свободна VG, а snapshot уже почти исчерпал выделенный объём. Бывает, что увеличили виртуальный диск, но ядро ещё видит старый размер. Поэтому мой диагностический порядок неизменен: lsblk и findmnt, затем pvs, vgs, lvs, и только после этого df. Команды изменения запускаются с полными путями к LV. Короткое имя экономит секунды, а разбор ошибочно выбранного тома занимает дни.
Вторая повторяющаяся ошибка — избыточно сложная схема. Thin provisioning позволяет выдать логическим томам виртуально больше места, чем физически есть в thin pool. Это полезно на больших платформах виртуализации, но для одного сервера на 32 рабочих места я выбираю обычные LV. При заполнении data или metadata thin pool операции ввода-вывода получают ошибки, возможна порча файловых систем. Значит, нужны dmeventd, мониторинг Data% и Meta%, автоматическое расширение и гарантированно свободные экстенты. Если в компании никто не будет смотреть эти показатели круглосуточно, экономия пространства не стоит нового режима отказа.
Для еженедельной ручной проверки достаточно короткого набора:
sudo pvs -o pv_name,vg_name,pv_size,pv_free
sudo vgs -o vg_name,vg_size,vg_free
sudo lvs -a -o lv_name,lv_size,segtype,origin,data_percent,metadata_percent,devices
findmnt -o SOURCE,FSTYPE,SIZE,USED,AVAIL,USE%,TARGET
df -hT
sudo vgcfgbackup vg_data
В постоянном мониторинге я ставлю предупреждение при 80 % заполнения файловой системы и отдельный прогноз по скорости роста. Для VG важен не универсальный процент, а абсолютный аварийный запас: на этом стенде мы держали не меньше 150 ГиБ — это примерно год прироста при нынешнем темпе. Также контролируем SMART или состояние аппаратного RAID, успешность резервного копирования и возраст последнего тестового восстановления.
Приоритеты здесь довольно жёсткие. Сначала резервное копирование и отказоустойчивый нижний слой. Затем понятные названия, запас в VG и мониторинг. Снимки, thin pool, кэширование и миграция через pvmove нужны только под конкретную задачу. Сам риск LVM часто преувеличивают: нормальная операция расширения отработана годами. Опасен не менеджер томов, а отсутствие схемы, актуального бэкапа и проверки команды перед нажатием Enter.
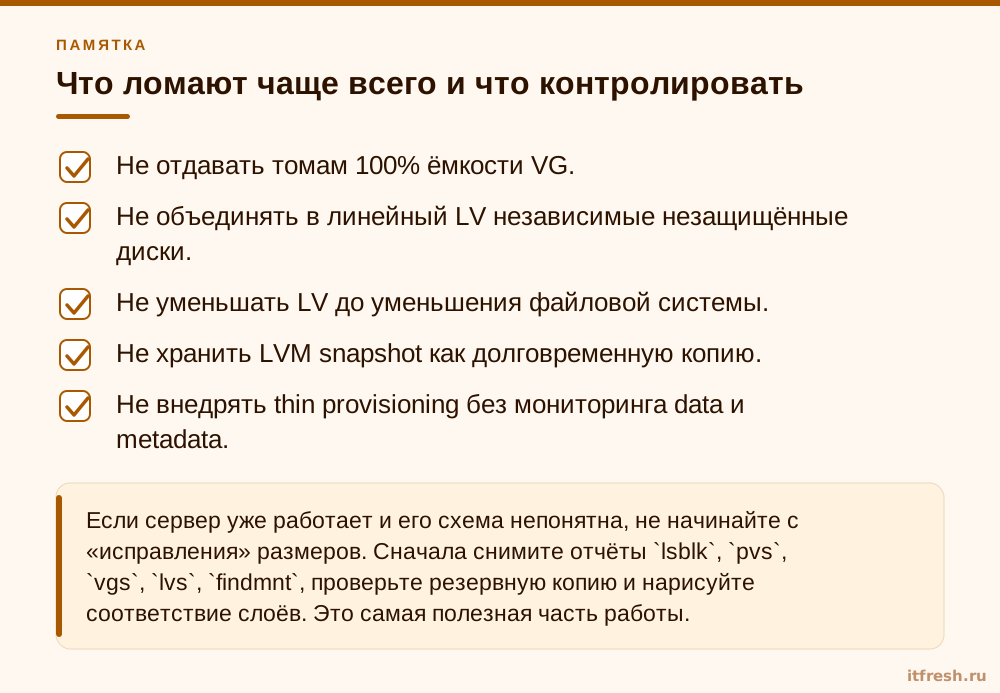
- Не отдавать томам 100 % ёмкости VG.
- Не объединять в линейный LV независимые незащищённые диски.
- Не уменьшать LV до уменьшения файловой системы.
- Не хранить LVM snapshot как долговременную копию.
- Не внедрять thin provisioning без мониторинга data и metadata.
- Документировать UUID, имена VG/LV, точки монтирования и процедуру восстановления.
Частые вопросы
Можно ли добавить новый диск в существующую VG без остановки сервера?
Да. Обычно диск превращают в PV командой `pvcreate`, добавляют через `vgextend`, затем расширяют LV и файловую систему. Но новый диск должен иметь подходящую отказоустойчивость: добавление одиночного носителя в линейный том увеличивает риск потери всего тома.
Нужно ли создавать раздел на диске перед `pvcreate`?
Не обязательно: LVM умеет использовать целое устройство. Я применяю целый отдельный виртуальный диск, если он предназначен только для LVM. Если диск разделяется между загрузчиком, ОС и данными, нужна аккуратная GPT-разметка.
Можно ли расширить XFS без остановки пользователей?
Да. Сначала увеличивают нижний блочный слой и LV, затем запускают `xfs_growfs` для смонтированной файловой системы — XFS вообще расширяется только в смонтированном виде. Делайте это после проверки резервной копии и в контролируемое окно.
Почему нельзя сразу отдать LV всё свободное место?
Резерв VG нужен для срочного расширения другого тома, временного snapshot и обслуживания. Когда VG заполнена полностью, любая незапланированная потребность снова требует изменения дисковой инфраструктуры.
Защищает ли LVM от отказа SSD?
Обычный линейный LVM — нет. Защиту обеспечивает RAID, отказоустойчивое хранилище гипервизора либо специально настроенный LVM RAID. Независимая резервная копия нужна в любом случае.
Стоит ли использовать thin provisioning в небольшой компании?
Для одиночного файлового сервера я обычно не использую thin pool. Он оправдан при большом количестве виртуальных томов и хорошем мониторинге, но заполнение данных или метаданных создаёт дополнительный опасный сценарий отказа.
Источники
- Red Hat Enterprise Linux 9: Configuring and managing logical volumes — Структура PV/VG/LV, расширение и уменьшение томов, снимки. https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/9/html/configuring_and_managing_logical_volumes/index
- lvresize(8) — Синтаксис --size, относительных размеров и --resizefs. https://man7.org/linux/man-pages/man8/lvresize.8.html
- lvmthin(7) — Контроль Data% и Meta%, автоматическое расширение и последствия заполнения thin pool. https://man7.org/linux/man-pages/man7/lvmthin.7.html
- vgcfgbackup(8) — Резервирование метаданных VG в /etc/lvm/backup; содержимое LV не копируется. https://man7.org/linux/man-pages/man8/vgcfgbackup.8.html
- xfs_growfs(8) — Расширение только смонтированной XFS; уменьшение реализовано лишь для последней группы выделения. https://man7.org/linux/man-pages/man8/xfs_growfs.8.html
- Ubuntu Packages: lvm2 в noble — Ubuntu 24.04 LTS — lvm2 2.03.16-3ubuntu3. https://packages.ubuntu.com/noble/lvm2