
На ext4 свободны гигабайты, но новый файл не создаётся: закончились inode
Сервер встал, приложение ругается на «нет места», а df -h спокойно показывает 30 % занятости. Это не глюк и не сбойный диск — на ext4 кончился второй, невидимый ресурс: inode. Разбираю, как опознать это за десять секунд, кто обычно съедает inode, что реально можно сделать на живой файловой системе (и чего нельзя, сколько бы вы ни мучили tune2fs), как посчитать bytes-per-inode под свою нагрузку и как переехать на новую ФС с простоем в десяток минут. Цифры по геометрии ФС я перепроверил на loop-образах с e2fsprogs 1.47.0, так что их можно повторить у себя за пять минут.
«Место есть, а файл не пишется» — как опознать за десять секунд
Сценарий узнаваемый до зубовного скрежета. Звонок: почта не принимается / выгрузка из 1С не сохраняется / Docker не может скачать образ. Заходишь на сервер, первым делом df -h — и видишь 118 ГБ из 393 ГБ, тридцать процентов. Дальше рука тянется к lsof +L1 искать удалённые, но всё ещё открытые файлы: классика, когда кто-то снёс лог, а процесс держит дескриптор, и место числится занятым. Иногда это правда оно. Но на серверах с большим количеством мелких файлов причина часто другая, и её видно одной командой.
Смотрим не блоки, а inode. У df для этого есть отдельный ключ — в man описан буквально одной строкой: «-i, --inodes — list inode information instead of block usage». Выполняем обе команды подряд и сравниваем (второй вывод даёт колонки Inodes, IUsed, IFree, IUse%):
df -hT -x tmpfs -x devtmpfs
df -ihT -x tmpfs -x devtmpfs
Если во втором выводе в колонке IUse% стоит 100 % и IFree равен нулю — диагноз поставлен, дальше можно не искать. Файлы не создаются не потому, что кончились байты, а потому что кончились сами «карточки учёта» файлов. Для точной картины по конкретному тому добавьте tune2fs -l /dev/<устройство> | egrep 'Inode count|Free inodes|Inodes per group|Inode size' — это данные прямо из суперблока, их удобно приложить к заявке или отчёту.
Приложения на это реагируют по-разному, и это сбивает с толку. Postfix честно пишет в maillog «No space left on device» и складывает почту в deferred-очередь. Nginx с включённым proxy_cache молча перестаёт кэшировать и сыпет в error.log про невозможность создать временный файл. Docker падает на распаковке слоя. PostgreSQL может уйти в панику при создании нового сегмента. А в dmesg при этом чисто — ядро не считает это ошибкой устройства, для него всё штатно: ФС просто отвечает ENOSPC. Тот же ENOSPC, что и при реально забитом диске. Отсюда и путаница.
Отдельная ловушка — контейнеры. overlay2 отдаёт в statfs счётчики той файловой системы, где лежит upperdir, то есть хостового тома с /var/lib/docker. Поэтому df -i внутри контейнера покажет те же 100 %, что и на хосте, но не скажет, кто их съел: соседние контейнеры, старые слои и кэш сборки изнутри не видны. Разбор через du --inodes по /var/lib/docker/overlay2 делайте с хоста, а не изнутри.
- df -ihT — первая команда при любом «No space left on device»
- IUse% 100 % при живом df -h = исчерпаны inode, а не место
- lsof +L1 проверяем параллельно, а не вместо
- в контейнере df -i показывает хостовый том, но виновника ищем с хоста
- в dmesg следов не будет, ищите ENOSPC в логах приложения
Откуда взялся потолок: bytes-per-inode задаётся один раз
На ext2/3/4 таблица inode статическая. Её размер вычисляется в момент mkfs и записывается в суперблок. Формула простая: mke2fs берёт объём тома и делит его на параметр bytes-per-inode. В man(8) mke2fs это ключ -i: «Specify the bytes/inode ratio. mke2fs creates an inode for every bytes-per-inode bytes of space on the disk». И там же прямо сказано, что после создания ФС это соотношение изменить нельзя. Не «сложно», не «требует отмонтирования» — нельзя вообще. Причина в устройстве ext4: таблица inode каждой группы блоков — непрерывный заранее выделенный участок размером inodes_per_group × inode_size, а номер inode однозначно указывает на группу и смещение в её таблице. Чтобы поменять inodes_per_group, пришлось бы перенумеровать все inode и переписать все записи каталогов, ссылающиеся на них, — по сути собрать новую ФС. Поэтому утилиты это и не предлагают.
Дефолты живут в /etc/mke2fs.conf, и их полезно один раз прочитать глазами. На Debian 12 / Ubuntu 24.04 с e2fsprogs 1.47 секция [defaults] содержит blocksize 4096, inode_size 256 и inode_ratio 16384. Плюс секция [fs_types], которая переопределяет ratio в зависимости от типа использования: small — 4096, floppy — 8192, big — 32768, huge — 65536, largefile — 1048576, largefile4 — 4194304. Тип mke2fs выбирает сам по размеру тома (small для 3–512 МБ, big для 4–16 ТБ, huge от 16 ТБ), либо вы задаёте его явно ключом -T.
Проверяю на стенде, чтобы не пересказывать чужие слова. Создаю образы через truncate и смотрю геометрию (e2fsprogs 1.47.0):
truncate -s 512M img.ext4 && mkfs.ext4 -q -F img.ext4
tune2fs -l img.ext4 | egrep 'Inode count|Block count|Inode size'
# Inode count:  32768
# Block count:  131072
# Inode size:   256

truncate -s 100M s.img && mkfs.ext4 -q -F s.img
tune2fs -l s.img | egrep 'Inode count|Block count'
# Inode count:  25600      <- сработал тип small, ratio 4096
# Block count:  25600

truncate -s 512M img3 && mkfs.ext4 -q -F -T largefile img3
tune2fs -l img3 | grep 'Inode count'
# Inode count:  512        <- ratio 1048576, пятьсот двенадцать штук на полгигабайта
Считаем прикладную арифметику. Раздел 1 ТиБ с дефолтным ratio 16384 даёт примерно 67 миллионов inode — это ровно то, что показывает df -i на моей рабочей машине. Звучит как «хватит навсегда», но подвох в другом: такая конфигурация рассчитана на средний размер файла 16 КБ и больше. Maildir с перепиской без вложений — это 4–12 КБ на файл. PHP-сессии — сотни байт. Слои overlay2 — тысячи файлов по килобайту. На таких данных inode кончатся раньше блоков, причём с большим запасом свободного места.
Обратная сторона медали — цена. Каждый inode при дефолтном inode_size 256 байт занимает эти 256 байт на диске, и таблица создаётся целиком, независимо от того, используете вы её или нет. 67 млн inode на терабайтном томе — это около 16 ГБ, съеденных под таблицу, полтора процента объёма. Поставите -i 4096 — получите 268 млн inode и уже 64 ГБ под таблицу, шесть с лишним процентов. Поэтому «наделать inode с запасом ×10» — не бесплатное решение, а осознанный размен.
- inode_ratio по умолчанию: 16384 байт на inode
- small (3–512 МБ) — 4096, big (4–16 ТБ) — 32768, huge (16 ТБ+) — 65536
- largefile — 1 МБ на inode, largefile4 — 4 МБ
- inode_size по умолчанию 256 байт: таблица = число inode × 256
- изменить ratio после mkfs невозможно
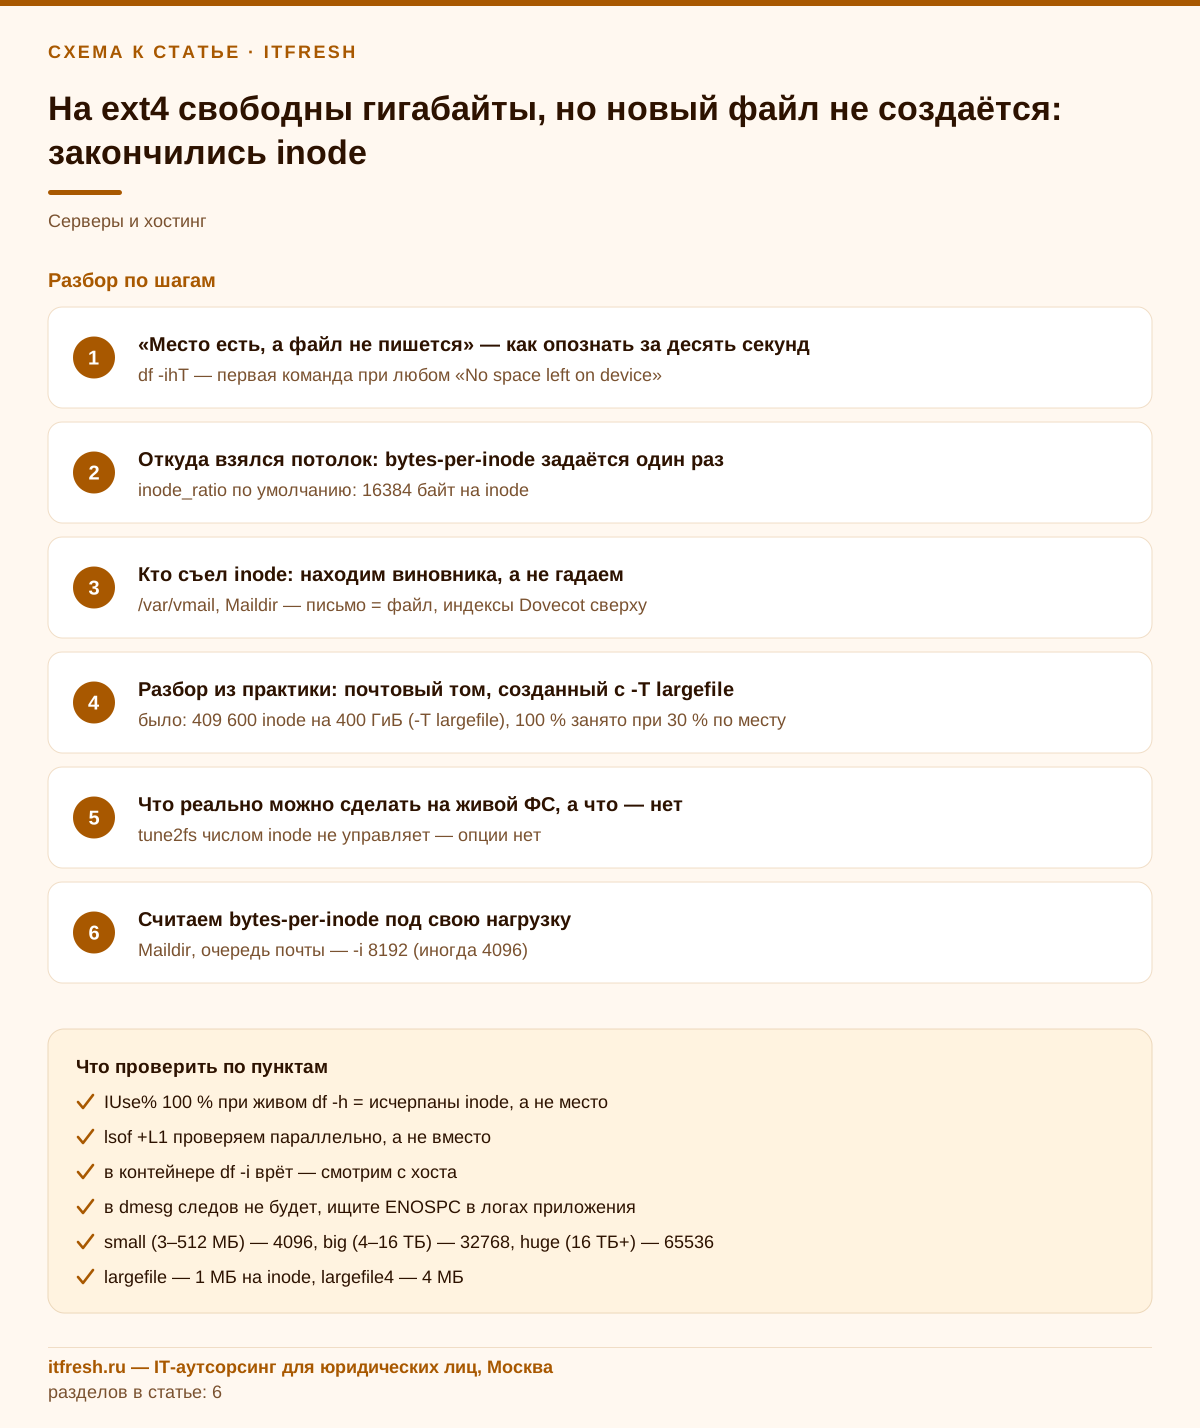
Кто съел inode: находим виновника, а не гадаем
Искать надо по количеству файлов, а не по объёму, и это принципиально другой обход дерева. Самый удобный инструмент — du с ключом --inodes (появился в coreutils 8.22 в декабре 2013 года, то есть есть на любой живой системе, включая CentOS 7). Спускаемся по уровням, как обычно спускаемся по размеру:
du --inodes -x -d1 /var 2>/dev/null | sort -rn | head -15
du --inodes -x -d1 /var/lib 2>/dev/null | sort -rn | head -15
Ключ -x обязателен: без него вы уедете на соседние смонтированные тома и получите бессмысленные числа. Если du --inodes почему-то недоступен, работает древний вариант через find, просто медленнее:
find /var -xdev -printf '%h\n' 2>/dev/null | sort | uniq -c | sort -rn | head -20Список подозреваемых за годы практики почти не меняется. Первое место с большим отрывом — почтовые хранилища: Maildir, где каждое письмо это отдельный файл, плюс индексы Dovecot. Второе — очередь Postfix /var/spool/postfix, особенно если сервер поймал спам-бота и накопил сотни тысяч сообщений в deferred. Третье — /var/lib/docker/overlay2 на хостах, где регулярно пересобирают образы и никогда не делают prune. Дальше по списку: PHP-сессии в /var/lib/php/sessions, кэш nginx с levels=1:2 (это десятки тысяч каталогов сами по себе), node_modules на билд-серверах, .git крупных репозиториев, папки автосканов с МФУ, письма-квитанции ЭДО и, конечно, /tmp, который никто не чистит.
Отдельно — файлы, которых «нет». Удалённые, но открытые процессом файлы держат и блоки, и inode. Проверяется так:
lsof +L1 2>/dev/null | awk '$5=="REG"' | head -20Если нашлось — рестарт процесса решает вопрос мгновенно, без всякой возни с файловой системой. Это самый дешёвый исход, и проверять его надо в первую очередь.
И маленький, но полезный нюанс: у ext4 каталог тоже занимает inode, а каталогов на таких томах бывает больше, чем кажется. Кэш nginx с двухуровневой раскладкой на миллион объектов — это плюс несколько десятков тысяч inode только под структуру. То же с распылёнными по хэшу хранилищами картинок в CMS.
- /var/vmail, Maildir — письмо = файл, индексы Dovecot сверху
- /var/spool/postfix — deferred-очередь после спам-волны
- /var/lib/docker/overlay2 — без docker system prune растёт бесконечно
- /var/lib/php/sessions, /var/cache/nginx (levels=1:2), /tmp
- node_modules, .git, автосканы МФУ, архивы ЭДО
- удалённые, но открытые файлы — lsof +L1
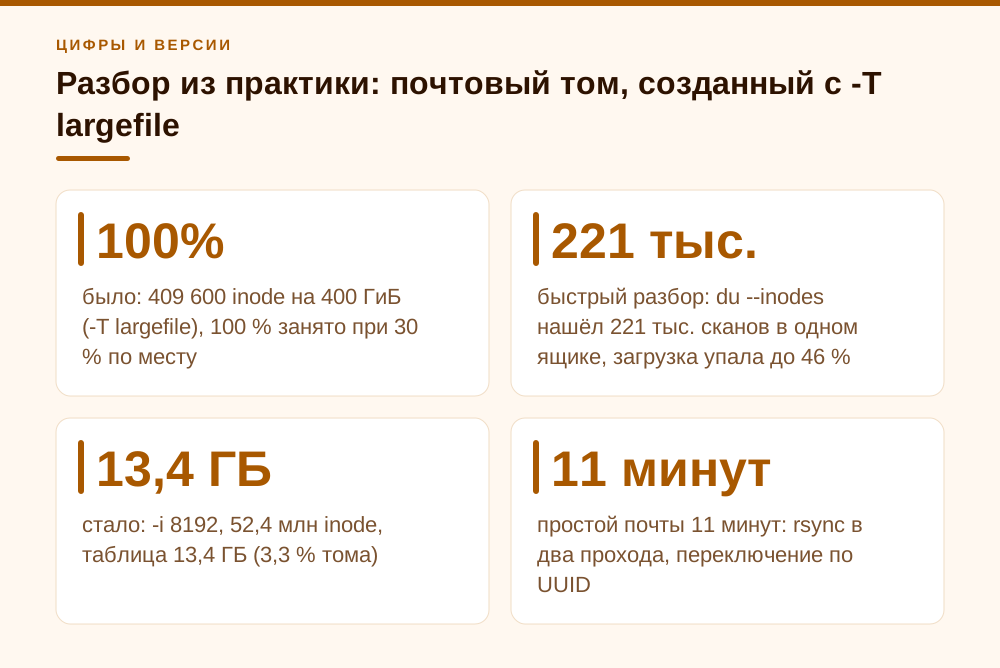
Разбор из практики: почтовый том, созданный с -T largefile
Компания организационного консалтинга «Структура роста», 25 рабочих мест. Консультанты годами хранят в почте переписку с клиентами, протоколы стратегических сессий и выгрузки опросов, поэтому ящики у них тяжёлые. Почтовый сервер — Debian 12, Postfix + Dovecot, Maildir, 27 ящиков (сотрудники плюс общие адреса проектов). Хранилище писем вынесено на отдельный LVM-том 400 ГиБ. Полтора года всё работало, потом за один день почта перестала приниматься: Postfix копил deferred, к вечеру там было 2 900 сообщений, Dovecot отвечал клиентам «Temporary failure».
Смотрю. df -h: занято 118 ГБ из 393 ГБ, тридцать процентов, места навалом. df -i: 409 600 из 409 600, сто процентов. Число красивое и подозрительно круглое — 400 ГиБ, делённые на 1 МиБ. Лезу в историю разворачивания и нахожу в ansible-роли строку mkfs.ext4 -T largefile /dev/vg0/lv_vmail. Роль когда-то писали под том с бэкапами виртуалок, там largefile был абсолютно уместен, а потом её скопировали под почту вместе с ключом. Итог: на четырёхсотгигабайтный почтовый том выделили четыреста тысяч inode. Средний размер письма в этой инсталляции — около 288 КБ, но это среднее по больнице: половина ящиков — переписка по 8–12 КБ, а весь объём делают вложения нескольких человек.
Действовал в два шага. Сначала — купить время, потому что бизнес стоял. du --inodes за минуту показал победителя: /var/vmail/company.example/scan/Maildir/.Archive/cur — ящик, куда МФУ три года складывал сканы анкет и раздаточных материалов после сессий, 221 тысяча файлов. Вынес его целиком на файловый сервер обычным tar, каталог убрал. Загрузка inode упала со 100 % до 46 % (409 600 − 221 000 ≈ 188 600 занятых), почта поехала через минуту, deferred-очередь разобралась postqueue -f за четверть часа. Дальше можно было думать спокойно.
Второй шаг — нормальная ФС. Считал так: целюсь в средний файл 8 КБ, то есть -i 8192. На 400 ГиБ это даёт 52,4 млн inode, таблица под них — 13,4 ГБ, то есть 3,3 % тома. Приемлемо. В VG было свободное место, поэтому обошёлся без внешнего хранилища:
lvcreate -L 400G -n lv_vmail_new vg0
mkfs.ext4 -i 8192 -m 1 -L vmail /dev/vg0/lv_vmail_new
mount /dev/vg0/lv_vmail_new /mnt/new

# первый проход — на живых сервисах
rsync -aHAX --numeric-ids --info=progress2 /var/vmail/ /mnt/new/

# окно простоя
systemctl stop postfix dovecot
rsync -aHAX --numeric-ids --delete /var/vmail/ /mnt/new/
umount /mnt/new /var/vmail
# в fstab — новый UUID, blkid /dev/vg0/lv_vmail_new
mount -a && systemctl start dovecot postfix
По времени: первый проход rsync по 118 ГБ шёл 41 минуту, финальный — 6 минут. Общий простой почты составил 11 минут, делали в 21:40. Ключ -m 1 тут не косметика: по умолчанию mke2fs резервирует под суперпользователя 5 % блоков, на 400 ГиБ это 20 ГБ, выкинутых в никуда. Резерв нужен корневому разделу, чтобы система не легла окончательно, — на томе с данными от него достаточно оставить процент. Старый том держал ещё двое суток, потом снёс. Итог через полгода: df -i на новом томе — около 0,9 %: примерно 470 тысяч файлов вместе с возвращённым архивом сканов на 52,4 млн доступных inode.
- было: 409 600 inode на 400 ГиБ (-T largefile), 100 % занято при 30 % по месту
- быстрый разбор: du --inodes нашёл 221 тыс. сканов в одном ящике, загрузка упала до 46 %
- стало: -i 8192, 52,4 млн inode, таблица 13,4 ГБ (3,3 % тома)
- простой почты 11 минут: rsync в два прохода, переключение по UUID
- -m 1 вместо дефолтных 5 % вернул 20 ГБ полезного объёма
Что реально можно сделать на живой ФС, а что — нет
Начну с того, чего нельзя, потому что на этом теряют часы. У tune2fs попросту нет опции для изменения числа inode — не «не работает», а не существует:
$ tune2fs -N 99999 /dev/vg0/lv_data
tune2fs: invalid option -- 'N'
Ключ -N есть у mke2fs (переопределить число inode при создании), и его регулярно путают с tune2fs. У tune2fs есть похожий по написанию -I, но он меняет *размер* inode, а не количество, и на обычной ext4 вы упрётесь в стену:
$ tune2fs -I 512 /dev/loop0
Changing the inode size not supported for filesystems with the flex_bg feature enabled.
$ tune2fs -I 128 /dev/loop0
Shrinking inode size is not supported
feature flex_bg включён у ext4 по умолчанию (посмотрите свой /etc/mke2fs.conf), так что этот путь закрыт практически везде. И даже если бы он открылся, увеличение размера inode отнимает место, а не добавляет их количество.
Теперь то, что работает. При увеличении файловой системы resize2fs добавляет новые группы блоков, а вместе с ними — новые inode, сохраняя исходное соотношение из суперблока. Проверил на стенде:
truncate -s 512M img.ext4 && mkfs.ext4 -q -F img.ext4
tune2fs -l img.ext4 | grep 'Inode count'   # 32768

truncate -s 2G img.ext4 && e2fsck -fy img.ext4 && resize2fs img.ext4
tune2fs -l img.ext4 | grep 'Inode count'   # 131072
Объём вырос в четыре раза — число inode выросло ровно в четыре раза. Значит, если раздел лежит на LVM и в группе томов есть свободное место, самый дешёвый выход из аварии выглядит так:
lvextend -L +200G /dev/vg0/lv_vmail
resize2fs /dev/vg0/lv_vmail          # ext4 растёт онлайн, размонтировать не надо
df -i /var/vmail
Оговорка, которую надо понимать до того, как вы обрадуетесь. Способ масштабируется линейно и только вперёд: чтобы удвоить число inode, надо удвоить том. На нормальном ratio 16384 это ещё имеет смысл. На томе, созданном с largefile, — почти нет: чтобы из 409 тысяч inode получить 819 тысяч, придётся выделить ещё 400 ГБ диска. Это лечение симптома за деньги, и рано или поздно всё равно придётся пересоздавать ФС.
И сразу закрою популярный народный рецепт: «а давайте сожмём ФС до минимума, а потом разожмём обратно — вдруг inode пересчитаются». Не пересчитаются. Соотношение bytes-per-inode хранится в суперблоке и переживает обе операции, вы просто вернётесь ровно к тому же числу, потеряв время и получив на выходе риск. Плюс уменьшение ext4 требует отмонтированной ФС и предварительного e2fsck -f, то есть простоя, ради нулевого результата.
- tune2fs числом inode не управляет — опции нет
- tune2fs -I меняет размер inode и не работает при flex_bg (дефолт ext4)
- уменьшить размер inode нельзя ни при каких условиях
- resize2fs при росте добавляет inode пропорционально — проверено 32768 → 131072
- ext4 растёт онлайн, уменьшается только в размонтированном виде
- shrink+grow не даёт новых inode — ratio сохраняется
Считаем bytes-per-inode под свою нагрузку
Не гадайте — измерьте. Если данные уже есть, посчитайте фактический средний размер файла прямо на них:
find /var/vmail -xdev -type f -printf '%s\n' \
  | awk '{s+=$1; n++} END {printf "файлов: %d, средний: %.0f Б\n", n, s/n}'
Если данных ещё нет — берите ориентир от типа нагрузки. Дальше моё рабочее правило: ставить bytes-per-inode примерно вдвое меньше фактического среднего размера файла. Запас нужен потому, что со временем доля мелочи растёт почти всегда: добавляются индексы, миниатюры, временные файлы, служебные метаданные.
Мои значения по типам томов, которые я ставлю не задумываясь:
# почта, Maildir
mkfs.ext4 -i 8192 -m 1 -L vmail /dev/vg0/lv_vmail

# /var под docker-хост, кэши, сессии
mkfs.ext4 -i 8192 -m 1 -L var /dev/vg0/lv_var

# офисная файлопомойка, документы
mkfs.ext4 -m 1 -L files /dev/vg0/lv_files      # дефолт 16384 подходит

# бэкапы, образы ВМ, видеоархив
mkfs.ext4 -i 262144 -m 0 -L backup /dev/vg0/lv_backup
Есть и второй способ задать то же самое — ключ -N, он переопределяет расчёт и задаёт число inode напрямую: «Overrides the default calculation of the number of inodes that should be reserved for the file system». Учтите, что mke2fs раскладывает inode поровну по группам блоков и округляет вверх, чтобы они целиком заполняли блоки таблицы, так что точного значения вы не получите: на стенде -N 50000 для 512 МиБ дало 50 048 inode (4 группы по 12 512). Мне удобнее рассуждать в терминах «сколько байт на файл», поэтому в 95 % случаев я использую -i.
И обязательный шаг, который экономит нервы: перед созданием ФС посмотрите геометрию всухую. У mke2fs есть ключ -n — он всё считает и печатает, но ничего не пишет на диск:
mke2fs -n -t ext4 -i 8192 -m 1 /dev/vg0/lv_vmail_new
# Creating filesystem with 104857600 4k blocks and 52428800 inodes
# Superblock backups stored on blocks: ...
Увидели ожидаемое число inode — повторяете команду без -n. Это тридцать секунд, которые страхуют от опечатки в разряде, а опечатка в разряде здесь означает повторную миграцию.
Про миграцию коротко, потому что схема универсальная и я её уже показал на кейсе «Структуры роста». Новый том → mkfs с нужным -i → первый rsync на живых сервисах → короткое окно: стоп сервисов, финальный rsync --delete, перемонтирование → правка fstab по UUID (никогда по /dev/sdX: после перезагрузки буквы разъезжаются) → сутки-двое держим старый том нетронутым и только потом освобождаем. Флаги -aHAX --numeric-ids обязательны, если на томе есть жёсткие ссылки, POSIX ACL или xattr — а на почтовых и файловых томах они есть почти всегда.
- Maildir, очередь почты — -i 8192 (иногда 4096)
- /var на docker-хосте, кэши, сессии — -i 8192
- документы, офисный файловый ресурс — дефолт 16384
- бэкапы, ISO, диски ВМ, видео — -i 262144 или -T largefile
- -N задаёт число inode напрямую, с округлением вверх по группам
- mke2fs -n — обязательная проверка геометрии перед записью
Мониторинг и выбор ФС для новых серверов
Главный вывод всей статьи простой: пересоздавать файловые системы «на всякий случай» не нужно, нужно знать своё число inode и следить за ним. У Zabbix-агента для этого есть штатный ключ vfs.fs.inode[fs,pfree] — процент свободных inode по точке монтирования, например vfs.fs.inode[/var/vmail,pfree]. В шаблоне «Linux by Zabbix agent» новых версий то же значение приходит зависимым элементом vfs.fs.dependent.inode[{#FSNAME},pfree] из vfs.fs.get, а пороги задаются макросами {$VFS.FS.INODE.PFREE.MIN.WARN} и {$VFS.FS.INODE.PFREE.MIN.CRIT}. Проблема обычно не в том, что метрики нет, а в том, что триггер по ней отключён или утоплен в шуме и никем не читается.
Если Zabbix нет, хватит десяти строк на cron. У нас на части площадок висит вот такой сторож с отправкой в Telegram:
#!/usr/bin/env bash
# /usr/local/sbin/inode-watch.sh — cron: 0 * * * *
THRESHOLD=80
df -iP -x tmpfs -x devtmpfs -x overlay | awk -v t="$THRESHOLD" 'NR>1 {
  gsub(/%/,"",$5);
  if ($5+0 >= t) printf "INODE %s%% на %s (%s)\n", $5, $6, $1;
}' > /tmp/inode.alert
[ -s /tmp/inode.alert ] && curl -s -X POST \
  "https://api.telegram.org/bot${TG_TOKEN}/sendMessage" \
  -d chat_id="${TG_CHAT}" --data-urlencode text@/tmp/inode.alert
Пороги я ставлю так: 80 % — предупреждение, 90 % — звонок дежурному. Для почтовых серверов и docker-хостов опускаю предупреждение до 70 %: там расход умеет ускоряться скачком, спам-волна или цикл пересборки образов съедают миллион inode за ночь.
Теперь про выбор ФС, и тут я скажу прямо, что мнение неединое. XFS выделяет блоки под inode по мере надобности, а не всё сразу при mkfs, и ограничена параметром imaxpct: по документации mkfs.xfs это «the maximum percentage of space in the filesystem that can be allocated to inodes», по умолчанию 25 % для ФС меньше 1 ТБ, 5 % — меньше 50 ТБ и 1 % — свыше 50 ТБ. Ключевое преимущество для нашей темы: этот лимит можно поднять на смонтированной ФС — xfs_growfs -m 10 /var/vmail. То есть сценарий «упёрлись в inode, пересоздаём том» на XFS в норме не возникает вовсе.
Мой практический выбор на 2026 год: под почтовые хранилища и хосты с контейнерами беру XFS (на RHEL/AlmaLinux она и так по умолчанию, на Debian ставится явно), под корень и под всё остальное — ext4 с осознанно выставленным -i. Против XFS есть честный контраргумент: штатно она не уменьшается (в свежих xfsprogs есть лишь экспериментальное ограниченное сжатие, на которое в продакшене я бы не рассчитывал), а ext4 при необходимости ужимается офлайн. Если у вас нестабильная разметка и вы регулярно перекраиваете тома, ext4 удобнее. Если том — «налил и растёт», XFS снимает целый класс проблем.
И на что можно спокойно забить: не надо переезжать на btrfs или ZFS ради одних только inode, не надо превентивно пересоздавать работающие тома, не надо ставить -i 1024 «чтобы уж точно хватило» — вы просто отдадите четверть диска под пустую таблицу. Достаточно трёх вещей: правильный -i при создании новых томов, df -i в мониторинге и docker system prune с ротацией логов в расписании.
- порог предупреждения 80 %, критический 90 %; для почты и docker — 70 %
- Zabbix: vfs.fs.inode[fs,pfree] или шаблонный vfs.fs.dependent.inode — проверьте, что триггер включён и его читают
- XFS: inode выделяются по мере надобности, лимит imaxpct 25/5/1 %
- xfs_growfs -m <pct> поднимает лимит на смонтированной ФС
- XFS штатно не уменьшается — учитывайте при нестабильной разметке
- docker system prune и logrotate в расписании снимают самые частые сценарии на docker-хостах
Частые вопросы
Можно ли увеличить число inode на ext4 без пересоздания файловой системы?
Напрямую — нет: bytes-per-inode фиксируется в суперблоке при mkfs и после этого не меняется, у tune2fs соответствующей опции просто не существует. Единственный законный способ — увеличить сам том: при росте ФС resize2fs добавляет группы блоков вместе с inode, сохраняя исходное соотношение. На моём стенде рост с 512 МиБ до 2 ГиБ дал ровно вчетверо больше inode: 32768 → 131072. Способ линейный: чтобы удвоить число inode, придётся удвоить объём.
Почему df -h показывает свободное место, а система пишет No space left on device?
Потому что ENOSPC возвращается и при нехватке блоков, и при нехватке inode. Проверяется командой `df -i`: если в колонке IUse% стоит 100 %, кончились именно inode. Такое типично для томов с миллионами мелких файлов — почта, кэши, PHP-сессии, слои Docker. Отдельно проверьте `lsof +L1`: удалённые, но открытые процессом файлы тоже держат ресурс, и там лечение — просто рестарт процесса.
Какое значение -i выбрать при создании файловой системы?
Считайте от фактического среднего размера файла и берите примерно вдвое меньше. Мои рабочие значения: почта и Maildir — `-i 8192`, /var на docker-хосте с кэшами и сессиями — `-i 8192`, офисные документы — дефолтные 16384, бэкапы и образы ВМ — `-i 262144` или `-T largefile`. Перед записью обязательно прогоните `mke2fs -n` с теми же ключами и убедитесь, что в строке «Creating filesystem with … blocks and … inodes» число inode ожидаемое.
Занимают ли inode место на диске?
Да, и это надо учитывать. Таблица создаётся целиком при mkfs, размер = число inode × inode_size (по умолчанию 256 байт). Терабайтный том с дефолтным ratio 16384 отдаёт под таблицу около 16 ГБ, то есть полтора процента. Если поставить `-i 4096`, будет уже 268 млн inode и 64 ГБ таблицы — шесть с лишним процентов объёма. Поэтому «побольше про запас» — это размен, а не бесплатная страховка.
Помогает ли переход на XFS?
Для этой конкретной проблемы — да. XFS выделяет блоки под inode по мере надобности, а верхний предел задаётся параметром imaxpct (по умолчанию 25 % для ФС меньше 1 ТБ, 5 % до 50 ТБ, 1 % свыше). Главное — этот предел можно поднять на живой смонтированной ФС командой `xfs_growfs -m 10 /mnt`. Обратная сторона: XFS штатно не уменьшается, только растёт. Я беру XFS под почту и контейнерные хосты, ext4 с осознанным -i — под всё остальное.
Что делать прямо сейчас, если продакшен уже встал?
Три шага по порядку. Первый: `lsof +L1` — если ресурс держат удалённые открытые файлы, рестарт процесса решает вопрос за секунды. Второй: `du --inodes -x -d1` по подозрительным каталогам и вынос найденной мелочи на другой том обычным tar — не удаление вслепую, а именно перенос. Третий: если том на LVM и в группе есть место, `lvextend` + `resize2fs` онлайн добавит inode пропорционально и купит вам недели на спокойную миграцию.
Поможет ли уменьшить, а потом увеличить файловую систему обратно?
Нет. Соотношение bytes-per-inode хранится в суперблоке и переживает обе операции — вы вернётесь ровно к тому же числу inode. При этом уменьшение ext4 требует размонтирования и предварительного `e2fsck -f`, то есть реального простоя ради нулевого результата. Не тратьте на это окно обслуживания.
Источники
- mke2fs(8), e2fsprogs 1.47 — Опции -i bytes-per-inode («mke2fs creates an inode for every bytes-per-inode bytes of space on the disk», соотношение неизменяемо после создания ФС), -N number-of-inodes, -I inode-size, -T usage-type, -m reserved-blocks-percentage (по умолчанию 5 %), -n (dry-run). https://man7.org/linux/man-pages/man8/mke2fs.8.html
- df(1), GNU coreutils — Опция «-i, --inodes — list inode information instead of block usage», а также -h, -T, -t, -x. https://man7.org/linux/man-pages/man1/df.1.html
- resize2fs(8), e2fsprogs 1.47 — Онлайн-увеличение ext4, требование resize_inode, offline-уменьшение, ключи -M и -P. https://man7.org/linux/man-pages/man8/resize2fs.8.html
- tune2fs(8), e2fsprogs 1.47 — Раздел про -I («Change the inode size used by the file system…»), -m, -r, -o, -e; опции изменения числа inode в утилите нет. https://man7.org/linux/man-pages/man8/tune2fs.8.html
- mke2fs.conf(5) на Debian 12 / Ubuntu 24.04 — Локальный /etc/mke2fs.conf, e2fsprogs 1.47.0: [defaults] blocksize 4096, inode_size 256, inode_ratio 16384; [fs_types] small 4096, floppy 8192, big 32768, huge 65536, largefile 1048576, largefile4 4194304. https://man7.org/linux/man-pages/man5/mke2fs.conf.5.html
- mkfs.xfs(8) и xfs_growfs(8), xfsprogs — imaxpct: «the maximum percentage of space in the filesystem that can be allocated to inodes», по умолчанию 25 % (<1 ТБ), 5 % (<50 ТБ), 1 % (>50 ТБ); xfs_growfs -m меняет это значение на смонтированной ФС. https://man7.org/linux/man-pages/man8/mkfs.xfs.8.html и https://man7.org/linux/man-pages/man8/xfs_growfs.8.html
- Linux kernel documentation — ext4, Block Groups — Таблица inode группы — непрерывный диапазон блоков размером s_inodes_per_group × s_inode_size; при flex_bg таблицы нескольких групп сводятся в первую группу. Объясняет, почему число inode фиксируется при mkfs. https://docs.kernel.org/filesystems/ext4/blockgroup.html
- Собственный стенд ITfresh, e2fsprogs 1.47.0 — Замеры в статье получены на loop-образах: mkfs.ext4 512 МиБ → 32768 inode; рост до 2 ГиБ через resize2fs → 131072 inode; 100 МиБ → 25600 inode (тип small); -T largefile 512 МиБ → 512 inode; tune2fs -I 512 отклоняется при flex_bg. Dry-run mke2fs -n для 400 ГиБ с -i 8192 → «Creating filesystem with 104857600 4k blocks and 52428800 inodes»; -N 50000 на 512 МиБ → 50048 inode.
- GNU coreutils 8.22 release announcement — «du accepts a new option: --inodes to show the number of inodes instead of the blocks used», релиз 13.12.2013. https://lists.gnu.org/archive/html/coreutils/2013-12/msg00134.html
- Zabbix Documentation — Zabbix agent items — Ключ vfs.fs.inode[fs,<mode>] (mode: total, free, used, pfree, pused) и vfs.fs.get для низкоуровневого обнаружения ФС. https://www.zabbix.com/documentation/current/en/manual/config/items/itemtypes/zabbix_agent
- Docker Docs — OverlayFS storage driver — Слои overlay2 хранятся в /var/lib/docker/overlay2 и расходуют inode хостовой (backing) файловой системы. https://docs.docker.com/engine/storage/drivers/overlayfs-driver/