
Перенесли репозиторий Veeam 13 на новый XFS вручную: почему синтетические full съели весь диск
Если вы считаете, что перенос бэкапов Veeam на новый диск — это «остановить задания, rsync, пересканировать репозиторий», то на XFS с reflink (и на ReFS с block cloning) вас ждёт сюрприз: 3,6 ТБ на старом томе превращаются в 16 ТБ на новом. Разбираю на живом переезде, почему так, чем ручное копирование отличается от Move Backup и эвакуации экстента, как вернуть Fast Clone, если уже перенесли руками, и как проверить, что он реально работает, а не «вроде должен».
Что вообще произошло: 3,6 ТБ превратились в 16
Звонок в субботу вечером: «Женя, репозиторий встал, места нет, а мы даже не всё перенесли». Дальше — классика жанра. Админ поставил новый сервер с массивом примерно на 14,5 ТБ, разметил XFS, запустил rsync со старого репозитория и ушёл домой с чувством выполненного долга. Логика железная: на старом томе занято 3,6 ТБ, новый — 14,5 ТБ, влезет с четырёхкратным запасом. К утру rsync лежал с No space left on device, перенеся 14,4 ТБ из 16.
Разгадка живёт в двух командах, которые почти никто не сравнивает между собой перед переездом:
# старый репозиторий, XFS с reflink
$ df -h /backup
Filesystem              Size  Used Avail Use% Mounted on
/dev/mapper/vg0-backup  8.2T  3.6T  4.6T  44% /backup

$ du -sh /backup
16T	/backup
Расхождение в 12,4 ТБ — это не глюк и не ошибка учёта. df показывает физически занятые блоки файловой системы. du обходит файлы и складывает блоки каждого по отдельности — а на XFS с reflink один и тот же физический экстент принадлежит сразу десятку файлов и считается десять раз. Разница между этими цифрами и есть ваша экономия от Fast Clone. И именно du, а не df, определяет, сколько байт прочитает и запишет обычный cp или rsync.
То есть на старом томе лежали двадцать с лишним точек восстановления, включая несколько синтетических full по 2,1 ТБ каждый, которые физически почти ничего не занимали: их блоки были ссылками на данные, уже лежащие в предыдущих файлах цепочки. rsync честно прочитал каждый из них байт за байтом и записал на новый том полноценным файлом на 2,1 ТБ. Три таких full — и 6,3 ТБ как не бывало, а ведь есть ещё GFS-точки.
- df -h /backup → Size 8.2T, Used 3.6T, Use% 44 %
- du -sh /backup → 16T
- разница 12,4 ТБ = блоки, разделяемые между файлами через reflink
- сколько запишет rsync на новый том — смотрите du, а не df
Механика: что делает Fast Clone и почему cp этого не умеет
Формулировка Veeam в документации предельно прямая: «Veeam Backup & Replication references existing data blocks on volumes instead of copying data blocks between files. Data blocks are copied only when files are modified». На Linux это построено на reflink — механизме XFS, где два файла законно указывают на один и тот же физический экстент, а копирование при записи (CoW) выполняется только тогда, когда кто-то из них меняется. На Windows то же самое делает block cloning файловой системы ReFS.
Синтетический full в такой схеме — это новый .vbk-файл, у которого почти все блоки являются ссылками на экстенты, уже лежащие в предыдущем full и инкрементах. Логически это полная резервная копия со всеми свойствами полной копии. Физически он стоит вам единицы гигабайт метаданных и минуты времени вместо часов чтения-записи. По документации тот же приём Veeam использует при merge, трансформации reverse incremental, compact, создании GFS, эвакуации и ребалансировке экстентов SOBR, а также при move, copy и export бэкапов.
А теперь ключевое, ради чего написана статья. reflink — операция внутри одной файловой системы. Ядро выполняет её через ioctl FICLONERANGE, и он физически не может связать экстенты на двух разных ФС. Проверяется в одну строку:
$ cp --reflink=always /backup/rostbiz/rostbiz-srv.vbk /backup2/
cp: failed to clone '/backup2/rostbiz-srv.vbk' from '/backup/rostbiz/rostbiz-srv.vbk': Invalid cross-device link
rsync про разделяемые экстенты не знает вообще ничего — у него нет такого понятия. cp --reflink=always знает, но между разными томами получит Invalid cross-device link. cp --reflink=auto (а в coreutils 9.x это поведение по умолчанию) в этом случае молча свалится в обычное копирование, что даже хуже: вы будете уверены, что всё в порядке. Вывод жёсткий: любой перенос файлов бэкапа на НОВУЮ файловую систему средствами ОС гарантированно разворачивает синтетику до полного физического размера. Способа обойти это шеллом не существует.
На Windows ровно та же история, только вместо rsync — robocopy или копирование в проводнике. Veeam пишет об этом прямо: при копировании данных с ReFS-тома в другое место файловая система вычитывает клонированные блоки, и скопированные данные занимают на приёмнике больше места, чем на источнике. Плюс ограничение Microsoft: исходный и клонируемый файлы должны лежать на одном и том же ReFS-томе, так что между двумя дисками block cloning невозможен в принципе.
- Fast Clone на Linux = reflink на XFS, на Windows = block cloning ReFS; оба работают только внутри одной файловой системы
- rsync, tar, scp, cp без флагов, robocopy — разворачивают разделяемые блоки в физические копии
- cp --reflink=always между двумя ФС → EXDEV (Invalid cross-device link), --reflink=auto — молчаливое полное копирование
- Veeam автоматически включает опцию «Align backup file data blocks» на репозиториях с Fast Clone — без выравнивания по границам кластера клонирование невозможно
Что об этом написано у вендора, чёрным по белому
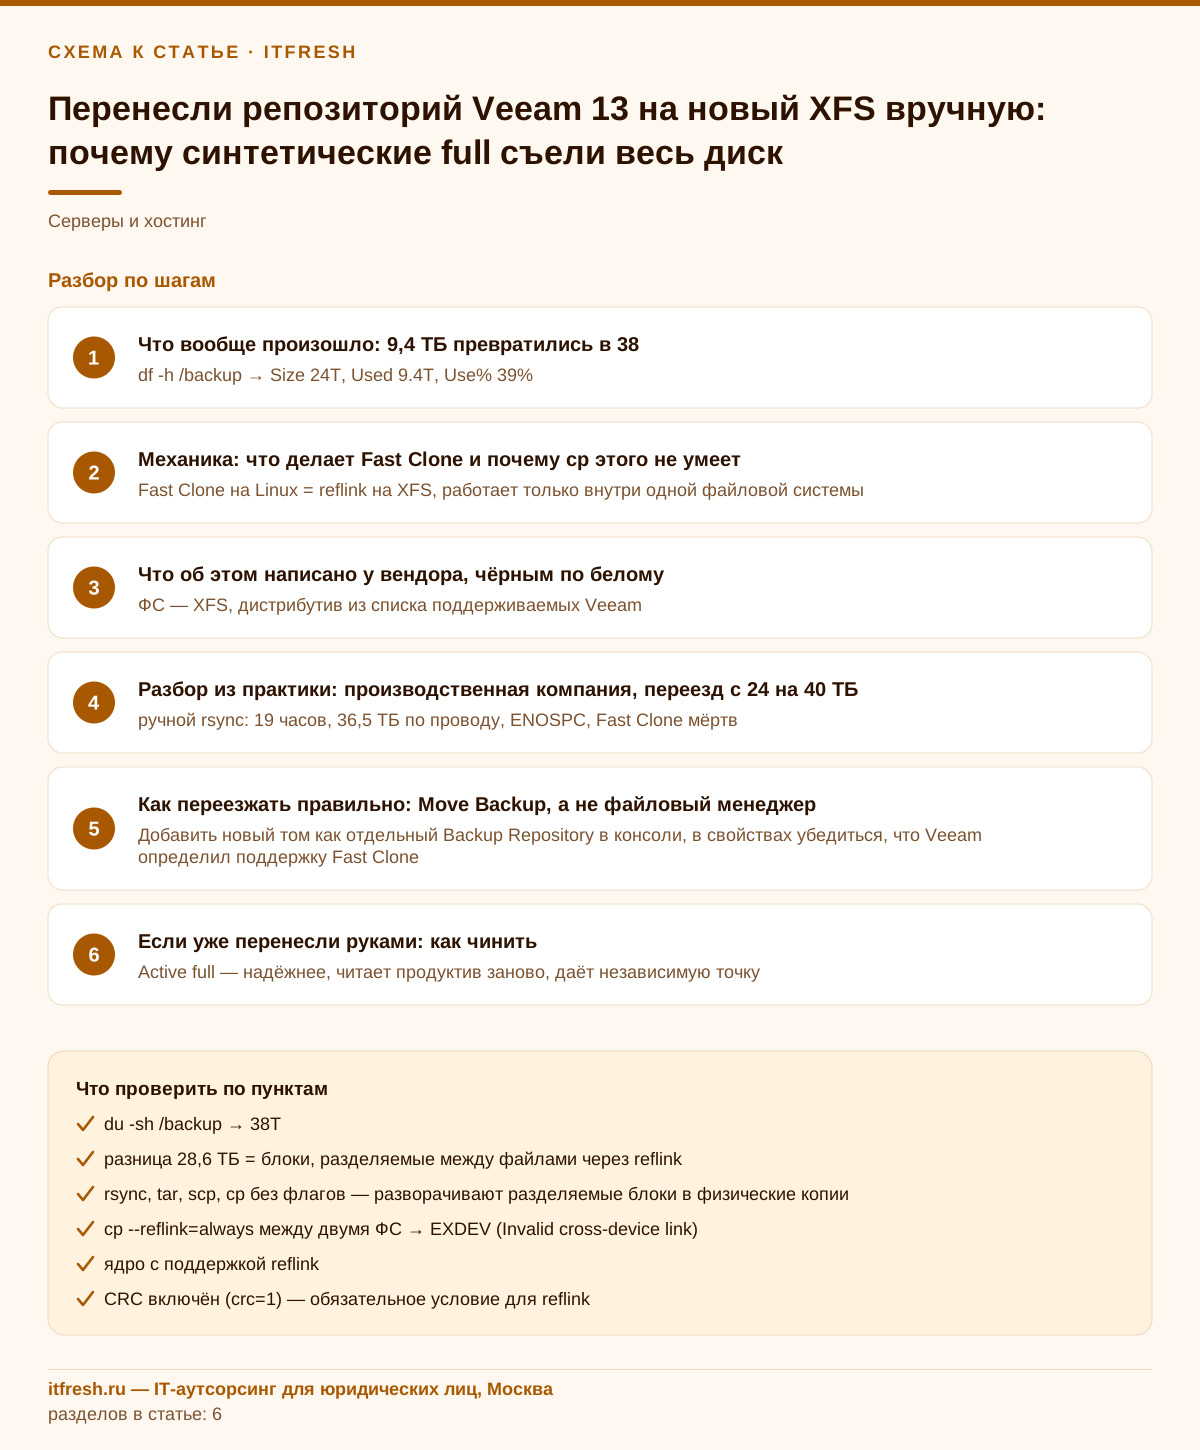
Это не фольклор с форумов, это документированное поведение. В разделе Fast Clone пользовательского руководства Veeam Backup & Replication 13 (на момент написания — редакция от 20.07.2026 для сборки 13.1.1.18) в блоке Limitations для Linux-репозиториев написано: «If you have manually moved backup chains to a Linux-based backup repository with Fast Clone support, you must create active full backups for these chains after the move to activate Fast Clone. You can also schedule the backup file compact operation instead of active full backup. Note that creation of active full backups is not required if you use the Veeam copy or move features».
Статья базы знаний KB1729 «How to Relocate Backup Files» описывает ту же проблему со стороны переноса: штатным способом называется функция Move Backup, а ручной (legacy) перенос файлов сопровождается предупреждениями — вручную перенесённые на ReFS или XFS цепочки не используют Fast Clone до нового active full, а «бесплатные» синтетические full при таком переносе разворачиваются до полного размера. Для Windows-репозиториев в самом разделе Fast Clone написано то же: после ручного переноса цепочек на репозиторий с поддержкой Fast Clone нужен active full либо запланированный compact.
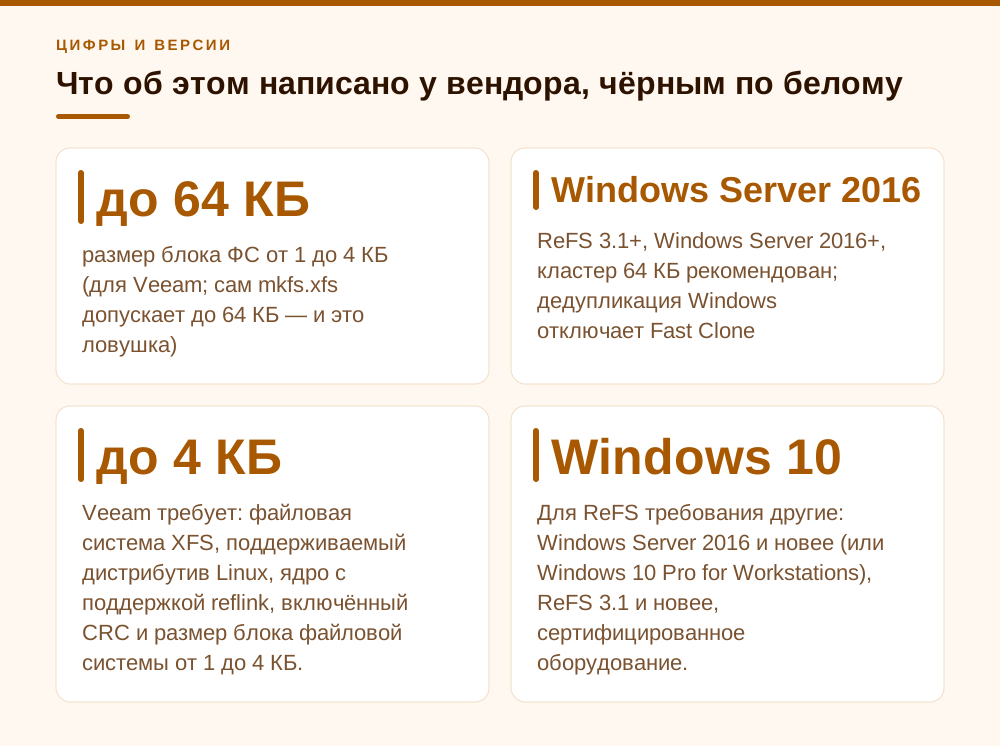
Заодно зафиксируем требования к самому репозиторию, потому что половина проблем с Fast Clone начинается ещё на этапе mkfs. Veeam требует: файловая система XFS, поддерживаемый дистрибутив Linux, ядро с поддержкой reflink, включённый CRC и размер блока файловой системы от 1 до 4 КБ. Эталонная строка форматирования из документации:
# размечаем том под репозиторий Veeam
mkfs.xfs -b size=4096 -m reflink=1,crc=1 /dev/sda1

mkdir /backups
mount /dev/sda1 /backups
df -hT

# в /etc/fstab — строго по UUID
blkid /dev/sda1
# UUID=<UUID>  /backups  xfs  defaults  0  0
Обратите внимание на нюанс, который в документации Veeam уже устарел: там reflink=1 подписан как «disabled by default». В современных xfsprogs это давно не так — актуальная man-страница mkfs.xfs говорит «By default, mkfs.xfs will create reference count btrees and therefore will enable the reflink feature», и CRC тоже включён по умолчанию. Но полагаться на дефолты я всё равно не советую: дефолты менялись между версиями xfsprogs, а на томах, размеченных когда-то на CentOS 7, reflink не поддерживался вообще. Пишите флаги явно и проверяйте результат.
Для ReFS требования другие: Windows Server 2016 и новее (или Windows 10 Pro for Workstations), ReFS 3.1 и новее, сертифицированное оборудование. Veeam выравнивает блоки по границе 4 или 64 КБ в зависимости от тома и рекомендует форматировать ReFS с кластером 64 КБ для больших объёмов. Размер кластера после форматирования не меняется, поэтому задаю его явно:
# том под репозиторий Veeam на ReFS, кластер 64 КБ
Format-Volume -DriveLetter R -FileSystem ReFS -AllocationUnitSize 65536 -NewFileSystemLabel VeeamRepo

# проверить размер кластера существующего тома
fsutil fsinfo refsinfo R:- ФС — XFS, дистрибутив из списка поддерживаемых Veeam; ядро с поддержкой reflink
- CRC включён (crc=1) — обязательное условие для reflink
- размер блока ФС от 1 до 4 КБ (для Veeam; сам mkfs.xfs допускает до 64 КБ — и это ловушка)
- ReFS 3.1+, Windows Server 2016+, кластер 64 КБ рекомендован; дедупликация Windows отключает Fast Clone
- для SOBR — политика размещения Data Locality, иначе файлы цепочки расползутся по экстентам и Fast Clone не сработает
Разбор из практики: бизнес-консалтинг на 22 рабочих места, переезд с 8 на 14,5 ТБ
Условно назову клиента «РостБизнеса» — бизнес-консалтинг, 22 рабочих места, один хост ESXi, 8 виртуалок: контроллер домена, файловый сервер с проектными архивами, 1С, терминальный сервер, почтовый шлюз и пара служебных машин. Veeam Backup & Replication 13. Репозиторий — отдельный физический сервер под Ubuntu 22.04 LTS, RAID6 из пяти дисков по 3 ТБ, около 8,2 ТБ полезного объёма, XFS размечен как положено: -b size=4096 -m reflink=1,crc=1. Задания: forever forward incremental, синтетический full по субботам, ретенция 14 точек плюс GFS — 4 недельных и 6 месячных. Логический размер полного бэкапа всех ВМ — 2,1 ТБ, суточный инкремент 35–60 ГБ.
Задача была простая: массив старый, диски подходили к 6 годам аптайма, купили новый — RAID6 из шести дисков по 4 ТБ, примерно 14,5 ТБ, Ubuntu 24.04 LTS. Админ клиента (толковый, кстати, парень) решил сэкономить окно и перенести файлы сам, ночью, через rsync по 10-гигабитной линковке между серверами. Команда была абсолютно правильная с точки зрения сохранения атрибутов — и абсолютно неправильная с точки зрения Fast Clone:
# то, что запустили ночью — и то, чего делать было нельзя
rsync -aHAX --numeric-ids --info=progress2 \
      /mnt/old-repo/ /backup/
# ...
# rsync: write failed on "/backup/rostbiz/rostbiz2026-08-29T220112.vbk": \
#   No space left on device (28)
Четырнадцать часов спустя — ENOSPC на 14,4 ТБ из 16. На новом томе лежали три раздутых синтетических full по 2,1 ТБ, четыре недельных GFS-точки полного размера и часть месячных. Экономия, которую Fast Clone накопил за год работы, испарилась ровно за одну ночь. Хуже того: даже если бы объём чудом влез, Fast Clone на вручную перенесённых цепочках не активировался бы до active full или compact, и синтетические full создавались бы полным физическим копированием. Субботнее окно вместо 9 минут выросло бы примерно до полутора часов.
Как разрулили. Новый том вычистили полностью (rm -rf по каталогу репозитория — файлы всё равно ещё нигде не были зарегистрированы), пересоздали ФС теми же флагами, добавили новый репозиторий в консоль Veeam и запустили штатный Move Backup по каждому заданию по очереди. Перенос всех цепочек занял около 6 часов вместо 14 — потому что Veeam физически писал уникальные блоки один раз, а не гонял по проводу 16 ТБ. Итог на новом томе: df показывает 3,8 ТБ занято, du — около 16 ТБ. Разделяемость сохранена. Первый синтетический full в ближайшую субботу добавил к df 18 ГБ и уложился в 10 минут. Это и был признак, что всё сделано правильно.
- ручной rsync: 14 часов, 14,4 ТБ по проводу, ENOSPC, Fast Clone мёртв
- Move Backup: около 6 часов, 3,8 ТБ на целевом томе, экономия сохранена
- контрольный синтетический full после переезда: +18 ГБ к df, 10 минут вместо ~1,5 часа
Как переезжать правильно: Move Backup, а не файловый менеджер
Мой рабочий порядок переезда репозитория, который я применяю уже не первый год и ни разу не пожалел. Он занимает больше календарного времени, чем «скопировал и забыл», но не требует ни одного лишнего терабайта.
Пара честных оговорок, чтобы не создавать ложных ожиданий. Move Backup — не мгновенная операция и не «переименование указателя». Данные реально читаются с источника и пишутся на приёмник, просто пишется в разы меньше: уникальные блоки один раз, остальное — клонирование уже на целевом томе. По документации Fast Clone используется в том числе для операций «move backups to another repository» и «copy backups to another repository», а в разделе Limitations для Linux-репозиториев отдельно сказано, что при использовании штатных функций copy и move active full после переноса не нужен. Переносится всё задание целиком: Veeam перенастраивает его на новый репозиторий, а если перенос упал, помечает сессию статусом User action required и держит исходное задание выключенным, пока вы не выберете retry, отмену или отвязку упавших бэкапов.
Где Move Backup не главный инструмент. Если репозиторий — экстент scale-out, переносом занимается Evacuate: при экстентах с Fast Clone Veeam выбирает целевой экстент, где есть переиспользуемые блоки, и собирает новый файл из них, так что эвакуированные бэкапы не занимают полного объёма. Но при эвакуации с hardened-репозитория Veeam копирует, а не перемещает, и блоки на источнике удалятся только после истечения иммутабельности — место под это надо закладывать. VeeamZIP к переезду отношения не имеет: это разовая полная копия ВМ в отдельный .vbk, она заново читает продуктив и существующую цепочку не переносит. А Export backups синтезирует независимый full из выбранной точки — годится для архива, но не для переезда цепочки. И наконец, если вы просто переносите каталог в пределах той же файловой системы, mv экстенты не трогает — но Veeam всё равно считает цепочку перенесённой вручную, так что делайте это только через консоль.
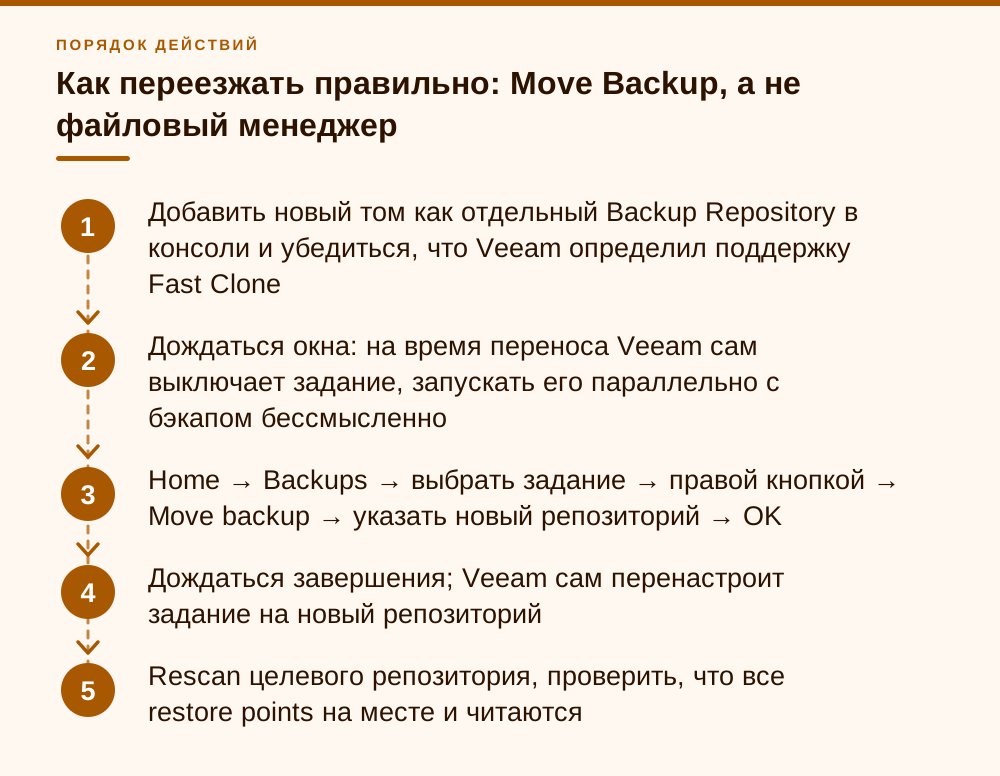
- Добавить новый том как отдельный Backup Repository в консоли и убедиться, что Veeam определил поддержку Fast Clone
- Дождаться окна: на время переноса Veeam сам выключает задание, запускать его параллельно с бэкапом бессмысленно
- Home → Backups → выбрать задание → правой кнопкой → Move backup → указать новый репозиторий → OK
- Дождаться завершения; Veeam сам перенастроит задание на новый репозиторий
- Rescan целевого репозитория, проверить, что все restore points на месте и читаются
- Только после проверки — вывести старый репозиторий из конфигурации и стереть данные
Если уже перенесли руками: как чинить
Ситуация «место кончилось, а старый массив уже отдали» встречается регулярно. Тут два документированных пути, и оба работают. Первый — active full: Veeam пишет новый полноценный .vbk, и именно от него дальше начинают строиться синтетические full через Fast Clone. Второй — операция Compact full backup file, которую документация Veeam прямо предлагает как альтернативу active full для активации Fast Clone. Компакт дешевле по нагрузке на источник (виртуалки заново не читаются), но полный файл переписывается в новый, и на время операции я закладываю на репозитории свободное место размером с полный бэкап — даже если Fast Clone в итоге сэкономит часть.
Чего ни один из этих способов НЕ делает — так это не сжимает задним числом уже раздутые точки восстановления. Три ваших раздутых субботних full как занимали по 2,1 ТБ, так и будут занимать. Место вернётся только тогда, когда они выпадут по ретеншену. При 14 точках это две недели, а при GFS с шестью месячными копиями — до полугода. Это надо считать заранее и держать запас ёмкости на весь переходный период, иначе вы получите вторую волну ENOSPC уже в штатном режиме.
Мой практический алгоритм разгребания, когда переезд уже сделан неправильно. Сначала считаем: сколько занимает раздутая цепочка сейчас, сколько добавит active full, влезет ли сумма. Если не влезает — сокращаем GFS-хвост осознанно, руками, через Delete from disk на самых старых точках, а не ждём, пока Veeam сам споткнётся. Дальше запускаем active full по одному заданию за ночь, не всё разом: одновременный полный проход по всем виртуалкам нагружает и хост, и файловый сервер в рабочие часы консультантов, если окно затянется. После каждого active full сверяем дельту df на следующем синтетическом full — если она в единицы процентов от размера .vbk, Fast Clone ожил.
И честно про спорный момент: у меня нет твёрдого мнения, что лучше — active full или compact. Compact быстрее и не трогает продуктивные ВМ, но при повреждённой цепочке он это повреждение унаследует. Active full дороже, зато даёт заведомо чистую точку отсчёта, не зависящую от предыдущих файлов. Если репозиторий переезжал после аварии массива — я всегда беру active full, даже если compact формально достаточно.
- Active full — надёжнее, читает продуктив заново, даёт независимую точку
- Compact full backup file — дешевле по нагрузке на ВМ, но закладывайте запас свободного места ~ размер полного бэкапа
- Ни то, ни другое не ужимает уже перенесённые раздутые точки — ждём ретеншен
- Не запускать active full по всем заданиям в одну ночь
Проверка и типовые грабли: как убедиться, что Fast Clone реально работает
Fast Clone не выдаёт баннера «я включился». Он либо тихо работает, либо тихо не работает, и разница видна только по цифрам. Первым делом — проверка самой файловой системы. Если в выводе стоит reflink=0, дальше можно не искать: Fast Clone на этом томе не будет никогда.
$ xfs_info /backup | grep -E 'reflink|crc=|bsize'
meta-data=/dev/mapper/vg0-backup isize=512  agcount=32, agsize=...
         =                       crc=1        finobt=1, sparse=1, rmapbt=0
         =                       reflink=1    bigtime=1 inobtcount=1
data     =                       bsize=4096   blocks=..., imaxpct=1
И вот самая неприятная грабля из всех: reflink нельзя включить на уже созданной файловой системе. Утилита xfs_admin умеет добавлять на живой V5-ФС только inobtcount, bigtime, nrext64 и exchange — reflink в этом списке отсутствует. Никакого офлайн-апгрейда нет. Если том размечен с reflink=0 (а такими были все XFS, созданные на CentOS 7, где эта фича вообще не поддерживалась), единственный путь — эвакуировать данные, пересоздать ФС через mkfs и вернуть бэкапы обратно, разумеется, через Move Backup.
Вторая по частоте ошибка — размер блока. Народ по привычке размечает «под большие файлы» с -b size=65536, потому что «так быстрее для терабайтных .vbk». mkfs.xfs это позволит (максимум у него 65536 байт), но Linux может смонтировать XFS только с блоком не больше размера страницы памяти, так что на обычном x86_64 такой том на старых ядрах просто не примонтируется. На свежих ядрах с поддержкой крупных блоков он смонтируется, но Veeam поддерживает только диапазон от 1 до 4 КБ, и рассчитывать на Fast Clone нельзя. Оставляйте 4096, это и дефолт, и то, что нужно Veeam.
Финальная проверка — она же самая надёжная, потому что не верит настройкам, а измеряет результат. Снимаем занятое место до синтетического full и после. Если .vbk на 2,1 ТБ добавил к использованию тома десятки гигабайт — всё хорошо. Если добавил 2,1 ТБ — Fast Clone не работает, идём разбираться. Дополнительно можно посмотреть флаг shared у экстентов конкретного файла через filefrag.
# замер до и после синтетического full
$ df --output=used -B1 /backup
     3903017984000
# ... отработало задание с synthetic full на 2,1 ТБ ...
$ df --output=used -B1 /backup
     3920974872576      # +18 ГБ вместо +2,1 ТБ — Fast Clone жив

# разделяемые экстенты конкретного файла
$ filefrag -v /backup/rostbiz/rostbiz2026-09-05T220117.vbk | grep -c shared
Отдельно про оценку реального места, потому что это вечный вопрос перед переездом. Истина по занятому месту — только df (или xfs_spaceman -c 'freesp -s', который показывает сводку по свободным экстентам). Команды, которая бы посчитала «сколько байт разделено reflink», в xfs_spaceman нет, так что объём ручного копирования оценивайте по du, а фактический расход — по df. На ReFS аналогично: «Размер на диске» в свойствах папки считает клонированные блоки каждого файла заново, а правду показывает свободное место тома.
# XFS: сводка свободного места по экстентам
$ xfs_spaceman -c 'freesp -s' /backup

# Windows/ReFS: реально свободное место тома
PS> Get-Volume -DriveLetter R | Select-Object FileSystem, Size, SizeRemaining- xfs_info /backup | grep -E 'reflink|crc=|bsize' — reflink=1 и crc=1 обязательны
- reflink не добавляется на существующую ФС: xfs_admin -O его не умеет, только mkfs заново
- -b size=65536 = на x86_64 том либо не смонтируется, либо окажется вне поддерживаемого Veeam диапазона 1–4 КБ
- SOBR без Data Locality = файлы цепочки на разных экстентах = Fast Clone не используется
- на Windows/ReFS: дедупликация Windows отключает Fast Clone для задания, а на SMB-репозитории на ReFS с включённой дедупликацией задание упадёт
- главный тест: дельта df до и после синтетического full
Частые вопросы
Можно ли перенести репозиторий Veeam на новый XFS-том обычным rsync и ничего не потерять?
Нет. reflink работает только внутри одной файловой системы, поэтому любое копирование средствами ОС на новый том разворачивает синтетические full до полного физического размера. Дополнительно Fast Clone на такой перенесённой цепочке не активируется, пока вы не сделаете active full или compact. Штатный путь — функция Move Backup в консоли Veeam.
Почему du показывает в разы больше, чем df, на моём репозитории?
Это нормально и это хороший признак. На XFS с reflink один физический экстент разделяется между несколькими файлами бэкапа. df считает физически занятые блоки один раз, du складывает блоки каждого файла отдельно. Разница между ними примерно равна экономии, которую вам даёт Fast Clone.
Я уже перенёс файлы вручную. Что делать — active full или compact?
Документация Veeam допускает оба варианта: active full или запланированная операция Compact full backup file. Active full надёжнее, так как создаёт независимую точку и не наследует возможные проблемы существующей цепочки, но заново читает продуктив. Compact дешевле по нагрузке на виртуалки, но требует свободного места на репозитории примерно в размер полного бэкапа. После аварии массива я всегда беру active full.
Вернётся ли место сразу после active full?
Нет. Active full возвращает Fast Clone только для новых точек. Уже раздутые точки восстановления так и останутся полного размера и освободят место только когда выпадут по ретеншену — при 14 точках это около двух недель, при GFS с месячными копиями до полугода. Ёмкость на переходный период надо планировать заранее.
Как быстро проверить, включён ли reflink на существующем томе, и можно ли его добавить?
Смотрите вывод `xfs_info /путь` — нужны reflink=1 и crc=1. Добавить reflink на уже созданную файловую систему нельзя: xfs_admin -O умеет только inobtcount, bigtime, nrext64 и exchange. Единственный вариант — эвакуировать данные, пересоздать ФС через mkfs.xfs с нужными флагами и вернуть бэкапы через Move Backup.
Почему Fast Clone не работает, хотя reflink=1 и всё по инструкции?
Три самые частые причины: размер блока файловой системы больше 4 КБ (Veeam поддерживает диапазон 1–4 КБ, а mkfs.xfs позволяет задать до 64 КБ), цепочка была перенесена вручную и не получала active full или compact, либо репозиторий входит в scale-out без политики Data Locality и файлы цепочки разъехались по разным экстентам. Проверяется всё одним тестом: замерьте дельту df до и после синтетического full.
На Windows с ReFS можно перенести бэкапы robocopy?
Скопировать можно, но экономия пропадёт так же, как с rsync на XFS: Veeam предупреждает, что при копировании с ReFS-тома клонированные блоки вычитываются и данные занимают на приёмнике больше места. Block cloning работает только в пределах одного ReFS-тома. Переносите через Move Backup, а новый том форматируйте в ReFS с кластером 64 КБ.
Как оценить, сколько места реально займёт перенос?
Если переносит Veeam (Move Backup, эвакуация), ориентируйтесь на df источника плюс запас. Если копировать средствами ОС — на du, потому что именно столько байт будет записано. xfs_spaceman -c 'freesp -s' покажет свободное место по экстентам, но счётчика разделяемых reflink-блоков в нём нет.
Источники
- Veeam Backup & Replication 13 User Guide — Fast Clone — Раздел Backup Infrastructure Components → Backup Repositories → Managing Backup Repositories → Fast Clone. Требования для Linux-репозиториев (XFS, reflink, CRC, размер блока 1–4 КБ), эталонная строка mkfs.xfs, блок Limitations про ручной перенос цепочек и необходимость active full или compact. Страница обновлена 2026-07-20, содержимое для сборки 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/backup_repository_block_cloning.html?ver=13
- Veeam KB1729 — How to Relocate Backup Files — Штатные и legacy-способы переноса бэкапов, предупреждения о ручном переносе на ReFS/XFS: Fast Clone не используется до нового active full, spaceless synthetic full разворачиваются до полного размера. https://www.veeam.com/kb1729
- mkfs.xfs(8), man-страница — Опции -m reflink=, -m crc=, -b size=. Актуальный текст: «By default, mkfs.xfs will create reference count btrees and therefore will enable the reflink feature»; reflink доступен только при -m crc=1; размер блока по умолчанию 4096 байт, минимум 512, максимум 65536. https://man7.org/linux/man-pages/man8/mkfs.xfs.8.html
- xfs_admin(8), man-страница — Опция -O «Add or remove features on an existing V5 filesystem» — поддерживаются inobtcount, bigtime, nrext64, exchange. Reflink в списке отсутствует, то есть включить его на существующей ФС невозможно. https://man7.org/linux/man-pages/man8/xfs_admin.8.html
- Veeam Backup & Replication 13 User Guide — Moving Backups — Порядок Home → Backups → Move backup, перенастройка задания на новый репозиторий, обработка упавших переносов (User action required). https://helpcenter.veeam.com/docs/vbr/userguide/move_backup.html?ver=13
- Veeam Backup & Replication 13 User Guide — Evacuating Backups from Extents — Эвакуация с экстентов SOBR: выбор экстента с переиспользуемыми блоками при Fast Clone, копирование вместо перемещения для hardened-репозиториев, иммутабельность. https://helpcenter.veeam.com/docs/vbr/userguide/sobr_evacuate.html?ver=13
- xfs_spaceman(8), man-страница — Команды freesp (-s — сводка), info, health, prealloc, trim. https://man7.org/linux/man-pages/man8/xfs_spaceman.8.html
- Veeam Backup & Replication 13 User Guide — VeeamZIP — VeeamZIP всегда создаёт полный независимый .vbk из ВМ — не инструмент переноса цепочки. https://helpcenter.veeam.com/docs/vbr/userguide/veeamzip.html?ver=13