
Перенос Veeam с Windows на Linux-апплаенс: почему обновление до 13.1 закрывает вам дверь
Если вы собрались уходить с Windows-сервера Veeam на Linux-апплаенс (VSA) и по привычке начали с «сначала накатим самый свежий релиз» — остановитесь. Обновление до 13.1 отрезает поддерживаемый путь конвертации, причём безвозвратно. Ниже — правильный порядок действий, живой разбор переноса в финансово-консультационной компании на 47 рабочих мест, список того, что обязательно отвалится после миграции, и честный ответ на вопрос «а может, вообще не мигрировать».
Сначала про грабли: 13.1 — это билет в один конец
Логика «обновимся до последней версии, а потом уже будем переезжать» в случае с Veeam 13 не работает. Veeam явно ограничил конвертацию Windows → Linux веткой 13.0.x. В KB4800 (Platform Migration Guide), последняя правка 10 сентября 2026 года, написано прямым текстом: путь протестирован и поддерживается только для Veeam Backup & Replication 13.0.x, на 13.1 он не валидировался и поддерживаться не будет. Целевой апплаенс — Veeam Software Appliance версии 13.0.3.
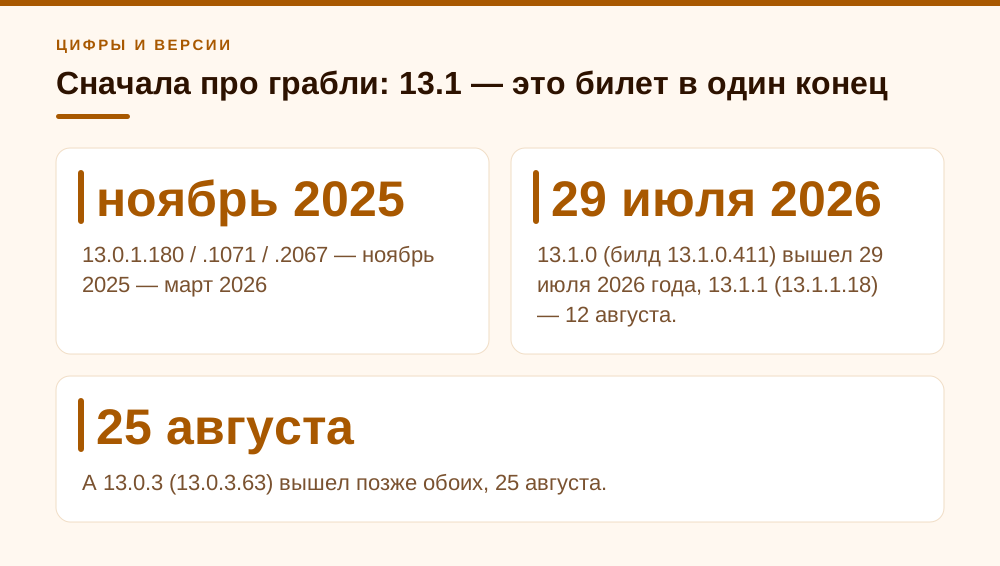
Сам апплаенс не новинка 13.1: Veeam Software Appliance поставляется с первого релиза v13 — билд 13.0.0.4967 от 3 сентября 2025 года. Меняется не наличие VSA, а то, с какой ветки на него разрешено конвертироваться. Обратите внимание на хронологию релизов, она сама по себе объясняет замысел вендора. 13.1.0 (билд 13.1.0.411) вышел 29 июля 2026 года, 13.1.1 (13.1.1.18) — 12 августа. А 13.0.3 (13.0.3.63) вышел позже обоих, 25 августа. То есть Veeam специально продолжает патчить «старую» ветку 13.0.x — именно для тех, кто ещё не переехал. Это не забытая линия, это коридор миграции, который держат открытым какое-то время.
Что происходит, если вы уже улетели на 13.1. Штатного даунгрейда у Veeam нет: конфигурационный бэкап с 13.1 в инсталляцию 13.0.x не восстановится, версии не совпадут. Остаётся либо жить на Windows дальше и ждать, пока Veeam (может быть) откроет конвертацию с более новых веток, либо разворачивать VSA с нуля и заводить задания заново — greenfield. Я специально пишу «может быть»: на сегодня у вендора нет публичных обязательств по срокам, и планировать на этом нельзя.
Есть и вторая половина той же ошибки — обратной дороги нет вообще. Миграция Linux → Windows не предусмотрена, и в KB4800 сказано, что такая функциональность даже не планируется. Значит, апплаенс — решение, которое стоит сначала пощупать на стенде, а не «попробовать на бою и откатиться».
- 13.0.0.4967 — 03.09.2025
- 13.0.1.180 / .1071 / .2067 — ноябрь 2025 — март 2026
- 13.0.2.29 — 27.05.2026
- 13.1.0.411 — 29.07.2026, 13.1.1.18 — 12.08.2026
- 13.0.3.63 — 25.08.2026 (ветка миграции, вышла ПОСЛЕ 13.1)
Что вы получаете на выходе и кому это реально нужно
Veeam Software Appliance — это не «Veeam, установленный на Linux руками». Это закрытая сборка: при установке Rocky Linux, VBR и компоненты апплаенса разворачиваются с предопределённой разбивкой томов и учётками; система соответствует большинству требований DISA STIG для RHEL 9 (в документации перечислены четыре исключения, включая FIPS 140-3 и deny-all на межсетевом экране); при первичной настройке создаются учётка администратора хоста и отдельная учётка Security Officer, а обновления ОС и продукта управляются самим апплаенсом. Управление — через веб-консоль хоста (Host Management Console) и веб-интерфейс самого VBR. Классической MMC-консоли на сервере больше нет.
Ради чего это всё. Windows-сервер резервного копирования — исторически самая сладкая цель для шифровальщика: он в домене, у него привилегии на гипервизор и на репозитории, на нём RDP. Апплаенс убирает из уравнения целый класс проблем: доменная учётка администратора домена больше не рулит бэкап-сервером, нет привычного RDP, нет свободной установки стороннего софта, нет «мы тут антивирус подкрутили и служба не стартует». По моей практике из десятка инцидентов с шифровальщиками у клиентов на 20–50 рабочих мест минимум в трёх бэкапы дожили только потому, что репозиторий был вне домена. Апплаенс двигает в ту же сторону сам бэкап-сервер.
Теперь честно про минусы, потому что их продают хуже. Вы теряете гибкость: не поставите на бэкап-сервер агент мониторинга, свой скрипт по расписанию или сторонний коннектор. Часть интеграций остаётся Windows-only — по KB4800 конфигурация Veeam Plug-in for Google Cloud и Veeam Plug-in for oVirt при миграции не переносится, Linux-сервер бэкапа не поддерживает кластеры Hyper-V в рабочей группе и функцию SCVMM High Availability. Добавьте к этому ограничения самого апплаенса из User Guide: нельзя ставить сторонний софт, нельзя бэкапить апплаенс сторонними средствами или Veeam Agent for Linux, не поддерживается trusted domain authentication, установка возможна только на выделенную пустую машину без multipath-устройств, а для VMware доступны транспорты Network и Virtual Appliance (HotAdd). Перед решением надо сверять свою конфигурацию со списком неподдерживаемого, а не «переносить и разбираться по ходу».
Кому я это честно не рекомендую прямо сейчас: тем, у кого лицензии посокетные (VSA требует instance-based Veeam Universal License), тем, у кого в контуре Veeam Cloud Connect (такие инсталляции на апплаенс не мигрируют), и тем, у кого Veeam стоит на одной машине с чем-то ещё — файловой шарой, лицензионным сервером, «и заодно там 1С-обменник крутится». Последним сначала нужно разъехаться по ролям, и только потом думать про Linux.
Отдельно про железо, потому что апплаенс сайзят иначе, чем Windows-сервер. По System Requirements VBR 13 минимум — 8 ядер (vCPU) и 16 ГБ RAM плюс 500 МБ на каждое одновременное задание; для совсем маленьких сред до 5 машин хватает 6 vCPU. Дисков два: Disk 1 (система, конфигурационная БД, кэш instant recovery) — минимум 240 ГБ, рекомендовано 480 ГБ SSD для сред до нескольких сотен машин; Disk 2 (каталоги гостевых ФС и бэкапы) — тоже от 240 ГБ, размер по объёму хранения. Системным апплаенс сам выбирает SSD, а из двух дисков — меньший. Поддерживаются только локальные диски и аппаратный RAID, увеличивать размер существующих локальных дисков после развёртывания нельзя — поэтому размер закладывайте сразу.
- Минимум 8 vCPU и 16 ГБ RAM + 500 МБ на одновременное задание (до 5 машин — 6 vCPU)
- Disk 1 от 240 ГБ, рекомендовано 480 ГБ SSD; Disk 2 от 240 ГБ под каталоги и бэкапы
- Только выделенная пустая машина: ISO, OVA (ESXi 7.0 U2+) или шаблон Hyper-V
- Лицензия — только instance-based VUL, посокетные не мигрируют
- Без стороннего ПО, без trusted domain authentication, без SCVMM HA
- Не мигрируют: Cloud Connect, конфигурации плагинов Google Cloud и oVirt
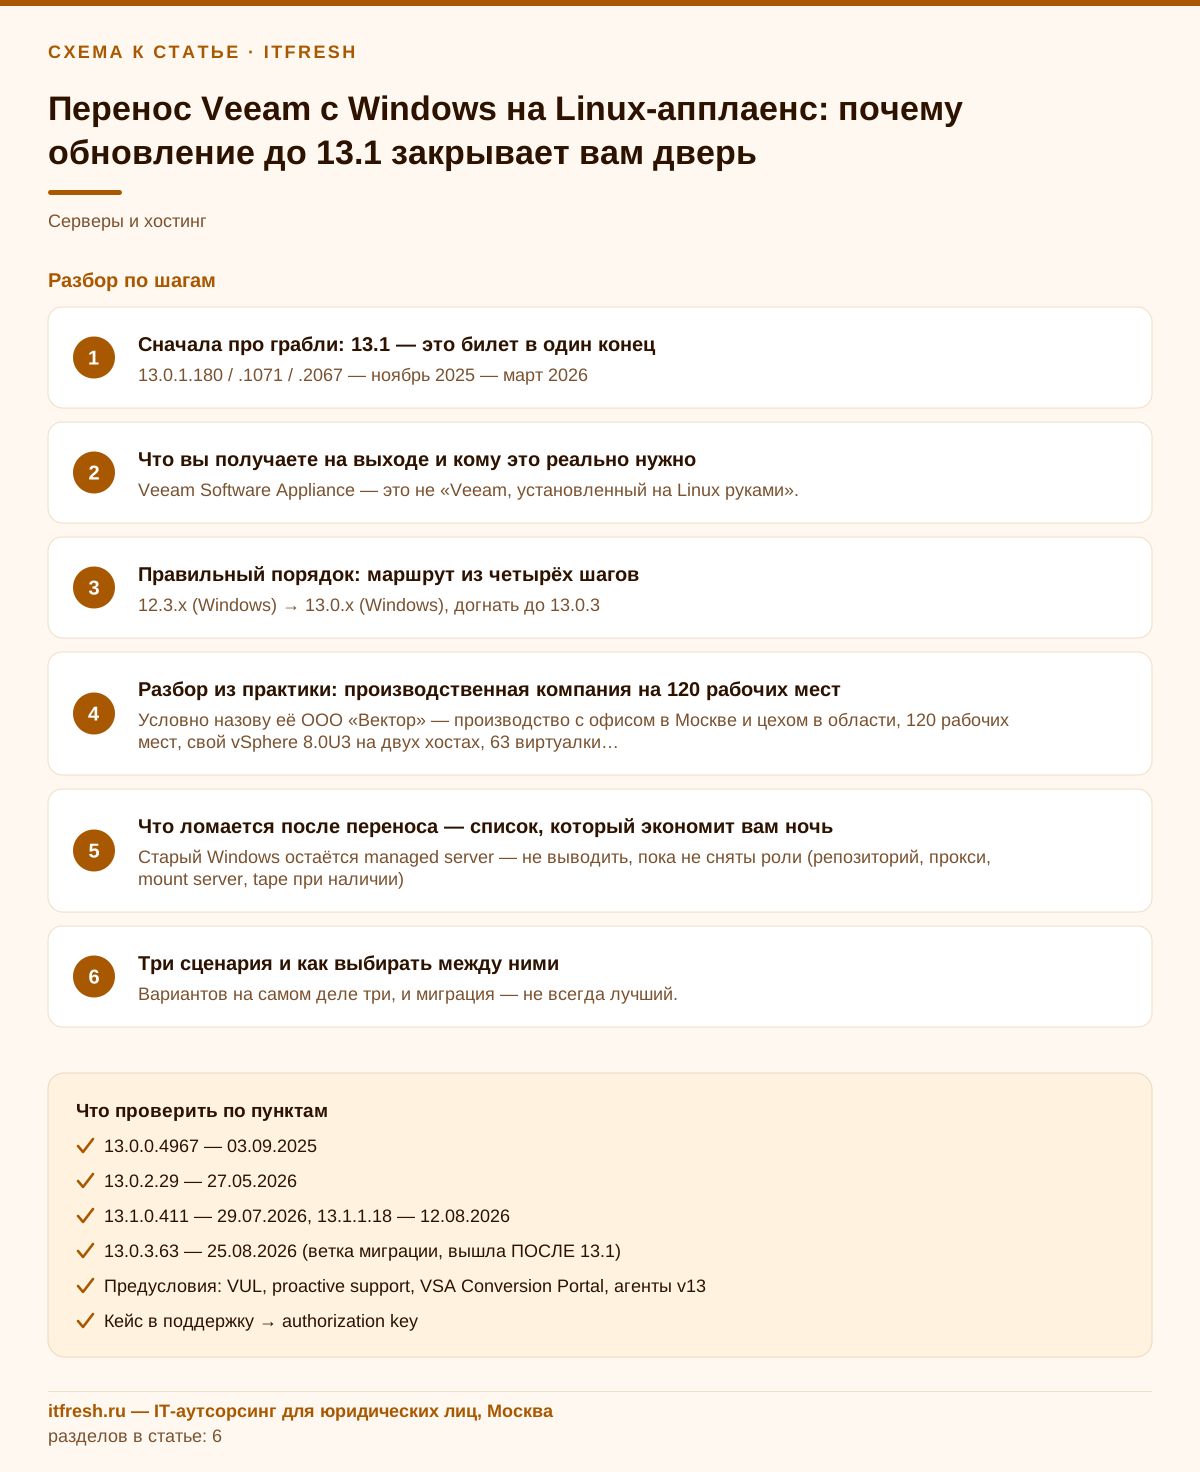
Правильный порядок: маршрут из четырёх шагов
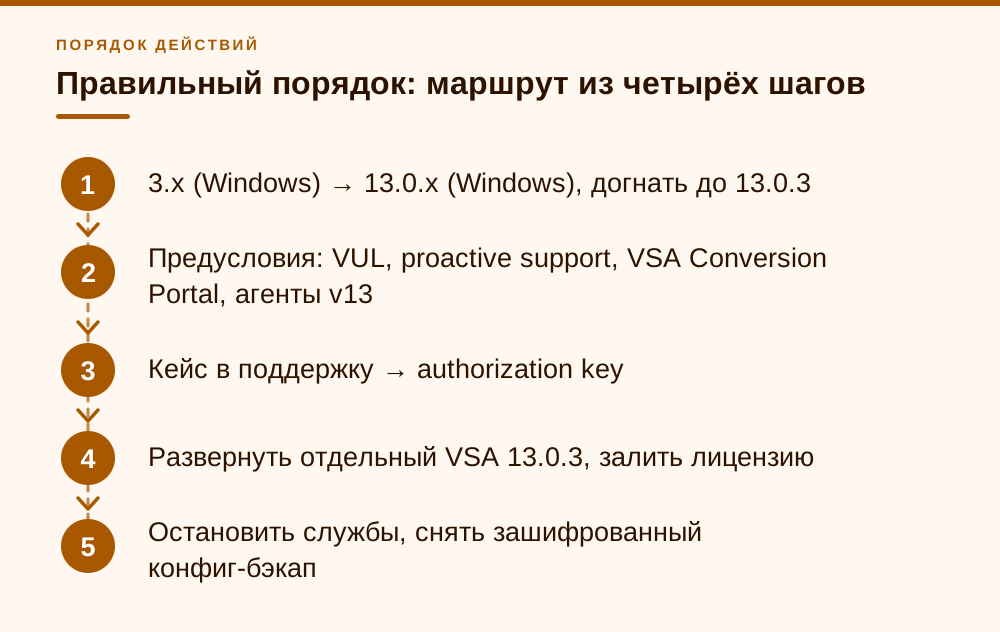
Маршрут выглядит так и меняться местами шаги не могут. Первое: с 12.3.x обновляемся на Windows до 13.0.x и доводим до последнего патча ветки (сейчас это 13.0.3). Второе: разворачиваем отдельную виртуалку с Veeam Software Appliance 13.0.3 — именно отдельную, поверх существующего VBR-сервера конвертация не делается, это должна быть чистая машина. Третье: переносим конфигурацию в режиме Migrate. И только четвёртое — уже на апплаенсе поднимаемся на 13.1.
Параллельно с обновлением до 13.0.x закрываются предусловия, и вот их обычно недооценивают по времени. Нужна инстансная лицензия VUL. Нужно включить в продукте опцию «Receive proactive support» — по ней Veeam оценивает, переносима ли ваша конфигурация. Нужно зарегистрироваться на VSA Conversion Portal и пройти его обязательный чек-лист. Все агенты Veeam на удалённых машинах должны быть подняты до версии 13 — вот это даже на 47 рабочих местах с ноутбуками консультантов, которые неделями не появляются в офисе, занимает неделю-другую.
Дальше — момент, который отличает эту миграцию от обычного обновления: она контролируемая вендором. Вы открываете кейс в поддержке Veeam, там проверяют, что предусловия выполнены и в конфигурации нет неподдерживаемых вещей, и выдают authorization key. Без этого ключа режим Migrate на апплаенсе просто не пройдёт. Планируйте на переписку с поддержкой минимум неделю до окна работ, а не «в пятницу вечером напишем».
Перед тем как что-то планировать, посмотрите, на каком билде вы стоите на самом деле — «у нас тринадцатая» ничего не значит, когда разница между 13.0.3 и 13.1.1 решает судьбу проекта:
# Точный билд установленного VBR на Windows-сервере
(Get-Item 'C:\Program Files\Veeam\Backup and Replication\Backup\Veeam.Backup.Service.exe').VersionInfo.ProductVersion

# Есть ли задание конфигурационного бэкапа и включено ли шифрование
Import-Module Veeam.Backup.PowerShell
Get-VBRConfigurationBackupJob | Format-List *
Сама техническая часть в день Х короткая. На Windows-сервере останавливаются и отключаются службы Veeam (в KB4800 перечислены десять служб — Veeam Backup Service, Veeam Broker Service, Veeam Data Analyzer Service и другие, там же готовый PowerShell-скрипт), создаётся зашифрованный конфигурационный бэкап с паролем. Затем на апплаенсе в Host Management Console запускается Configuration Restore, выбирается режим Migrate, загружается файл .bco, вводятся пароль шифрования, имя исходного Windows-сервера, учётные данные сервисной учётки и тот самый authorization key.
- 12.3.x (Windows) → 13.0.x (Windows), догнать до 13.0.3
- Предусловия: VUL, proactive support, VSA Conversion Portal, агенты v13
- Кейс в поддержку → authorization key
- Развернуть отдельный VSA 13.0.3, залить лицензию
- Остановить службы, снять зашифрованный конфиг-бэкап
- Configuration Restore в режиме Migrate на VSA
- Проверка, апгрейд компонентов на удалённых хостах
- Только теперь — обновление апплаенса до 13.1
Разбор из практики: финансовый консалтинг на 47 рабочих мест
Условно назову её «Актив Плюс» — финансово-консультационная компания в Москве, 47 рабочих мест, из них треть — консультанты с ноутбуками на выездах. Свой vSphere 8.0U3 на двух хостах, 17 виртуалок (1С, файловый сервер, CRM, почтовый шлюз, терминальный сервер), около 6,5 ТБ полезных данных. Бэкап-сервер — физический Dell PowerEdge с Windows Server 2019, VBR 12.3, база конфигурации PostgreSQL, локальный репозиторий на DAS 24 ТБ и второй — hardened repository на отдельной коробке с Rocky Linux. Задача от собственника формулировалась просто: «у нас клиентская финансовая отчётность, после истории у коллег по рынку хочу, чтобы бэкап нельзя было убить из домена».
Работали в три захода. В июне подняли Windows-инсталляцию с 12.3 до 13.0.2 — это заняло одно вечернее окно на 3 часа плюс двое суток наблюдения за заданиями. В июле выкатили агенты v13 на 44 машины через существующие Protection Groups (три ноутбука консультантов доехали позже, руками). В августе, уже на 13.0.3, открыли кейс в поддержке. Ключ авторизации пришёл на второй рабочий день после того, как саппорт посмотрел логи и подтвердил, что неподдерживаемых конфигураций нет — у нас удачно не было ни Cloud Connect, ни Google-плагина.
Апплаенс развернули на vSphere отдельной ВМ из OVA: 8 vCPU, 24 ГБ RAM (16 ГБ базы плюс запас на одновременные задания), Disk 1 480 ГБ на SSD-датасторе, Disk 2 2 ТБ — под основной репозиторий на апплаенсе. Системным апплаенс выбирает меньший диск, так что перепутать не получится. Окно работ выпросили на 4 часа в субботу, уложились в 2 часа 10 минут. Конфигурационный бэкап .bco получился около 400 МБ, заливка через веб-консоль заняла пару минут, сам Configuration Restore в режиме Migrate — примерно 25 минут. Дальше — апгрейд компонентов на удалённых хостах и первый тестовый прогон.
# Перед снятием конфига: штатный список служб — в KB4800, в лабе останавливали все Veeam*
Get-Service Veeam* | Stop-Service -Force
Get-Service Veeam* | Set-Service -StartupType Disabled
Get-Service Veeam* | Select-Object Name, Status, StartType
Чем закончилось. Полный прогон всех заданий в ночь после миграции прошёл с двумя ошибками, обе — из-за учётных данных: доменные креды на апплаенсе требуются в формате UPN (user@fqdn), привычный DOMAIN\user не годится. Пересоздали, пересканировали Protection Groups — стало чисто. Старый Windows-сервер остался в консоли как managed server, и его локальный репозиторий на 24 ТБ никуда не делся: доступ к старым точкам восстановления сохранился. Роль репозитория с него сняли только через месяц, когда backup copy добила данные на новую площадку. Восстановление тестовой ВМ из «старой» цепочки после миграции проверяли отдельно — поднялось.
А теперь антипример, который я регулярно вижу на аудитах. Типичная картина: админ прошлого подрядчика слышит про «тринадцатую версию» и в профилактический день обновляется на 13.1.1. Через пару недель собственник просит перевести бэкап на апплаенс — и выясняется, что поддерживаемый путь закрыт. Итог: либо остаёмся на Windows до особых распоряжений, либо строим VSA с нуля и переносим два-три десятка заданий руками, теряя историю точек в консоли (сами бэкапы никуда не деваются — их подключают как импортированные). Для офиса такого размера цена одного необдуманного «Update now» — примерно 15–20 человеко-часов и несколько месяцев отложенной безопасности.
- Июнь: VBR 12.3 → 13.0.2 на Windows, окно 3 часа + 2 суток наблюдения
- Июль: агенты v13 на 44 машины через Protection Groups, 3 ноутбука вручную
- Август: 13.0.3, кейс в поддержку, authorization key на второй рабочий день
- Суббота: VSA из OVA, Migrate за ~25 минут, всё окно — 2 ч 10 мин
- Первая ночь: 2 ошибки из-за формата учёток (DOMAIN\user → UPN), rescan Protection Groups
- Через месяц: роль репозитория со старого Windows-сервера снята после backup copy
Что ломается после переноса — список, который экономит вам ночь
Перенос конфигурации — не телепортация. Есть предсказуемый набор вещей, которые после Migrate требуют ручной доводки, и лучше пройтись по нему сразу, чем ловить красные задания в понедельник. Первое и главное — старый Windows-сервер автоматически добавляется в новую консоль как managed server. Это сделано намеренно: его локальные репозитории остаются доступными, значит, доступ к уже существующим точкам восстановления не теряется. Именно поэтому нельзя торопиться с выводом старого сервера из эксплуатации.
Второе — переименования. Дефолтные репозитории при переносе получают префикс Migrated, чтобы не конфликтовать с объектами, которые апплаенс создал у себя сам. Выглядит непривычно, ломает глазами привычные скрипты и отчёты, но переименовывать обратно я не советую — путаницы будет больше. Просто зафиксируйте новое имя в документации.
Третье — учётные данные и сканирование. Доменные креды нужны в UPN-формате. Protection Groups после миграции требуют повторного rescan — до него состояние агентов в консоли будет неактуальным. Если у вас есть удалённые Linux mount-серверы, у них тоже придётся обновить учётные данные. И отдельно проверьте прокси: конфигурация переезжает, но фактическую работоспособность каждого transport-прокси стоит подтвердить тестовым заданием, а не галочкой в интерфейсе.
Четвёртое, про что забывают, — сеть. У апплаенса другой IP, другой набор портов и другой принцип управления. Правила на межсетевом экране, разрешения на СХД, ACL на NAS-репозиториях, whitelist на объектном хранилище — всё это было прописано под старый Windows-сервер. Я всегда прошу заранее подготовить список правил, где фигурирует IP бэкап-сервера, и переписать его в тот же день. Иначе задания на объектное хранилище начнут падать по таймауту, а вы будете искать причину внутри Veeam.
- Старый Windows остаётся managed server — не выводить, пока не сняты роли (репозиторий, прокси, mount server, tape при наличии)
- Репозитории с префиксом Migrated — не переименовывать, а задокументировать
- Доменные учётные записи — только UPN (user@fqdn)
- Rescan всех Protection Groups после миграции
- Обновление учётных данных удалённых Linux mount-серверов
- Пересмотр правил межсетевого экрана и ACL под новый IP апплаенса
- Контрольное восстановление ВМ и файла из «старой» цепочки — обязательно
Три сценария и как выбирать между ними
Вариантов на самом деле три, и миграция — не всегда лучший. Первый: обновление на месте до 13.1 на Windows и жизнь дальше. Подходит, если инфраструктура стабильна, лицензии посокетные, есть Cloud Connect или Windows-only интеграции, и переход на Linux в ближайший год не планируется. Минус очевиден — вы тащите за собой всю накопленную конфигурацию и обслуживание Windows, а дверь в VSA-конвертацию закрываете.
Второй: миграция по описанному маршруту. Подходит, когда конфигурация чистая, задания документированы, лицензия VUL, и вы хотите сохранить историю точек восстановления и структуру заданий. Это мой выбор по умолчанию для клиентов на 20–50 рабочих мест с одним бэкап-сервером и парой репозиториев. Требует дисциплины по версиям и переписки с поддержкой, зато в понедельник у людей всё на своих местах.
Третий: greenfield — чистая установка апплаенса и настройка заданий заново, со старыми бэкапами, подключёнными как импортированные репозитории. Звучит как поражение, но часто это самый честный вариант. Если у вас конфигурации накопились с версии 9.5, половина заданий делалась «на попробовать», документации нет и никто уже не помнит, зачем существует задание с именем test2_new_final — переносить этот музей на новую платформу смысла мало. Плюс greenfield не требует ключа авторизации и не зависит от того, на какой вы ветке.
Про сроки. Veeam Backup & Replication 12 по Product Lifecycle уже вышел из фикс-поддержки (End of Fix — ноябрь 2025) и поддерживается до февраля 2027 года — это не завтра, но и не «когда-нибудь». Если вы на 12.x и хотите на апплаенс, разумная раскладка такая: осенью 2026 — обновление до 13.0.3 и подготовка предусловий, зима — пилот на тестовом стенде и кейс в поддержку, весна 2027 — боевая миграция. Если же вы просто хотите остаться в поддержке и Linux вам не нужен, обновляйтесь до 13.1 спокойно, но тогда решение по VSA примите осознанно и запишите его в протокол, чтобы через полгода не было сюрприза.
- Обновление на месте до 13.1 на Windows — посокетные лицензии, Cloud Connect, Windows-only интеграции
- Миграция 13.0.3 → VSA 13.0.3 — чистая конфигурация, VUL, нужна история точек и структура заданий
- Greenfield на VSA — «музей» конфигураций, уже стоите на 13.1, нет времени на кейс с поддержкой
- Остаться на 12.3 временно — только до февраля 2027 и только с планом перехода
Мои приоритеты: что делать в первую очередь, а на что можно забить
В первую очередь — зафиксируйте версию. Пока у вас нет решения по апплаенсу, выключите автоматическое предложение обновиться и предупредите всех, у кого есть доступ к консоли: кнопку Update не жать. Это самое дешёвое действие в статье и самое дорогое по последствиям, если его не сделать. Одно неосторожное обновление стоит вам всего сценария миграции.
Во вторую — приведите в порядок конфигурацию до переезда, а не после. Удалите мёртвые задания, приведите имена к системе, разнесите роли по машинам, проверьте, что у вас вообще есть актуальный конфигурационный бэкап и что вы знаете пароль его шифрования. По моим наблюдениям, у каждого второго клиента конфигурационный бэкап включён, но пароль шифрования никто не сохранял — а без него он бесполезен. Проверить это можно за десять минут, и это обязательный пункт независимо от миграции.
В третью — проверьте восстановление. Не «задания зелёные», а именно восстановление: поднять ВМ, достать файл, восстановить письмо. До миграции и после. Красивый статус задания и работающая точка восстановления — вещи связанные, но не тождественные, и убеждаться в этом лучше не в день инцидента.
На что можно забить без ущерба. На ручное доведение ОС апплаенса до DISA STIG в первый день — большая часть требований для RHEL 9 выполнена из коробки, а лезть в систему сторонними средствами на VSA всё равно нельзя. На попытки «перетащить всё как было» — часть объектов переименуется, и это нормально. И на спешку с выводом старого сервера: пусть постоит месяц, электричества он ест немного, а нервов экономит много. И, наконец, не гонитесь за 13.1 сразу после переезда — дайте апплаенсу отработать хотя бы полный цикл ретеншена, а потом обновляйтесь.
- Заморозить версию: никаких обновлений до 13.1 до решения по VSA
- Проверить наличие зашифрованного конфиг-бэкапа и сохранность пароля
- Удалить мёртвые задания, разнести роли с бэкап-сервера
- Выяснить тип лицензии (VUL или посокетная) и наличие Cloud Connect
- Сделать контрольное восстановление ВМ, файла и объекта 1С до и после переезда
Частые вопросы
Я уже обновился до 13.1. Совсем нельзя мигрировать на апплаенс?
Поддерживаемым способом — нет. KB4800 ограничивает конвертацию веткой 13.0.x, а штатного даунгрейда с 13.1 на 13.0.x у Veeam нет: конфигурационный бэкап более новой версии в старую инсталляцию не восстанавливается. Реальные варианты два: остаться на Windows и ждать, откроет ли Veeam конвертацию с более новых веток (обещаний по срокам нет), либо развернуть VSA с нуля и настроить задания заново, подключив старые репозитории как импортированные.
Можно ли конвертировать прямо на том же сервере, где стоит Veeam?
Нет. Целевой Veeam Software Appliance должен быть отдельной пустой машиной, которая соответствует системным требованиям (User Guide прямо запрещает ставить апплаенс поверх чего-либо), с версией 13.0.3. Исходный Windows-сервер на момент миграции остаётся живым — с него снимается зашифрованный конфигурационный бэкап, а после переноса он автоматически добавляется в новую консоль как managed server.
Зачем нужен authorization key и где его взять?
Это защитный механизм Veeam: конвертация контролируемая. Вы включаете в продукте опцию Receive proactive support, проходите чек-лист на VSA Conversion Portal и открываете кейс в поддержке. Там проверяют, что предусловия выполнены и в конфигурации нет неподдерживаемых вещей, и выдают ключ. Без него режим Migrate не пройдёт. Закладывайте на это не меньше недели до окна работ.
Что будет со старыми бэкапами после переноса?
Они останутся доступны. Локальные репозитории старого Windows-сервера сохраняют доступность именно потому, что сервер добавляется в новую инфраструктуру как managed server. Поэтому выводить его из эксплуатации сразу нельзя — сначала переносите роли и данные, проверяете восстановление из старых цепочек и только потом гасите машину.
Можно ли вернуться с Linux-апплаенса обратно на Windows?
Нет. В KB4800 прямо сказано, что обратная миграция не предоставляется и такая функциональность не планируется. Поэтому решение про VSA стоит принимать после теста на стенде, а не пробовать сразу на боевом контуре.
Обязательно ли обновлять агенты Veeam перед миграцией?
Да, все агенты Veeam на удалённых машинах должны быть подняты до версии 13 до начала конвертации. Даже в офисе на 47 рабочих мест это самая длинная по календарю часть подготовки — планируйте пару недель с учётом окон и машин, которые появляются в сети нерегулярно.
Источники
- Veeam KB4800 — Veeam Backup & Replication Platform Migration Guide (Windows to Linux). Published 19.02.2026, Last Modified 10.09.2026 — поддержка только 13.0.x, целевой апплаенс 13.0.3, режим Migrate, authorization key, отсутствие обратного пути. https://www.veeam.com/kb4800
- Veeam KB4738 — Release Information for Veeam Backup & Replication 13 and Updates — таблица билдов: 13.0.0.4967 (03.09.2025), 13.0.2.29 (27.05.2026), 13.1.0.411 (29.07.2026), 13.1.1.18 (12.08.2026), 13.0.3.63 (25.08.2026). https://www.veeam.com/kb4738
- Veeam Community Resource Hub — Veeam v13.1 Deployment: Upgrade, Migration or Greenfield? 3 options — сравнение трёх сценариев, последовательность 12.3.x → 13.0.x → VSA 13.0.x → 13.1, ограничения по лицензиям и Cloud Connect. https://community.veeam.com/blogs-and-podcasts-57/veeam-v13-1-deployment-upgrade-migration-or-greenfield-3-options-but-which-one-is-the-right-one-for-my-environment-13958
- Veeam Community Resource Hub (lab) — Lab: Migrating my lab v13 Veeam Backup Server from Windows to Linux VSA — практический прогон: отдельная машина под VSA, остановка служб, .bco, Host Management Console, режим Migrate, префиксы Migrated. https://community.veeam.com/blogs-and-podcasts-57/lab-migrating-my-lab-v13-veeam-backup-server-from-windows-to-linux-vsa-13154
- Veeam Product Lifecycle — Политика жизненного цикла продуктов Veeam: Veeam Backup & Replication 12 — End of Fix ноябрь 2025, End of Support февраль 2027. https://www.veeam.com/product-lifecycle.html
- Veeam Backup & Replication 13 User Guide — System Requirements, Backup Server — Требования к Linux-Based Backup Server (Veeam Software Appliance): 8 vCPU, 16 ГБ RAM + 500 МБ на задание, Disk 1/Disk 2 от 240 ГБ, только локальные диски и аппаратный RAID. https://helpcenter.veeam.com/docs/vbr/userguide/system_requirements.html?ver=13
- Veeam Backup & Replication 13 User Guide — Veeam Software Appliance: Considerations and Limitations — Выделенная пустая машина, запрет стороннего ПО и trusted domain authentication, SCVMM HA не поддерживается, DISA STIG для RHEL 9 с исключениями. https://helpcenter.veeam.com/docs/vbr/userguide/deployment_linux_byb.html?ver=13