
XFS не ужимается: как забрать место у /home через xfsdump и пересоздание тома
Уменьшить XFS нельзя ни онлайн, ни офлайн: чтобы отдать место от /home корню, данные снимают через xfsdump, том ужимают и пересоздают, затем восстанавливают через xfsrestore. Ниже — рабочая процедура для RHEL 9 с командами, порядок шагов, где операция рвётся и когда её можно не затевать.
«Свободные 600 гигабайт есть, а отдать их некому»
Классическая разметка от установщика RHEL: VG на весь диск, root гигабайт на семьдесят, swap, а всё остальное щедро отдано под /home. Потом на машину приезжают контейнеры, логи, выгрузки, база данных — и корень начинает задыхаться. Эту картину я регулярно вижу, когда мы в АйТи-Фреш принимаем на обслуживание Linux-серверов после другого подрядчика. Администратор смотрит на df, видит на /home 60 ГБ занятого из 800 и логично думает: отрежу лишнее и добавлю корню. И упирается в стену.
Стена в том, что XFS умеет только расти. Расширение — онлайн, одной командой xfs_growfs, на смонтированной файловой системе. Уменьшение не поддерживается. Red Hat пишет об этом прямым текстом в документации RHEL 9 — и в разделе установщика, и в руководстве по файловым системам: XFS нельзя ужать, чтобы получить свободное место; если раздел или том нужно сделать меньше, данные сохраняют, файловую систему уничтожают и создают новую, меньшего размера, на её месте.
То есть «уменьшить /home» — это неправильная формулировка задачи. Правильная звучит так: «перенести данные /home во временное место, снести том, пересоздать его меньшим, вернуть данные обратно». Разница принципиальная: это не resize, а миграция с окном обслуживания, требованием свободного места под копию и вполне реальным риском потерять данные, если перепутать порядок шагов. И именно порядок шагов люди путают чаще всего.
# как это выглядит на типовом больном сервере
$ df -hT | grep -E 'Filesystem|/home|/$'
Filesystem            Type  Size  Used Avail Use% Mounted on
/dev/mapper/rhel-root   xfs    70G   66G  4.0G  95% /
/dev/mapper/rhel-home   xfs   800G   58G  742G   8% /home

$ vgs
  VG   #PV #LV #SN Attr   VSize    VFree
rhel 1 3 0 wz--n- <893.00g 0- XFS расширяется онлайн: xfs_growfs, том можно не размонтировать.
- XFS не уменьшается: ни онлайн, ни офлайн, ни «аккуратно и на свой страх».
- Свободное место в VG у вас, скорее всего, нулевое — установщик раздал всё.
- Значит, задача = перенос данных + пересоздание ФС, а не изменение размера.
Почему XFS не ужимается и не надейтесь на «экспериментальную поддержку»
Вопрос про shrink обсуждают в рассылке XFS больше десяти лет. Разработчики честно говорят, что фича сложная и рискованная, а сценариев под неё мало. Кое-что всё же появилось: в ядре 5.13 XFS научился отдавать неиспользуемое место из последней группы аллокации (AG) — через xfs_growfs -D с размером меньше текущего. Звучит красиво, на практике почти бесполезно.
Ограничение простое: убрать можно только свободный хвост последней AG. Удалить группу аллокации целиком нельзя, переносить данные и метаданные с конца файловой системы нечем. С тома в 800 ГБ вы в лучшем случае отгрызёте хвост последней группы, если он пуст, и не приблизитесь к цели «отдать 600». Плюс ядро пишет в журнал предупреждение «EXPERIMENTAL online shrink feature in use. Use at your own risk!» — его видели все, кто пробовал. Red Hat этот путь не поддерживает, и на боевом сервере клиента я его не использую.
Отдельно предупрежу про соблазн сделать всё «одной командой LVM». В свежих версиях lvm2 у lvreduce есть ключ --fs со значениями checksize, resize, resize_fsadm и ignore. Выглядит так, будто LVM сам разберётся. Не разберётся: для XFS вызвать уменьшение нечем, и в режимах checksize и resize вы получите ошибку, а не чудо. А вот --fs ignore действительно «сработает» — молча отрежет том под живой файловой системой. В справке lvreduce прямо сказано, что ignore при уменьшении может уничтожить файловую систему.
# так делать нельзя — LVM не спасёт XFS
lvreduce -L 200G --fs ignore /dev/rhel/home   # данные в мусор
lvreduce -L 200G --resizefs /dev/rhel/home # ошибка: xfs не умеет shrink- Частичный shrink XFS есть в ядре с 5.13, но отдаёт только пустой хвост последней AG.
- Полноценного уменьшения нет: нет переноса данных с конца ФС и удаления AG.
- Red Hat не поддерживает уменьшение XFS в RHEL 9 — только пересоздание.
- lvreduce --fs ignore не «обходит ограничение», а разрушает файловую систему.
Разбор из практики: сервер сети салонов «Шарм», 50 рабочих мест
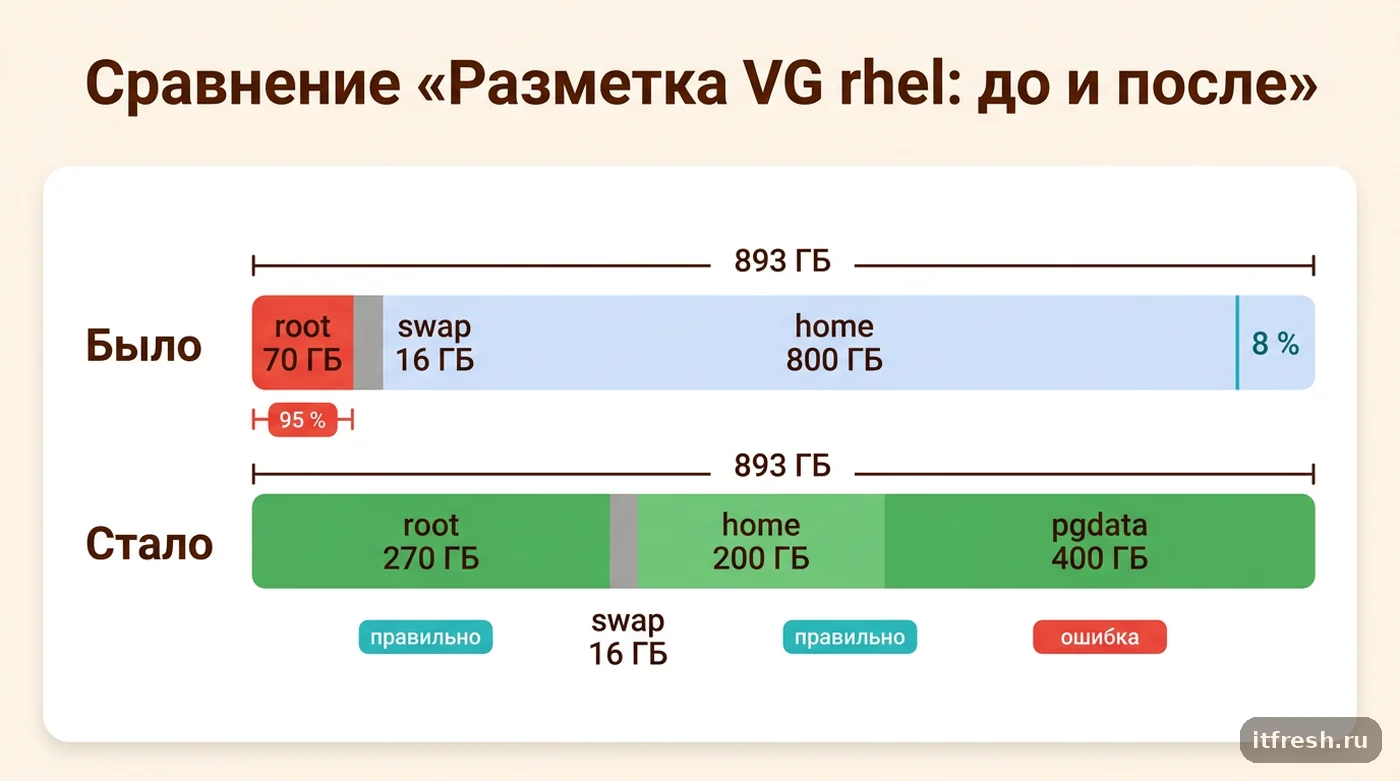
Салон красоты «Шарм» — несколько салонов и офис, 50 рабочих мест, у нас на обслуживании. В офисе стоит один физический сервер приложений: RHEL 9, два NVMe в аппаратном зеркале, единственная VG rhel на 893 ГБ. Разметка от установщика: rhel-root 70 ГБ, rhel-swap 16 ГБ, rhel-home 800 ГБ. На /home живут две учётки администраторов, суммарно 58 ГБ, из них больше половины — старый архив фотографий работ мастеров, который когда-то готовили для сайта. На корне — Podman с контейнерами сервиса онлайн-записи и интеграций, PostgreSQL 16 в /var/lib/pgsql под учётную базу, каталог выгрузок для обмена с 1С и логи.
Прилетело в мониторинг в четверг вечером: на корне свободно 4 ГБ, автовакуум базы начал спотыкаться, выгрузки для бухгалтерии перестали формироваться. Быстрое лечение — урезали журналы journald до 1 ГБ, снесли неиспользуемые образы через podman image prune -a, отыграли ещё 11 ГБ. Хватило на неделю, и это ровно та ситуация, когда «полечили симптом». Нормальное решение — забрать у /home 600 ГБ и отдать корню и базе.
Свободного места в VG не было ни байта, свободного слота в шасси тоже. Зато в офисе стоял NAS с гигабитной линией. Схема получилась такая: дамп /home по сети на NAS, размонтирование, lvreduce до 200 ГБ, mkfs.xfs, восстановление, расширение rhel-root на 200 ГБ и новый LV rhel-pgdata на 400 ГБ под базу. Окно — воскресенье, 07:00–09:30, до открытия салонов. Фактически уложились в час пятьдесят, из которых час десять ушло на перегон 58 ГБ по сети туда и обратно.
Что показал разбор после: 34 ГБ из 58 на /home оказались тем самым архивом, который никто не открывал годами. Мы всё равно перенесли всё как есть — чистить чужие каталоги в окне обслуживания нельзя, это отдельный разговор с владельцем. И вторая находка: у одного из администраторов висела живая screen-сессия, которая держала /home и не давала размонтировать. Об этом дальше.
- Было: rhel-root 70 ГБ (95 %), rhel-home 800 ГБ (8 %), VFree 0.
- Стало: rhel-root 270 ГБ, rhel-home 200 ГБ, новый rhel-pgdata 400 ГБ под PostgreSQL.
- Окно 2,5 часа, реально 1 ч 50 мин, из них 70 минут — сеть.
- Простой полный: /home размонтирован, вход закрыт, сервисы остановлены до открытия салонов.
Процедура целиком: команды по шагам
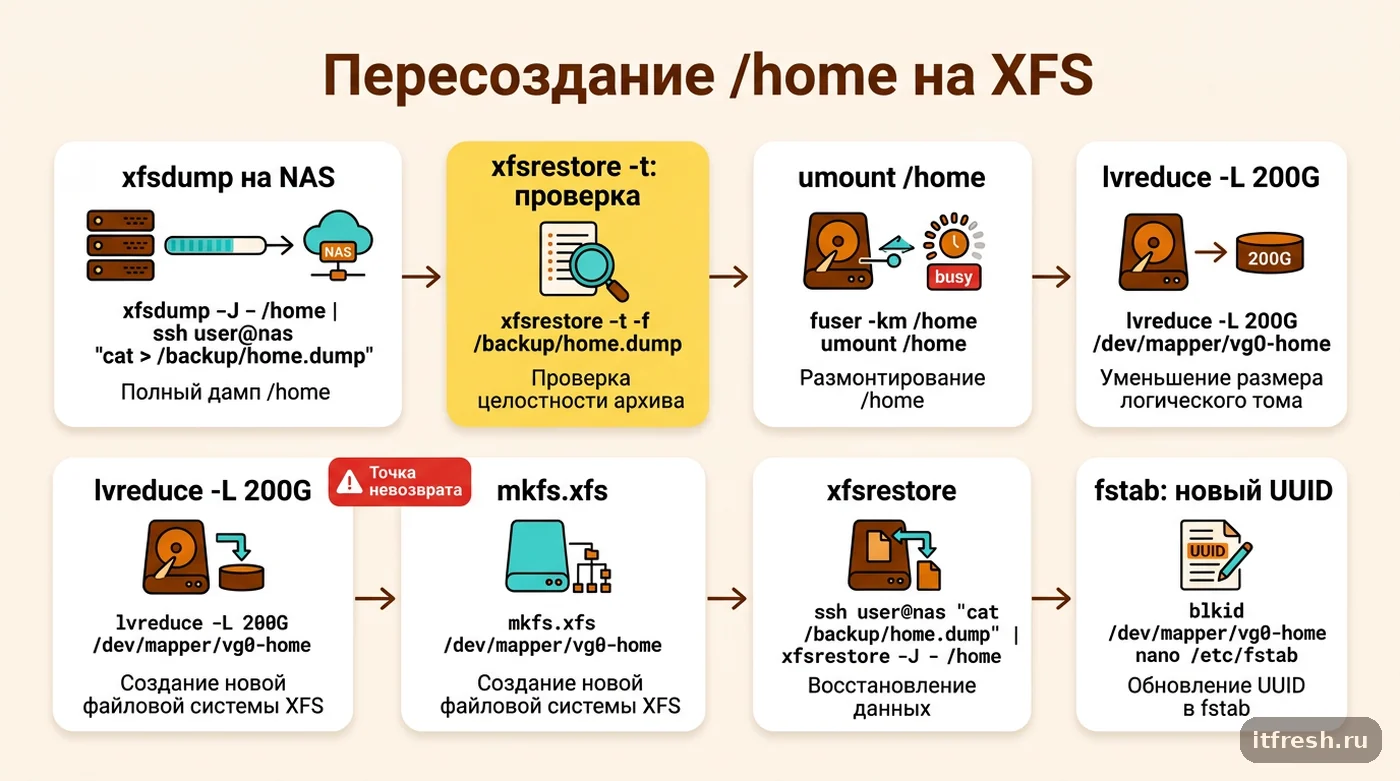
Дальше — последовательность, которую я прогоняю на боевых машинах. Инструмент — xfsdump и xfsrestore из одноимённого пакета (в RHEL 9 ставится через dnf install xfsdump). Почему именно они, а не rsync или tar: xfsdump сохраняет файлы вместе с атрибутами, включая расширенные, а расширенные атрибуты — это в том числе SELinux-контексты и ACL. На RHEL с включённым SELinux это критично: восстановите домашние каталоги без контекстов — получите отвалившийся вход по SSH и увлекательное чтение audit.log.
Важная особенность: один запуск xfsdump работает ровно с одной файловой системой, и она должна быть смонтирована — размонтированные ФС он не дампит. Вывод можно направить в файл, на ленту или в стандартный вывод: одиночный дефис вместо пути назначения отправляет поток в stdout, откуда его можно перекинуть по конвейеру. xfsrestore по умолчанию работает в простом режиме и раскладывает содержимое дампа в указанный каталог; накопительный режим для серии инкрементов включается ключом -r и в нашей задаче не нужен.
# 0. Закрываем вход обычным пользователям и ищем, кто держит /home
touch /etc/nologin              # pam_nologin: вход разрешён только root
who
fuser -vm /home
lsof +f -- /home | head

# 1. Дамп на внешний носитель (уровень 0 = полный)
mount -t nfs nas.example.local:/backup /mnt/backup
xfsdump -l 0 -L "home-migration" -M "nas-backup" \
        -f /mnt/backup/home.xfsdump /home

# 1b. Вариант с конвейером, если промежуточный файл положить негде
# xfsdump -J -l 0 -L "home" - /home | ssh backup@nas.example.local 'cat > /backup/home.xfsdump'

# 2. Проверяем, что дамп читается, ДО того как что-то ломать
xfsrestore -t -f /mnt/backup/home.xfsdump | tail
Пункт 2 не пропускайте никогда. Ключ -t у xfsrestore показывает содержимое дампа, ничего не создавая — это дешёвая тридцатисекундная страховка от «а дамп-то был битый». Дальше — самое ответственное. Размонтируем, уменьшаем логический том, создаём новую файловую систему и возвращаем данные. Между lvreduce и mkfs.xfs пути назад уже нет.
# 3. Размонтируем
umount /home

# 4. Ужимаем LV. --fs ignore здесь ОСОЗНАННО: ФС мы всё равно уничтожаем
#    (в старых lvm2 без --fs ключ просто не указывают)
lvreduce -L 200G --fs ignore /dev/rhel/home

# 5. Создаём новую XFS
mkfs.xfs -f /dev/rhel/home
blkid /dev/rhel/home        # запоминаем НОВЫЙ UUID!

# 6. Монтируем и восстанавливаем
mount /dev/rhel/home /home
xfsrestore -f /mnt/backup/home.xfsdump /home

# 7. Правим fstab на новый UUID и перечитываем юниты
vi /etc/fstab
systemctl daemon-reload
mount -a && df -hT /home

# 8. Контексты SELinux на всякий случай
restorecon -R -v /home

# 9. Отдаём освободившееся место
vgs
lvextend -L +200G -r /dev/rhel/root
lvcreate -L 400G -n pgdata rhel
mkfs.xfs /dev/rhel/pgdata
Финальная проверка — не «df показывает нужные цифры», а «пользователь зашёл и увидел свои файлы». Логинюсь под обычной учёткой по SSH, смотрю ls -laZ в домашнем каталоге (ключ Z покажет контексты SELinux), проверяю владельцев и права, запускаю сервисы. Только после этого удаляю /etc/nologin и ухожу. Дамп на NAS держу как минимум неделю — стоит он копейки, а нервы бережёт.
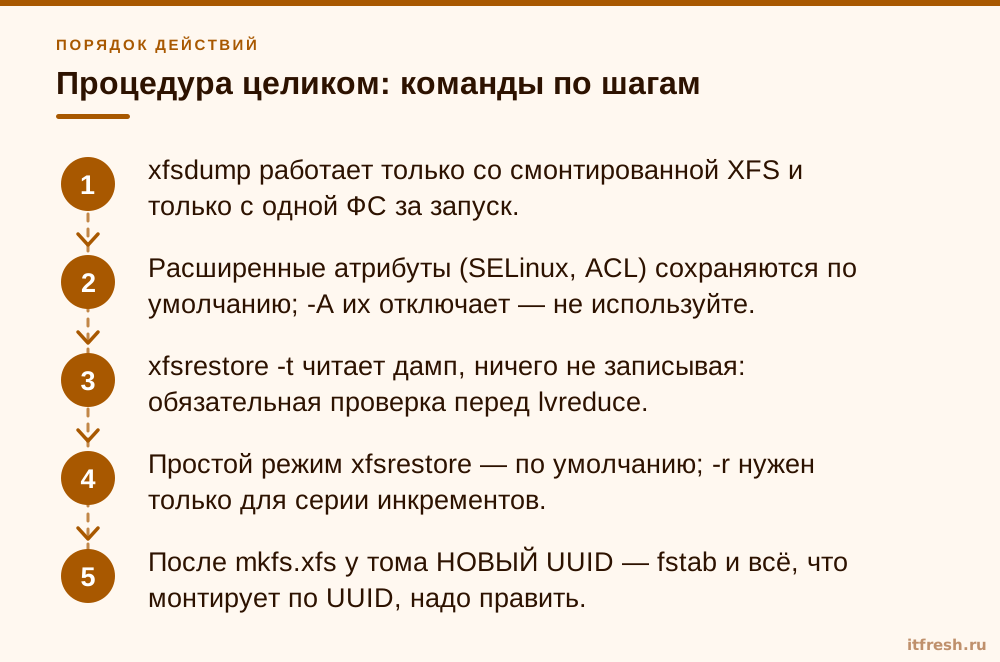
- xfsdump работает только со смонтированной XFS и только с одной ФС за запуск.
- Расширенные атрибуты (SELinux, ACL) сохраняются по умолчанию; -A их отключает — не используйте.
- xfsrestore -t читает дамп, ничего не записывая: обязательная проверка перед lvreduce.
- Простой режим xfsrestore — по умолчанию; -r нужен только для серии инкрементов.
- После mkfs.xfs у тома НОВЫЙ UUID — fstab и всё, что монтирует по UUID, надо править.
Где эта операция ломается из раза в раз
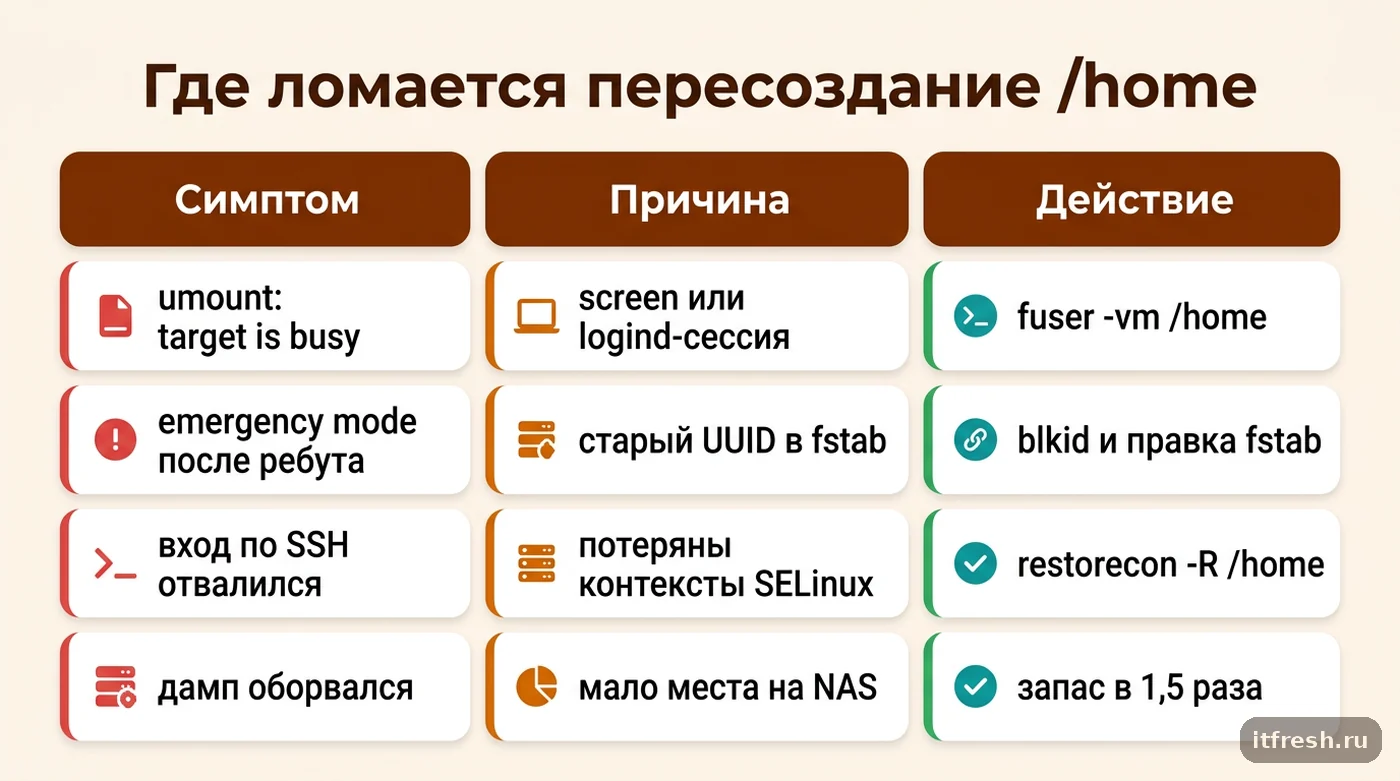
За годы у меня накопился короткий список, по которому я прохожусь перед каждой такой миграцией. Он скучный, но именно он экономит окно обслуживания. Самое частое — /home не размонтируется. Пользователь ушёл домой, но оставил screen; systemd-logind держит сессию; в /home лежит каталог с образом контейнера, примонтированный внутрь Podman; NFS-экспорт из /home забыт в /etc/exports. fuser -vm /home и lsof показывают виновника за секунды, но искать надо ДО начала работ, а не в 07:40 в воскресенье.
Второе — UUID. После mkfs.xfs идентификатор новый, а в /etc/fstab старый. Перезагрузка — и система висит в emergency mode. Отдельно ловушка: если /home прописан не в fstab, а как systemd-юнит (home.mount) или монтируется автомонтировщиком, правьте там же и обязательно делайте systemctl daemon-reload. Проверяйте до перезагрузки командой mount -a на уже размонтированном томе, а не «ну оно потом само».
Третье — квоты и опции монтирования. Если на /home были дисковые квоты (uquota, gquota, prjquota), новая ФС создаётся без них: опции монтирования надо вернуть в fstab, а сами лимиты — переналить. Аналогично с nodev/nosuid/noexec, которые часто ставят на пользовательские каталоги по требованиям безопасности. И четвёртое — шифрование: если под LV лежит LUKS, порядок другой, сначала ужимается контейнер, и цена ошибки там выше.
Пятое, самое обидное: недооценка объёма. Дамп xfsdump без сжатия занимает примерно столько же, сколько данные. Если на NAS свободно 60 ГБ, а /home занят на 58 — упрётесь в конец места посреди процесса. Считайте с запасом в полтора раза, а если места впритык — гоните поток в stdout со сжатием на лету (xfsdump -J - /home | zstd | ssh …), но помните, что проверка -t тогда потребует обратной распаковки.
- Не размонтируется /home: screen/tmux, logind-сессии, bind-mount в контейнеры, NFS-экспорт.
- Старый UUID в fstab или в .mount-юните → emergency mode после перезагрузки.
- Потерянные квоты (uquota/prjquota) и security-опции монтирования.
- Утерянные SELinux-контексты, если восстанавливали rsync'ом без -X или xfsrestore с -A.
- Нехватка места под дамп; дамп, положенный на ту же файловую систему.
- Забытый lvextend: место освободили, но корню так и не отдали.
Когда пересоздавать не нужно: три обходных пути
Прежде чем затевать окно обслуживания, я всегда прикидываю, нельзя ли решить задачу дешевле. Первый вопрос — а нужно ли вообще трогать /home? Если в шасси есть свободный слот или это виртуалка, ответ очевиден: добавить диск, pvcreate, vgextend, lvextend -r. Пятнадцать минут онлайн, без простоя и без риска — как именно я расширяю диск без даунтайма, разобрано отдельно. Это всегда первый вариант, который я проверяю.
Второй — перенести не место, а данные. Домашние каталоги остаются на большом /home, а тяжёлого потребителя с корня переселяем туда: останавливаем сервис, копируем каталог, монтируем обратно через bind-mount и прописываем это в fstab с зависимостью от /home. Решение не самое красивое — логика разметки размывается, — но рабочее, делается за полчаса и не требует ни дампа, ни mkfs. Для SELinux добавляю правило эквивалентности путей, чтобы restorecon не перепутал контексты. Если сервис работает под systemd с ProtectHome, учтите, что он может не увидеть каталог в /home — как открыть один путь при ProtectHome, я писал отдельно.
# перенос тяжёлого каталога на просторный /home через bind-mount
systemctl stop postgresql
mkdir -p /home/_data/pgsql
rsync -aHAX --numeric-ids /var/lib/pgsql/ /home/_data/pgsql/
mv /var/lib/pgsql /var/lib/pgsql.old
mkdir /var/lib/pgsql && chown postgres:postgres /var/lib/pgsql
semanage fcontext -a -e /var/lib/pgsql /home/_data/pgsql
restorecon -R -v /home/_data/pgsql
echo '/home/_data/pgsql /var/lib/pgsql none bind,x-systemd.requires-mounts-for=/home 0 0' >> /etc/fstab
systemctl daemon-reload && mount -a
systemctl start postgresql
Третий вариант, если инфраструктура виртуальная: не мучиться, а пересобрать машину с правильной разметкой и переехать. На виртуалках это часто быстрее и безопаснее, чем оперировать боевую ФС. Скажу честно: пересоздание XFS через dump/restore — операция нормальная и предсказуемая, я её делал десятки раз, но она всегда стоит окна и всегда несёт ненулевой риск. Если есть способ обойтись без неё — обходитесь.
- Есть свободный слот/место у гипервизора → добавить диск и vgextend. Без простоя.
- Распух конкретный каталог → bind-mount на просторный том. Полчаса.
- Виртуалка и есть окно на переезд → пересобрать с нормальной разметкой.
- Ничего из этого недоступно → только xfsdump/lvreduce/mkfs.xfs/xfsrestore.
Как разметить сервер, чтобы больше сюда не возвращаться
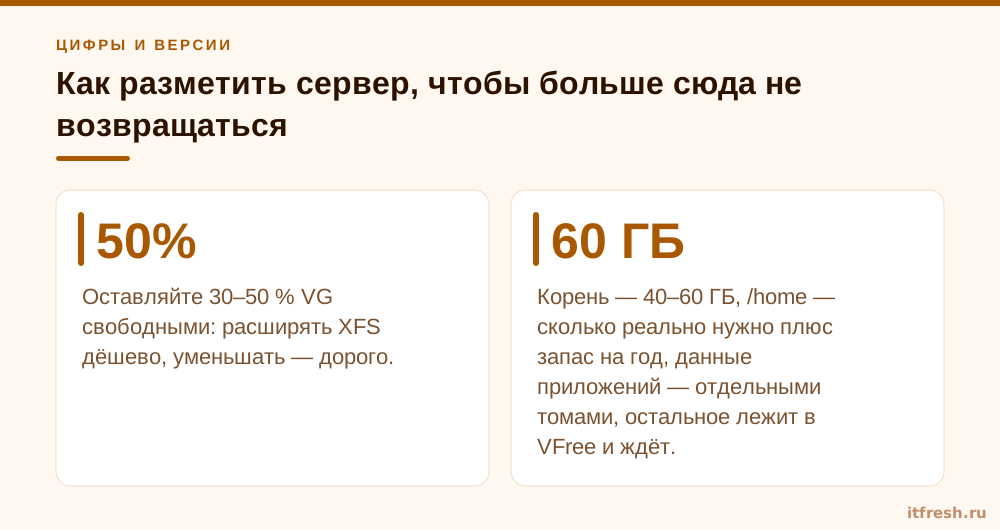
Главный вывод из всех этих историй — не про XFS, а про разметку. Установщик по умолчанию раздаёт всё свободное место одному тому, и это решение вы потом оплачиваете окном обслуживания. Моё правило простое: в VG после установки должно оставаться свободным 30–50 % ёмкости. Растить тома онлайн XFS умеет прекрасно, поэтому «недодать» дёшево, а «передать» — дорого. Корень — 40–60 ГБ, /home — сколько реально нужно плюс запас на год, данные приложений — отдельными томами, остальное лежит в VFree и ждёт.
Второй приём — thin-провижининг LVM. Тонкие тома позволяют выдать логические размеры с запасом, а физическое место расходовать по факту. Это удобно, но требует дисциплины: переполнение тонкого пула — неприятность похуже забитого корня, причём смотреть надо не только на данные, но и на метаданные thin-pool. Я включаю thin там, где есть нормальный мониторинг и человек, который на него реагирует. На сервере у клиента без выделенного админа — обычную толстую разметку с честным VFree.
Третье — мониторинг с порогами, которые срабатывают заранее. Не 95 %, а 80 % с предупреждением и 90 % с алертом. У наших клиентов такие алерты приходят дежурному инженеру, и «корень 82 %» — это спокойная задача на неделю, а не аврал в воскресенье. Разница между плановой миграцией /home и аварийной — в стоимости нервов и в вероятности ошибиться в порядке команд.
И последнее, спорное. Иногда меня спрашивают, не перейти ли с XFS на ext4 ради возможности ужимать тома. Мой ответ — нет. XFS — файловая система по умолчанию в RHEL, хорошо держит большие файлы и параллельную нагрузку, и у вендора она основная со всеми вытекающими для поддержки. У ext4 свои сюрпризы — например, закончились inode при свободных гигабайтах. Уменьшение файловой системы на нормально спроектированном сервере случается ноль раз за жизнь машины. Менять рабочую характеристику на страховку от собственной ошибки при разметке — плохой размен. Правильный ответ на «XFS не ужимается» — не менять ФС, а не раздавать всё место сразу.
- Оставляйте 30–50 % VG свободными: расширять XFS дёшево, уменьшать — дорого.
- Данные приложений (БД, контейнеры, выгрузки) — всегда отдельными LV.
- Thin-пулы — только там, где за пулом кто-то следит.
- Пороги мониторинга 80/90 %, а не 95 %.
- Ext4 ради shrink — плохой размен; чините разметку, а не файловую систему.
Частые вопросы
Точно нельзя уменьшить XFS без пересоздания? А экспериментальный shrink в ядре?
Практически нельзя. С ядра 5.13 XFS умеет отдавать только неиспользуемое место из последней группы аллокации: переносить данные с конца файловой системы и удалять AG целиком он не умеет. Ядро при этом пишет предупреждение об экспериментальной функции. Забрать так 600 ГБ из 800 не получится, и Red Hat этот путь не поддерживает.
Можно ли обойтись rsync вместо xfsdump?
Можно, но аккуратно: нужны ключи -aHAX --numeric-ids, иначе вы потеряете расширенные атрибуты (а вместе с ними SELinux-контексты и POSIX ACL), сломаете жёсткие ссылки и раздуете разрежённые файлы. xfsdump сохраняет файлы вместе с атрибутами по умолчанию — на RHEL с включённым SELinux это заметно надёжнее. Если всё же копировали rsync'ом, обязательно прогоните restorecon -R по восстановленному каталогу.
Сколько времени займёт операция и какой будет простой?
Простой полный: /home на время работ размонтирован, пользователи не заходят. Время почти целиком определяется объёмом данных и скоростью канала до места хранения дампа. Ориентир из практики: 58 ГБ по гигабитной сети на NAS — около 70 минут туда и обратно, все остальные шаги (umount, lvreduce, mkfs.xfs, правка fstab, lvextend) укладываются в 10–15 минут. Планируйте окно с двукратным запасом.
Что делать, если /home не размонтируется?
Найти держателя: fuser -vm /home и lsof +f -- /home. Типовые виновники — забытые screen/tmux-сессии, живые сессии systemd-logind, bind-mount каталогов из /home в контейнеры, NFS-экспорт. Закройте вход (touch /etc/nologin), завершите сессии через loginctl terminate-session, снимите экспорты и bind-mount. Ленивый umount -l не используйте: процессы останутся с открытыми файлами на уходящей ФС.
После перезагрузки сервер ушёл в emergency mode — что я сделал не так?
С вероятностью 90 % — не обновили UUID. После mkfs.xfs у тома новый идентификатор, а в /etc/fstab остался старый. Загрузитесь в emergency, посмотрите blkid /dev/rhel/home, впишите актуальный UUID в fstab, выполните systemctl daemon-reload и mount -a. Если /home монтируется .mount-юнитом systemd или автомонтировщиком, правьте UUID и там.
Стоит ли перейти на ext4, чтобы такого больше не было?
Не стоит. Ext4 действительно умеет уменьшаться (офлайн, через resize2fs), но XFS — файловая система по умолчанию в RHEL, хорошо держит большие файлы и параллельную нагрузку. Уменьшение ФС на нормально спроектированном сервере не случается ни разу. Лечить надо разметку: оставлять 30–50 % VG свободными и растить тома по мере надобности.
Источники
- Red Hat Enterprise Linux 9 — Customizing the system in the installer — Раздел о поддерживаемых файловых системах: XFS нельзя уменьшить, для меньшего тома — резервная копия, уничтожение ФС и создание новой. https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/9/html/interactively_installing_rhel_over_the_network/customizing-the-system-in-the-installer_rhel-installer
- Red Hat Enterprise Linux 9 — Managing file systems — Увеличение XFS через xfs_growfs, отсутствие утилиты уменьшения, резервное копирование и восстановление XFS через xfsdump/xfsrestore. https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/9/html-single/managing_file_systems/index
- xfsdump(8), man7.org — Одна ФС за запуск, дамп только смонтированных ФС, ключи -l, -L, -M, -J, -A, вывод в stdout через «-». https://man7.org/linux/man-pages/man8/xfsdump.8.html
- lvreduce(8), LVM2 — Debian trixie — Ключ --fs (checksize | resize | resize_fsadm | ignore) и предупреждение «using ignore when reducing the LV size may destroy the file system». https://manpages.debian.org/trixie/lvm2/lvreduce.8.en.html
- LKML — [GIT PULL] xfs: new code for 5.13 — Появление в ядре 5.13 возможности убирать неиспользуемое место из последней AG как первого шага к shrink. https://lkml.rescloud.iu.edu/2104.3/05136.html