
lvextend отработал успешно, но df показывает старый размер: какой слой хранилища вы забыли
Если lvextend прошёл без ошибок, а df показывает старый размер, вы расширили логический том, но не файловую систему на нём. Лечится одной командой — xfs_growfs или resize2fs, онлайн. Ниже разбираю, из каких слоёв состоит место на диске, как за минуту найти застрявший слой и в каком порядке расширять.
Почему lvextend не меняет df: шесть слоёв вместо одного
Звонок в девять утра: «Расширили диск, всё сделали по инструкции, lvextend отработал без ошибок — а база всё равно падает». Подключаюсь, смотрю df -h — те же 150 гигабайт, что и вчера. Смотрю lvs — 250. Обе команды говорят правду, просто о разных вещах. Это непонимание я вижу у администраторов чаще любой другой ошибки в LVM, и особенно больно оно бьёт по серверам 1С на Linux с PostgreSQL, где база растёт незаметно, а падает мгновенно.
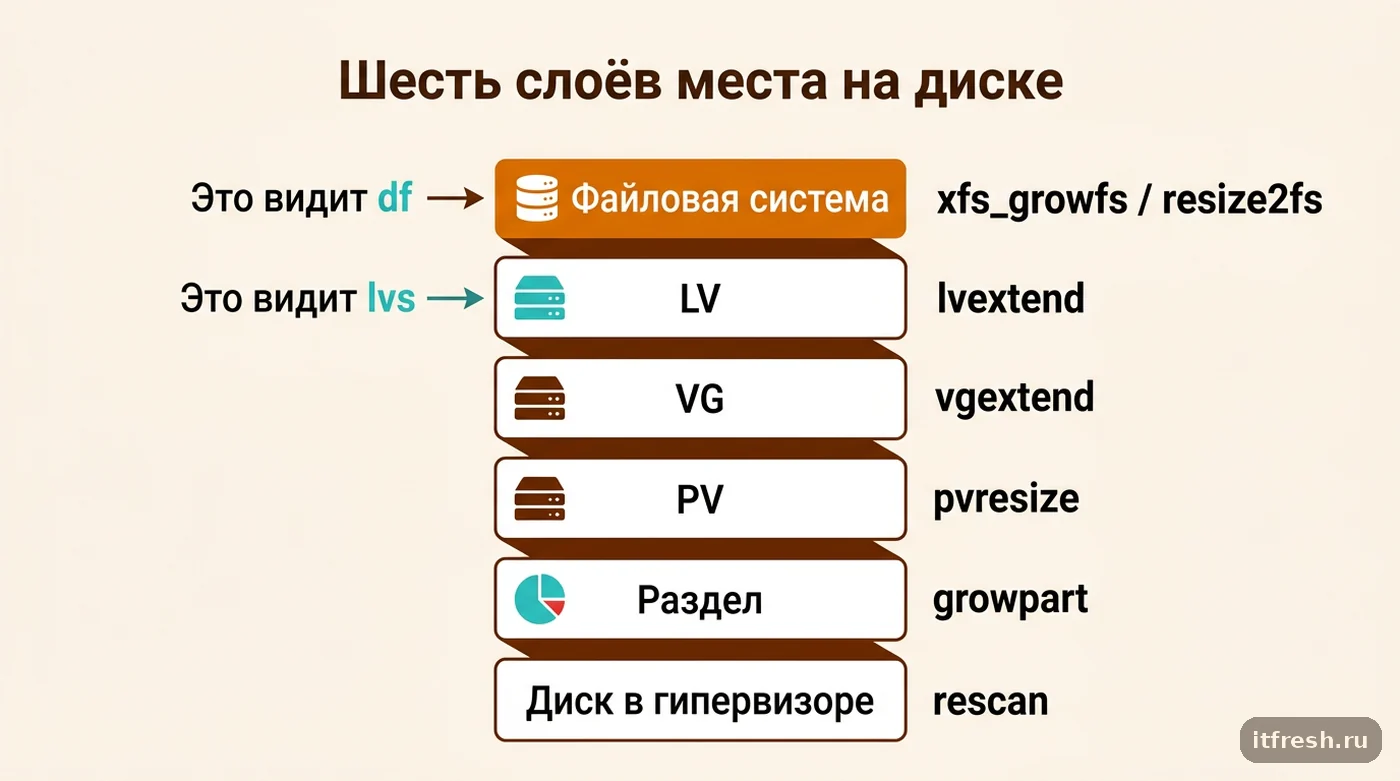
«Место на диске» в схеме с LVM — это не одна величина, а стопка вложенных друг в друга сущностей. Снизу вверх: блочное устройство (виртуальный диск или LUN), поверх него таблица разделов, поверх раздела — физический том LVM (PV), PV входит в группу томов (VG), из свободных экстентов VG нарезается логический том (LV), и уже на LV лежит файловая система. Шесть уровней. И каждый из них имеет собственный размер, который меняется собственной командой. Ни один из них не растёт автоматически вслед за соседом.
lvextend работает ровно с одним уровнем — он забирает свободные физические экстенты из VG и отдаёт их логическому тому. Всё. Ему нет дела до того, что лежит внутри LV: файловая система, LUKS-контейнер, сырой раздел под Oracle ASM или вообще ничего. Поэтому сообщение «Logical volume successfully resized» означает буквально: том стал больше. Оно ничего не обещает про файловую систему. А df показывает именно файловую систему — её суперблок, её счётчик блоков. Файловая система, которую никто не трогал, честно рапортует старый размер.
Симметричная ошибка на нижнем уровне: человек расширил виртуальный диск в vSphere или Proxmox, побежал делать lvextend -l +100%FREE и получил «Insufficient free space». Потому что новые гигабайты появились у блочного устройства, но ядро об этом не знает, раздел остался прежним, PV не переразмечен, и свободных экстентов в VG как не было, так и нет. Тот же самый разрыв между слоями, просто с другой стороны.
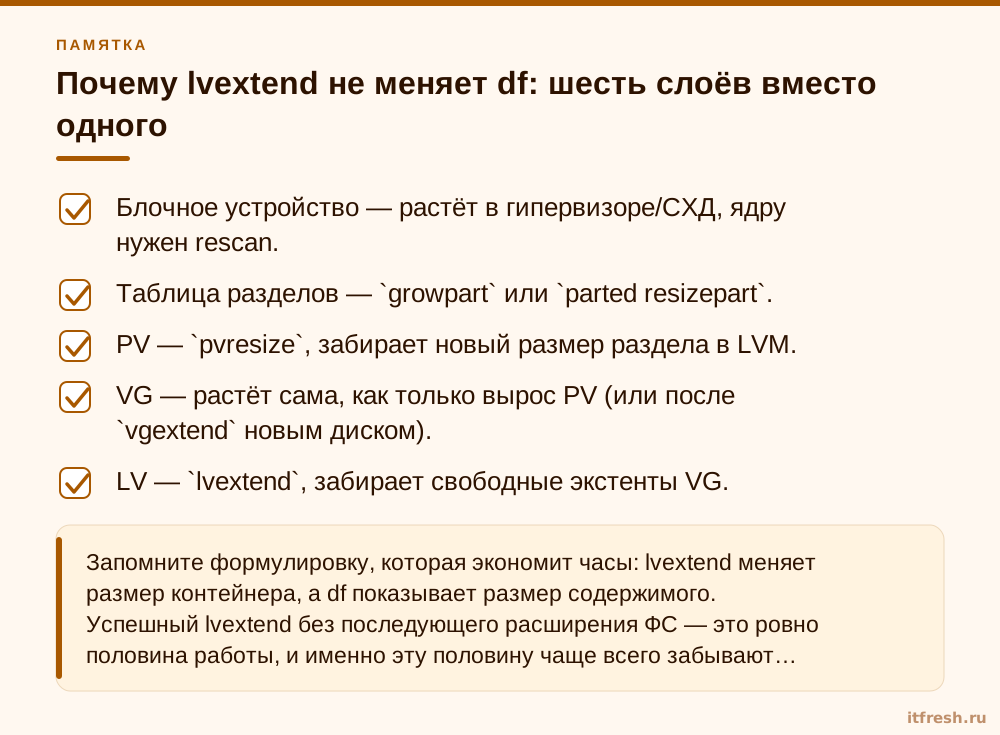
- Блочное устройство — растёт в гипервизоре/СХД, ядру нужен rescan.
- Таблица разделов — `growpart` или `parted resizepart`.
- PV — `pvresize`, забирает новый размер раздела в LVM.
- VG — растёт сама, как только вырос PV (или после `vgextend` новым диском).
- LV — `lvextend`, забирает свободные экстенты VG.
- Файловая система — `xfs_growfs` / `resize2fs`, показывается в `df`.
Кейс: аквариумный салон, 1С на PostgreSQL и 100 гигабайт, которых не было
Клиент — аквариумный салон «Коралловый риф», 26 рабочих мест: два торговых зала, склад живого товара и кормов, сервисная служба, которая обслуживает аквариумы в офисах и ресторанах. Учёт — 1С:Розница и 1С:Бухгалтерия на PostgreSQL 15, сервер — виртуальная машина с Debian 12 на Proxmox. Каталог /var/lib/postgresql жил на отдельном LV в 150 ГБ с файловой системой XFS, PV был создан на всём втором виртуальном диске /dev/sdb без таблицы разделов. К концу года база и архив WAL разрослись, мониторинг начал сигналить на 90 %, и администратор клиента получил задачу «добавить места».
Он увеличил виртуальный диск в Proxmox со 150 до 250 ГБ, выполнил на сервере rescan устройства, pvresize /dev/sdb и lvextend -l +100%FREE /dev/vgdata/pgdata, увидел «Logical volume successfully resized» и закрыл заявку. Шаг с файловой системой в найденной им инструкции просто отсутствовал. Через двое суток, в субботу — самый загруженный день салона, — PostgreSQL остановился с could not extend file ... No space left on device, кассы перестали проводить чеки. Я подключился и увидел картину, которая с тех пор служит мне учебным пособием.
# LVM уверен, что всё хорошо
$ sudo lvs vgdata/pgdata
  LV     VG     Attr       LSize
  pgdata vgdata -wi-ao---- <250.00g

# файловая система живёт в прошлом
$ df -hT /var/lib/postgresql
Filesystem                Type  Size  Used Avail Use% Mounted on
/dev/mapper/vgdata-pgdata xfs   150G  150G   20K 100% /var/lib/postgresql

# XFS знает только о старых 150 ГиБ
$ sudo xfs_info /var/lib/postgresql | head -3
meta-data=/dev/mapper/vgdata-pgdata isize=512  agcount=4, agsize=9830400 blks
         =                         sectsz=512  attr=2, projid32bit=1
data     =                         bsize=4096  blocks=39321600, imaxpct=25
Лечение заняло одиннадцать секунд: xfs_growfs /var/lib/postgresql. XFS расширяется только на смонтированной ФС, так что базу даже не пришлось останавливать — PostgreSQL сам продолжил работу, как только появилось место, кассы ожили через пару минут. Весь простой — около сорока минут, из которых тридцать ушли на то, чтобы до меня дозвонились. Потом мы разложили процедуру в чек-лист, добавили в Zabbix триггер на расхождение размера LV и размера ФС (lvs --units b -o lv_size против df -B1 --output=size) и договорились, что расширение диска — не «одна команда», а последовательность из пяти. За следующие девять месяцев повторов не было.
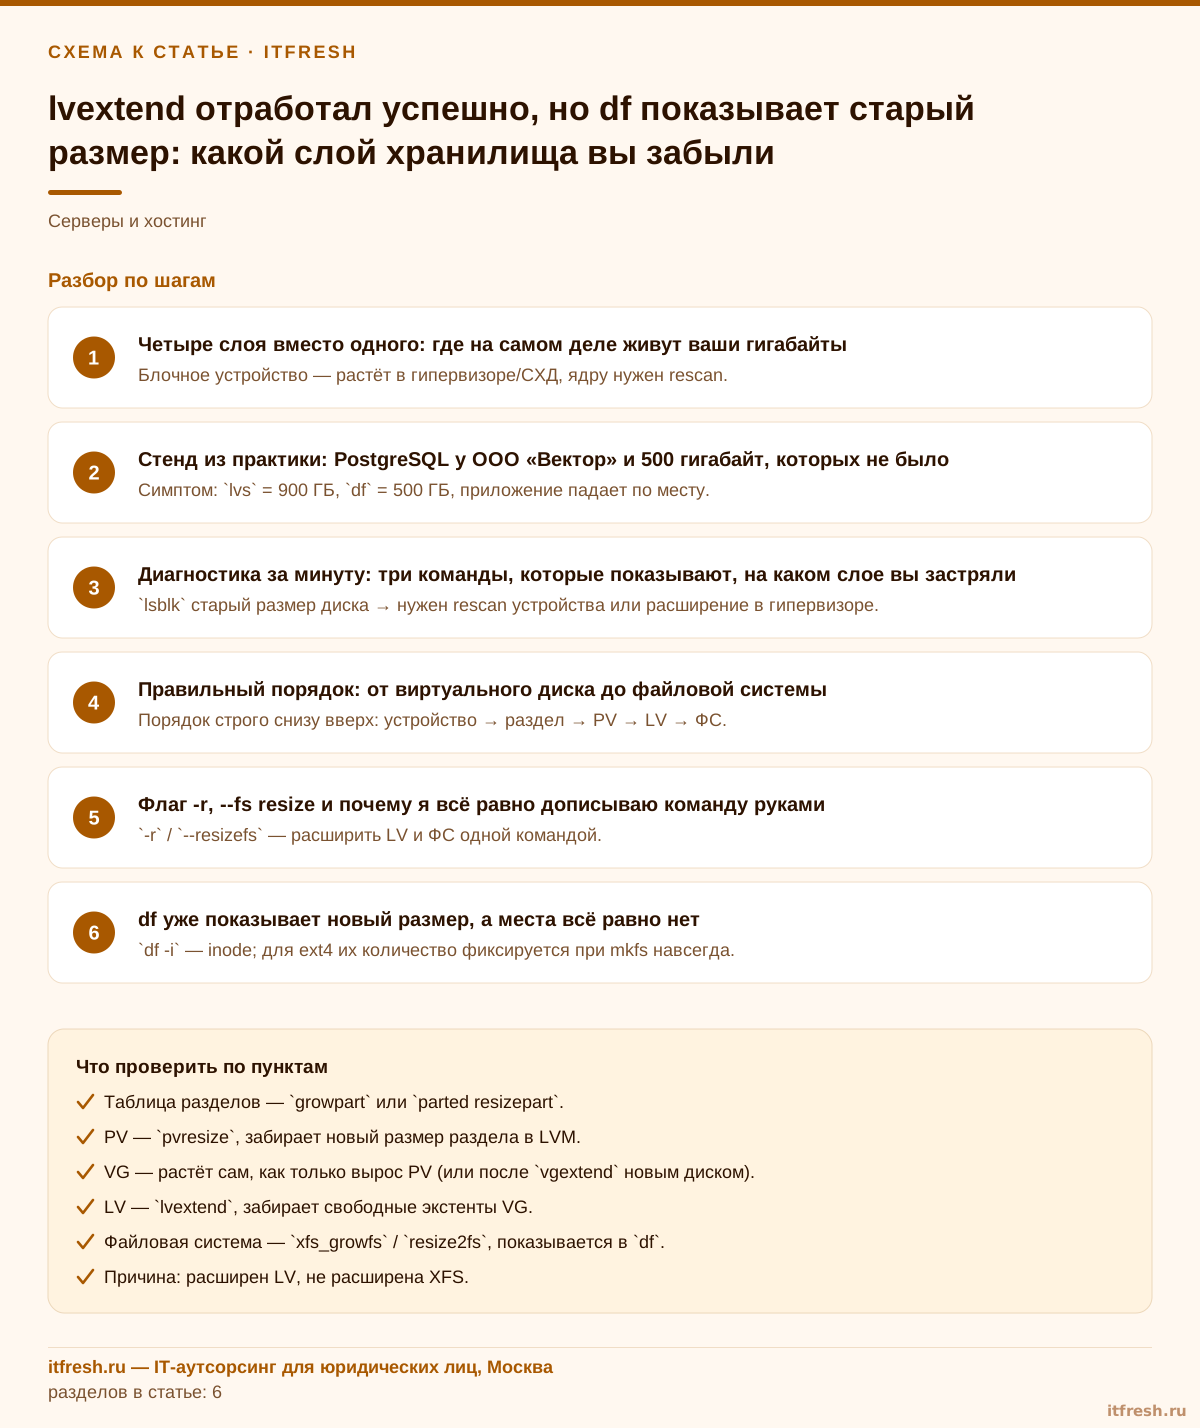
- Симптом: `lvs` = 250 ГБ, `df` = 150 ГБ, PostgreSQL падает по месту.
- Причина: расширен LV, не расширена XFS.
- Проверка: `xfs_info` показывает `blocks=` от старого размера.
- Фикс: `xfs_growfs /точка/монтирования` — онлайн, без остановки сервиса.
- Профилактика: триггер мониторинга на расхождение LSize и размера ФС.
Диагностика за минуту: три команды, которые показывают, на каком слое вы застряли
Когда прилетает «место добавили, а его нет», я не гадаю и не читаю чужие логи. Я выполняю три команды подряд и по расхождению цифр сразу вижу точку разрыва. Это занимает меньше минуты и работает на любом дистрибутиве — RHEL, Debian, Astra Linux, неважно.
# 1. Что видит ядро: диски, разделы, LV, точки монтирования
lsblk -o NAME,SIZE,FSTYPE,MOUNTPOINT

# 2. Что видит LVM: размер PV, свободное место VG, размер LV
sudo pvs; sudo vgs; sudo lvs

# 3. Что видит файловая система
df -hT
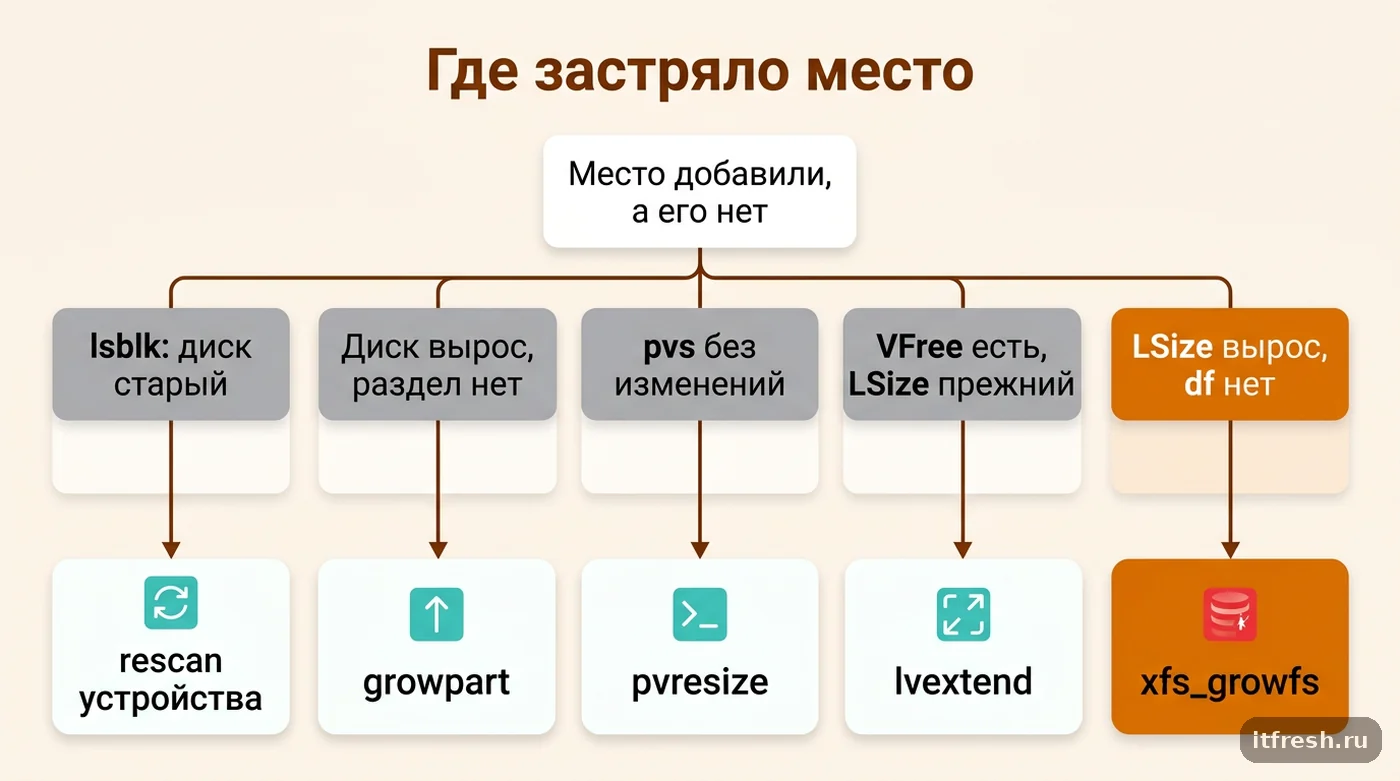
Читаются они снизу вверх по стопке слоёв. Если lsblk показывает диск старого размера — вы не сделали rescan на стороне ОС (или вообще не расширили диск в гипервизоре, бывает и такое). Если диск нового размера, а раздел старого — не хватает growpart. Если раздел вырос, а pvs показывает прежний PSize — забыт pvresize. Если vgs показывает VFree в сотни гигабайт, а LSize не изменился — не сделан lvextend. И, наконец, если LSize вырос, а df стоит на месте — вы ровно в той ситуации, ради которой написана эта статья: не расширена файловая система. Если же все цифры сошлись, а свободное место в VG кончилось, остаётся добавить новый диск через vgextend — а старый при необходимости потом вывести из LVM без размонтирования.
Отдельно советую сразу проверять, ту ли ФС вы вообще смотрите. Классика жанра: на сервере два похожих тома, vgdata/data и vgdata/data_archive, админ расширил первый, а приложение пишет во второй, смонтированный через bind-mount из другого каталога. Команда findmnt -T /путь/к/каталогу показывает реальный источник монтирования и снимает вопрос за секунду. Ещё чаще это встречается с контейнерами: внутри контейнера df вообще может показывать overlay-слой, никак не связанный с вашим LV.
- `lsblk` старый размер диска → нужен rescan устройства или расширение в гипервизоре.
- Диск вырос, раздел нет → `growpart /dev/sdb 1` (если PV на разделе).
- Раздел вырос, `pvs` нет → `pvresize /dev/sdb1`.
- `vgs` показывает VFree, `lvs` нет → `lvextend`.
- `lvs` вырос, `df` нет → `xfs_growfs` или `resize2fs`.
- `findmnt -T /путь` — проверить, что расширяете именно тот том.
Правильный порядок: от виртуального диска до файловой системы
Вот последовательность, которую я держу в чек-листе и по которой работаю на любом Linux-сервере с LVM. Она предполагает, что диск уже расширен в гипервизоре или СХД. Показываю на PV, лежащем на разделе /dev/sdb1, — это более сложный и более частый вариант. Если PV создан на диске целиком, как у «Кораллового рифа», шаг 2 просто пропускается. Для дисков virtio-blk (/dev/vda, /dev/vdb) rescan обычно не нужен: ядро получает новый размер от гипервизора само, проверьте lsblk.
# 1. Показать ядру, что устройство подросло (SCSI/virtio-scsi)
echo 1 | sudo tee /sys/class/block/sdb/device/rescan
# или из пакета sg3-utils: sudo rescan-scsi-bus.sh -s
lsblk /dev/sdb

# 2. Растянуть раздел на новое место (пакет cloud-guest-utils / cloud-utils-growpart)
sudo growpart /dev/sdb 1

# 3. Забрать новый размер раздела в физический том LVM
sudo pvresize /dev/sdb1
sudo vgs           # здесь должен появиться VFree

# 4. Отдать место логическому тому (явный размер, не всё)
sudo lvextend -L +80G /dev/vgdata/pgdata

# 5. Расширить файловую систему
sudo xfs_growfs /var/lib/postgresql     # XFS: по точке монтирования
# sudo resize2fs /dev/vgdata/pgdata     # ext4: по устройству
Про growpart скажу отдельно, потому что тут людей пугают зря. Да, вы редактируете таблицу разделов на живом диске с примонтированной ФС. Нет, это не страшно — при условии, что вы увеличиваете последний раздел и не двигаете его начало. growpart из пакета cloud-utils написан именно под этот сценарий, он же корректно переносит резервную копию GPT в новый конец диска. Ручные пляски с fdisk (удалить раздел, создать заново с тем же стартовым сектором) тоже работают, но там ошибиться на один сектор — и вы потеряли файловую систему. Я такое делаю только когда growpart недоступен.
Про -l +100%FREE тоже есть нюанс. Проценты в LVM считаются от свободного места группы томов, а не от свободных блоков внутри файловой системы. Если в VG живут снимки, тонкие пулы или вы хотели оставить запас под соседний том, +100%FREE съест всё подчистую и не спросит. На боевых серверах я почти всегда пишу явный размер — lvextend -L +80G, оставляя 10–15 % VG свободными как манёвр на случай аварии, в том числе под снимок перед обновлением: как он ведёт себя при нехватке места, я разбирал в статье про переполненный снимок LVM. Вернуть место обратно из XFS штатно не получится: xfs_growfs умеет уменьшать только последнюю группу выделения, и то в экспериментальном режиме, для практики это не вариант.
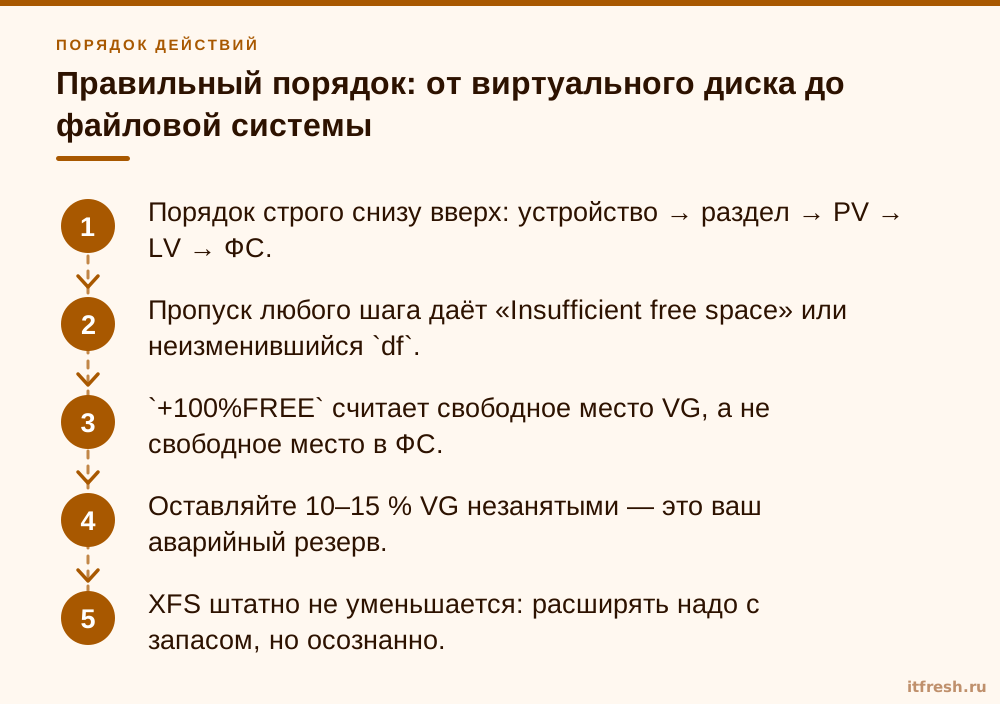
- Порядок строго снизу вверх: устройство → раздел → PV → LV → ФС.
- Пропуск любого шага даёт «Insufficient free space» или неизменившийся `df`.
- `+100 %FREE` считает свободное место VG, а не свободное место в ФС.
- Оставляйте 10–15 % VG незанятыми — это ваш аварийный резерв.
- XFS штатно не уменьшается: расширять надо с запасом, но осознанно.
Флаг -r, --fs resize и почему я всё равно пишу два шага
У lvextend есть ключ, который закрывает ровно эту боль: -r (он же --resizefs). Команда lvextend -r -L +80G /dev/vgdata/pgdata расширит и том, и файловую систему одним вызовом, и df покажет новую цифру сразу. Для XFS расширение идёт онлайн, размонтировать ничего не нужно. Без -r lvextend файловую систему не трогает вообще — именно это и случилось у «Кораллового рифа».
Механика под капотом поменялась, и это важно понимать. До lvm2 2.03.17 -r вызывал внешний скрипт fsadm, который умеет ext2/3/4, ReiserFS и XFS и не умеет btrfs. Именно такая версия, 2.03.16, стоит в Debian 12 и Ubuntu 24.04 — новых ключей там нет. В Debian 13 уже lvm2 2.03.31, и там появились --fs и --fsmode. --fs resize вызывает штатную утилиту конкретной ФС, и по man-странице -r теперь эквивалентен именно ему; --fs resize_fsadm — старый путь через fsadm, помеченный как устаревший; --fs ignore — изменить LV, не глядя на файловую систему. --fsmode определяет, можно ли LVM самому монтировать и размонтировать том: manage — можно, с попыткой вернуть исходное состояние; nochange — нельзя, и команда упадёт, если без этого не обойтись; offline — размонтировать и менять размер на отмонтированной ФС. Узнать свою версию — lvm version.
# lvm2 2.03.17 и новее (Debian 13 и др.)
sudo lvextend --fs resize --fsmode nochange -L +80G /dev/vgdata/pgdata

# универсальный вариант, работает и на старых версиях
sudo lvextend -r -L +80G /dev/vgdata/pgdata

# для btrfs -r не поможет, ФС расширяется своей командой
sudo lvextend -L +80G /dev/vgdata/data
sudo btrfs filesystem resize max /mnt/data
Для ручной работы на живом сервере я указываю --fsmode nochange: если LVM вдруг решит, что том надо размонтировать, пусть лучше упадёт, чем уронит базу. И теперь честно: сам я на боевых серверах чаще пишу два шага вместо одного. Не потому, что -r плохой — он хороший и почти всегда работает идеально. А потому, что при неудаче он даёт менее понятный вывод: том уже расширен, ФС нет, а в консоли одна общая строка ошибки от fsadm, по которой не сразу видно, на чём именно споткнулось. Когда шаги разделены, lvextend и xfs_growfs рапортуют отдельно, и в логе заявки видно, что прошло, а что нет. Для скриптов и автоматизации -r — правильный выбор, для ручной работы под нагрузкой я предпочитаю видеть каждый шаг. Это вопрос вкуса, и я не стану утверждать, что мой подход единственно верный.
Отдельная ловушка — уменьшение. lvreduce -r для ext4 сначала ужмёт файловую систему (офлайн), потом том, и это сработает. Для XFS штатного пути нет: единственный способ получить меньший размер — выгрузить данные, пересоздать ФС и загрузить обратно. Без -r lvreduce в новых версиях по умолчанию проверяет, не отрежет ли он занятые данные (--fs checksize), а в старых — отрежет молча, так что порядок «сначала ФС, потом том» надо держать в голове всегда.
- `-r` / `--resizefs` — расширить LV и ФС одной командой.
- `--fs resize` (новые lvm2) вызывает нативный ресайзер ФС, а не fsadm.
- `--fs ignore` — изменить только том, ФС не трогать (сырые устройства, LUKS без ФС сверху).
- Debian 12 и Ubuntu 24.04 — lvm2 2.03.16, ключей `--fs` нет, `-r` работает через fsadm.
- Уменьшение через `-r` возможно для ext4 и невозможно для XFS.
df уже показывает новый размер, а места всё равно нет
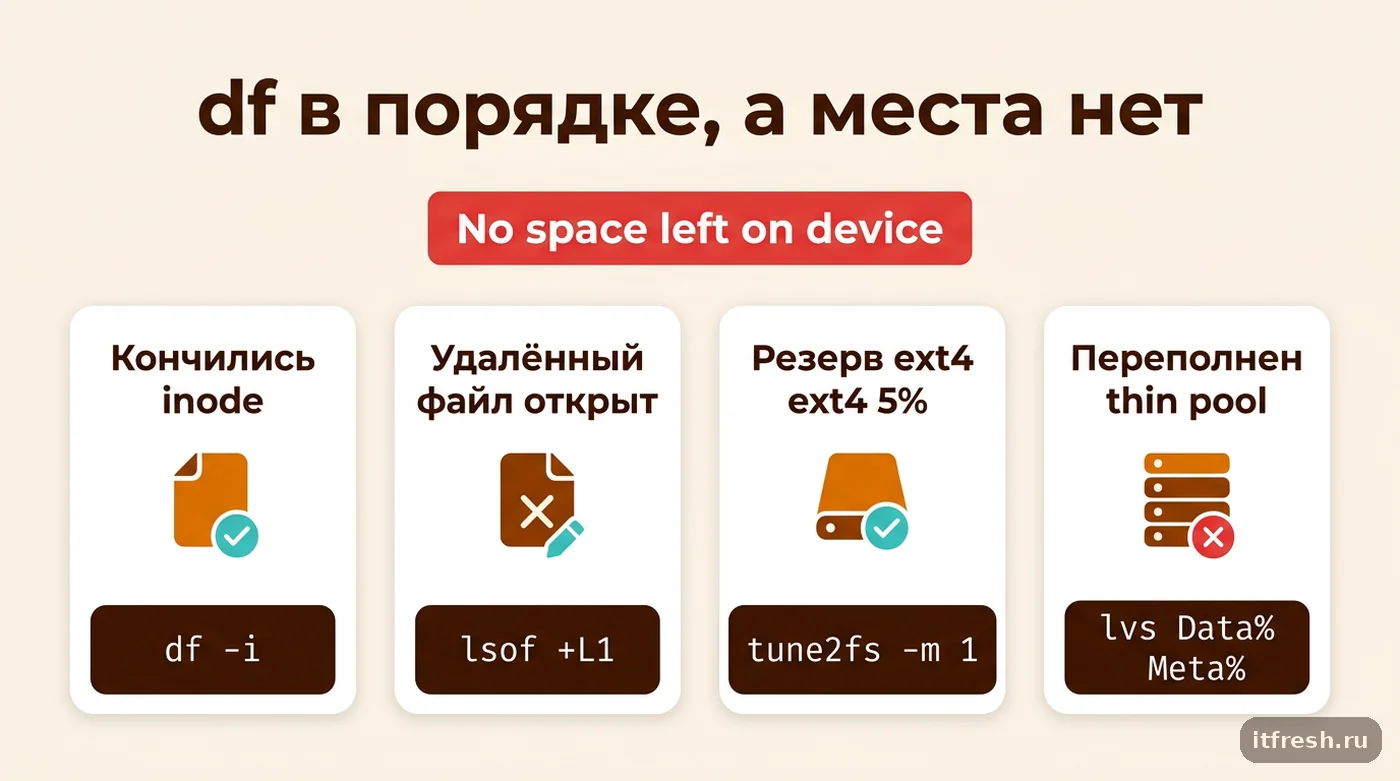
Бывает и обратная история, и она честно относится к той же боли: расширили всё правильно, df рисует свежие гигабайты с кучей свободного — а приложение продолжает ругаться на нехватку места. Значит, вы уперлись не в блоки. Частых причин четыре, и проверяются они за пару минут.
Первая — закончились inode. Файловая система хранит метаданные о файлах в отдельном пуле фиксированного размера, заданном при mkfs. Если на томе миллионы мелких файлов (кэш, сессии PHP, почтовый maildir, спул 1С), inode кончаются задолго до блоков, и ядро отдаёт ровно тот же ENOSPC. Смотрите df -i. У XFS ситуация мягче — inode выделяются динамически, но упираются в параметр imaxpct; у ext4 пул жёсткий и увеличить его без пересоздания ФС нельзя. Это ещё один аргумент за XFS под нагрузками с миллионами файлов. Как это выглядит на практике и чем лечится, я подробно разбирал в статье про исчерпание inode на ext4.
Вторая — удалённые, но открытые файлы. Кто-то удалил старый лог на 20 ГБ, а процесс держит на него дескриптор — место не освобождается до перезапуска процесса. Ищется командой sudo lsof +L1, там будет столбец NLINK со значением 0. Третья — зарезервированные блоки: ext4 по умолчанию прячет 5 % тома под root, и на терабайтном разделе это около пятидесяти гигабайт, недоступных обычному приложению. Лечится sudo tune2fs -m 1 /dev/vgdata/data, для тома с данными (не системного) резерв в 5 % — чистое расточительство. Похожая история бывает и с системным журналом: journalctl --vacuum-size отработал, а место не вернулось, потому что его держат совсем другие файлы.
df -i /var/lib/pgsql          # закончились ли inode
sudo lsof +L1                 # удалённые файлы, удерживаемые процессами
sudo tune2fs -l /dev/vgdata/data | grep -i reserved   # резерв ext4
sudo lvs -o+data_percent,metadata_percent             # заполнение thin pool
Четвёртая и самая неприятная — тонкие тома. Если LV нарезан из thin pool, его собственный размер вам ничего не говорит: физическое место выделяется по мере записи и берётся из пула. Пул может быть переполнен, притом что и lvs и df показывают приличные цифры. Отдельно следите за метаданными пула: их переполнение переводит пул в режим только для чтения и лечится куда сложнее, чем нехватка данных. Колонки Data% и Meta% в выводе lvs — то, что должно быть в мониторинге, а не только использование ФС.
- `df -i` — inode; для ext4 их количество фиксируется при mkfs навсегда.
- `lsof +L1` — удалённые файлы, которые держит живой процесс.
- `tune2fs -m 1` — вернуть себе 5 % ext4, зарезервированные под root.
- `lvs -o+data_percent,metadata_percent` — реальное заполнение thin pool.
- Квоты (`repquota`, XFS project quota) — редко, но встречается.
Что делать прямо сейчас, а на что можно спокойно забить
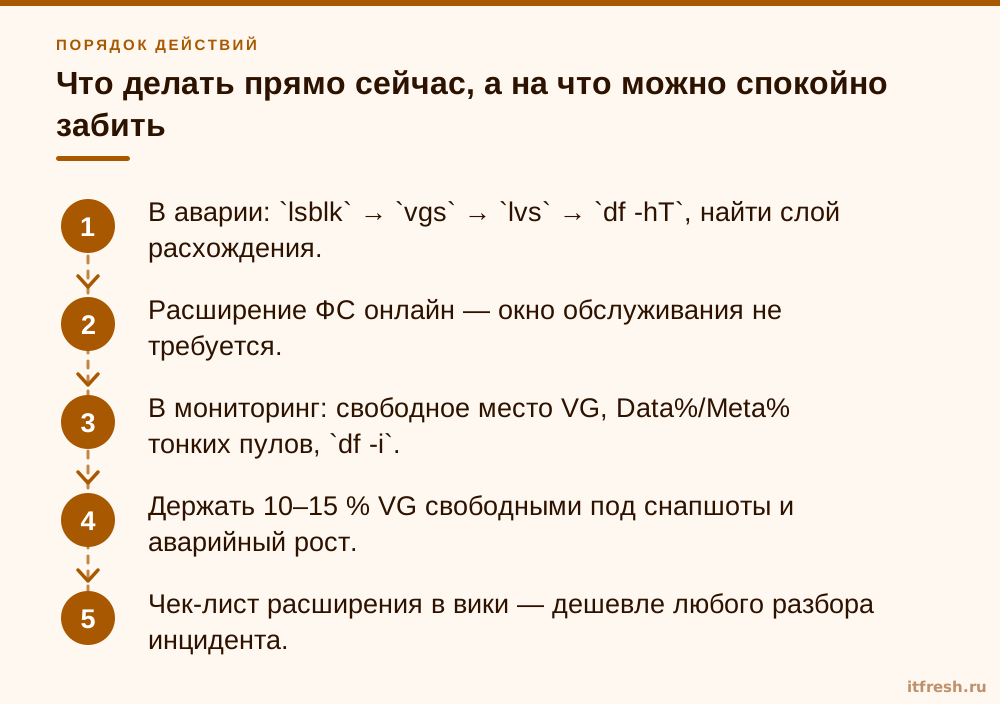
Если вы читаете это в аварии — порядок такой. Выполните lsblk, vgs, lvs, df -hT и сравните цифры сверху вниз. Найдите слой, где размер перестал совпадать. Доделайте недостающий шаг: pvresize, lvextend или xfs_growfs/resize2fs. Расширение XFS и ext4 идёт онлайн, останавливать сервисы не нужно. Обычно с момента подключения до нормального df проходит меньше пяти минут — если, конечно, вам есть откуда взять место.
Если авария уже позади, вложитесь в две вещи. Первая: мониторинг не только процента заполнения ФС, но и свободного места VG. Классический сценарий у моих клиентов — мониторинг сигналит на 90 % занятости тома, админ идёт расширять, а в VG свободных экстентов ноль, потому что при установке всё раздали под корень. Знать об этом надо за месяц до, а не в ночь на понедельник. Вторая: чек-лист расширения в вики, с командами под вашу разметку. Пять строк текста, которые снимают 90 % повторных заявок.
А на что можно забить со спокойной душой. Не переживайте по поводу «онлайн-расширения на живой базе» — это штатная операция, XFS и ext4 растут на смонтированной ФС годами и стабильно, окно обслуживания под это не нужно. Не гонитесь за идеальной разметкой отдельных томов под каждый каталог: для сервера на 26 рабочих мест, как у «Кораллового рифа», вынесенных /var и данных приложения более чем достаточно, дробление на восемь LV даёт вам восемь мест, где может кончиться место. И не бойтесь -r — да, я сам пишу шаги раздельно, но это привычка, а не требование безопасности.
Единственное, к чему я отношусь всерьёз, — резерв в группе томов. Оставленные незанятыми 10–15 % VG стоят вам ровно ничего, а в момент, когда база растёт быстрее прогноза или нужно срочно снять снапшот перед обновлением, они спасают вечер. Отдать всё до последнего экстента командой +100%FREE — самое частое решение и самое частое сожаление. У «Кораллового рифа» после того случая мы увеличили диск ещё на 100 ГБ и держим их свободными в VG: при нынешнем росте базы это запас примерно на год, и расширение теперь плановая пятиминутная задача, а не субботний пожар.
- В аварии: `lsblk` → `vgs` → `lvs` → `df -hT`, найти слой расхождения.
- Расширение ФС онлайн — окно обслуживания не требуется.
- В мониторинг: свободное место VG, Data%/Meta% тонких пулов, `df -i`.
- Держать 10–15 % VG свободными под снапшоты и аварийный рост.
- Чек-лист расширения в вики — дешевле любого разбора инцидента.
Частые вопросы
lvextend отработал, а df показывает старый размер. Данные не потерялись?
Нет, данные в полном порядке. Файловая система просто не знает, что том под ней стал больше, и продолжает работать в старых границах. Выполните `xfs_growfs /точка/монтирования` для XFS или `resize2fs /dev/vg/lv` для ext4 — размер в df обновится сразу, останавливать сервисы не нужно.
Можно ли расширять файловую систему на работающей базе, не останавливая сервис?
Да. И XFS, и ext4 расширяются онлайн, на смонтированной файловой системе. XFS вообще умеет только онлайн-расширение — команда `xfs_growfs` требует, чтобы ФС была примонтирована. На нагруженных серверах операция занимает секунды и не вызывает заметной просадки. Окно обслуживания нужно только на шаг с правкой таблицы разделов, и то скорее из осторожности.
Почему lvextend пишет «Insufficient free space», хотя я увеличил диск в гипервизоре?
Потому что новое место застряло на нижнем слое. Ядру нужно сообщить о росте устройства (`echo 1 > /sys/class/block/sdX/device/rescan` или `rescan-scsi-bus.sh -s`), затем растянуть раздел (`growpart /dev/sdX 1`, если PV на разделе), затем забрать новый размер в LVM (`pvresize`). Только после этого в `vgs` появится VFree.
Чем -r отличается от отдельного вызова xfs_growfs?
Результат тот же, разница в диагностике. В lvm2 до 2.03.17 (Debian 12, Ubuntu 24.04) `-r` вызывает fsadm, в новых эквивалентен `--fs resize` и вызывает штатную утилиту ФС. Отдельные команды дают более понятный вывод при ошибке: видно, что LV расширился, а ФС нет. Для скриптов удобнее `-r`, для ручной работы я пишу два шага.
Расширил всё правильно, df показывает свободное место, а приложение всё равно пишет No space left. Что дальше?
Проверьте четыре вещи: `df -i` (закончились inode), `lsof +L1` (удалённые файлы удерживает живой процесс), резерв 5 % у ext4 (`tune2fs -m 1` для томов с данными) и заполнение тонкого пула (`lvs -o+data_percent,metadata_percent`). В девяти случаях из десяти это inode или удалённый лог, который держит незакрытый дескриптор.
Можно ли потом уменьшить том обратно, если расширил лишнего?
Для ext4 — да, офлайн: размонтировать, проверить `e2fsck -f`, `resize2fs` до нужного размера, затем `lvreduce` (или всё сразу через `lvreduce -r`). Для XFS штатного уменьшения нет: выгрузка данных, пересоздание ФС меньшего размера и загрузка обратно. Поэтому на XFS я задаю размер явно, а не `+100 %FREE`.
Источники
- lvextend(8), lvm2 2.03.31 (Debian 13) — Ключи --fs (checksize, resize, resize_fsadm — устаревший, ignore), --fsmode (manage, nochange, offline); -r|--resizefs эквивалентен --fs resize. https://manpages.debian.org/trixie/lvm2/lvextend.8.en.html
- Пакет lvm2 в Debian — bookworm — 2.03.16-2, trixie — 2.03.31-2. https://packages.debian.org/search?keywords=lvm2&searchon=names&exact=1&suite=all§ion=all
- Пакет lvm2 в Ubuntu 24.04 — noble — 2.03.16-3ubuntu3, без ключей --fs/--fsmode. https://packages.ubuntu.com/noble/lvm2
- xfs_growfs(8) — ФС должна быть смонтирована для расширения; уменьшение реализовано только для последней группы выделения. https://man7.org/linux/man-pages/man8/xfs_growfs.8.html
- resize2fs(8) — Онлайн-расширение смонтированной ext4; уменьшение только на отмонтированной ФС. https://man7.org/linux/man-pages/man8/resize2fs.8.html
- rescan-scsi-bus.sh(8), sg3-utils — -s|--resize — найти диски с изменённым размером; -r — удаление устройств (не для расширения). https://manpages.debian.org/trixie/sg3-utils/rescan-scsi-bus.sh.8.en.html