
journalctl --vacuum-size отработал, а место не вернулось: разбираем journald по слоям
Ночью прилетает алерт «/ 91 %». Админ заходит на сервер, бьёт journalctl --vacuum-size=200M, команда рапортует об успехе — а --disk-usage через секунду показывает 3,4 ГБ. Ощущение, что systemd врёт. Он не врёт: вы попросили его удалить не то, что занимает место. Ниже — что на самом деле считает --disk-usage, почему вакуум по определению не трогает активные файлы, какая связка команд работает, какие лимиты в journald.conf реально удерживают журнал в заданном объёме и где место съедает вообще не journald.
«Вакуум сработал, место не вернулось» — это не баг
Начнём с того, что вы читаете на экране. journalctl --disk-usage отвечает фразой вида «Archived and active journals take up 8.0M in the file system» — и в самой формулировке уже есть ответ. Мануал journalctl(1) говорит про эту опцию прямо: «Shows the current disk usage of all journal files. This shows the sum of the disk usage of all archived and active journal files». То есть в цифру входят и архивы, и файлы, в которые journald прямо сейчас пишет.
Теперь вторая половина. --vacuum-size= в том же мануале описана так: «removes the oldest archived journal files until the disk space they use falls below the specified size». Ключевое слово — archived. Активные файлы вакуум не рассматривает вообще. И чтобы не было разночтений, systemd отдельным абзацем предупреждает: «Note that running --vacuum-size= has only an indirect effect on the output shown by --disk-usage, as the latter includes active journal files, while the vacuuming operation only operates on archived journal files». Этот текст стоит в мануале с systemd 218, когда опция появилась, и слово в слово присутствует в актуальной на сентябрь 2026 версии 261.3. Это не регрессия и не особенность вашего дистрибутива — это описанное поведение.
Дальше вылезает деталь, которую пропускают почти все: активный файл не один. journald держит открытым system.journal для системного потока, отдельный user-<UID>.journal на каждого пользователя, у которого есть свои записи, отдельный набор файлов на каждый journal namespace а в /var/log/journal после клонирования ВМ легко остаётся ещё и каталог со старым machine-id. На терминальном сервере с двумя десятками UID «активных» файлов может быть двадцать с лишним. Отличить их друг от друга проще всего по имени: у активного файла в имени нет символа «@», у архивного — есть, туда зашиты порядковый номер и метка времени.
Проверять я советую двумя командами. Первая показывает состояние каждого файла глазами самого journald — ARCHIVED значит архивный, а ONLINE или OFFLINE — активный (OFFLINE у активного файла означает лишь, что journald уже сбросил его на диск и закрыл запись до следующего сообщения). Вторая просто раскладывает каталог по размерам, чтобы стало видно, что именно весит.
# состояние всех файлов, которые видит journalctl
sudo journalctl --header | grep -E 'File path|^State'

# что реально лежит на диске
sudo du -sh /var/log/journal /run/log/journal 2>/dev/null
sudo ls -lhS /var/log/journal/*/ | head -20- `system.journal` — активный системный файл, вакуум его не тронет никогда
- `system@0005f3c...-0006a1b....journal` — архивный, вот его вакуум и удаляет
- `user-1000.journal` — активный журнал конкретного UID, тоже вне зоны вакуума
- `*.journal~` — «грязный» файл, оставшийся после некорректного завершения journald
- каталог `/var/log/journal/<machine-id>/` — текущий набор файлов; соседний каталог с чужим machine-id — наследство клонирования, вакуум текущей машины его не видит
Ротация — единственная кнопка, которая превращает активный файл в архивный
Раз вакуум умеет только архивы, задача сводится к простому: сделать активные файлы архивными. Ровно этим занимается journalctl --rotate. Мануал: «Journal file rotation has the effect that all currently active journal files are marked as archived and renamed, so that they are never written to in future. New (empty) journal files are then created in their place». Под капотом это тот же SIGUSR2, который systemd-journald(8) описывает как «Request immediate rotation of the journal files» — но через journalctl вы дожидаетесь завершения операции, а не отправляете сигнал в пустоту.
Дальше — самое полезное. Эти вещи можно и нужно писать одной командой, и systemd отдельно объясняет порядок: «These three switches may also be combined with --rotate into one command. If so, all active files are rotated first, and the requested vacuuming operation is executed right after. The rotation has the effect that all currently active files are archived... and hence the vacuuming operation has the greatest effect as it can take all log data written so far into account». То есть правильная форма команды — не journalctl --vacuum-size=1G, а journalctl --rotate --vacuum-size=1G. Я за годы видел десятки runbook-ов, где эти две команды написаны отдельными строками и в обратном порядке — сначала вакуум, потом ротация. Работает это ровно наоборот: сначала вы чистите старьё, потом создаёте новый архив и снова упираетесь в тот же объём.
Есть и обратная сторона, про которую забывают. Насколько мелко журнал вообще может «отпускать» место, задаёт SystemMaxFileSize= — мануал journald.conf(5) формулирует это как «This influences the granularity in which disk space is made available through rotation, i.e. deletion of historic data». По умолчанию параметр равен одной восьмой от SystemMaxUse и ограничен сверху 128 МБ, «so that usually seven rotated journal files are kept as history». Если journald работает в compact-режиме (он включён по умолчанию, в выводе journalctl --header видно Incompatible flags: ... COMPACT), потолок поднимается до 4 ГБ. И вот когда админ вручную ставит SystemMaxFileSize=2G «чтобы файлов было поменьше», он собственными руками создаёт двухгигабайтный активный файл, который не удалить ничем, кроме ротации.
Время тоже ротирует: MaxFileSec= по умолчанию месяц. На нагруженной машине размер срабатывает сильно раньше, так что этот параметр в реальной жизни трогают редко — он нужен, чтобы на тихом сервере вы не потеряли разом месячный кусок истории.
# рабочая форма: сначала ротация, потом очистка — одной командой
sudo journalctl --rotate --vacuum-size=1G

# то же самое, но по времени — безопаснее для расследования инцидента
sudo journalctl --rotate --vacuum-time=14d

# ограничения можно комбинировать
sudo journalctl --rotate --vacuum-size=2G --vacuum-time=30d --vacuum-files=40- `--vacuum-size=` — удалить старейшие архивы, пока они не влезут в размер (суффиксы K/M/G/T по основанию 1024)
- `--vacuum-time=` — удалить архивы старше срока (s/m/h/days/weeks/months/years)
- `--vacuum-files=` — оставить указанное число файлов; активные при этом не удаляются, поэтому итог может оказаться больше
- нулевое значение любого из трёх = ограничение не применяется, писать его бессмысленно
Разбор из практики: управляющая компания ЖКХ на 40 рабочих мест
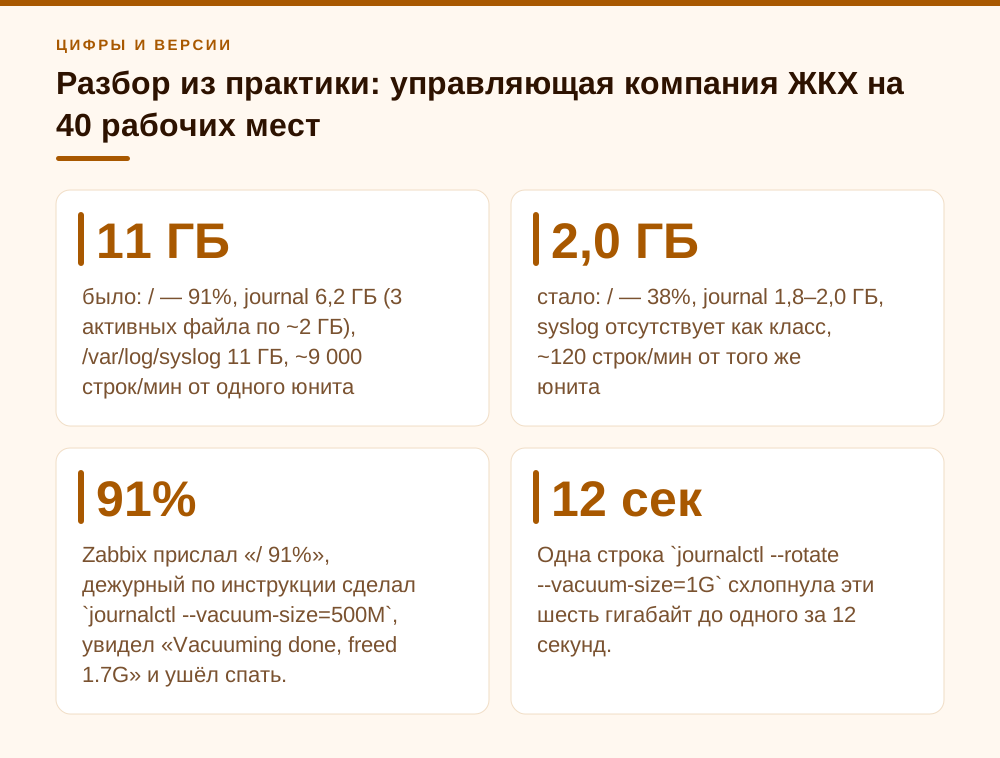
Условно назову клиента «УправДом Сервис» — управляющая компания ЖКХ, 40 рабочих мест: диспетчерская, бухгалтерия, абонентский отдел. Linux-машин у них три, все в нашем ЦОД: шлюз, сервер приложений (личный кабинет жильцов и интеграция с приборами учёта) и сервер БД. Проблемный — сервер приложений: Ubuntu Server 24.04 LTS, systemd 255, корень 40 ГБ одним разделом, отдельного /var нет (типовая ошибка при разметке, но переделывать на живом сервере — отдельный проект). Zabbix прислал «/ 91 %», дежурный по инструкции сделал journalctl --vacuum-size=500M, увидел «Vacuuming done, freed 1.7G» и ушёл спать. Утром было 88 %.
Первое, что я сделал утром, — посмотрел не на суммарную цифру, а на раскладку файлов. journalctl --disk-usage показывал 6,2 ГБ. В каталоге лежали три файла по 1,9–2,0 ГБ с состоянием не ARCHIVED (ONLINE/OFFLINE) — system.journal и два user-журнала. Причина нашлась в /etc/systemd/journald.conf: за две недели до этого подрядчик клиента вписал туда SystemMaxUse=8G и SystemMaxFileSize=2G. Первое разрешило журналу занимать 8 ГБ на 40-гигабайтном корне, второе — раздуло активные файлы до двух гигабайт каждый, то есть до объёма, который вакуум не может даже теоретически потрогать. Одна строка journalctl --rotate --vacuum-size=1G схлопнула эти шесть гигабайт до одного за 12 секунд.
Дальше вылез второй слой, и он оказался крупнее первого. du -sh /var/log/* показал /var/log/syslog на 11 ГБ. В образе стоял rsyslog, ForwardToSyslog=yes гнал в него весь поток журнала, а logrotate для syslog кто-то поправил на rotate 12 без maxsize. Итог: два независимых архива одних и тех же сообщений на одном разделе, и чистка одного из них принципиально не могла решить задачу. Мы оставили journald как единственный приёмник, ForwardToSyslog выключили, rsyslog из автозапуска убрали, старые syslog.* удалили.
Третий слой — источник спама. Одна команда показала, что 78 % записей за час дал самописный сборщик показаний общедомовых и квартирных счётчиков: примерно 9 000 строк в минуту уровня debug, из них половина — «heartbeat ok». Юниту прописали drop-in с LogLevelMax и rate limit, поток упал до ~120 строк в минуту. Итог по серверу: корень с 91 % до 38 %, журнал третий месяц стабильно держится в 1,8–2,0 ГБ, алертов по диску с тех пор не было. На всю работу ушло около двух часов, из них полтора — на выяснение, что виноват не journald.
# кто именно пишет в журнал: топ юнитов за последний час
sudo journalctl --since '-1h' -o json --output-fields=_SYSTEMD_UNIT --no-pager \
| jq -r '._SYSTEMD_UNIT // "kernel"' | sort | uniq -c | sort -rn | head -15- было: / — 91 %, journal 6,2 ГБ (3 активных файла по ~2 ГБ), /var/log/syslog 11 ГБ, ~9 000 строк/мин от одного юнита
- стало: / — 38 %, journal 1,8–2,0 ГБ, syslog отсутствует как класс, ~120 строк/мин от того же юнита
- исправлено: SystemMaxUse 8G → 2G, SystemMaxFileSize 2G → 128M, ForwardToSyslog yes → no, LogLevelMax=notice на шумном юните
Постоянные лимиты: SystemMaxUse, SystemKeepFree и почему их путают
Разовая чистка лечит симптом. Чтобы объём держался сам, есть четыре параметра в journald.conf(5), и путают их регулярно. SystemMaxUse= — сколько журналу можно занять максимум. SystemKeepFree= — сколько свободного места журнал обязан оставить всем остальным. Это не одно и то же и не альтернатива: мануал говорит, что «systemd-journald will respect both limits and use the smaller of the two values». По умолчанию первое — 10 % размера файловой системы, второе — 15 %, и каждое значение ограничено сверху 4 ГБ. Именно поэтому на 40-гигабайтном корне журнал спокойно вырастает до 4 ГБ и формально ничего не нарушает.
Есть неочевидная тонкость, которая объясняет странные наблюдения. Мануал: «If the file system is nearly full and either SystemKeepFree= or RuntimeKeepFree= are violated when systemd-journald is started, the limit will be raised to the percentage that is actually free». То есть если journald стартовал на уже забитом разделе, он не станет героически освобождать место — он просто понизит собственные аппетиты до фактически свободного объёма. И там же прямым текстом: «journald will stop using more space, but it will not be removing existing files to reduce the footprint again, either». Отсюда практическое следствие: уменьшили SystemMaxUse на живом сервере — не ждите мгновенного эффекта, лишнее уйдёт только при очередной ротации и вакууме, которые journald запускает сам. Чтобы не ждать, ротируйте и вакуумьте руками один раз.
SystemMaxFiles= (по умолчанию 100) ограничивает количество файлов, и с ним та же история: «only archived files are deleted to reduce the number of files until this limit is reached; active files will stay around». Общий итог мануал формулирует честно и без иллюзий: «there might still be more space used than SystemMaxUse= or RuntimeMaxUse= limit after a vacuuming operation is complete». Это ровно тот ответ на вопрос из заголовка, только написанный разработчиками systemd.
Мой рабочий шаблон конфига — ниже. Ставлю его всегда drop-in файлом, а не правкой /etc/systemd/journald.conf: обновление пакета systemd перезапишет основной файл или подсунет .dpkg-dist/.rpmnew, и ваши настройки тихо уедут. Проверять результат — systemd-analyze cat-config systemd/journald.conf, эта команда собирает итоговую конфигурацию из всех кусков и показывает, кто кого перекрыл.
# /etc/systemd/journald.conf.d/10-limits.conf
[Journal]
Storage=persistent
Compress=yes
SystemMaxUse=2G
SystemKeepFree=4G
SystemMaxFileSize=128M
SystemMaxFiles=50
MaxRetentionSec=1month
ForwardToSyslog=no
sudo systemd-analyze cat-config systemd/journald.conf
sudo systemctl restart systemd-journald
sudo journalctl --rotate --vacuum-size=2G
sudo journalctl --disk-usage- SystemMaxUse= — потолок для журнала; по умолчанию 10 % ФС, но не больше 4G
- SystemKeepFree= — сколько оставить остальным; по умолчанию 15 % ФС, но не больше 4G; журнал уважает оба и берёт меньшее
- SystemMaxFileSize= — размер одного файла и гранулярность освобождения; по умолчанию 1/8 от SystemMaxUse, не больше 128M; в compact-режиме (включён по умолчанию) абсолютный максимум файла — 4G
- SystemMaxFiles= — сколько файлов держать, по умолчанию 100; удаляются только архивные
- MaxRetentionSec= — по умолчанию 0 (выключено); включайте, только если есть требование к сроку хранения
- Runtime*-аналоги тех же параметров применяются, когда журнал лежит в /run/log/journal
Когда место сожрал вообще не journald
Первое, что стоит исключить: где вообще лежит журнал. Если в конфиге стоит Storage=volatile или Storage=auto, а каталога /var/log/journal нет, всё пишется в /run/log/journal — а это tmpfs, то есть оперативная память. В этом случае SystemMaxUse не действует вообще, работают Runtime*-параметры, а «переполнение диска» на деле оказывается съеденной памятью. Проверяется одной командой du -sh /var/log/journal /run/log/journal. Кстати, если нужен постоянный журнал, а каталога нет — достаточно создать его и дать systemd-tmpfiles выставить права.
Второе — дубли, о которых я писал выше. На Debian и Ubuntu во многих образах живёт rsyslog, и ForwardToSyslog= гонит в него весь поток; получаете /var/log/syslog или /var/log/messages того же порядка, что и сам журнал. Рядом обычно обнаруживаются логи nginx без ротации и docker с драйвером json-file без max-size — контейнерные логи в /var/lib/docker/containers/*/*-json.log растут без ограничений по умолчанию, и journalctl про них не знает ничего.
Третье — файлы, удалённые руками. Классика: админ делает rm /var/log/journal/*/system@*.journal при живом journald, ls показывает пустоту, а df не меняется — inode держится открытым дескриптором до перезапуска демона. Ищется через sudo lsof -nP +L1 | grep -i journal, лечится systemctl restart systemd-journald. Но лучше вообще не удалять .journal вручную: вы рвёте индексы и получаете невнятные ошибки чтения по всему набору файлов. Штатный способ ровно один — вакуум.
Четвёртое — каталоги, до которых обычная команда просто не дотягивается. После клонирования ВМ в /var/log/journal остаётся каталог со старым machine-id. Юниты с LogNamespace= пишут в отдельный каталог вида <machine-id>.<namespace>, и обычный journalctl --vacuum-size их не чистит — нужен ключ --namespace=. Приёмник systemd-journal-remote складывает чужие журналы в /var/log/journal/remote, и туда надо идти через --directory=. Всё это входит в общую цифру --disk-usage, но не входит в область действия команды, которую вы набрали.
# журнал в памяти или на диске?
sudo du -sh /var/log/journal /run/log/journal 2>/dev/null

# что ещё ест /var/log
sudo du -sh /var/log/* | sort -h | tail -15

# удалённые, но открытые файлы
sudo lsof -nP +L1 | grep -i journal

# отдельный namespace и внешний каталог чистятся отдельно
sudo journalctl --namespace=telemetry --rotate --vacuum-size=200M
sudo journalctl --directory=/var/log/journal/remote --vacuum-time=30d- /run/log/journal = tmpfs = оперативка, лимиты там Runtime*, а не System*
- rsyslog + ForwardToSyslog=yes = вторая копия того же журнала на том же разделе
- docker json-file без max-size растёт бесконечно и к journald отношения не имеет
- rm по .journal при живом journald не отдаёт место до рестарта демона
- namespace-каталоги и /var/log/journal/remote требуют --namespace= и --directory=
Как найти источник спама и заткнуть его точечно
Ограничивать размер журнала, не разобравшись, кто его наполняет, — это лечить температуру. Сначала находим виновника: одна команда за час-два наблюдений почти всегда даёт понятную картину, где один-два юнита выдают больше половины потока. Если jq на сервере нет, тот же результат даёт связка journalctl -o verbose | grep _SYSTEMD_UNIT | sort | uniq -c | sort -rn, просто заметно медленнее.
Глобальный предохранитель у journald уже есть: RateLimitIntervalSec= и RateLimitBurst= по умолчанию дают 10 000 сообщений за 30 секунд, причём — важная деталь — лимит применяется на каждый сервис отдельно, «so that two services which log do not interfere with each other's limits». Поднимать эти значения почти никогда не нужно; если сервис в них упирается, проблема в сервисе. Отключать (нулём) — тем более: получите ровно то, с чего начали статью.
Точечно юнит душится drop-in файлом. LogLevelMax= (systemd 236 и новее) режет всё ниже указанного уровня — обычно достаточно notice. LogRateLimitIntervalSec=/LogRateLimitBurst= переопределяют глобальный лимит для одного юнита. LogFilterPatterns= (появился в systemd 253) фильтрует по регулярному выражению поле MESSAGE; шаблон, начинающийся с ~, означает «выкинуть совпавшее». Работает он только для системных сервисов, не для пользовательских юнитов, и отфильтрованное не уходит ни в syslog, ни в kmsg. Последнее — самый аккуратный инструмент, когда вам нужно вырезать конкретный шумный heartbeat, но оставить всё остальное на уровне info.
# /etc/systemd/system/telemetry.service.d/10-logs.conf
[Service]
LogLevelMax=notice
LogRateLimitIntervalSec=30s
LogRateLimitBurst=200
LogFilterPatterns=~^heartbeat ok
sudo systemctl daemon-reload
sudo systemctl restart telemetry.service
systemctl cat telemetry.service- LogLevelMax= — доступен начиная с systemd 236, есть везде, где вы работаете
- LogRateLimitIntervalSec=/LogRateLimitBurst= — переопределение глобального лимита для одного юнита
- LogFilterPatterns= — только systemd 253+; на RHEL 8 (systemd 239), Ubuntu 20.04 (245) и Ubuntu 22.04 (249) его нет; только системные сервисы
- ForwardToSyslog=no — минус вторая копия потока, часто это половина проблемы
Мой порядок действий и на что можно забить
Когда прилетает «диск забит», я иду строго по этому списку и не перескакиваю. Порядок важен: если начать с крутилок в journald.conf, можно час двигать лимиты на сервере, где журнал вообще не был проблемой.
Отдельно про то, что чистка убивает историю. Если диск переполнился на фоне инцидента — сначала сохраните нужное окно, потом чистите. И чистите по времени, а не по размеру: --vacuum-time=14d оставляет предсказуемое окно наблюдения, --vacuum-size= может срезать ровно те сутки, ради которых вы всё это затеяли. Экспорт делается штатно, но учтите: поток -o export — это не .journal-файл, и journalctl --file его напрямую не прочитает. Для разбора распакуйте архив и превратите поток обратно в журнал через /usr/lib/systemd/systemd-journal-remote -o incident.journal - (пакет systemd-journal-remote), после чего открывайте его journalctl --file=incident.journal.
И про то, на что можно забить со спокойной душой. Compress= включён по умолчанию, трогать не надо. SplitMode= менять не надо почти никогда. Гонять вакуум по крону каждый час — не надо: корректно выставленные SystemMaxUse/SystemKeepFree делают то же самое сами и синхронно, при расширении файлов. Переезжать «обратно на syslog, потому что привычнее» — точно не надо: вы получите две системы логирования вместо одной и ровно ту же проблему через полгода. Единственный крон, который я иногда ставлю, — еженедельный journalctl --rotate --vacuum-time=<срок хранения> на машинах, где есть формальное требование к глубине хранения логов.
# сохранить окно инцидента перед любой чисткой
sudo journalctl --since '2026-09-05 18:00' --until '2026-09-06 09:00' \
  -o export | zstd -19 > /root/incident-20260906.journal.export.zst

# и только потом
sudo journalctl --rotate --vacuum-time=14d- 1. `df -h` и `du -sh /var/log/*` — убедиться, что виноват именно журнал, а не syslog/docker/nginx
- 2. `journalctl --disk-usage` и `journalctl --header | grep -E 'File path|^State'` — сколько в активных, сколько в архивах
- 3. сохранить окно инцидента, если расследование ещё идёт
- 4. `journalctl --rotate --vacuum-time=14d` (или --vacuum-size=, если места совсем нет) — разовая чистка
- 5. drop-in /etc/systemd/journald.conf.d/10-limits.conf с SystemMaxUse/SystemKeepFree/SystemMaxFileSize
- 6. найти шумный юнит и придушить его LogLevelMax/rate limit — иначе вернётесь к пункту 1 через месяц
- 7. поставить в мониторинг метрику по /var (или по /), а не только по корню целиком
Частые вопросы
Почему после journalctl --vacuum-size=200M команда --disk-usage показывает 3 ГБ?
Потому что --disk-usage считает сумму активных и архивных файлов, а --vacuum-size= удаляет только старейшие архивные. Активные файлы (system.journal, user-<UID>.journal и файлы namespace-ов) остаются нетронутыми. Сделайте `journalctl --rotate --vacuum-size=200M` одной командой: сначала активные станут архивными, потом отработает вакуум.
Можно ли просто удалить файлы в /var/log/journal через rm?
Нет. journald держит их открытыми, поэтому df не изменится до перезапуска демона, а индексы вы порвёте и получите ошибки чтения по всему набору файлов. Штатный инструмент один — journalctl --rotate --vacuum-size=/--vacuum-time=. Если кто-то уже удалил файлы, найдите зависшие дескрипторы через `lsof -nP +L1 | grep journal` и перезапустите systemd-journald.
Чем SystemMaxUse отличается от SystemKeepFree и что ставить?
SystemMaxUse — максимум, который может занять журнал; SystemKeepFree — минимум свободного места, который он обязан оставить остальным. journald учитывает обе границы и использует меньшую. По умолчанию это 10 % и 15 % размера файловой системы с потолком 4 ГБ каждая. На типовом сервере с корнем 40–80 ГБ я ставлю SystemMaxUse=2G и SystemKeepFree=4G.
Почему после уменьшения SystemMaxUse место не освободилось сразу?
journald не удаляет существующие файлы, чтобы задним числом уменьшить свой след, — новые лимиты применяются при очередной ротации и вакууме, которые демон выполняет сам. Чтобы получить эффект немедленно, после правки конфига выполните `systemctl restart systemd-journald` (он перечитает конфигурацию) и разово `journalctl --rotate --vacuum-size=<новый лимит>`.
Как почистить журнал, не потеряв логи инцидента?
Сначала выгрузите нужное окно: `journalctl --since '…' --until '…' -o export | zstd -19 > /root/incident.export.zst`. Затем чистите по времени, а не по размеру: --vacuum-time=14d оставляет предсказуемую глубину, тогда как --vacuum-size= может срезать именно те сутки, которые нужны для разбора. Учтите, что export-поток читается не через journalctl --file, а после обратной конвертации утилитой systemd-journal-remote.
Мой журнал лежит в /run/log/journal — почему SystemMaxUse не работает?
Потому что к /run/log/journal применяются параметры с префиксом Runtime (RuntimeMaxUse=, RuntimeKeepFree= и т. д.), а System*-опции действуют только для постоянного хранилища /var/log/journal. Это значит, что журнал лежит в tmpfs, то есть в оперативной памяти. Если нужен постоянный журнал — создайте /var/log/journal, выставьте права через systemd-tmpfiles и поставьте Storage=persistent.
Источники
- journalctl(1), systemd 261.3 — Разделы --disk-usage, --vacuum-size=/--vacuum-time=/--vacuum-files= (Added in version 218, ноль = лимит не применяется), --rotate (Added in version 227): «This shows the sum of the disk usage of all archived and active journal files», «--vacuum-size= has only an indirect effect on the output shown by --disk-usage», порядок при комбинировании с --rotate. https://www.freedesktop.org/software/systemd/man/latest/journalctl.html (зеркало: https://man.archlinux.org/man/journalctl.1.en)
- journald.conf(5), systemd 261.3 — SystemMaxUse=/SystemKeepFree= (10 % и 15 % ФС, потолок 4G, «respect both limits and use the smaller of the two values»), SystemMaxFileSize= (1/8 от MaxUse, потолок 128M, максимум 4G в compact-режиме), SystemMaxFiles=100, MaxFileSec= (1 месяц), MaxRetentionSec= (0), RateLimitIntervalSec=/RateLimitBurst= (10000 за 30s, per-service). https://www.freedesktop.org/software/systemd/man/latest/journald.conf.html (зеркало: https://man.archlinux.org/man/journald.conf.5.en)
- systemd-journald.service(8) — Раздел SIGNALS: SIGUSR1 — flush из /run в /var, SIGUSR2 — «Request immediate rotation of the journal files», SIGRTMIN+1 — запись несброшенных данных; создание /var/log/journal через systemd-tmpfiles --create --prefix /var/log/journal; отдельные журналы на пользователей. https://www.freedesktop.org/software/systemd/man/latest/systemd-journald.service.html
- systemd.exec(5) — Опции юнита LogLevelMax= (Added in version 236), LogRateLimitIntervalSec=/LogRateLimitBurst=, LogFilterPatterns= (Added in version 253, фильтр по полю MESSAGE=, deny через «~», только системные сервисы), LogNamespace=. https://www.freedesktop.org/software/systemd/man/latest/systemd.exec.html
- journalctl(1), systemd-journal-remote.service(8) — Формат export (-o export) и его обратное преобразование в .journal: https://www.freedesktop.org/software/systemd/man/latest/systemd-journal-remote.service.html
- systemd, релизы проекта — Актуальность версий на сентябрь 2026: стабильная ветка v261.3, v262-rc2 от 08.09.2026; поведение --vacuum-* и --disk-usage не менялось с v218. https://github.com/systemd/systemd/releases