
Бэкапы журнала проходят, а log_reuse_wait_desc всё ещё LOG_BACKUP: разбираемся, авария это или нет
Ночной алерт: «журнал транзакций не освобождается, log_reuse_wait_desc = LOG_BACKUP». Бывает два совершенно разных сценария за одним и тем же текстом. В первом база в модели FULL годами живёт без единого BACKUP LOG, файл .ldf пухнет до размеров самой базы и однажды упирается в диск. Во втором бэкапы лога идут по расписанию, все job зелёные, занято меньше процента — а статус всё равно висит. Разберу, что этот статус на самом деле показывает, почему после успешного бэкапа он законно остаётся LOG_BACKUP, по каким метрикам я отличаю нормальную работу от предаварийной ситуации и что категорически не надо делать в панике в три часа ночи.
Что на самом деле показывает log_reuse_wait_desc
Ситуация знакомая до зубовного скрежета. 03:40, прилетает письмо от мониторинга: у базы продуктива log_reuse_wait_desc = LOG_BACKUP. Администратор просыпается, лезет в SSMS, видит, что job бэкапа журнала отработал четыре минуты назад со статусом Succeeded, повторяет бэкап руками — статус не меняется. Дальше по классике: паника, поиск в интернете, кто-то советует переключить базу в SIMPLE и обратно, кто-то — сделать SHRINKFILE. К утру база жива, цепочка бэкапов порвана, а причина так и не понята.
Начну с главного. log_reuse_wait_desc — это не индикатор здоровья и не измеритель заполнения. Это ответ движка на один узкий вопрос: что помешало повторно использовать место в журнале в момент последней попытки. Документация Microsoft по sys.databases формулирует это буквально: «Reuse of transaction log space is currently waiting on one of the following as of the last checkpoint» — то есть значение отражает состояние на момент последнего checkpoint. Не «сейчас», не «прямо в эту секунду», а на момент последней контрольной точки. Между checkpoint'ами значение просто лежит в метаданных и никем не пересчитывается.
Второй момент — физика журнала. Журнал устроен как кольцо из виртуальных файлов (VLF). Усечение (truncation) не стирает записи и не трогает файл на диске: оно всего лишь помечает неактивные VLF как доступные для повторной записи. И вот ключевое: как минимум один VLF всегда обязан оставаться активным — тот, в который прямо сейчас пишутся лог-блоки. Пол Рэндал в разборе кольцевой природы журнала говорит об этом прямым текстом: «there always has to be at least one active VLF in the transaction log». Если база пишет мало и с прошлого бэкапа голова журнала не успела перевалить в следующий VLF, бэкап лога честно отработает, а текущий VLF так и останется активным — освобождать в нём нечего.
Отсюда и весь эффект. Бэкап прошёл, LSN сдвинулся, следующий бэкап заберёт всё что нужно, но описание причины ожидания в sys.databases по-прежнему LOG_BACKUP, потому что на момент последней проверки движку действительно нужен был очередной бэкап журнала, чтобы освободить хоть что-то сверх текущего VLF. Это не сбой, не порванная цепочка и не повод будить людей. Это статус, который вы прочитали не тем инструментом.
- Статус НЕ показывает, сколько места занято в журнале — для этого есть отдельная DMV.
- Статус НЕ обновляется в реальном времени: он актуален на момент последнего checkpoint.
- Статус НЕ означает, что бэкап журнала не прошёл — проверять надо msdb.dbo.backupset и log_backup_time.
- Значение NOTHING не является целевым состоянием боевой базы: на активной OLTP-базе в FULL вы будете видеть LOG_BACKUP большую часть времени.
Три запроса, которые закрывают вопрос за десять секунд
Первое, что я делаю вместо чтения статуса, — смотрю фактическое заполнение. sys.dm_db_log_space_usage отдаёт ровно то, что нужно: общий размер журнала, занятый объём, процент и — с SQL Server 2014 и новее — сколько лога набежало с последнего бэкапа журнала. Запускать надо в контексте нужной базы, представление возвращает одну строку и суммирует все файлы журнала.
USE [StomGrad_Med];
GO
SELECT DB_NAME() AS db_name,
       total_log_size_in_bytes / 1048576.0            AS total_mb,
       used_log_space_in_bytes / 1048576.0            AS used_mb,
       used_log_space_in_percent                      AS used_pct,
       log_space_in_bytes_since_last_backup / 1048576.0 AS since_backup_mb
FROM sys.dm_db_log_space_usage;
Если нужно одним взглядом окинуть все базы экземпляра, старый добрый DBCC SQLPERF(LOGSPACE) никуда не делся: он возвращает по строке на каждую базу — имя, размер журнала в мегабайтах и процент занятого места. Microsoft в описании команды прямо рекомендует начиная с SQL Server 2012 использовать для одной базы sys.dm_db_log_space_usage, но для быстрой ночной сводки «кто из баз распух» SQLPERF по-прежнему удобнее. Требует VIEW SERVER STATE на сервере.
DBCC SQLPERF (LOGSPACE);
GO
Второй запрос — sys.dm_db_log_stats. Это табличная функция, появилась в SQL Server 2016 SP2 и живёт во всех версиях по SQL Server 2025 включительно. Она отдаёт то же самое поле причины удержания, но уже вместе с контекстом: log_truncation_holdup_reason (значение то же, что log_reuse_wait_desc), время старта последнего бэкапа журнала, объём лога с последнего бэкапа и с последнего checkpoint, число VLF всего и число активных VLF. Именно связка «причина + время последнего бэкапа + число активных VLF» и даёт диагноз, а не одно текстовое поле.
SELECT d.name,
       s.recovery_model,
       s.log_truncation_holdup_reason,
       s.log_backup_time,
       s.log_since_last_log_backup_mb,
       s.log_since_last_checkpoint_mb,
       s.total_vlf_count,
       s.active_vlf_count,
       s.active_log_size_mb,
       s.total_log_size_mb
FROM sys.databases AS d
CROSS APPLY sys.dm_db_log_stats(d.database_id) AS s
WHERE d.state = 0 AND d.database_id > 4;
Третий запрос нужен реже, но именно он ставит точку в споре «а точно ли журнал зациклился». sys.dm_db_log_info показывает каждый VLF отдельно: смещение, размер, порядковый номер, признак активности и статус, где 0 — VLF неактивен, 1 — инициализирован, но не использован, 2 — активен. Microsoft прямо пишет, что эта функция заменяет старый недокументированный DBCC LOGINFO, так что новые скрипты стоит писать сразу на ней. Если у вас 400 VLF и активны два — с журналом всё в порядке, что бы ни писала строчка статуса.
SELECT COUNT(*)                                        AS vlf_total,
       SUM(CASE WHEN vlf_active = 1 THEN 1 ELSE 0 END) AS vlf_active,
       CAST(SUM(vlf_size_mb) AS decimal(12,1))         AS log_mb
FROM sys.dm_db_log_info(DB_ID(N'StomGrad_Med'));
Для ориентира по количеству VLF у Microsoft в примерах к sys.dm_db_log_info и sys.dm_db_log_stats фигурирует порог в 100 VLF: больше — повод посмотреть, как рос журнал. Реальные проблемы со стартом и восстановлением базы документация описывает на сотнях тысяч VLF, так что сотня — не авария, а сигнал к плановой гигиене.
- sys.dm_db_log_space_usage — процент занятого журнала и объём с последнего бэкапа лога.
- sys.dm_db_log_stats(database_id) — причина удержания, время бэкапа, VLF-статистика в одной строке.
- sys.dm_db_log_info(database_id) — по каждому VLF отдельно, замена DBCC LOGINFO.
- msdb.dbo.backupset с type = 'L' — доказательство, что бэкапы журнала физически идут и цепочка не рвалась.
- DBCC SQLPERF(LOGSPACE) — размер и процент заполнения журнала сразу по всем базам экземпляра.
Разбор из практики: стоматологическая клиника на 14 рабочих мест
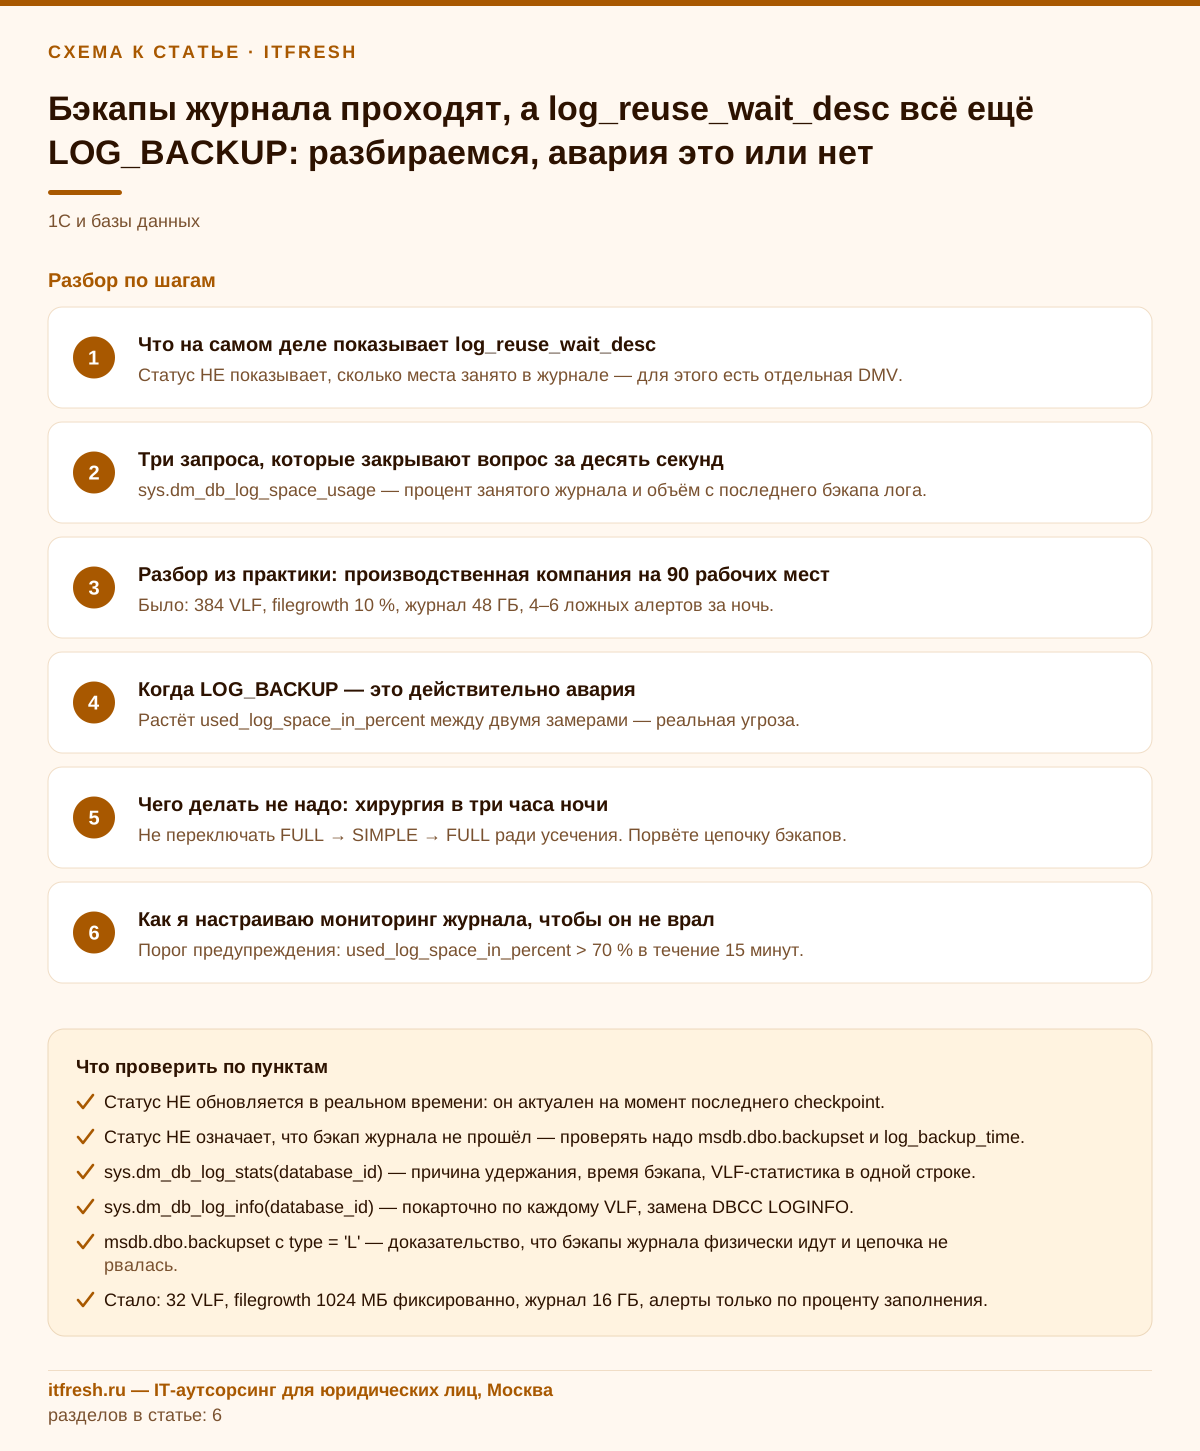
Клиент — стоматологическая клиника «СтомГрад», 14 рабочих мест: регистратура, кабинеты врачей, бухгалтерия и директор. Один сервер на всё: Windows Server 2022, SQL Server 2025 Standard, 8 vCPU, 32 ГБ ОЗУ, он же сервер 1С. Отраслевая конфигурация 1С для медицинской клиники плюс ЗУП, основная база около 38 ГБ. Данные лежат на SSD-зеркале 400 ГБ, журналы — на отдельном томе 60 ГБ. Базу когда-то создал сервер 1С, и она унаследовала модель восстановления FULL от системной базы model. Предыдущий подрядчик настроил план обслуживания с ночным полным бэкапом — и ни одного BACKUP LOG.
Итог предсказуем. За три года файл журнала дорос до 41 ГБ при базе в 38 ГБ, sys.dm_db_log_stats показывал log_truncation_holdup_reason = LOG_BACKUP, log_backup_time = NULL, а DBCC SQLPERF(LOGSPACE) — 97 % занятого места. Автоприрост стоял по умолчанию, 64 МБ, поэтому журнал разбился на 648 VLF. Когда на томе журналов осталось 4 ГБ, кто-то из «приходящих» админов сделал классику: SIMPLE, SHRINKFILE, обратно FULL. Файл сжался, через четыре месяца снова разросся. Точки восстановления на момент времени у клиники при этом не было никогда: без журнальных бэкапов RPO равнялся суткам, сколько бы ни стояло галочек FULL.
Что мы сделали. Сразу после возврата в FULL сняли полный бэкап, чтобы начать цепочку журналов, и включили BACKUP LOG каждые 15 минут. После второго журнального бэкапа журнал усёкся, used_log_space_in_percent упал до долей процента. Дальше — разовая гигиена: DBCC SHRINKFILE журнала до 256 МБ и сразу ALTER DATABASE MODIFY FILE до 8 ГБ одним шагом, FILEGROWTH фиксированные 512 МБ. Прирост больше гигабайта SQL Server нарезает на 16 VLF, так что total_vlf_count стал 20 вместо 648. Время запуска базы после перезагрузки сервера сократилось с минуты с лишним до нескольких секунд.
А потом начались ночные алерты. Шаблон мониторинга, который стоял на сервере, содержал триггер «log_reuse_wait_desc <> NOTHING», и раньше он молчал только потому, что статус был стабильно LOG_BACKUP и триггер кто-то давно отключил. Мы его включили вместе со всем шаблоном — и он начал стрелять каждую ночь примерно с 22:00 до 07:00, когда клиника закрыта и в базу пишут только регламентные задания 1С. Дежурный делал ручной BACKUP LOG, статус не менялся.
Цифры в момент алерта оказались предельно скучными. sys.dm_db_log_space_usage: журнал 8 ГБ, used_log_space_in_percent — 0,6 %, log_space_in_bytes_since_last_backup — около 1,2 МБ. sys.dm_db_log_stats: log_backup_time — 4 минуты назад, log_truncation_holdup_reason — LOG_BACKUP, total_vlf_count 20, active_vlf_count 1. Ночью запись падала до сотен килобайт за интервал, голова журнала не уходила за границу текущего VLF — ровно тот сценарий, который описан выше. Триггер на текстовый статус мы выключили и завели вместо него два: used_log_space_in_percent > 70 в течение 15 минут и возраст журнального бэкапа больше 35 минут.
- Было: FULL без журнальных бэкапов, журнал 41 ГБ, 648 VLF, прирост 64 МБ, RPO — сутки.
- Стало: BACKUP LOG каждые 15 минут, журнал 8 ГБ, 20 VLF, прирост 512 МБ фиксированно, RPO — 15 минут.
- Мониторинг: вместо «log_reuse_wait_desc <> NOTHING» — процент заполнения и возраст журнального бэкапа, ноль ложных ночных алертов.
- Побочный ущерб до разбора: два цикла SIMPLE → SHRINKFILE → FULL, каждый из которых ничего не лечил, и три года без восстановления на момент времени.
Когда LOG_BACKUP — это действительно авария
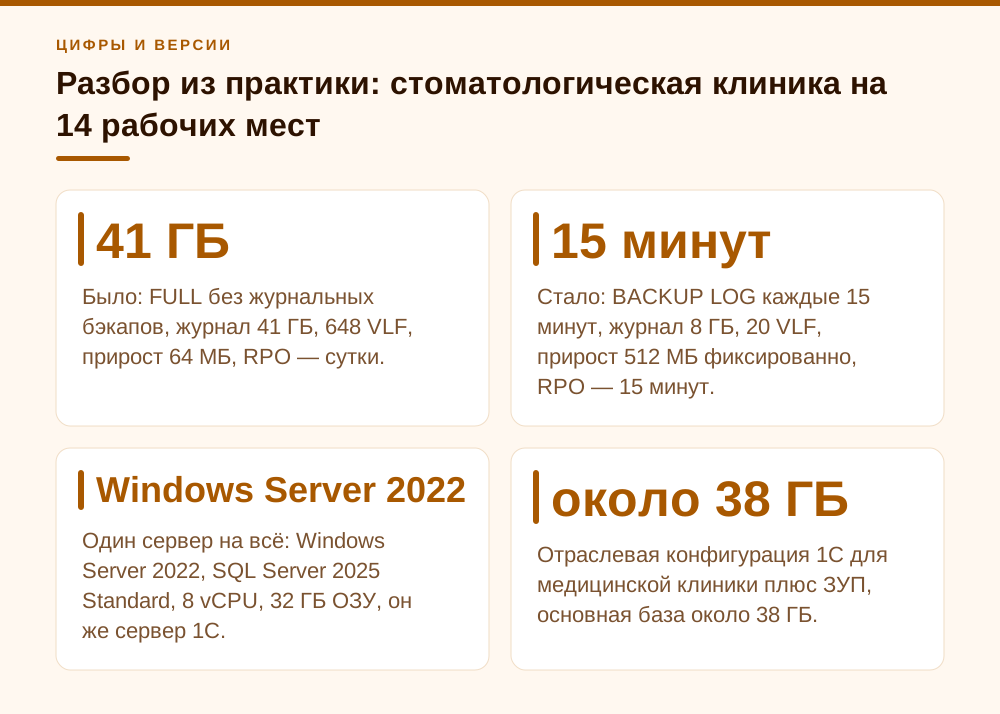
Теперь честно про обратную сторону: успокаиваться нельзя, потому что тот же самый статус сопровождает и настоящую беду. Разница не в тексте, а в динамике. Если снять метрики дважды с интервалом в 15–20 минут и увидеть, что used_log_space_in_percent растёт, log_since_last_log_backup_mb растёт, а log_backup_time не двигается — вот это уже инцидент, и заниматься им надо немедленно, до того как журнал упрётся в максимальный размер и вы получите ошибку 9002.
Причин, по которым бэкап журнала «идёт», но не освобождает место, в моей практике набралось немного, и все они проверяются за пять минут. Первая — job упал или отключён, а мониторинг следит за SQL Agent, но не за конкретным шагом. Вторая — журнал бэкапится с опцией COPY_ONLY: такой бэкап по определению не вызывает усечение, и это прямо написано в документации. Третья — на диске бэкапов кончилось место, бэкап валится, а алерт уходит в почтовый ящик, который никто не читает. Четвёртая, самая частая на небольших серверах 1С, — журнальных бэкапов нет вообще: база в FULL, план обслуживания делает только полный бэкап. Полный бэкап журнал не усекает. Коварство в том, что после перевода из SIMPLE в FULL модель начинает действовать только после первого полного или разностного бэкапа — до него журнал усекается как в SIMPLE. Так что проблема проявляется не сразу, а через недели после того, как появился первый ночной полный бэкап.
Если выяснилось, что журнал никогда не бэкапился, документация Microsoft по ошибке 9002 даёт важную деталь: чтобы движок смог усечь журнал до точки последнего бэкапа, понадобятся два журнальных бэкапа подряд, а не один. Не пугайтесь, если после первого BACKUP LOG процент заполнения почти не изменился, — сделайте второй и только потом делайте выводы.
BACKUP LOG [StomGrad_Med] TO DISK = N'E:\SQLBackup\StomGrad_Med_log_1.trn';
BACKUP LOG [StomGrad_Med] TO DISK = N'E:\SQLBackup\StomGrad_Med_log_2.trn';
SELECT used_log_space_in_percent
FROM [StomGrad_Med].sys.dm_db_log_space_usage;
И отдельная категория — когда причина удержания на самом деле другая, а вы её просто не увидели, потому что смотрели старое значение. ACTIVE_TRANSACTION от зависшей открытой транзакции 1С, REPLICATION с недоставленными в дистрибьютор командами, AVAILABILITY_REPLICA при отставшей вторичной реплике, OLDEST_PAGE при непрямых контрольных точках. Все они дают одинаковую внешнюю картину «журнал пухнет», но лечатся принципиально по-разному. Поэтому диагноз я ставлю по свежему значению из sys.dm_db_log_stats, а не по тому, что показал sys.databases в момент отправки алерта.
Для самой частой из этих причин — активной транзакции — есть быстрый ответ. DBCC OPENTRAN покажет самую старую активную транзакцию в базе, её SPID и время старта. Если она висит с прошлой ночи, никакие бэкапы журнала место не освободят, пока эта транзакция не завершится или не будет откачена.
- Растёт used_log_space_in_percent между двумя замерами — реальная угроза.
- log_backup_time старше вашего интервала бэкапа лога — сначала чините расписание, потом всё остальное.
- log_since_last_log_backup_mb в гигабайтах при интервале 15 минут — идёт массовая операция или бэкапы не проходят.
- active_vlf_count близко к total_vlf_count — кольцо реально замкнулось, места почти нет.
- log_truncation_holdup_reason = ACTIVE_TRANSACTION — бэкапы тут ни при чём, ищите транзакцию через DBCC OPENTRAN.
- log_backup_time = NULL при модели FULL — журнальных бэкапов не было никогда, настраивайте расписание немедленно.
Чего делать не надо: хирургия в три часа ночи
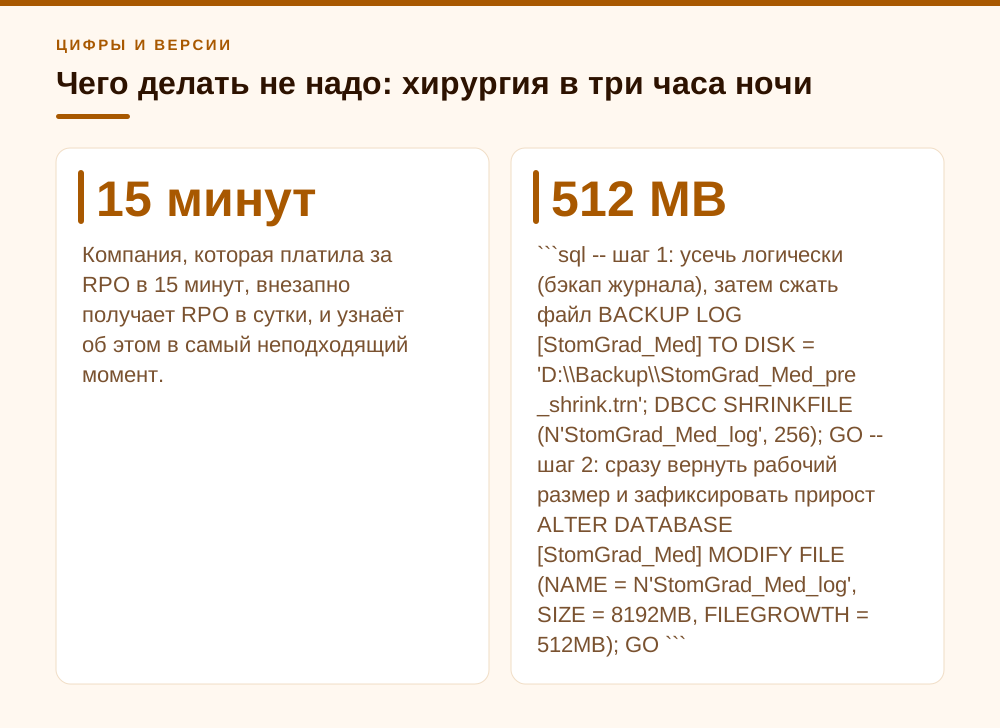
Первое и самое дорогое по последствиям — переключение модели восстановления в SIMPLE и обратно. Да, журнал усечётся. И одновременно с этим порвётся цепочка журнальных бэкапов: восстановиться на произвольный момент времени вы сможете только начиная со следующего полного или разностного бэкапа. Компания, которая платила за RPO в 15 минут, внезапно получает RPO в сутки, и узнаёт об этом в самый неподходящий момент. Если вы всё-таки на это пошли — снимайте полный бэкап немедленно после возврата в FULL, а не «утром, когда нагрузка спадёт».
Второе — попытки применить старые рецепты из интернета. BACKUP LOG ... WITH TRUNCATE_ONLY и NO_LOG удалены из продукта ещё в SQL Server 2008, в 2025-й версии их просто нет, и хорошо, что нет. Регулярный DBCC SHRINKFILE по журналу — тоже не решение: Microsoft в разделе про управление размером журнала прямо предупреждает, что shrink не должен быть регулярной операцией обслуживания, влияет на производительность во время выполнения, а когда журналу снова понадобится место, он вырастет обратно с накладными расходами на каждое расширение. И главное: shrink не устраняет причину. Если журнал не усекается, сжимать нечего — сначала надо понять, чего он ждёт.
Сжатие журнала оправдано ровно в одном сценарии: разовая аномалия раздула файл (перестроение индексов, миграция, массовая загрузка), и вы возвращаете журнал к рабочему размеру. Делается это в два шага и обязательно оба: сжать, а потом сразу же выставить нужный размер одной операцией, чтобы получить корректную нарезку VLF, а не сотни мелких. Сжать журнал можно только когда хотя бы один VLF свободен, а «хвостовые» неактивные VLF отрезаются с конца файла — поэтому иногда сжатие срабатывает только после следующего бэкапа журнала.
-- шаг 1: усечь логически (бэкап журнала), затем сжать файл
BACKUP LOG [StomGrad_Med] TO DISK = 'D:\\Backup\\StomGrad_Med_pre_shrink.trn';
DBCC SHRINKFILE (N'StomGrad_Med_log', 256);
GO
-- шаг 2: сразу вернуть рабочий размер и зафиксировать прирост
ALTER DATABASE [StomGrad_Med]
  MODIFY FILE (NAME = N'StomGrad_Med_log', SIZE = 8192MB, FILEGROWTH = 512MB);
GO
И третье, о чём говорю почти каждому клиенту: не гонитесь за значением NOTHING. Это не KPI. Я видел настройки, где после каждого бэкапа журнала принудительно выполнялся CHECKPOINT только для того, чтобы «статус стал зелёным». Кроме лишнего ввода-вывода это не даёт ничего.
- Не переключать FULL → SIMPLE → FULL ради усечения. Порвёте цепочку бэкапов.
- TRUNCATE_ONLY и NO_LOG удалены с SQL Server 2008 — рецепты с ними безнадёжно устарели.
- Не ставить DBCC SHRINKFILE журнала в регламентное обслуживание.
- После разового сжатия обязательно вернуть размер через ALTER DATABASE MODIFY FILE.
- Не выставлять AUTO_SHRINK = ON. По умолчанию он выключен, и это правильное умолчание.
Как я настраиваю мониторинг журнала, чтобы он не врал
Схема, которую я ставлю клиентам, держится на трёх метриках и ни одна из них не является текстовым статусом. Метрика номер один — процент заполнения журнала из sys.dm_db_log_space_usage: предупреждение на 70 %, авария на 85 %. Метрика номер два — возраст последнего журнального бэкапа: тревога, если log_backup_time старше двух ваших интервалов (для интервала 15 минут — старше 30 минут, я ставлю 35 с запасом на длительность самого бэкапа). Метрика номер три — объём лога с последнего бэкапа: она ловит массовые операции, которые начали писать в журнал гигабайтами, до того как процент заполнения дойдёт до порога.
Текстовую причину удержания я тоже собираю, но не как триггер, а как контекст к алерту. Когда стреляет порог по проценту, инженер сразу видит в теле уведомления, чего именно ждёт журнал, и не тратит первые пять минут на подключение к серверу. Именно поэтому удобно снимать всё одним запросом с CROSS APPLY по всем базам экземпляра — годится и для Zabbix, и для самописного скрипта, и просто для ручной проверки утром. Одна тонкость: sys.dm_db_log_space_usage возвращает данные только по текущей базе, соединить её с sys.databases через database_id не получится — для чужих баз строк просто не будет. Поэтому в сводном запросе по экземпляру я считаю долю активной части журнала из sys.dm_db_log_stats, а точный процент по конкретной базе при разборе беру уже из sys.dm_db_log_space_usage или DBCC SQLPERF(LOGSPACE).
SELECT d.name                                                AS db_name,
       s.recovery_model,
       CAST(s.total_log_size_mb AS decimal(12,1))            AS log_mb,
       CAST(100.0 * s.active_log_size_mb
            / NULLIF(s.total_log_size_mb, 0) AS decimal(5,2)) AS active_pct,
       CAST(s.log_since_last_log_backup_mb AS decimal(12,1)) AS since_backup_mb,
       DATEDIFF(MINUTE, s.log_backup_time, GETDATE())        AS backup_age_min,
       s.log_truncation_holdup_reason                        AS holdup,
       s.active_vlf_count,
       s.total_vlf_count
FROM sys.databases AS d
CROSS APPLY sys.dm_db_log_stats(d.database_id) AS s
WHERE d.state = 0
  AND d.database_id > 4
  AND d.recovery_model_desc <> 'SIMPLE'
ORDER BY active_pct DESC;
Организационная часть не менее важна технической. Бэкап журнала каждые 15 минут для боевой базы 1С — разумное умолчание; если бизнес готов терять час, ставьте час, но решение должно быть осознанным, а не «как настроилось». Журнал держим на отдельном томе с низкой задержкой, filegrowth задаём в мегабайтах, а не в процентах, и не выше 1024 МБ — это прямая рекомендация Microsoft в статье об управлении размером журнала. Строка backup_age_min со значением NULL при модели FULL — отдельный красный флаг: журнал не бэкапился ни разу. Раз в месяц — контрольное восстановление из полного бэкапа плюс цепочки журналов на тестовый экземпляр: только этот тест доказывает, что цепочка цела, а не зелёные галочки в истории job.
И последнее по порядку, но не по важности: заведите в базе знаний одну страницу с этим разбором и ссылкой на неё в теле алерта. Половина ночных инцидентов такого класса — это не техническая проблема, а проблема интерпретации. Дежурный, который за 30 секунд видит «процент не растёт, бэкап был 4 минуты назад — это норма», не будет переключать модель восстановления в три часа ночи.
- Порог предупреждения: used_log_space_in_percent > 70 % в течение 15 минут.
- Порог аварии: used_log_space_in_percent > 85 % или ошибка 9002 в журнале SQL Server.
- Возраст журнального бэкапа: больше двух интервалов расписания.
- Гигиена: filegrowth журнала фиксированный (256–1024 МБ), total_vlf_count ориентировочно до сотни.
- Ежемесячно: тестовое восстановление полной цепочки на отдельный экземпляр.
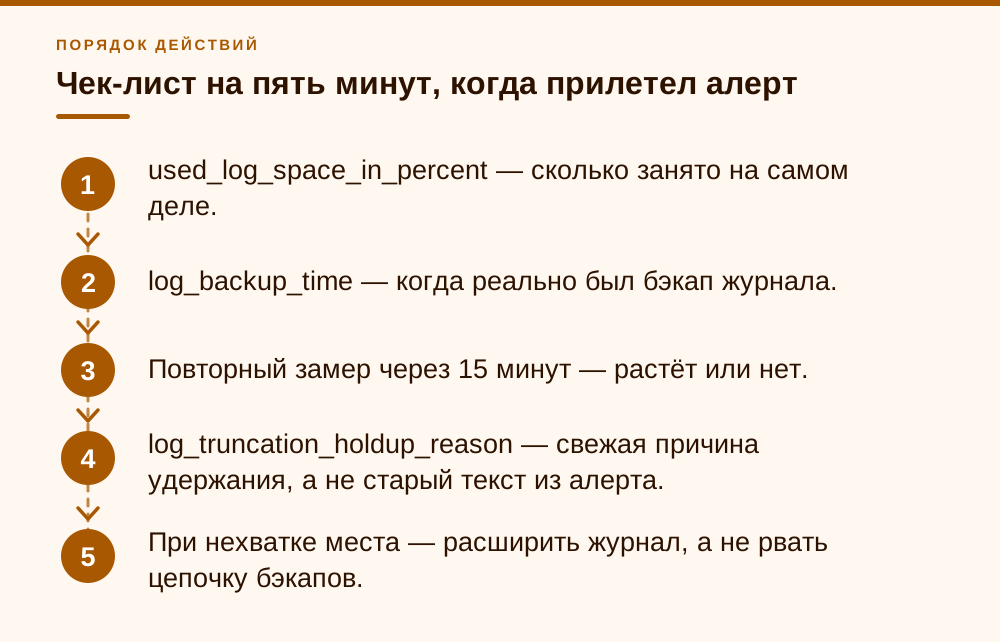
Чек-лист на пять минут, когда прилетел алерт
Порядок действий, который я держу в шпаргалке у дежурных, специально короткий — он рассчитан на человека, которого разбудили. Первый шаг: снять фактическое заполнение через sys.dm_db_log_space_usage. Если used_log_space_in_percent меньше 20 — вы уже знаете ответ, дальше можно не бежать, а разбираться утром. Второй шаг: посмотреть log_backup_time в sys.dm_db_log_stats и сверить с расписанием. Свежий бэкап плюс низкий процент — закрываем инцидент как ложный.
Третий шаг нужен, только если процент высокий. Повторяем первый запрос через 15 минут и сравниваем: растёт или стоит. Если стоит — журнал просто большой и хорошо заполненный, это вопрос планирования размера, а не ночной аварии. Если растёт — четвёртый шаг: смотрим log_truncation_holdup_reason и действуем по причине. LOG_BACKUP — чиним расписание и место на диске бэкапов. ACTIVE_TRANSACTION — DBCC OPENTRAN и разбираемся с зависшей транзакцией. REPLICATION или AVAILABILITY_REPLICA — идём к репликации и группам доступности, журнал тут только симптом.
Пятый шаг — временная мера, чтобы выиграть время: если места на томе достаточно, дать журналу вырасти через ALTER DATABASE MODIFY FILE, а не судорожно его сжимать. Расширение журнала — обратимая операция, разрыв цепочки бэкапов — нет. И только после того как инцидент закрыт и причина устранена, возвращайтесь к вопросу размера файла.
- 1. used_log_space_in_percent — сколько занято на самом деле.
- 2. log_backup_time — когда реально был бэкап журнала.
- 3. Повторный замер через 15 минут — растёт или нет.
- 4. log_truncation_holdup_reason — свежая причина удержания, а не старый текст из алерта.
- 5. При нехватке места — расширить журнал, а не рвать цепочку бэкапов.
Частые вопросы
Почему log_reuse_wait_desc остаётся LOG_BACKUP сразу после успешного бэкапа журнала?
По двум причинам сразу. Во-первых, значение в sys.databases отражает состояние на момент последнего checkpoint, а не текущую секунду. Во-вторых, при слабой записи голова журнала может не выйти за пределы текущего VLF, а текущий VLF всегда остаётся активным — освобождать в нём нечего, и движок честно сообщает, что для дальнейшего усечения нужен очередной бэкап журнала. При заполнении менее 1 % это нормальное рабочее состояние.
База в FULL, полный бэкап каждую ночь есть — почему журнал всё равно растёт?
Потому что в модели FULL журнал усекается только после журнального бэкапа, а полный бэкап его не усекает. Если в плане обслуживания нет BACKUP LOG, журнал копит всё с момента первого полного бэкапа, и log_reuse_wait_desc будет стабильно LOG_BACKUP при растущем проценте заполнения. Лечение — расписание BACKUP LOG (для 1С разумно каждые 15–30 минут); если журнал не бэкапился никогда, для усечения понадобятся два журнальных бэкапа подряд. Если восстановление на момент времени бизнесу не нужно, честнее осознанно перевести базу в SIMPLE и отключить журнальные задания, чем держать FULL без бэкапов.
Как понять, что журнал действительно перестал освобождаться?
Только по динамике. Снимите used_log_space_in_percent из sys.dm_db_log_space_usage дважды с интервалом 15 минут. Если процент растёт, log_since_last_log_backup_mb растёт, а log_backup_time не двигается — это реальный инцидент. Если процент стоит на месте или падает — журнал освобождается штатно, независимо от текста статуса.
Почему после бэкапа журнала файл .ldf не уменьшается?
Потому что усечение и сжатие — разные операции. Усечение освобождает место внутри журнала для повторной записи, помечая неактивные VLF доступными; физический размер файла при этом не меняется — это прямо сказано в документации Microsoft. Уменьшить файл может только DBCC SHRINKFILE, и делать это стоит разово после аномального роста, а не по расписанию.
Можно ли переключить базу в SIMPLE, чтобы усечь журнал, а потом вернуть FULL?
Технически можно, практически — почти всегда не нужно. Такое переключение рвёт цепочку журнальных бэкапов: восстановление на произвольный момент времени станет возможным только начиная со следующего полного или разностного бэкапа. Если вы всё же это сделали, снимите полный бэкап сразу после возврата в FULL, а не «утром».
Работают ли эти запросы на SQL Server 2019 и 2022, или только на 2025?
sys.dm_db_log_stats и sys.dm_db_log_info доступны начиная с SQL Server 2016 SP2, sys.dm_db_log_space_usage и DBCC SQLPERF(LOGSPACE) — и в более ранних версиях (столбец log_space_in_bytes_since_last_backup — с SQL Server 2014). Отличаются права: до SQL Server 2019 включительно нужен VIEW SERVER STATE, начиная с SQL Server 2022 — VIEW SERVER PERFORMANCE STATE на сервере и VIEW DATABASE PERFORMANCE STATE на базе для sys.dm_db_log_info; VIEW SERVER STATE их по-прежнему покрывает.
Сколько VLF считается нормой?
Жёсткого норматива у Microsoft нет. В примерах к sys.dm_db_log_info и sys.dm_db_log_stats порогом для внимания служит 100 VLF, а в руководстве по архитектуре журнала разумным пределом названы «несколько тысяч»; серьёзные задержки старта и восстановления описаны при сотнях тысяч VLF. На практике я считаю здоровым диапазон в несколько десятков и планово разбираюсь с журналом, если счётчик уходит за пару сотен — причина почти всегда в мелком шаге FILEGROWTH, на котором журнал рос годами.
Источники
- Microsoft Learn — sys.databases (Transact-SQL) — Описание столбцов log_reuse_wait и log_reuse_wait_desc: значение отражает причину ожидания повторного использования журнала «as of the last checkpoint». Версия SQL Server 2025 (17.x). https://learn.microsoft.com/en-us/sql/relational-databases/system-catalog-views/sys-databases-transact-sql?view=sql-server-ver17
- Microsoft Learn — The Transaction Log (SQL Server) — Разделы «Transaction log truncation» и «Factors that can delay log truncation»: усечение не уменьшает физический размер файла журнала; полная таблица значений log_reuse_wait_desc с пояснениями (LOG_BACKUP, ACTIVE_TRANSACTION, AVAILABILITY_REPLICA и др.). https://learn.microsoft.com/en-us/sql/relational-databases/logs/the-transaction-log-sql-server?view=sql-server-ver17
- Microsoft Learn — sys.dm_db_log_space_usage (Transact-SQL) — Столбцы total_log_size_in_bytes, used_log_space_in_bytes, used_log_space_in_percent, log_space_in_bytes_since_last_backup (с SQL Server 2014); все файлы журнала суммируются; права VIEW SERVER STATE до SQL Server 2019, VIEW SERVER PERFORMANCE STATE начиная с SQL Server 2022. https://learn.microsoft.com/en-us/sql/relational-databases/system-dynamic-management-objects/sys-dm-db-log-space-usage-transact-sql?view=sql-server-ver17
- Microsoft Learn — sys.dm_db_log_stats (Transact-SQL) — С SQL Server 2016 SP2; столбцы log_truncation_holdup_reason (совпадает с log_reuse_wait_desc), log_backup_time (время начала последнего журнального бэкапа), log_since_last_log_backup_mb, total_vlf_count, active_vlf_count, active_log_size_mb, total_log_size_mb. https://learn.microsoft.com/en-us/sql/relational-databases/system-dynamic-management-objects/sys-dm-db-log-stats-transact-sql?view=sql-server-ver17
- Microsoft Learn — sys.dm_db_log_info (Transact-SQL) — Информация по каждому VLF: vlf_active, vlf_status (0 — неактивен, 1 — инициализирован и не использован, 2 — активен); функция заменяет DBCC LOGINFO; с SQL Server 2016 SP2; права VIEW DATABASE PERFORMANCE STATE начиная с SQL Server 2022; пример с порогом 100 VLF. https://learn.microsoft.com/en-us/sql/relational-databases/system-dynamic-management-objects/sys-dm-db-log-info-transact-sql?view=sql-server-ver17
- Microsoft Learn — Manage the size of the transaction log file — Мониторинг журнала через sys.dm_db_log_space_usage, предупреждение о том, что сжатие не должно быть регулярной операцией обслуживания, рекомендации по FILEGROWTH (не выше 1024 МБ для журнала, задавать в мегабайтах, а не в процентах). https://learn.microsoft.com/en-us/sql/relational-databases/logs/manage-the-size-of-the-transaction-log-file?view=sql-server-ver17
- Microsoft Learn — Troubleshoot a full transaction log (SQL Server Error 9002) — Раздел «LOG_BACKUP log_reuse_wait»: регулярные журнальные бэкапы для баз в FULL/BULK_LOGGED; если журнал никогда не бэкапился, нужны два журнальных бэкапа; усечение и сжатие — разные операции, shrink сам по себе не решает проблему заполненного журнала. https://learn.microsoft.com/en-us/sql/relational-databases/logs/troubleshoot-a-full-transaction-log-sql-server-error-9002?view=sql-server-ver17
- Microsoft Learn — Set database recovery model — Раздел «Recommendations: After you change the recovery model»: после перехода из SIMPLE в FULL сразу сделать полный или разностный бэкап, чтобы начать цепочку журналов; переключение вступает в силу только после первого бэкапа данных. https://learn.microsoft.com/en-us/sql/relational-databases/backup-restore/view-or-change-the-recovery-model-of-a-database-sql-server?view=sql-server-ver17
- Microsoft Learn — DBCC SQLPERF (Transact-SQL) — LOGSPACE: размер журнала и процент занятого места по всем базам; с SQL Server 2012 для одной базы рекомендуется sys.dm_db_log_space_usage; права VIEW SERVER STATE. https://learn.microsoft.com/en-us/sql/t-sql/database-console-commands/dbcc-sqlperf-transact-sql?view=sql-server-ver17
- Microsoft Learn — SQL Server Transaction Log Architecture and Management Guide — Раздел «Virtual log file (VLF) creation»: с SQL Server 2014 прирост меньше 1/8 размера журнала даёт 1 VLF, прирост больше 1 ГБ — 16 VLF; с SQL Server 2022 прирост до 64 МБ — 1 VLF; разумный предел — несколько тысяч VLF; порядок исправления: сжать журнал и вырастить одним шагом. https://learn.microsoft.com/en-us/sql/relational-databases/sql-server-transaction-log-architecture-and-management-guide?view=sql-server-ver17
- Paul Randal (SQLskills) — The SQL Server Transaction Log, Part 3: The Circular Nature of the Log — Разбор кольцевой природы журнала и статусов VLF: в журнале всегда должен оставаться хотя бы один активный VLF — тот, в который ведётся запись. https://www.sqlskills.com/blogs/paul/the-sql-server-transaction-log-part-3-the-circular-nature-of-the-log/