
Запрос на реплике отменён за четыре секунды, хотя в конфиге 30s: как на самом деле работает max_standby_streaming_delay
Эта статья для тех, кто вынес отчёты на физическую реплику PostgreSQL и теперь ловит «canceling statement due to conflict with recovery» на ровном месте. Разберу, почему тридцать секунд из конфига почти никогда не достаются вашему запросу целиком, какие конфликты бывают и как их различить по одной строке в логе, что я включаю первым делом и чем за это платит основная база. С разбором реального стенда, цифрами до и после и командами, которые можно выполнить прямо сейчас.
Тридцать секунд отсчитываются не от старта вашего запроса
Классическая картина. Реплика поднята под отчётность, аналитик запускает выгрузку, через несколько секунд получает в лицо:
ERROR:  canceling statement due to conflict with recovery
DETAIL:  User query might have needed to see row versions that must be removed.
Администратор лезет в postgresql.conf, видит там max_standby_streaming_delay = 30s, смотрит на секундомер — запрос жил четыре секунды — и делает единственный логичный вывод: параметр не работает. Параметр работает. Он просто измеряет совсем не тот интервал, который вы себе представили.
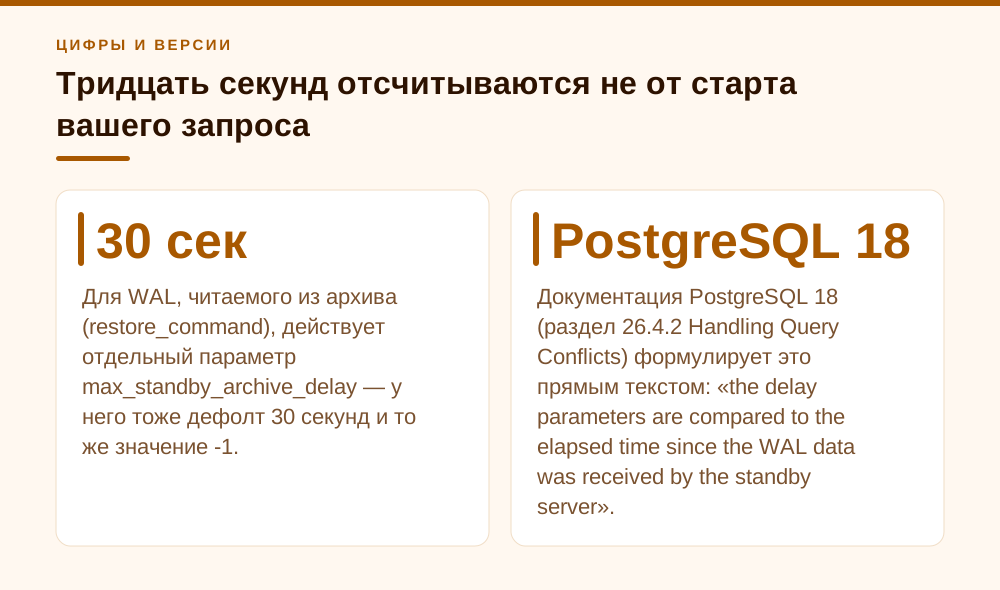
Документация PostgreSQL 18 (раздел 26.4.2 Handling Query Conflicts) формулирует это прямым текстом: «the delay parameters are compared to the elapsed time since the WAL data was received by the standby server». Ключевые слова — elapsed time и since the WAL data was received. Секундомер запускается в момент, когда порция WAL приехала на standby по стримингу, а не в момент, когда startup-процесс упёрся в ваш SELECT. Пока эта запись WAL стояла в очереди на применение, пока реплика догоняла отставание, пока разбирались с предыдущим конфликтом — время уже шло. К вашему запросу оно приходит частично израсходованным.
Второй множитель — бюджет общий, а не персональный. Мануал добавляет, что отпущенное запросу время «is never more than the delay parameter, and could be considerably less if the standby has already fallen behind as a result of waiting for previous queries to complete». Перевожу на язык практики: если десять минут назад чужой отчёт продержал применение WAL двадцать восемь секунд, следующему конфликтующему запросу останется две. И это не деградация и не баг — это ровно то поведение, которое заложено. Реплика не может позволить себе отставать вечно, поэтому расплачивается за задержку теми запросами, которые подвернулись.
Отсюда третий вывод, который экономит часы бессмысленной отладки: сравнивать «время жизни запроса» с «значением параметра» бессмысленно в принципе. Эти два числа не связаны напрямую никогда. Запрос может прожить час и не быть отменённым, если конфликтующих WAL-записей не приезжало. И может умереть на первой секунде, если бюджет уже выбран. Если вы хотите ограничить именно длительность запроса — для этого есть statement_timeout, и это другой инструмент с другой задачей.
- Отсчёт идёт от момента получения WAL репликой, а не от начала запроса.
- Бюджет расходуется всеми конфликтами подряд, а не выделяется каждому запросу заново.
- Значение -1 разрешает ждать конфликтующие запросы бесконечно, и тогда отставание применения WAL этим параметром не ограничено вообще.
- Для WAL, читаемого из архива (restore_command), действует отдельный параметр max_standby_archive_delay — у него тоже дефолт 30 секунд и то же значение -1.
- Оба параметра задаются только в postgresql.conf или в командной строке сервера: через SET в сеансе их не поменять, но перезапуск не нужен — хватает pg_reload_conf().
Пять видов конфликта, и различить их можно по строке DETAIL
Прежде чем что-то крутить, надо понять, из-за чего именно вас отменяют. PostgreSQL честно пишет причину в DETAIL, и по ней сразу видно, куда копать. Конфликтов, которые приводят к принудительной отмене, по сути пять: снятие Access Exclusive Lock на primary (явный LOCK или любой DDL), удаление табличного пространства, которое standby использует под временные файлы, удаление базы, к которой на реплике есть подключения, и две разновидности конфликта с записями очистки от VACUUM — когда снапшот запроса ещё видит строки, которые вычищаются, и когда запрос просто держит буфер той страницы, которую переписывают.
На практике в девяноста с лишним процентах случаев вы увидите строку про row versions that must be removed. Это конфликт снапшота, и он же — самый частый. Мануал прямо называет его «early cleanup»: на primary VACUUM имеет полное право снести мёртвые версии строк, потому что там их уже никто не видит. О том, что на реплике в этот момент крутится отчёт с получасовым снапшотом, primary по умолчанию не знает ничего. Сюда же попадает неочевидная вещь: index-only scan требует, чтобы карта видимости согласовывалась со снапшотом, поэтому конфликт возникает и тогда, когда VACUUM просто помечает страницу как all-visible.
Отдельно стоит конфликт буферного пина — «User was holding shared buffer pin for too long». Он ловится реже, но выглядит особенно обидно: запрос не видит удаляемых данных, он просто держал открытый курсор на странице. И совсем отдельно — DROP DATABASE: в этом случае никакая отмена запроса не поможет, standby рвёт всю сессию целиком. Так же рвётся сессия, если конфликтующая блокировка удерживается транзакцией, которая ничего не делает и сидит в idle in transaction.
Считать конфликты руками не нужно, для этого есть представление pg_stat_database_conflicts — по строке на базу. Смотреть его надо на самой реплике: по документации оно содержит данные только на standby, потому что на primary конфликтов восстановления не бывает, и там все счётчики нулевые.
- confl_snapshot — отменены из-за устаревшего снапшота (тот самый early cleanup, обычно основная масса).
- confl_bufferpin — отменены из-за удерживаемого пина буфера.
- confl_lock — отменены по конфликту блокировок.
- confl_tablespace — отменены из-за удаления табличного пространства.
- confl_deadlock — отменены из-за взаимоблокировки.
- confl_active_logicalslot — отменённые использования логических слотов (старый снапшот или слишком низкий wal_level на primary).
Разбор со стенда: медицинский центр «Эскулап на Соколе», МИС на 210 ГБ и отчёты, которые падали через раз
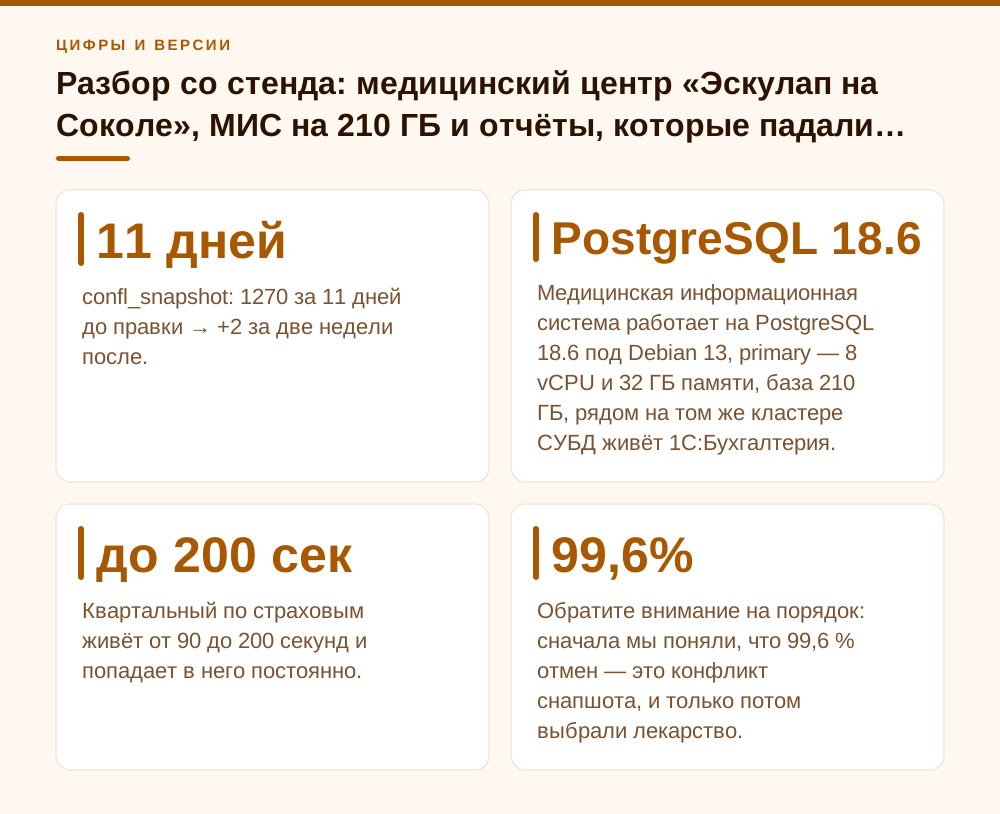
Медицинский центр «Эскулап на Соколе», 41 рабочее место: регистратура, врачебные кабинеты, лаборатория, бухгалтерия. Медицинская информационная система работает на PostgreSQL 18.6 под Debian 13, primary — 8 vCPU и 32 ГБ памяти, база 210 ГБ, рядом на том же кластере СУБД живёт 1С:Бухгалтерия. Год назад вынесли аналитику на отдельную машину: физическая реплика через streaming replication, туда ходит BI-панель главного врача, выгрузки реестров для страховых компаний и ежемесячная сверка оказанных услуг с бухгалтерией. Схема правильная, primary разгрузился, регистратура перестала жаловаться на подтормаживания в часы пик. Жалоба пришла через месяц и звучала фирменно: «квартальный отчёт по страховым падает через раз, а дневной работает всегда».
Сняли статистику. За одиннадцать дней аптайма реплики картина была такая:
SELECT datname, confl_snapshot, confl_bufferpin, confl_lock, confl_deadlock
  FROM pg_stat_database_conflicts
 WHERE datname NOT LIKE 'template%';
confl_snapshot — 1270, confl_bufferpin — 4, confl_lock — 1, остальное нули. Диагноз читается сразу: никакой экзотики, чистый early cleanup — так этот случай называет сама документация. Дальше стало понятно и почему «через раз». На primary каждую ночь идёт закрытие дня: пересчёт статусов оплат и загрузка результатов из лабораторной системы, UPDATE трогает от полутора до двух миллионов строк в таблице оказанных услуг на 40 миллионов записей, следом просыпается autovacuum и начинает выносить мёртвые версии. Дневной отчёт живёт шесть-восемь секунд и в это окно почти никогда не попадает. Квартальный по страховым живёт от 90 до 200 секунд и попадает в него постоянно.
Отдельно проверил гипотезу «просто поднимем задержку». Включил на реплике логирование ожиданий и посмотрел, сколько startup-процесс реально стоит:
# postgresql.conf на реплике, применяется через pg_reload_conf(), перезапуск не нужен
log_recovery_conflict_waits = on
deadlock_timeout = 1s
Этот параметр пишет в лог сообщение, когда startup-процесс ждёт разрешения конфликта дольше, чем deadlock_timeout. По умолчанию он выключен, и зря — без него вы не видите, кто именно тормозит накат WAL. Логи показали, что в ночное окно реплика уже упиралась в потолок: тридцать секунд бюджета выбирались подчистую, лаг применения доходил до сорока секунд, и следующим по очереди запросам не доставалось ничего. Поднимать max_standby_streaming_delay до трёх минут в такой ситуации означало бы получить реплику, отстающую на три минуты в самый нужный момент — то есть сломать её второе назначение, быть кандидатом на переключение, если primary с МИС ляжет посреди приёма.
Сделали иначе. Включили обратную связь от реплики и закрепили её физическим слотом, чтобы xmin реплики честно доезжал до primary и не сбрасывался при переподключениях. Задержку не трогали вообще — оставили дефолтные 30 секунд. Результат за две недели наблюдения: confl_snapshot вырос за это время всего на 2 — оба случая пришлись на окно планового перезапуска реплики при обновлении минорной версии, пока обратная связь ещё не восстановилась. Отчёты перестали падать, лаг применения на ночном окне снизился до 3-5 секунд, потому что startup-процессу больше не надо было никого ждать.
Отдельный вопрос, который задала бухгалтерия: а нельзя ли и отчёты 1С гонять на этой же реплике? Просто перенаправить информационную базу 1С на read-only standby как на обычную базу не получится — платформе при работе нужна запись в служебные таблицы. У 1С есть собственный механизм «копии баз данных», который, по описанию на v8.1c.ru, может выносить данные для аналитических отчётов на внешний сервер СУБД. Условия его применения (версия и редакция платформы, поддержка конкретной конфигурацией) я каждый раз сверяю по актуальной документации 1С, прежде чем обещать это клиенту; в «Эскулапе» бухгалтерия осталась на primary, её отчёты лёгкие и конфликтов не создают.
- confl_snapshot: 1270 за 11 дней до правки → +2 за две недели после.
- Пиковый лаг применения WAL в ночном окне: ~40 с → 3-5 с.
- max_standby_streaming_delay не менялся: как было 30s, так и осталось.
- Плата: таблица оказанных услуг на primary прибавила 1,3 ГБ за первый месяц, пока не закрыли долгие сессии тайм-аутами.
Что я включаю первым делом и в каком порядке
Мой порядок действий на отчётной реплике простой и почти всегда одинаковый. Первым идёт hot_standby_feedback = on. Это параметр самой реплики, он заставляет её сообщать primary о том, какие снапшоты сейчас активны, и primary перестаёт вычищать нужные версии строк. Мануал описывает его роль ровно так: «can be used to eliminate query cancels caused by cleanup records, but can cause database bloat on the primary for some workloads». По умолчанию он выключен. Сообщения уходят не чаще, чем раз в wal_receiver_status_interval, у которого дефолт 10 секунд — этого достаточно, крутить его почти никогда не нужно.
Вторым идёт физический слот репликации. Без слота обратная связь живёт ровно до разрыва соединения: реплика отвалилась на минуту, primary забыл её xmin, autovacuum отработал и вычистил всё, что мог. Со слотом информация сохраняется на стороне primary. Конфигурация минимальная:
# на primary
max_slot_wal_keep_size = 64GB

# на реплике
primary_slot_name = 'standby_bi'
hot_standby_feedback = on
wal_receiver_status_interval = 10s
Слот создаётся на primary одной командой SELECT pg_create_physical_replication_slot('standby_bi', true);. Ограничение max_slot_wal_keep_size ставить обязательно — иначе забытый или отвалившийся слот однажды забьёт pg_wal на primary целиком, и это гораздо более неприятная авария, чем отменённый отчёт.
Третьим — тайм-ауты на отчётной роли. Именно на роли, а не глобально, чтобы не задеть репликацию и служебные процессы:
ALTER ROLE bi_reader SET statement_timeout = '15min';
ALTER ROLE bi_reader SET idle_in_transaction_session_timeout = '5min';
Это страховка от того, чтобы одна забытая транзакция в открытом psql не держала xmin реплики сутками. С включённым hot_standby_feedback такая транзакция превращается в тормоз для очистки на primary, и последствия вы увидите не сразу, а через неделю по размеру таблиц.
max_standby_streaming_delay я трогаю последним и редко. Осмысленных сценария всего два. Если реплика — исключительно источник отчётов и никогда не будет промоутиться, можно поставить -1 и разрешить ждать бесконечно; отставание тогда ограничится только вашим терпением и местом под WAL. Если реплика — прежде всего HA-кандидат, значение наоборот стоит опустить до нескольких секунд или до нуля, приняв, что тяжёлые запросы там будут отменяться. Промежуточные значения вроде «поставим 5 минут» обычно означают, что решение не принято: и отставание выросло, и отмены остались.
- hot_standby_feedback = on — снимает подавляющее большинство отмен, если у вас confl_snapshot.
- primary_slot_name + max_slot_wal_keep_size — чтобы обратная связь пережила разрыв связи, а слот не убил primary.
- statement_timeout и idle_in_transaction_session_timeout на роли отчётов — страховка от забытых транзакций.
- max_standby_streaming_delay — только осознанно: -1 для чисто аналитической реплики, единицы секунд для HA-кандидата.
- recovery_min_apply_delay — отдельная история, для машины времени, а не для борьбы с отменами.
Чем платит primary: раздувание и как его удержать в рамках
Честно про обратную сторону. hot_standby_feedback не бесплатный: запрещая вычищать нужные реплике версии строк, вы откладываете работу VACUUM на primary. Мануал успокаивает разумной формулировкой — ситуация с очисткой не хуже той, что была бы, если бы эти же запросы выполнялись прямо на primary. Это правда, и это важный аргумент против паники. Но в реальности запросы на аналитической реплике живут дольше, чем кто-либо позволил бы им жить на боевой базе, и вот тут раздувание становится заметным.
На стенде «Эскулапа» это выглядело так: за первый месяц после включения обратной связи таблица оказанных услуг прибавила 1,3 ГБ при том, что объём полезных данных почти не изменился. Копали недолго — нашли экономиста, который держал открытый сеанс в DBeaver с незакрытой транзакцией по два-три дня. После ALTER ROLE с idle_in_transaction_session_timeout проблема исчезла, а сам объём вернулся в норму после планового VACUUM FULL в ночное окно, когда центр закрыт.
Мерить раздувание надо не по ощущениям, а по числам. Смотрю три вещи: горизонт очистки на primary, число мёртвых кортежей в горячих таблицах и время последнего автовакуума.
-- на primary: чей xmin держит горизонт
SELECT slot_name, active, xmin, catalog_xmin,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS wal_held
  FROM pg_replication_slots;

SELECT application_name, state, backend_xmin, write_lag, flush_lag, replay_lag
  FROM pg_stat_replication;

SELECT relname, n_live_tup, n_dead_tup, last_autovacuum
  FROM pg_stat_user_tables
 ORDER BY n_dead_tup DESC LIMIT 10;
Если backend_xmin реплики застыл и не двигается часами — у вас не «раздувание из-за hot_standby_feedback», у вас конкретная зависшая транзакция, и лечится она адресно.
Про recovery_min_apply_delay скажу отдельно, потому что его периодически предлагают как средство от отмен. Это не средство от отмен. Он задерживает применение коммитов на заданное время и нужен для другого — чтобы иметь копию данных «пять минут назад» и успеть спасти базу после случайного DELETE. Причём документация прямо предупреждает: hot_standby_feedback будет задержан использованием этой возможности, что может привести к раздуванию на primary, и совмещать их следует осторожно. Плюс отложенный WAL надо где-то хранить, и pg_wal на реплике вырастет пропорционально задержке.
- Раздувание почти всегда упирается не в саму обратную связь, а в конкретную долгоживущую или зависшую транзакцию.
- Первым делом ищите idle in transaction на реплике — по pg_stat_activity, а не по догадкам.
- max_slot_wal_keep_size обязателен: иначе неактивный слот со временем забьёт pg_wal на primary.
- Совмещать recovery_min_apply_delay и hot_standby_feedback можно, но осознанно и с запасом по месту.
Мониторинг: перестать гадать за один вечер
Проблема отмен на реплике тем и неприятна, что жалоба приходит от пользователя, а следов почти нет: запрос упал, приложение показало «ошибка соединения», в логе одна строка. Поэтому перед любыми правками я ставлю наблюдение — это полчаса работы, зато дальше разговор идёт про цифры, а не про ощущения.
Минимальный набор такой. На реплике включаем log_recovery_conflict_waits = on и deadlock_timeout в 1 секунду, чтобы видеть, когда накат WAL реально стоит и кого он ждёт. Туда же — логирование самих отмен, они и так пишутся как ERROR, но полезно иметь их отдельно с текстом запроса:
log_recovery_conflict_waits = on
log_min_error_statement = error   # это и есть дефолт, фиксирую явно
log_line_prefix = '%m [%p] %q%u@%d/%a '
В Zabbix или что у вас стоит выносим три метрики: дельту по столбцам pg_stat_database_conflicts, лаг применения через pg_last_xact_replay_timestamp() и возраст горизонта на primary.
Хороший практический приём — считать не абсолютные значения confl_*, а прирост за интервал. Абсолютные бесполезны: они накапливаются с последнего сброса статистики, и большое число там может означать один плохой день полгода назад. Прирост же сразу показывает, отработала правка или нет, и попадает ли всплеск отмен в окно ночного пересчёта.
psql -Atc "SELECT sum(confl_snapshot+confl_bufferpin+confl_lock+confl_deadlock) FROM pg_stat_database_conflicts"Эту строчку можно повесить на чтение раз в минуту и рисовать по ней производную.
И ещё одно, что часто выпадает из виду: посмотрите, как ведёт себя приложение. Отмена по конфликту с восстановлением — это штатная, ожидаемая и в общем-то восстановимая ошибка, код SQLSTATE 40001 (serialization_failure). Исключение — конфликт с DROP DATABASE: там сессия завершается целиком с кодом 57P04, и повторять запрос уже некуда. Нормально написанный отчётный слой должен уметь её распознать и повторить запрос, а не выкидывать пользователю красное окно. Если у вас BI-инструмент этого не умеет — иногда дешевле обернуть тяжёлые выгрузки в скрипт с одним ретраем, чем неделю тюнить репликацию.
- log_recovery_conflict_waits = on на реплике — видно, что тормозит накат WAL (по умолчанию выключен).
- Прирост confl_* за интервал, а не накопленные значения.
- pg_last_xact_replay_timestamp() на реплике — реальный лаг применения в секундах.
- backend_xmin в pg_stat_replication и xmin в pg_replication_slots на primary — здоровье горизонта очистки.
- Ретрай на SQLSTATE 40001 в отчётном слое приложения.
Чего я не делаю и где мнения расходятся
Не ставлю -1 по умолчанию. Соблазн понятный: одна строчка, и отмены исчезли. Но -1 означает, что реплика будет ждать конфликтующие запросы неограниченно долго, и отставание применения WAL этим параметром больше не ограничено вообще. На чисто аналитической машине, куда никто никогда не переключится, это допустимое решение — я так делаю, но осознанно и с мониторингом лага. На реплике, которая числится резервом, -1 — это отложенная авария: в день переключения выяснится, что догонять надо сорок минут.
Не путаю max_standby_streaming_delay с max_standby_archive_delay и не правлю их «за компанию». Первый работает по WAL, приехавшему через стриминг, второй — по WAL, вычитанному из архива через restore_command. Второй важен ровно в двух случаях: при первоначальном восстановлении реплики и когда она долго была отключена и догоняет по архиву. В штатном режиме на стриминговой реплике он не срабатывает никогда, и его правка ничего не изменит.
Где действительно нет единого мнения — это в вопросе, включать ли hot_standby_feedback на нагруженных OLTP-системах с очень горячими таблицами. Есть лагерь, который считает, что аналитику вообще нельзя пускать в тот же контур, и вместо обратной связи предлагает логическую репликацию в отдельное хранилище. Аргумент сильный: там горизонт очистки primary вообще не зависит от того, сколько живут отчёты. Мой контраргумент прагматичный — логическая репликация это ещё одна система, которую надо строить, чинить и обслуживать, а для медцентра на 41 рабочее место физическая реплика с обратной связью и парой тайм-аутов закрывает вопрос за один вечер. Если у вас база на терабайты и десятки тысяч транзакций в секунду — да, разговор другой.
И последнее, про приоритеты. Если сейчас у вас падают отчёты и нет времени разбираться глубоко: снимите pg_stat_database_conflicts, и если там преобладает confl_snapshot — включайте hot_standby_feedback со слотом и тайм-аутами на отчётной роли. Это закроет проблему в подавляющем большинстве случаев. На тонкую настройку задержек, разбор буферных пинов и логическую репликацию можно спокойно забить до тех пор, пока цифры не покажут, что они вам действительно нужны.
- -1 — только для реплики, которая никогда не станет primary, и только с мониторингом лага.
- max_standby_archive_delay правят при восстановлении и долгом отставании, а не в штатном режиме.
- hot_standby_feedback на очень горячих OLTP-таблицах — спорно; альтернатива логической репликации сложнее в эксплуатации.
- Сначала диагноз по confl_*, потом лечение. Обратный порядок стабильно приводит к выросшему лагу и тем же самым отменам.
Частые вопросы
Почему запрос отменяется за 3 секунды, если max_standby_streaming_delay = 30s?
Потому что эти 30 секунд — не тайм-аут запроса, а общий бюджет задержки применения WAL, который отсчитывается с момента получения WAL репликой. Если предыдущие конфликты уже съели часть бюджета или порция WAL полежала в очереди, вашему запросу достанется остаток. Мануал прямо пишет, что параметры задержки сравниваются с временем, прошедшим с получения WAL репликой (elapsed time since the WAL data was received), а не с длительностью запроса.
Можно ли просто поставить max_standby_streaming_delay = -1 и забыть?
Можно, если реплика используется исключительно под отчётность и никогда не будет промоутиться в primary. Значение -1 разрешает ждать конфликтующие запросы бесконечно, и отставание применения WAL этим параметром больше не ограничивается — реплика может уйти в отставание на десятки минут. Для машины, которая числится горячим резервом, это неприемлемо: в момент переключения придётся ждать, пока она догонит.
hot_standby_feedback точно раздует базу на primary?
Он откладывает очистку мёртвых версий строк ровно на время жизни запросов на реплике. Документация справедливо замечает, что ситуация не хуже той, что была бы, если бы эти запросы выполнялись прямо на primary. Проблемы начинаются не от самой обратной связи, а от долгоживущих и зависших транзакций: поставьте statement_timeout и idle_in_transaction_session_timeout на отчётную роль, и раздувание останется в разумных пределах.
Чем отличается max_standby_archive_delay от max_standby_streaming_delay?
Первый применяется к WAL, который реплика читает из архива — при первоначальном восстановлении или когда догоняет после долгого простоя. Второй применяется к WAL, полученному через streaming replication. У обоих дефолт 30 секунд и у обоих -1 означает бесконечное ожидание. В штатно работающей стриминговой реплике срабатывает только второй.
Как понять, из-за чего именно отменяются запросы?
Посмотреть pg_stat_database_conflicts на самой реплике — заполнено оно только на standby, на primary счётчики нулевые. Преобладает confl_snapshot — это конфликт с очисткой строк, лечится hot_standby_feedback. Преобладает confl_lock — ищите DDL и явные LOCK на primary. confl_bufferpin — долгие открытые курсоры. Дополнительно включите log_recovery_conflict_waits, чтобы видеть, когда накат WAL реально стоит.
Помогает ли recovery_min_apply_delay избавиться от отмен?
Нет, это инструмент для другой задачи — иметь копию данных с задержкой во времени и успеть отреагировать на ошибочное удаление. От конфликтов он не спасает, зато требует места под накопленный WAL на реплике, а документация предупреждает, что он задерживает hot_standby_feedback и совмещать их надо с осторожностью.
Источники
- PostgreSQL 18 Documentation — 20.6. Replication — Описание параметров max_standby_archive_delay, max_standby_streaming_delay (default 30s, -1 = ждать бесконечно), hot_standby_feedback (default off), wal_receiver_status_interval (default 10s), recovery_min_apply_delay. https://www.postgresql.org/docs/18/runtime-config-replication.html
- PostgreSQL 18 Documentation — 26.4.2. Handling Query Conflicts — Перечень видов конфликтов восстановления, поведение при DROP DATABASE и блокировке idle-транзакции, early cleanup, index-only scan и карта видимости, сравнение параметров задержки со временем с момента получения WAL, рекомендации по значениям для HA и аналитики (вплоть до -1). https://www.postgresql.org/docs/18/hot-standby.html
- PostgreSQL 18 Documentation — 27.2. The Cumulative Statistics System — Определение представления pg_stat_database_conflicts и столбцов confl_tablespace, confl_lock, confl_snapshot, confl_bufferpin, confl_deadlock, confl_active_logicalslot; оговорка, что представление содержит данные только на standby. https://www.postgresql.org/docs/18/monitoring-stats.html
- PostgreSQL 16 Release Notes — E.16.2. Migration to Version 16 — Запись об удалении серверной переменной vacuum_defer_cleanup_age как ненужной после появления hot_standby_feedback и слотов репликации. https://www.postgresql.org/docs/release/16.0/
- PostgreSQL 18 Documentation — 20.8. Error Reporting and Logging — Параметр log_recovery_conflict_waits (по умолчанию off): сообщение в лог, когда startup-процесс ждёт разрешения конфликта дольше deadlock_timeout. https://www.postgresql.org/docs/18/runtime-config-logging.html
- PostgreSQL Versioning Policy — Актуальные поддерживаемые ветки на сентябрь 2026: 18.6, 17.11, 16.15, 15.19, 14.24; ветка 18 поддерживается до ноября 2030. https://www.postgresql.org/support/versioning/
- 1С:Предприятие 8 — Копии баз данных — Описание механизма копий баз данных: вынос данных для аналитических отчётов на внешний сервер СУБД для снижения нагрузки на основную базу. https://v8.1c.ru/platforma/kopii-baz-dannykh/