
Удалил бэкапы в Proxmox Backup Server, запустил Garbage Collection, а место не вернулось
Место в Proxmox Backup Server освобождает только Garbage Collection, и удаляет она лишь chunks, к которым не обращались больше 24 часов 5 минут. Всё свежее уходит в Pending removals и ждёт следующего прогона. Ниже разбираю механику, случай со сторонним rsync, тюнинг gc-atime-cutoff и порядок действий при заполненном датасторе.
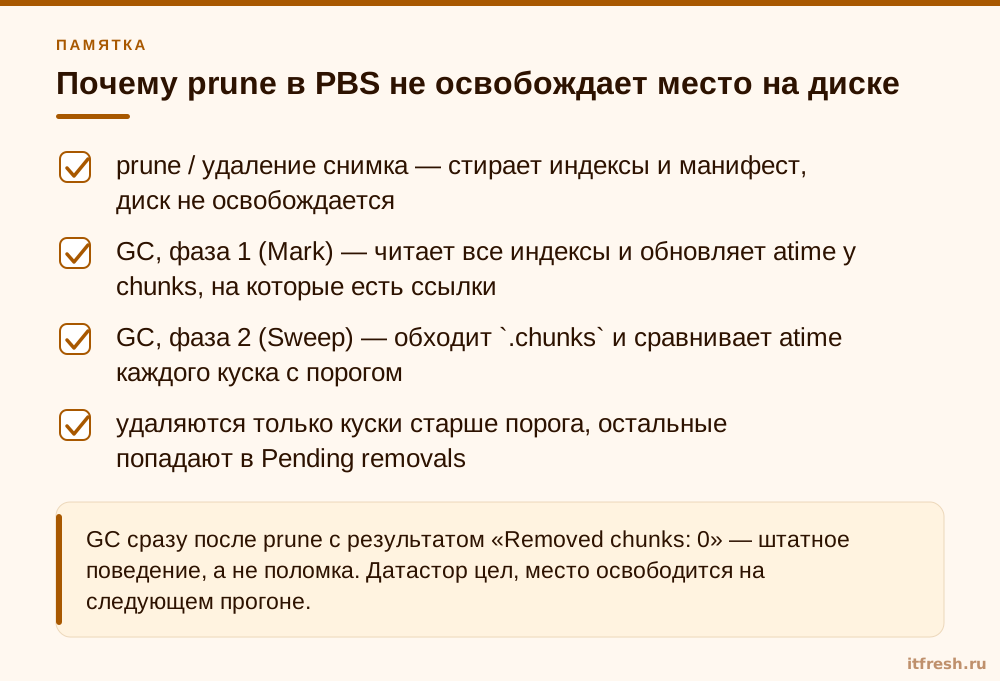
Почему prune в PBS не освобождает место на диске
Первое, что надо принять: в Proxmox Backup Server снимок — это не файл с данными. Это каталог с манифестом и индексными файлами (.fidx для образов дисков, .didx для файловых архивов), внутри которых лежат ссылки на куски данных — chunks. Сами куски живут отдельно, в каталоге .chunks датастора, разложенные по 65 536 подкаталогам от 0000 до ffff. Один и тот же кусок могут одновременно упоминать десятки снимков разных виртуальных машин — это и есть дедупликация, ради которой PBS берут в резервное копирование и защиту данных.
Отсюда прямое следствие. Когда вы делаете prune (в веб-интерфейсе — кнопка Prune у группы, из CLI — proxmox-backup-client prune с --keep-last, --keep-daily, --keep-weekly, --keep-monthly, --keep-yearly) или удаляете снимок руками, сервер стирает только метаданные: индексы и манифест. Ни один chunk при этом не трогается, потому что в момент prune неизвестно, ссылается ли на кусок кто-то ещё. df -h после prune покажет ту же цифру, что и до него.
Фактически освобождает место отдельная задача — Garbage Collection. Она и только она удаляет chunks с диска. Поэтому связка всегда двухтактная: сначала prune, потом GC. И на втором такте начинается то, из-за чего мне звонят: GC завершилась с зелёной галочкой, а свободного места не прибавилось.
- prune / удаление снимка — стирает индексы и манифест, диск не освобождается
- GC, фаза 1 (Mark) — читает все индексы и обновляет atime у chunks, на которые есть ссылки
- GC, фаза 2 (Sweep) — обходит `.chunks` и сравнивает atime каждого куска с порогом
- удаляются только куски старше порога, остальные попадают в Pending removals
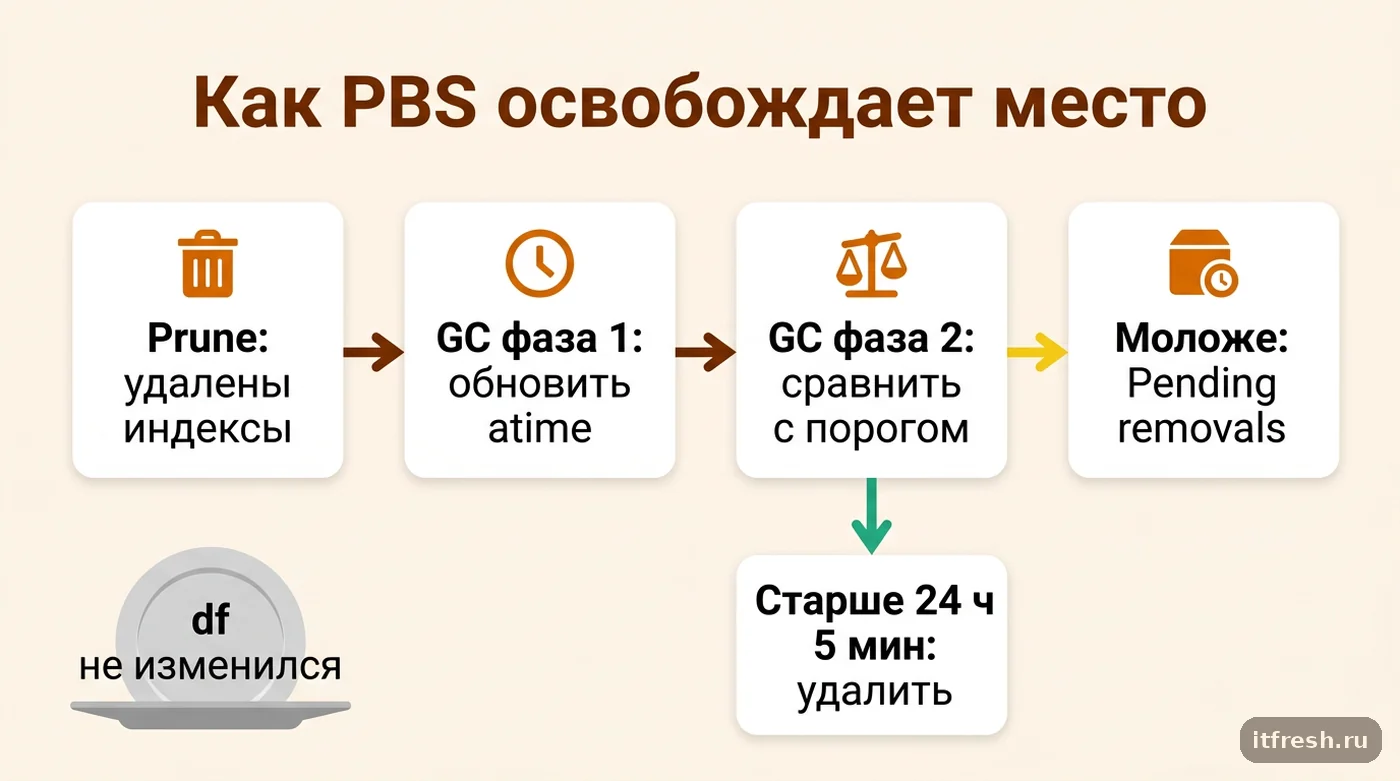
Что такое Pending removals и откуда 24 часа 5 минут
Порог во второй фазе, по документации PBS 4.2, — либо время старта самого старого активного backup writer, если в датастор прямо сейчас кто-то пишет, либо момент за 24 часа и 5 минут до начала GC. Всё, что новее этой отметки, GC не трогает и в конце задачи честно показывает как Pending removals с объёмом и числом кусков.
Обратите внимание на первую часть правила — про активного writer. Если во время GC идёт длинный бэкап, например ночная копия большого файлового сервера, которая тянется до утра, порог отодвигается к моменту её старта. Поэтому GC, запущенная поверх незавершённого бэкапа, освобождает меньше, чем вы ожидаете. Я ставлю GC в окно, где гарантированно нет ни backup, ни sync задач на этот датастор.
Почему сутки, а не час. Файловые системы Linux по умолчанию монтируются с relatime: atime обновляется, только если файл изменён после последнего доступа или если прошлый atime старше суток. Система не гарантирует, что у активно читаемого куска atime свежий, — только что он не старше суток. Пять минут сверху — запас на длительность первой фазы. PBS предпочитает подержать лишние гигабайты сутки, чем удалить кусок, на который кто-то ссылается. Между «подождать сутки» и «потерять точку восстановления» я тоже каждый раз выбираю первое.
Практический вывод один: prune и GC нужно разносить больше чем на сутки. Не «prune в 03:00, GC в 03:30» — так место не вернётся на этом прогоне. А «prune ежедневно ночью, GC раз в неделю». Запускать GC чаще не значит освобождать быстрее: каждый прогон заново трогает atime живых кусков, а освобождение определяется возрастом мусора, а не числом запусков.
# расписание и итог последнего прогона GC по всем датасторам
proxmox-backup-manager garbage-collection list

# статус конкретного датастора
proxmox-backup-manager garbage-collection status store1

# GC раз в неделю, воскресенье 05:30 (формат Calendar Events)
proxmox-backup-manager datastore update store1 --gc-schedule 'sun 05:30'

# запустить вручную
proxmox-backup-manager garbage-collection start store1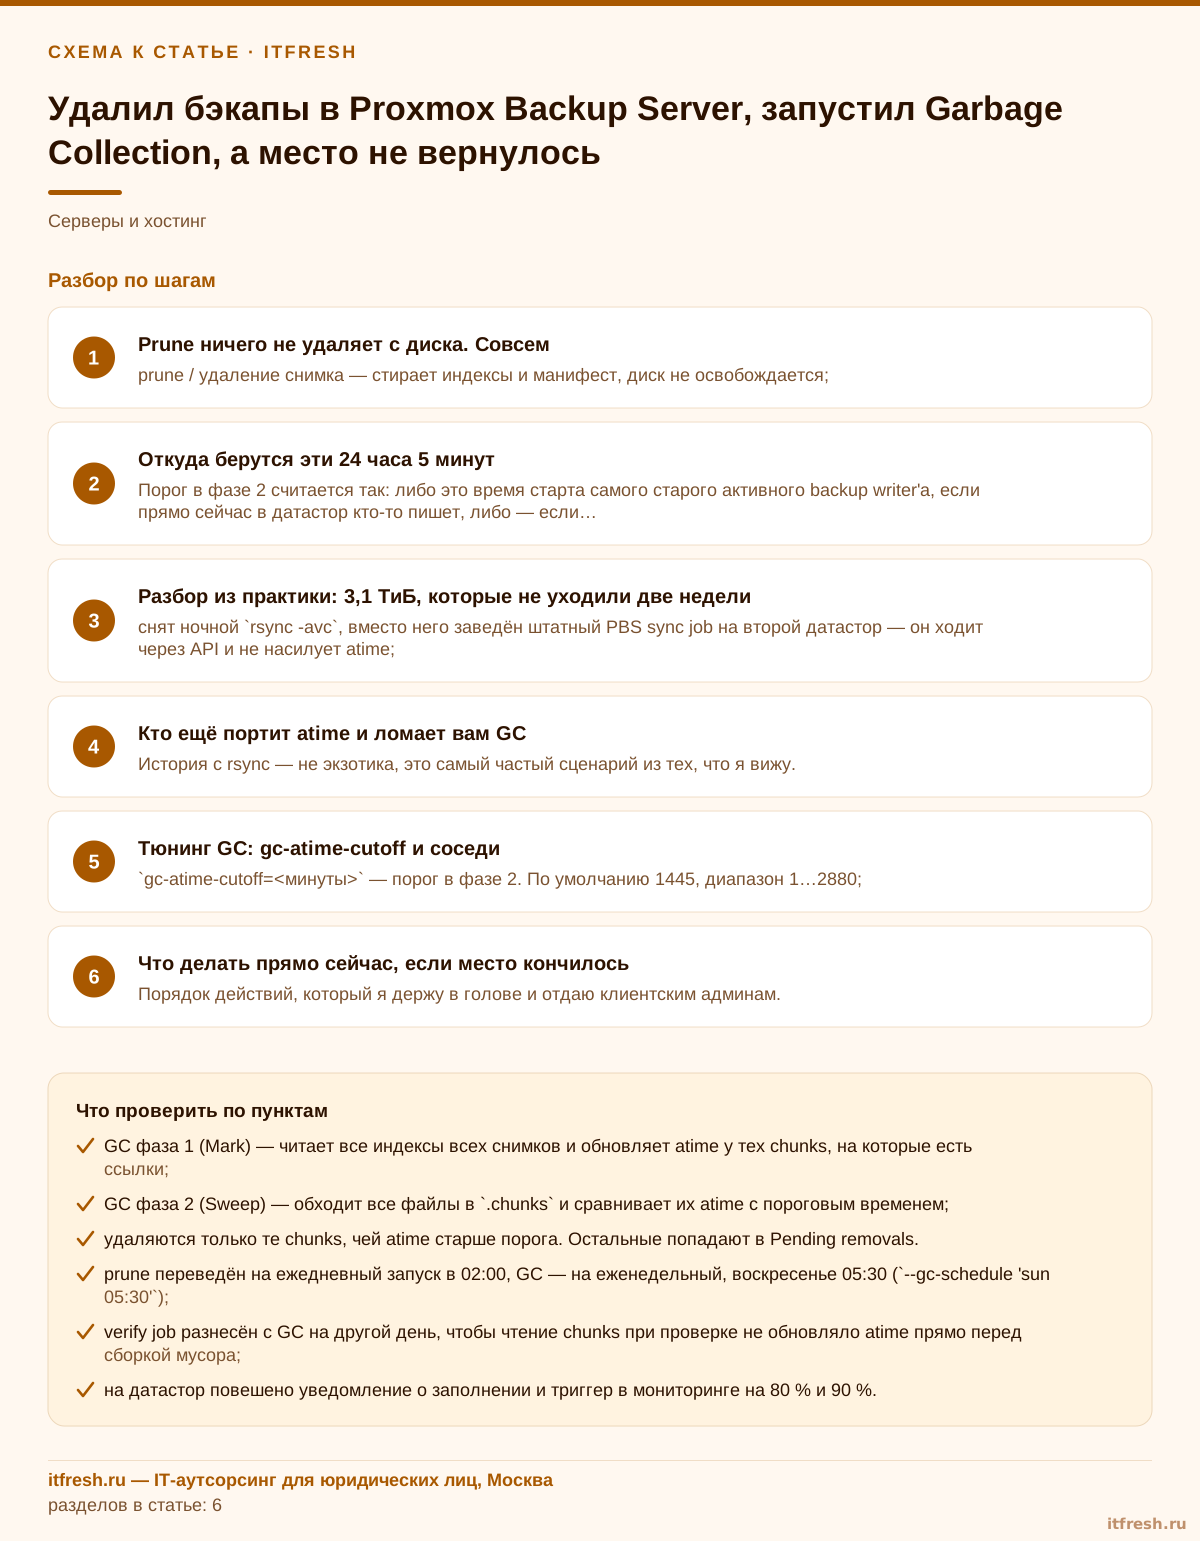
Разбор из практики: «Точный учёт», 1,2 ТиБ, которые не уходили неделю
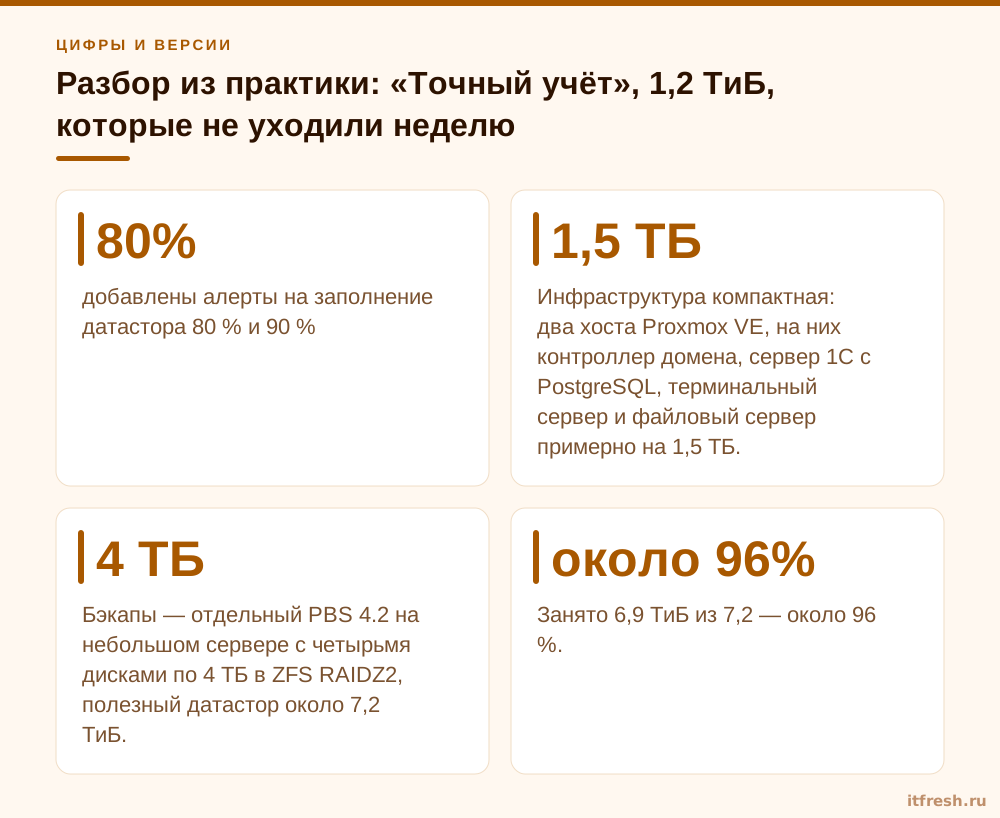
Бухгалтерская консультация «Точный учёт», 20 рабочих мест. Инфраструктура компактная: два хоста Proxmox VE, на них контроллер домена, сервер 1С с PostgreSQL, терминальный сервер и файловый сервер примерно на 1,5 ТБ. Бэкапы — отдельный PBS 4.2 на небольшом сервере с четырьмя дисками по 4 ТБ в ZFS RAIDZ2, полезный датастор около 7,2 ТиБ. Политика хранения: keep-daily 14, keep-weekly 8, keep-monthly 6 — для бухгалтерии глубина в полгода по базам 1С важна, клиенты регулярно просят поднять данные за прошлые периоды.
Приходит заявка: «место кончается, ночные бэкапы падают». Занято 6,9 ТиБ из 7,2 — около 96 %. Штатный админ к моменту моего подключения уже сделал самое вредное, что можно сделать: срезал политику до keep-daily 7 / keep-weekly 4 / keep-monthly 2, снёс 38 снимков, запустил GC, увидел, что место не вернулось, — и пошёл резать дальше. Хорошо, что успели остановить.
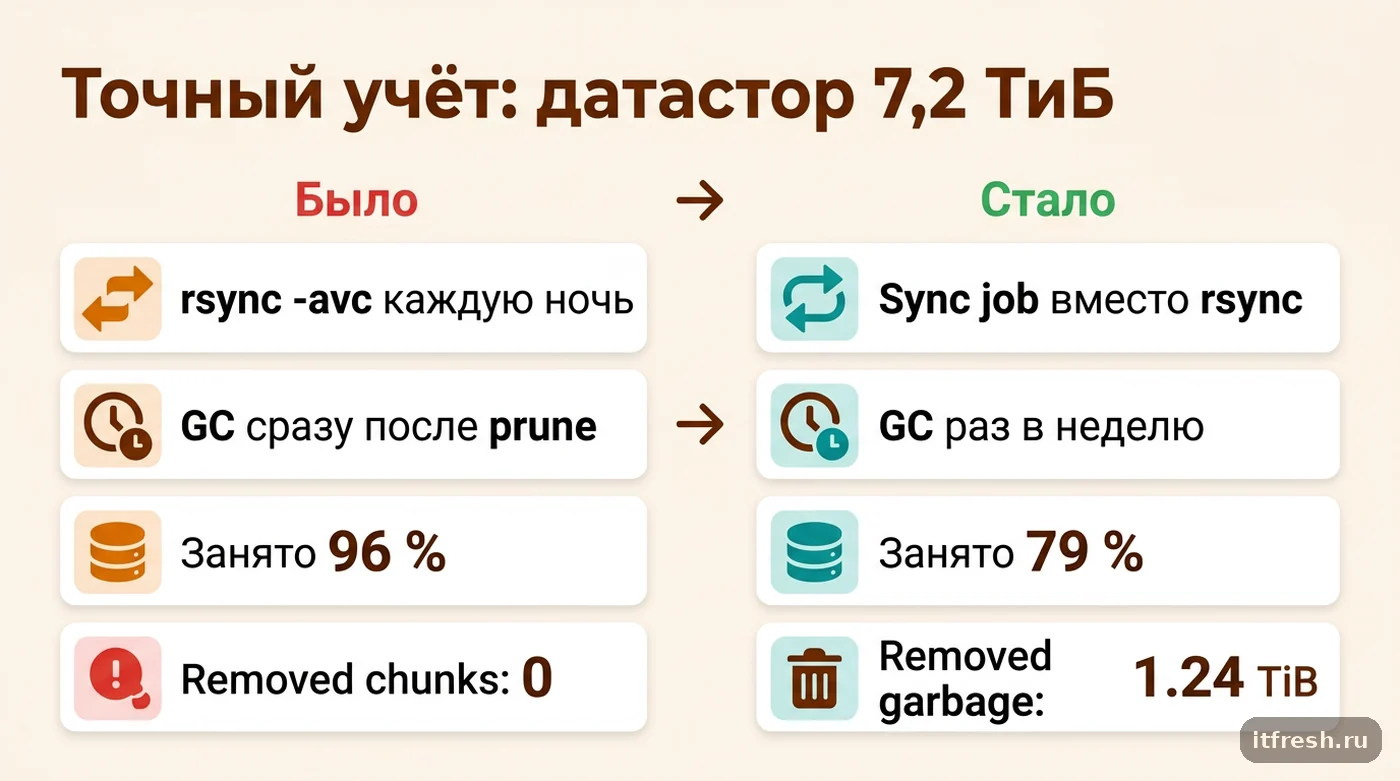
Смотрю лог GC: статус OK, в конце «Pending removals: 1.18 TiB», «Removed chunks: 0». Первая причина очевидна — GC стартовала через двадцать минут после prune. Но повторный прогон на следующие сутки дал тот же ноль. Проверяю самый старый atime в датасторе: find /mnt/datastore/store1/.chunks -type f -printf '%A@\n' | sort -n | head -1 — вчерашний. У всех кусков свежее время доступа. Виновник нашёлся в cron: ночной rsync -avc всего датастора на NAS, «вторая копия бэкапов». Ключ -c заставляет rsync считать контрольные суммы, то есть читать каждый файл целиком. Каждую ночь atime у всех chunks обновлялся, и они вечно оставались внутри защитного окна.
Что сделали: убрали rsync, вторую копию перевели на штатный sync job в датастор на NAS — про то, что синхронизация PBS — это зеркало, а не архив, и как не потерять историю на приёмнике, я писал отдельно. Prune оставили ежедневным в 02:00, GC — еженедельно в воскресенье 05:30, verify — в среду. Через двое суток GC выдала «Removed garbage: 1.24 TiB», занятость упала до 5,7 ТиБ, около 79 %. Итог честный, без хеппи-энда: место вернулось, а 38 удалённых в панике снимков — нет. Глубина по базам 1С на пару месяцев схлопнулась с полугода до двух месяцев и восстанавливалась естественным путём.
- снят ночной `rsync -avc`, вторая копия — штатный sync job
- prune — ежедневно 02:00, GC — еженедельно, воскресенье 05:30
- verify разнесён с GC на другой день
- добавлены алерты на заполнение датастора 80 % и 90 %
Кто ещё обновляет atime и ломает сборку мусора
История с rsync — не экзотика, это самый частый сценарий из тех, что я вижу. Датастор выглядит как обычный каталог с файлами, и рука сама тянется скопировать его привычным инструментом или прогнать по нему что-нибудь полезное. А любое сплошное чтение .chunks обнуляет смысл механизма atime.
Кого я проверяю первым, когда GC даёт ноль при ненулевых Pending removals: ночной rsync -c / --checksum; rclone с --checksum; резервное копирование самого датастора сторонним агентом; антивирус с полным сканированием тома; самописные скрипты инвентаризации, если они читают содержимое файлов. Отдельно — собственный verify job PBS, если он идёт впритык перед GC.
Про verify честно: официального заявления, что он гарантированно мешает ближайшей GC, я не встречал. Но проверка целостности читает chunks, а чтение при relatime обновляет atime у файлов, у которых он старше суток. Я просто развожу verify и GC по разным дням: это ничего не стоит и убирает один потенциальный источник проблем.
Если по cron и таймерам виновника не видно, я ставлю временное наблюдение за чтением каталога через auditd: auditctl -w /mnt/datastore/store1/.chunks -p r -k pbs-chunks-read, жду ночь и смотрю ausearch -k pbs-chunks-read -i | grep -E 'exe=|comm=' | sort | uniq -c. В выводе сразу видно, какой исполняемый файл читал куски, кроме самого proxmox-backup-proxy. Правило потом обязательно снимаю через auditctl -W с теми же параметрами: на датасторе с миллионом файлов журнал аудита растёт очень быстро.
Отдельная категория — «оптимизаторы», которые монтируют датастор с noatime или ставят на ZFS atime=off. Это прямая дорога к тому, что GC либо не удалит ничего, либо удалит нужное. От таких сюрпризов в PBS есть защита — проверка gc-atime-safety-check: при создании датастора и на каждой GC сервер убеждается, что обновление atime действительно доходит до файловой системы. Она включена по умолчанию, и выключать её я не советую никогда. Если место на диске ведёт себя странно и без PBS — например, удалённый файл продолжает занимать место, — это другая история: файл удалён, а место не вернулось из-за процесса, который держит его открытым.
Как ускорить Garbage Collection: gc-atime-cutoff и gc-cache-capacity
В актуальных версиях защитный интервал не зашит жёстко: его меняют на уровне датастора через --tuning. Параметр называется gc-atime-cutoff, задаётся в минутах, по умолчанию 1445 — те самые 24 часа 5 минут. В веб-интерфейсе он в свойствах датастора, на вкладке Options, в группе Tuning, с подсказкой «1445 (24 hours 5 minutes)» в пустом поле. Допустимый диапазон значений уточните через proxmox-backup-manager datastore update --help в своей версии.
Там же живут и соседние ручки. Задаются они одной строкой через запятую без пробелов. Важный момент: --tuning передаёт строку целиком, поэтому, если у вас уже заданы другие параметры, перечислите их вместе с новым, иначе они вернутся к умолчаниям.
# текущие настройки датастора
proxmox-backup-manager datastore show store1

# временно снизить защитный интервал до часа
proxmox-backup-manager datastore update store1 --tuning 'gc-atime-cutoff=60'

# вернуть умолчание и увеличить кэш первой фазы
proxmox-backup-manager datastore update store1 --tuning 'gc-atime-cutoff=1445,gc-cache-capacity=4194304'
Когда я реально снижаю cutoff. Только в аварийной ситуации, когда место нужно вернуть в течение часа, а не завтра. Порядок: останавливаю все backup и sync job на этот датастор, проверяю через proxmox-backup-manager task list, что активных задач нет, ставлю 60 минут, запускаю GC, возвращаю 1445. Именно возвращаю: пониженное значение как постоянная настройка лишает вас той страховки, ради которой механизм сделан. Ниже часа я не опускался ни разу.
gc-cache-capacity помогает не по месту, а по времени. Это размер LRU-кэша, в котором первая фаза запоминает уже обработанные chunks, чтобы не трогать atime одного куска много раз. По документации по умолчанию 1 048 576 слотов, максимум 8 388 608, ноль выключает кэш. На датасторах с сильной дедупликацией увеличение заметно сокращает первую фазу; платите за это оперативной памятью.
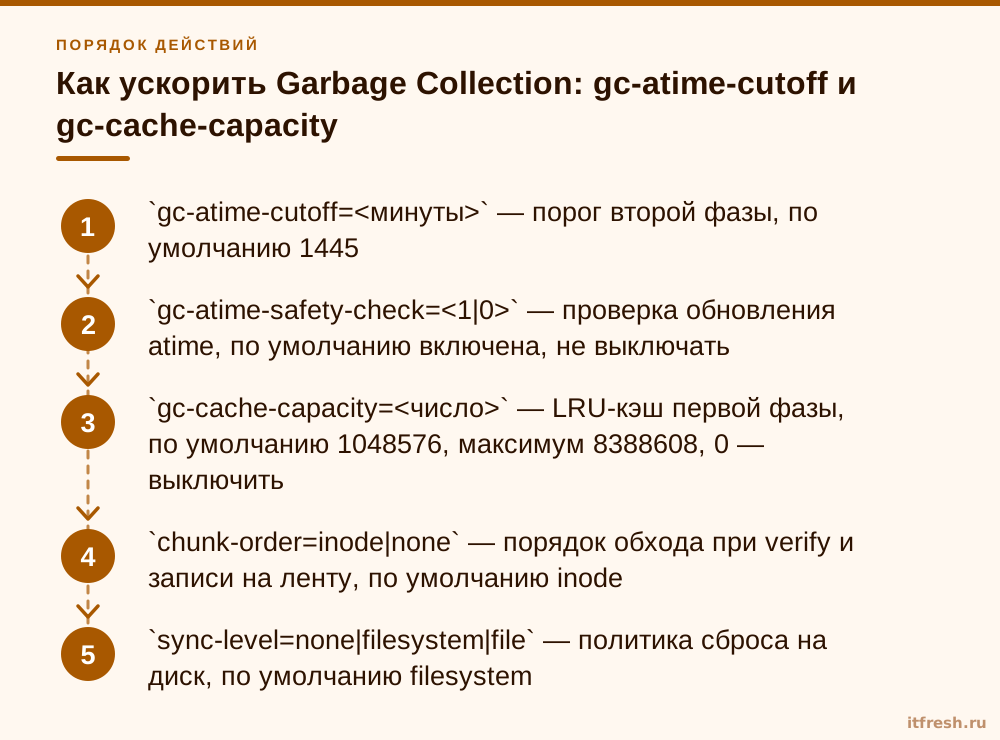
- `gc-atime-cutoff=<минуты>` — порог второй фазы, по умолчанию 1445
- `gc-atime-safety-check=<1|0>` — проверка обновления atime, по умолчанию включена, не выключать
- `gc-cache-capacity=<число>` — LRU-кэш первой фазы, по умолчанию 1048576, максимум 8388608, 0 — выключить
- `chunk-order=inode|none` — порядок обхода при verify и записи на ленту, по умолчанию inode
- `sync-level=none|filesystem|file` — политика сброса на диск, по умолчанию filesystem
Что делать, если место на датасторе PBS кончилось прямо сейчас
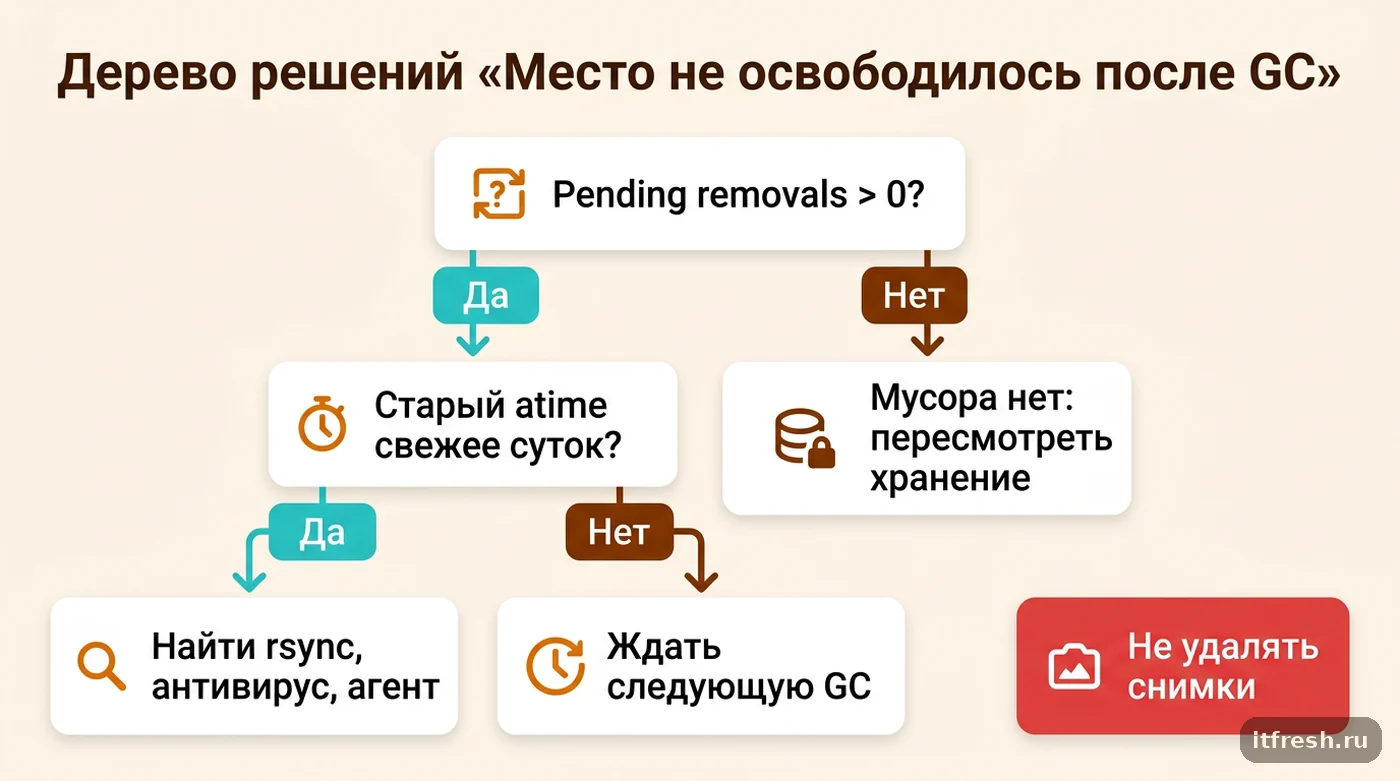
Порядок, который я отдаю клиентским админам, построен по принципу «сначала бесплатное и обратимое, потом дорогое и необратимое». Шаг ноль и самый важный — перестать удалять снимки. Каждый удалённый снимок — минус точка восстановления навсегда, а места он сегодня всё равно не даст. Читаем лог последней GC: если Pending removals ненулевые, место уже найдено, ждать нужно конкретно до истечения cutoff от последнего касания chunks.
Дальше — диагностика: действительно ли всё упирается в atime и кто его трогает.
# занятость датастора
proxmox-backup-manager datastore list
df -h /mnt/datastore/store1
zfs list -o name,used,avail,quota
zfs get atime,relatime <пул/датасет>

# самый старый atime: если он свежее суток — виновник снаружи
find /mnt/datastore/store1/.chunks -type f -printf '%A@ %p\n' | sort -n | head -3

# активные задачи PBS
proxmox-backup-manager task list
Если самый старый atime вчерашний, хотя сутки ничего не бэкапилось, ищите постороннего читателя в cron, systemd-таймерах и расписании антивируса. Пока он не убран, никакой тюнинг cutoff не поможет: чужой процесс обновляет atime быстрее, чем истекает любой разумный порог.
Параллельно решаем проблему по-настоящему. Место кончилось не потому, что GC плохая, а потому, что политика хранения не соответствует объёму дисков. Вариантов три, все честные: осознанно уменьшить глубину хранения, докупить диски или вынести длинный хвост истории на отдельный дешёвый датастор через sync job — в 4.2 это может быть и S3-совместимое хранилище.
И последнее про аварийный режим. Если датастор забит настолько, что не проходят даже ночные бэкапы, я сначала отключаю самые тяжёлые и наименее критичные задания — например, полный образ файлового сервера, который можно пропустить на одну ночь, — а базы 1С и контроллер домена оставляю. Одна пропущенная ночь по файлопомойке почти ничего не стоит, а пропущенная ночь по бухгалтерской базе в конце квартала может стоить очень дорого.
Как настроить расписания PBS, чтобы вопрос больше не возникал
Расписание. Prune — ежедневно ночью, после окна бэкапов. GC — раз в неделю, через сутки с лишним после prune, обычно в выходной утром. Verify — раз в неделю, но в другой день. Всё ставится штатно, из веб-интерфейса или CLI, без самописных скриптов. Если PBS ставите с нуля, базовые шаги я разбирал в статье про установку и удалённый бэкап PBS.
Политику хранения я считаю от требований бизнеса, а не от того, что влезло. Для бухгалтерии типичный запрос — возможность поднять базу 1С на любой день последних двух недель, на конец каждой недели за два месяца и на конец каждого месяца за полгода. Это ровно keep-daily 14, keep-weekly 8, keep-monthly 6. Дальше смотрю реальный суточный прирост уникальных данных по статистике датастора, умножаю на глубину, добавляю запас на суточную задержку GC и 20 % свободного места — и получаю объём дисков, который нужно закладывать, а не угадывать.
Мониторинг. Два порога на заполнение: 80 % — «пора планировать», 90 % — «пора действовать». Плюс алерт на статус задач GC, prune, verify и sync. PBS умеет слать уведомления сам, но я дополнительно вешаю внешнюю проверку через Zabbix по API: уведомление о проблеме от самого сломавшегося сервера — так себе уведомление.
Гигиена датастора. Никаких посторонних процессов внутри каталога: ни антивируса, ни rsync, ни «бэкапа бэкапа» файловыми средствами. Вторая копия — только sync job. На ZFS atime должен быть включён; отдельный датасет под датастор с квотой, чтобы переполнение PBS не утащило за собой систему. И раз в квартал — тестовое восстановление: не verify, а настоящий restore виртуальной машины или базы 1С на тестовый хост с замером времени. В «Точном учёте» после этой истории такой тест стал пунктом квартального регламента.
Частые вопросы
Сколько ждать, чтобы место реально освободилось?
При настройках по умолчанию — 24 часа 5 минут от последнего обращения к chunks плюс время самой GC. На практике — до следующего запланированного прогона GC, начатого позже этого срока. Ненулевые Pending removals означают, что место вернётся.
Можно удалить файлы из .chunks вручную, чтобы не ждать?
Нет. Вы не знаете, на какие куски ссылаются живые снимки. Единственный поддерживаемый способ удаления chunks — задача Garbage Collection. Если горит, временно снизьте gc-atime-cutoff, остановив все задачи на датастор.
Почему повторный запуск GC через час ничего не меняет?
Первая фаза предыдущего прогона обновила atime у живых кусков, а мусор ещё не старше порога. Освобождение зависит от возраста кусков, а не от числа запусков. Оптимально — GC раз в неделю.
GC ругается на atime safety check — что делать?
Проверьте, что файловая система датастора смонтирована без noatime и что на ZFS-датасете не стоит atime=off (`zfs get atime,relatime`). Чинить нужно монтирование, а не выключать проверку.
Как правильно держать вторую копию датастора PBS?
Через sync job — pull или push на второй PBS или в другой датастор, в версии 4.2 — в том числе с S3-совместимым бэкендом. rsync, rclone и сторонние файловые агенты читают chunks и мешают GC освобождать место.
Источники
- Proxmox Backup Server 4.2 — Maintenance Tasks, Garbage Collection — Две фазы GC, порог «oldest backup writer или 24 часа 5 минут до старта GC», объяснение через relatime, Pending removals, --gc-schedule. https://pbs.proxmox.com/docs/maintenance.html
- Proxmox Backup Server 4.2 — Backup Storage, Tuning Options — gc-atime-cutoff, gc-atime-safety-check (по умолчанию включена), gc-cache-capacity (1048576, максимум 8388608, 0 — выключить), chunk-order, sync-level, синтаксис --tuning. https://pbs.proxmox.com/docs/storage.html
- Proxmox Backup Server — Command Syntax — garbage-collection list/start/status, datastore update --tuning, task list, допустимые значения --output-format (text|json|json-pretty). https://pbs.proxmox.com/docs/command-syntax.html
- pbs-devel: «ui: expose GC atime cutoff in datastore tuning option» — gc-atime-cutoff в минутах, значение по умолчанию 1445 (24 часа 5 минут), подсказка в интерфейсе. https://lore.proxmox.com/pbs-devel/20250405090512.165609-9-c.ebner@proxmox.com/
- Proxmox — Proxmox Backup Server 4.2 released — Релиз 29.04.2026: S3-совместимое хранилище как бэкенд датастора, параллельные sync job (worker-threads). https://www.proxmox.com/en/about/company-details/press-releases/proxmox-backup-server-4-2