
Синхронизация PBS — это зеркало, а не второй архив: что делает remove-vanished
Вторую площадку с Proxmox Backup Server ставят ровно за одним: чтобы история копий пережила всё, что случится с первой. А потом одна галочка в задании синхронизации превращает её в зеркало — и удалённое на источнике аккуратно удаляется на приёмнике. Разбираю, что именно делает remove-vanished, какие права ему нужны в pull и push, почему флаг protected не переезжает вместе со снимком, и как я собираю DR-площадку так, чтобы её нельзя было выкосить с основного сервера.
Синхронизация в PBS — это зеркало, а не второй архив
Меня регулярно зовут «посмотреть бэкапы», и в половине случаев картина одинаковая. Есть PBS в серверной, есть PBS на второй площадке, между ними sync job по расписанию, в отчётах зелёно. Хозяин инфраструктуры уверен, что у него две независимые копии. На деле у него одна копия и её отражение, а степень независимости отражения определяется одним булевым полем в конфиге задания.
Задание синхронизации в PBS — это не «копирование в архив». Это приведение состояния целевого datastore к состоянию источника в пределах выбранных namespace, групп и глубины. Новые снимки приезжают всегда. А вот что делать со снимками, которые на источнике уже исчезли, решает опция remove-vanished. По документации она удаляет с локального хранилища «backup snapshots, groups and namespaces which are no longer available on the Remote datastore» — то есть не только отдельные снимки, но и целые группы и целые пространства имён.
Хорошая новость, с которой стоит начать, потому что паниковать чаще всего не нужно: в sync.cfg у remove-vanished значение по умолчанию — false. Если вы создавали задание в веб-интерфейсе и не трогали чекбокс «Remove vanished», ваша вторая площадка уже ведёт себя как накопитель, а не как зеркало. Проблема почти всегда в другом: кто-то когда-то включил галочку, чтобы «место не росло», и об этом забыли. Проверяется это за одну команду, и я советую сделать это прямо сейчас, не дочитывая статью.
Отдельно о связи с prune на источнике, потому что её недооценивают сильнее всего. Для задания синхронизации нет разницы, кто убрал снимок: администратор руками, штатное задание prune по расписанию или шифровальщик с доступом к веб-интерфейсу. С включённым remove-vanished политика удержания источника автоматически становится политикой удержания приёмника: держите на основном PBS keep-daily 14, значит и на второй площадке через месяц останется не больше. Собственное задание prune на приёмнике в такой схеме может только укоротить историю, но никак не удлинить её.
- remove-vanished выключен по умолчанию — специально включённая опция, а не поведение из коробки
- удаляются не только снимки, но и группы, и namespace целиком
- работает в обе стороны синхронизации: и в pull, и в push
- в веб-интерфейсе это скромный чекбокс в диалоге создания задания, без предупреждений
Что делает remove-vanished и какие права ему нужны
Механика простая. Задание получает список групп и снимков на удалённой стороне, сравнивает с локальным, и всё, что есть локально и отсутствует на источнике в пределах области видимости задания, помечается как vanished. Дальше поведение развилки: при выключенной опции такие снимки просто остаются лежать, при включённой — удаляются. Ключевое слово тут «в пределах области видимости»: если вы сузили group-filter или max-depth, то, что не попало в область, vanished не считается. Это, кстати, единственный аккуратный способ иметь remove-vanished и при этом не потерять кусок истории — вынести его в отдельный namespace, которого задание не касается.
Права различаются по направлению. Для pull настраивающему задание пользователю нужен Remote.Read на пути /remote/{remote}/{remote-store} и как минимум Datastore.Backup на локальном /datastore/{store}. Если включён remove-vanished, добавляется Datastore.Prune на локальном datastore. Если опция owner не задана (тогда владельцем становится root@pam) или указан кто-то, кроме настраивающего, нужен ещё Datastore.Modify. Важно понимать, где эта проверка работает: права проверяются у того, кто создаёт или меняет задание. Поэтому полезный приём такой — задания синхронизации на приёмнике ведёт отдельная учётка с ролью без Datastore.Prune, и сохранить задание с галочкой Remove vanished она просто не сможет. От root@pam это не защищает, так что рядом нужна дисциплина: под root задания не правим.
Вторая половина прав живёт на источнике. Задание pull видит только те группы, которые может прочитать учётка из конфигурации remote. Если на основном сервере этой учётке выдана только роль DatastoreBackup, синхронизируются лишь снимки, которыми она владеет. Для полной копии ей нужна DatastoreReader на datastore источника — и ничего сверх этого: права на запись и удаление на основном сервере DR-площадке не нужны.
Для push набор другой: Remote.Audit на /remote/{remote} и Remote.DatastoreBackup на целевом namespace, плюс Datastore.Read и Datastore.Audit на источнике (или Datastore.Backup, если пользователь владеет заданием). Удаление исчезнувшего требует Remote.DatastorePrune, а снос исчезнувших namespace — Remote.DatastoreModify. То есть в push-сценарии удаляющие права живут на приёмнике и выдаются удалённой учётной записи, под которой пушит источник. Это принципиально: в push вы отдаёте право удалять на DR-площадке машине, которая стоит в основном офисе.
Отдельно про API-токены. Права токена считаются по ACL, содержащим его ID, независимо от прав самого пользователя, а затем пересекаются с правами пользователя. Токен не может быть шире юзера, но может быть уже — и это нужно использовать. Синхронизация должна ходить не под root@pam, а под выделенным токеном с минимальным набором.
- pull + remove-vanished → Datastore.Prune на локальном datastore у настраивающего задание
- pull + owner не задан или чужой → дополнительно Datastore.Modify
- push + remove-vanished → Remote.DatastorePrune у удалённой учётки
- push + удаление namespace → Remote.DatastoreModify
- pull видит только группы, доступные учётке remote на источнике (для полной копии — DatastoreReader)
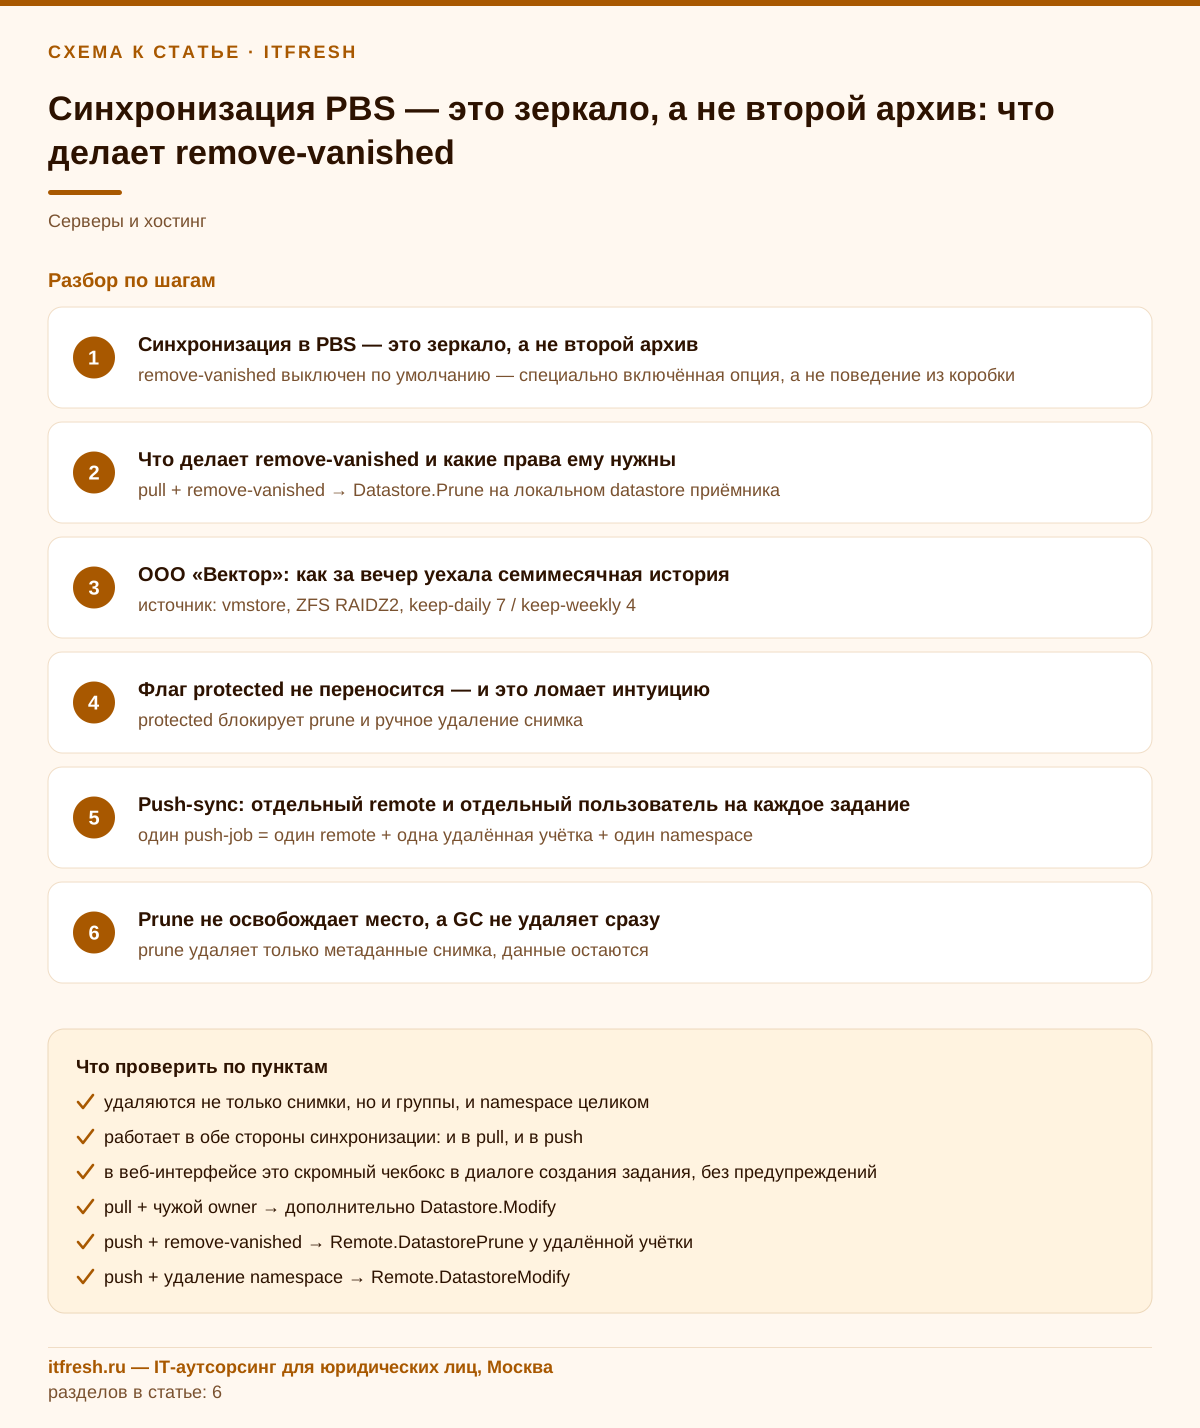
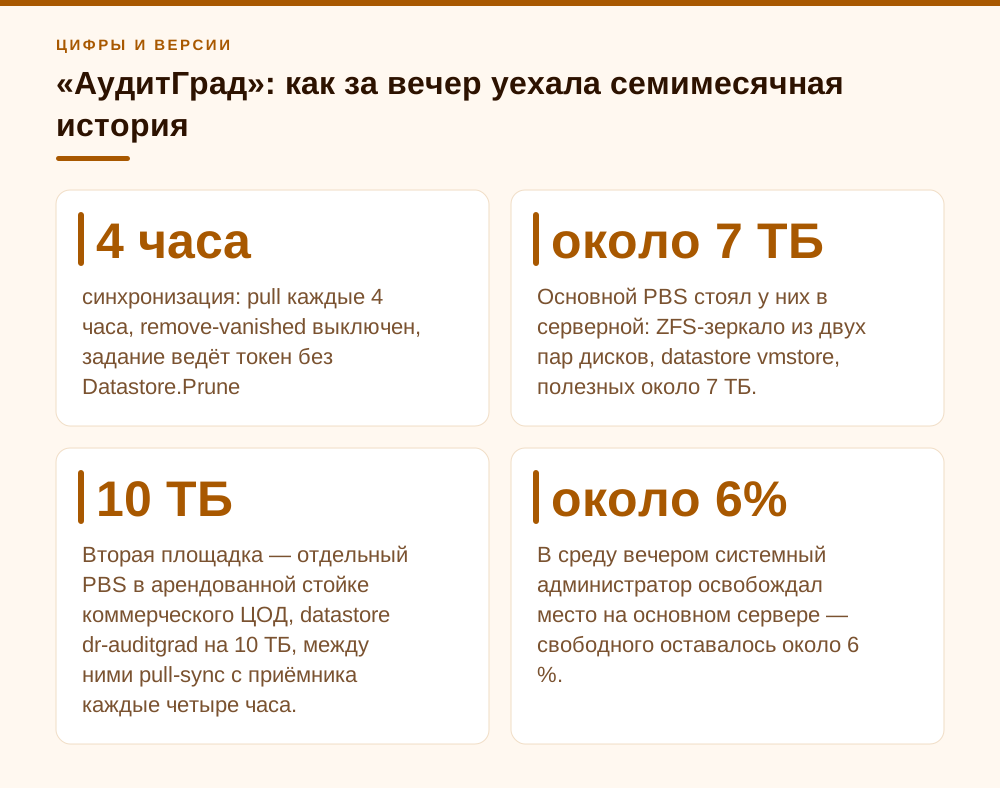
«АудитГрад»: как за вечер уехала семимесячная история
Аудиторская фирма «АудитГрад», 19 рабочих мест, две ноды Proxmox VE и девять виртуалок: контроллер домена, сервер 1С, терминальный сервер, файловый сервер с рабочими документами проверок и пара служебных машин. Основной PBS стоял у них в серверной: ZFS-зеркало из двух пар дисков, datastore vmstore, полезных около 7 ТБ. Вторая площадка — отдельный PBS в арендованной стойке коммерческого ЦОД, datastore dr-auditgrad на 10 ТБ, между ними pull-sync с приёмника каждые четыре часа. Схема правильная: тянет получатель, основной сервер не имеет на DR никаких прав. Ошибка была одна — при создании задания поставили Remove vanished, «чтобы зеркало не разъезжалось».
Политика удержания на источнике была keep-daily 14 / keep-weekly 8 / keep-monthly 6, и с включённым remove-vanished ровно столько же жило на приёмнике. В среду вечером системный администратор освобождал место на основном сервере — свободного оставалось около 6 %. Он удалил через веб-интерфейс группу vm/112: старый файловый сервер, который уже мигрировали на новую виртуалку, и группа считалась мусором. Для текущей работы она и была мусором. Но в ней лежала история шары с рабочими документами за семь месяцев — 26 снимков, и именно за ними аудиторы приходили с просьбой «верните папку по клиенту, как было до сдачи отчёта».
В 22:15 отработал очередной pull. Задание увидело, что группы vm/112 на источнике больше нет, и удалило её на приёмнике — у владельца задания были нужные права. Утром позвонили нам. Garbage collection на dr-auditgrad шёл по воскресеньям, чанки физически ещё лежали в chunk-store, но манифесты и index-файлы удалены вместе со снимками. Без индекса чанки — мешок обезличенных блоков, штатного пути собрать из них снимок нет. Восстановили ноль из 26; спасло только то, что часть документов нашлась в почте и у самих аудиторов на ноутбуках.
Что переделали. Выключили remove-vanished. Завели на приёмнике namespace auditgrad-prod и отдельный API-токен sync@pbs!auditgrad с ролью DatastoreBackup на этом namespace — без Prune и без Modify, задания правит только он. Поставили на приёмнике собственное задание prune с длинным окном, независимым от источника: на vmstore оставили keep-daily 14 / keep-weekly 8 / keep-monthly 6, на dr-auditgrad — keep-daily 30 / keep-weekly 12 / keep-monthly 24 / keep-yearly 5, под сроки хранения рабочих документов аудита. Роста, которого боялись, не случилось: однотипные Windows-виртуалки дедуплицируются хорошо, и хранилище прибавляет порядка 40–60 ГБ в месяц.
- источник: vmstore, ZFS-зеркало, keep-daily 14 / keep-weekly 8 / keep-monthly 6
- приёмник: dr-auditgrad, namespace auditgrad-prod, keep-daily 30 / keep-weekly 12 / keep-monthly 24 / keep-yearly 5
- синхронизация: pull каждые 4 часа, remove-vanished выключен, задание ведёт токен без Datastore.Prune
- GC на приёмнике — воскресенье после prune, verify — ежедневно новое + ежемесячная переверификация
Флаг protected не переносится — и это ломает интуицию
Многие пытаются защититься иначе: пометить важные снимки как protected и жить спокойно. Логика понятная — protected запрещает и prune, и ручное удаление, пока флаг не снят. Но есть строчка в документации, которую пропускают почти все: «This flag will not be synced when using pull or sync jobs. If you want to protect a synced snapshot, you have to do this again manually on the target backup server.» В разделе про sync jobs то же сказано короче: «The protected flag of remote backup snapshots will not be synced.»
То есть вы защитили мартовский снимок на основном сервере, он приехал на DR-площадку — и приехал незащищённым. На приёмнике он обычный снимок, который снесёт и локальный prune, и remove-vanished. Флаг надо ставить отдельно, на целевом сервере, своими руками или скриптом. Это ровно та деталь, из-за которой у людей возникает ощущение «я же всё пометил» — а на второй площадке помечено ничего.
Спасает ли protected на приёмнике от remove-vanished? По исходникам PBS — да: в коде pull помеченный локальный снимок при удалении исчезнувших пропускается с записью в журнал задания, а в push целевой сервер оставляет защищённые снимки и задание пишет «Kept protected snapshot … on remote». Группа при этом удаляется частично: уходят незащищённые снимки, защищённые остаются. Но в документации к sync jobs такого обещания прямым текстом нет, и строить на этом единственную линию обороны я бы не стал. Protected — хорошая вторая линия. Первая — права и выключенный remove-vanished.
- protected блокирует prune и ручное удаление снимка
- при синхронизации флаг не переносится ни в pull, ни в push
- на приёмнике его надо ставить заново — вручную или скриптом
- при удалении группы с protected-снимком удаляются только незащищённые, остальные остаются; снять флаг так же просто, как поставить
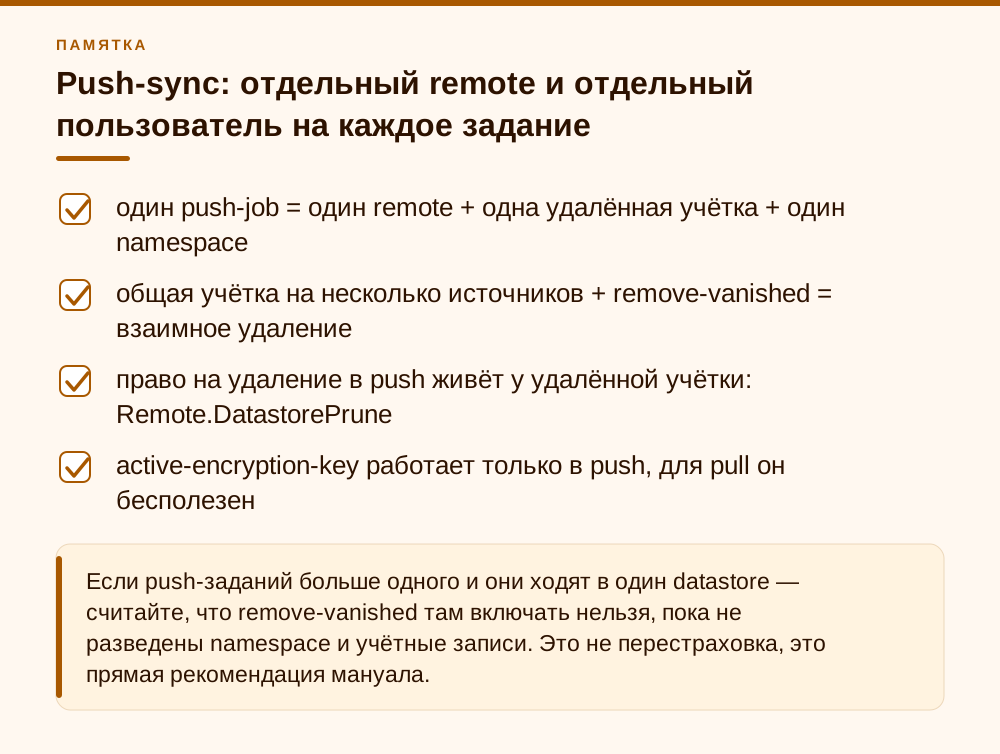
Push-sync: отдельный remote и отдельный пользователь на каждое задание
Push-направление появилось не так давно и очень удобно там, где приёмник не может достучаться до источника: DR-площадка за NAT, филиал без белого адреса, изолированный сегмент. Источник сам инициирует соединение и заливает снимки. Но именно тут документация даёт самое жёсткое предупреждение из всей главы про синхронизацию: «It is strongly advised to create a dedicated remote configuration for each individual sync job in push direction, using a dedicated user on the remote. Otherwise, sync jobs pushing to the same target might remove each others snapshots and/or groups, if the remove vanished flag is set…»
Переведу на язык последствий. Если у вас три филиала пушат в один datastore на центральной площадке под одной и той же удалённой учёткой, и хотя бы у одного задания включён remove-vanished — это задание увидит снимки двух других филиалов как «исчезнувшие на источнике» и снесёт их. Не по злому умыслу, а строго по своей логике: их нет там, откуда я пушу, значит они vanished. Владелец тут не спасает: в push всё залитое на приёмнике принадлежит пользователю из конфигурации remote, а не локальному owner задания — у трёх филиалов с общей учёткой и владелец общий. А Remote.DatastoreModify, по документации, позволяет удалять namespace на приёмнике целиком, независимо от владельца.
Правильная раскладка: на каждое push-задание — свой namespace на приёмнике, свой пользователь или API-токен, свой remote-конфиг. Namespace изолирует область видимости, отдельная учётка изолирует права. И только в такой конфигурации я вообще готов обсуждать включение remove-vanished в push, потому что тогда задание физически не видит чужого.
Ещё одна практическая вещь про push: шифрование. При push можно назначить заданию active-encryption-key, и незашифрованные снимки будут зашифрованы при отправке, а уже зашифрованные пойдут как есть, без перешифровки. Для pull активный ключ не действует и задавать его не нужно — там указываются associated keys для расшифровки. Снимки с частично зашифрованным содержимым push пропускает, а для настройки ключей нужен System.Modify на /system/encryption-keys/{key}. Если вы гоните бэкапы на площадку, которой доверяете не полностью, это тот самый рычаг.
- один push-job = один remote + одна удалённая учётка + один namespace
- общая учётка на несколько источников + remove-vanished = взаимное удаление
- право на удаление в push живёт у удалённой учётки: Remote.DatastorePrune
- active-encryption-key работает только в push, для pull он бесполезен
Prune не освобождает место, а GC не удаляет сразу
Тут стоит успокоить, потому что этот момент пугает людей сильнее, чем следует. Prune в PBS не трогает данные: при удалении снимка убираются только метаданные — манифест, индексы, блобы, лог и заметки. Сами чанки остаются в chunk-store и живут там до сборки мусора. Garbage collection проходит по хранилищу и удаляет неиспользуемые чанки, сверяя время доступа с отсечкой: это либо самый старый активный писатель, либо 24 часа и 5 минут до старта GC. Чанки внутри этого окна не удаляются — так сделано потому, что файловые системы обычно монтируются с relatime, и atime обновляется не чаще раза в сутки.
Практический вывод двоякий. С одной стороны, между ошибочным удалением и физической потерей данных у вас есть окно минимум в сутки плюс интервал до ближайшего GC. С другой — радоваться нечему: без index-файлов собрать снимок из чанков штатными средствами нельзя, и в истории с «АудитГрадом» именно это нас и убило. Окно GC спасает от переполнения хранилища и от повторной заливки, но не от потери снимка.
Из этого следует режим действий при инциденте. Первое: немедленно остановить или отключить по расписанию все задания синхронизации, чтобы удаление не приехало по новой. Второе: не запускать garbage collection ни в коем случае. Третье — перевести datastore в режим обслуживания read-only, чтобы туда никто ничего не писал, пока разбираетесь. Четвёртое: искать копию не в chunk-store, а там, где сохранились индексы — на ленте, на снапшоте ZFS под datastore, на третьей площадке.
На практике первые минуты у меня выглядят так — на приёмнике, где ещё остались данные:
# Снять расписание с задания синхронизации, чтобы следующий запуск не повторил удаление
proxmox-backup-manager sync-job update auditgrad-pull --delete schedule

# Перевести хранилище в read-only: чтение и восстановление работают, запись — нет
proxmox-backup-manager datastore update dr-auditgrad --maintenance-mode type=read-only

# Если datastore на ZFS — зафиксировать текущее состояние
zfs snapshot tank/dr-auditgrad@incident-$(date +%F-%H%M)
Имя пула и датасета ZFS здесь условные — подставьте свои. После разбора режим снимается через --delete maintenance-mode, расписание возвращается обратно.
- prune удаляет только метаданные снимка, данные остаются
- GC освобождает место, отсечка — 24 часа 5 минут до старта
- чанки в пределах grace-периода не удаляются
- потеря индекса = потеря снимка, даже если чанки на диске
Как я собираю вторую площадку сейчас
Схема, к которой я пришёл за несколько лет и которую ставлю по умолчанию. Тянет всегда приёмник — pull, а не push, если сеть позволяет. Основной сервер не имеет на DR-площадке никаких прав вообще: скомпрометировали основной PBS шифровальщиком — DR это не касается. remove-vanished выключен. На приёмнике свой namespace под каждого источника, свой API-токен с ролью DatastoreBackup без Datastore.Prune, а на источнике — учётка для чтения с DatastoreReader, своё задание prune с более длинным удержанием, свой GC и своя верификация.
Начинаю с аудита того, что уже есть. Эти две команды я прогоняю на каждом PBS, который вижу впервые:
# 1. Все задания синхронизации, включая push, с флагом remove-vanished
proxmox-backup-manager sync-job list --sync-direction all --output-format json-pretty \
  | jq -r '.[] | [.id, ."sync-direction" // "pull", .store, .remote // "-", ."remote-store",
           (."remove-vanished" // false), .ns // "/", .owner // "-"] | @tsv'

# 2. Кто и что может делать на хранилищах — ищем Datastore.Prune и DatastoreAdmin
proxmox-backup-manager acl list --output-format json-pretty
Дальше — создание задания и разграничение прав. Обратите внимание на порядок: сначала ACL, потом задание. Namespace на приёмнике создаю заранее в веб-интерфейсе хранилища. Если сделать наоборот, между созданием и настройкой прав будет окно, когда задание ходит с чрезмерными правами.
# Сначала права: токен для синхронизации получает только DatastoreBackup,
# без Datastore.Prune и без Datastore.Modify (namespace auditgrad-prod создан заранее)
proxmox-backup-manager user generate-token sync@pbs auditgrad
proxmox-backup-manager acl update /datastore/dr-auditgrad/auditgrad-prod DatastoreBackup \
  --auth-id 'sync@pbs!auditgrad'
proxmox-backup-manager acl update /remote/pbs-office RemoteSyncOperator \
  --auth-id 'sync@pbs!auditgrad'

# Remote на основной сервер. На источнике токен pull@pbs!dr имеет только DatastoreReader на vmstore
proxmox-backup-manager remote create pbs-office \
  --host 192.0.2.10 --auth-id 'pull@pbs!dr' --password '<секрет токена>' \
  --fingerprint '<sha256-отпечаток сертификата источника>'

# И только теперь само задание. remove-vanished НЕ указываем — default false
proxmox-backup-manager sync-job create auditgrad-pull \
  --remote pbs-office --remote-store vmstore \
  --store dr-auditgrad --ns auditgrad-prod \
  --sync-direction pull \
  --schedule '*-*-* 02,06,10,14,18,22:15' \
  --owner 'sync@pbs!auditgrad' \
  --rate-in 40MiB --worker-threads 4 \
  --resync-corrupt true
И финальный слой — независимая политика удержания на приёмнике плюс верификация. Верифицировать надо обязательно: синхронизация переносит чанки, а не гарантирует их целостность на новом месте. Мануал рекомендует переверифицировать все копии не реже раза в месяц, и я делаю именно так — ежедневное задание на новые снимки и ежемесячное на всё хранилище. Опция resync-corrupt в задании синхронизации заново подтягивает снимки, не прошедшие последнюю верификацию, — поэтому verify должен отработать раньше такого sync, а сам sync с resync-corrupt идёт дольше обычного: он проверяет манифесты всех снимков.
# Своя, более длинная политика удержания на приёмнике
proxmox-backup-manager prune-job create dr-auditgrad-keep \
  --store dr-auditgrad --ns auditgrad-prod \
  --schedule 'sun 03:00' \
  --keep-daily 30 --keep-weekly 12 --keep-monthly 24 --keep-yearly 5

# GC после prune, не раньше
proxmox-backup-manager garbage-collection start dr-auditgrad

# Ручная защита ключевой точки восстановления — флаг с источника не приедет
proxmox-backup-client snapshot protected update vm/112/2026-03-31T22:00:03Z true \
  --repository 'root@pam@localhost:dr-auditgrad' --ns auditgrad-prod
Про производительность коротко, раз уж речь о реальных внедрениях. worker-threads по умолчанию 1, диапазон 1–32; на канале с заметной задержкой между площадками поднятие до 4–8 даёт очень ощутимый прирост, потому что группы синхронизируются параллельно. Ограничение полосы задаётся rate-in для pull и rate-out для push, всплески — burst-in / burst-out — на канале, который днём нужен людям, я ставлю rate-in порядка 30–40 % от ширины и не жалею. Опция transfer-last пригодится при первичном наливе, чтобы не тащить всю историю разом.
Отдельно про max-depth и group-filter, раз уж они определяют, что задание считает «своим». Пустой max-depth означает полную рекурсию по вложенным namespace, 0 — только указанный namespace без вложенных. Group-filter по документации применяется и к локальным группам при обработке remove-vanished: то, что под фильтр не попало, задание не тронет. Этим удобно пользоваться при первичном наливе (--transfer-last, --group-filter type:vm), но я не люблю строить на фильтрах защиту — один неосторожный --delete group-filter, и область видимости задания разом расширяется на всё хранилище.
- pull вместо push, если сеть позволяет: источник не имеет прав на DR
- remove-vanished выключен, а права на приёмнике не содержат Datastore.Prune
- свой namespace и свой токен на каждого источника
- своя, более длинная политика prune на приёмнике
- verify ежедневно на новое + раз в месяц полная переверификация
- worker-threads 4–8 и rate-in на межплощадочном канале
Частые вопросы
Как быстро проверить, включён ли remove-vanished в моих заданиях?
Выполните на каждом PBS: proxmox-backup-manager sync-job list --sync-direction all --output-format json-pretty и посмотрите поле remove-vanished. Ключевой момент — параметр --sync-direction all: без него команда покажет только pull-задания, а push-задания, где риск взаимного удаления выше, останутся невидимыми. Если поля нет вовсе, значит опция не задана и действует значение по умолчанию — false.
Если я удалю снимок на основном сервере, он исчезнет на второй площадке?
Только если в задании синхронизации включён remove-vanished: тогда при pull исчезнувшее удаляется на локальном datastore приёмника, а при push удаление выполняется на удалённом сервере с правом Remote.DatastorePrune. Причём неважно, как снимок исчез на источнике — вручную или плановым prune. По умолчанию remove-vanished выключен, и удалённый на источнике снимок остаётся на приёмнике, пока его не удалит собственное задание prune приёмника.
Флаг protected защитит мои снимки на второй площадке?
Не автоматически. Документация прямо говорит, что protected не синхронизируется: снимок приезжает на приёмник незащищённым, и ставить флаг нужно заново на целевом сервере. Если флаг на приёмнике поставлен, код синхронизации пропускает такой снимок при удалении исчезнувших и пишет об этом в журнал, но в документации это поведение не описано, поэтому основной защитой должны быть права и выключенный remove-vanished.
Мы случайно удалили группу и синхронизация её унесла. Что делать в первые минуты?
Остановить и отключить по расписанию все задания синхронизации, чтобы удаление не приехало повторно, и ни в коем случае не запускать garbage collection. Перевести datastore в режим обслуживания: proxmox-backup-manager datastore update <store> --maintenance-mode type=read-only. Чанки в хранилище ещё живы — GC не удаляет их в пределах 24 часов и 5 минут до своего старта, — но без index-файлов собрать из них снимок штатными средствами нельзя. Ищите копию там, где сохранились метаданные: снапшот ZFS под datastore, лента, третья площадка.
Стоит ли вообще когда-нибудь включать remove-vanished?
Да, но в узком случае: когда вторая площадка сознательно строится как точное зеркало для быстрого переезда, а не как долговременный архив, и её объём жёстко ограничен. Тогда обязательны выделенный namespace и учётка на каждое задание, а критичные точки восстановления помечаются protected на приёмнике вручную. Единого мнения в сообществе тут нет: часть админов держит зеркало ради предсказуемого объёма, я предпочитаю платить дисками и иметь на DR более длинную историю, чем на источнике.
Несколько филиалов пушат в один datastore. Это безопасно?
Безопасно, только если у каждого задания свой remote, своя удалённая учётная запись и свой namespace на приёмнике. Мануал предупреждает об этом прямым текстом: при общей учётке задания, пушащие в одну цель, могут удалять снимки и группы друг друга — потому что чужие снимки с точки зрения каждого задания выглядят исчезнувшими на источнике. Пока namespace и учётки не разведены, remove-vanished в такой схеме включать нельзя.
Чем опасна связка remove-vanished и prune на основном сервере?
С включённым remove-vanished приёмник наследует политику удержания источника: всё, что плановый prune убрал на основном PBS, следующий запуск синхронизации удалит и на второй площадке. Длинную историю на DR при такой схеме получить нельзя — собственный prune приёмника может только укоротить её. Если нужна история длиннее, чем на источнике, remove-vanished выключают, а на приёмнике заводят своё задание prune с более щедрыми keep-*.
Источники
- Proxmox Backup Server 4.2.5-1 — Managing Remotes & Sync Jobs — Раздел «Sync Jobs»: поведение remove-vanished, требуемые привилегии для pull (Remote.Read, Datastore.Backup, Datastore.Prune, Datastore.Modify) и push (Remote.Audit, Remote.DatastoreBackup, Remote.DatastorePrune, Remote.DatastoreModify), рекомендация отдельного remote и пользователя на каждое push-задание, несинхронизируемый флаг protected, применение group-filter к локальным группам при remove-vanished, удаление исчезнувших namespace, resync-corrupt, worker-threads, rate-in/out, active-encryption-key. https://pbs.proxmox.com/docs/managing-remotes.html
- Proxmox Backup Server 4.2.5-1 — sync.cfg (man 5) — Полный список опций задания синхронизации с типами и значениями по умолчанию: remove-vanished (boolean, default false), sync-direction (pull|push, default pull), worker-threads (1-32, default 1), transfer-last, max-depth (0-7), group-filter, ns / remote-ns, encrypted-only, verified-only, resync-corrupt, rate-in/rate-out, burst-in/burst-out. https://pbs.proxmox.com/docs/config/sync/man5.html
- Proxmox Backup Server 4.2.5-1 — Backup Client, раздел Protection — Команда proxmox-backup-client snapshot protected update <snapshot> true|false и прямая формулировка: «This flag will not be synced when using pull or sync jobs. If you want to protect a synced snapshot, you have to do this again manually on the target backup server.» https://pbs.proxmox.com/docs/backup-client.html
- Proxmox Backup Server 4.2.5-1 — Maintenance Tasks — Prune удаляет только метаданные снимка (manifest, indices, blobs, log, notes); garbage collection удаляет неиспользуемые чанки с отсечкой «24 hours and 5 minutes before the start of the garbage collection»; опции удержания keep-last / keep-hourly / keep-daily / keep-weekly / keep-monthly / keep-yearly; рекомендация переверифицировать копии не реже раза в месяц. https://pbs.proxmox.com/docs/maintenance.html
- Proxmox Backup Server 4.2.5-1 — User Management — Встроенные роли (DatastoreAdmin, DatastorePowerUser, DatastoreBackup, DatastoreReader, DatastoreAudit, RemoteSyncOperator и др.) и правило для API-токенов: права токена считаются по собственным ACL и затем пересекаются с правами пользователя. https://pbs.proxmox.com/docs/user-management.html
- proxmox-backup-manager (man 1) — синтаксис sync-job и prune-job — Точный синтаксис proxmox-backup-manager sync-job create <id> --remote-store <string> --store <string> [OPTIONS] с флагами --remove-vanished, --sync-direction, --ns, --remote-ns, --max-depth, --transfer-last, --worker-threads; sync-job list --sync-direction all|push|pull (default pull); prune-job create --schedule --store --keep-*; acl update <path> <role> --auth-id. https://pbs.proxmox.com/docs/proxmox-backup-manager/man1.html
- Proxmox Forum — Why not delete backup VM with synchronisation on second server PBS — Тред «[SOLVED] Why not delete backup VM with synchronisation on second server PBS»: снимки, удалённые на основном PBS, остаются на втором, пока в задании синхронизации не включён remove-vanished; типовые ожидания администраторов против реального поведения sync job. https://forum.proxmox.com/threads/why-not-delete-backup-vm-with-synchronisation-on-second-server-pbs.115909/
- Исходный код proxmox-backup — src/server/pull.rs и push.rs — Логика удаления исчезнувших снимков: защищённые (protected) снимки при remove-vanished пропускаются с записью в журнал, в push целевой сервер сообщает о сохранённых protected-снимках. https://git.proxmox.com/?p=proxmox-backup.git;a=tree;f=src/server