
Proxmox Backup Server нашёл повреждённые снимки, а обычный Sync их не лечит: как работает resync-corrupt
У вас два Proxmox Backup Server: основной в серверной и резервный на другой площадке. Sync между ними который месяц горит зелёным. А потом вы запускаете Verification на резервном — и получаете три десятка снимков в статусе failed. Запускаете Sync ещё раз, надеясь, что он перекачает битое. Он отрабатывает за семь минут и снова зелёный. Не исправилось ничего. Разбираю, почему так устроено, что именно делает опция resync-corrupt, в каком порядке всё запускать, сколько это занимает по времени — и что делать, если повреждение оказалось не только на приёмнике.
Обычный Sync не перекачивает то, что у него формально уже есть
Начну с механики, потому что без неё всё остальное выглядит как магия. Sync-задание в PBS работает по группам бэкапов. Для каждого снимка оно скачивает с источника манифест — файл index.json — и сравнивает его с локальным манифестом. Если байты совпали, задание пишет в лог no data changes, закрывает снимок и идёт дальше. Ни индексные файлы, ни chunks оно при этом не трогает. И правильно делает: именно на этом сравнении держится вся экономия трафика, ради которой офсайт-копию вообще имеет смысл делать по узкому каналу.
Теперь вторая половина картины. Когда Verification находит повреждённый chunk, она его не оставляет лежать как есть. Chunk переименовывается — в исходниках это rename_corrupt_chunk, в логе задачи вы увидите строку вида corrupt chunk renamed to ..., на диске получается файл с суффиксом .bad рядом с исходным именем в каталоге .chunks. То есть кусок данных физически перестаёт существовать под своим цифровым отпечатком. В хранилище образуется дырка.
Сложите одно с другим. Манифест снимка не изменился ни на байт — он и не мог измениться, порча произошла в данных, а не в метаданных. Значит, Sync честно говорит no data changes и не скачивает недостающий chunk. Снимок на приёмнике остаётся в том же состоянии: манифест на месте, индексы на месте, одного куска данных нет. Он проходит синхронизацию и не проходит восстановление. Это худший из возможных сценариев, потому что вы узнаете о нём в тот момент, когда бэкап уже нужен.
Именно поэтому я не считаю зелёный Sync доказательством того, что резервная копия жива. Sync — это про доставку. Про целостность — только Verification, и только та, которую вы запустили на самом приёмнике, а не на источнике.
- prune и удаление снимка — трогают метаданные, chunks остаются на месте;
- Verification — читает chunks, считает контрольные суммы, битые переименовывает в `.bad`, результат пишет в манифест;
- Garbage Collection — физически удаляет неиспользуемые chunks и подчищает `.bad`;
- Sync — сравнивает манифесты и тянет только то, чего нет или что изменилось.
Что делает resync-corrupt и почему он такой медленный
В документации PBS формулировка предельно короткая: включение расширенной опции resync-corrupt заставляет задание повторно синхронизировать все снимки, которые не прошли последнюю Verification. Опция появилась в PBS 3.3 (28 ноября 2024 года) — в том же релизе, где у sync-заданий появилось направление push, — и в текущей ветке 4.2 (апрель 2026) логика её работы та же. В конфигурации задания это булево свойство resync-corrupt, в справке оно описано одной фразой: если верификация локального снимка провалилась, попытаться стянуть его ещё раз. По умолчанию она выключена — и это осознанное решение разработчиков, а не недосмотр.
Работает это так. Результат проверки снимка PBS сохраняет прямо в манифесте, в незащищённой секции: manifest.unprotected["verify_state"]. Значений там три состояния, и от них зависит поведение sync-задания. Если verify_state равен Failed — снимок помечается на повторную выкачку. Если манифест вообще не читается (а это тоже симптом повреждения) — снимок тоже идёт на повторную выкачку, логика в исходниках прямо прокомментирована как «была ошибка загрузки манифеста, лучше пересинхронизировать». А вот если поля verify_state в манифесте нет — то есть снимок ни разу не проверялся — resync-corrupt его проигнорирует. Он не перепроверяет данные, он читает вердикт, вынесенный до него.
Отсюда вытекает и цена. Чтобы понять, какие снимки перезабирать, задание вынуждено открыть и разобрать локальный манифест каждого снимка в области действия задания. Обычный Sync такой работы не делает — он идёт по группам и быстро отсекает то, что совпало. Документация прямо предупреждает, что такое задание может занять существенно больше времени, чем обычная синхронизация. На датасторе с парой тысяч снимков разница между семью минутами и несколькими часами — нормальная картина, особенно если под хранилищем HDD.
И отдельно то, обо что спотыкаются чаще всего: resync-corrupt доступен только для pull-заданий. Направление задаётся свойством sync-direction (pull по умолчанию или push), и для push флага нет. Push к тому же устроен иначе по правам и владению: содержимое на удалённой стороне всегда принадлежит пользователю из настроек remote, требуются Remote.Audit и Remote.DatastoreBackup, а удалённый PBS должен быть не старше 2.2 с поддержкой пространств имён. Инженер Proxmox в форумной ветке про массовые verify failed прямо это проговаривает: если есть возможность тянуть с источника, настройте pull-задание, потому что в нём можно выбрать флаг повторной синхронизации повреждённых, а в push — нельзя. Если у вас офсайт-копия организована пушем с основного PBS на резервный, то для лечения придётся временно поднять pull-задание с обратной стороны.
- `verify_state = Failed` → снимок будет перекачан;
- манифест не читается → снимок будет перекачан;
- `verify_state` отсутствует (никогда не проверялся) → снимок будет пропущен;
- направление push (`sync-direction push`, есть с PBS 3.3) → опции нет вообще, только pull.
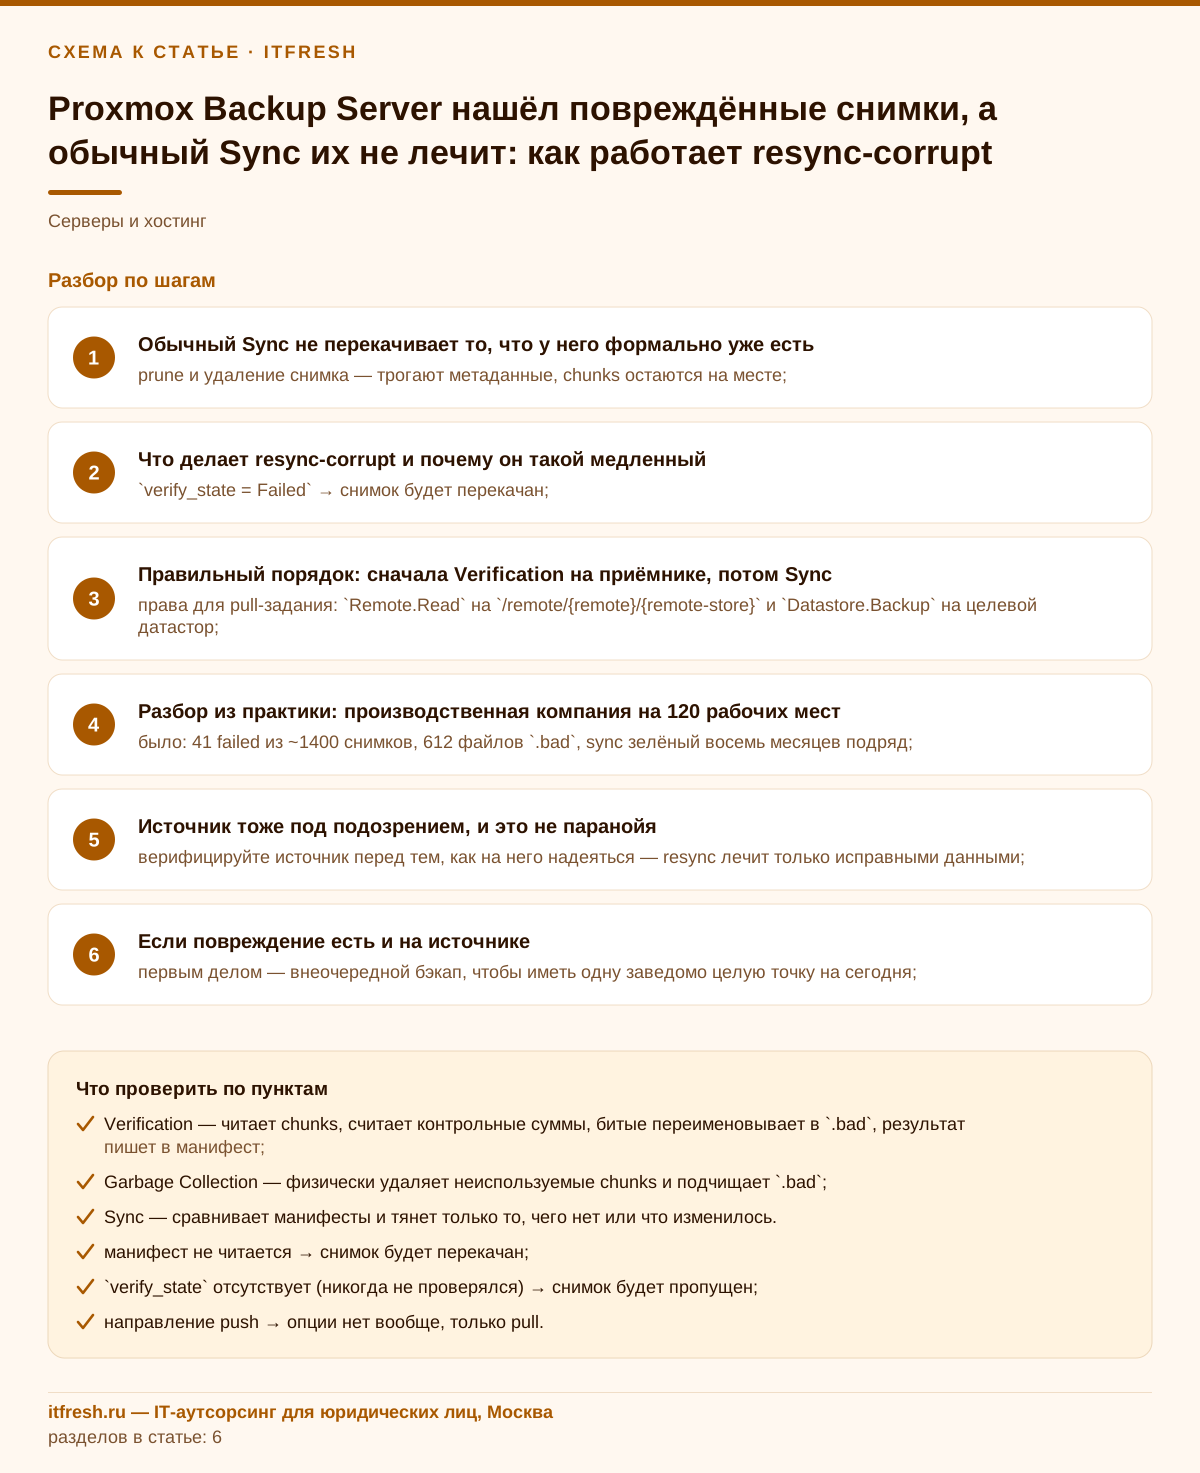
Правильный порядок: сначала Verification на приёмнике, потом Sync
Порядок здесь не рекомендация, а условие работоспособности. Сначала верификация на том сервере, где лежит подозрительная копия. Потом — синхронизация с флагом. Если сделать наоборот, вы просто прогоните обычный sync и потеряете время.
Верификацию удобнее делать заданием, а не разовой командой: у verify-job есть два параметра, ради которых он и существует. ignore-verified пропускает снимки, уже успешно проверенные ранее, а outdated-after задаёт срок, после которого проверенный снимок считается устаревшим и проверяется заново. В PBS 4.1 (ноябрь 2025) добавили настройку параллелизма верификации: read-threads и verify-threads, диапазон от 1 до 32, по умолчанию один поток чтения и четыре потока проверки. На HDD-массиве увеличение потоков чтения обычно делает только хуже — головки и так пилят случайный доступ по 65 536 подкаталогам.
Дальше — само задание. Флаг можно щёлкнуть в веб-интерфейсе (Datastore → Sync Jobs → Advanced), но я предпочитаю CLI, потому что его видно в истории и можно положить в скрипт. Полная последовательность — во врезке этого раздела: сначала verify-задание на приёмнике, потом включение флага через proxmox-backup-manager sync-job update и ручной запуск, в конце флаг снимается.
Отдельно проверьте область действия задания. Если у вас в нём стоит group-filter, ограничение глубины пространств имён через max-depth или transfer-last (синхронизировать только N последних снимков в группе), то resync-corrupt вылечит ровно то, что попадает в фильтр. Битые снимки за пределами фильтра останутся битыми, и вы этого не заметите, потому что задание отработает успешно. Я на время лечения снимаю фильтры полностью и возвращаю их обратно после.
- права для pull-задания: `Remote.Read` на `/remote/{remote}/{remote-store}` и как минимум `Datastore.Backup` на целевой датастор `/datastore/{store}`;
- плюс `Datastore.Prune`, если включён `remove-vanished`;
- плюс `Datastore.Modify`, если в поле `owner` указан не тот пользователь, который настраивает задание;
- `verified-only` — не тащить с источника непроверенное; полезно, но проверьте, что на источнике verify реально ходит, иначе задание не перенесёт ничего.
Разбор из практики: креативное агентство на 29 рабочих мест
Условно — креативное агентство «Бюро замыслов», 29 рабочих мест: дизайнеры, моушн-отдел, аккаунты и бухгалтерия. Кластер Proxmox VE из двух нод плюс кворум-устройство в офисной серверной, 12 виртуалок: 1С:Бухгалтерия, файловый сервер с исходниками макетов и видеопроектов, контроллер домена, сервер лицензий и рендер-очередь. Основной PBS стоит там же на отдельном железе, датастор на ZFS raidz2 из шести дисков по 4 ТБ. Резервный PBS — у нас в ЦОД, забирает данные pull-заданием через WireGuard, датастор на аппаратном RAID5 поверх ext4. Обе машины на ветке PBS 4.2. Занято около 7,5 ТБ — видеоархив дедуплицируется плохо, — 14 групп, порядка 620 снимков. Sync ежедневный, ночью, стабильно отрабатывал за 4–6 минут.
Verification на резервном сервере не была настроена вообще — классика. Не потому что кто-то ленивый, а потому что при заводке офсайт-копии задача звучала как «чтобы данные уехали», и на этом её закрыли. Мы взяли агентство на обслуживание, прогнали первичный аудит и запустили полную проверку резервного датастора. Она шла девять часов и выдала 23 снимка в статусе failed из 620. В каталоге .chunks нашлось 287 файлов с суффиксом .bad. На основном PBS верификация в тот же период дала ноль ошибок.
Причина обнаружилась в системном журнале резервной машины: за предыдущие полгода было два некорректных выключения по питанию, а батарея на кэше RAID-контроллера числилась деградировавшей ещё с зимы. Классическая write hole — контроллер отрапортовал о записи, данные до пластин не доехали. Ни ZFS-подобной самопроверки, ни контрольных сумм на уровне файловой системы там не было. То есть виноват был приёмник, а не канал и не источник.
Дальше по регламенту. Сначала проверили источник — полная верификация основного PBS, 0 failed, 21 из 23 «пострадавших» снимков на источнике жив и в пределах ретеншена. Потом сняли group-filter с pull-задания, включили --resync-corrupt true и запустили вручную. Обычный sync занимал 4–6 минут — этот шёл 1 час 50 минут и вытянул 96 ГБ, в основном куски образа файлового сервера. В логе задачи по каждому проблемному снимку шла строка вида re-sync snapshot ... due to corruption.
Результат: 21 снимок из 23 вылечился и прошёл повторную верификацию. Два не вылечились — они были старше сорока дней, а на источнике ретеншен настроен на тридцать, то есть исходников уже не существовало. remove-vanished на задании был выключен, поэтому приёмник их и хранил. Удалили руками: снимок, который заведомо не восстановится, только занимает место. После этого прогнали Garbage Collection: она убрала .bad-файлы и освободила 31 ГБ. Контроллеру заменили батарею, датастор пересобрали на ZFS. За четыре месяца после этого — ноль failed.
- было: 23 failed из ~620 снимков, 287 файлов `.bad`, sync зелёный восемь месяцев подряд;
- стало: 21 вылечен повторной синхронизацией, 2 удалены как безнадёжные;
- время: обычный sync 4–6 минут против 1 ч 50 мин с флагом, трафик 96 ГБ;
- после: GC освободила 31 ГБ, батарея контроллера заменена, датастор переехал на ZFS.
Источник тоже под подозрением, и это не паранойя
Инженер Proxmox в той самой форумной ветке даёт совет, который я считаю главным во всей теме: перед тем как полагаться на снимки при восстановлении, верифицируйте их и на исходных системах тоже. Логика простая — повторная передача исправляет резерв только тогда, когда на источнике лежат исправные данные. Если битый chunk приехал к вам с источника, resync-corrupt добросовестно перекачает битое ещё раз и снимок снова не пройдёт проверку.
Есть и вторая причина смотреть на источник. Инкрементальные бэкапы переиспользуют chunks предыдущих снимков — на этом стоит вся дедупликация. Один повреждённый кусок тянется через десятки снимков одной группы, и картина выглядит как лавина: сегодня один failed, через месяц пятнадцать из двадцати четырёх. Интересный побочный эффект, который в той же ветке проговаривает Chris: если снимок не прошёл верификацию, следующий бэкап зальёт chunks заново, и цепочка порчи рвётся сама. То есть верификация не просто выявляет проблему — она запускает механизм её самолечения на будущих точках.
Из этого получается практический приём, который я применяю на всех стендах с большим количеством групп, когда времени на полную проверку нет. По каждой группе бэкапов берём самый свежий снимок, ставим ему флаг protected — чтобы его не выкосил prune — и проверяем только его. Это на порядок быстрее полной верификации и при этом закрывает главный риск: свежая точка восстановления по каждой машине.
И честно про спорное. Флаг verified-only на sync-задании выглядит как идеальная защита — не тащить с источника то, что не прошло проверку. На практике он больно кусается, если на источнике верификация настроена нерегулярно: непроверенные снимки просто не поедут, и вы обнаружите на офсайте дыру в неделю. Я включаю verified-only только там, где на источнике верификация гарантированно ходит по расписанию и опережает sync по времени.
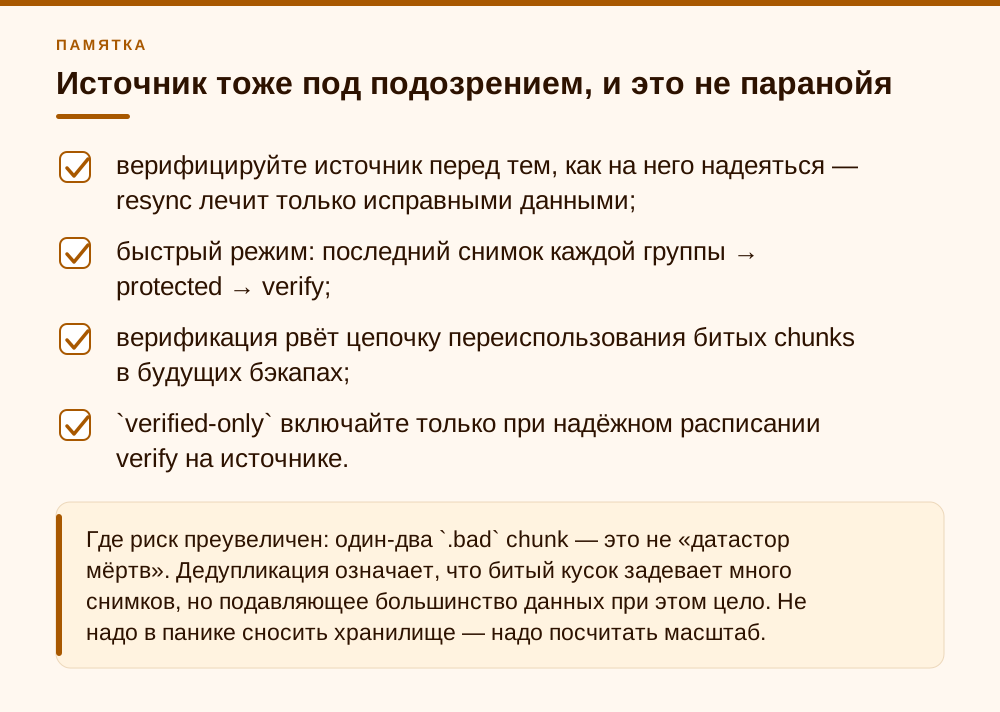
- верифицируйте источник перед тем, как на него надеяться — resync лечит только исправными данными;
- быстрый режим: последний снимок каждой группы → protected → verify;
- верификация рвёт цепочку переиспользования битых chunks в будущих бэкапах;
- `verified-only` включайте только при надёжном расписании verify на источнике.
Если повреждение есть и на источнике
Тогда resync-corrupt бессилен, и надо честно оценивать ущерб. Первым делом смотрим, сколько битых chunks и какие снимки они задевают. Считать .bad-файлы напрямую в каталоге датастора можно, но удалять их руками я не советую: этим занимается Garbage Collection, и она делает это согласованно с учётом ссылок.
Дальше — по приоритету восстановимости. Если в группе есть более старый снимок, прошедший верификацию, у вас есть точка восстановления, просто с большей потерей данных. Если повреждение задело один диск виртуалки из трёх — восстанавливайте поштучно, PBS умеет доставать отдельный образ и отдельные файлы из архива, необязательно катить всю ВМ. Если речь про файловый сервер — файловое восстановление из .pxar часто вытаскивает 95 % содержимого, потому что битым оказался конкретный chunk, а не весь архив.
И принудительно обновляем цепочку. Снимок, помеченный как failed, приводит к тому, что следующий бэкап этой группы зальёт chunks заново — то есть достаточно просто дождаться или запустить внеочередной бэкап, чтобы получить гарантированно свежую целую точку. Это, кстати, я делаю первым действием, ещё до всякого лечения: не важно, что происходит со старыми снимками, важно, чтобы на сегодня была одна заведомо целая копия.
Ну и правда, которую неприятно произносить: если битое и на источнике, и на приёмнике одинаково — значит, у вас не две копии, а одна, размноженная. Правило 3-2-1 существует ровно для этого. Офсайт-PBS, который получает данные синхронизацией, — это не независимая копия, а зеркало со всеми унаследованными дефектами. Независимость даёт только другой носитель и другой механизм: выгрузка на ленту, отдельный vzdump на съёмный диск, копия в объектное хранилище.
- первым делом — внеочередной бэкап, чтобы иметь одну заведомо целую точку на сегодня;
- `.bad`-файлы не трогать руками, их убирает Garbage Collection;
- восстанавливать поштучно: отдельный диск, отдельные файлы из `.pxar`;
- откат на предыдущий верифицированный снимок как запасной вариант;
- не считать синхронизированную копию независимой — это зеркало.
Регламент, который я ставлю на такие стенды
Первое и самое важное — развести задачи по времени, чтобы они не мешали друг другу. В той же форумной ветке настоящей причиной массовых verify failed оказалась не деградация дисков, а одновременная работа верификации и Garbage Collection на перегруженном сервере плюс забитый под ноль системный диск. Я строю ночное окно последовательно: сначала бэкапы, затем prune, затем Garbage Collection, затем верификация, и только после неё — синхронизация. Между этапами оставляю запас, а не ставлю их встык.
Второе — частота проверки. Документация PBS прямо рекомендует перепроверять все бэкапы минимум раз в месяц, даже если предыдущая проверка была успешной, потому что носители деградируют и bit rot никто не отменял. Рабочая связка: ежедневное задание с ignore-verified и outdated-after порядка 30 дней, которое подхватывает свежее и просроченное, плюс отдельное полное задание раз в месяц на выходных. На большом датасторе полная проверка идёт часами — планируйте её на время, когда сервер свободен.
Третье, и здесь моя позиция расходится с тем, что часто советуют. Держать resync-corrupt постоянно включённым на ежедневном sync-задании я не люблю: оно каждый раз перечитывает манифесты всех снимков, ежедневная синхронизация из семиминутной превращается в многочасовую, а пользы в 99 % случаев ноль, потому что чинить нечего. Я делаю два задания на одном и том же remote: ежедневное быстрое без флага и еженедельное с флагом, запускаемое после ночной верификации. Если вам такая схема кажется избыточной — включайте флаг руками по факту обнаружения failed, это тоже нормально, просто требует дисциплины.
Четвёртое — уведомления. Настройте оповещения по задачам PBS так, чтобы письмо или сообщение приходило не только при падении задания, но и при ненулевом числе неудачных снимков в верификации. Задание верификации, нашедшее 23 битых снимка, завершается со статусом «ошибка» — но если это письмо падает в общий ящик, который никто не читает, толку от него нет.
И то, на что можно спокойно забить. Не надо крутить worker-threads у sync-задания на HDD-хранилище: параллельная обработка групп появилась только в PBS 4.2 (значение от 1 до 32, по умолчанию 1, память и число соединений растут примерно линейно) даёт выигрыш на NVMe и на быстрых массивах, а на шпинделях чаще только добавляет случайного доступа. Не надо гнаться за максимальным verify-threads по той же причине. И не надо каждую неделю руками ходить в .chunks и считать .bad-файлы — если у вас настроены верификация и уведомления, вы узнаете о проблеме раньше, чем она станет видна в файловой системе.
- ночное окно строго последовательно: backup → prune → GC → verify → sync;
- verify ежедневно с `ignore-verified` + `outdated-after 30`, полная реверификация раз в месяц;
- два sync-задания: быстрое ежедневное и еженедельное с `resync-corrupt`;
- уведомления по результату верификации, а не только по падению задания;
- не крутить `worker-threads` и `verify-threads` на HDD — станет хуже.
Частые вопросы
Почему повторный запуск обычного Sync не исправляет повреждённый снимок?
Потому что Sync сравнивает манифесты, а не данные. Манифест повреждённого снимка не изменился, поэтому задание пишет в лог «no data changes» и не скачивает недостающие chunks. При этом сама Verification переименовала битый chunk в файл с суффиксом .bad, то есть кусок данных исчез из хранилища, а метаданные остались целыми. Снимок проходит синхронизацию и не проходит восстановление.
Нужно ли запускать Verification до Sync или её результат появится сам?
Обязательно до, и именно на приёмнике. resync-corrupt не проверяет данные — он читает поле verify_state в манифесте каждого локального снимка. Снимки со статусом Failed перекачиваются, снимки с нечитаемым манифестом тоже, а снимки, которые никогда не проверялись и поля verify_state не имеют, задание просто пропустит.
Работает ли resync-corrupt для push-направления?
Нет. Опция доступна только для pull-заданий (sync-direction pull, значение по умолчанию). Push-направление появилось в PBS 3.3 одновременно с resync-corrupt, но флага повторной синхронизации у него нет. Если офсайт-копия у вас организована пушем с основного PBS на резервный, для лечения придётся временно создать pull-задание с обратной стороны — именно это рекомендует инженер Proxmox в форумной ветке про массовые verify failed.
Насколько дольше идёт синхронизация с включённым флагом?
Существенно дольше, потому что заданию приходится открывать и разбирать манифест каждого снимка в области действия, а не быстро отсекать совпавшие. На стенде агентства с 620 снимками обычный sync занимал 4–6 минут, а прогон с resync-corrupt — 1 час 50 минут. Постоянно держать флаг включённым на ежедневном задании я не советую.
Что делать с файлами .bad в каталоге .chunks?
Ничего руками. Их удаляет Garbage Collection, которая делает это согласованно с учётом ссылок из индексов. Ручное удаление в .chunks — хороший способ добавить себе повреждений сверх имеющихся. После успешного лечения просто запустите GC и получите место обратно.
Что делать, если повреждение обнаружилось и на источнике тоже?
Повторная передача тут не поможет — она исправляет резерв только при наличии исправных данных на источнике. Сначала запустите внеочередной бэкап, чтобы получить одну заведомо целую точку на сегодня: снимок, помеченный как failed, приводит к тому, что следующий бэкап зальёт chunks заново. Затем оцените ущерб по отдельным снимкам и восстанавливайте поштучно — отдельный диск ВМ или отдельные файлы из архива, — либо откатывайтесь на предыдущий верифицированный снимок.
С какой версии PBS есть resync-corrupt и как включить его из командной строки?
Опция появилась в Proxmox Backup Server 3.3 (ноябрь 2024) и есть во всех последующих ветках, включая 4.x. На существующем pull-задании она включается командой proxmox-backup-manager sync-job update <id> --resync-corrupt true, выключается тем же ключом со значением false. В веб-интерфейсе — чекбокс Re-sync corrupt snapshots в расширенных настройках sync-задания.
Не удалит ли remove-vanished повреждённые снимки вместо того, чтобы их вылечить?
remove-vanished удаляет на приёмнике только то, чего больше нет на источнике, — повреждение тут ни при чём. Если снимок на источнике жив, remove-vanished его не тронет, а resync-corrupt перекачает. Если на источнике снимок уже удалён prune, при включённом remove-vanished приёмник удалит свою битую копию, при выключенном — оставит её висеть в статусе failed. Для включения нужен Datastore.Prune на локальном датасторе.
Источники
- Proxmox Backup Server — Managing Remotes & Sync — Документация Proxmox Backup 4.2, раздел Sync Jobs: «Enabling the advanced option 'resync-corrupt' will re-sync all snapshots that have failed to verify during the last Verification», оговорка, что опция только для pull; remove-vanished (Datastore.Prune), verified-only и encrypted-only, worker-threads, направление push и его привилегии (Remote.Audit, Remote.DatastoreBackup, remote не старше 2.2), привилегии pull (Remote.Read, Datastore.Backup, Datastore.Prune, Datastore.Modify), синтаксис proxmox-backup-manager sync-job create/update/run. https://pbs.proxmox.com/docs/managing-remotes.html
- Proxmox Backup Server — Maintenance Tasks (Verification) — Документация Proxmox Backup 4.2, раздел Verification: параметры verify-job ignore-verified и outdated-after, read-threads и verify-threads (1–32, по умолчанию 1 и 4), рекомендация «It is recommended that you reverify all backups at least monthly, even if a previous verification was successful». https://pbs.proxmox.com/docs/maintenance.html
- Proxmox Forum — Proxmox Backup Server: a lot of verify failed — Ветка №165129: рекомендация сотрудника Proxmox настроить именно pull-задание, поскольку флаг resync-corrupt недоступен для push; совет ставить protected и верифицировать последний снимок каждой группы; указание проверять снимки на исходных системах; итоговая причина у автора темы — одновременная работа verify и GC плюс заполненный системный диск. https://forum.proxmox.com/threads/proxmox-backup-server-a-lot-of-verify-failed.165129/
- Исходный код proxmox-backup.git — src/server/pull.rs и src/backup/verify.rs — Логика resync-corrupt: снимок перекачивается при verify_state == VerifyState::Failed и при неудачной загрузке манифеста, лог-сообщение «re-sync snapshot ... due to corruption»; сохранение результата проверки в manifest.unprotected["verify_state"]; переименование повреждённого чанка через rename_corrupt_chunk с сообщением «corrupt chunk renamed to ...». https://git.proxmox.com/?p=proxmox-backup.git;a=blob_plain;f=src/server/pull.rs;hb=HEAD
- Proxmox Roadmap — Proxmox Backup Server — История релизов: PBS 3.3 (28.11.2024) — push-направление sync и опция повторной синхронизации повреждённых снимков для pull-заданий; PBS 3.4 (10.04.2025) — фильтры encrypted-only и verified-only; PBS 4.1 (26.11.2025) — настройка параллелизма verify (потоки чтения и проверки); PBS 4.2 (29.04.2026) — worker-threads для параллельной обработки групп в sync. https://pbs.proxmox.com/wiki/index.php/Roadmap
- Proxmox Backup Server — sync.cfg (формат конфигурации sync-заданий) — Справочник свойств sync-задания: resync-corrupt («If the verification failed for a local snapshot, try to pull it again»), sync-direction pull|push (по умолчанию pull), remove-vanished (по умолчанию false), verified-only, encrypted-only, worker-threads 1–32 (по умолчанию 1), transfer-last, group-filter. https://pbs.proxmox.com/docs/config/sync/man5.html
- Proxmox Backup Server — Backup Storage — Устройство датастора: каталог .chunks с 65 536 подкаталогами 0000–ffff, требования к файловой системе, фазы Garbage Collection. https://pbs.proxmox.com/docs/storage.html