
Как ограничить tempdb для тяжёлого отчёта в SQL Server 2025 — и почему процентный лимит молча не применяется
Один ночной отчёт съедает весь tempdb, инстанс встаёт целиком, и вместе с ним встают все базы 1С на сервере. В SQL Server 2025 наконец появился штатный способ это ограничить — лимит на tempdb для workload group. Но у него есть засада: команда применения конфигурации отрабатывает «успешно», а лимита при этом нет. Ниже — почему так, как проверить, что лимит реально действует, какой конфиг я ставлю в бою и что этот механизм не ловит в принципе.
«RECONFIGURE прошёл успешно» ничего не доказывает
Классический звонок в 9:10 утра: «У нас 1С не запускается, пишет какую-то ошибку про место». Лезу на сервер — tempdb раздут до размера тома, свободного места ноль, в ERRORLOG пачка ошибок 1105 про невозможность выделить страницу. Виновник — ночной отчёт по себестоимости, который отработал на объёме за квартал вместо месяца. Пострадали при этом все базы инстанса, а не только та, где считался отчёт. Потому что tempdb в SQL Server один на весь экземпляр, и это общая коммуналка.
В SQL Server 2025 (17.x) для этой боли есть штатный инструмент: Resource Governor умеет ограничивать объём данных в tempdb, который потребляет workload group. Два аргумента у CREATE/ALTER WORKLOAD GROUP — GROUP_MAX_TEMPDB_DATA_MB (жёсткая цифра в мегабайтах) и GROUP_MAX_TEMPDB_DATA_PERCENT (процент от максимального размера tempdb). Дальше человек делает ровно то, что написано в мануале: выставляет процент, выполняет ALTER RESOURCE GOVERNOR RECONFIGURE, видит «Commands completed successfully» — и на следующую ночь получает ровно тот же инцидент.
Разгадка в том, что RECONFIGURE честно сохраняет конфигурацию, но процентный лимит вступает в силу только при определённой конфигурации файлов данных tempdb. Если требования не выполнены, значение сохраняется в метаданных, а enforcement не включается. Вы при этом получаете предупреждение 10989 с severity 10: «GROUP_MAX_TEMPDB_DATA_PERCENT is not in effect because tempdb configuration requirements aren't met». Оно же пишется в error log.
Severity 10 — это информационное сообщение, а не ошибка. В SSMS оно улетает во вкладку Messages, где его никто не читает. Через .NET-клиент, sqlcmd или шаг SQL Agent Job оно вообще не поднимет исключение: скрипт отработает с кодом успеха, деплой в CI пройдёт зелёным, а лимита не будет. Именно поэтому проверять надо не текст ответа, а фактический эффективный лимит запросом.
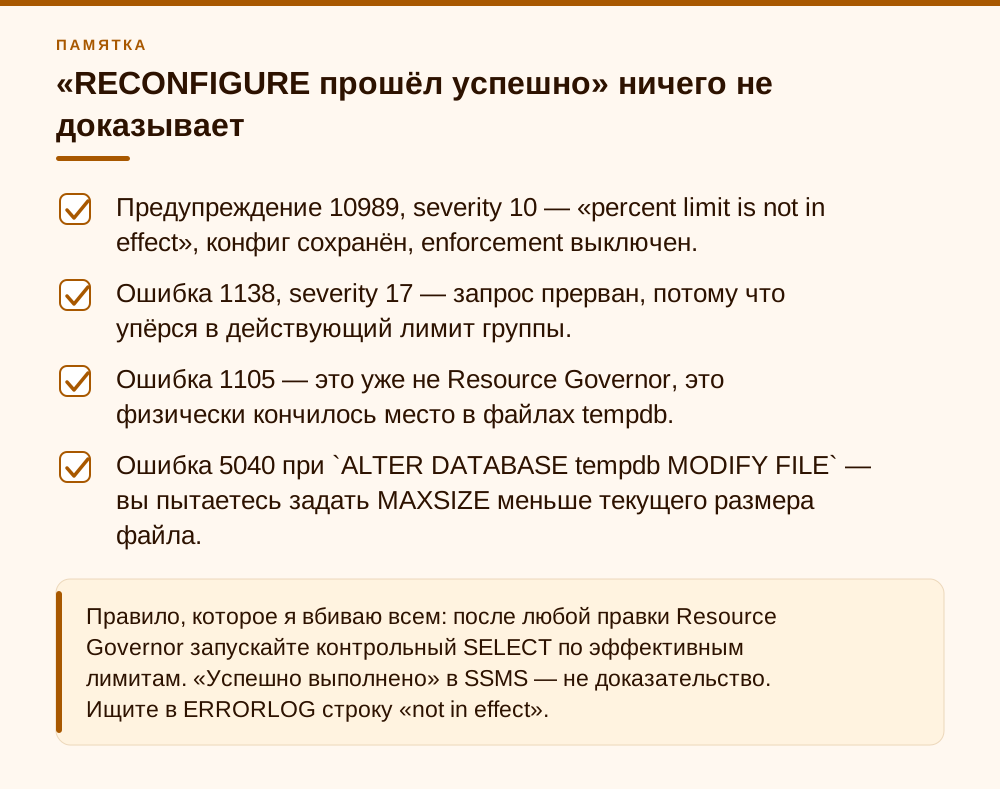
- Предупреждение 10989, severity 10 — «percent limit is not in effect», конфиг сохранён, enforcement выключен.
- Ошибка 1138, severity 17 — запрос прерван, потому что упёрся в действующий лимит группы.
- Ошибка 1105 — это уже не Resource Governor, это физически кончилось место в файлах tempdb.
- Ошибка 5040 при `ALTER DATABASE tempdb MODIFY FILE` — вы пытаетесь задать MAXSIZE меньше текущего размера файла.
Что SQL Server считает за «100 % tempdb»
Процент считается не от текущего размера файлов и не от размера тома, а от максимального размера tempdb. И вот определение этого максимума — самое неочевидное место всей фичи. Документация Microsoft описывает ровно две конфигурации, при которых процентный лимит вообще применяется, и одну строчку «все остальные конфигурации» — для них лимит не работает.
Первая рабочая конфигурация: у всех файлов данных MAXSIZE не равен UNLIMITED, и у всех файлов FILEGROWTH не равен нулю. Тогда 100 % — это сумма MAXSIZE по всем файлам данных. Файлы могут расти, но упрутся в потолок, и этот потолок берётся за базу. Вторая рабочая конфигурация: у всех файлов MAXSIZE равен UNLIMITED, а FILEGROWTH равен нулю. Это сценарий «файлы предрощены руками до нужного размера и расти не будут», и тогда 100 % — это сумма SIZE. Всё, что не попало в эти две строки, даёт вам предупреждение 10989.
А теперь главное. На свежей установке SQL Server у файлов tempdb MAXSIZE = UNLIMITED и FILEGROWTH больше нуля. То есть дефолтная конфигурация — это ровно «все остальные», и процентный лимит из коробки не работает никогда. Это не баг и не регрессия, это документированное поведение. Просто оно ломает интуицию: человек ставит 40 %, видит успех, и ему в голову не приходит, что фича выключена самой установкой по умолчанию.
Ловушка номер два — условие «для ВСЕХ файлов». Смешанные конфигурации не прощаются. Восемь файлов tempdb, у семи выставили MAXSIZE, а восьмой (тот, что добавляли позже, когда переезжали на новый том) забыли — процент не работает. Четыре файла предрощены с FILEGROWTH=0, а пятый оставили с автоприростом — процент не работает. Ловушка номер три: если процент уже действует, а вы добавили, удалили или изменили размер файла tempdb, надо снова выполнить ALTER RESOURCE GOVERNOR RECONFIGURE, иначе Resource Governor продолжит считать проценты от старого максимума.
Вот два запроса, которые я держу в снипетах. Первый показывает фактическую конфигурацию файлов tempdb, второй — эффективный лимит по каждой группе в мегабайтах. Если во втором запросе group_effective_limit_mb вернулся NULL — значит либо лимитов нет вообще, либо требования для процента не выполнены. Третьего не дано.
-- 1. Конфигурация файлов данных tempdb
SELECT file_id,
       name,
       size * 8. / 1024 AS size_mb,
       IIF (max_size = -1, NULL, max_size * 8. / 1024) AS maxsize_mb,
       IIF (is_percent_growth = 0, growth * 8. / 1024, NULL) AS filegrowth_mb,
       IIF (is_percent_growth = 1, growth, NULL) AS filegrowth_percent
FROM sys.master_files
WHERE database_id = 2
      AND type_desc = 'ROWS';
-- maxsize_mb IS NULL  => MAXSIZE UNLIMITED
-- filegrowth_mb = 0   => FILEGROWTH ноль
-- 2. Эффективный лимит tempdb по каждой workload group
SELECT wg.group_id,
wg.name,
tf.tempdb_max_size_mb,
CASE
WHEN wg.group_max_tempdb_data_mb IS NOT NULL
THEN wg.group_max_tempdb_data_mb
WHEN wg.group_max_tempdb_data_percent IS NOT NULL AND tf.tempdb_max_size_mb IS NOT NULL
THEN 0.01 * wg.group_max_tempdb_data_percent * tf.tempdb_max_size_mb
ELSE NULL END AS group_effective_limit_mb
FROM sys.resource_governor_workload_groups AS wg
CROSS APPLY (
SELECT IIF (SUM(IIF (max_size <> -1 AND growth > 0, 1, 0)) = COUNT(1)
OR SUM(IIF (max_size = -1 AND growth = 0, 1, 0)) = COUNT(1),
SUM(IIF (growth = 0, size, max_size)) * 8 / 1024., NULL) AS tempdb_max_size_mb
FROM sys.master_files
WHERE database_id = 2 AND type_desc = 'ROWS'
) AS tf;- 100 % при `MAXSIZE` ограничен и `FILEGROWTH` больше нуля у всех файлов данных — сумма MAXSIZE.
- 100 % при `MAXSIZE = UNLIMITED` и `FILEGROWTH = 0` у всех файлов данных — сумма SIZE.
- Дефолт после установки (UNLIMITED плюс автоприрост) процент не поддерживает — предупреждение 10989.
- Хотя бы один файл выбивается из правила — процент не работает для всего tempdb.
- Добавили, удалили или изменили размер файла — снова `ALTER RESOURCE GOVERNOR RECONFIGURE`.
- Задан `GROUP_MAX_TEMPDB_DATA_MB` у той же группы — процент игнорируется.
Мой рабочий рецепт: мегабайты, а не проценты
Позиция у меня простая: в проде я ставлю GROUP_MAX_TEMPDB_DATA_MB. Не потому, что проценты плохие, а потому что фиксированный лимит не зависит от конфигурации файлов tempdb, работает сразу после RECONFIGURE, читается человеком без калькулятора и не отваливается, когда коллега добавит девятый файл tempdb на новый диск. За три года эксплуатации любой сервер обрастает изменениями, и механизм, который молча выключается от изменения FILEGROWTH одного файла — это мина.
Где проценты объективно лучше — я тоже скажу честно. Если вы живёте в облаке и регулярно масштабируете виртуалку вместе с tempdb, процент избавляет от ручного пересчёта: увеличили максимальный размер tempdb, доли групп поехали пропорционально сами. Для типового офисного сервера 1С в стойке, где tempdb не меняется годами, это чистая экзотика, ради которой не стоит связываться с требованиями к MAXSIZE и FILEGROWTH.
Базовый конфиг выглядит так. Создаём пул и две группы — под отчёты и под ETL, вешаем лимиты, пишем классификатор, включаем. Классификатор — обычная скалярная функция в master с SCHEMABINDING, которая по контексту соединения возвращает имя группы.
-- Пул и группа под отчёты
CREATE RESOURCE POOL rpt_pool WITH (MAX_CPU_PERCENT = 40);
GO

CREATE WORKLOAD GROUP wg_reports
WITH (
     GROUP_MAX_TEMPDB_DATA_MB = 61440,   -- 60 ГБ
     REQUEST_MAX_MEMORY_GRANT_PERCENT = 20,
     MAX_DOP = 4
     )
USING rpt_pool;
GO

CREATE WORKLOAD GROUP wg_etl
WITH (GROUP_MAX_TEMPDB_DATA_MB = 40960)   -- 40 ГБ
USING rpt_pool;
GO

USE master;
GO
CREATE FUNCTION dbo.rg_classifier()
RETURNS sysname
WITH SCHEMABINDING
AS
BEGIN
    DECLARE @g sysname = N'default';

    IF SUSER_SNAME() IN (N'bi_reader', N'rpt_runner')
        SET @g = N'wg_reports';

    IF SUSER_SNAME() = N'etl_loader'
        SET @g = N'wg_etl';

    RETURN @g;
END;
GO

ALTER RESOURCE GOVERNOR WITH (CLASSIFIER_FUNCTION = dbo.rg_classifier);
ALTER RESOURCE GOVERNOR RECONFIGURE;
Два предостережения по значениям. Первое: не вешайте лимит на группу default, пока у вас нет классификатора и выделенных групп. Если ограничить default, ошибку 1138 начнут ловить совершенно посторонние задачи — вплоть до того, что не откроется Object Explorer в SSMS. Второе: значение 0 означает «выделение места в tempdb запрещено вовсе», а не «без ограничений». «Без ограничений» — это NULL. Перепутать 0 и NULL в скрипте деплоя очень легко, а последствия у этих значений противоположные.
И третье, приятное: сумма лимитов по всем группам спокойно может превышать размер tempdb. Это не ошибка конфигурации, а рекомендованный приём. При tempdb на 192 ГБ можно дать группе отчётов 60 ГБ, а ETL — 40 ГБ, и никто не мешает дать обеим по 100 ГБ, если они заведомо не работают одновременно. Смысл лимита не в бухгалтерии свободного места, а в том, чтобы один запрос не съел всё.
- Ставьте лимиты только на пользовательские группы, `default` держите без ограничений.
- NULL — снять ограничение, 0 — запретить tempdb полностью. Это разные вещи.
- Значения дробные допустимы: `GROUP_MAX_TEMPDB_DATA_MB = 1536.5` пройдёт.
- Оверкоммит суммы лимитов — нормальная практика, если группы не пересекаются по времени.
- Классификатор выполняется на каждом логине: держите его коротким, без обращений к пользовательским таблицам.
Разбор из практики: сеть пекарен «Хлебный угол», 42 рабочих места
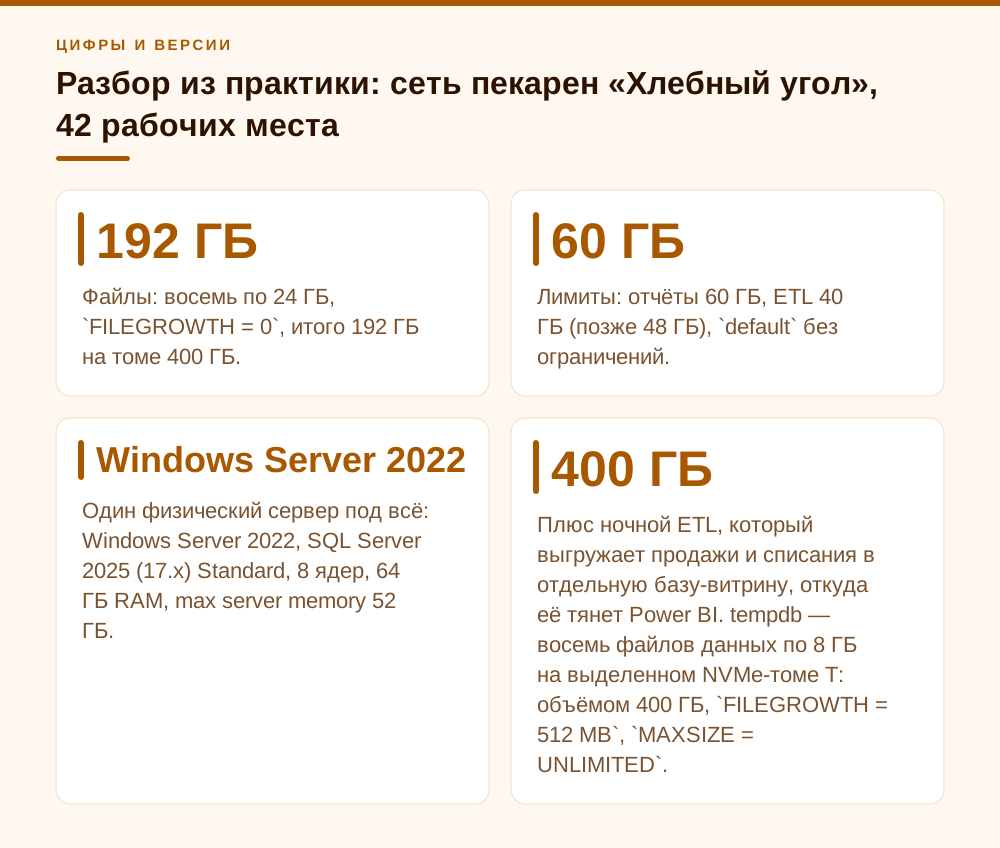
Сеть пекарен «Хлебный угол»: собственный цех и торговые точки, 42 рабочих места — офис, технологи, склад и кассовые места на точках. Один физический сервер под всё: Windows Server 2022, SQL Server 2025 (17.x) Standard, 8 ядер, 64 ГБ RAM, max server memory 52 ГБ. Три базы 1С на инстансе — бухгалтерия, зарплата и производственный учёт с рецептурами и выпуском по точкам. Плюс ночной ETL, который выгружает продажи и списания в отдельную базу-витрину, откуда её тянет Power BI. tempdb — восемь файлов данных по 8 ГБ на выделенном NVMe-томе T: объёмом 400 ГБ, FILEGROWTH = 512 MB, MAXSIZE = UNLIMITED. То есть ровно дефолт, только файлов побольше.
За шесть недель — четыре инцидента, все в интервале 03:20–04:10. Сценарий одинаковый: ETL стартует в 03:00, а в 03:30 отрабатывает регламентный отчёт по плановой и фактической себестоимости выпуска по рецептурам с отбором за квартал. Оба льют в tempdb, том 400 ГБ заканчивается, дальше 1105 и мёртвый инстанс до утра. Ребут лечит, но к утру половина ночных заданий не отработала, и в 9:00 технологи и управляющие точками видят вчерашние остатки и не могут нормально спланировать утреннюю выпечку.
Первая попытка была ровно той, из-за которой я и пишу эту статью. Админ клиента выставил GROUP_MAX_TEMPDB_DATA_PERCENT = 40 на группу отчётов, выполнил RECONFIGURE, получил успех и закрыл задачу. Через двое суток — пятый инцидент. Нашлось это за две минуты: в ERRORLOG по строке «not in effect» лежало предупреждение 10989, а контрольный запрос эффективных лимитов вернул group_effective_limit_mb = NULL. Файлы tempdb были в дефолтной конфигурации, а она процент не поддерживает.
Что сделали дальше. Предрастили восемь файлов до 24 ГБ каждый — итого 192 ГБ tempdb на томе в 400 ГБ, с запасом под лог tempdb и под то, что на том иногда падают дампы. FILEGROWTH выставили в ноль: файлы предрощены, расти им незачем, заодно уходит риск получить autogrow посреди тяжёлого запроса. Формально после этого процентные лимиты заработали бы, но я всё равно перевёл конфиг на мегабайты — по причинам из предыдущего раздела.
-- Предрост файлов tempdb (выполнялось в окно обслуживания)
ALTER DATABASE tempdb MODIFY FILE (NAME = N'tempdev', SIZE = 24576 MB, FILEGROWTH = 0);
ALTER DATABASE tempdb MODIFY FILE (NAME = N'temp2',   SIZE = 24576 MB, FILEGROWTH = 0);
-- ... и так далее до temp8

-- Лимиты
ALTER WORKLOAD GROUP wg_reports WITH (GROUP_MAX_TEMPDB_DATA_MB = 61440); -- 60 ГБ
ALTER WORKLOAD GROUP wg_etl     WITH (GROUP_MAX_TEMPDB_DATA_MB = 40960); -- 40 ГБ
ALTER WORKLOAD GROUP [default]  WITH (GROUP_MAX_TEMPDB_DATA_MB = NULL,
                                      GROUP_MAX_TEMPDB_DATA_PERCENT = NULL);
ALTER RESOURCE GOVERNOR RECONFIGURE;
Отдельно — честная проблема, которую я решить красиво не смог. Все соединения сервера 1С приходят в SQL под одним логином, который прописан в параметрах информационной базы в кластере, поэтому развести «обычную работу пользователей» и «тяжёлый регламентный отчёт» классификатором по APP_NAME() или SUSER_SNAME() не получается: фоновое задание 1С ходит в SQL под тем же логином, что и пользователи. Обошли организационно — квартальный отчёт по себестоимости перенесли на ночную копию базы производственного учёта, которую восстанавливаем из бэкапа на тот же инстанс; в кластере 1С она зарегистрирована с отдельным SQL-логином rpt_runner. ETL и Power BI и так работали под своими логинами. Пользовательская нагрузка 1С осталась в default без лимита. Это компромисс: если тяжёлый отчёт запустит руками пользователь в рабочей базе, он по-прежнему пойдёт мимо лимита. Универсального решения тут нет, и обещать его я не буду.
Итог за девять недель наблюдения: инцидентов с остановкой инстанса — ноль. Ошибка 1138 сработала дважды, оба раза на ETL в 03:0x, ретрай задания отработал на уменьшенном батче. Пиковое потребление по peak_tempdb_data_space_kb для wg_reports — 41 ГБ при лимите 60 ГБ, для wg_etl — 38 ГБ при лимите 40 ГБ (лимит ETL я потом поднял до 48 ГБ, было слишком впритык). Суммарно на всё про всё ушло одно окно обслуживания на 40 минут и полдня на настройку мониторинга.
- Симптом: четыре ночных остановки инстанса за шесть недель, в ERRORLOG ошибки 1105, tempdb размером с том.
- Первая попытка: `GROUP_MAX_TEMPDB_DATA_PERCENT = 40` при дефолтных файлах — предупреждение 10989, `group_effective_limit_mb = NULL`.
- Файлы: восемь по 24 ГБ, `FILEGROWTH = 0`, итого 192 ГБ на томе 400 ГБ.
- Лимиты: отчёты 60 ГБ, ETL 40 ГБ (позже 48 ГБ), `default` без ограничений.
- Классификация: отдельные логины для копии базы под отчёты, ETL и Power BI — рабочие базы 1С не трогали.
- Результат за девять недель: ноль остановок инстанса, две ошибки 1138 на ETL с успешным ретраем.
Чего этот лимит не ловит в принципе
Механизм узкий, и это надо понимать до того, как вы отчитаетесь клиенту «tempdb теперь под контролем». Он считает страницы данных в файлах данных tempdb, привязанные к workload group. Всё остальное — мимо.
Первое и самое важное: version store не губернируется. Включая persistent version store (PVS), если у tempdb включён Accelerated Database Recovery. Логика Microsoft понятна — версии строк могут читаться запросами из разных групп, и приписать их одной группе некорректно. Практическое следствие: если у вас включён RCSI или snapshot-изоляция и завелась долгая открытая транзакция, tempdb вырастет мимо всех ваших лимитов. Никакой Resource Governor вас тут не спасёт, спасёт только контроль долгих транзакций.
Второе: журнал транзакций tempdb тоже не под лимитом — губернируется только пространство файлов данных. Штатная рекомендация Microsoft на этот случай — включить ADR в самой tempdb, тогда лог не будет разрастаться. В SQL Server 2025 ADR доступен и в Standard, так что вариант рабочий для малого бизнеса.
Третье: лимит контролирует место в файлах, а не на томе. Если файлы не предрощены и на диск с tempdb кто-то положил дамп или бэкап, tempdb может упереться в физическое отсутствие места задолго до срабатывания лимита группы. Отсюда моя настойчивость с предростом файлов и правило «сумма MAXSIZE файлов на томе не больше свободного места тома».
Четвёртое, мелкое, но регулярно ломающее расчёты: учёт идёт по 8-килобайтным страницам. Даже наполовину пустая страница добавляет группе 8 КБ. И глобальные временные таблицы (##t), а также обычные постоянные таблицы, созданные прямо в tempdb, записываются на ту группу, которая вставила в них первую строку — даже если потом с ними работают сессии других групп. Если такую группу удалить, а объекты в tempdb останутся, их место не переедет ни к кому: оно просто перестанет учитываться.
- Не ограничивается: version store и PVS при ADR в tempdb.
- Не ограничивается: журнал транзакций tempdb (лечится включением ADR в tempdb).
- Не ограничивается: свободное место на самом томе.
- Учёт округляется до страницы 8 КБ.
- Глобальные и постоянные таблицы в tempdb приписываются группе, вставившей первую строку.
Мониторинг: как выбрать цифру и не выстрелить себе в ногу
Ставить лимит «на глазок» — верный способ получить отказы при свободном tempdb. Правильный порядок другой: сначала создаём группы и классификатор без всяких лимитов, две-четыре недели собираем статистику, и только потом ставим цифры. Хорошая новость: счётчики tempdb_data_space_kb и peak_tempdb_data_space_kb в sys.dm_resource_governor_workload_groups ведутся всегда, даже когда никаких лимитов не задано.
Я вешаю простую джобу раз в минуту, которая складывает срез в служебную таблицу — этого достаточно, чтобы через месяц увидеть реальный профиль. Формула, по которой я выбираю значение: пик за период наблюдения умножить на 1,5, но не больше чем размер tempdb минус 20 % резерва. Если пик умноженный на 1,5 уже больше половины tempdb — значит проблема не в лимите, а в самом запросе, и надо чинить запрос.
-- Срез потребления tempdb по группам
SELECT SYSUTCDATETIME() AS ts,
       group_id,
       name,
       tempdb_data_space_kb / 1024. AS tempdb_mb,
       peak_tempdb_data_space_kb / 1024. AS peak_tempdb_mb,
       total_tempdb_data_limit_violation_count AS violations
FROM sys.dm_resource_governor_workload_groups
ORDER BY peak_tempdb_data_space_kb DESC;
Для реакции на срабатывания есть расширенное событие tempdb_data_workload_group_limit_reached — оно возникает ровно тогда, когда запрос прерывается ошибкой 1138. Параллельно инкрементится total_tempdb_data_limit_violation_count. Я обычно поднимаю лёгкую XE-сессию на диск и раз в сутки проверяю дельту счётчика: если она растёт, лимит либо занижен, либо появился новый тяжёлый запрос, о котором никто не предупредил.
CREATE EVENT SESSION rg_tempdb_watch ON SERVER
ADD EVENT sqlserver.tempdb_data_workload_group_limit_reached
    (ACTION (sqlserver.sql_text,
             sqlserver.username,
             sqlserver.client_app_name,
             sqlserver.session_id))
ADD TARGET package0.event_file
    (SET filename = N'rg_tempdb_watch.xel', max_file_size = 64, max_rollover_files = 4)
WITH (STARTUP_STATE = ON, MAX_DISPATCH_LATENCY = 15 SECONDS);
GO
ALTER EVENT SESSION rg_tempdb_watch ON SERVER STATE = START;
И важный нюанс интерпретации: не пытайтесь сверять эти цифры с sys.dm_db_session_space_usage — они не сойдутся, и это нормально. Сессионное представление обновляется по завершении задачи и не показывает текущие работающие, не учитывает IAM-страницы, а данные по закрытым сессиям из него уходят. Представление Resource Governor обновляется непрерывно и отражает освобождение страниц по факту, включая асинхронную фоновую деаллокацию. Я видел, как люди сутки ловят «расхождение», которого нет.
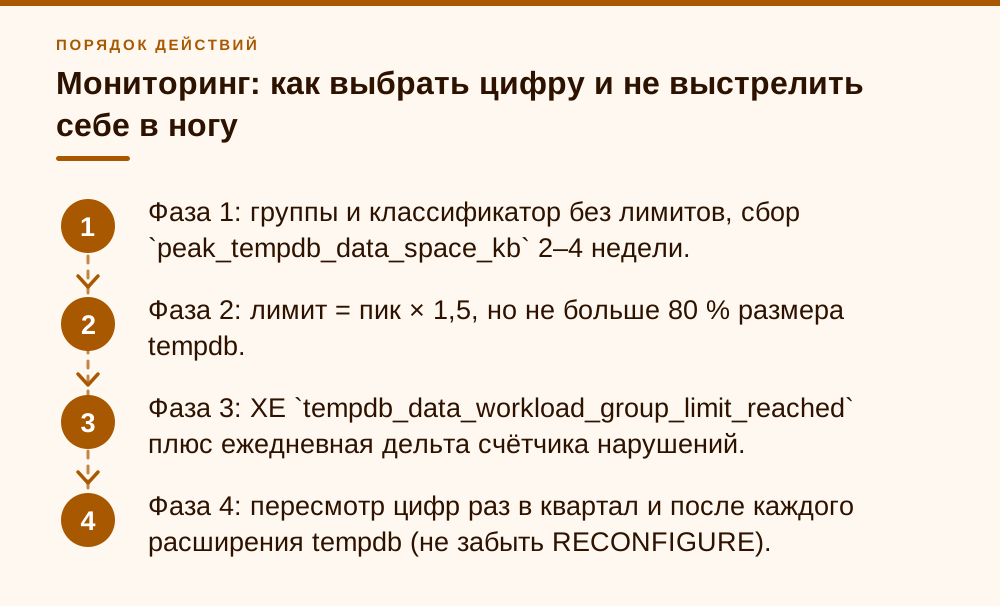
- Фаза 1: группы и классификатор без лимитов, сбор `peak_tempdb_data_space_kb` 2–4 недели.
- Фаза 2: лимит = пик × 1,5, но не больше 80 % размера tempdb.
- Фаза 3: XE `tempdb_data_workload_group_limit_reached` плюс ежедневная дельта счётчика нарушений.
- Фаза 4: пересмотр цифр раз в квартал и после каждого расширения tempdb (не забыть RECONFIGURE).
Редакции, приоритеты и на что можно забить
Главная новость 2025 года для малого бизнеса — не сам tempdb-лимит, а то, что Resource Governor уехал в Standard. В SQL Server 2022 и раньше в таблице редакций в строке «Resource governor» стояло Yes только у Enterprise, у Standard — No. В таблице редакций SQL Server 2025 в строке «Resource governor» у Standard стоит Yes, и отдельной строкой идёт «Tempdb space resource governance»: Enterprise — Yes, Standard — Yes, Express — No. То есть механизм, ради которого раньше надо было покупать Enterprise, теперь доступен на той лицензии, которая у типового клиента с 1С уже стоит.
Заодно у Standard в 2025 подняли потолки: максимум памяти под буферный пул 256 ГБ вместо прежних 128 ГБ, и вычислительная мощность ограничена меньшим из 4 сокетов или 32 ядер вместо 24. Для сервера на 50 рабочих мест это означает, что апгрейд на Enterprise ради «ну там же больше можно» стал ещё менее оправданным.
Мои приоритеты, если у вас прямо сейчас горит tempdb. Первое и самое дешёвое — вынести tempdb на отдельный том и предрастить файлы до разумного размера с FILEGROWTH = 0. Это снимает половину проблем без всякого Resource Governor: autogrow посреди тяжёлого запроса перестаёт быть событием, и на том с tempdb больше ничего не претендует. Второе — включить Resource Governor, завести группу под известного нарушителя и поставить ему GROUP_MAX_TEMPDB_DATA_MB. Третье — мониторинг пиков и XE. Четвёртое, если пухнет лог tempdb — ADR в tempdb.
На что можно спокойно забить. На процентные лимиты, если вы не в облаке и не масштабируете сервер раз в квартал — они дают ровно ту же защиту, но с тремя дополнительными способами молча сломаться. На тонкую настройку CPU- и memory-лимитов в пулах, пока никто не жаловался на конкуренцию за процессор: tempdb и CPU — разные болезни, и лечить их одновременно означает не понять, что именно помогло. И на попытки развести классификатором соединения внутри одной базы 1С — как я писал выше, средствами SQL это не решается, тут работают только организационные меры.
И последнее, спорное, скажу прямо. Лимит tempdb — это предохранитель, а не лечение. Он превращает «лёг весь сервер и три базы до утра» в «упал один отчёт с внятной ошибкой 1138». Это огромная разница для бизнеса, но сам запрос от этого лучше не станет. Если у вас регулярно срабатывает 1138 — идите смотреть план запроса, спиллы в tempdb и статистику, а не поднимайте лимит по кругу. Я видел сервер, где лимит подняли трижды и в итоге вернулись ровно к исходной ситуации, только с лишней сущностью в конфигурации.
- SQL Server 2022 и раньше: Resource Governor — только Enterprise.
- SQL Server 2025: Resource Governor и tempdb space resource governance — Enterprise и Standard; Express — нет.
- Standard 2025: буферный пул до 256 ГБ, до 4 сокетов / 32 ядер.
- Порядок работ: том и предрост tempdb → лимит в МБ на нарушителя → мониторинг → ADR в tempdb при росте лога.
Частые вопросы
Почему RECONFIGURE завершился успешно, а лимит tempdb не действует?
Скорее всего вы задали процентный лимит, а конфигурация файлов данных tempdb не соответствует требованиям. Значение сохраняется, но enforcement не включается, а вы получаете предупреждение 10989 с severity 10 — это информационное сообщение, которое не вызывает ошибку у клиента. Проверьте ERRORLOG по строке «not in effect» и выполните контрольный запрос эффективных лимитов: если group_effective_limit_mb вернулся NULL, лимита нет. Второй частый случай — у той же группы остался заданным GROUP_MAX_TEMPDB_DATA_MB, а он имеет приоритет над процентом.
Какая конфигурация файлов tempdb нужна, чтобы процентный лимит заработал?
Работают ровно два варианта. Первый: у всех файлов данных MAXSIZE не UNLIMITED и FILEGROWTH не ноль — тогда 100 % это сумма MAXSIZE. Второй: у всех файлов MAXSIZE = UNLIMITED и FILEGROWTH = 0, то есть файлы предрощены и не растут — тогда 100 % это сумма SIZE. Любая смешанная конфигурация, включая дефолтную после установки (UNLIMITED плюс автоприрост), процент не поддерживает. После изменения состава или размеров файлов tempdb нужно снова выполнить ALTER RESOURCE GOVERNOR RECONFIGURE.
Что означает ошибка 1138 и что делать пользователю, который её поймал?
Ошибка 1138, severity 17 — запрос прерван, потому что его workload group упёрлась в заданный лимит потребления tempdb. Текст: «Could not allocate a new page for database 'tempdb' because that would exceed the limit set for workload group». Это штатное срабатывание предохранителя, а не поломка. Правильная реакция — посмотреть, почему запрос требует столько tempdb: спиллы сортировок и хэшей, отсутствие подходящих индексов, слишком широкий период отбора. Поднимать лимит стоит только если запрос действительно легитимно тяжёлый.
Нужна ли редакция Enterprise, чтобы ограничивать tempdb?
Нет, начиная с SQL Server 2025 (17.x) — не нужна. В таблице редакций 2025 года Resource Governor и tempdb space resource governance доступны и в Enterprise, и в Standard; недоступны только в Express. В SQL Server 2022 и более ранних версиях Resource Governor был исключительно enterprise-функцией, а самих tempdb-лимитов не существовало вовсе. Для сервера 1С на Standard это означает, что механизм доступен без доплаты за лицензию.
Защитит ли лимит от роста tempdb из-за version store и RCSI?
Нет. Потребление tempdb version store, включая persistent version store при включённом ADR в tempdb, этим механизмом не ограничивается — версии строк могут использоваться запросами из разных workload group. Журнал транзакций tempdb тоже не губернируется, для него отдельная мера — включить ADR в tempdb. Если tempdb растёт, а потребление групп в sys.dm_resource_governor_workload_groups маленькое, ищите долгую открытую транзакцию, а не крутите лимиты.
Можно ли поставить лимит на группу default?
Технически да, но я не советую, пока у вас нет классификатора и выделенных групп под конкретные нагрузки. Через default проходит вся неклассифицированная активность, включая служебную: при заниженном лимите ошибку 1138 начнут получать посторонние операции, вплоть до невозможности открыть Object Explorer в SSMS. И помните, что 0 означает полный запрет выделения места в tempdb, а «без ограничений» — это NULL.
Источники
- Microsoft Learn — Tempdb space resource governance — Раздел «Percent limit configuration» (таблица условий применения процентного лимита), «How it works» (ошибка 1138 severity 17, предупреждение 10989 severity 10, счётчик total_tempdb_data_limit_violation_count, событие tempdb_data_workload_group_limit_reached, исключение version store и PVS), SQL Server 2025 (17.x). https://learn.microsoft.com/en-us/sql/relational-databases/resource-governor/tempdb-space-resource-governance?view=sql-server-ver17
- Microsoft Learn — CREATE WORKLOAD GROUP (Transact-SQL) — Аргументы GROUP_MAX_TEMPDB_DATA_MB и GROUP_MAX_TEMPDB_DATA_PERCENT: допустимые значения (0, положительное число или NULL; для процента 0–100), приоритет фиксированного лимита, полный синтаксис для SQL Server 2025 (ver17). https://learn.microsoft.com/en-us/sql/t-sql/statements/create-workload-group-transact-sql?view=sql-server-ver17
- Microsoft Learn — Tutorial: Examples to configure tempdb space resource governance — Пошаговые примеры: ALTER WORKLOAD GROUP с фиксированным и процентным лимитом, ALTER DATABASE tempdb MODIFY FILE (SIZE/FILEGROWTH/MAXSIZE), классификатор dbo.rg_classifier, воспроизведение ошибки 1138 и 5040. https://learn.microsoft.com/en-us/sql/relational-databases/resource-governor/tempdb-space-resource-governance-walkthrough?view=sql-server-ver17
- Microsoft Learn — Editions and supported features of SQL Server 2025 / SQL Server 2022 — Таблицы «Scalability and performance»: в 2025 строки «Resource governor» и «Tempdb space resource governance» — Yes для Enterprise и Standard, No для Express; в 2022 «Resource governor» — Yes только для Enterprise. Плюс «Scale limits» (Standard: 256 ГБ буферный пул, 4 сокета / 32 ядра). https://learn.microsoft.com/en-us/sql/sql-server/editions-and-components-of-sql-server-2025?view=sql-server-ver17
- Redgate Simple Talk — TempDB Resource Governor Space Controls in SQL Server 2025: A Complete Guide — Статья Edward Pollack (июнь 2025, обновлена в сентябре 2025): практический разбор обеих настроек, воспроизведение сообщения «GROUP_MAX_TEMPDB_DATA_PERCENT is not in effect», поведение SELECT INTO после ошибки 1138 (пустая таблица остаётся). https://www.red-gate.com/simple-talk/databases/sql-server/tempdb-resource-governor-space-controls-in-sql-server-2025/