
Veeam 13 копирует бэкапы на вторую площадку, а SQL-журналов там нет: почему Periodic copy убивает короткий RPO
Ситуация, которую я разбирал у клиентов уже раз шесть: на основной площадке SQL-журналы снимаются каждые 15 минут, на резервной стоит аккуратная копия всех виртуалок, отчёты зелёные — а при тестовом восстановлении выясняется, что откатиться можно только на вчерашние 23:40. Ни одной транзакции после этого момента на второй площадке нет. Разбираю, чем Periodic copy отличается от Immediate, почему журналы не едут именно в периодическом режиме, как это чинится без пересоздания цепочки с нуля и что проверить прямо сегодня, чтобы не узнать об этом в день аварии.
Копия ВМ — это не копия задания. Разница стоит рабочего дня
Самая распространённая ошибка в проектировании второй площадки звучит так: «У нас настроен Backup Copy, значит, на резервной площадке лежит то же самое, что и на основной». Не лежит. Backup Copy job переносит точки восстановления — файлы .vbk и .vib. Резервные копии журналов транзакций Microsoft SQL Server живут отдельно, в файлах формата .vlb, и попадают на вторую площадку только если вы явно попросили об этом. А попросить можно не всегда: такая возможность есть ровно в одном режиме работы задания.
В Veeam Backup & Replication 13 у задания копирования два режима — immediate copy и periodic copy. В документации это сформулировано максимально прямо: в immediate-режиме продукт копирует точки восстановления сразу, как только они появляются в исходном репозитории, и «может также копировать резервные копии журналов транзакций, если вы включите эту возможность в настройках задания». В periodic-режиме копируется последняя исходная точка восстановления по расписанию задания копирования — и всё. Про журналы в описании периодического режима нет ни слова, потому что он их не умеет обрабатывать в принципе.
Практическое следствие простое и неприятное. Если у вас на основной площадке SQL-бэкап с интервалом журналов 15 минут (это дефолт Veeam), то заявленный RPO у вас 15 минут. Но если Backup Copy работает в Periodic с расписанием раз в сутки, то реальный RPO второй площадки — 24 часа плюс время копирования. И вы об этом не узнаете, пока не потеряете основную площадку целиком или пока не проведёте честное тестовое восстановление с переключением на резерв. Первый вариант дороже.
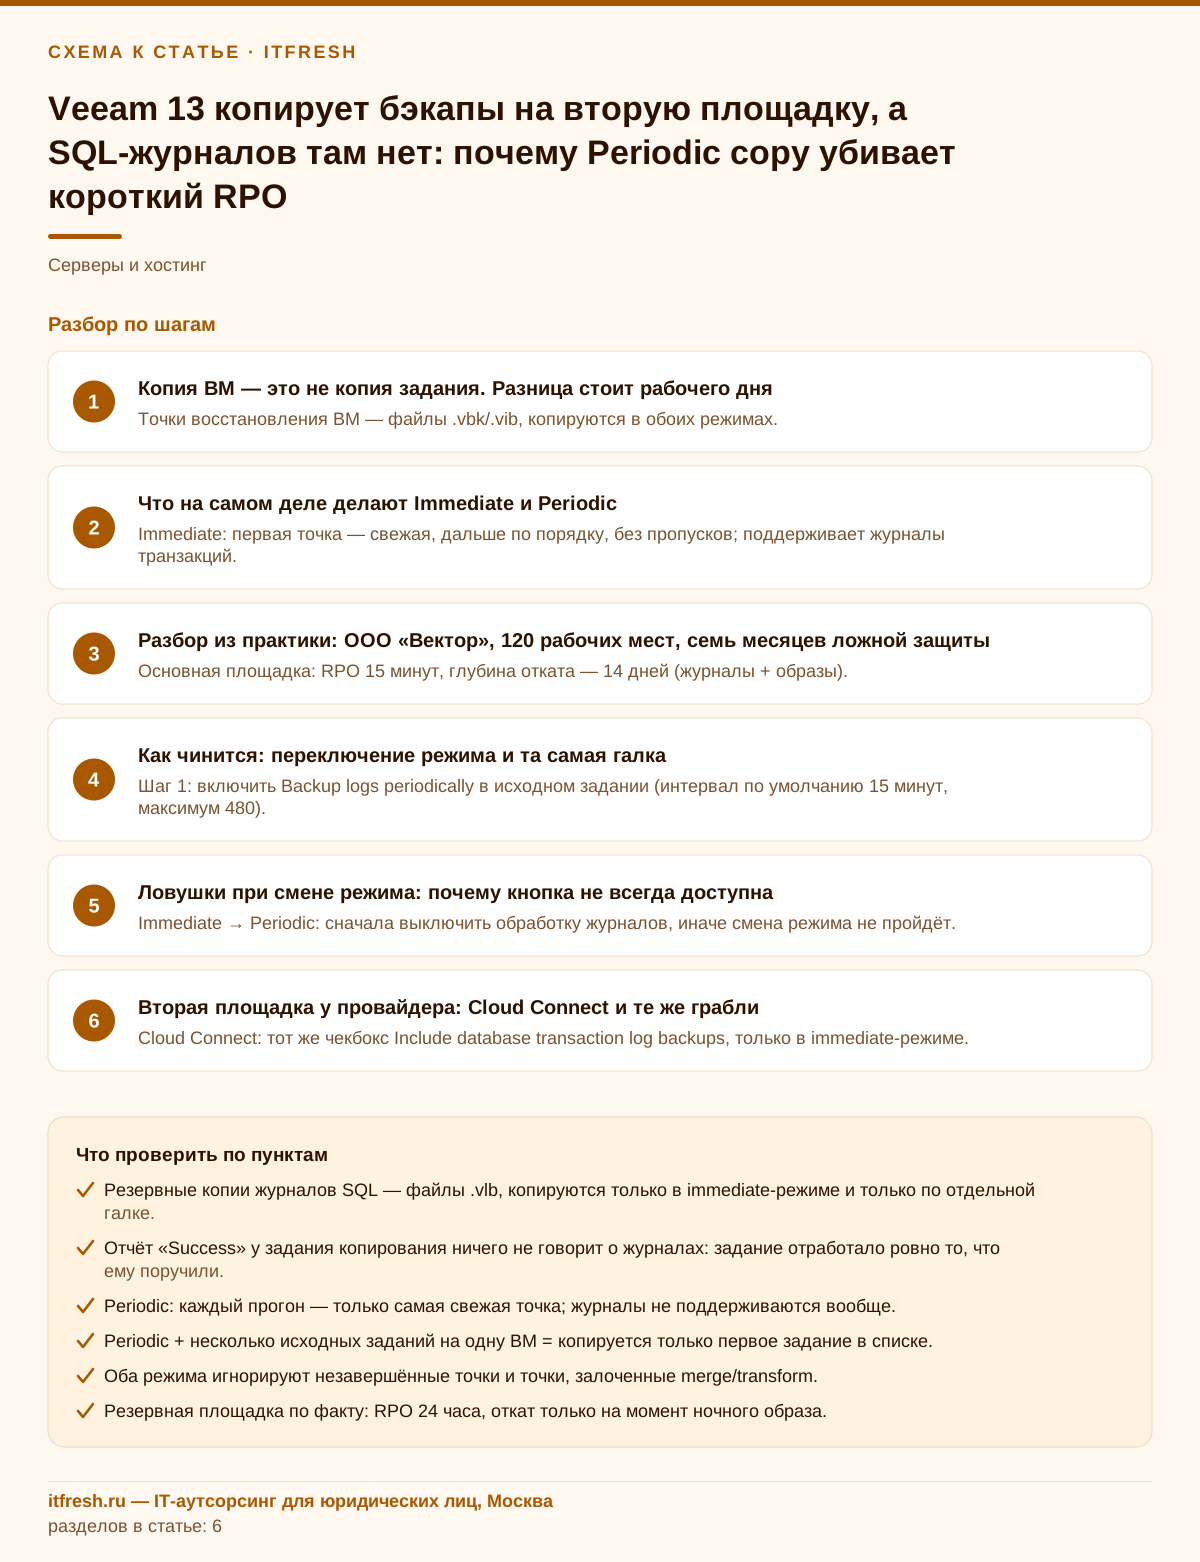
- Точки восстановления ВМ — файлы .vbk/.vib, копируются в обоих режимах.
- Резервные копии журналов SQL — файлы .vlb, копируются только в immediate-режиме и только по отдельной галке.
- Отчёт «Success» у задания копирования ничего не говорит о журналах: задание отработало ровно то, что ему поручили.
Что на самом деле делают Immediate и Periodic
Разница между режимами глубже, чем «сразу против по расписанию». Она в логике выбора точек. В immediate-режиме на первом прогоне задание копирует самую свежую завершённую точку, созданную исходным заданием, а на последующих прогонах — самые старые из тех, что появились после первой скопированной, и так пока непереданных точек не останется. То есть цепочка на второй площадке повторяет исходную: точка за точкой, ничего не пропускается. В periodic-режиме на каждом прогоне копируется просто самая свежая завершённая точка на текущий момент. Всё, что образовалось между прогонами, на вторую площадку не попадёт никогда.
Отсюда и невозможность журналов в Periodic. Резервная копия журнала транзакций сама по себе бесполезна: replay журналов выполняется поверх конкретной точки восстановления образа, и цепочка .vlb должна непрерывно продолжать ту точку, от которой начинается восстановление. Periodic по определению пропускает промежуточные точки, поэтому непрерывной цепочки «образ → журналы → следующий образ» на целевой площадке не получается. Veeam не объясняет механику в документации подробно, но итог зафиксирован однозначно: в блоке IMPORTANT руководства сказано, что periodic copy mode не поддерживает обработку transaction log backups. Это не баг и не лицензия — сочетание просто не предусмотрено.
Ещё одна деталь периодического режима, о которую спотыкаются: если одну и ту же ВМ обрабатывают несколько исходных заданий, в Periodic копируются только точки, созданные первым заданием в списке Objects to process. В Immediate такого ограничения нет. На стендах, где виртуалка попала в два задания (например, ежедневное и отдельное «перед обновлением 1С»), это даёт ещё один слой сюрпризов.
И общие ограничения, которые работают в обоих режимах и портят статистику: не копируются незавершённые точки, точки из импортированных бэкапов, точки, заблокированные процессом слияния (merge/transform), и точки с изменившимся размером блока — последнее даёт в логе характерное «Restore point is located in backup file with different block size» и лечится созданием active full.
- Immediate: первая точка — свежая, дальше по порядку, без пропусков; поддерживает журналы транзакций.
- Periodic: каждый прогон — только самая свежая точка; журналы не поддерживаются вообще.
- Periodic + несколько исходных заданий на одну ВМ = копируется только первое задание в списке.
- Оба режима игнорируют незавершённые точки и точки, залоченные merge/transform.
Разбор из практики: маркетплейс «Купи-Продай Плюс», 28 рабочих мест, семь месяцев ложной защиты
Клиент — маркетплейс «Купи-Продай Плюс»: 28 рабочих мест в офисе, склад-фулфилмент, заказы идут круглые сутки через сайт и интеграции с площадками. Инфраструктура компактная: один хост VMware ESXi 8.0 U3 в серверной и второй в резерве, 7 ВМ, из них критичны три — KPP-SQL01 (Windows Server 2022, Microsoft SQL Server 2019 Standard, база 1С:УТ 11.5 примерно на 160 ГБ плюс база обмена с сайтом), KPP-1C01 (сервер приложений 1С) и KPP-DC01. Резервное копирование — Veeam Backup & Replication 13 (build 13.1.1.18), сервер бэкапа физический, локальный репозиторий на ReFS 64K на 8 ТБ. Вторая площадка — наш ЦОД, Linux-репозиторий на XFS с reflink, канал IPsec 100 Мбит/с.
Основное задание было настроено грамотно: application-aware processing включено, на вкладке SQL выбрано Backup logs periodically, интервал журналов оставлен дефолтным — 15 минут, ретеншен журналов «Until the corresponding image-level backup is deleted». В сутки это давало 96 файлов .vlb суммарно примерно на 600 МБ — у маркетплейса журнал пухнет и ночью, потому что заказы и обмены остатками идут без перерыва. На локальном репозитории компания честно имела RPO в четверть часа и умела откатывать базу на любой момент за две недели.
А задание копирования на нашу площадку было в Periodic с расписанием «раз в сутки в 01:00». Настраивал его прежний подрядчик ещё на VBR 11, и с тех пор оно просто работало. Обнаружилось всё на плановом тестовом восстановлении, которое мы делаем раз в квартал: подняли KPP-SQL01 из копии в ЦОД, попробовали через Veeam Explorer for Microsoft SQL Server сделать restore to point in time на 14:20 — и в мастере не оказалось ни одной точки, кроме самого образа. Пошли в файловую систему репозитория: .vbk и .vib на месте, .vlb — ноль файлов.
Считаем цену. В обычный день через «Купи-Продай Плюс» проходит около 1 200 заказов, в распродажи — втрое больше, плюс возвраты, оплаты от платёжного агрегатора и перемещения на складе. При потере офисной площадки в 17:00 восстановление шло бы на точку 23:40 предыдущего дня, то есть терялся весь операционный день. Ручное восстановление по выгрузкам с площадок и банковским выпискам — это не «переделать за вечер», это несколько дней работы трёх-четырёх сотрудников из 28, пересорт на складе и отменённые заказы покупателей. Семь месяцев компания жила с бэкапом, который считала эквивалентным основному.
- Основная площадка: RPO 15 минут, глубина отката — 14 дней (журналы + образы).
- Резервная площадка по факту: RPO 24 часа, откат только на момент ночного образа.
- Обнаружено на квартальном тестовом восстановлении, а не на аварии — единственная хорошая новость в этой истории.
Как чинится: переключение режима и та самая галка
Порядок действий такой. Сначала убеждаемся, что исходное задание действительно бэкапит журналы: Job → Edit → Guest Processing → Applications → Edit → вкладка SQL → Backup logs periodically. Без этого копировать нечего, и галка в задании копирования ничего не даст — документация по Cloud Connect формулирует это как предусловие: копировать логи можно, если резервирование журналов уже настроено в исходных заданиях.
Дальше открываем задание копирования и меняем режим. На шаге Job Name and Copy Mode выбираем Immediate copy, затем на шаге Objects (Select Workloads to Process) добавляем источники — задания, репозитории или бэкапы — и ставим чекбокс Include database transaction log backups. Формулировка в мануале ровно такая: «[For the immediate copy mode] If you have configured processing of transaction log backups in the source backup jobs, and want to copy these log backups to the target repository, select the Include database transaction log backups check box». Обратите внимание на префикс в квадратных скобках — в периодическом режиме чекбокса просто не будет на экране, и это первое, что должно навести на мысль.
Из PowerShell то же самое делается двумя строчками. Сначала смотрим, что у нас есть:
Get-VBRBackupCopyJob | Select-Object Name, Mode, IsEnabledПотом переводим нужное задание в Immediate и включаем перенос журналов:
$job = Get-VBRBackupCopyJob -Name "KPP-Copy-DC"
Set-VBRBackupCopyJob -Job $job -Mode Immediate -EnableTransactionLogCopy
Параметры реальные, я сверял их со справочником VBR PowerShell Reference для build 13.1.1.18: у Set-VBRBackupCopyJob есть -Mode со значениями Periodic и Immediate и ключ-переключатель -EnableTransactionLogCopy, который «defines that a backup copy job will process transaction logs of the source job». Оговорюсь честно: в разделе Detailed Description того же командлета написано, что он модифицирует задания копирования Veeam Agent, хотя синтаксис явно рассчитан на задания для ВМ (есть -BackupJob, -SourceRepository, -TargetRepository). Поэтому на боевом сервере я сначала проверяю, что Get-VBRBackupCopyJob вообще возвращает нужное задание, после изменения перечитываю его настройки в консоли — открываю задание и смотрю, что режим и галка действительно применились, — и только потом жду прогона.
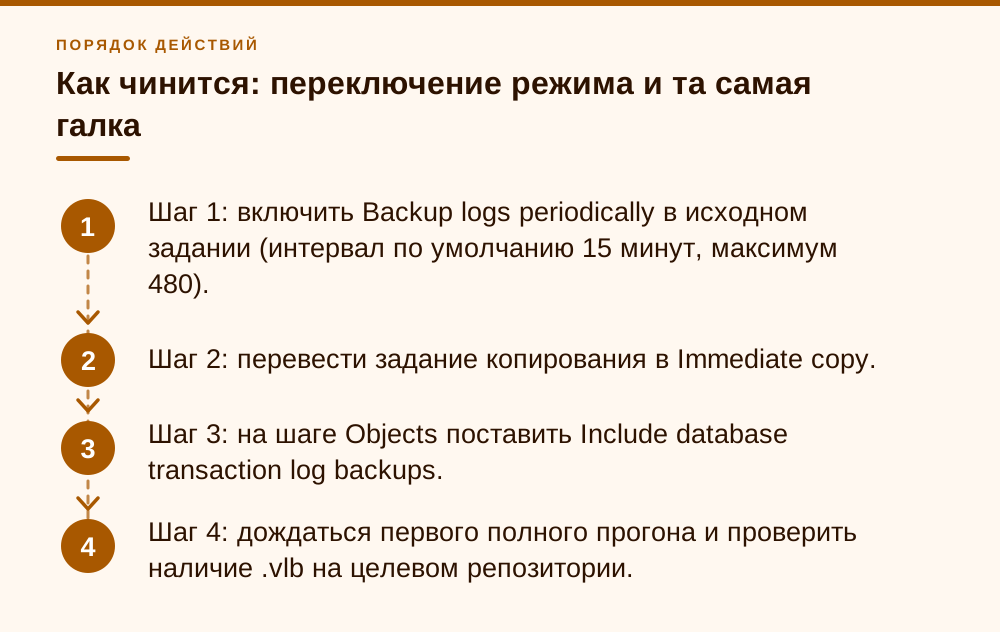
- Шаг 1: включить Backup logs periodically в исходном задании (интервал по умолчанию 15 минут, максимум 480).
- Шаг 2: перевести задание копирования в Immediate copy.
- Шаг 3: на шаге Objects поставить Include database transaction log backups.
- Шаг 4: дождаться первого полного прогона и проверить наличие .vlb на целевом репозитории.
Ловушки при смене режима: почему кнопка не всегда доступна
Veeam 13 разрешает менять режим копирования редактированием настроек задания — это не заблокировано. Но есть два условия, и оба регулярно портят вечер. Первое сформулировано в мануале в блоке IMPORTANT: «The periodic copy mode does not support processing of transaction log backups. Processing of transaction log backups must be turned off before changing the immediate copy mode to the periodic copy mode». То есть в обратную сторону — из Immediate в Periodic — вас не пустят, пока не снимете галку с журналов. Логично, но люди упираются в ошибку и начинают пересоздавать задание, вместо того чтобы прочитать текст.
Второе условие бьёт как раз по таким наследственным конфигурациям, как в «Купи-Продай Плюс». Для бэкап-сервера на Windows смена режима у задания, созданного в более ранних версиях, возможна только если у него формат per-machine backup with separate metadata files. Если формат per-machine with single metadata file — нужно сначала обновить формат цепочки или отцепить бэкапы и начать новую цепочку. Плюс отдельная новость для тех, кто ещё не переехал: периодические задания копирования, созданные в VBR 11 и раньше, объявлены устаревшими, и перед апгрейдом до 13 формат цепочки надо обновлять заранее.
У «Купи-Продай Плюс» задание было именно из VBR 11. Мы пошли по варианту с новой цепочкой: создали новое задание копирования в Immediate, направили в тот же репозиторий, старое задание отключили, но бэкапы не удаляли — они остались как отдельная цепочка на глубину ретеншена, чтобы не оставить компанию без резерва на время первичной синхронизации. Первый прогон перелил около 210 ГБ образов трёх критичных ВМ примерно за 5–6 часов на канале 100 Мбит/с, дальше инкременты пошли по 6–10 ГБ в сутки плюс те самые 600 МБ журналов. Через двое суток старая цепочка была выведена, место освобождено.
Отдельно скажу про страх «Immediate завалит канал». Он преувеличен. Immediate не копирует больше данных — он копирует те же самые точки, просто по мере их появления, а не пачкой. Пиковая нагрузка у него, наоборот, ниже: вместо одного окна в час ночи трафик размазан по суткам. Если канал узкий, ограничивайте не режим, а Backup Copy Window и throttling в настройках сетевого трафика.
- Immediate → Periodic: сначала выключить обработку журналов, иначе смена режима не пройдёт.
- Смена режима у старых заданий на Windows: требуется формат per-machine с отдельными файлами метаданных.
- Periodic-задания из VBR 11 и старше — deprecated, формат цепочки обновляется до апгрейда на 13.
- Новую цепочку заводим, не удаляя старую, — резерв должен существовать всё время миграции.
Вторая площадка у провайдера: Cloud Connect и те же грабли
Если резервная площадка — не ваш ЦОД, а облачный репозиторий Cloud Connect у сервис-провайдера, логика та же: Backup Copy в облачный репозиторий строится тем же мастером, и шаг выбора объектов содержит тот же чекбокс Include database transaction log backups — ставить его есть смысл, только если в исходных заданиях включено резервирование журналов. Ограничение режима тоже никуда не девается: periodic copy mode журналы не обрабатывает независимо от того, куда вы копируете, так что на стороне тенанта задание должно быть в immediate-режиме.
Практическая разница с собственной площадкой — в деньгах и в квоте. Журналы SQL на активной базе — это постоянный поток мелких файлов, у «Купи-Продай Плюс» это около 18 ГБ в месяц дополнительно к образам. У провайдеров тарификация обычно по занятому объёму в квоте, и добавление журналов заметно двигает счёт. Перед включением посчитайте: объём .vlb за сутки на локальном репозитории умножьте на глубину ретеншена журналов. Если денег на такой объём нет — честный разговор с бизнесом о том, что RPO второй площадки будет равен интервалу образов, а не 15 минутам.
И помните про ретеншен: журналы удаляются вместе с образом, к которому привязаны. Даже если у вас настроен GFS с годовым хранением, резервные копии журналов живут по короткому (short-term) ретеншену и удаляются после его истечения. Ожидание «у нас годовые архивы, значит и журналы за год» — неверное. Если нужен вариант «хранить журналы N дней», в настройках SQL выбирается Keep only last N days of log backups, по умолчанию 15 дней, но тогда следите, чтобы ретеншен журналов не превышал ретеншен образов: без образа replay журналов бессмысленен.
- Cloud Connect: тот же чекбокс Include database transaction log backups, только в immediate-режиме.
- Журналы едят квоту постоянно — считайте объём заранее.
- GFS не продлевает жизнь журналам: они живут по короткому ретеншену.
- Keep only last N days of log backups по умолчанию 15 дней; ретеншен журналов не должен превышать ретеншен образов.
Как проверить за десять минут и что поставить на мониторинг
Первое и самое быстрое — посмотреть на файлы в целевом репозитории. Никакие отчёты не заменят факт наличия .vlb с сегодняшней датой. На Windows-репозитории:
Get-ChildItem 'E:\Backups\KPP-Copy-DC' -Recurse -Filter *.vlb |
  Sort-Object LastWriteTime -Descending |
  Select-Object -First 5 Name, LastWriteTime, @{n='MB';e={[math]::Round($_.Length/1MB,1)}}
На Linux-репозитории проверка ещё короче — считаем свежие журналы за последний час:
find /mnt/veeam/KPP-Copy-DC -name '*.vlb' -mmin -60 | wc -lПри интервале журналов 15 минут за час должно приезжать порядка четырёх файлов на защищаемую SQL-ВМ. Ноль — значит либо режим Periodic, либо снята галка, либо задание копирования встало. Второе, что стоит сделать, — прогнать честный тест: Veeam Explorer for Microsoft SQL Server, restore to a specific point in time, выбрать произвольный момент вчерашнего дня в середине рабочего времени и убедиться, что мастер даёт ползунок по времени, а не только список образов. Это пятиминутная операция на копии, и она отвечает на вопрос однозначно.
Из постоянного мониторинга я ставлю три вещи. RPO Warning в настройках задания копирования — Veeam сам предупредит, если новая точка не приехала в заданный срок. Отдельный чек в системе мониторинга на возраст самого свежего .vlb на целевом репозитории (порог — три интервала журналов, у нас 45 минут). И раз в квартал — восстановление на произвольную точку времени с протоколом. За 15 лет практики я не видел ни одной инфраструктуры, где регламент бэкапа не разошёлся бы с реальностью за пару лет: меняются администраторы, добавляются базы, кто-то пересоздаёт задание и забывает галку. Ловится это только проверкой, а не верой в зелёные иконки.
Что делать в первую очередь, если у вас сейчас Periodic: не паниковать и не пересоздавать всё ночью. Сначала убедиться, что журналы вообще снимаются на основной площадке (если нет — это дыра пострашнее). Потом посчитать дополнительный трафик и место. Потом в спокойное окно перевести задание в Immediate с галкой журналов, оставив старую цепочку живой. На что можно забить — на попытки затащить журналы в Periodic обходными путями и на переживания о «лишней нагрузке» Immediate. Первое невозможно, второе не подтверждается.
- Проверка №1: есть ли свежие .vlb на целевом репозитории.
- Проверка №2: даёт ли Veeam Explorer for SQL восстановление на точку во времени из копии.
- Мониторинг: RPO Warning в задании + внешний чек на возраст последнего .vlb.
- Регламент: тестовое восстановление на произвольный момент времени раз в квартал.
Частые вопросы
Можно ли как-то заставить Periodic copy переносить журналы транзакций?
Нет. Это не настройка и не лицензионное ограничение, а архитектурное: периодический режим копирует только последнюю точку восстановления и пропускает промежуточные, поэтому привязывать цепочку журналов не к чему. Документация Veeam 13 прямо указывает, что periodic copy mode не поддерживает обработку transaction log backups. Единственный путь — перевод задания в immediate copy.
Я хочу вернуться из Immediate в Periodic, консоль ругается. Что делать?
Сначала снимите чекбокс Include database transaction log backups на шаге Objects и сохраните задание, потом меняйте режим. Требование выключить обработку журналов перед переходом Immediate → Periodic зафиксировано в мануале. Если задание создано в старой версии VBR на Windows-сервере, дополнительно потребуется формат цепочки per-machine backup with separate metadata files.
Immediate copy сильнее нагрузит канал между площадками?
Суммарный объём тот же — переносятся те же точки восстановления. Меняется распределение во времени: вместо одного ночного окна трафик идёт по мере появления точек, то есть пик обычно ниже. Дополнительный объём даёт только перенос журналов, и его легко посчитать заранее по размеру .vlb за сутки на основном репозитории. Ограничивать нагрузку правильнее через Backup Copy Window и throttling, а не через выбор режима.
Сколько журналов реально должно приезжать на вторую площадку?
При дефолтном интервале 15 минут — 96 файлов .vlb в сутки на каждую защищаемую SQL-ВМ, то есть примерно 4 файла в час. Если за час на целевом репозитории не появилось ни одного нового .vlb, задание либо в периодическом режиме, либо встало, либо галка снята. Максимальный интервал журналов в Veeam — 480 минут, но ставить его имеет смысл только для баз, где потеря восьми часов транзакций приемлема.
У нас GFS с хранением год. Журналы тоже будут храниться год?
Нет. Резервные копии журналов удаляются по короткому (short-term) ретеншену вместе с образом, к которому привязаны, даже если для образов настроено долгосрочное GFS-хранение. Годовые архивы дают восстановление на дату архивной точки, но не на произвольную минуту внутри прошедшего года.
Как быстро понять, что на резервной площадке нет журналов, не залезая в файловую систему?
Откройте Veeam Explorer for Microsoft SQL Server на бэкапе, лежащем на второй площадке, и попробуйте восстановление на конкретный момент времени. Если мастер предлагает только список образов без выбора времени внутри суток — журналов там нет. Это пятиминутная проверка, которую можно делать без восстановления самой ВМ.
Как восстановить базу на точку во времени именно из копии на второй площадке?
В консоли откройте Home → Backups → Disk (Copy), найдите SQL-ВМ в задании копирования и запустите восстановление базы Microsoft SQL Server через Veeam Explorer for Microsoft SQL Server. Если журналы доехали, мастер предложит восстановление на конкретный момент времени: Veeam возьмёт образ, предшествующий выбранному моменту, и накатит цепочку .vlb до нужной минуты. Для полной проверки восстанавливайте базу под другим именем на тестовый SQL-сервер, а не поверх рабочей.
Источники
- Veeam Backup & Replication 13 User Guide — Backup Copy Modes — Раздел Platform-Independent Features; там же Note: periodic backup copy jobs, созданные в VBR 11 и раньше, deprecated — перед апгрейдом до 13 обновить формат цепочки; условие per-machine backup with separate metadata files для смены режима → Backup Copy → Backup Copy Modes; блок Changing Backup Copy Modes: «The periodic copy mode does not support processing of transaction log backups. Processing of transaction log backups must be turned off before changing the immediate copy mode to the periodic copy mode». Page updated 2026-09-01, применимо к build 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/backup_copy_modes.html?ver=13
- Veeam Backup & Replication 13 User Guide — Step 3. Select Workloads to Process — Шаг Objects мастера New Backup Copy Job: «[For the immediate copy mode] ... select the Include database transaction log backups check box»; там же «[For the periodic copy mode] If multiple jobs process one workload, Veeam Backup & Replication copies only restore points created by the first job in the Objects to process list» — ограничение периодического режима на несколько исходных заданий для одной ВМ. Page updated 2025-08-31, build 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/backup_copy_vms.html?ver=13
- Veeam Backup & Replication 13 User Guide — Restore Point Selection — Логика выбора точек в immediate и periodic режимах, список ограничений (незавершённые точки, импортированные бэкапы, разный размер блока). Page updated 2025-03-17, build 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/backup_copy_select_point.html?ver=13
- Veeam Backup & Replication 13 User Guide — Microsoft SQL Server Transaction Log Settings — Опция Backup logs periodically, поле Backup logs every N minutes (по умолчанию 15 минут, максимум 480), варианты ретеншена Until the corresponding image-level backup is deleted и Keep only last N days of log backups (по умолчанию 15 дней). Build 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/backup_job_vss_sql_vm.html?ver=13
- Veeam Backup & Replication 13 User Guide — Retention for Transaction Log Backups — «Even if long-term retention is configured for the VM backup, Veeam Backup & Replication retains transaction log backups according to the short-term retention policy»; требование согласовать ретеншен журналов и образов. Page updated 2025-03-04, build 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/sql_backup_retention.html?ver=13
- Veeam Cloud Connect Guide — Backup Copy to Cloud Repository — Руководство Veeam Cloud Connect для VBR 13: создание заданий Backup Copy в облачный репозиторий, шаг выбора объектов с чекбоксом Include database transaction log backups. https://helpcenter.veeam.com/docs/vbr/cloud/cloud_connect_backup_copy.html?ver=13
- Veeam PowerShell Reference 13 — Set-VBRBackupCopyJob — Параметры -Mode <VBRBackupCopyJobMode> (Periodic | Immediate) и -EnableTransactionLogCopy («Defines that a backup copy job will process transaction logs of the source job»). Page updated 2026-08-19, build 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/powershell/set-vbrbackupcopyjob.html?ver=13