
RESTORE VERIFYONLY прошёл, а CHECKDB нашёл порчу: что на самом деле проверяет ваш тест бэкапа
Если у вас в ночном задании стоит BACKUP, а следом RESTORE VERIFYONLY — и вы считаете, что бэкап проверен, — эта статья для вас. Я покажу, что именно проверяет VERIFYONLY по документации Microsoft, почему даже WITH CHECKSUM не ловит целый класс повреждений, разберу конкретный случай, где порча жила в базе семь недель при «зелёных» проверках каждую ночь, и дам регламент, который у меня работает на клиентских стендах.
«Проверка резервной копии прошла успешно» — что за этим стоит
Типовая картина, которую я вижу у новых клиентов раз в месяц. В SQL Server Agent есть задание: полный бэкап ночью, лог каждые 15 минут, после полного — шаг RESTORE VERIFYONLY FROM DISK = .... Задание зелёное уже второй год. Все спокойны. Потом наступает день, когда база падает или отчёт начинает вываливаться с ошибкой чтения, вы поднимаете копию на запасном сервере, от нечего делать запускаете DBCC CHECKDB — и получаете список ошибок согласованности. Дальше самое неприятное: вы начинаете перебирать копии назад по датам и на глубине всего ретеншена везде видите одно и то же. Чистой копии в хранилище просто нет.
Разберём формально. В документации по RESTORE VERIFYONLY первая же фраза описания звучит так: команда проверяет резервную копию, но не восстанавливает её, и убеждается, что backup set комплектен и весь бэкап читается. И сразу следом — ключевое предложение, которое почти никто не дочитывает: RESTORE VERIFYONLY не пытается проверить структуру данных, содержащихся в томах резервной копии. Дальше в разделе General Remarks приведён явный список того, что проверяется.
То есть VERIFYONLY отвечает ровно на один вопрос: «этот файл дочитывается до конца, он в формате Microsoft Tape Format, набор томов не рассыпан, и мне хватит места, чтобы его развернуть». Это тест носителя и тест комплектности, а не тест базы. Разница примерно как между «архив открывается» и «внутри архива рабочий проект». Я не преувеличиваю проблему: сама проверка полезная, дешёвая и должна быть. Просто её нельзя записывать в графу «бэкап протестирован».
Есть ещё одна деталь, которая добавляет ложного спокойствия. По статье Microsoft о медиаошибках при бэкапе и восстановлении, встретив ошибку постраничной контрольной суммы, BACKUP и RESTORE по умолчанию падают, а RESTORE VERIFYONLY — продолжает работу. Поэтому в задании Agent я смотрю не только на код возврата шага, но и на весь вывод команды: сообщение о проблемной странице может быть, а шаг при этом зелёный.
- backup set комплектен и все тома читаются;
- отдельные поля заголовков страниц базы, в частности page ID — так, как если бы страница вот-вот записывалась;
- контрольная сумма — если она присутствует на носителе;
- достаточно ли места на устройствах назначения.
Почему WITH CHECKSUM тоже не закрывает вопрос
Логичный следующий шаг — включить контрольные суммы. Механика такая. При BACKUP ... WITH CHECKSUM перед записью каждой страницы на носитель операция проверяет то, что уже есть на странице: page checksum или признак torn page, а также page ID. Если ни того ни другого нет, страница проверена быть не может — она уходит в копию как есть, а её содержимое просто учитывается в общей контрольной сумме бэкапа. Дополнительно BACKUP считает отдельный backup checksum по всему потоку и хранит его на носителе, не на страницах. Факт наличия сумм записывается в msdb.dbo.backupset.has_backup_checksums.
При восстановлении, если суммы на носителе есть, то и RESTORE, и RESTORE VERIFYONLY по умолчанию проверяют и backup checksum, и page checksums. А если сумм нет — обе операции идут без всякой проверки, потому что без backup checksum восстановление не может надёжно проверить постраничные суммы. Отдельная ловушка: если вы явно пишете WITH CHECKSUM в RESTORE, а в backup set сумм нет, операция не «пропустит проверку», а упадёт с сообщением, что контрольных сумм нет. Это не баг, это документированное поведение.
И вот главное, ради чего вся статья. Page checksum считается движком в момент записи страницы на диск. Если страница испорчена логически — оборвалась цепочка страниц в некластерном индексе, разошлись метаданные, слетела ссылка в allocation-структурах, — она была записана штатно, и контрольная сумма над ней абсолютно валидна. Такая страница пройдёт любую проверку сумм на любом этапе и приедет в восстановленную базу ровно в том виде, в котором она лежала в исходной. Бэкап честно сделал свою работу: он снял точную копию базы, включая порчу. CHECKDB на восстановленной копии найдёт ошибки, потому что он смотрит не на суммы, а на смысл структур.
- по умолчанию BACKUP работает с NO_CHECKSUM — исключение составляет сжатый бэкап, для него CHECKSUM включён по умолчанию (то же и для восстановления сжатой копии);
- если у базы `PAGE_VERIFY` выставлен в NONE или TORN_PAGE_DETECTION, постраничных сумм для проверки просто нет;
- логическая порча имеет корректную контрольную сумму — это не ловится ни на бэкапе, ни на VERIFYONLY;
- `CONTINUE_AFTER_ERROR` даёт «успешный» бэкап с флагом `is_damaged = 1` в backupset и записями в `msdb.dbo.suspect_pages`;
- CHECKDB проверяет только дисковые таблицы — для memory-optimized валидация выполняется в рамках CHECKSUM при бэкапе и восстановлении, а опций repair для них нет вообще.
Разбор из практики: «Экспорт-Импорт Консалт», 21 рабочее место
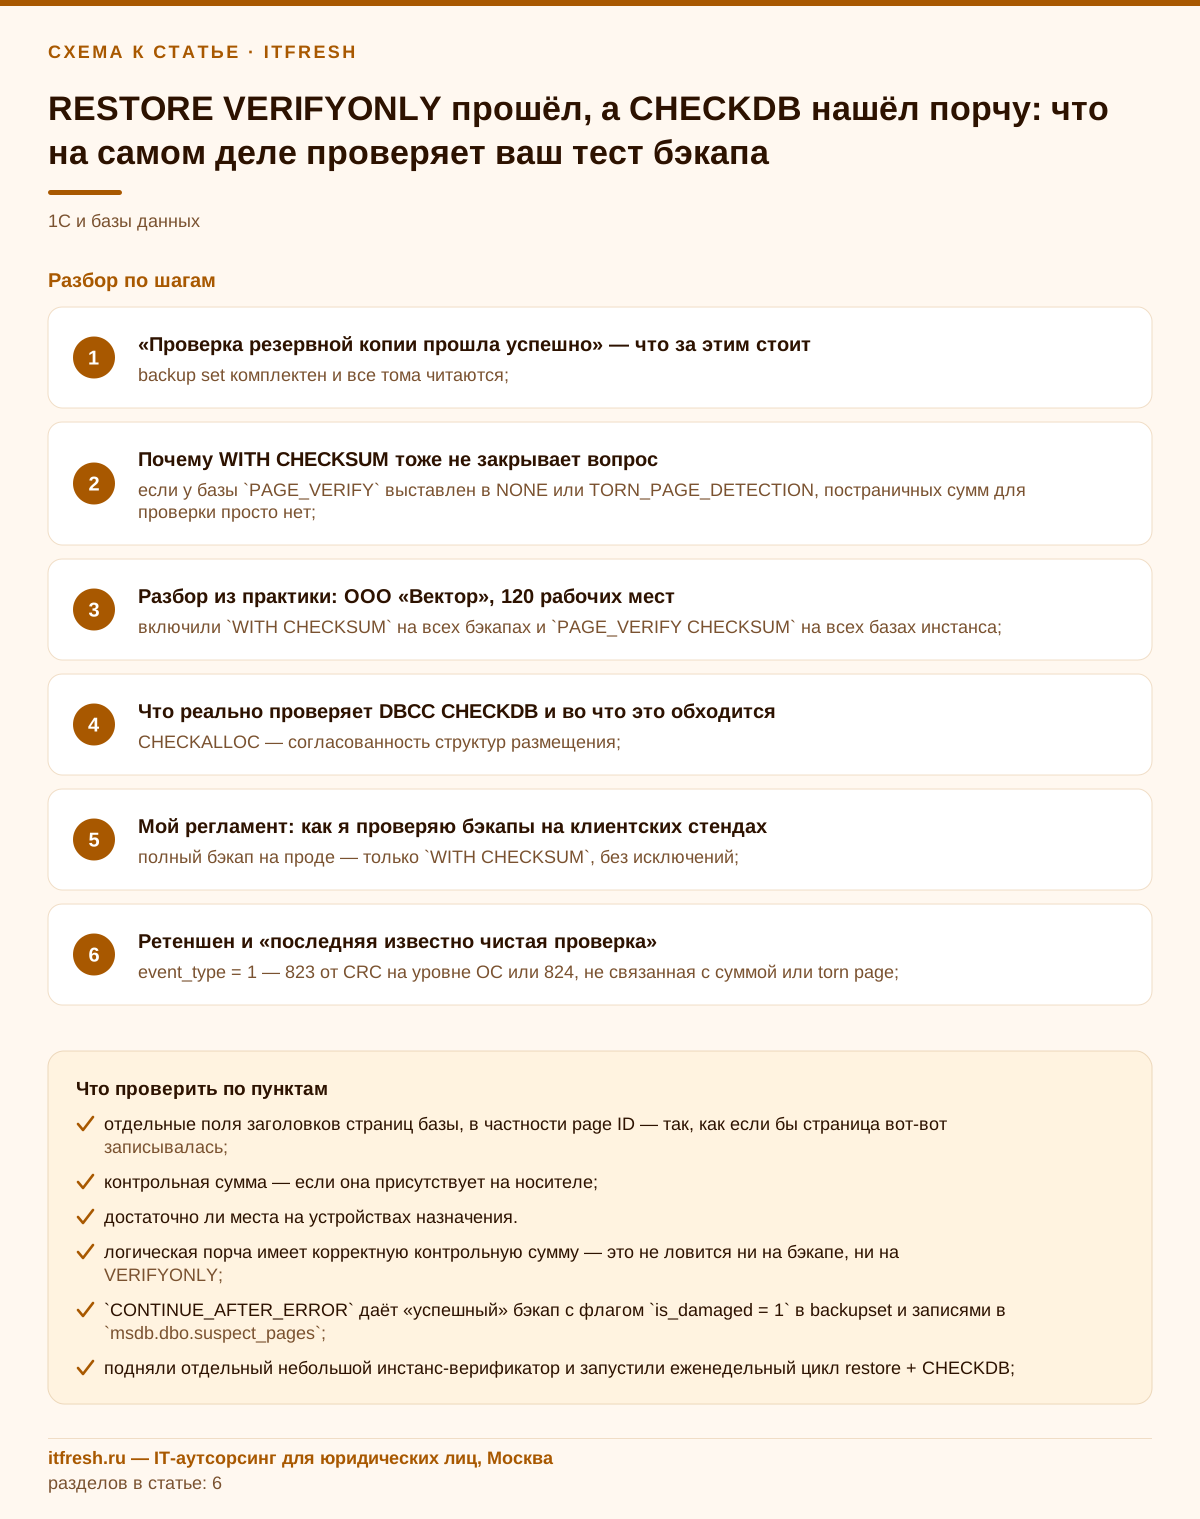
Компания таможенного консультирования, 21 рабочее место: декларанты, двое бухгалтеров, юрист и руководство. Учёт — 1С:Бухгалтерия предприятия и 1С:Зарплата и управление персоналом в клиент-серверном варианте на SQL Server 2025, на момент разбора билд 17.0.4055.5 (CU6 от 17 июня 2026). Размер бухгалтерской базы 86 ГБ, полный бэкап ночью на NAS, журнал транзакций каждые 30 минут, ретеншен 14 дней. Обслуживание — стандартный Maintenance Plan, собранный ещё предыдущим подрядчиком: «Резервное копирование базы данных», «Очистка после обслуживания» и отдельным заданием — VERIFYONLY. Задача «Проверка целостности базы данных» в плане была, но её отключили, когда ночью на том же сервере запустили выгрузку архива деклараций и окно перестало хватать. Как минимум за год до моего появления.
Позвали меня по другому поводу: в конце каждого месяца у бухгалтерии падала оборотно-сальдовая ведомость по счёту 76 с ошибкой СУБД, а декларанты жаловались, что «база тормозит по пятницам», когда закрываются платежи по таможенным пошлинам за клиентов. Первое, куда я смотрю в таких случаях, — журнал ошибок SQL Server и msdb.dbo.suspect_pages. В таблице лежало 7 строк, из них 5 с event_type = 2, то есть bad checksum, и 2 с event_type = 1 — 823-я ошибка от CRC на уровне ОС. Самая старая запись last_update была датирована семью неделями ранее. Семь недель порчи при ежедневном «успешном» тесте бэкапа.
Дальше — арифметика, из-за которой всё и получилось дорого. Ретеншен 14 дней. Я поднял на отдельной виртуалке самую старую доступную копию, запустил DBCC CHECKDB ... WITH NO_INFOMSGS, ALL_ERRORMSGS и получил те же ошибки. То есть порча старше всего срока хранения. Проверил has_backup_checksums — везде 0: план обслуживания писал бэкапы без CHECKSUM и без сжатия, поэтому даже постраничные суммы никто не сверял. VERIFYONLY два года подряд честно говорил «файл читается», и это была правда.
Что удалось спасти. Из трёх повреждённых объектов два оказались некластерными индексами — такие лечатся без потери данных: индекс удаляется и создаётся заново, никакого REPAIR не нужно. Третий объект был кластеризованным индексом таблицы движений регистра бухгалтерии. Восстановление отдельных страниц (page-level restore) не помогло — чистой копии страницы не существовало ни в одном доступном бэкапе. В итоге выгребали строки в новую таблицу по диапазонам ключа, обходя битые страницы; несколько проводок за один день так и не прочитались, бухгалтер перепровела эти документы вручную по первичке. Простой — пять часов в субботу, в рабочие дни декларанты его бы не пережили: у них сроки подачи деклараций.
Причина, для полноты картины, была не в SQL Server. Сервер — одна машина в серверной на две стойки: деградировавший диск в RAID-1 и контроллер с разряженной батареей кэша, который жил в режиме write-back вместо write-through. В журнале событий драйвера контроллера предупреждения были — их просто никто не смотрел, потому что мониторинг железа на этом сервере ставили «потом».
- включили `WITH CHECKSUM` на всех бэкапах и `PAGE_VERIFY CHECKSUM` на всех базах инстанса;
- подняли отдельный небольшой инстанс-верификатор и запустили еженедельный цикл restore + CHECKDB;
- растянули хранение полных копий до 60 дней — копии за воскресенье уезжают на отдельный USB-диск и во внешнее хранилище, для базы в 86 ГБ со сжатием это недорого;
- завели два алерта: любая новая строка в `suspect_pages` и «дней с последней чистой проверки CHECKDB» больше 8;
- включили мониторинг контроллера и SMART, чего до этого не было вовсе.
Что реально проверяет DBCC CHECKDB и во что это обходится
CHECKDB — это не одна проверка, а пакет. По документации он выполняет DBCC CHECKALLOC по базе, DBCC CHECKTABLE по каждой таблице и представлению, DBCC CHECKCATALOG по базе, проверяет содержимое каждого индексированного представления, проверяет консистентность связей между метаданными таблиц и файловой системой для FILESTREAM, а также данные Service Broker. Отдельно запускать CHECKALLOC, CHECKTABLE и CHECKCATALOG после этого не нужно.
Для транзакционной согласованности CHECKDB создаёт внутренний снапшот базы. С SQL Server 2014 он делается разреженными файлами рядом с исходными, по шаблону <имя.расширение>_MSSQL_DBCC<database_id_снапшота>. Файлы удаляются в конце работы, но если сервер аварийно выключится посреди проверки — останутся на диске и могут помешать следующим запускам. Это, кстати, частая находка на клиентских стендах: непонятные файлы рядом с mdf, которые администратор боится трогать. Трогать можно, убедившись, что CHECKDB сейчас не идёт.
Про PHYSICAL_ONLY. Опция ограничивает проверку целостностью физической структуры страниц и заголовков записей плюс согласованностью размещения. Она ловит torn pages, ошибки контрольных сумм и типовые аппаратные отказы, и Microsoft прямо рекомендует её для частого использования на продуктивных системах — на больших базах она отрабатывает в разы быстрее. Но там же сказано, что полный прогон CHECKDB без опций всё равно нужно делать периодически. PHYSICAL_ONLY не проверяет данные FILESTREAM вообще и отключает проверки корректности значений колонок. Ещё одна тонкость: TABLOCK ускоряет проверку под нагрузкой, но при нём не выполняется CHECKCATALOG и не проверяются данные Service Broker.
Оценить стоимость по tempdb можно заранее, не выполняя саму проверку:
-- сколько tempdb потребуется
DBCC CHECKDB ('buh') WITH ESTIMATEONLY;

-- частый режим на проде
DBCC CHECKDB ('buh') WITH PHYSICAL_ONLY, MAXDOP = 4;

-- полный прогон, обычно на инстансе-верификаторе
DBCC CHECKDB ('buh_verify') WITH NO_INFOMSGS, ALL_ERRORMSGS, DATA_PURITY;
Про DATA_PURITY скажу отдельно, потому что вокруг неё много путаницы. Проверки корректности значений колонок включены по умолчанию и опции не требуют. Но для баз, поднятых из старых версий SQL Server, они не включаются, пока DBCC CHECKDB WITH DATA_PURITY хотя бы раз не отработает без ошибок. Если у вас база переехала с 2012-го или 2014-го через простой attach/restore — прогоните её один раз явно. Найденные этой проверкой ошибки (сообщение 2570) не чинятся никакими REPAIR: значение колонки правится руками.
- CHECKALLOC — согласованность структур размещения;
- CHECKTABLE по каждой таблице и представлению — физическая и логическая целостность;
- CHECKCATALOG — согласованность системного каталога;
- проверка содержимого индексированных представлений;
- link-level consistency для FILESTREAM;
- проверка данных Service Broker.
Мой регламент: как я проверяю бэкапы на клиентских стендах
Позиция у меня жёсткая: тест резервной копии — это восстановление копии на отдельный инстанс и полный CHECKDB на восстановленной базе. Всё остальное — вспомогательные проверки. VERIFYONLY я не выкидываю, он стоит копейки и ловит битый носитель на следующее утро, а не через полгода. Но в отчёте клиенту строка «бэкап протестирован» появляется только после успешного CHECKDB на восстановленной базе.
Схема простая. Отдельный инстанс-верификатор — обычно виртуалка с медленным, но объёмным диском; лицензия Developer Edition для этой роли годится, если инстанс действительно не используется в продуктиве, но этот момент лучше сверить со своим лицензионным договором. Раз в неделю на него разворачивается свежий полный бэкап, прогоняется CHECKDB, результат пишется в таблицу и уходит в мониторинг, база удаляется. Побочный эффект приятный: вы регулярно измеряете реальное время восстановления и перестаёте отвечать «часа за два, наверное» на вопрос про RTO.
Бэкап на продуктиве при этом настраивается так:
BACKUP DATABASE [buh]
  TO DISK = N'\\nas\sql\buh_full.bak'
  WITH CHECKSUM, COMPRESSION, INIT, STATS = 5;
А сам цикл проверки на инстансе-верификаторе выглядит примерно так (пути и логические имена, разумеется, свои):
RESTORE DATABASE [buh_verify]
  FROM DISK = N'\\nas\sql\buh_full.bak'
  WITH MOVE N'buh'     TO N'E:\verify\buh_verify.mdf',
       MOVE N'buh_log' TO N'E:\verify\buh_verify.ldf',
       CHECKSUM, STATS = 5, RECOVERY;
GO
DBCC CHECKDB ([buh_verify]) WITH NO_INFOMSGS, ALL_ERRORMSGS, DATA_PURITY;
GO
DROP DATABASE [buh_verify];
Обратите внимание на CHECKSUM в RESTORE: если бэкап делался без сумм, эта команда упадёт — и это правильно, потому что вы сразу узнаете, что ваши копии непроверяемы, а не через год. Именно так я и нахожу «унаследованные» планы обслуживания у новых клиентов.
- полный бэкап на проде — только `WITH CHECKSUM`, без исключений;
- `PAGE_VERIFY CHECKSUM` на всех базах, включая те, что переехали со старых версий;
- `STOP_ON_ERROR` (поведение по умолчанию) — `CONTINUE_AFTER_ERROR` только осознанно, когда другой копии нет;
- еженедельный restore + полный CHECKDB на инстансе-верификаторе;
- на проде между полными прогонами — CHECKDB `WITH PHYSICAL_ONLY` ночью, если окно позволяет;
- результат каждого прогона — в таблицу и в мониторинг, а не в почтовый ящик, который никто не читает.
Ретеншен и «последняя известно чистая проверка»
Порча обнаруживается не тогда, когда возникает, а тогда, когда до неё добирается чтение. Между этими двумя моментами могут пройти недели — как в «Экспорт-Импорт Консалт». Поэтому глубину хранения копий нужно считать не только от RPO («на сколько назад мы готовы откатиться»), но и от интервала проверок целостности. Моё практическое правило: хранить полные копии дольше, чем два интервала между полными CHECKDB, плюс запас на праздники и отпуск администратора. Проверяете раз в неделю — держите минимум месяц. Проверяете раз в месяц — держите квартал, хотя бы холодные копии на дешёвом хранилище.
SQL Server сам подсказывает, когда база последний раз проверялась начисто. При запуске базы дата последней чистой проверки пишется в журнал ошибок и в журнал событий Windows с EventID 17573, в формате: «CHECKDB for database '<database>' finished without errors on 2022-05-05 18:08:22.803 (local time)». Эту дату удобно снимать и превращать в метрику «дней с последней чистой проверки». Существует ещё способ вытащить её через DBCC DBINFO по полю dbi_dbccLastKnownGood, но честно предупрежу: это недокументированная команда, и опираться на неё в продуктивном мониторинге я бы не стал — парсинг журнала надёжнее.
Второй источник сигнала — та самая msdb.dbo.suspect_pages. Таблица ограничена тысячей строк, и когда она заполняется, новые ошибки в неё уже не пишутся. Поэтому её надо обслуживать: периодически удалять или архивировать строки со статусами «восстановлено» (4), «исправлено» (5) и «освобождено DBCC» (7), а также старые записи. Резкий рост числа строк — почти всегда признак проблем с дисковой подсистемой, а не с SQL Server.
-- реальные проблемы: 823, битая контрольная сумма, torn page
SELECT * FROM msdb..suspect_pages
WHERE event_type IN (1, 2, 3);

-- обслуживание таблицы
DELETE FROM msdb..suspect_pages
WHERE event_type IN (4, 5, 7);- event_type = 1 — 823 от CRC на уровне ОС или 824, не связанная с суммой или torn page;
- event_type = 2 — битая контрольная сумма;
- event_type = 3 — torn page;
- event_type = 4 — страница восстановлена;
- event_type = 5 — страница исправлена DBCC;
- event_type = 7 — страница освобождена DBCC.
Как часто проверять базы 1С на SQL Server
Для 1С у меня отдельный подход, потому что профиль нагрузки у этих баз предсказуемый: днём интерактивная работа, в конце месяца и квартала — закрытие периода, перепроведение, регламентированная отчётность. Именно в эти дни чтение доходит до старых страниц, которые месяцами никто не трогал, и порча «всплывает». Поэтому полный цикл restore + CHECKDB я стараюсь поставить так, чтобы свежая чистая проверка была за несколько дней до закрытия месяца, а не через неделю после.
Ориентиры, которые я использую, — это практика, а не требование Microsoft или фирмы «1С»: в документации SQL Server прямо сказано, что частота полных прогонов зависит от конкретного бизнеса. Для небольшой фирмы на 20–30 рабочих мест, где бухгалтерская база весит десятки гигабайт, полный CHECKDB на восстановленной копии раз в неделю занимает меньше часа на обычной виртуалке, и экономить на нём нет смысла. Отдельно помню, что встроенное в конфигуратор «Тестирование и исправление информационной базы» работает на уровне платформы 1С и не заменяет проверку структур SQL Server — это разные уровни, и один не видит проблем другого.
-- дата последней чистой проверки из журнала ошибок (текущий журнал)
EXEC sys.xp_readerrorlog 0, 1, N'CHECKDB for database', N'finished without errors';- рабочая база 1С:Бухгалтерии или УТ до 100 ГБ — еженедельный restore + полный CHECKDB на верификаторе;
- за 3–5 дней до закрытия месяца — внеплановый прогон, чтобы к отчётности была свежая чистая копия;
- база ЗУП и мелкие базы — полный CHECKDB раз в неделю прямо ночью на проде, они проверяются за минуты;
- после любого сбоя питания, замены диска или записи в suspect_pages — проверка в тот же день;
- полные копии хранить не меньше двух интервалов между полными проверками плюс запас на праздники.
Где риск преувеличен и на что можно спокойно забить
Успокою по нескольким пунктам, вокруг которых много страха. Первое: CHECKDB не блокирует базу. Он работает через внутренний снапшот, и монопольные блокировки берутся только если снапшот создать не удалось или вы сами указали TABLOCK. Второе: с SQL Server 2005 SP2 запуск CHECKDB больше не очищает кэш планов, так что байку про «после проверки всё тормозит из-за перекомпиляции» можно забыть. Третье: разреженные файлы _MSSQL_DBCC рядом с mdf — это штатный механизм, а не признак взлома.
Теперь про то, чем пугать надо. REPAIR_ALLOW_DATA_LOSS — это не «кнопка починить». В документации прямым текстом: опция может привести к большей потере данных, чем восстановление из последней известно чистой копии, и рекомендуется только как аварийное последнее средство, когда восстановиться неоткуда. После неё ссылочная целостность не гарантируется, нужно отдельно гонять DBCC CHECKCONSTRAINTS. Я за пятнадцать лет применял её считанные разы и каждый раз — с предварительной физической копией всех файлов базы и внутри явной транзакции, чтобы был шанс откатиться.
Отдельно про сторонние системы резервного копирования. Их встроенная верификация проверяет свою копию: сходится ли контрольная сумма блоков, загружается ли виртуальная машина, отвечает ли служба. Это ценно, но это не проверка согласованности базы SQL Server. Хорошая новость — в такие продукты обычно можно вкрутить произвольный скрипт при тестовом запуске машины из копии; туда и ставится CHECKDB. Плохая — по умолчанию этого нет нигде, и «зелёный» отчёт системы бэкапа читается людьми ровно так же ошибочно, как зелёный VERIFYONLY.
И честно про спорное. Единого мнения о частоте полного CHECKDB нет ни в документации Microsoft, ни в сообществе: Microsoft пишет, что частота зависит от конкретного бизнеса и среды. Я на базах до сотни гигабайт делаю полный прогон еженедельно на верификаторе, на базах в сотни гигабайт и больше — еженедельный PHYSICAL_ONLY ночью на проде и полный раз в месяц на верификаторе. Это компромисс между стоимостью железа и глубиной обнаружения, и если у вас ресурсы позволяют делать полный прогон чаще — делайте чаще, хуже не будет.
- можно забить: на ежедневный полный CHECKDB для базы в сотни гигабайт, если есть еженедельный цикл на верификаторе;
- можно забить: на страх «CHECKDB положит прод» — при наличии окна и MAXDOP это управляемая нагрузка;
- нельзя забить: на `WITH CHECKSUM` в бэкапах и `PAGE_VERIFY CHECKSUM` в базах;
- нельзя забить: на глубину ретеншена относительно интервала проверок;
- нельзя забить: на мониторинг дисковой подсистемы — почти вся порча приходит оттуда.
Частые вопросы
Можно ли считать успешный RESTORE VERIFYONLY подтверждением, что бэкап рабочий?
Нет. По документации Microsoft VERIFYONLY проверяет комплектность backup set, читаемость всех томов, отдельные поля заголовков страниц (в том числе page ID), имеющиеся контрольные суммы и достаточность места на устройствах назначения. Структуру данных внутри копии он не проверяет. Успешный VERIFYONLY означает «файл читается», а не «база внутри согласована».
Если делать бэкапы WITH CHECKSUM, порча будет поймана?
Только физическая. При наличии сумм и BACKUP, и RESTORE, и VERIFYONLY сверяют backup checksum и постраничные суммы. Но page checksum рассчитывается движком в момент записи страницы, поэтому логически повреждённая страница имеет корректную сумму и проходит все проверки. Такую порчу находит только DBCC CHECKDB.
Достаточно ли гонять CHECKDB с PHYSICAL_ONLY?
Как основной ежедневный или еженедельный режим — да, Microsoft прямо рекомендует PHYSICAL_ONLY для частого использования на продуктивных системах. Но там же сказано, что полный прогон CHECKDB нужно выполнять периодически. PHYSICAL_ONLY пропускает проверки FILESTREAM и проверки корректности значений колонок, поэтому полностью заменить полный прогон он не может.
Что делать, если CHECKDB уже нашёл ошибки на боевой базе?
Первым делом не запускать REPAIR. Порядок такой: снять текущее состояние, посмотреть msdb..suspect_pages и журнал ошибок, найти самую свежую копию, которая проходит CHECKDB чисто, и восстанавливаться из неё. Microsoft прямо рекомендует восстановление из последней известно чистой копии как основной способ, а REPAIR_ALLOW_DATA_LOSS — как аварийное последнее средство, которое может привести к большей потере данных. Порча в некластерных индексах чинится их пересозданием без потери данных вообще.
Как долго хранить резервные копии, чтобы точно был чистый экземпляр?
Считайте не только от RPO, но и от частоты проверок целостности. Практическое правило: глубина хранения полных копий должна перекрывать минимум два интервала между полными прогонами CHECKDB плюс запас. Проверяете раз в неделю — держите месяц, проверяете раз в месяц — держите квартал хотя бы в холодном хранилище.
Верификация в системе резервного копирования (Veeam, Acronis и подобные) заменяет CHECKDB?
Нет. Такие проверки подтверждают целостность собственной копии и работоспособность восстановленной машины или службы, но не согласованность структур базы SQL Server. Если продукт умеет запускать произвольные скрипты при тестовом восстановлении — добавьте туда DBCC CHECKDB, тогда проверка станет полноценной.
Как часто гонять полный CHECKDB для баз 1С небольшой компании?
Microsoft не называет конкретной частоты — она зависит от бизнеса и среды. На практике для баз 1С в десятки гигабайт я делаю восстановление копии на тестовый инстанс и полный DBCC CHECKDB WITH NO_INFOMSGS, ALL_ERRORMSGS раз в неделю, плюс внеплановый прогон за несколько дней до закрытия месяца. Глубина хранения полных копий должна перекрывать минимум два интервала между проверками.
Источники
- Microsoft Learn — RESTORE VERIFYONLY (Transact-SQL) — Раздел General Remarks, перечень проверок и фраза «does not attempt to verify the structure of the data contained in the backup volumes», версия SQL Server 2025 (ver17): https://learn.microsoft.com/en-us/sql/t-sql/statements/restore-statements-verifyonly-transact-sql?view=sql-server-ver17
- Microsoft Learn — Enable or disable backup checksums during backup or restore (SQL Server) — Поведение WITH CHECKSUM / NO_CHECKSUM при BACKUP и RESTORE, отказ операции при отсутствии сумм в backup set, ver17: https://learn.microsoft.com/en-us/sql/relational-databases/backup-restore/enable-or-disable-backup-checksums-during-backup-or-restore-sql-server?view=sql-server-ver17
- Microsoft Learn — DBCC CHECKDB (Transact-SQL) — Состав проверок (CHECKALLOC, CHECKTABLE, CHECKCATALOG, индексированные представления, FILESTREAM, Service Broker), опции PHYSICAL_ONLY, DATA_PURITY, TABLOCK, ESTIMATEONLY, MAXDOP, внутренний снапшот, EventID 17573, ver17: https://learn.microsoft.com/en-us/sql/t-sql/database-console-commands/dbcc-checkdb-transact-sql?view=sql-server-ver17
- Microsoft Learn — Media errors: Backup and Restore (SQL Server) — Механика backup checksum и page checksum, поведение по умолчанию при ошибке, флаг is_damaged в msdb..backupset, ver17: https://learn.microsoft.com/en-us/sql/relational-databases/backup-restore/possible-media-errors-during-backup-and-restore-sql-server?view=sql-server-ver17
- Microsoft Learn — Manage the suspect_pages Table (SQL Server) — Значения event_type (1, 2, 3, 4, 5, 7), лимит в 1000 строк, обслуживание таблицы, ver17: https://learn.microsoft.com/en-us/sql/relational-databases/backup-restore/manage-the-suspect-pages-table-sql-server?view=sql-server-ver17
- Microsoft Learn — msdb.dbo.backupset (Transact-SQL) — Колонки has_backup_checksums, is_damaged, compression_algorithm, last_valid_restore_time и пример запроса истории бэкапов, ver17: https://learn.microsoft.com/en-us/sql/relational-databases/system-tables/backupset-transact-sql?view=sql-server-ver17
- Microsoft Support — SQL Server 2025 build versions (KB5005684) — Актуальные билды ветки 17.x: CU8 — 17.0.4075.5 от 13 августа 2026, CU8 + GDR — 17.0.4085.5 от 8 сентября 2026, CU6 — 17.0.4055.5 от 17 июня 2026: https://learn.microsoft.com/en-us/troubleshoot/sql/releases/sqlserver-2025/build-versions
- Microsoft Learn — BACKUP (Transact-SQL) — Опции CHECKSUM / NO_CHECKSUM (NO_CHECKSUM по умолчанию), STOP_ON_ERROR / CONTINUE_AFTER_ERROR, COMPRESSION, ver17: https://learn.microsoft.com/en-us/sql/t-sql/statements/backup-transact-sql?view=sql-server-ver17