
После проверки массива mismatch_cnt показывает 128: это повреждение данных или штатная работа swap?
Раз в неделю или раз в месяц мониторинг после планового скраба присылает алерт: mismatch_cnt на /dev/md1 не ноль, а 128, SMART чистый, массив в состоянии clean. Дальше начинается самодеятельность: кто-то немедленно пишет repair, кто-то открывает прайс на новые диски. Разбираю, что реально посчитано в этих 128, откуда берётся именно это число, почему на RAID5 то же значение означает совсем другой масштаб проблемы, когда repair уместен, а когда он молча закрепит ошибку — и как настроить скраб, чтобы письма от него снова что-то значили.
Что буквально означает mismatch_cnt — и чего он не означает
Понедельник, 09:15, в почте алерт из мониторинга: после ночного скраба /sys/block/md1/md/mismatch_cnt показывает 128. mdadm --detail /dev/md1 показывает State : clean, оба устройства в active sync, у обоих дисков в SMART ни одного Reallocated_Sector_Ct и ни одного Current_Pending_Sector. И вот здесь начинается самое интересное: половина администраторов в этот момент пишет в sync_action слово repair, вторая половина звонит поставщику за парой новых дисков. Обе реакции преждевременны, и обе я видел вживую не по одному разу.
Формулировка в man md(4) предельно скупая: если все блоки прочитались успешно, но их содержимое оказалось несогласованным, это считается mismatch. Ключевые слова — «прочитались успешно». Ошибки чтения тут нет вообще: диск отдал данные, внутренняя коррекция сектора отработала, SMART молчит абсолютно справедливо. Просто содержимое двух копий одного и того же логического блока разное. Для RAID1 и RAID10 проверка — это сравнение зеркальных копий между собой. Для RAID4, RAID5 и RAID6 — проверка того, что блок чётности соответствует блокам данных в полосе.
Дальше — то, о чём забывают чаще всего. Счётчик не считает повреждённые секторы. Он считает секторы в той единице ввода-вывода, которой оперировал md в момент обнаружения расхождения. Ядро не выясняет, сколько именно байт разошлось; оно берёт размер запроса целиком и прибавляет его к счётчику. Отсюда и подозрительно «круглые» числа: 128, 256, 384 на зеркалах и кратные восьми на RAID5. Один-единственный несовпавший байт даст в отчёте 128 — то есть 64 КиБ, если умножить на 512 байт сектора. Разница между «у меня разошёлся один байт» и «у меня битые 64 килобайта» для принятия решения довольно принципиальна.
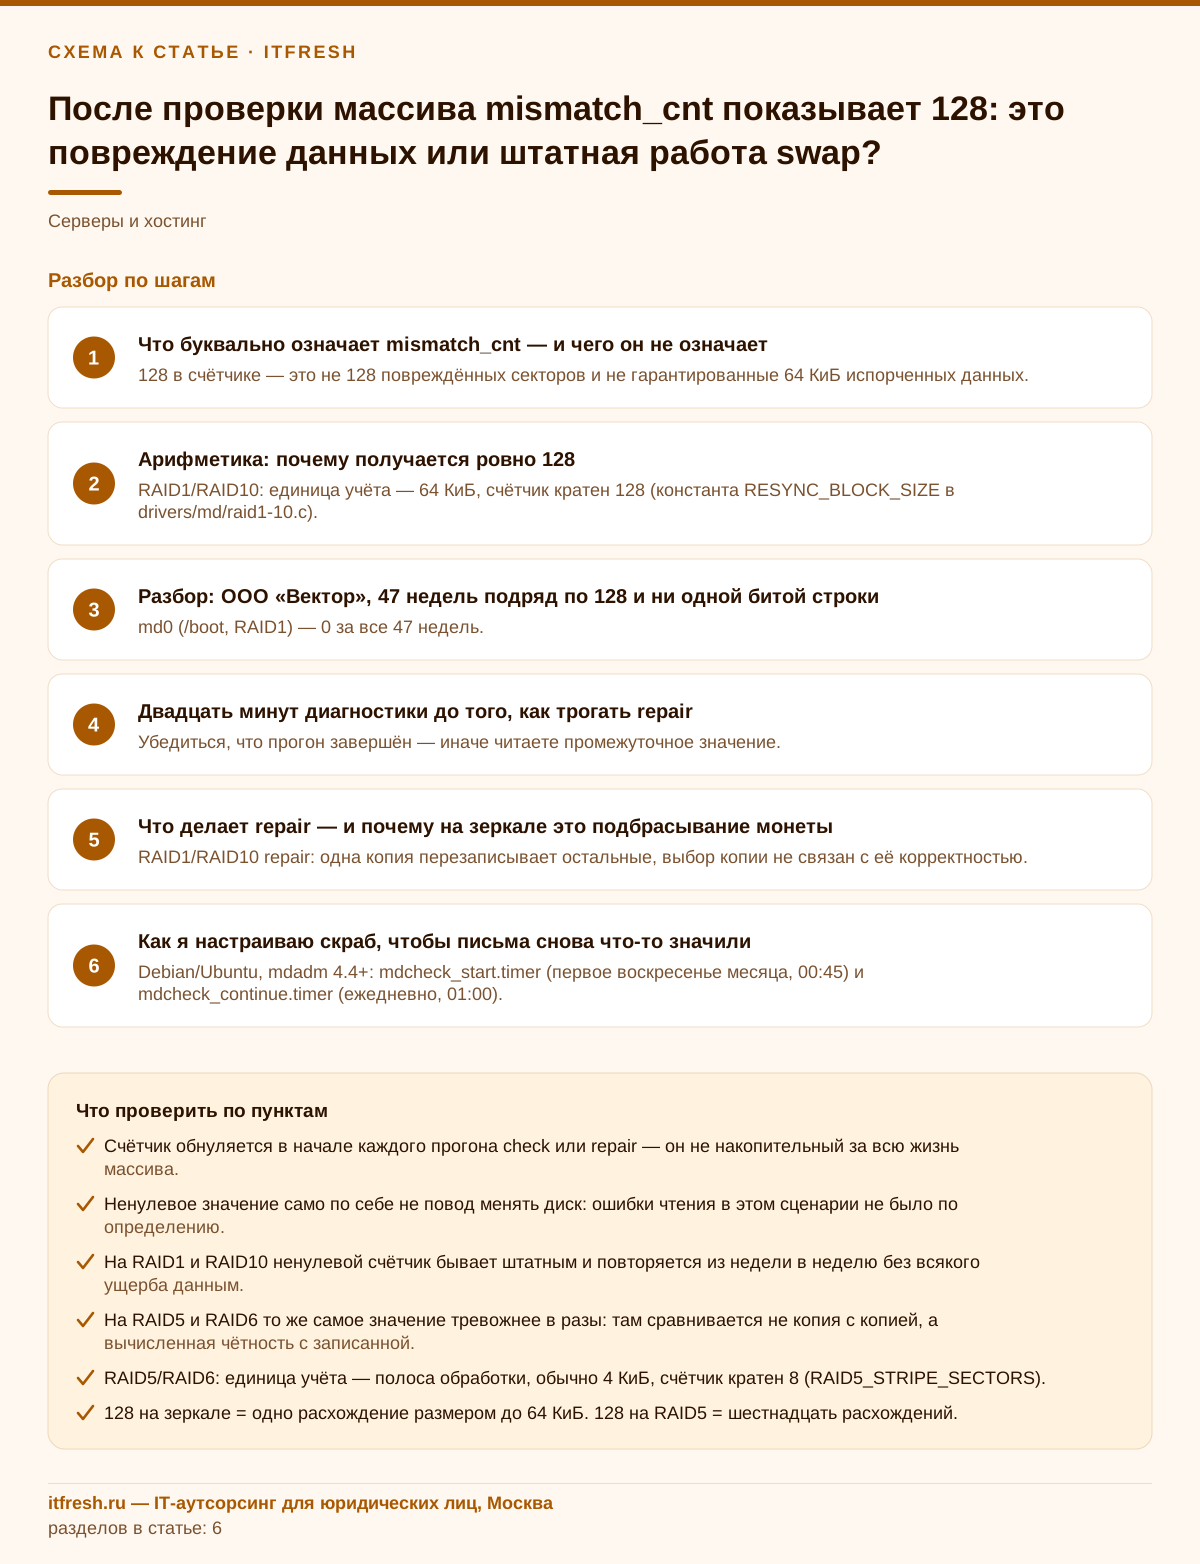
- 128 в счётчике — это не 128 повреждённых секторов и не гарантированные 64 КиБ испорченных данных.
- Счётчик обнуляется в начале каждого прогона check или repair — он не накопительный за всю жизнь массива.
- Ненулевое значение само по себе не повод менять диск: ошибки чтения в этом сценарии не было по определению.
- На RAID1 и RAID10 ненулевой счётчик бывает штатным и повторяется из недели в неделю без всякого ущерба данным.
- На RAID5 и RAID6 то же самое значение тревожнее в разы: там сравнивается не копия с копией, а вычисленная чётность с записанной.
Арифметика: почему получается ровно 128
Число 128 не случайное и не магическое, оно вылезает из константы в исходниках ядра. В drivers/md/raid1-10.c объявлено #define RESYNC_BLOCK_SIZE (64*1024), а рядом, в drivers/md/raid1.c, из неё выводится #define RESYNC_SECTORS (RESYNC_BLOCK_SIZE >> 9). Сдвиг на девять бит — это деление на 512, размер сектора. 65536 / 512 = 128. Именно такими порциями RAID1 читает устройства во время ресинка и проверки.
Когда md сравнил две копии порции и увидел различие, он выполняет atomic64_add(r1_bio->sectors, &mddev->resync_mismatches) — прибавляет к счётчику размер всей порции, а не размер расхождения. Поэтому на RAID1 значение почти всегда кратно 128. 128 — одна порция в 64 КиБ. 256 — либо две разные порции, либо одна порция, разошедшаяся сразу на двух зеркалах: на массиве из трёх устройств прибавка идёт за каждую отличающуюся копию. Хвостовая порция в самом конце массива может быть короче 64 КиБ, и тогда вы увидите некруглое число вроде 40 или 72 — это тоже нормально и ничего дополнительно не значит.
На RAID5 и RAID6 арифметика другая. Там при несовпадении чётности прибавляется RAID5_STRIPE_SECTORS — размер полосы обработки, который по умолчанию равен странице памяти, то есть 4 КиБ или восемь секторов. Значит на RAID5 счётчик 128 означает уже шестнадцать независимых расхождений чётности, а не одно. Одно и то же число на разных уровнях RAID описывает совершенно разный масштаб проблемы, и это первое, что нужно уточнить, прежде чем вообще что-то решать.
Смотреть всё это удобнее напрямую в sysfs, а не через обёртки — там же лежит и то, чем закончился прошлый прогон:
cat /sys/block/md1/md/mismatch_cnt      # 128
cat /sys/block/md1/md/sync_action       # idle | check | repair | resync | recover
cat /sys/block/md1/md/last_sync_action  # что делали в прошлый раз
cat /sys/block/md1/md/degraded          # 0 — избыточность на месте
cat /sys/block/md1/md/sync_completed- RAID1/RAID10: единица учёта — 64 КиБ, счётчик кратен 128 (константа RESYNC_BLOCK_SIZE в drivers/md/raid1-10.c).
- RAID5/RAID6: единица учёта — полоса обработки, обычно 4 КиБ, счётчик кратен 8 (RAID5_STRIPE_SECTORS).
- 128 на зеркале = одно расхождение размером до 64 КиБ. 128 на RAID5 = шестнадцать расхождений.
- Некруглое значение — почти наверняка укороченная хвостовая порция в конце массива.
- Кратность больше 128 на трёхдисковом зеркале может означать одно расхождение, посчитанное дважды — за каждую отличающуюся копию.
Разбор: «ПроцессКонсалт», 11 проверок подряд со 128 и ни одной битой строки
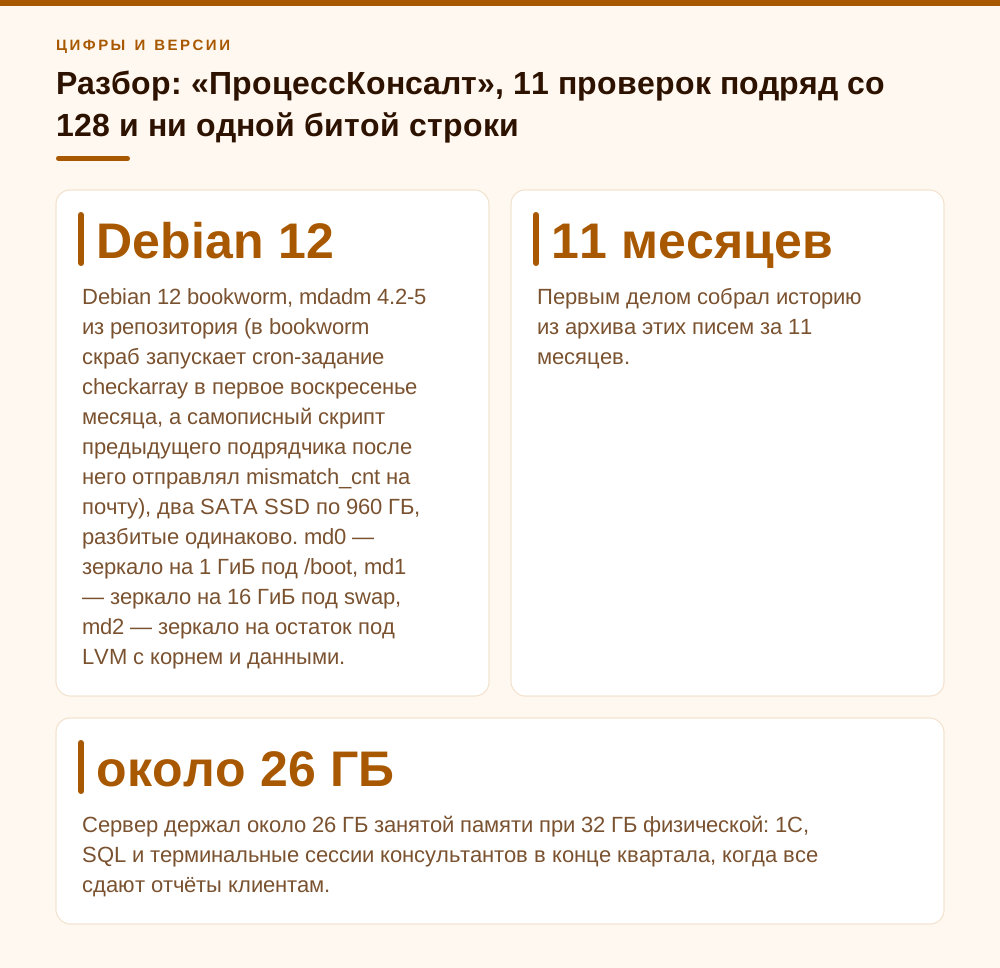
Компания организационного консалтинга «ПроцессКонсалт», 28 рабочих мест, один физический сервер под 1С и файловый шар. Debian 12 bookworm, mdadm 4.2-5 из репозитория (в bookworm скраб запускает cron-задание checkarray в первое воскресенье месяца, а самописный скрипт предыдущего подрядчика после него отправлял mismatch_cnt на почту), два SATA SSD по 960 ГБ, разбитые одинаково. md0 — зеркало на 1 ГиБ под /boot, md1 — зеркало на 16 ГиБ под swap, md2 — зеркало на остаток под LVM с корнем и данными. Сервер собирал не я, он достался по наследству вместе с формулировкой заказчика: «каждый месяц приходят страшные письма, предыдущий подрядчик сказал не обращать внимания». Формулировка, от которой у меня обычно портится настроение, потому что «не обращать внимания» через год превращается в привычку не читать почту от сервера вообще.
Первым делом собрал историю из архива этих писем за 11 месяцев. Картина оказалась железобетонно однообразной: md0 — ноль всегда, md2 — ноль всегда, md1 — от 128 до 512, в среднем 128–256, и ни одного месяца с нулём. Сервер держал около 26 ГБ занятой памяти при 32 ГБ физической: 1С, SQL и терминальные сессии консультантов в конце квартала, когда все сдают отчёты клиентам. Подкачка использовалась постоянно, по полтора-три гигабайта. То есть массив с swap стабильно даёт расхождения, массивы с файлами не дают их никогда. Это ровно тот сценарий, который в man md(4) назван самой вероятной причиной неожиданного mismatch на RAID1 и RAID10.
Механизм описан в man md(4) прямым текстом. Подсистема подкачки, выгружая страницу, помечает её в менеджере памяти как «чистую» и просит swap-устройство её записать. На RAID1 и RAID10 md отправляет данные из памяти на устройства дважды (на трёхдисковом зеркале — трижды), и между этими отправками страница может успеть измениться. На разные диски уезжает разное содержимое. Подсистема подкачки при этом узнает, что страница снова «грязная», и записанную копию использовать не будет — слот для неё мусорный, читать его никто не станет. Скраб честно находит расхождение и честно его считает, но повреждения данных нет. И repair здесь не лечит ничего: предыдущий подрядчик несколько раз его запускал, а в следующем же прогоне счётчик снова показывал 128.
Что сделал я. Вынес подкачку с массива совсем: убрал md1 из fstab, остановил и разобрал его, сделал по разделу подкачки на каждом SSD с одинаковым приоритетом. Ядро при равном pri раскидывает страницы по обоим устройствам параллельно — это и быстрее зеркала, и снимает проблему в корне. Риск потерять содержимое подкачки при смерти одного диска существует, но сервер в этот момент и так уходит в аварийную перезагрузку, а данные в swap переживать смысла нет. После переделки счётчики на всех массивах семь месяцев подряд показывают ноль, а письма от проверки снова означают ровно то, что должны означать.
# было
swapon --show
# NAME      TYPE      SIZE USED PRIO
# /dev/md1  partition  16G 2,4G   -2

# стало
swapon --show
# NAME       TYPE      SIZE USED PRIO
# /dev/sda2  partition   8G 1,1G   10
# /dev/sdb2  partition   8G 1,3G   10
# /etc/fstab — одинаковый приоритет, ядро балансирует сам
UUID=6b1f... none swap sw,pri=10 0 0
UUID=9c4a... none swap sw,pri=10 0 0- md0 (/boot, RAID1) — 0 во всех 11 прогонах.
- md1 (swap, RAID1) — от 128 до 512 в каждом прогоне без единого исключения.
- md2 (LVM с данными, RAID1) — 0 во всех 11 прогонах.
- repair на md1 запускали трижды — счётчик возвращался в следующем же прогоне.
- После выноса swap с зеркала: 0 на всех массивах семь месяцев подряд.
Кроме swap: O_DIRECT, TRIM, SMART и dm-integrity
Swap — самый частый, но не единственный источник безвредных расхождений на зеркале. Причина общая: md на RAID1 не делает стабильной копии буфера перед записью, данные уходят на каждое устройство отдельно. Авторы raid-check в RHEL прямо пишут в комментарии, что запись raid1/10 в ядре небуферизованная, поэтому ненулевой счётчик бывает на здоровом массиве и живёт в «транзитных» областях данных. Типичный кандидат — приложения с O_DIRECT: гипервизор с cache=none, некоторые СУБД. Если приложение меняет буфер, пока запрос ещё летит на диски, копии разойдутся. Как правило, этот блок потом перезаписывается или освобождается, но скраб, пришедший раньше, успеет его посчитать. Честно оговорюсь: в md.rst этот сценарий не описан, это практика и комментарии разработчиков, поэтому я считаю его гипотезой, пока не исключены swap и железо.
Второй источник — неиспользуемые блоки. Если на SSD-зеркале включён discard, то что вернут диски при чтении «оттримленного» сектора, зависит от модели: одни гарантированно отдают нули, другие — что угодно. check читает весь массив, включая пустое место файловой системы, и может насчитать расхождения там, где данных нет в принципе. То же бывает после аварийного выключения без write-intent bitmap, если в момент сбоя шла запись в блоки, которые файловая система так и не успела закоммитить.
Теперь про SMART. mismatch по определению — это успешное чтение, поэтому SMART о нём ничего не знает. Но сам скраб — лучший способ разбудить SMART: он читает каждый сектор, и осыпающиеся места всплывают как Current_Pending_Sector или ошибки в журнале ядра. Если сектор не читается, RAID1 берёт данные со второй копии и перезаписывает сбойное место, а в dmesg появляется строка вида md/raid1:md2: read error corrected (8 sectors at ... on sda). Поэтому SMART по участникам массива я снимаю до и после каждого прогона: рост pending или reallocated за время скраба важнее любого mismatch_cnt.
journalctl -k --since "-24h" | grep -E 'read error corrected|unrecoverable I/O read error'
smartctl -A /dev/sda | grep -Ei 'pending|reallocated|uncorrect'
И наконец dm-integrity — ответ на главный недостаток md: у него нет контрольных сумм, поэтому repair на зеркале и не может выбрать правильную копию. dm-integrity хранит контрольную сумму для каждого сектора. Если при чтении сумма не совпадает, он возвращает ошибку ввода-вывода вместо данных. Положенный под каждый участник RAID1, он превращает тихую порчу в обычную ошибку чтения, и md перезаписывает испорченное место с исправной копии. Цена — дополнительная запись метаданных. В режиме журнала (J) документация ядра прямо предупреждает о двукратном падении пропускной способности на запись, режим bitmap (B) быстрее, но менее надёжен после сбоя. Разворачивается через integritysetup format и integritysetup open на каждом разделе или средствами LVM (lvcreate --type raid1 --raidintegrity y), и только на новом, пустом массиве.
- Swap на зеркале — известный и описанный в man md(4) источник ложных расхождений.
- O_DIRECT-запись от гипервизоров и СУБД — вероятный источник расхождений в транзитных данных; сначала исключите swap и железо.
- discard/TRIM на SSD-зеркале может давать расхождения в пустом месте файловой системы.
- SMART mismatch не видит, но скраб выявляет pending-секторы — сравнивайте SMART до и после прогона.
- dm-integrity под участниками RAID1 даёт md то, чего у него нет: знание, какая копия испорчена.
Двадцать минут диагностики до того, как трогать repair
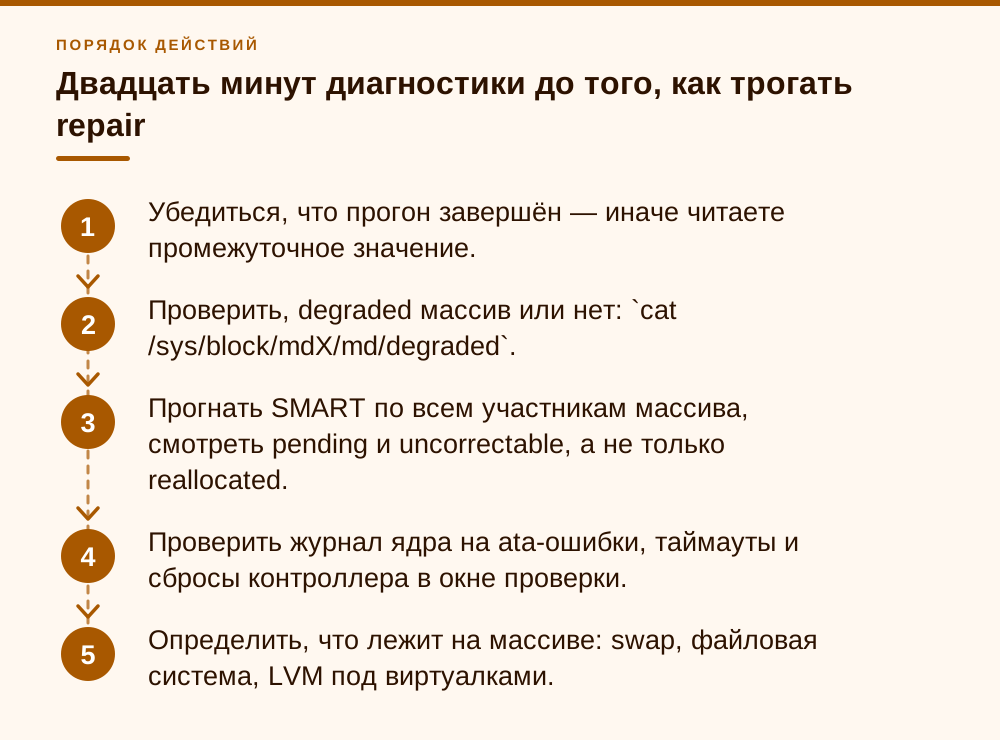
Порядок, который я прогоняю всегда и который ни разу не подвёл. Он занимает минут двадцать вместе с чтением логов и почти всегда закрывает вопрос без единой операции записи на массив. Сначала выясняем, не идёт ли проверка прямо сейчас — счётчик во время прогона растёт, и читать его в этот момент бессмысленно. Потом смотрим на железо. Потом на журналы за время проверки. И только в самом конце решаем, что делать.
# 1. не идёт ли скраб прямо сейчас
grep -E 'resync|check|repair|recovery' /proc/mdstat

# 2. что говорит железо по обоим дискам
for d in /dev/sda /dev/sdb; do echo "== $d"; \
  smartctl -a $d | grep -Ei 'reallocated|pending|uncorrect|crc|media|wear|percentage'; done

# 3. что было в логах ядра во время проверки
journalctl -k --since "-12h" | grep -iE 'md/raid|mismatch|I/O error|ata[0-9]|nvme.*error'

# 4. кто вообще живёт на этом массиве
lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINT /dev/md1
swapon --show
Важная асимметрия, о которой мало кто знает. На RAID5 и RAID6 ядро при обнаружении расхождения пишет в журнал диапазон: md/raid:md2: mismatch sector in range 1234567-1234575. Сообщение ratelimited, при шторме часть строк будет прижата, но начало диапазона вы увидите. На RAID1 такого сообщения нет вообще — ядро просто увеличивает счётчик и едет дальше. То есть на зеркале вы штатными средствами принципиально не узнаете, какой именно блок разошёлся. Это не баг и не недоработка, это следствие того, что у md нет контрольных сумм блоков и он всё равно не смог бы сказать, какая из копий правильная.
Теоретически, имея номер сектора с RAID5, можно дойти до конкретного файла: пересчитать смещение внутри LVM, потом debugfs -R "icheck <блок>" /dev/mapper/vg-lv даст inode, а debugfs -R "ncheck <inode>" — имя файла; для XFS — xfs_db -r с командами blockget -n и blockuse -n (только в режиме чтения и на отмонтированной или замороженной ФС; blocktrash из того же набора, наоборот, намеренно портит блоки, путать их нельзя). Честно скажу: за пятнадцать лет практики я делал это ровно дважды, и оба раза ради отчёта заказчику, а не ради принятия решения. Решение всё равно принимается по другим признакам — по SMART, по журналам контроллера и по тому, повторяется ли расхождение.
Отдельно — про исключение массива из проверки. Соблазн просто выключить скраб или отфильтровать письма в почте велик, и я понимаю почему. Но это самообман: скраб существует не ради счётчика расхождений, а ради раннего обнаружения нечитаемых секторов. Диск, у которого сектор осыпался полгода назад, ведёт себя абсолютно нормально до того момента, пока не умрёт второй диск и вам не понадобится каждый байт с первого. Вот тогда и выясняется, что зеркало было бумажным.
- Убедиться, что прогон завершён — иначе читаете промежуточное значение.
- Проверить, degraded массив или нет: `cat /sys/block/mdX/md/degraded`.
- Прогнать SMART по всем участникам массива, смотреть pending и uncorrectable, а не только reallocated.
- Проверить журнал ядра на ata-ошибки, таймауты и сбросы контроллера в окне проверки.
- Определить, что лежит на массиве: swap, файловая система, LVM под виртуалками.
- Только после всего этого решать между «ничего не делать», «repair» и «менять диск».
Что делает repair — и почему на зеркале это подбрасывание монеты
На RAID1 и RAID10 repair работает грубо: берётся содержимое одной копии и записывается поверх всех остальных. Никакого голосования большинством, никакого выбора «правильной» копии по контрольной сумме — потому что контрольной суммы блока у md попросту нет. В коде это bio_copy_data(sbio, pbio): данные из ведущего bio копируются в остальные. Кто оказался ведущим — вопрос порядка устройств в массиве, а не корректности данных. Если одна из копий действительно испорчена, вероятность, что repair закрепит именно её, на двухдисковом зеркале примерно один к двум. Это ровно тот случай, когда команда с обнадёживающим названием ничего не гарантирует.
На RAID4, RAID5 и RAID6 логика другая и по-своему коварная. При несовпадении md пересчитывает чётность по блокам данных и записывает новую чётность. То есть по умолчанию принимается, что данные правы, а чётность врёт. Если реальность обратная и испорчен как раз блок данных, repair аккуратно подгонит чётность под мусор. Данные вы этим не почините, а возможность восстановить их по чётности потеряете окончательно. Редкий случай, когда операция «починить» уменьшает ваши шансы, и я об этом всегда предупреждаю заказчика до того, как что-то запускать.
При этом сам check — операция безопасная почти во всех смыслах: он читает и считает, но расхождений не исправляет. В коде это видно явно: при взведённом флаге MD_RECOVERY_CHECK ядро увеличивает счётчик и отменяет запись на отличающееся устройство. Единственное, что при check всё-таки может произойти с диском, — штатная обработка ошибки чтения: если сектор не читается, md возьмёт данные с исправного устройства и перезапишет сбойный блок, чтобы контроллер накопителя его ремапнул. Это не «исправление mismatch», это лечение bad block, и оно случается при любом чтении, не только во время скраба.
Мой рабочий алгоритм короткий. Mismatch на массиве с подкачкой — не трогаю вообще, убираю swap с зеркала и закрываю тему. Mismatch на массиве с данными, появившийся один раз после жёсткой перезагрузки, пропадания питания или зависания контроллера — снимаю резервную копию, запускаю repair, потом обязательно повторный check. Если после repair счётчик снова не ноль — это уже не «программная особенность RAID1», это железо, кабель или контроллер, и разговор идёт про диагностику и замену, а не про магические команды.
# проверка без исправлений — безопасно
echo check  > /sys/block/md2/md/sync_action

# исправление — только осознанно и после бэкапа
echo repair > /sys/block/md2/md/sync_action

# прервать прогон
echo idle   > /sys/block/md2/md/sync_action

# следить за прогрессом
watch -n 30 'cat /proc/mdstat; cat /sys/block/md2/md/mismatch_cnt'- RAID1/RAID10 repair: одна копия перезаписывает остальные, выбор копии не связан с её корректностью.
- RAID5/RAID6 repair: пересчитывается и переписывается чётность, данные считаются эталоном.
- check ничего не исправляет — кроме штатного лечения нечитаемых секторов, которое идёт при любом чтении.
- После repair обязателен повторный check: он показывает, помогло или нет.
- Счётчик, не обнулившийся после repair, — это уже железная проблема, а не особенность реализации.
Как я настраиваю скраб, чтобы письма снова что-то значили
Скраб нужен, спорить тут не о чем: он вылавливает медленно осыпающиеся секторы до того, как вы упрётесь в них при отказе второго диска. Вопрос только в расписании и скорости. Systemd-юниты для mdcheck появились в upstream mdadm ещё в ветке 4.2 (сейчас разработка идёт в репозитории md-raid-utilities/mdadm на GitHub, свежий тег — 4.6). Это два таймера. mdcheck_start.timer с OnCalendar=Sun *-*-1..7 0:45:00 — первое воскресенье месяца в 00:45, начинает новый проход. mdcheck_continue.timer с OnCalendar=1:00:00 — каждый день в час ночи, продолжает незавершённый проход с сохранённой позиции. Бюджет времени задан прямо в юните: Environment="MDADM_CHECK_DURATION=6 hours". В пакетах Debian и Ubuntu есть патч, добавляющий случайную задержку запуска, поэтому точное время на вашем сервере смотрите через systemctl cat.
Идея правильная. Массив на двадцать терабайт не проверится за одну ночь, и вместо того чтобы гонять диски сутки подряд в ущерб рабочей нагрузке, mdcheck откусывает по шесть часов и запоминает позицию в /var/lib/mdcheck (файлы MD_UUID_* для позиции и Checked_* как отметка о завершённом проходе). С дистрибутивами есть тонкость. В Debian 12 bookworm (mdadm 4.2-5) скраб по-прежнему запускает /etc/cron.d/mdadm: в 00:57 каждое воскресенье, но реально работает только если число месяца не больше 7, и вызывает /usr/share/mdadm/checkarray --cron --all --idle --quiet; включается это параметром AUTOCHECK в /etc/default/mdadm. Начиная с Debian 13 trixie (mdadm 4.4) cron-задание убрано в пользу systemd-таймеров, и они включаются при установке пакета. Проверить, что именно работает на конкретном сервере:
# trixie и новее: таймеры
systemctl list-timers 'mdcheck*'
systemctl cat mdcheck_start.timer

# bookworm: cron + checkarray
cat /etc/cron.d/mdadm
grep AUTOCHECK /etc/default/mdadm

# увеличить бюджет одного прохода (для таймеров)
systemctl edit mdcheck_continue.service
# [Service]
# Environment="MDADM_CHECK_DURATION=10 hours"
В RHEL, AlmaLinux и Rocky исторически другой механизм: скрипт /usr/sbin/raid-check и юнит raid-check.timer с OnCalendar=Sun *-*-* 01:00:00, Persistent=true и AccuracySec=24h. Persistent тут важен — если сервер в воскресенье был выключен, проверка догонится при следующей загрузке. Настраивается всё через /etc/sysconfig/raid-check, и там ровно те ручки, которые нужны на практике. Только помните, что для raid1 и raid10 скрипт mismatch_cnt не проверяет и предупреждение не печатает — эту метрику по зеркалам придётся снимать самим:
# /etc/sysconfig/raid-check
ENABLED=yes
CHECK=check          # только check; repair сюда не ставить никогда
NICE=low             # renice -n 5 плюс ionice -c2 -n7
SKIP_DEVS="md1"      # массивы, которые проверять не надо (например, swap-зеркало)
MAXCONCURRENT=1      # не пилить все массивы одновременно
И последнее — скорость. Дефолтные dev.raid.speed_limit_min и dev.raid.speed_limit_max (1000 и 200000 КБ/с) на боевом сервере с 1С надо прижимать, иначе ночная проверка превращается в утренние жалобы «база тормозит». На шпиндельных массивах ставлю потолок в районе 30–50 МБ/с, на NVMe обычно не ограничиваю вовсе. И обязательно снимаю значение mismatch_cnt в мониторинг сразу после завершения прогона — иначе следующий скраб затрёт результат, и вы никогда не увидите, что счётчик растёт от раза к разу.
# разово, на текущий прогон
echo 50000 > /sys/block/md2/md/sync_speed_max

# постоянно
echo 'dev.raid.speed_limit_max = 50000' > /etc/sysctl.d/90-md.conf
sysctl --system

# то, что стоит забирать в Zabbix по каждому массиву
cat /sys/block/md2/md/mismatch_cnt
cat /sys/block/md2/md/degraded
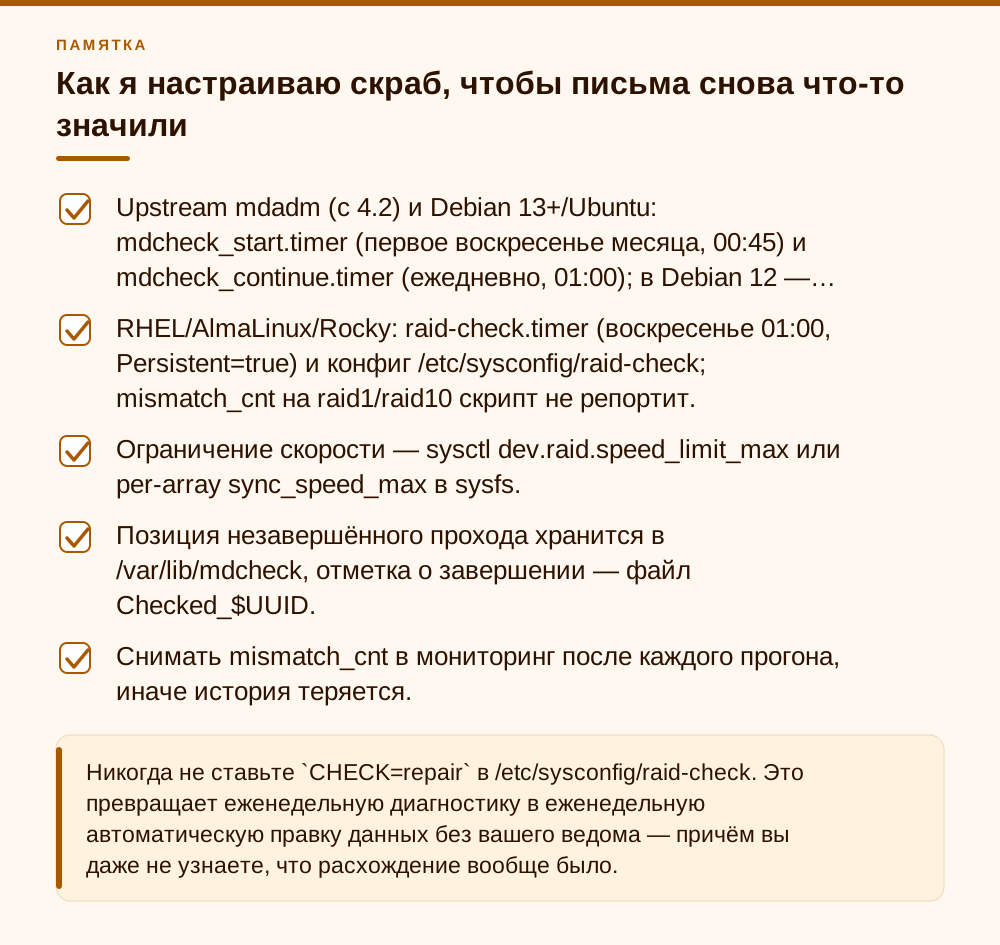
cat /sys/block/md2/md/last_sync_action- Upstream mdadm (с 4.2) и Debian 13+/Ubuntu: mdcheck_start.timer (первое воскресенье месяца, 00:45) и mdcheck_continue.timer (ежедневно, 01:00); в Debian 12 — cron-задание checkarray.
- RHEL/AlmaLinux/Rocky: raid-check.timer (воскресенье 01:00, Persistent=true) и конфиг /etc/sysconfig/raid-check; mismatch_cnt на raid1/raid10 скрипт не репортит.
- Ограничение скорости — sysctl dev.raid.speed_limit_max или per-array sync_speed_max в sysfs.
- Позиция незавершённого прохода хранится в /var/lib/mdcheck, отметка о завершении — файл Checked_$UUID.
- Снимать mismatch_cnt в мониторинг после каждого прогона, иначе история теряется.
Когда 128 — это действительно тревога
Есть набор признаков, при которых ненулевой счётчик перестаёт быть безобидным и требует настоящего разбирательства. Главный из них — массив не несёт подкачку, а расхождение всё равно есть. Второй по важности — счётчик растёт от прогона к прогону: 128, потом 384, потом 1024. Это уже не «программная особенность», это деградация, и её надо ловить за хвост. Третий — расхождение на RAID5 или RAID6 вне сценария «сразу после аварийного выключения»: там нет механизма, который давал бы ложные срабатывания вроде swap, и любое несовпадение чётности означает, что где-то в полосе лежит не то, что должно.
Отдельная категория — RAID5/RAID6 после нештатного выключения. Классическая дыра записи: питание пропало между записью блока данных и записью чётности, полоса осталась несогласованной. Ядро в этом случае гонит полный resync, но часть расхождений может доехать до ближайшего скраба. Тут ненулевой счётчик — ожидаемая вещь, и repair как раз уместен. На будущее лечится внутренним write-intent bitmap: mdadm --grow --bitmap=internal --bitmap-chunk=64M /dev/md2. Стоит копейки по производительности на современных дисках и радикально сокращает время пересинхронизации после нештатной перезагрузки — вместо суток по всему массиву проходят только грязные участки.
Про приоритеты. На что можно спокойно забить: на разовые 128 на массиве с подкачкой; на некруглое значение вроде 40 или 72 — это укороченная хвостовая порция; на панику вокруг того, что счётчик «не обнуляется сам» — он обнуляется, просто в начале следующего прогона, а не по окончании текущего. На что забивать нельзя: на растущий от прогона к прогону счётчик; на mismatch вместе с ata-ошибками, таймаутами или сбросами контроллера в журнале ядра; на любое ненулевое значение на массиве, который в этот момент degraded.
И главное, что я повторяю заказчикам каждый раз. Счётчик — это индикатор, а не диагноз. Решение о замене диска принимается по SMART, по ошибкам ввода-вывода и по журналам контроллера, а не по числу в sysfs. За пятнадцать лет практики я ни разу не менял диск на основании одного лишь mismatch_cnt — и ни разу об этом не пожалел. А вот случаев, когда админ по этому числу заказывал пару новых дисков, ставил их в сервер и получал ровно тот же mismatch на следующей неделе, потому что причина была в swap, я видел достаточно.
- Массив не несёт swap, а счётчик ненулевой — разбираться обязательно.
- Счётчик растёт от прогона к прогону (128 → 384 → 1024) — это деградация, а не особенность.
- Рядом в dmesg есть ata-ошибки, таймауты, сбросы контроллера или сообщения о CRC — виноват тракт передачи, а не пластина.
- SMART показывает Current_Pending_Sector, Offline_Uncorrectable или растущий Reallocated_Sector_Ct — меняем диск, потом сверяем данные.
- RAID5/RAID6 и любое ненулевое значение вне сценария «после аварийного выключения» — считайте проблему подтверждённой.
- Массив в degraded — никакого repair до восстановления избыточности.
Частые вопросы
mismatch_cnt = 128 — сколько это в байтах и сколько файлов пострадало?
На RAID1 или RAID10 это одна порция синхронизации размером 64 КиБ (128 секторов по 512 байт), в которой нашлось хотя бы одно отличие — может быть один байт, может быть все 64 килобайта, ядро не уточняет. На RAID5 или RAID6 единица учёта другая, обычно 4 КиБ, поэтому там 128 означает шестнадцать независимых расхождений чётности. Сколько файлов затронуто, счётчик не говорит вообще, и на зеркале выяснить это штатными средствами нельзя — ядро не логирует номер сектора для RAID1.
Нужно ли сразу запускать repair?
Нет. Сначала посмотрите, что лежит на массиве. Если это раздел подкачки — repair бесполезен, расхождение вернётся на следующем прогоне, лечится выносом swap с зеркала. Если это данные, а расхождение появилось после аварийного выключения — снимите резервную копию, запустите repair, затем обязательно повторный check. Если массив в состоянии degraded или в SMART есть pending-секторы — repair запускать нельзя до восстановления избыточности.
Может ли сам check повредить данные?
Расхождения check не трогает: при взведённом флаге MD_RECOVERY_CHECK ядро увеличивает счётчик и отменяет запись на отличающееся устройство. Единственная запись, которая может случиться во время check, — штатное лечение нечитаемого сектора: данные берутся с исправной копии и перезаписываются на проблемный диск, чтобы его контроллер сделал ремап. Это происходит при любом чтении, а не только при скрабе, и это ровно то, ради чего скраб и нужен.
Почему счётчик обнулился сам, без моего участия?
Он обнуляется в начале каждого прогона check или repair — в коде это atomic64_set(&mddev->resync_mismatches, 0). Поэтому значение, которое вы читаете, всегда относится к последнему прогону, а не накапливается годами. Чтобы видеть динамику, снимайте mismatch_cnt в мониторинг сразу после завершения проверки; иначе следующий скраб просто затрёт предыдущий результат.
Стоит ли вообще отключить скраб, чтобы не получать эти письма?
Категорически нет. Скраб существует не ради счётчика расхождений, а ради того, чтобы прочитать все блоки на всех дисках и обнаружить осыпающиеся секторы заранее. Диск с нечитаемым сектором ведёт себя нормально ровно до момента, когда умрёт его напарник и вам понадобится каждый байт. Правильное решение — убрать источник ложных срабатываний (swap с зеркала) или завести для конкретного массива отдельное правило в мониторинге, а не выключать проверку целиком.
Какая версия mdadm актуальна в 2026 году?
Upstream-разработка ведётся в репозитории md-raid-utilities/mdadm на GitHub, свежие теги — 4.5 и 4.6. В Debian 12 bookworm пакет 4.2-5, в Debian 13 trixie — 4.4-11, в testing/unstable — 4.6-3. Для скраба важнее другое: systemd-таймеры mdcheck_start и mdcheck_continue есть в upstream с ветки 4.2, но Debian перешёл на них с cron-скрипта checkarray только в trixie. В bookworm скраб по-прежнему запускает /etc/cron.d/mdadm.
Поможет ли dm-integrity не гадать, какая копия правильная?
Да, это его прямое назначение. dm-integrity хранит контрольную сумму каждого сектора и при несовпадении отдаёт ошибку чтения, а md на RAID1 лечит её перезаписью с исправной копии. Цена — накладные расходы на запись (в режиме журнала документация ядра говорит о двукратном падении пропускной способности) и развёртывание только на новом массиве: format стирает данные.
Источники
- man md(4), раздел SCRUBBING AND MISMATCHES — Определение mismatch, поведение check и repair для RAID1/RAID10 и RAID4/5/6, оговорка о том, что md прибавляет к счётчику число секторов всей единицы ввода-вывода, и предупреждение про swap на зеркале. https://man7.org/linux/man-pages/man4/md.4.html
- Linux kernel admin-guide: MD (Software RAID) — Описание sysfs-атрибутов md/sync_action, md/mismatch_cnt, md/last_sync_action, md/sync_speed_min и md/sync_speed_max; прямая оговорка, что счётчик может превышать число реальных ошибок в число раз, равное количеству секторов в странице. https://docs.kernel.org/admin-guide/md.html
- Исходники ядра Linux, drivers/md/raid1-10.c и drivers/md/raid1.c — Константы RESYNC_BLOCK_SIZE (64*1024) и RESYNC_SECTORS (RESYNC_BLOCK_SIZE >> 9) = 128; вызов atomic64_add(r1_bio->sectors, &mddev->resync_mismatches) при обнаружении расхождения и отмена записи при взведённом MD_RECOVERY_CHECK. https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/tree/drivers/md/raid1-10.c
- Исходники ядра Linux, drivers/md/raid5.c и drivers/md/md.c — Прибавление RAID5_STRIPE_SECTORS к resync_mismatches при несовпадении чётности, сообщение «mismatch sector in range», сброс счётчика через atomic64_set(&mddev->resync_mismatches, 0) в начале прогона и реализация mismatch_cnt_show. https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/tree/drivers/md/raid5.c
- mdadm upstream, systemd-юниты mdcheck_start и mdcheck_continue — mdadm 4.6 (актуальная ветка, репозиторий md-raid-utilities/mdadm на GitHub): OnCalendar=Sun *-*-1..7 0:45:00 для mdcheck_start.timer, OnCalendar=1:00:00 для mdcheck_continue.timer, Environment="MDADM_CHECK_DURATION=6 hours" в mdcheck_continue.service; позиция в /var/lib/mdcheck/MD_UUID_*, отметка Checked_*. https://github.com/md-raid-utilities/mdadm/tree/mdadm-4.6/systemd
- CentOS Stream, пакет mdadm: raid-check и raid-check.timer — Скрипт /usr/sbin/raid-check читает /etc/sysconfig/raid-check (ENABLED, CHECK, NICE, SKIP_DEVS, MAXCONCURRENT) и пропускает проверку mismatch_cnt для raid1/raid10; таймер — OnCalendar=Sun *-*-* 01:00:00, Persistent=true, AccuracySec=24h. https://gitlab.com/redhat/centos-stream/rpms/mdadm
- Debian, пакет mdadm: debian/changelog, debian/mdadm.cron.d, debian/rules — Bookworm 4.2-5: /etc/cron.d/mdadm с checkarray в первое воскресенье месяца, 00:57; с 4.2+20230227 cron-задания удалены в пользу systemd-таймеров (trixie 4.4-11). https://sources.debian.org/src/mdadm/4.4-11/debian/changelog/
- Linux kernel admin-guide: dm-integrity — Назначение dm-integrity, режимы D/J/B и оговорка о двукратном падении пропускной способности записи в режиме журнала. https://docs.kernel.org/admin-guide/device-mapper/dm-integrity.html