Tesseract, PaddleOCR или языковая модель: какой движок выбрать для распознавания первички
Для русской бухгалтерской первички я ставлю Tesseract 5 первым проходом, PaddleOCR PP-OCRv5 — вторым для плохих мест, а языковую модель подключаю только при сомнении. Единого лучшего движка нет. Ниже: что каждый умеет по документации, где ошибается и как сравнить их на ваших сканах.
Tesseract, PaddleOCR и языковая модель: три разные роли, а не три конкурента
Когда компания приходит к нам за IT-аутсорсингом для бухгалтерии и спрашивает «Tesseract или PaddleOCR для документов?», я сначала переспрашиваю: что вы хотите получить на выходе — просто текст, поля документа или готовый черновик в 1С? От ответа зависит всё. «Движок» в задаче с первичкой — это не одна программа, а три семейства инструментов с разными ролями, и сравнивать их в лоб так же бессмысленно, как сравнивать отвёртку с мультиметром.
Первое семейство — классические OCR-движки, которые превращают пиксели в слова с координатами. Tesseract с четвёртой версии умеет работать на нейросети LSTM; пятая ветка стартовала с релиза 5.0.0 30 ноября 2021 года и считается текущей стабильной, лицензия Apache 2.0, готового графического интерфейса у проекта нет. Второе семейство — PaddleOCR: тоже открытый (Apache 2.0), построен на PaddlePaddle, включает модели распознавания текста PP-OCRv5 и конвейер PP-StructureV3 для разбора страницы с таблицами. Третье — языковые модели: они читают либо картинку, либо уже распознанный текст и «рассуждают» о нём.
Мой принцип простой: не выбирать одного победителя, а расставить движки по цене вызова и цене ошибки. Дешёвый и предсказуемый Tesseract читает всё. Второй движок с другой архитектурой включается там, где первый сомневается. Дорогая модель видит только спорные места. Именно так устроены стадии 4, 5 и 8 конвейера в нашем MCP-сервере для 1С: Tesseract 5 с языковыми моделями rus+eng, второй проход PaddleOCR для сложных мест и перепроверка моделью только при сомнении. Ниже — что каждое звено умеет по документации и как проверить выбор на ваших сканах.
Общую картину — от препроцессинга до черновика в «Бухгалтерии 3.0» и экономику внедрения — я уже разбирал в статье про OCR-распознавание первички в бухгалтерии. Здесь я не повторяюсь: разбираю узкий вопрос, какой движок ставить на какую роль, где он ломается и как не платить лишнего за модель.
- Tesseract 5 — первый проход: печатный текст, работает локально на CPU, отдаёт слова с координатами и уверенностью
- PaddleOCR PP-OCRv5 — второй проход для плохих фото и трудных мест; PP-StructureV3 — отдельно для сложных таблиц
- языковая модель — не читатель всей пачки, а перепроверка: смотрит распознанный текст, когда проверки не сошлись
Что Tesseract 5 умеет на русских сканах и где он ломается
Начну с того, что в Tesseract часто путают: есть три набора обученных моделей. Набор tessdata содержит и LSTM, и старый «легаси»-движок в целочисленном виде; tessdata_best — только LSTM, модели с плавающей точкой, самые медленные и самые точные; tessdata_fast — уменьшенная целочисленная сеть, самая быстрая и наименее точная. Для tessdata_best и tessdata_fast работает только режим --oem 1: режимы 0 и 2 с ними не заработают. Для бухгалтерской первички, где скорость обычно не упирается в один документ, а ошибка в цифре стоит дорого, мы берём tessdata_best.
Рабочий вызов выглядит так. Пакеты дистрибутива кладут модели в системный каталог, но какой именно набор (best, fast или обычный) в них лежит, проверьте у своего дистрибутива; для tessdata_best скачайте rus.traineddata и eng.traineddata из одноимённого репозитория и укажите каталог через переменную TESSDATA_PREFIX или ключ --tessdata-dir.
sudo apt install tesseract-ocr tesseract-ocr-rus
tesseract --list-langs
tesseract scan.png out -l rus+eng --oem 1 --psm 4 --dpi 300 tsv
Здесь -l rus+eng включает два языка сразу (в счетах-фактурах много латиницы: артикулы, наименования на английском), --oem 1 — только нейросеть, --psm 4 — режим «один столбец текста переменного размера» (значение по умолчанию — --psm 3, полностью автоматическая сегментация страницы; --psm 6 предполагает один однородный блок), --dpi 300 подсказывает разрешение, а tsv в конце даёт таблицу со словами, их рамками и уверенностью. Какой --psm лучше для вашего бланка, решает только сравнение на ваших сканах: я всегда пробую 3, 4 и 6.
Где Tesseract силён: чистые сканы от 300 dpi и типовые печатные формы, то есть основной поток УПД и накладных. Где он ломается, документация говорит прямо: при сильном перекосе страницы качество сегментации строк падает существенно, тёмные рамки по краям скана распознаются как лишние символы, а при неравномерном фоне встроенная бинаризация по Оцу работает хуже. В версии 5.0.0 добавили адаптивные методы Оцу и Саувола. И ещё одно ограничение: Tesseract возвращает слова и координаты, но не «таблицу». Сборкой строк — количество, цена, сумма — занимается ваш код или правила поверх координат; у нас это стадия извлечения полей (шаблон → якоря → правила).
Про скорость. По FAQ проекта, Tesseract 4 использует до четырёх потоков на страницу; на двухъядерной машине это, наоборот, тормозит. Для пакетной обработки документация рекомендует выключить многопоточность переменной OMP_THREAD_LIMIT=1 и запускать по одному процессу на ядро. Так масштабируется весь этот слой: видеокарта не нужна, нужны ядра.
export OMP_THREAD_LIMIT=1
ls scans/*.png | xargs -P 8 -I{} tesseract {} {}.out -l rus+eng --oem 1 --psm 4 --dpi 300 tsv
Цифру «страниц в минуту» я сознательно не привожу: она зависит от процессора, размера страницы и модели, поэтому измерьте её на своей виртуальной машине.
PaddleOCR PP-OCRv5 и PP-StructureV3: когда нужен второй проход
PaddleOCR я подключаю не вместо Tesseract, а рядом. Пакет ставится через pip, лицензия Apache 2.0; на PyPI последняя версия на момент проверки — 3.7.0 от 11 июня 2026 года, нужен Python 3.8 или новее. Главная тонкость для нас — язык. Базовая модель PP-OCRv5 по документации покрывает упрощённый и традиционный китайский, пиньинь, английский и японский. Русский закрывают отдельные многоязычные модели: eslav_PP-OCRv5_mobile_rec (русский, белорусский, украинский и английский) и более широкая cyrillic_PP-OCRv5_mobile_rec (плюс сербский, болгарский, казахский и другие кириллические языки). В пакете 3.7.0 параметр lang="ru" по исходному коду выбирает восточнославянскую модель eslav_PP-OCRv5_mobile_rec. Разработчики приводят для неё 81,6 % на собственном наборе из 7031 строки-изображения на русском, белорусском и украинском. Я вижу в этой цифре не обещание, а пример того, почему чужим процентам верить нельзя: к вашим счетам-фактурам с печатями и мятыми углами тот набор отношения не имеет.
Вторая оговорка — версии. В актуальной документации 11 июня 2026 года вышел PP-OCRv6 с одной моделью на 50 языков: китайский, английский, японский и 46 языков на латинице. Кириллицы в этом списке нет. Если не указать ни lang, ни ocr_version, PaddleOCR 3.7.0 берёт PP-OCRv6; при lang="ru" пакет сам откатывается на PP-OCRv5, а явная пара lang="ru" и ocr_version="PP-OCRv6" закончится ошибкой «нет моделей для этого языка». Поэтому для русского я всегда явно задаю lang="ru", фиксирую версию пакета, смотрю по журналу загрузки, какая именно модель распознавания подтянулась, и только потом сравниваю качество. Если забыть про lang или обновить пакет «по привычке», на кириллице может оказаться совсем другая модель, а вы этого не заметите.
pip install paddlepaddle paddleocrfrom paddleocr import PaddleOCR
ocr = PaddleOCR(lang="ru",
use_doc_orientation_classify=True,
use_doc_unwarping=True)
for res in ocr.predict("photo.jpg"):
print(res["rec_texts"], res["rec_scores"])Поля rec_texts (строки) и rec_scores (уверенность по каждому фрагменту) описаны в документации; способ обращения к результату проверьте в своей версии пакета. Опции use_doc_orientation_classify (определение поворота страницы) и use_doc_unwarping (выравнивание искривлённого изображения) для фото с телефона пригодятся, но каждая добавляет время обработки.
Роль в каскаде такая: второй проход на тех страницах или местах, где Tesseract не уверен. Аргумент у меня практический, а не бенчмарочный: два движка с разной архитектурой ошибаются в разных местах, поэтому расхождение между ними — уже сигнал сомнения, причём бесплатный. Если оба прочитали ИНН одинаково и контрольная сумма сошлась, поле можно не трогать. Если прочитали по-разному, поле уходит на проверку или в перепроверку моделью. Сравнительных цифр скорости я не публикую: на вашем железе они будут другими.
Отдельная история — PP-StructureV3. Это не «ещё один OCR», а конвейер разбора страницы: определение областей макета (в документации — 20 типовых категорий элементов: заголовки, текст, таблицы, колонтитулы, печати и т. д.), распознавание таблиц с линиями и без, формул, печатей, диаграмм, восстановление порядка чтения; результат сохраняется в JSON или Markdown. Для первички он нужен в одном месте — сложные таблицы, где строки товаров переносятся, ячейки объединены или линий нет.
paddleocr pp_structurev3 -i ./scan.pngВ документации тестовый стенд описан с видеокартой NVIDIA Tesla T4, поэтому на CPU-only виртуальной машине я не пускаю его на каждую страницу: в нашем конвейере он живёт в отдельной очереди и запускается только для документов со сложной табличной частью.
Можно ли отдать сканы языковой модели вместо OCR: почему я не делаю так со всей пачкой
Соблазн понятен: загрузил картинку, получил поля. Технически это работает, и по документации Anthropic изображения принимаются в форматах JPEG, PNG, GIF и WebP, до 8000×8000 пикселей на изображение, а число картинок на запрос зависит от модели. Заметьте, чего в списке нет: TIFF и BMP, а сканеры и МФУ часто отдают именно TIFF. Значит, перед моделью всё равно нужна конвертация, то есть часть конвейера вы строите в любом случае.
Теперь главное ограничение. Модель видит изображение не пикселями, а патчами 28×28, и у каждой модели есть потолок: на стандартном уровне это длинная сторона 1568 пикселей и не более 1568 визуальных токенов, на «высоком разрешении» — 2576 пикселей и 4784 токена. Всё, что больше, уменьшается. Страница А4 при 300 dpi — это 2480×3508 пикселей. По моей прикидке из этих лимитов, после уменьшения остаётся примерно 110 dpi на стандартном уровне и около 200 dpi на высоком. Мелкий шрифт табличной части УПД на таком разрешении читается заметно хуже, чем на оригинале. Документация прямо предупреждает: модель может ошибаться на изображениях плохого качества, повёрнутых или очень мелких, а сильное сжатие в JPEG добавляет артефакты, которые вредят распознаванию.
Второй риск — характер ошибки. У OCR-движка есть число, показывающее, насколько он уверен в каждом слове: Tesseract пишет уверенность в TSV, PaddleOCR отдаёт rec_scores. У языковой модели по умолчанию такого поля нет: она выдаёт правдоподобное значение, а «правдоподобно» — не то же самое, что «прочитано». OCR ошибается на символ и часто ломает контрольную сумму ИНН, поэтому ошибка заметна. Модель может исправить «7 124,26» на красивое, но неверное число, и оно пройдёт мимо глаз. Поэтому в нашей схеме проверки и арифметика стоят после модели, а не вместо неё.
Третье — куда уходят данные. Скан счёта содержит реквизиты, суммы и часто персональные данные, а отправка картинки в облако для многих компаний просто закрыта договорами или службой безопасности. Поэтому в нашем модуле облачной модели по умолчанию уходит только уже распознанный текст, не изображения, и только когда локальных проверок мало; подробнее о контуре и требованиях — в статье про локальное распознавание первички и 152-ФЗ (юридическую часть проверяйте в своей ситуации). А если политика запрещает и это, модель можно поднять у себя: как это устроено на практике, я описывал в материале про локальные модели на своём сервере.
Сводка по всем вариантам в одном месте: | Вариант | Сильная сторона | Слабое место | Где работает | Роль в каскаде | |---|---|---|---|---| | Tesseract 5 (rus+eng) | чистые сканы, типовые бланки, слова с координатами и уверенностью | перекос, тёмные края, неровный фон; структуру таблицы не собирает | локально, CPU | первый проход | | PaddleOCR PP-OCRv5 | другой тип ошибок, поворот и выравнивание страницы, уверенность по фрагментам | для русского нужны отдельные модели, версии меняются быстро | локально, CPU или GPU | второй проход | | PP-StructureV3 | макет и сложные таблицы, вывод в JSON/Markdown | тяжелее обычного OCR | локально, отдельная очередь | таблицы по необходимости | | Языковая модель по тексту | нетиповые бланки, смысл полей, разбор спорных мест | правдоподобная ошибка вместо честного «не прочитал» | у заказчика, у нас в ЦОД или облако по выбору | перепроверка при сомнении | | Языковая модель по картинке | не нужен отдельный OCR | снижение разрешения, стоимость за каждую страницу, данные уходят за периметр | облако или своя мультимодальная модель | я не ставлю на всю пачку |
Каскад перепроверки: как платить только за сомнение (модельный расчёт)
Каскад в нашем модуле устроен по ступеням. Уровень 0 — проверки ИНН, КПП и НДС и шаблоны поставщиков: детерминированные, мгновенные, стоят 0 ₽. Уровень 1 — бюджетная модель смотрит текст только при сомнении (доли копейки). Уровень 2 — вторая модель, если первая не уверена (копейки). Арбитр — сильная модель, только при расхождении первых двух (редко). Режим задаётся на пачку: «каскад», «строгая» (две модели и арбитр) или «выключена». Если проверки чистые и уверенность высокая, либо сработал проверенный шаблон поставщика, модель не вызывается вообще.
Покажу на условном примере, а не на отчёте о реальном внедрении. Возьмём бухгалтерскую консультацию «Точный учёт» на 20 рабочих мест. Все цифры ниже — допущения, подставьте свои: 800 документов в месяц, в среднем 1,6 страницы, то есть около 1300 страниц; в 25 % документов (200) проверки или шаблон не дали чистого результата и подключилась модель первого уровня; из них в 20 % (40) понадобилась вторая модель; арбитру достались 5 документов. Итого 245 вызовов, и в каждом уходит только текст, допустим около 1500 токенов (это тоже допущение).
Сравним по входным токенам, потому что цена — это токены на цену вашей модели. Каскад: 245 × 1500 ≈ 0,37 млн токенов в месяц. Вариант «все страницы картинкой в модель»: по документации, страница стоит до 1568 токенов на стандартном уровне и до 4784 на высоком, то есть 1300 страниц дают от 2,0 до 6,2 млн токенов. Разница получается в 5–17 раз. В расчёте не учтены выходные токены, текст инструкции и повторные запросы, а арбитр стоит дороже за токен; на порядок это не влияет, но итоговую сумму в рублях посчитайте сами по прайсу вашей модели.
Вывод из расчёта неочевидный: деньги здесь определяет не цена движка, а доля сомнения. Поэтому самая полезная работа — уменьшать эту долю: подготовка скана, шаблоны постоянных поставщиков (после одобрения запоминается макет бланка, следующий документ читается по нему), синонимы из справочников 1С. Обратная сторона: если у вас 30 документов в месяц, никакой каскад не окупит настройку, ручной ввод дешевле. А если PDF выгружен из ЭДО или из 1С и содержит текстовый слой (проверьте, выделяется ли в нём текст мышью), OCR для него не нужен вовсе: читайте текст напрямую.
Фото с телефона и плохой скан: что делать до того, как документ попадёт в движок
Половина «плохого распознавания», с которым ко мне приходят, лечится до всякого движка. Документация Tesseract перечисляет то же, что мы делаем на стадии подготовки: разрешение не ниже 300 dpi (при необходимости изображение масштабируют), бинаризация, удаление шума, удаление тёмных рамок, выравнивание перекоса, белая рамка в 10 пикселей вокруг страницы. У нас это стадия 3: 300 DPI, контраст, шум, выравнивание. Параметры бинаризации своей сборки Tesseract можно посмотреть так:
tesseract --print-parameters | grep thresholding_и, если фон неровный, попробовать адаптивные методы из версии 5.0.0. Меняйте по одному параметру и сравнивайте на эталонном наборе (о нём — в последнем разделе), иначе легко улучшить один скан и испортить десять.
Фото с телефона — отдельный класс. У снимка нет осмысленного «dpi», есть только размер в пикселях, зато есть перспективные искажения, блики от лампы, тени от руки, срезанные края и загнутый угол. С искажением частично справляется выравнивание, а PaddleOCR умеет определять поворот страницы и выпрямлять изображение (те самые две опции из примера выше). В нашем конвейере плохое фото проходит подготовку, при низкой уверенности включается второй движок, а если и это не помогло, документ честно помечается низкой уверенностью, и замечания показывают, какие поля проверить. Я принципиально не делаю «магический» препроцессинг в десять проходов: один-два цикла и остановка, иначе получим красивую картинку с потерянными запятыми.
Что не лечится ничем: смятая копия, факс, «копия с копии», печать поверх цифр итога. Здесь важно не то, что движок ошибся, а то, что он не смолчал. Ошибка в одной цифре ИНН ломает контрольную сумму, расхождение «количество × цена ≠ сумма» ловится арифметикой, и карточка показывает замечание вроде «Строка 2: 1.0 × 5 839,48 ≠ 7 124,26 (расхождение 1 284,78)». Бухгалтер видит, куда смотреть, и не находит ошибку через месяц при сверке с контрагентом.
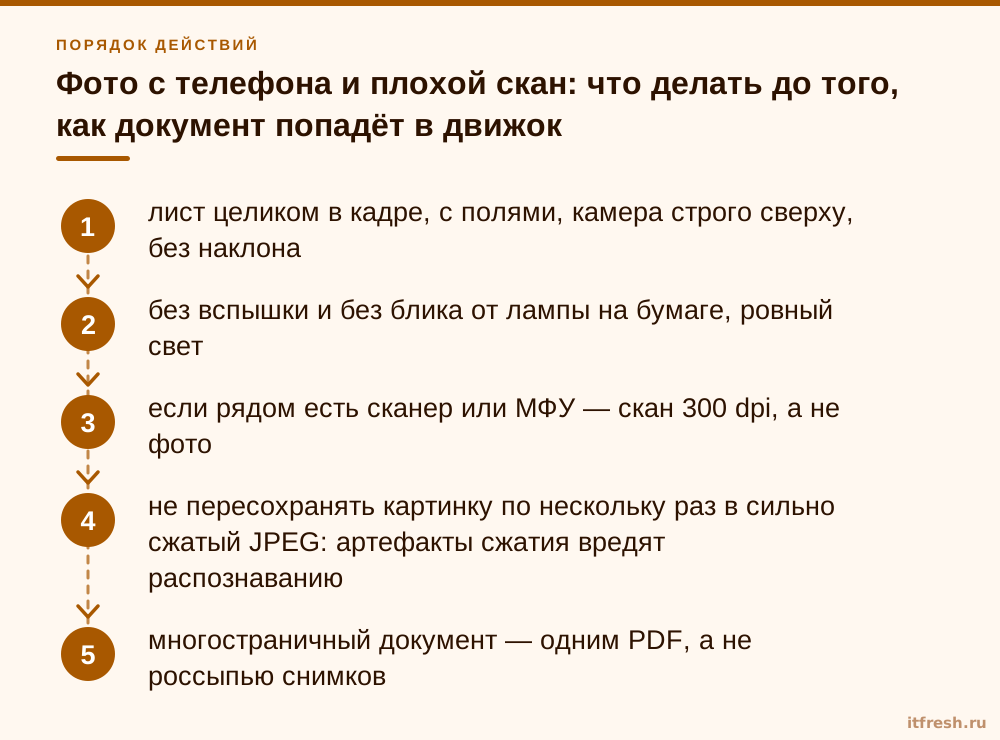
Дешевле всего работает дисциплина на входе. Бухгалтеру и снабженцу, которые фотографируют накладные, я даю короткую памятку (она ниже, в списке).
- лист целиком в кадре, с полями, камера строго сверху, без наклона
- без вспышки и без блика от лампы на бумаге, ровный свет
- если рядом есть сканер или МФУ — скан 300 dpi, а не фото
- не пересохранять картинку по нескольку раз в сильно сжатый JPEG: артефакты сжатия вредят распознаванию
- многостраничный документ — одним PDF, а не россыпью снимков
Как выбрать движок на своих документах: метрика «поля без правок», а не «точность OCR»
Точность распознавания символов, которую любят приводить в сравнениях, бухгалтеру ни о чём не говорит. Его волнует другое: сколько документов он открыл и не тронул, а сколько пришлось править. Поэтому я считаю две метрики. Первая — доля полей без правок: из всех полей эталона (ИНН, КПП, номер, дата, итог, сумма НДС, строки товаров) сколько движок вернул верно. Вторая — доля документов без единой правки. Критичные поля (ИНН, номер, дата, итог) считаю отдельно: ошибка в названии товара и ошибка в сумме стоят по-разному.
Процедура скучная, но другой нет. Берёте 50–100 документов из вашего реального потока: типовые поставщики, нетиповые бланки, несколько плохих фото. Бухгалтер один раз вручную размечает эталон. Каждый движок и каждая связка (только Tesseract; Tesseract и PaddleOCR; каскад с моделью) прогоняется по одному и тому же набору. Сравнение — простым скриптом:
import json

def norm(v):
    return str(v).replace(" ", "").replace(",", ".").strip().lower()

gold = json.load(open("gold.json"))   # {"doc001": {"inn": "...", "number": "...", "total": "..."}}
pred = json.load(open("pred.json"))   # тот же формат, ответ проверяемого движка

ok = total = clean = 0
for doc, fields in gold.items():
    p = pred.get(doc, {})
    bad = [k for k, v in fields.items() if norm(p.get(k, "")) != norm(v)]
    total += len(fields)
    ok += len(fields) - len(bad)
    clean += 0 if bad else 1
print(f"поля без правок: {ok/total:.1%}, документы без правок: {clean/len(gold):.1%}")
Это набросок, а не готовый инструмент: ключи полей и нормализацию (даты, суммы с пробелами и запятыми) подгоните под свой формат.
Иллюстрация расчёта, а не результат измерения продукта. Пусть эталон — 60 документов по 12 полей, то есть 720 полей, и движок вернул верно 684. Это 95,0 % полей без правок, звучит отлично. Но если ошибки независимы, вероятность, что все 12 полей документа верны, равна 0,95 в 12-й степени, то есть около 54 %. В нашем условном наборе документов без правок оказалось бы 41 из 60, то есть 68 %, потому что ошибки группируются на плохих сканах. Отсюда мой совет: смотрите на документы без правок, а не на красивый процент полей. А число «67/67 верно определённых типов» на странице продукта — про определение вида документа на смешанной пачке, а не про чтение полей; не путайте эти вещи.
И последнее, самое важное: калибровка. Разделите поля на «движок уверен» и «движок сомневается» и посчитайте, сколько ошибок осталось среди уверенных. Такая ошибка тихая, она доходит до бухгалтера без пометки, и именно её надо минимизировать порогом уверенности и проверками. Как устроить такую проверку в пилоте без записи в 1С, разобрано в статье про пилот распознавания в dry-run, там — что именно мерить.
Мой порядок выбора — в списке ниже, от простого к сложному. И ничего из него не решайте по чужим процентам: если хотите проверить на своих документах, мы можем прогнать ваши сканы в dry-run без записи в базу и показать карточки, замечания и то, что создалось бы в вашей 1С.
- чистые сканы 300 dpi, типовые бланки: Tesseract 5 + проверки + шаблоны поставщиков
- фото с телефона, мелкий шрифт, расхождения: добавить второй проход PaddleOCR
- сложные таблицы: PP-StructureV3 в отдельной очереди
- нетиповые бланки и спорные поля: модель по тексту, только при сомнении
Частые вопросы
Что точнее для русских документов, Tesseract или PaddleOCR?
Честного ответа без ваших сканов нет. Разработчики PaddleOCR приводят 81,6 % для восточнославянской модели PP-OCRv5, но на собственном наборе, а у Tesseract для русского есть модели tessdata_best, fast и обычные. Соберите 50–100 своих документов, разметьте эталон и сравните долю полей без правок для каждой связки.
Нужна ли видеокарта для распознавания первички?
Для Tesseract нет: он работает на CPU и масштабируется числом ядер. Наш модуль распознавания тоже CPU-only: отдельная виртуальная машина без видеокарты. В документации PaddleOCR тестовые стенды описаны с GPU, поэтому скорость тяжёлых компонентов вроде PP-StructureV3 на CPU проверяйте отдельно.
Можно ли просто отправлять сканы в языковую модель вместо OCR?
Технически можно, но по документации изображение уменьшается до лимита модели, а на мелком тексте и плохих сканах возможны ошибки. К тому же у модели нет числовой уверенности по каждому слову, как у OCR, и данные уходят наружу. Надёжнее читать OCR-движком, проверять контрольные суммы и арифметику, а модель подключать по тексту при сомнении.
Зачем два OCR-движка, если можно взять один лучший?
Движки с разной архитектурой ошибаются в разных местах, и расхождение между ними само служит сигналом сомнения. Второй проход запускается не на каждой странице, а только для сложных мест и плохих фото, поэтому лишней нагрузки для чистых сканов нет.
Какая доля полей без правок считается хорошей?
Универсального порога нет: зависит от потока документов и цены ошибки. Смотрите на долю документов без единой правки и на ошибки среди полей, в которых движок был «уверен»: они доходят до бухгалтера без пометки. Проверять всё равно должен человек: проведение документов из конвейера у нас запрещено.
Источники
- Tesseract: Command Line Usage — Синтаксис вызова, -l с несколькими языками через «+», --oem 1 (LSTM), --psm 3/6, форматы вывода (txt, tsv, hocr, pdf), --tessdata-dir и TESSDATA_PREFIX. https://tesseract-ocr.github.io/tessdoc/Command-Line-Usage.html
- Tesseract: Improving the quality of the output — Рекомендация не менее 300 dpi, бинаризация Оцу и добавленные в 5.0.0 адаптивные Оцу и Саувола, влияние шума, тёмных рамок и перекоса, рамка 10 пикселей. https://tesseract-ocr.github.io/tessdoc/ImproveQuality.html
- Tesseract: Data files (tessdata, tessdata_best, tessdata_fast) — Различия трёх наборов моделей: float и целочисленные, поддержка legacy-движка, режимы --oem с best и fast. https://tesseract-ocr.github.io/tessdoc/Data-Files.html
- PaddleOCR: PP-OCRv5 multilingual (документация) — Модели eslav_PP-OCRv5_mobile_rec и cyrillic_PP-OCRv5_mobile_rec, параметр lang="ru", заявленная разработчиками точность на собственном наборе; параметры use_doc_orientation_classify, use_doc_unwarping и поля rec_texts, rec_scores проверены на странице конвейера OCR (https://www.paddleocr.ai/latest/en/version3.x/pipeline_usage/OCR.html). https://www.paddleocr.ai/latest/en/version3.x/algorithm/PP-OCRv5/PP-OCRv5_multi_languages.html
- PaddleOCR: PP-StructureV3 — Состав конвейера (макет, таблицы, формулы, печати, диаграммы), вывод в JSON и Markdown, команда paddleocr pp_structurev3, описание тестового стенда. https://www.paddleocr.ai/latest/en/version3.x/pipeline_usage/PP-StructureV3.html
- Anthropic: Vision (работа с изображениями) — Форматы JPEG/PNG/GIF/WebP, лимит 8000×8000 пикселей, патчи 28×28, лимиты стандартного (1568 пикселей и токенов) и высокого (2576 пикселей, 4784 токена) уровней, предупреждения о качестве изображений и сжатии. https://platform.claude.com/docs/en/build-with-claude/vision