Сопоставление контрагентов и номенклатуры при распознавании первички: где на самом деле теряется время
Самое дорогое при вводе первички — не прочитать скан, а связать прочитанное со справочниками 1С: контрагента по ИНН и КПП, строки — с вашей номенклатурой, не создав дублей. Ниже — как это устроено в нашем модуле, где оно ошибается и как подготовить справочники, чтобы автоподстановка работала.
Что на самом деле тормозит ввод первички: не чтение скана, а справочники
Когда владелец или главный бухгалтер приходит ко мне с фразой «давайте распознавать первичку», я задаю один вопрос: что у вас занимает время после того, как человек прочитал накладную глазами? Обычно оказывается, что не «печатать цифры». Печатать — быстро. Долго — понять, что «ООО Мукомол-Сервис» из накладной и «Мукомол Сервис ООО (старый)» в базе — один и тот же поставщик, а «Мука в/с 50кг меш.» в его бланке — это наша позиция «Мука пшеничная высший сорт». Мы в АйТи-Фреш как ИТ-аутсорсинговая компания сопровождаем 1С у компаний до 50 рабочих мест, и эту картину я вижу почти везде, где часть первички приходит бумагой или сканами.
Возьмём условный пример — пищевое производство «Домашний вкус», 23 рабочих места. Это модельный расчёт, а не отчёт о внедрении: все цифры ниже — допущения, которые вы подставите свои. Допустим, у них около 45 активных поставщиков сырья и упаковки, в справочнике «Контрагенты» накопилось порядка 1 900 карточек, в номенклатуре — около 3 400 позиций. В день приходит примерно 40 входящих документов (УПД, накладные, акты), в среднем по 8 строк. Это 320 строк в сутки, и каждую нужно привязать к позиции номенклатуры.
Наш модуль распознавания первички устроен как конвейер из десяти стадий, и сама «читалка» — это стадии с четвёртой по шестую: Tesseract 5, при необходимости второй проход PaddleOCR, извлечение полей. Девятая стадия — «сопоставление с 1С»: контрагенты, номенклатура, дубли. Про то, чем отличаются движки распознавания, у нас есть отдельный разбор в этом же цикле статей. Здесь — про девятую стадию, потому что именно она определяет, сколько времени бухгалтер проведёт в карточке документа.
Почему я так упираюсь в справочники. Ошибка чтения заметна: цифра не сошлась с итогом — система подсветит расхождение, человек увидит. Ошибка сопоставления незаметна: документ выглядит идеально, но ушёл на дубль контрагента или на чужую номенклатуру, и в учёте это всплывёт через месяц на сверке или при инвентаризации. Поэтому в нашей схеме документ не проводится из конвейера никогда, а в 1С попадает только непроведённым черновиком после явного «Применить» оператора. О том, как устроены черновики, — в статье про черновики вместо проводок.
Как система находит контрагента: ИНН и КПП, а если ИНН не прочитался
Порядок такой. Первый и главный ключ — пара ИНН + КПП, совпадение точное. ИНН у юридического лица состоит из 10 знаков, у индивидуального предпринимателя — из 12, КПП — 9 знаков; контрольные суммы проверяются на стадии проверки реквизитов, и её мы разобрали отдельно: проверка ИНН, КПП и НДС. Дальше карточка ищется в справочнике по этой паре. Нашлась одна — привязали. Это самый дешёвый и самый надёжный случай, и именно на нём должны закрываться документы постоянных поставщиков.
Почему именно пара, а не один ИНН. КПП назначается при каждой постановке на учёт, поэтому у одной организации может быть несколько КПП: головной офис, филиалы, обособленные подразделения. В структуре КПП первые четыре знака — код налогового органа, следующие два — причина постановки, последние три — порядковый номер. Если сопоставлять только по ИНН, документ от филиала уедет на карточку головной организации. Иногда это допустимо, иногда нет — зависит от того, как вы ведёте расчёты и договоры, но решать это должен ваш учёт, а не алгоритм по умолчанию.
Теперь неприятная часть. Скан бывает плохой: смазанная печать поверх реквизитов, факс, фото под углом. ИНН не читается или контрольная сумма не сходится. Тогда точного ключа нет, и включается нечёткий поиск по наименованию. Тут важна одна вещь, за которую я держусь принципиально: нечёткий поиск даёт подсказку, а не решение. Оператор видит «похоже на такой-то контрагент» и сам подтверждает. Автоматически подставлять контрагента по похожему названию нельзя: «Мукомол-Сервис» и «Мукомол-Сервис Плюс» отличаются одним словом и являются разными юрлицами с разными ИНН.
Что касается ИП, здесь своя граница применимости. У ИП в бланке часто вместо названия — фамилия, а в справочнике карточка может называться по-разному: «ИП Петров А. Б.», «Петров Алексей Борисович ИП». По ИНН из 12 знаков всё сходится идеально, а вот по наименованию — уже с трудом. Поэтому для ИП чтение ИНН — критичное поле, и если в вашем потоке много таких поставщиков, в пилоте стоит отдельно посмотреть, как читаются 12-значные номера. Для тех, кто хочет заранее проверить карточки, подойдёт сервис заполнения реквизитов по ИНН из ИТС, который берёт данные из ЕГРЮЛ/ЕГРИП: он помогает завести карточку правильно с самого начала.
Как сопоставляется номенклатура: артикул поставщика, потом наименование с оценкой похожести
С номенклатурой всё сложнее, чем с контрагентом: у неё нет универсального ключа вроде ИНН. Поэтому порядок двухступенчатый. Сначала ищем по артикулу поставщика: если в бланке есть артикул и в вашей базе он записан у позиции, совпадение, как правило, однозначно. Если артикула нет или он не найден, идёт сопоставление по наименованию с оценкой похожести. Уверенное совпадение подставляется, сомнительное — предлагается оператору списком вариантов. Два порога вместо одного — это и есть суть подхода: подставлять только когда почти уверен, а в остальных случаях показывать кандидатов и не заставлять человека искать по всему справочнику.
В типовых конфигурациях 1С для связки «чужой артикул — наша позиция» обычно есть справочник или регистр номенклатуры контрагентов (в Бухгалтерии 3.0 он используется в электронном документообороте: там сопоставляется наименование и артикул поставщика с вашей номенклатурой). Как он называется и где лежит именно в вашей конфигурации — проверьте в своей версии, это зависит от конфигурации и релиза. Мы определяем источники артикулов на этапе настройки, при разборе ваших справочников: конкретный маппинг под конфигурацию — часть внедрения, а не «магия из коробки».
Что такое «оценка похожести», проще всего показать на общедоступном примере. В PostgreSQL расширение pg_trgm считает похожесть двух строк по триграммам, и результат — число от нуля (совсем разные) до единицы (идентичны). Оператор % возвращает истину, если похожесть выше порога pg_trgm.similarity_threshold, по умолчанию он равен 0,3. Это очень широкий порог: он годится, чтобы набрать кандидатов в список, но никак не для автоматической подстановки. Это иллюстрация принципа, а не описание внутренностей нашего модуля: какие именно метрики и пороги работают у вас, определяется на вашей пачке в пилоте.
CREATE EXTENSION IF NOT EXISTS pg_trgm;
SELECT similarity('Мука пшеничная в/с 50 кг', 'Мука пшеничная высший сорт, мешок 50 кг');
-- индекс под быстрый поиск кандидатов
CREATE INDEX nom_name_trgm ON nomenclature USING GIN (name gin_trgm_ops);
SELECT name FROM nomenclature WHERE name % 'мука пшеничная в/с' ORDER BY similarity(name, 'мука пшеничная в/с') DESC LIMIT 5;
Перед использованием на кириллице проверьте результаты на своей базе и локали: расширение игнорирует «не-словные» символы, а что считается буквой, зависит от настроек базы.
Где тут ловушки, и они не про буквы. Первая — единицы измерения и фасовка. Поставщик выставил «Мука, мешок 50 кг, 20 шт.», а вы ведёте учёт в килограммах: название совпало идеально, но количество надо пересчитать. В обсуждениях среди 1С-специалистов часто отмечают, что при загрузке документов по ЭДО позиция не опознаётся, если у номенклатуры отличаются единицы измерения или характеристики, — та же ловушка ждёт и при сканах. Вторая — «универсальные» строки: «Доставка», «Услуги по договору», «Прочее»: артикула нет, названия одинаковые у десятка поставщиков, а учётная позиция у каждого своя. Третья — синонимы и жаргон: в бланке «дрожжи сух. инст.», в базе «Дрожжи сухие instant». Синонимы из справочников 1С попадают в базу знаний модуля, а правки оператора «было → стало» добавляют туда то, чего в справочниках нет.
Если сравнить подходы к сопоставлению, картина такая. | Подход | Когда работает | Где ломается | |---|---|---| | Точное совпадение по ИНН+КПП | Постоянные поставщики, читаемый скан | Дубли карточек с одинаковой парой | | Артикул поставщика | В бланке есть артикул, он записан в базе | Артикул меняется или не заполнен | | Наименование с оценкой похожести | Разные написания одной позиции | Похожие, но разные товары (фасовка, сорт) | | Шаблон поставщика | Повторяющийся бланк | Поставщик сменил форму документа | | Ручной выбор | Всегда | Дорого по времени при потоке в сотни строк |
Дубли: защита внутри пачки и против того, что уже заведено в 1С
Дубли бывают двух совершенно разных видов, и путают их постоянно. Первый — дубль документа: тот же счёт-фактура заведена дважды. Здесь работает связка «поставщик + номер + дата + сумма». Мы проверяем её в двух плоскостях: внутри загружаемой пачки (бухгалтер сфотографировал один документ дважды, или он лежит и в PDF от поставщика, и в скане с подписью) и против уже заведённого в 1С. Проверка детерминированная, мгновенная и бесплатная — модель для неё не нужна.
Второй вид — дубль карточки в справочнике: два «поставщика» с одним ИНН и КПП или три позиции «Мука пшеничная в/с» с разными кодами. Он не виден на этапе распознавания, но отравляет всё остальное. Логика простая: если пара ИНН+КПП встречается в справочнике дважды, точное совпадение перестаёт быть однозначным, и алгоритму приходится либо выбирать случайно, либо возвращать человеку два кандидата. А есть и второй эффект: проверка дублей документов опирается на поставщика, а значит, документ, заведённый на «вторую» карточку, для неё выглядит как документ другого поставщика. Это моё рассуждение из практики, не свойство конкретной системы, но оно объясняет, почему чистка справочников — не косметика.
В «Домашнем вкусе» (по-прежнему условный пример) допустим, что около 9 % карточек контрагентов — дубли: примерно 170 из 1 900. Причины типовые: карточку заводили разные люди, кто-то не нашёл существующую и создал новую, часть карточек пришла из старой базы. Для 1С это стандартная проблема, и у нас есть отдельная статья про то, как задвоение возникает между 1С и CRM: как убрать задвоение клиентов между менеджерами и бухгалтерией. Корень там тот же, что и у поставщиков: у одной организации несколько карточек, заведённых разными людьми.
Что делать, когда дубль обнаружился до записи? В нашей схеме документ остаётся карточкой в очереди оператора, а не проводкой, поэтому исправить привязку можно до «Применить». А вот если документ уже записан в 1С и проведён вашим бухгалтером, он живёт своей жизнью в учёте — и править его придётся так же, как любой другой документ 1С. Именно поэтому мы против «автопроведения по высокой уверенности» и придерживаемся принципа, зафиксированного в продукте: команда проведения из конвейера запрещена всегда.
Шаблоны поставщиков и обучение на правках оператора: чему учить нельзя
Постоянные поставщики присылают документы в одной и той же форме. Поэтому после того, как оператор одобрил документ, система запоминает макет бланка: где стоит номер, где дата, где итог. Следующий документ этого поставщика читается уже по шаблону — быстрее и стабильнее, чем «с нуля». Стадия извлечения полей работает по цепочке «шаблон → якоря → правила»: сначала пробуем шаблон, затем поиск по опорным словам («Итого», «Счёт-фактура №»), затем общие правила. Если шаблон сработал и проверки чистые, модель перепроверки в каскаде не вызывается вовсе.
Что запоминается кроме шаблонов. В базе знаний хранятся выученные правила, правки оператора в виде «было → стало», синонимы из справочников 1С и статистика качества. Когда бухгалтер исправил привязку строки («не эта позиция, а вон та»), эта правка сохраняется в базе знаний в виде «было → стало». Правила не вечны: неудачное правило отключается само после 10 промахов. Я считаю это важной защитой: поставщик поменял ассортимент или названия, а старое правило продолжает подставлять устаревшую позицию — без самоотключения такой «мусор» копится незаметно.
Теперь главное, ради чего я и пишу этот раздел. Обучение не идёт на документах с неустранёнными ошибками. Логика простая: если в документе итог не сходится со строками или ИНН не проходит контрольную сумму, а оператор всё равно применил его «как есть», то любая правка на этом документе рискует стать правилом. Запомнив ошибку, система будет её воспроизводить. Поэтому на документах с неустранёнными ошибками обучение не идёт вовсе — и оператору в карточке приходится либо устранить замечание (например, ответить комментарием, что в графе «Всего к оплате» на самом деле указано другое значение), либо оставить документ без обучения.
Это создаёт полезную дисциплину. Бухгалтер быстро привыкает: замечание снято — значит, документ пойдёт «в копилку». Замечание висит — значит, документ он доведёт сам, а в базу знаний из него ничего не попадёт. Мне такая асимметрия нравится больше, чем «умный» вариант, в котором система учится на всём подряд: у него после полугода работы невозможно понять, откуда взялась странная подстановка.
Как подготовить справочники до запуска: чек-лист на две недели
Хорошая новость: чистка справочников — работа, которая окупается независимо от того, будете вы внедрять распознавание или нет. Я советую начинать до пилота, а не после. Порядок такой: сначала контрагенты, потом номенклатура, потому что ошибки в контрагентах размножаются в документах быстрее. В 1С есть штатная обработка «Поиск и удаление дублей»: в УТ 11, КА и ERP она лежит в «НСИ и администрирование» — «Администрирование» — «Обслуживание» — «Корректировка данных», в Бухгалтерии 3.0 — в «Администрирование» — «Обслуживание» — «Корректировка данных». Для контрагентов условия сравнения стоит задавать по ИНН и КПП, а не по названию; ссылки в документах на найденный дубль обработка заменяет на оригинал сама. Но результат нужно просматривать глазами: обособленное подразделение имеет тот же ИНН, что и головная организация, но свой КПП, — и отдельная карточка под него может быть корректной, а не дублем.
Перед объединением — резервная копия базы; это не формальность, откатить замену ссылок в документах непросто. Проверьте также справочник «Партнёры», если он у вас есть: дубль партнёра тянет за собой дубль контрагента. Быстро узнать, сколько карточек живёт под одним ИНН, можно и через OData, если база опубликована с этим интерфейсом. Имена реквизитов проверьте в описании сервиса (адрес /odata/standard.odata/$metadata) своей конфигурации, они могут отличаться.
curl -s -u "user:password" -G \
  "https://1c.example.com/base/odata/standard.odata/Catalog_Контрагенты" \
  --data-urlencode "\$format=json" \
  --data-urlencode "\$select=Ref_Key,Description,ИНН,КПП" \
  --data-urlencode "\$filter=ИНН eq '7700000000'"
Дальше номенклатура. Здесь чек-лист короче, но кропотливее. Во-первых, для каждой закупаемой позиции у поставщика зафиксируйте артикул, если он у него есть, — именно с него начинается сопоставление. Во-вторых, вычистите дубли позиций и приведите единицы измерения к единому виду: килограмм — везде килограмм, упаковка — везде упаковка с коэффициентом. В-третьих, для «универсальных» строк вроде доставки заведите отдельные позиции по поставщикам или явные правила. В-четвёртых, для 5–10 крупнейших поставщиков подготовьте образцы документов: по ним будут строиться шаблоны.
Пилот на такой почве идёт спокойно: вы приносите 10–20 сканов типичной первички, мы прогоняем их в режиме dry-run и показываем карточки, замечания и то, что создалось бы в вашей 1С. Пока запись не включена явно, ничего не создаётся — показывается только то, что было бы создано. Какие показатели смотреть на пилоте — что мерить при пилоте в dry-run. А если хотите начать прямо сейчас, пришлите нам 10–20 сканов: прогон бесплатный, в вашем контуре или на нашем стенде.
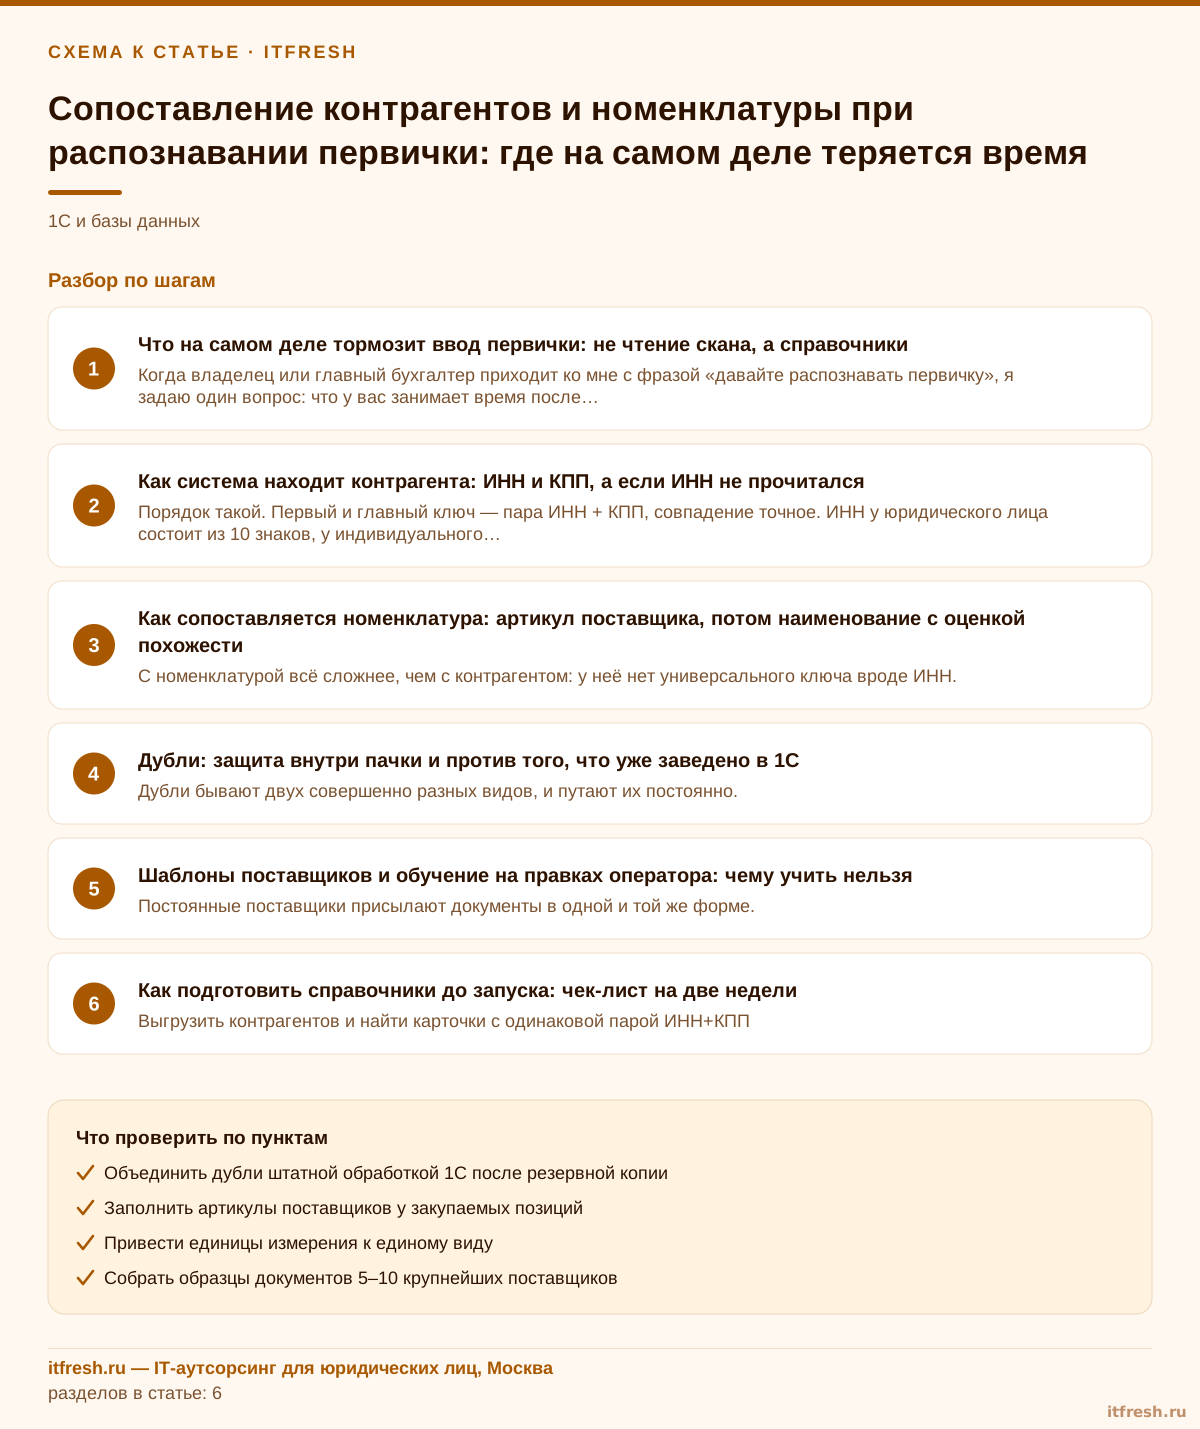
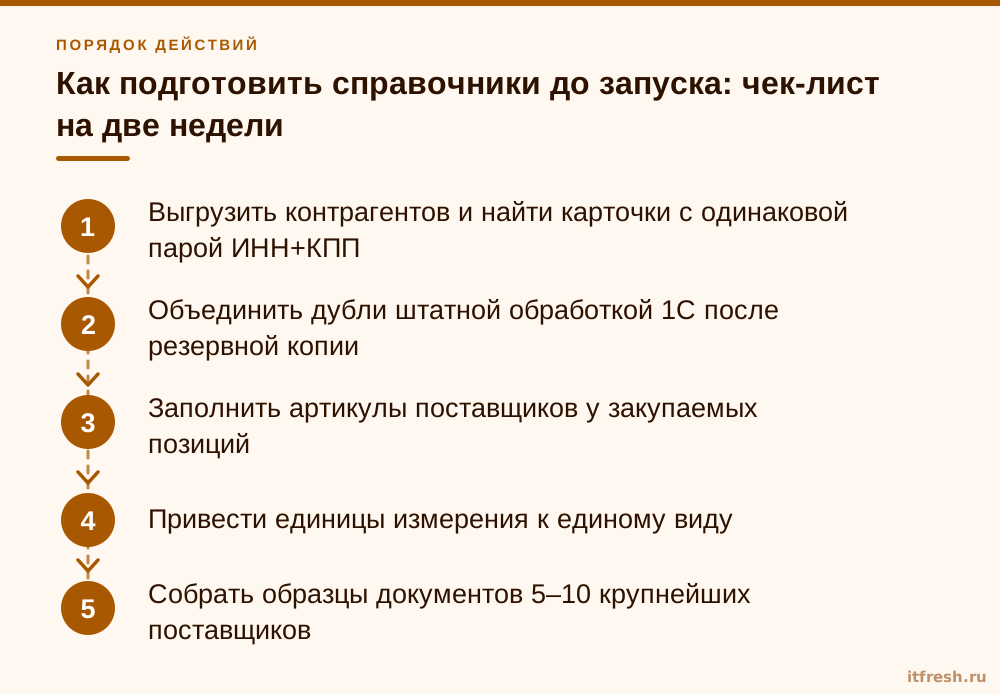
- Выгрузить контрагентов и найти карточки с одинаковой парой ИНН+КПП
- Объединить дубли штатной обработкой 1С после резервной копии
- Заполнить артикулы поставщиков у закупаемых позиций
- Привести единицы измерения к единому виду
- Собрать образцы документов 5–10 крупнейших поставщиков
Модельный расчёт: сколько времени съедает сопоставление и когда это не нужно
Посчитаем на условном «Домашнем вкусе». Допущения (замените своими): 40 документов и 320 строк в день; ручной выбор позиции в справочнике — около 20 секунд на строку; просмотр уже подставленной строки в карточке — около 3 секунд. Это не результаты наших внедрений, а входные данные модели: у вас скорость выбора зависит от вашего справочника, и главное, чтобы вы проверили её секундомером на своих документах.
Если сопоставлять всё руками, выходит 320 × 20 секунд = 6 400 секунд, то есть около 107 минут в день, почти 1 час 47 минут только на привязку. Теперь три сценария по доле строк, которые сопоставляются автоматически без вмешательства: 50 %, 70 % и 85 %. Это тоже допущения — реальную долю покажет пилот на ваших документах, а не эта статья. | Доля авто-сопоставления | Ручной выбор, мин | Просмотр подставленного, мин | Итого, мин/день | |---|---|---|---| | 0 % (всё вручную) | 107 | 0 | 107 | | 50 % | 53 | 8 | 61 | | 70 % | 32 | 11 | 43 | | 85 % | 16 | 14 | 30 | В рабочем месяце из 21 дня разница с ручным режимом получается порядка 16, 22 и 27 часов соответственно. Учтено только сопоставление; ввод, проверка сумм и сверка в этой модели не считаются.
Ключевой вывод: доля авто-сопоставления зависит не от того, насколько «умна» модель, а от чистоты справочников и от того, сколько у вас постоянных поставщиков с шаблонами. Поэтому я всегда предлагаю сначала посмотреть на потоке реальные сканы, и только потом обсуждать сроки: наш MCP-сервер для 1С в dry-run показывает, что именно создалось бы, ничего не записывая. Если хотите прикинуть выгоду в деньгах, а не в минутах, умножьте минуты на вашу ставку часа, а подробную методику расчёта окупаемости мы разбираем отдельно в этом же цикле.
Теперь про границы. Если у вас 5–10 входящих документов в неделю, распознавание не окупится: сначала вычистите справочники, этого будет достаточно. Если поставщики каждый раз новые (разовые закупки, розница) и артикулов нет, то доля автоподстановки будет невысокой, а основную работу всё равно сделает человек. Если документы приходят преимущественно в ЭДО, ситуация другая: там сопоставление опирается на структурированные данные, и вопрос остатка бумаги при ЭДО мы разбираем отдельно. Общую картину по OCR для бухгалтерии я давал в статье про ускорение ввода УПД и накладных. А там, где бумага остаётся, важно до включения записи увидеть, что именно создастся в базе.
Частые вопросы
Чем сопоставление контрагента отличается от сопоставления номенклатуры?
У контрагента есть точный ключ — пара ИНН и КПП, и при читаемом скане совпадение однозначно. У номенклатуры универсального ключа нет: сначала ищем по артикулу поставщика, затем по наименованию с оценкой похожести — уверенное подставляется, сомнительное предлагается оператору.
Что будет, если ИНН на скане не читается?
Включается нечёткий поиск по наименованию контрагента. Он даёт подсказку, которую подтверждает оператор, — автоматически по похожему названию контрагент не подставляется. Замечание в карточке покажет, какие поля стоит проверить.
Почему система не учится на документах с ошибками?
Правка на документе с неустранённым замечанием рискует превратиться в выученное правило и начать воспроизводить ошибку. Поэтому на документах с неустранёнными ошибками обучение не идёт: замечание нужно устранить или снять комментарием. Выученное правило, которое подводит, отключается само после 10 промахов.
Нужно ли чистить справочники до запуска?
Да, и я советую начинать до пилота. Дубли карточек с одинаковой парой ИНН и КПП делают точное совпадение неоднозначным, а разные единицы измерения и незаполненные артикулы снижают долю строк, которые сопоставляются без участия человека. Объединять дубли можно штатной обработкой 1С после резервной копии.
Где искать номенклатуру поставщика в 1С?
В типовых конфигурациях для связки артикулов поставщиков с вашей номенклатурой есть справочник или регистр номенклатуры контрагентов, он же используется при загрузке документов по ЭДО. Название и расположение зависят от конфигурации и релиза, поэтому проверьте в своей версии.
Создаёт ли модуль документы в 1С сам?
Только непроведённые черновики и только после явного нажатия «Применить» оператором. Команда проведения из конвейера запрещена всегда. Пока запись не включена, система работает в dry-run и лишь показывает, что было бы создано.
Источники
- PostgreSQL: pg_trgm — Проверено: similarity() возвращает число от 0 до 1, оператор % сравнивает с порогом pg_trgm.similarity_threshold (по умолчанию 0,3), классы индексов gin_trgm_ops и gist_trgm_ops, неалфавитные символы игнорируются. https://www.postgresql.org/docs/current/pgtrgm.html
- ФНС России: значение ИНН и КПП — Проверено: структура КПП NNNN (код налогового органа) + PP (причина постановки) + XXX (порядковый номер), ИНН организации 10 знаков, физлица/ИП 12. https://www.nalog.gov.ru/rn77/ifns/imns77_47/5955916/
- 1С:ИТС — использование сервиса OData — Проверено: адрес вида .../odata/standard.odata/Catalog_..., параметры $format, $select, $filter, пример отбора по ИНН через eq. https://its.1c.ru/db/content/fresh/src/19956692.html
- 1С:Контрагент (ИТС) — Проверено: заполнение и проверка реквизитов контрагента по ИНН на основе данных ЕГРЮЛ/ЕГРИП. https://v8.1c.ru/its/services/1c-kontragent/
- 1С: поиск и удаление дублей — Проверено: путь НСИ и администрирование — Администрирование — Обслуживание — Корректировка данных (УТ 11; в БП 3.0 — Администрирование — Обслуживание), рекомендация искать дубли контрагентов по ИНН и КПП, подстановка ссылки на оригинал. https://torg.1c.ru/articles/dubli-nomenklatury-kontragentov-dogovorov-i-pr-v-1s-ut-kak-nayti-i-udalit/