Пилот распознавания первички в 1С: как проверить на своих документах и что мерить
Пилот распознавания первички — это прогон 10–20 ваших реальных сканов в режиме dry-run: система показывает, что было бы создано в 1С, но ничего не пишет. Мерьте шесть вещей: долю документов без правок, время до решения, замечания, дубли, тихие ошибки и стоимость сомнения. Ниже — план, таблицы метрик и критерии «стоп / идём дальше».
Что такое пилот распознавания первички и чем он отличается от демо
Пилот — это не презентация с красивыми образцами, а проверка на вашем потоке: те же поставщики, те же кривые фото с телефона, та же 1С. Я сам пишу модуль распознавания и сам его внедряю, поэтому скажу неудобное: решение по чужим примерам и по процентам точности из брошюр принимать нельзя. Единственная честная проверка — ваши документы, ваша база и ваш бухгалтер, который нажимает кнопку. Мы ведём такие проекты в рамках ИТ-аутсорсинга, но схема ниже работает и без нас: метрики и критерии можно применить к любому решению, которое вам предложат.
Основа пилота — режим dry-run. По умолчанию наш модуль ничего не записывает в 1С: пока запись не включена явно, он показывает, что БЫЛО БЫ создано — карточку документа, найденного контрагента, строки номенклатуры, замечания проверок. Бухгалтер видит результат до того, как что-либо появилось в базе. Как устроен конвейер внутри — от подготовки скана до сопоставления со справочниками — я разбирал в статье про OCR-распознавание первички для бухгалтерии. Здесь речь о другом: как организовать проверку, чтобы через несколько недель вы приняли решение на цифрах, а не на впечатлении.
Внедрение у нас идёт в пять шагов: разбор потока, развёртывание, пилот в dry-run на вашей реальной пачке, настройка и обучение, боевой режим. Пилот — третий шаг, но основная часть его успеха закладывается в первом и втором: если пачка подобрана неудачно, а критерии не записаны заранее, любой результат можно истолковать как угодно. Поэтому в статье я иду по шагам и для каждого говорю, что именно нужно подготовить и записать на бумаге.
Чтобы разговор не был абстрактным, я буду вести один модельный пример — строительная компания «СтройГрад», 22 рабочих места, бухгалтерия из главного бухгалтера и одного помощника. Это условный пример, а не отчёт о реальном внедрении: все объёмы, минуты и пороги ниже — допущения, вместо которых вы подставите свои. Смысл примера — показать, как считать, а не какие цифры получатся у вас.
Как разобрать поток и собрать пачку сканов для пилота
Первый шаг — разбор потока, и делается он до любой установки. Мне нужны ответы на три вопроса: какие документы приходят (виды), от кого (постоянные поставщики или разовые) и в какую базу и юрлицо они должны попасть. Отдельно выясняем, что из этого приходит бумагой или сканом, а что уже по ЭДО: электронные документы приходят структурированными, и распознавать их не нужно. Если у компании девять документов из десяти идут через ЭДО, честный итог разбора потока может быть таким: распознавание вам почти не нужно, и пилот можно не начинать. Я предпочту сказать это на первой встрече, чем через месяц.
Дальше собираем пачку. В предложении на странице продукта — 10–20 сканов типичной первички, и я держусь именно этого объёма: меньше не даёт картины, больше на первом прогоне утопит бухгалтера в карточках. Главное правило: не выбирайте лучшие документы. Пачка должна повторять пропорции вашего потока плюс несколько самых неприятных случаев. Именно такую смесь мы просим прислать, чтобы распознавание первички в 1С прогнало её через портал и показало карточки, замечания и то, что создалось бы в вашей базе. Поддерживаются PDF (постранично), JPG, PNG, TIFF, BMP и WEBP, многостраничные PDF режутся сами.
Третье — эталон. Пока пачка не загружена, бухгалтер вручную заполняет эталонную таблицу: по каждому документу тип, поставщик, номер, дата, сумма, НДС и то, что должно получиться в 1С. Заодно с секундомером замеряет, сколько минут уходит на ручной ввод каждого документа. Без эталона метрику «верно или неверно» не посчитать: останутся споры «мне кажется, тут ошибка». А без замера ручного ввода вам нечем будет сравнить время после.
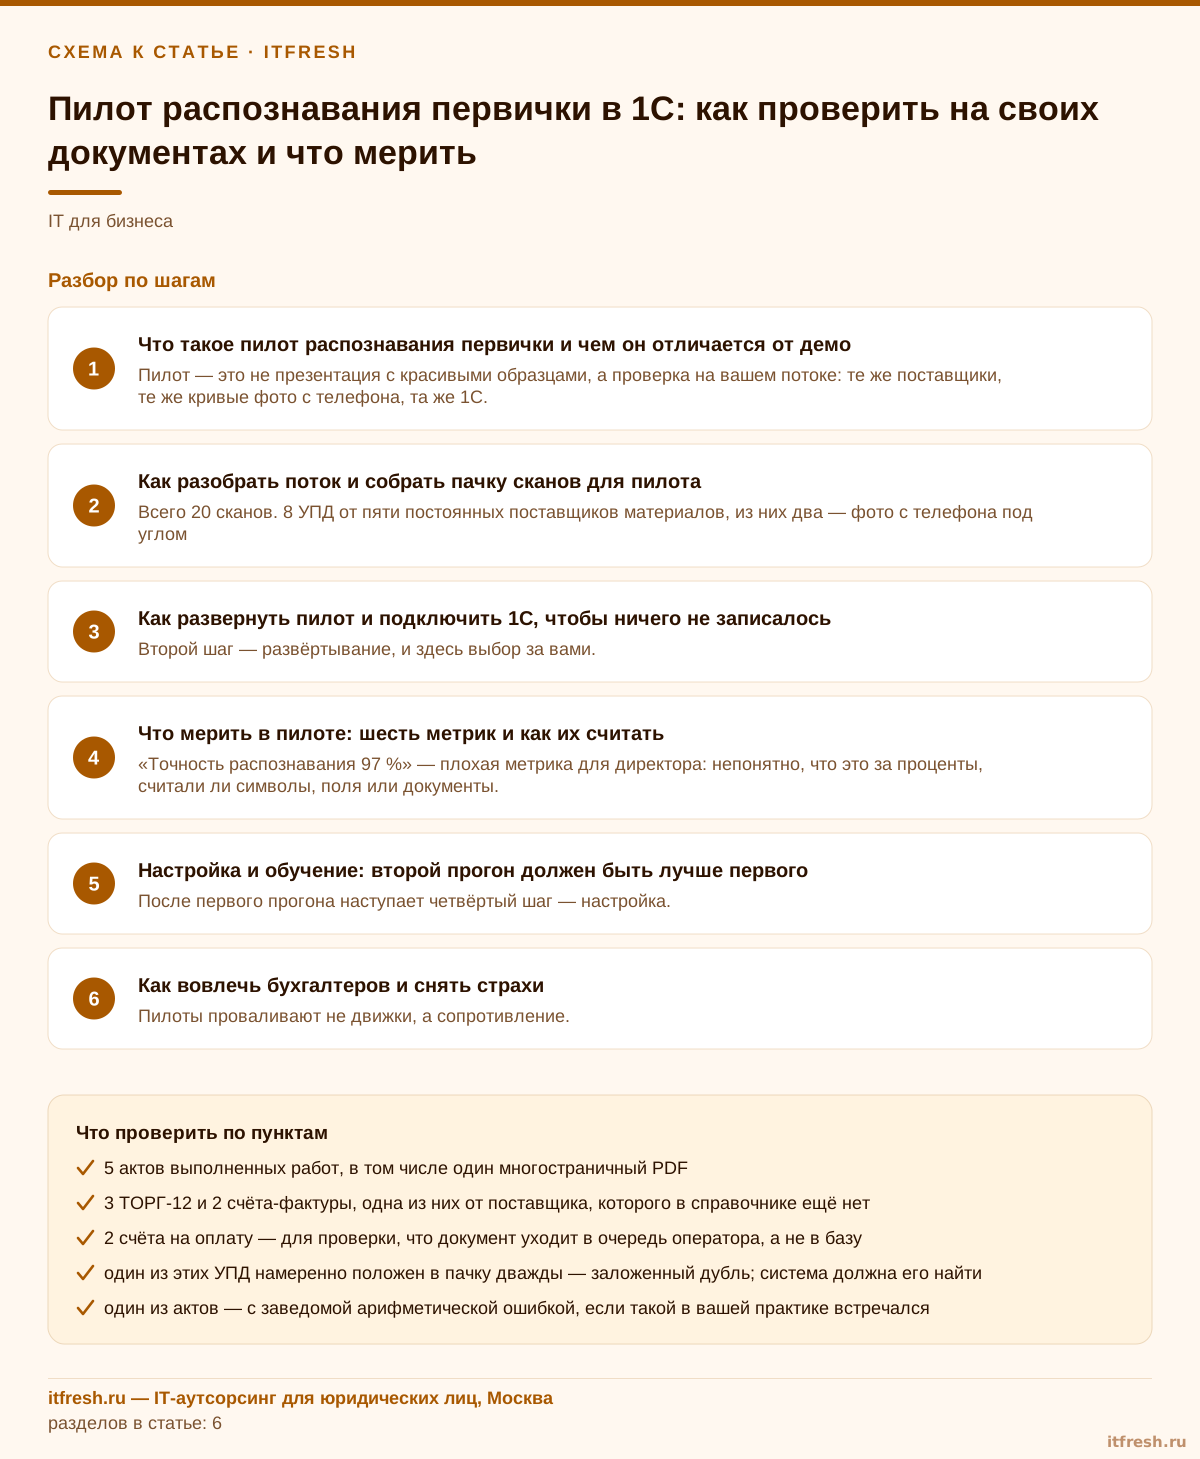
- Всего 20 сканов. 8 УПД от пяти постоянных поставщиков материалов, из них два — фото с телефона под углом
- 5 актов выполненных работ, в том числе один многостраничный PDF
- 3 ТОРГ-12 и 2 счёта-фактуры, одна из них от поставщика, которого в справочнике ещё нет
- 2 счёта на оплату — для проверки, что документ уходит в очередь оператора, а не в базу
- один из этих УПД намеренно положен в пачку дважды — заложенный дубль; система должна его найти
- один из актов — с заведомой арифметической ошибкой, если такой в вашей практике встречался
Как развернуть пилот и подключить 1С, чтобы ничего не записалось
Второй шаг — развёртывание, и здесь выбор за вами. Вариант по умолчанию: отдельная виртуальная машина у вас, CPU-only, видеокарта не нужна; скан и текст не выходят за периметр. Второй вариант: изолированный контур под вашу компанию на наших локальных агентах в ЦОД в Москве, со своими моделями и без вызова внешних API. Третий, облачные модели по вашему выбору, в пилоте я не включаю: сначала посмотрим, что дают локальные проверки и шаблоны, а облако подключим в боевом режиме, если захотите. И даже тогда по умолчанию наружу уходит только уже распознанный текст, не изображения.
Причина осторожности проста: в первичке есть ФИО подписантов, данные ИП и физических лиц. Часть 5 статьи 18 закона о персональных данных (152-ФЗ) в актуальной редакции запрещает запись, систематизацию, накопление, хранение, уточнение и извлечение персональных данных граждан России с использованием баз данных за пределами территории РФ, кроме случаев, указанных в пунктах 2, 3, 4 и 8 части 1 статьи 6 того же закона. Формулировку я сверил по тексту закона в КонсультантПлюс, но применение к вашей ситуации — вопрос к вашему юристу или ответственному за персональные данные. Локальный контур просто снимает вопрос.
Подключение к 1С идёт через веб-публикацию (OData или HTTP-сервис): поддерживаются 1С:Предприятие 8.3, Бухгалтерия 3.0, УНФ, УТ 11, КА, ERP. Адрес стандартного интерфейса OData имеет вид «адрес приложения / odata/standard.odata / идентификатор ресурса», формат ответа задаётся параметром $format=json — так описано в документации 1С:Фреш. Для пилота заведите отдельного пользователя 1С с правами только на чтение: справочников — для сопоставления контрагентов и номенклатуры, и уже заведённых документов — для поиска дублей против базы. Dry-run ничего не записывает, значит, права на запись ему не нужны. Проверить публикацию можно одной командой (имя справочника проверьте в своей конфигурации):
curl -u pilot_reader 'https://1c.example.com/base/odata/standard.odata/Catalog_Контрагенты?$top=1&$format=json'Команда спросит пароль пользователя, вернёт одну запись справочника — и на этом проверка закончена.
Есть нюанс, который важен бухгалтеру больше любых процентов. Стандартный OData платформы умеет не только читать и создавать объекты, но и проводить документы: в документации 1С:Фреш описан метод Post() и парный ему Unpost(). Поэтому запрет проведения — это не ограничение протокола, а осознанное правило нашего модуля: команда проведения из конвейера запрещена всегда, независимо от роли и уверенности. Перед переходом к записи, уже после пилота, я всё равно прошу тестовую копию базы: черновики сначала создаются на ней, а в боевой базе запись включается только при подтверждённой резервной копии.
Что мерить в пилоте: шесть метрик и как их считать
«Точность распознавания 97 %» — плохая метрика для директора: непонятно, что это за проценты, считали ли символы, поля или документы. Меня интересует другое: сколько документов бухгалтер принял без единой правки, сколько времени это заняло и не пропустили ли мы ошибку. Из этого получаются шесть метрик, которые я прошу записать до старта пилота и заполнить по его итогам. Дополнительно фиксируем две вспомогательные: верно ли определён тип документа (он определяется по содержанию, а не по имени файла) и верно ли подобраны контрагент и номенклатура. | Метрика | Как считать | На что смотреть | |---|---|---| | Доля документов без правок | документы, принятые оператором без изменений, делить на все документы пачки | отдельно для постоянных и для новых поставщиков | | Время от скана до решения | от загрузки до статуса «готов к решению» плюс минуты оператора на карточку | машинное время и время человека — раздельно | | Доля замечаний проверок | документы с хотя бы одним замечанием делить на все | какие замечания настоящие, какие ложные | | Дубли | найденные по связке «поставщик, номер, дата, сумма» в пачке и против 1С | заложенный дубль должен найтись | | Тихие ошибки | ошибки, которые система не отметила, а оператор не заметил | цель — ноль по суммам, реквизитам, номерам и датам | | Стоимость сомнения | доля документов, дошедших до перепроверки моделью, и время человека на них | должна падать по мере появления шаблонов |
Самая важная — тихие ошибки, и ловить их надо специально. Детерминированные проверки закрывают реквизиты и арифметику: контрольные суммы ИНН из 10 и 12 знаков, КПП, БИК и расчётный счёт по методике ЦБ, арифметику НДС «в том числе» и «сверху», связку «количество × цена = сумма» и «сумма строк = итог шапки»; подробнее о них — в статье про проверку ИНН, КПП и НДС после распознавания. Но контрольной суммы у номера и даты документа нет. Поэтому после пилота второй человек по оригиналам перепроверяет по эталонной таблице пять-семь документов, принятых без правок, и особенно внимательно смотрит именно номера и даты. Если находится хоть одна тихая ошибка в сумме — это стоп, а не «мелочь».
Про «стоимость сомнения». Перепроверка задаётся режимом на пачку: «каскад», «строгая» (две модели и арбитр) или «выключена». Уровень 0 — проверки и шаблоны, они ничего не стоят. Уровень 1 — бюджетная модель смотрит текст только при сомнении, это доли копейки. Уровень 2 — вторая модель, если первая не уверена, копейки. Арбитр — сильная модель, только при расхождении, и это редко. Если проверки чистые и уверенность высокая или сработал проверенный шаблон поставщика, модель не вызывается вовсе. В пилоте замеряйте, какая доля документов дошла до каждого уровня. В локальном контуре без облака эта метрика — про число сомнительных документов и время человека на них, а не про рубли: так я её читаю.
И последнее: не сравнивайте скорость с цифрами со страницы продукта. Там заявлено, что на одной ВМ обрабатываются сотни документов в час; на пилоте из 20 документов это не проверить, да и не нужно. Ваш вопрос — не «как быстро машина читает», а «сколько времени бухгалтер тратит от загрузки скана до решения по карточке».
Настройка и обучение: второй прогон должен быть лучше первого
После первого прогона наступает четвёртый шаг — настройка. Начинаем с маппинга видов документов на результат в 1С. По умолчанию логика такая: УПД (статусы 1 и 2) даёт поступление и счёт-фактуру, ТОРГ-12 — поступление с запасами, счёт-фактура — счёт-фактуру полученную, акт выполненных работ или услуг — поступление с расходами. Счёт на оплату, платёжное поручение, ТТН, кассовые документы и чеки уходят в очередь оператора, неизвестный вид сохраняется текстом и тоже уходит в ручную очередь. Набор видов и то, куда они заводятся, настраивается под вашу конфигурацию при внедрении.
Затем справочники и шаблоны. Контрагента система ищет по точному совпадению ИНН и КПП; если ИНН не читается, работает нечёткий поиск по наименованию с подсказкой, которую подтверждает оператор. Номенклатура ищется сначала по артикулу поставщика, затем по наименованию с оценкой похожести: уверенное совпадение подставляется, сомнительное предлагается. Как это устроено и где ломается, я описал отдельно — про сопоставление контрагентов и номенклатуры. Для пилота важно одно: утверждайте шаблоны только у постоянных поставщиков. После одобрения запоминается макет бланка — где номер, дата, итог, — и следующий документ читается по шаблону.
Как проверить, что обучение работает? Возьмите на второй прогон новые документы тех же поставщиков, а не те же самые сканы. Иначе вы проверите память, а не обучение. Правки оператора «было → стало» попадают в базу знаний вместе с шаблонами, якорями и синонимами из справочников 1С, а выученные правила, которые дают промахи, отключаются сами после 10 промахов. Есть и неочевидное ограничение: обучение не идёт на документах с неустранёнными ошибками. Поэтому не закрывайте карточку «для галочки»: если замечание не снято, документ в обучение не попадёт. Сама база знаний — PostgreSQL с расширением pgvector в вашем контуре; если готовите ВМ сами, расширение включается в нужной базе командой из документации pgvector:
CREATE EXTENSION vector;Отдельный вопрос — плохое фото. Скан проходит подготовку (300 DPI, контраст, шум, выравнивание), затем распознавание в Tesseract 5 (русский и английский), а при низкой уверенности включается второй проход — PaddleOCR, версия PP-OCRv5, которую разработчики описывают как решение для сложных сценариев — рукописного текста (в их описании речь о китайском и английском), вертикального текста, редких символов. Не верьте этому описанию на слово, тем более для кириллицы, — проверьте на своих самых плохих сканах. Если и второй проход не помог, документ честно помечается низкой уверенностью, а замечания показывают, какие поля проверить. Для пилота это правильный исход: плохой документ с низкой уверенностью — нормально, а плохой документ с высокой уверенностью и ошибкой — провал.
Если у вас в компании есть кому запустить Tesseract, можно сделать полезный контрольный опыт: прогнать самый плохой скан голым движком и сравнить результат с карточкой портала. Синтаксис из документации Tesseract — ключ -l с языками через плюс:
tesseract scan.png - -l rus+engДля этого в системе должны быть установлены языковые данные rus и eng. Опыт не обязателен, но он быстро показывает, сколько работы делает не сам движок, а всё, что вокруг него: подготовка скана, проверки, шаблоны и сопоставление.
Как вовлечь бухгалтеров и снять страхи
Пилоты проваливают не движки, а сопротивление. На каждом старте я слышу три вопроса. Первый: «Заменит ли это меня?» Нет: система готовит черновики, а бухгалтер смотрит карточки и нажимает «Применить». Работа смещается от набора к проверке. Сокращать ли штат — решение директора, и пилот его не принимает; я не обещаю сокращений и не советую подавать пилот как экономию на людях. Второй: «Кто отвечает, если ошибка?» Запись в 1С происходит только после явного «Применить», каждое решение подписывается учётной записью оператора, документов, проведённых без человека, ноль: проведение из конвейера запрещено. Третий: «А если плохой скан?» Ответ — в предыдущем разделе: низкая уверенность и подсказка, какие поля проверить.
Что помогает на практике. Пусть бухгалтер сам выбирает пачку и сам формулирует критерии успеха: тогда результат — его, а не навязанный нами. Дайте ему право вето: если он говорит, что карточкам нельзя доверять, мы разбираем каждый случай, а не спорим. Ведите журнал замечаний, где каждая запись — «что, в каком документе, что ожидалось», а не «плохо работает». И раз в неделю на двадцать минут садитесь разбирать карточки вместе: половина недоверия исчезает, когда человек видит, что его правка попала в базу знаний.
Роли в портале помогают развести ответственность. Есть режим ввода документов, режим просмотра и анализа только для чтения и отчёт о заведённом за период с выгрузкой в Excel; роли для ввода и анализа отдельные. Главному бухгалтеру и директору я обычно даю просмотр: цифры видны, а право записи остаётся у оператора. В модельном «СтройГраде» ответственный за пилот — главный бухгалтер, помощник — оператор ввода, директор смотрит отчёт. Три человека, три роли, никто не оценивает других по скорости.
Чего я не делаю. Не сравниваю бухгалтеров между собой по числу карточек в час. Не подгоняю пачку, если результат получился неприятным. И насторожился бы, если бы пилот вышел идеальным: пачка, в которой ни разу не сработало замечание, скорее всего, слишком чистая, и вы измерили не свой поток, а хорошие сканы.
Критерии «стоп» и «идём дальше»: как принять решение по итогам пилота
Пороги задаются до пилота и записываются: иначе после получения цифр их будут двигать под желаемый вывод. Ниже — мои ориентиры для модельного «СтройГрада». Это допущения для примера, а не гарантии продукта и не отраслевые нормативы: ваши значения могут отличаться, и это нормально. | Сигнал | Идём дальше | Стоп или доработка | |---|---|---| | Тихие ошибки в суммах, реквизитах, номерах, датах | ноль на перепроверенных документах | любая — стоп, пока не найдена причина | | Документы без правок у постоянных поставщиков | на втором прогоне не меньше 60 % (допущение) | не растёт от прогона к прогону | | Время оператора на карточку | не больше половины ручного (в модели — до 6 минут при 12 ручных) | не меньше ручного ввода | | Замечания проверок | понятные, единичные ложные | шум, бухгалтер перестал их читать | | Заложенный дубль | найден | не найден |
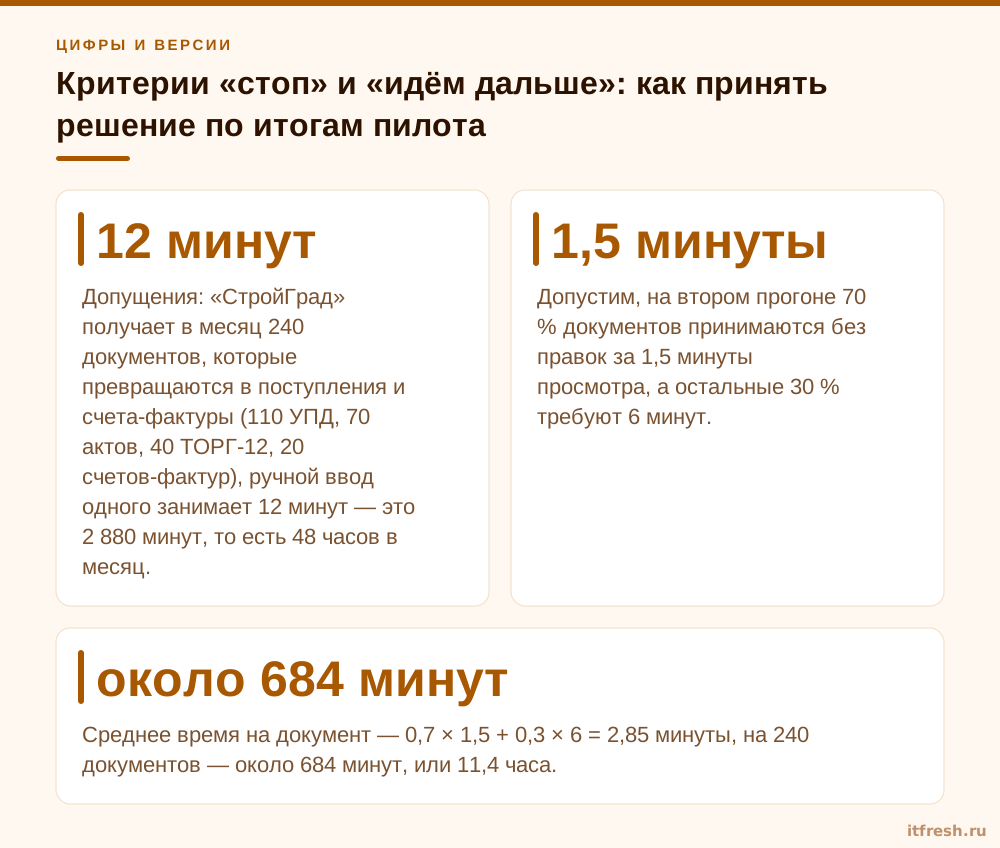
Теперь модельный расчёт, чтобы порог «половина времени» не висел в воздухе. Допущения: «СтройГрад» получает в месяц 240 документов, которые превращаются в поступления и счета-фактуры (110 УПД, 70 актов, 40 ТОРГ-12, 20 счетов-фактур), ручной ввод одного занимает 12 минут — это 2 880 минут, то есть 48 часов в месяц. Допустим, на втором прогоне 70 % документов принимаются без правок за 1,5 минуты просмотра, а остальные 30 % требуют 6 минут. Среднее время на документ — 0,7 × 1,5 + 0,3 × 6 = 2,85 минуты, на 240 документов — около 684 минут, или 11,4 часа. Все входные цифры условные; свои вы возьмёте из секундомера и эталонной таблицы. Как превратить это в деньги, разобрано в статье про то, как считать окупаемость.
Когда я говорю «стоп». Если поток в основном идёт по ЭДО и бумаги мало. Если девять документов из десяти приходят от разовых поставщиков: шаблоны не сработают, останется только общее распознавание, и выигрыш будет скромнее. Если бухгалтерия принципиально не готова проверять карточки: система без проверяющего человека нам не нужна, у нас нет режима проведения без человека. Если найдена хотя бы одна тихая ошибка в сумме и её причину не удалось устранить. И если документов в месяц несколько десятков: ручной ввод может оказаться дешевле, чем весь проект.
Когда «идём дальше», наступает пятый шаг — боевой режим. Запись черновиков включается явно, только в разрешённые поля и при подтверждённой резервной копии; только непроведённые документы, только после «Применить» оператора; настраиваются роли и отчёты, а облачные модели подключаются, если вы этого хотите. Если хотите увидеть всё это на своих документах — пришлите 10–20 сканов, и мы прогоним ваши сканы в dry-run бесплатно, в вашем контуре или на нашем стенде. Решение после этого остаётся за вами и вашим бухгалтером, а мы отдаём цифры и карточки.
Частые вопросы
Сколько документов нужно для пилота распознавания первички?
Для первого прогона в режиме dry-run хватает 10–20 сканов типичной первички, как в нашем предложении. Учтите: на такой выборке один документ — это 5–10 процентных пунктов, поэтому по отдельным процентам судить рано. Смотрите на характер ошибок и на то, как меняются метрики на втором прогоне с новыми документами тех же поставщиков.
Запишет ли пилот что-нибудь в нашу 1С?
Нет. По умолчанию действует dry-run: система показывает, что было бы создано, но не пишет. Запись включается только явно, создаются лишь непроведённые черновики, и только после «Применить» оператора. Проведение документов из конвейера запрещено всегда, независимо от роли и уверенности.
Нужны ли для пилота видеокарта и мощный сервер?
Нет. Модуль работает на CPU, видеокарта не нужна, производительность масштабируется числом ядер. В варианте по умолчанию это отдельная виртуальная машина без видеокарты в вашем контуре; альтернатива — изолированный контур ITfresh в ЦОД в Москве.
Можно ли проводить пилот на документах с персональными данными?
В локальном контуре — да, скан и текст не выходят за периметр. Часть 5 статьи 18 закона 152-ФЗ ограничивает хранение и обработку персональных данных граждан РФ в базах за пределами территории России, за исключением случаев из пунктов 2, 3, 4, 8 части 1 статьи 6. Применение к вашей ситуации согласуйте с юристом или ответственным за персональные данные.
Что мы получим, если после пилота решим не внедрять?
Эталонную таблицу, замеры ручного ввода, карточки и журнал замечаний — это ваши данные, и они пригодятся при оценке любого другого решения. Судьбу данных пилота на нашем стенде оговорите заранее письменно.
Как отличить честный пилот от подогнанного?
Пачку выбирает бухгалтер, а не поставщик; в ней есть самые плохие сканы, заложенный дубль и новый поставщик; пороги записаны до старта; пять-семь принятых без правок документов перепроверяет второй человек по оригиналам. Если ни одного замечания не появилось, подозрительна сама пачка.
Источники
- 1С:Фреш — работа со стандартным интерфейсом OData — Проверено: формат адреса «…/odata/standard.odata/…», параметр $format=json, создание и изменение объектов методами POST и PATCH/PUT, проведение методом Post() и отмена Unpost(). https://1cfresh.com/articles/data_odata
- Федеральный закон № 152-ФЗ, статья 18 (КонсультантПлюс) — Проверена дословная формулировка части 5 о локализации баз данных с персональными данными граждан РФ и исключениях из пунктов 2, 3, 4, 8 части 1 статьи 6. https://www.consultant.ru/document/cons_doc_LAW_61801/cbf4e15b7c330f9372e876cdf2bc928bad7950ef/
- Tesseract OCR — Command Line Usage — Проверен синтаксис выбора нескольких языков ключом -l LANG[+LANG], пример tesseract images/eurotext.png - -l eng+deu. https://tesseract-ocr.github.io/tessdoc/Command-Line-Usage.html
- Tesseract OCR — Data Files — Проверено, что существуют наборы языковых данных tessdata, tessdata_fast и tessdata_best. https://tesseract-ocr.github.io/tessdoc/Data-Files.html
- pgvector — репозиторий и документация — Проверено: расширение включается командой CREATE EXTENSION vector; один раз в каждой базе, тип vector хранит векторы заданной размерности. https://github.com/pgvector/pgvector
- PaddleOCR — описание PP-OCRv5 — Проверено назначение PP-OCRv5: сложные сценарии — рукописный китайский и английский текст, вертикальный текст, редкие символы; приведены замеры на CPU и GPU. https://www.paddleocr.ai/latest/en/version3.x/algorithm/PP-OCRv5/PP-OCRv5.html