Локальное распознавание документов бухгалтерии: почему сканы первички не должны уходить в облако
Сканы первички содержат персональные данные и коммерческую тайну, поэтому безопаснее распознавать их на своём сервере или в изолированном контуре, а не в чужом облаке. Для печатных документов видеокарта не нужна: хватает CPU-ВМ. Ниже: что требует 152-ФЗ, три схемы размещения, модельный расчёт и чек-лист вопросов вендору.
Что на самом деле лежит в сканах первички и почему это не просто картинки
Скан УПД выглядит безобидно: бумага как бумага, только в PDF. Но если открыть каталог со сканами за один месяц у любой бухгалтерии, там окажется вся коммерческая жизнь компании. Цены закупки и цены продажи, артикулы и наименования номенклатуры, условия из договоров, банковские реквизиты и расчётные счета, ИНН, подписи, ФИО руководителей и материально ответственных лиц. У поставщиков-ИП добавляются ФИО, ИНН и адрес. Я много лет занимаюсь защитой информации в небольших компаниях, и мой первый вопрос к любой схеме обработки документов всегда один: куда физически попадает файл после нажатия «загрузить».
Внутри такого файла я вижу три разных слоя, и с каждым связан свой риск. Первый слой — персональные данные: любая информация о конкретном человеке, а фамилия и инициалы подписанта в сочетании с должностью и ИНН предпринимателя под это определение подходят. Второй — коммерческая тайна и просто деловая информация: закупочные цены, скидки, состав и объёмы поставок, которые конкурент с удовольствием увидел бы одним списком. Третий — служебные данные: реквизиты счетов, номера договоров, схема расчётов с контрагентами. Поэтому когда мы проектировали наш модуль распознавания первички, я исходил из простого допущения: скан — это не картинка, а документ, и первым делом нужно решить, где он обрабатывается.
Есть и практическая сторона, которую часто упускают. В облачной схеме скан получает не только «сервис распознавания», а вся цепочка: провайдер, его хостинг, системы логирования, иногда подрядчик по разметке или дообучению. Я не утверждаю, что кто-то там читает ваши УПД, — вопрос не в недоверии, а в контроле. Если файл ушёл за периметр, вы больше не управляете тем, сколько копий существует, как долго они хранятся и кто имеет доступ. Локальная схема этот вопрос просто снимает: копия одна, и она в вашей инфраструктуре.
Что требует 152-ФЗ, когда скан уходит к внешнему распознавателю
Начну с оговорки: я не юрист, а разработчик и внедренец, поэтому ниже — то, что я проверил по тексту закона в КонсультантПлюс, и то, что обычно обсуждаю с юристами клиентов. Первое — часть 5 статьи 18 закона № 152-ФЗ. Она обязывает оператора при сборе персональных данных обеспечить запись, систематизацию, накопление, хранение, уточнение и извлечение персональных данных граждан Российской Федерации с использованием баз данных, находящихся на территории России. Исключения перечислены в пунктах 2, 3, 4 и 8 части 1 статьи 6. Для первички смысл такой: если сканы с ФИО хранятся и накапливаются в чьей-то базе, эта база должна находиться в России.
Второе — статья 12 о трансграничной передаче. По части 3 оператор обязан уведомить Роскомнадзор о намерении осуществлять такую передачу до её начала, причём отдельным уведомлением, не совмещённым с уведомлением по статье 22. Часть 5 требует заранее получить от иностранного получателя сведения о мерах защиты и правовом режиме. Летом 2026 года в статью внесены очередные изменения (Федеральный закон от 26.07.2026 № 265-ФЗ), и часть новой редакции может вступать в силу не сразу, так что текст нужно сверять на день внедрения. Практический вывод для нас: если в запросе к зарубежному API большой языковой модели есть персональные данные, по общему правилу это трансграничная передача, и «мы отправляем только текст» её не отменяет. Как именно квалифицировать ваш поток, пусть скажет юрист. В распознанном тексте остаются те же ФИО и ИНН, пропадает лишь картинка с подписью и печатью.
Третье — статья 6, часть 3: поручение обработки другому лицу. Оператор вправе поручить обработку по договору, где должны быть определены перечень персональных данных, перечень действий, цели обработки и обязанность исполнителя соблюдать конфиденциальность, требования части 5 статьи 18, статьи 18.1 и меры защиты по статье 19. При этом перед субъектом данных отвечает оператор, то есть вы, а не подрядчик. Если вы отдаёте сканы интегратору или облачному сервису, вы заключаете именно такой договор. Отдельно проверьте у юриста, нужно ли в вашей ситуации согласие субъектов: формулировка закона допускает поручение с согласия субъекта, если иное не предусмотрено федеральным законом.
Четвёртое — коммерческая тайна. По статье 10 закона № 98-ФЗ меры охраны включают перечень сведений, ограничение доступа и порядок обращения с ними, учёт лиц, получивших доступ, регулирование отношений с работниками и контрагентами по договорам и гриф «Коммерческая тайна» на носителях. Внешний сервис распознавания — это контрагент, поэтому его место должно быть прописано в вашем режиме. Как встроить нейросетевые сервисы в такой режим на уровне правил для сотрудников, я разбирал в материале про политику использования нейросетей в компании, здесь же нас интересует сам конвейер.
Что касается денег, по данным КонсультантПлюс, с 30 мая 2025 года штрафы за утечки персональных данных выросли и зависят от масштаба: для организаций — от 3 до 5 млн рублей при утечке данных от 1 000 до 10 000 человек (или от 10 000 до 100 000 идентификаторов), от 5 до 10 млн — от 10 000 до 100 000 человек, от 10 до 15 млн — свыше 100 000. За повторную утечку предусмотрен оборотный штраф — от 1 до 3 процентов годовой выручки, но не менее десятков миллионов рублей и не более 500 млн, а за неуведомление Роскомнадзора об утечке — отдельный штраф. Точные пороги и суммы сверяйте по статье 13.11 КоАП РФ в актуальной редакции. Для типичной бухгалтерии на 40–50 рабочих мест число субъектов в сканах обычно намного меньше порогов «утечечных» составов, но другие составы статьи 13.11 о нарушениях порядка обработки никто не отменял. Поэтому я не пугаю цифрами: главный риск — не штраф, а необходимость объяснять проверяющему и контрагентам, почему их реквизиты оказались у стороннего сервиса.
Три схемы размещения: где физически обрабатывается скан
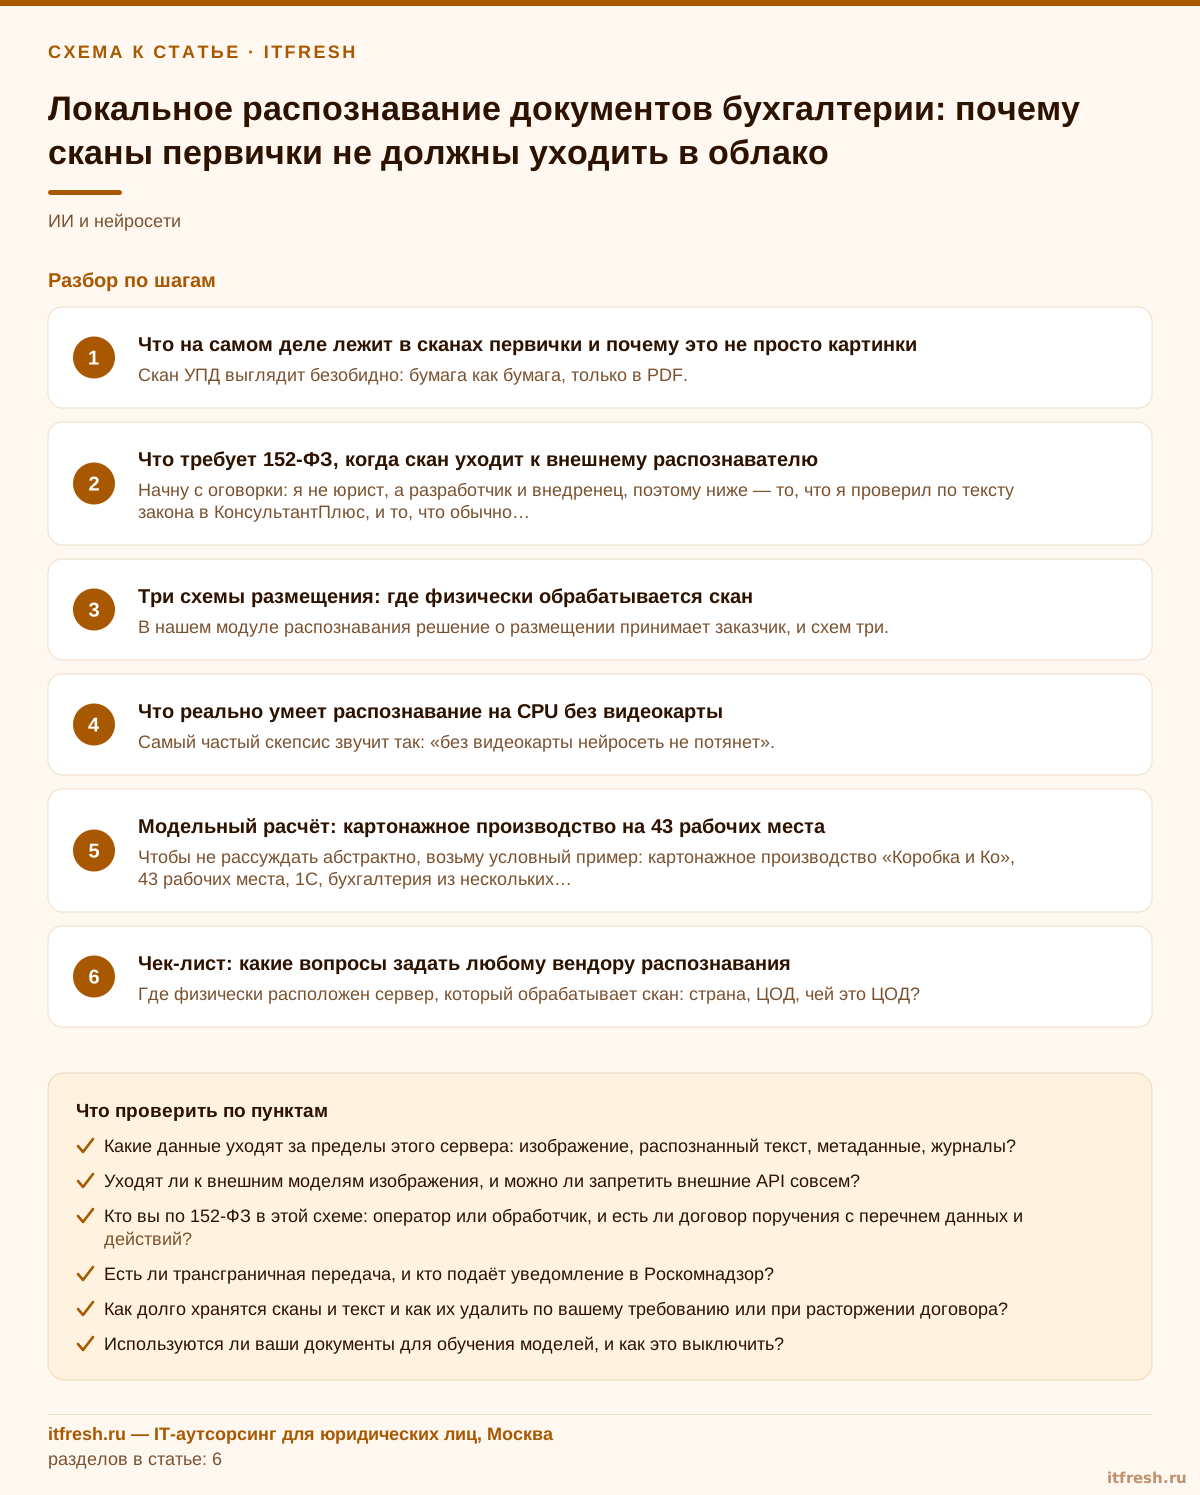
В нашем модуле распознавания решение о размещении принимает заказчик, и схем три. Сначала сведу их в таблицу, потом разберу, где какая работает лучше. | Схема | Где обрабатывается | Что уходит наружу | Когда выбираю | |---|---|---|---| | 1. Сервер заказчика | Отдельная CPU-ВМ без видеокарты в вашей инфраструктуре | Ничего: скан и текст остаются у вас | Требования службы безопасности, 152-ФЗ, нет желания вести договор поручения | | 2. Изолированный контур интегратора | ЦОД в Москве, отдельный контур под компанию, свои модели | Внешние API не вызываются | Нет своей площадки или админа, но нужен запрет на внешние сервисы | | 3. Облачные модели по выбору | Ваш сервер или наш контур плюс внешняя модель | Только распознанный текст, не изображения, и только когда локальных проверок мало | Сложные документы, где локальный конвейер сомневается |
Схема 1 — базовая, и по умолчанию я предлагаю именно её. Конвейер работает на отдельной виртуальной машине без видеокарты, скан и текст не выходят за периметр компании. С точки зрения 152-ФЗ это самая простая позиция: нет передачи третьему лицу, нет договора поручения, нет вопроса о трансграничности. Цена — вы обслуживаете ещё одну ВМ: обновления, резервная копия, мониторинг. Если у вас уже есть виртуализация и админ, это не проблема; если нет, вторая схема удобнее.
Схема 2 — изолированный контур в нашем ЦОД в Москве: отдельное окружение под вашу компанию со своими моделями, внешние API оттуда не вызываются. Честно скажу про границу: это уже поручение обработки. Скан физически лежит у нас, значит, нужен договор по статье 6 закона № 152-ФЗ, и вы вправе потребовать схему потоков и подтверждения. Зато вам не нужны своя площадка и человек, который будет её поддерживать.
Схема 3 — облачные модели по выбору: GPT, Claude, Gemini, DeepSeek, Qwen, GigaChat или YandexGPT. По умолчанию им уходит только уже распознанный текст, не изображения, и только когда локальных проверок недостаточно. Тут я всегда прошу заказчика зафиксировать письменно, какие модели разрешены. Зарубежный провайдер — это статья 12 и уведомление Роскомнадзора. Отечественный снимает вопрос трансграничности, если обработка действительно происходит в России (это надо подтвердить у провайдера), но не снимает вопрос поручения. Как выбирать рантайм и модели для собственного сервера, если вы всё-таки хотите большую языковую модель у себя, я подробно писал в разборе про локальные ИИ-модели и Ollama; здесь фокус другой — документооборот бухгалтерии и закон.
Что реально умеет распознавание на CPU без видеокарты
Самый частый скепсис звучит так: «без видеокарты нейросеть не потянет». Для распознавания печатных документов это неверно. Основа нашего конвейера — Tesseract 5: по документации проекта, пятая версия вышла 30 ноября 2021 года, а LSTM-движок работает начиная с 4.0, причём хорошо на x86 и Linux. Мы используем его на русском и английском, а перед этим готовим скан: 300 DPI, контраст, шум, выравнивание. Это не прихоть, в документации Tesseract прямо сказано, что он лучше всего работает на изображениях от 300 dpi, а перекос и шум заметно снижают точность. Как выбирать между движками под свой поток, я разобрал в статье про Tesseract, PaddleOCR и языковые модели, здесь только то, что важно для локальной схемы.
Второй проход — PaddleOCR PP-OCRv5 для сложных мест, куда Tesseract не уверен. Для русского языка в документации PaddleOCR есть отдельные модели распознавания: eslav_PP-OCRv5_mobile_rec (русский, белорусский, украинский и английский) и cyrillic_PP-OCRv5_mobile_rec. Для сложных таблиц у нас отдельная очередь на PP-StructureV3 — это конвейер разбора структуры документа (обнаружение разметки, таблицы, печати), и документация приводит замеры инференса на процессоре для каждой его модели, так что видеокарта не обязательна. Абсолютные цифры из этих замеров переносить на своё железо нельзя: они получены на Xeon Gold 6271C, поэтому скорость нужно мерить на пилоте.
По ресурсам я даю ориентиры со страницы продукта, а не выдуманные конфигурации ВМ. Конвейер CPU-only, видеокарта не нужна, масштабируется числом ядер, обработка идёт до 30 документов параллельно на пачку плюс резерв для оператора, а производительность — сотни документов в час на одной ВМ. Сколько ядер и памяти нужно именно вам, зависит от вашей пачки, и это как раз то, что мы измеряем на пилоте. Хорошая новость: Tesseract сам подсказывает, как раскладывать нагрузку. В FAQ проекта сказано, что для обработки большого числа изображений лучший вариант — по одному процессу на ядро, а многопоточность отключается переменной OMP_THREAD_LIMIT=1. Простейший пример пакетной обработки папки сканов на всех ядрах выглядит так:
export OMP_THREAD_LIMIT=1
ls *.png | xargs -P "$(nproc)" -I{} tesseract {} {}.out -l rus+eng
Первая строка отключает внутреннюю многопоточность, вторая запускает по процессу на каждое ядро (nproc возвращает их число). Это иллюстрация принципа, а не наш боевой конвейер: у нас поверх идут проверка файла, подготовка, извлечение полей и сопоставление с 1С.
Отдельно про роль моделей. Чтобы локальный контур не превращался в дорогой эксперимент, большая часть проверок у нас детерминированная: контрольные суммы ИНН, КПП, БИК и расчётного счёта, арифметика НДС, «количество на цену равно сумма», дубли документов. Они бесплатны и мгновенны. Модель включается только при сомнении, и в каскаде её не вызывают вовсе, если проверки чистые и уверенность высокая или сработал проверенный шаблон поставщика. Как устроены эти проверки по шагам, я подробно разбираю в отдельном материале цикла, здесь важен сам принцип: чем больше решается правилами, тем реже нужна любая модель, локальная или облачная.
Модельный расчёт: картонажное производство на 43 рабочих места
Чтобы не рассуждать абстрактно, возьму условный пример: картонажное производство «Коробка и Ко», 43 рабочих места, 1С, бухгалтерия из нескольких человек. Это модельный расчёт, а не отчёт о реальном внедрении: все цифры ниже — допущения, которые вы замените своими. Допущу, что в месяц приходит около 900 документов бумагой или сканом (УПД, накладные, акты, счета-фактуры) и в среднем по 1,8 страницы на документ, то есть около 1 600 страниц. Допущу также, что 30 процентов документов приходится на последние три рабочих дня месяца.
Считаю. Средняя нагрузка — 900 документов на 21 рабочий день, около 43 документов в день. Пиковая — 270 документов за три дня, то есть около 90 в день. Против заявленной производительности «сотни документов в час на одной ВМ» это означает: даже в пик виртуальная машина занята считаные десятки минут в сутки. Видеокарта не нужна, отдельный сервер под конвейер тоже: хватит отдельной CPU-ВМ на имеющемся гипервизоре. Схему 1 я бы выбрал для такого клиента, если у него есть админ, и схему 2, если нет. Режим перепроверки в каскаде я бы на пилоте оставил «выключена» или «каскад» без облачных моделей, пока юрист не согласует список разрешённых провайдеров.
Как проверить, что скан действительно не уходит за периметр? Не верить на слово ни мне, ни вендору. Во время пилота обработайте пачку и посмотрите исходящие соединения ВМ. Показать установленные TCP-соединения и процессы, которым они принадлежат, можно так:
sudo ss -tnp state establishedА чтобы увидеть любой трафик наружу, в обход внутренних сетей, запустите перехват на время обработки пачки:
sudo tcpdump -ni any 'not net 10.0.0.0/8 and not net 192.168.0.0/16 and not net 172.16.0.0/12'Если вы после проверки хотите жёстко закрыть исходящий трафик ВМ, в Ubuntu это делается правилами ufw: запретить исходящие по умолчанию и разрешить нужные сети, например sudo ufw default deny outgoing и sudo ufw allow out to 10.0.0.0/8. Только сначала продумайте, что ещё должна видеть машина (DNS, обновления, мониторинг), иначе вы отрежете себе доступ. Если компонент работает в контейнере, для полной изоляции сетевого стека в Docker есть флаг --network none: по документации, внутри контейнера тогда создаётся только петлевой интерфейс.
И последний шаг расчёта — что происходит с результатом. Распознанное превращается в черновики документов в 1С, а не в проводки: команда проведения из конвейера запрещена всегда, запись идёт только после явного «Применить» оператора, и до включения записи система работает в режиме dry-run, показывая, что было бы создано. Это важно и для безопасности: даже ошибка распознавания не превращается в бухгалтерскую операцию без человека. Как устроена эта часть, я описал в статье про черновики вместо проводок.
Чек-лист: какие вопросы задать любому вендору распознавания
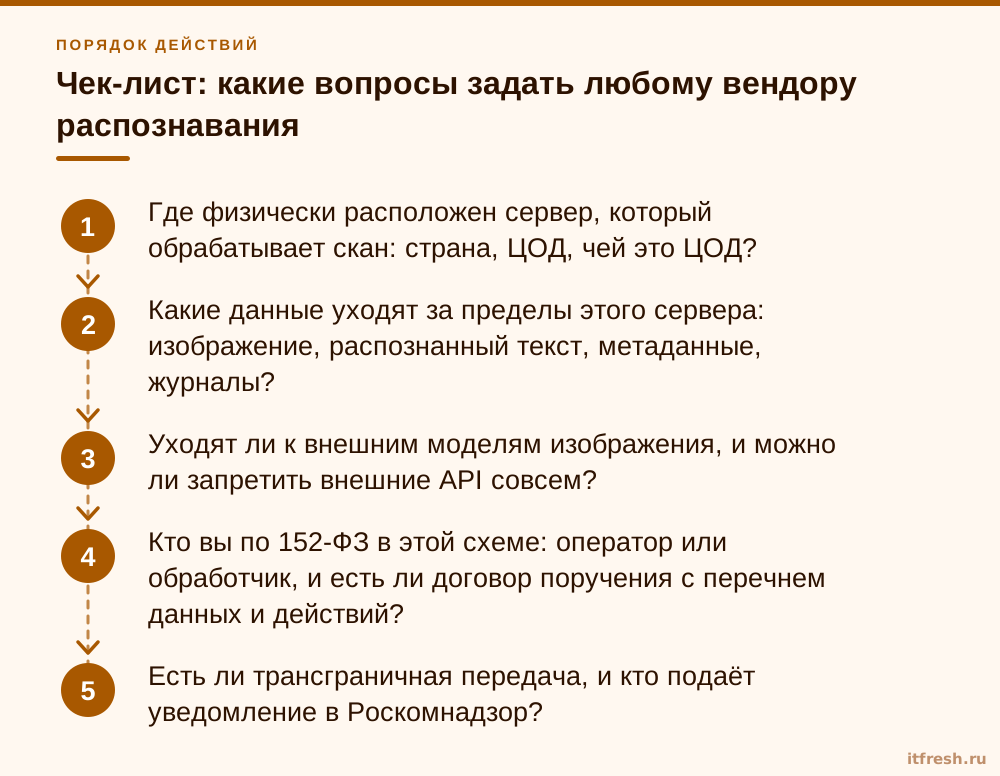
Ниже список, с которым я бы сам пошёл к любому поставщику распознавания первички, включая нас. Он одинаково полезен и при сравнении облачных сервисов, и при обсуждении локальной установки. Ответы «у нас всё безопасно» и «данные шифруются» не считаются: просите конкретику и письменный ответ.
Как читать ответы. Если вендор не может нарисовать схему потоков данных с указанием юрисдикции каждого узла, это плохой знак: значит, он сам не знает, где живёт ваш скан. Если хранение «на усмотрение провайдера» без срока и без процедуры удаления, у вас проблема со статьёй 18 и с режимом коммерческой тайны. Если на вопрос про обучение на ваших данных отвечают уклончиво, считайте, что обучение идёт. Локальная установка эти вопросы снимает не магически, а потому что ответы на них проверяемы: вы сами видите сервер, сеть и журналы.
- Где физически расположен сервер, который обрабатывает скан: страна, ЦОД, чей это ЦОД?
- Какие данные уходят за пределы этого сервера: изображение, распознанный текст, метаданные, журналы?
- Уходят ли к внешним моделям изображения, и можно ли запретить внешние API совсем?
- Кто вы по 152-ФЗ в этой схеме: оператор или обработчик, и есть ли договор поручения с перечнем данных и действий?
- Есть ли трансграничная передача, и кто подаёт уведомление в Роскомнадзор?
- Как долго хранятся сканы и текст и как их удалить по вашему требованию или при расторжении договора?
- Используются ли ваши документы для обучения моделей, и как это выключить?
- Что пишется в журнал и кто его может читать: кто из сотрудников вендора видит ваши документы?
Когда локальный контур не нужен, где он ошибается и с чего начать
Локальное распознавание — не универсальный ответ. Если у вас пара десятков документов в месяц, ручной ввод обходится дешевле, чем любая установка, локальная или облачная. Если сканы уже заведомо публичные и не содержат ни персональных данных, ни сведений, которые вы считаете тайной, облачный сервис проще. А вот бухгалтерская первичка почти всегда содержит ФИО подписантов и цены, так что для неё я по умолчанию иду от локальной схемы и включаю внешние модели только сознательно.
Есть и границы качества. Печатный документ нормального качества CPU-конвейер читает уверенно, а вот плохое фото, рукописные пометки и нестандартные бланки — слабое место любого движка. В нашем модуле плохое фото проходит подготовку, при низкой уверенности включается второй движок, а если и это не помогло, документ честно помечается низкой уверенностью, и замечания показывают, какие поля проверить. Я не обещаю процента точности на вашей бумаге: единственный честный способ узнать — прогнать ваши документы. На странице продукта есть сквозной тест на смешанной пачке (67 из 67 типов определены верно), но это тест типа документа, а не гарантия по каждому полю.
Порядок действий у меня такой. Первое — за один день инвентаризировать, какие документы идут сканами и какие данные в них есть. Второе — выбрать схему размещения и согласовать её со службой безопасности и юристом. Третье — прогнать ваши сканы в dry-run: пришлите 10–20 типичных документов, и мы покажем карточки, замечания и то, что создалось бы в вашей 1С, бесплатно, в вашем контуре или на нашем стенде. Что именно стоит мерить на таком пилоте, я расписал в статье про пилот распознавания в режиме dry-run.
Частые вопросы
Можно ли отправлять сканы первички в облачный сервис распознавания по 152-ФЗ?
Закон не запрещает это напрямую, но накладывает условия. Хранение и накопление персональных данных граждан РФ должно идти в базах на территории России (часть 5 статьи 18), поручение обработки оформляется договором (часть 3 статьи 6), а трансграничная передача персональных данных требует уведомления Роскомнадзора до её начала (статья 12). Проверьте актуальную редакцию и покажите схему юристу.
Если отправлять внешней модели только текст, а не изображение, это безопасно?
Безопаснее, но вопрос не снят. В распознанном тексте остаются ФИО, ИНН, реквизиты и цены, то есть те же персональные данные и деловая информация. Исчезает только картинка с подписью и печатью. Поэтому условия статей 6 и 12 152-ФЗ и режим коммерческой тайны остаются в силе.
Нужна ли видеокарта для локального распознавания документов?
Для печатной первички нет. В нашем модуле конвейер работает на процессоре: Tesseract 5, PaddleOCR PP-OCRv5 и PP-StructureV3 для сложных таблиц. Ресурсы масштабируются числом ядер, сколько нужно именно вам, определяем на пилоте на вашей пачке.
Чем схема «изолированный контур интегратора» отличается от собственного сервера?
При собственном сервере скан не покидает вашу инфраструктуру. В изолированном контуре в ЦОД интегратора в Москве обработка идёт в отдельном окружении под вашу компанию без вызова внешних API, но это уже поручение обработки: нужен договор по статье 6 закона № 152-ФЗ и прозрачная схема потоков.
Как проверить, что распознавание действительно не отправляет данные наружу?
Обработайте пилотную пачку и посмотрите исходящие соединения сервера: ss -tnp state established покажет процессы с открытыми TCP-соединениями, а tcpdump с фильтром на внешние сети покажет любой трафик за пределы ваших подсетей. Для контейнера полная изоляция сети — флаг --network none.
Может ли модуль сам провести документ в 1С?
Нет. Из конвейера команда проведения запрещена всегда, независимо от роли и уверенности. Создаются только непроведённые черновики, запись идёт после явного «Применить» оператора, а пока запись не включена, система работает в режиме dry-run.
Источники
- КонсультантПлюс: Федеральный закон № 152-ФЗ «О персональных данных» — Проверено: часть 5 статьи 18 (локализация баз данных, исключения в пунктах 2, 3, 4, 8 части 1 статьи 6), части 3, 4, 5 статьи 12 (уведомление Роскомнадзора о трансграничной передаче, редакция от 26.07.2026 № 265-ФЗ, часть изменений не вступила в силу), часть 3 статьи 6 (поручение обработки). https://www.consultant.ru/document/cons_doc_LAW_61801/cbf4e15b7c330f9372e876cdf2bc928bad7950ef/ ; https://www.consultant.ru/document/cons_doc_LAW_61801/e4ebbe1780de623c7cf32a59ca82a7bb523a25dd/ ; https://www.consultant.ru/document/cons_doc_LAW_61801/315f051396c88f1e4f827ba3f2ae313d999a1873/
- КонсультантПлюс: Федеральный закон № 98-ФЗ «О коммерческой тайне», статья 10 — Меры охраны конфиденциальности: перечень сведений, ограничение доступа, учёт лиц, договорное регулирование, гриф «Коммерческая тайна». https://www.consultant.ru/document/cons_doc_LAW_48699/0ca1b144b64eaa68cd80ca51ad37ac4047c47775/
- КонсультантПлюс: Персональные данные: новые штрафы с 30 мая 2025 года — Штрафы по статье 13.11 КоАП РФ: за утечки по масштабу, оборотный штраф за повторную утечку (1–3 процента выручки, минимум 20–25 млн, максимум 500 млн рублей), пороги 1 000/10 000/100 000 субъектов, штраф 1–3 млн за неуведомление РКН об утечке. https://www.consultant.ru/legalnews/28492/
- Tesseract OCR: документация (FAQ и Improving the quality of the output) — Переменная OMP_THREAD_LIMIT и рекомендация запускать по одному процессу на ядро; рекомендация изображений от 300 dpi; влияние перекоса и шума; версия 5.0.0 от 30.11.2021, LSTM-движок с 4.0. https://tesseract-ocr.github.io/tessdoc/FAQ.html ; https://tesseract-ocr.github.io/tessdoc/ImproveQuality.html ; https://tesseract-ocr.github.io/tessdoc/
- PaddleOCR: документация PP-OCRv5 и PP-StructureV3 — Модели распознавания eslav_PP-OCRv5_mobile_rec и cyrillic_PP-OCRv5_mobile_rec для русского; PP-StructureV3 — конвейер разбора структуры документа с замерами инференса на CPU (Intel Xeon Gold 6271C). https://www.paddleocr.ai/latest/en/version3.x/algorithm/PP-OCRv5/PP-OCRv5_multi_languages.html ; https://www.paddleocr.ai/latest/en/version3.x/pipeline_usage/PP-StructureV3.html
- Docker Docs: none network driver — Флаг --network none изолирует сетевой стек контейнера, внутри создаётся только петлевой интерфейс. https://docs.docker.com/engine/network/drivers/none/