
n8n и LLM-агент для входящих счетов: письмо → извлечение → 1С → напоминание об оплате
Ящик buh@ разгребают руками: открыть письмо, найти счёт, переписать ИНН, номер, сумму и НДС в 1С, положить PDF в папку, а потом ещё вспомнить про срок оплаты. В оптовой компании на 24 рабочих места это около двух часов в неделю и стабильно один-два просроченных счёта в квартал. Ниже — как я собираю этот конвейер на n8n с LLM внутри: какие ноды беру, какой JSON Schema отдаю модели, чем ловлю её враньё до записи в базу, как кладу черновик документа в 1С через OData и как потом напоминаю об оплате. С конфигами, цифрами и списком того, что у меня не заработало.
Что в потоке счетов реально автоматизируется, а что нет
Разберём поток честно. В компанию на 20–50 рабочих мест в месяц приходит 250–600 писем на общий бухгалтерский ящик. Счетов среди них 100–250. Дальше человек делает четыре механические операции: достаёт вложение, читает из него восемь-десять реквизитов, заводит их в 1С, кладёт файл в сетевую папку. И одну неавтоматизируемую: решает, платить ли вообще и когда.
Вот эти четыре механические операции и надо снять. Я никогда не делаю пятую. Мне регулярно приносят идею «пусть агент сам решает, что оплатить, ведь у него есть остаток на счёте и бюджет» — нет. Ошибка на этом шаге стоит денег напрямую, а не времени. LLM в моём конвейере — это парсер документа, а не финансовый директор. Она превращает картинку и текст в структуру, и на этом её полномочия заканчиваются.
Отсюда и архитектура: жёсткий детерминированный конвейер, внутри которого ровно один нечёткий шаг — извлечение. Всё до него и всё после него — обычный код и обычные HTTP-запросы. Такой конвейер отлаживается, воспроизводится и не разваливается, когда провайдер модели поменяет поведение. «Автономный агент, который сам решит, что делать с письмом» выглядит эффектнее на демо и хуже живёт в проде: у него нет стабильной точки, где можно поставить проверку.
Что попадает в автоматику: приём и дедупликация письма, вытаскивание текста из PDF или скана, извлечение реквизитов в фиксированную структуру, проверка этой структуры арифметикой и справочниками, создание непроведённого документа в 1С, уведомление ответственного и напоминание о сроке. Что остаётся человеку: одобрение сомнительных случаев и сама оплата.
- Приём и дедупликация — IMAP-триггер + ключ «отправитель + Message-ID + хэш вложения».
- Извлечение текста — Extract From File для цифровых PDF, vision-модель для сканов и фото.
- Извлечение реквизитов — Information Extractor со строгой JSON Schema.
- Валидация — контрольная сумма ИНН, сходимость сумм и НДС, проверка контрагента по справочнику.
- Запись — POST в стандартный интерфейс OData 1С, документ создаётся непроведённым.
- Напоминание — расписание, выборка неоплаченного из 1С, сообщение ответственному.
Стенд: «Скрепка-Опт», 24 рабочих места, счета от 60 поставщиков
Условная компания «Скрепка-Опт» — оптовая торговля канцтоварами, 24 рабочих места, 1С:Бухгалтерия 3.0 и 1С:Управление торговлей 11.5 на одном сервере, один общий ящик buh@ на корпоративном почтовом сервере, входящих счетов около 110 в месяц от 60 постоянных поставщиков бумаги, пластика и офисной мелочи. Больно было так: бухгалтер и менеджер по закупкам тратили на ввод по часу в неделю каждый, а в декабре, в пик сезона перед школьными закупками, просрочили счёт на 180 тысяч и получили пени по договору — просто потому, что письмо утонуло в потоке.
n8n я поставил на отдельную виртуалку: Debian 12, 4 vCPU, 8 ГБ RAM, 60 ГБ диска, всё в Docker Compose рядом с PostgreSQL. На такой нагрузке никакого queue mode и воркеров не нужно — это оверинжиниринг для 110 документов в месяц, одиночный процесс справляется с многократным запасом. Компоуз-минимум, на котором это живёт:
services:
  postgres:
    image: postgres:16-alpine
    environment:
      POSTGRES_DB: n8n
      POSTGRES_USER: n8n
      POSTGRES_PASSWORD: ${PG_PASS}
    volumes: [ "./pgdata:/var/lib/postgresql/data" ]
    restart: unless-stopped

  n8n:
    image: docker.n8n.io/n8nio/n8n:2.38.7
    depends_on: [ postgres ]
    environment:
      DB_TYPE: postgresdb
      DB_POSTGRESDB_HOST: postgres
      DB_POSTGRESDB_DATABASE: n8n
      DB_POSTGRESDB_USER: n8n
      DB_POSTGRESDB_PASSWORD: ${PG_PASS}
      N8N_ENCRYPTION_KEY: ${N8N_KEY}
      GENERIC_TIMEZONE: Europe/Moscow
      TZ: Europe/Moscow
    volumes: [ "./n8n:/home/node/.n8n" ]
    ports: [ "127.0.0.1:5678:5678" ]
    restart: unless-stopped
Версию образа я всегда прибиваю гвоздями, а не беру latest. n8n выпускает релизы почти ежедневно — на момент, когда я это пишу, релиз с пометкой Latest — 2.38.7 от 11 сентября 2026, а пре-релизная ветка уже 2.39.5. Обновляться раз в квартал с чтением changelog — нормально; ловить регресс ноды на проде из-за автоматического latest — нет. Заодно сразу закройте порт на localhost и выведите наружу через свой nginx с TLS: интерфейс n8n в интернет голым не выставляют никогда.
Про лицензию, раз это корпоративный контур. n8n распространяется под Sustainable Use License 1.0, и её ключевая формулировка — вы можете использовать и модифицировать софт «only for your own internal business purposes or for non-commercial or personal use». То есть автоматизировать собственную бухгалтерию на self-hosted n8n можно бесплатно и законно. А вот продавать клиентам хостинг n8n как сервис — уже нет, для этого нужна коммерческая лицензия. Файлы с .ee. в имени вообще под отдельной Enterprise-лицензией.
- Отдельная ВМ под n8n: Debian 12, 4 vCPU, 8 ГБ RAM, 60 ГБ диска — с запасом на 110 счетов в месяц.
- PostgreSQL вместо встроенного SQLite: история выполнений и таблица ключей идемпотентности в одной базе.
- Образ n8n с прибитой версией, обновление раз в квартал после чтения changelog.
- Порт 5678 только на 127.0.0.1, наружу — через nginx с TLS и ограничением по IP офиса.
- N8N_ENCRYPTION_KEY и пароль БД — в .env вне репозитория, плюс копия ключа в менеджере паролей.
- Ежесуточный дамп PostgreSQL и тома ./n8n: без ключа шифрования восстановленные учётки не расшифруются.
Приём письма: IMAP-триггер и разбор вложений
Старт — нода Email Trigger (IMAP). Три параметра, которые определяют, заработает конвейер или нет. Первый: Format. Ставьте Resolved — именно этот режим отдаёт вложения бинарными данными, пригодными для следующих нод. Simple документация прямо не рекомендует для писем с инлайновыми вложениями, а RAW отдаёт base64url без разбора payload и вам придётся парсить MIME руками. Второй: Download Attachments — документация советует включать его только при необходимости, потому что он увеличивает нагрузку на обработку; для счетов он нужен, так что включаем осознанно. Третий: Action — «Mark as Read» или «None».
С Action связана первая типовая ошибка. Если поставить None и не завести собственную дедупликацию, при каждом переподключении вы рискуете переобработать письма. Я делаю так: Action = Mark as Read, плюс собственный ключ идемпотентности. Ключ считаю как SHA-256 от связки «нормализованный адрес отправителя + Message-ID + sha256 каждого вложения» и складываю в таблицу PostgreSQL. Пришло письмо с уже виденным ключом — конвейер останавливается на первой же ноде. Это дёшево и снимает 90 % кошмаров с дублями документов в 1С.
В расширенных настройках есть Custom Email Rules — фильтр в синтаксисе поисковой функции node-imap, и Force Reconnect — интервал принудительного переподключения в минутах. Второе понадобится обязательно: IMAP-сессии на некоторых серверах тихо умирают, триггер остаётся «живым», а письма не приходят. У «Скрепки-Опт» я ставлю Force Reconnect на 30 минут и отдельным расписанием раз в час проверяю, что за последний час триггер вообще что-то видел.
Дальше Switch разводит вложения по типу. Цифровой PDF (тот, из которого извлекается текстовый слой) идёт в ноду Extract From File с операцией Extract From PDF. Она же умеет CSV, XLSX, XLS, ODS, HTML, JSON, ICS, RTF, текст и Move File to Base64 String — последнее пригодится для сканов. Если после извлечения текста в PDF меньше 200 символов — это скан, и он уходит в vision-ветку картинкой. XLSX-счета встречаются реже, но встречаются: их я парсю Extract From XLSX и отдаю модели уже в виде текста, а не картинки — дешевле и точнее.
- Format: Resolved — вложения приходят бинарями.
- Download Attachments: включить — без него вложений на выходе ноды не будет.
- Action: Mark as Read + свой ключ идемпотентности в БД.
- Force Reconnect: 30 минут, плюс внешний сторож «давно ли были письма».
- Custom Email Rules — фильтр по отправителю/теме, если ящик общий и шумный.
Извлечение реквизитов: Information Extractor и строгая схема
Для извлечения я беру не AI Agent, а Information Extractor. Разница принципиальная: агент — это цикл с инструментами, он может ходить по кругу, звать тулзы и тратить токены; экстрактор делает ровно один проход «текст → структура». Для счёта это ровно то, что нужно. Кстати, про агента полезно знать: настройка типа агента объявлена устаревшей начиная с n8n 1.82.0, все ноды AI Agent теперь работают как Tools Agent, а старая v1-версия ноды будет выпилена в n8n 3.0. Если у вас в старых воркфлоу торчит выбор типа агента — это долг, который скоро придёт.
У Information Extractor есть параметр Schema Type с тремя вариантами: From Attribute Descriptions (перечисляете атрибуты с описаниями), Generate From JSON Example (даёте пример, схема строится по именам и типам свойств) и Define using JSON Schema. Я беру третий и только третий. У Generate From JSON Example есть ловушка, честно описанная в документации: n8n делает все поля обязательными. Для счёта это гарантированная беда — КПП у ИП не бывает в принципе, срок оплаты часто не указан, и модель начнёт эти поля выдумывать, лишь бы удовлетворить схему. Вот моя рабочая схема:
{
  "type": "object",
  "additionalProperties": false,
  "required": ["doc_number", "doc_date", "supplier_inn", "total", "currency", "lines"],
  "properties": {
    "doc_number":    { "type": "string" },
    "doc_date":      { "type": "string", "description": "ISO 8601, YYYY-MM-DD" },
    "supplier_name": { "type": ["string", "null"] },
    "supplier_inn":  { "type": "string", "description": "10 или 12 цифр, только цифры" },
    "supplier_kpp":  { "type": ["string", "null"] },
    "bank_bik":      { "type": ["string", "null"] },
    "bank_account":  { "type": ["string", "null"] },
    "total":         { "type": "number" },
    "vat_amount":    { "type": ["number", "null"] },
    "vat_mode":      { "type": "string", "enum": ["vat20", "vat10", "vat0", "none", "unknown"] },
    "currency":      { "type": "string", "enum": ["RUB", "USD", "EUR", "CNY"] },
    "pay_due_date":  { "type": ["string", "null"] },
    "lines": {
      "type": "array",
      "items": {
        "type": "object",
        "additionalProperties": false,
        "required": ["name", "qty", "price", "sum"],
        "properties": {
          "name":  { "type": "string" },
          "unit":  { "type": ["string", "null"] },
          "qty":   { "type": "number" },
          "price": { "type": "number" },
          "sum":   { "type": "number" }
        }
      }
    }
  }
}
Обратите внимание на две вещи. Первая: схема плоская, без единой ссылки $ref. Это не стилистика — в документации Structured Output Parser n8n прямым текстом пишет, что ссылки через $ref в JSON-схемах не поддерживаются, и я не рассчитываю, что экстрактор, построенный на той же схемной механике, поведёт себя иначе. Строка позиции у меня продублирована инлайном именно поэтому. Красиво было бы вынести line в $defs и сослаться — красиво не заработает. Вторая: vat_mode как enum вместо свободной строки. Пока это была строка, я получал «НДС 20 %», «в т.ч. НДС 20 %», «Без налога (НДС)» и «НДС не облагается» — четыре формы одного смысла, и каждую приходилось нормализовать кодом. Enum переносит нормализацию внутрь модели, где она делается бесплатно и точнее.
В системный промпт (у ноды для этого есть опция System Prompt Template) я кладу три инструкции: не додумывать отсутствующее — ставить null; суммы возвращать числом в единицах валюты, а не строкой с пробелами и запятыми; если в файле несколько счетов — извлекать первый и выставить признак multi_doc. Последнее — реальный кейс: поставщики любят слать сшитый PDF из трёх счетов, и без явной инструкции модель тихо смешивает позиции из разных документов в один массив lines. Это самая коварная ошибка из всех, потому что итоговая сумма при ней внешне правдоподобна.
- Schema Type — только Define using JSON Schema: Generate From JSON Example делает все поля обязательными.
- Необязательные реквизиты (КПП, БИК, срок оплаты) — тип ["string", "null"], а не пропуск поля.
- Перечислимые значения (режим НДС, валюта) — enum, чтобы не нормализовать формулировки кодом.
- Никаких `$ref` и `$defs` — вложенные объекты расписываются инлайн.
- System Prompt Template: «не додумывай — ставь null», суммы числом, признак multi_doc для сшитых PDF.
- Температуру модели — в ноль или минимум, который допускает провайдер: здесь нужна повторяемость, а не фантазия.
Валидация: тут работает код, а не модель
Между экстрактором и 1С у меня стоит Code-нода на 120 строк. Она не делает ничего умного — только арифметику и справочники. И именно она поймала подавляющее большинство ошибок за первые два месяца эксплуатации у «Скрепки-Опт»: 9 случаев на 220 документов, то есть около 4,1 %. Из них 6 — расхождение суммы позиций с итогом (обычно из-за скана плохого качества, где 8 читается как 3), 2 — неверная контрольная сумма ИНН, 1 — тот самый сшитый многосчётный PDF.
Первая проверка — контрольные разряды ИНН. Это чистая арифметика по весовым коэффициентам, десятизначный и двенадцатизначный считаются по-разному, реализуется за двадцать строк и отсекает почти все ошибки OCR в ключевом поле. Вторая — сходимость: сумма всех lines[].sum должна совпасть с total с допуском в 1 копейку на позицию, накопленным на округлениях. Третья — НДС: при vat_mode = vat20 величина vat_amount должна быть близка к total × 20 / 120, допуск тот же. Четвёртая — дата: doc_date не в будущем и не старше 180 дней.
Пятая проверка — внешняя, по ИНН. Я дёргаю DaData: POST https://suggestions.dadata.ru/suggestions/api/4_1/rs/findById/party с заголовком Authorization: Token <ключ> и телом {"query": "7707083893"}. Бесплатного лимита в 10 тысяч запросов в сутки хватает любой компании нашего размера с огромным запасом (ограничение по частоте — 30 запросов в секунду с одного IP). Из ответа мне нужны два поля: наименование — чтобы сверить с извлечённым supplier_name, и статус — чтобы поймать ликвидированного контрагента до, а не после оплаты. Второе за год сработало у меня дважды, и оба раза это были неприятные сюрпризы для клиента.
Дальше маршрутизация. Прошло все проверки и контрагент уже есть в справочнике 1С — конвейер идёт до конца сам. Не прошло хоть что-то или контрагент новый — документ уходит в очередь ручной проверки: сообщение в Telegram ответственному с картинкой счёта, извлечённым JSON и указанием, какая именно проверка не прошла. Человек правит и подтверждает. Я сознательно не делаю «автоисправление силами второй модели»: это добавляет ещё один нечёткий шаг там, где уже есть точный ответ у человека, и удлиняет цикл разбора вместо того, чтобы его укоротить.
- Контрольная сумма ИНН — 10 и 12 знаков считаются по разным весам.
- Сумма позиций = итог, допуск копейка на позицию.
- НДС сходится с режимом: total × 20 / 120 для vat20.
- Дата счёта не в будущем и не старше 180 дней.
- БИК — 9 цифр, расчётный счёт — 20 цифр (в идеале — с проверкой контрольного ключа по БИК).
- Контрагент по ИНН существует и не ликвидирован — DaData или ФНС.
- Флаг multi_doc не поднят.
Запись в 1С: стандартный интерфейс OData без сюрпризов
В 1С я хожу через штатный OData-интерфейс — он описан в руководстве разработчика платформы 1С:Предприятие 8.3 (раздел про стандартный интерфейс OData в главе о механизме интернет-сервисов) и не требует доработки прикладного кода конфигурации. Два условия. Первое: база опубликована на веб-сервере с включённой галкой публикации стандартного интерфейса OData. Второе — то, на чём спотыкаются все: нужно явно задать состав стандартного интерфейса OData — методом глобального контекста УстановитьСоставСтандартногоИнтерфейсаOData() из обработки или через готовую обработку настройки состава, — иначе метаданные вернутся пустыми и вы будете полчаса думать, что сломалась публикация. Проверяется за секунду:
curl -s -u 'odata_bot:PASSWORD' \
  'http://1c.corp.local/buh/odata/standard.odata/$metadata' | head -c 400

# контрагент по ИНН
curl -s -u 'odata_bot:PASSWORD' \
  "http://1c.corp.local/buh/odata/standard.odata/Catalog_Контрагенты?\$format=json&\$select=Ref_Key,Description,ИНН&\$filter=ИНН eq '7707083893'"
Синтаксис ровно такой: сущности именуются Catalog_<Имя>, Document_<Имя>, InformationRegister_<Имя>; $format=json обязателен, иначе прилетит XML; ссылочные поля в ответе имеют суффикс _Key и содержат GUID (Контрагент_Key, Организация_Key), а собственная ссылка объекта лежит в Ref_Key. Аутентификация — Basic. Точное имя документа под счёт поставщика зависит от конфигурации: в «Бухгалтерии 3.0» это Document_СчетНаОплатуПоставщика, в отраслевых сборках бывает иначе — не верьте статьям из интернета, откройте $metadata своей базы и посмотрите. Полторы минуты экономят полдня.
Создание — обычный POST JSON-объекта на коллекцию документа. Три вещи, которые я делаю всегда. Первое: документ создаётся непроведённым, поле Posted остаётся false. Робот не проводит документы — точка. Проведение меняет остатки и движения, и это осознанное действие бухгалтера. Второе: в поле комментария я пишу тот самый ключ идемпотентности из письма и перед POST проверяю $filter по нему — так повторный прогон конвейера не создаёт второй документ. Третье: если контрагента по ИНН в справочнике нет, я не создаю его молча, а отправляю задачу человеку. Автосозданные дубли контрагентов — та ещё радость, вычищать их потом дороже, чем один раз завести руками.
Отдельно про учётку. Заводите под интеграцию отдельного пользователя 1С (у меня это odata_bot) с минимальными правами и без доступа к интерфейсу. Не используйте «Администратора» — это соблазнительно быстро и очень плохо кончается при разборе, кто и что сделал в базе.
- Публикация базы на веб-сервере с галкой «Публиковать стандартный интерфейс OData».
- Состав интерфейса задан явно: справочники Контрагенты, Номенклатура, Организации и нужный документ счёта.
- Отдельный пользователь `odata_bot` с ролью только на чтение справочников и запись черновиков документов.
- Проверка `$metadata` и тестовый GET по ИНН до сборки воркфлоу.
- POST документа с `Posted: false` и ключом идемпотентности в комментарии, перед этим — `$filter` по ключу.
- Доступ к публикации — только из сети, где стоит n8n, и только по HTTPS.
Напоминания, деньги и то, чего я делать не стал
Напоминание — самая простая часть и при этом та, ради которой всё чаще всего и затевается. Schedule Trigger в 09:30 по будням дёргает 1С запросом за непроведёнными счетами со сроком оплаты в ближайшие три дня и за всеми просроченными, группирует по ответственному и шлёт одним сообщением в Telegram. Одно сообщение в день на человека, не по письму на счёт — иначе через неделю всё это уйдёт в мьют, и вы получите дорогой генератор шума вместо инструмента. Эскалацию делаю только на просрочку больше трёх дней: копия руководителю.
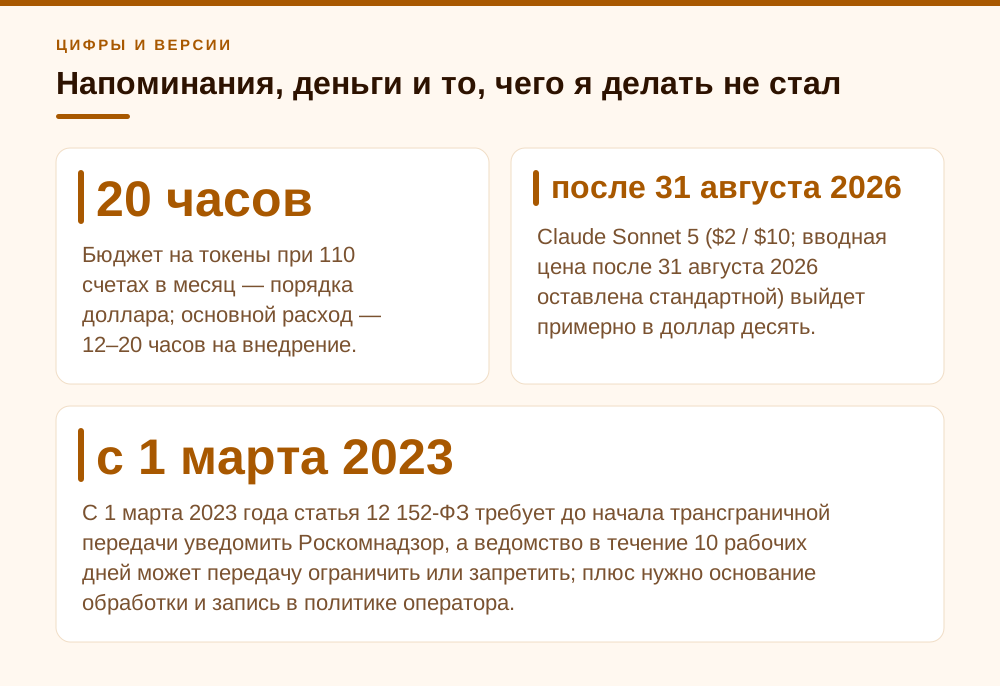
Теперь про деньги, потому что этот вопрос задают первым. На 110 счетах в месяц расход на модель смешной. Текстовый счёт — это примерно 1,5–2,5 тысячи входных токенов и 300–500 выходных; скан страницы дороже, порядка 2–3 тысяч входных. Итого около 300 тысяч входных и 50 тысяч выходных токенов в месяц. По прайсу Anthropic на момент написания Claude Haiku 4.5 стоит $1 за миллион входных и $5 за миллион выходных — это около 55 центов в месяц. Claude Sonnet 5 ($2 / $10; вводная цена после 31 августа 2026 оставлена стандартной) выйдет примерно в доллар десять. Реальная стоимость проекта — это не токены, а 12–20 часов на настройку, отладку схемы и обкатку на исторической выборке. Кто продаёт вам «экономию на ИИ» через удешевление модели — считает не ту статью.
Про риск, который переоценивают, и риск, который недооценивают. Переоценивают «модель придумает сумму, и мы заплатим не то»: при непроведённом документе, детерминированной валидации и человеке на оплате этот сценарий закрыт полностью. Недооценивают другое — 152-ФЗ. В счёте есть ФИО директора и ИП, иногда подпись и телефон, и это персональные данные, которые вы отправляете в зарубежное облако. С 1 марта 2023 года статья 12 152-ФЗ требует до начала трансграничной передачи уведомить Роскомнадзор, а ведомство в течение 10 рабочих дней может передачу ограничить или запретить; плюс нужно основание обработки и запись в политике оператора. Для многих компаний это решаемая бумажная работа, для работающих с госзаказом или медициной — стоп-фактор. Тогда вариантов два: российские провайдеры моделей (GigaChat, YandexGPT) или локальная открытая vision-модель на своём GPU. Второй путь честно дороже по железу и заметно слабее по качеству распознавания рукописных и кривых сканов — но по цифровым PDF разница уже почти не чувствуется. Проверяйте на своей выборке, а не по чужим бенчмаркам.
Чего я не стал делать и не советую. Не стал автоматически проводить документы — по описанным выше причинам. Не стал делать полноценного «агента с инструментами» вместо линейного конвейера: два раза попробовал, оба раза получил непредсказуемое число вызовов модели и невозможность объяснить бухгалтеру, почему на одинаковых счетах разный результат. Не стал складывать вложения в облако — файлы едут в ту же сетевую папку, куда бухгалтерия клала их руками, с именем вида ИНН_номер_дата.pdf; смена привычного места хранения ломает людям процесс сильнее, чем помогает автоматика. И не стал автоматически заводить новых контрагентов. За полгода эксплуатации у «Скрепки-Опт» конвейер закрывает 95 % счетов без участия человека, ручной ввод сократился с двух часов в неделю до примерно пятнадцати минут, а просроченных счетов с момента запуска не было ни одного.
- Напоминание — одно сводное сообщение в день на ответственного, эскалация руководителю при просрочке больше трёх дней.
- Бюджет на токены при 110 счетах в месяц — порядка доллара; основной расход — 12–20 часов на внедрение.
- Перед отправкой счетов в зарубежный API — уведомление Роскомнадзора о трансграничной передаче по ст. 12 152-ФЗ.
- Для чувствительных отраслей — российский провайдер моделей или локальная vision-модель, проверенная на своей выборке.
- Не автоматизировать: проведение документов, решение об оплате, создание новых контрагентов.
Частые вопросы
Можно ли обойтись без n8n и написать всё на Python?
Можно, и первую версию я делал именно так. Но n8n выигрывает в двух вещах: готовые IMAP-триггер и разбор вложений (это самая скучная часть кода) и визуальный лог каждого выполнения — когда счёт «не завёлся», вы за минуту видите, на какой ноде и с какими данными это произошло. Для команды, где скрипт после вас будет поддерживать не программист, это решающий аргумент. Если у вас сильная разработка внутри — пишите на Python, разницы в результате не будет.
Насколько точно LLM извлекает реквизиты из счёта?
На цифровых PDF от постоянных поставщиков — практически безошибочно, ошибки единичны и почти все ловятся арифметикой. На сканах и фотографиях с телефона хуже: у меня 3–6 % документов уходит в ручную проверку, и это нормальный рабочий диапазон. Смертельная ошибка одна — смешивание позиций из нескольких счетов, сшитых в один PDF; лечится явной инструкцией в промпте и флагом multi_doc в схеме.
Обязательно ли отправлять документы во внешнее облако?
Нет. Есть три варианта: зарубежные API (лучшее качество, но счёт с ФИО директора — это персональные данные, до начала передачи нужно уведомить Роскомнадзор по ст. 12 152-ФЗ), российские провайдеры моделей и локальная открытая vision-модель на собственном GPU. Для цифровых PDF разница в качестве между вариантами уже невелика; на кривых сканах локальные модели заметно слабее. Начните с тестового прогона одной и той же выборки из 50 счетов через все три варианта — цифры будут убедительнее любых обзоров.
Почему документ создаётся непроведённым?
Потому что проведение меняет остатки и формирует движения по регистрам, а это уже влияет на учёт и отчётность. Робот, который сам проводит документы, при первой же ошибке распознавания даёт кривые остатки, и разбирать это будет бухгалтер. Непроведённый документ — это черновик: все реквизиты уже заполнены, человеку остаётся посмотреть и нажать кнопку. Экономия времени та же, риск на порядок ниже.
Что делать, если 1С возвращает пустые метаданные по $metadata?
Почти наверняка не задан состав стандартного интерфейса OData. Публикация на веб-сервере с включённой галкой OData — это только половина: объекты конфигурации в состав интерфейса надо включить явно. Пока состав пуст, $metadata вернётся почти пустым, а обращения к сущностям будут давать 404, и выглядит это как сломанная публикация.
Сколько времени занимает внедрение такого конвейера?
На типовой конфигурации 1С и рабочем ящике — 12–20 часов работы: развернуть n8n, настроить публикацию OData и учётку, собрать воркфлоу, отладить схему извлечения на исторической выборке из 50–100 счетов и обкатать две недели в режиме «пишем черновики, но человек проверяет каждый». Основное время съедает не сборка, а именно обкатка на реальных документах ваших поставщиков.
Источники
- n8n Docs — Information Extractor — Описание ноды Information Extractor: параметр Schema Type (From Attribute Descriptions / Generate From JSON Example / Define using JSON Schema), опция System Prompt Template, замечание «n8n treats every field as mandatory when generating schemas from JSON examples». https://docs.n8n.io/integrations/builtin/cluster-nodes/root-nodes/n8n-nodes-langchain.information-extractor/
- n8n Docs — Structured Output Parser — Sub-node Structured Output Parser: Schema Type, прямое указание «we don't support references (using $ref) in JSON schemas», поведение sub-nodes с выражениями. https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.outputparserstructured/
- n8n Docs — Email Trigger (IMAP) — Параметры Action (Mark as Read / None), Download Attachments («Only set this if necessary, since it increases processing»), Format (RAW / Resolved / Simple), опции Custom Email Rules и Force Reconnect Every Minutes. https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.emailimap/
- n8n Docs — AI Agent — Agent type deprecated с n8n 1.82.0; все ноды AI Agent работают как Tools Agent; v1-версия ноды будет удалена в n8n 3.0. https://docs.n8n.io/integrations/builtin/cluster-nodes/root-nodes/n8n-nodes-langchain.agent/
- n8n — LICENSE.md (Sustainable Use License 1.0) — Формулировка ограничения: «You may use or modify the software only for your own internal business purposes or for non-commercial or personal use»; файлы с «.ee.» — под отдельной Enterprise-лицензией. https://github.com/n8n-io/n8n/blob/master/LICENSE.md
- n8n — Releases — Версии релизов и даты публикации; на 14.09.2026 релиз с пометкой Latest — n8n@2.38.7 (2026-09-11), пре-релиз — n8n@2.39.5 (2026-09-14). https://github.com/n8n-io/n8n/releases
- DaData — API «Найти компанию по ИНН» — Метод POST https://suggestions.dadata.ru/suggestions/api/4_1/rs/findById/party, заголовок Authorization: Token, тело {"query": «ИНН»}; лимиты: 30 запросов в секунду с одного IP, бесплатно до 10 000 запросов в сутки. https://dadata.ru/api/find-party/
- 1С:Предприятие 8.3 — Руководство разработчика, стандартный интерфейс OData — Раздел документации платформы о стандартном интерфейсе OData: публикация, состав интерфейса (метод УстановитьСоставСтандартногоИнтерфейсаOData), $metadata, именование сущностей Catalog_/Document_, суффикс _Key. https://its.1c.ru/db/v8312doc#bookmark:dev:TI000000791
- Anthropic — Pricing — Тарифы на модели Claude: Claude Haiku 4.5 — $1 / $5 за 1M входных/выходных токенов, Claude Sonnet 5 — $2 / $10 (вводная цена сохранена как стандартная после 31.08.2026). https://platform.claude.com/docs/en/about-claude/pricing
- Федеральный закон от 27.07.2006 № 152-ФЗ «О персональных данных», статья 12 — Трансграничная передача персональных данных: уведомление Роскомнадзора до начала передачи (ч. 3), срок рассмотрения и право ограничить/запретить передачу (ч. 8–12); редакция, действующая с 01.03.2023. https://www.consultant.ru/document/cons_doc_LAW_61801/e4ebbe1780de623c7cf32a59ca82a7bb523a25dd/