
Сколько стоит распознавание первичных документов в 1С и как посчитать экономию на 1000 документов
Страница в 1С:РПД стоит от 4 до 6 рублей для пакетов до 10 000 страниц, и тысяча двухстраничных документов обходится примерно в 8–12 тысяч рублей. Но это малая часть расходов: главная статья — время бухгалтера на проверку. Ниже — прайс, формула, четыре статьи затрат и расчёт на отеле из 35 рабочих мест.
Сколько стоит распознавание первичных документов: официальный прайс 1С:РПД
Начну с цифр, за которыми обычно и приходят. Если у вас «1С:Бухгалтерия» на официальной поддержке, самый короткий путь — сервис «1С:Распознавание первичных документов» (1С:РПД), и считается он в страницах, а не в документах. Я занимаюсь сопровождением 1С и баз на PostgreSQL и вижу, что на этом месте директора путаются чаще всего: в прайсе написано «100 страниц — 600 рублей», а в голове уже сидит «600 рублей за сто документов». Это разные вещи, и разница бывает двукратной.
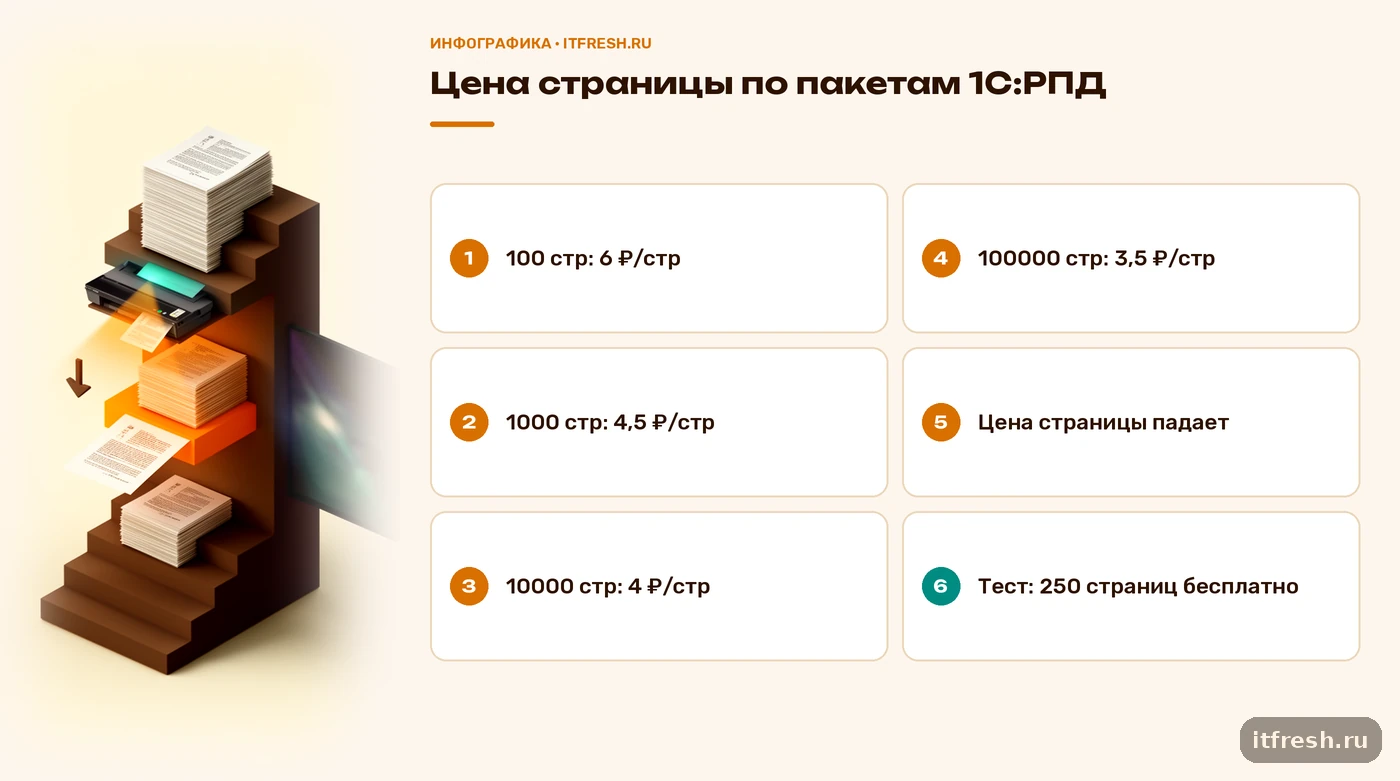
Вот прайс с официальной страницы сервиса на сайте ИТС. Колонка «за страницу» — не цена из прайса, а моё деление цены пакета на число страниц, чтобы ступени можно было сравнить: | Пакет, страниц | Цена, руб./год | За страницу, руб. | |---|---|---| | 100 | 600 | 6,00 | | 500 | 2 500 | 5,00 | | 1 000 | 4 500 | 4,50 | | 5 000 | 21 000 | 4,20 | | 10 000 | 40 000 | 4,00 | | 50 000 | 187 500 | 3,75 | | 100 000 | 350 000 | 3,50 | | 500 000 | 1 625 000 | 3,25 | | 1 000 000 | 3 000 000 | 3,00 | Для компании до 50 рабочих мест реальный диапазон — пакеты от 1 000 до 10 000 страниц, то есть 4–4,5 рубля за страницу. Верхние ступени сделаны не для нас.
Что ещё есть на официальных страницах. Тестовый пакет — 250 страниц бесплатно для пользователей локальных версий программ на официальной поддержке. Срок его действия на разных страницах ИТС указан по-разному (где-то один месяц, где-то двенадцать), поэтому смотрите условия в момент активации и не откладывайте проверку на потом. Для 1С:Фреш страницы входят в тариф: по данным портала 1С, 250 страниц в год на тарифах ПРОФ, КОРП, СПЕЦ и ERP и 30 в год на «Базовом» и «Рознице». Для бухгалтерии на 700 бумажных документов в месяц это, по сути, только тест. Цены на странице сервиса не датированы, поэтому перед бюджетом сверьте их с личным кабинетом или у партнёра 1С.
Из чего складывается стоимость: за что вы платите, кроме страниц
За пятнадцать лет я не видел ни одной компании, у которой стоимость распознавания равнялась бы строчке из прайса. Реальных статей четыре. Первая — страницы или лицензия: пакет 1С:РПД, подписка стороннего сервиса, постраничная оплата облачного OCR либо сервер и поддержка собственного контура. Вторая — внедрение: настройка сопоставления контрагентов и номенклатуры, пилот, обучение. Третья — сопровождение. Четвёртая, самая тяжёлая и самая незаметная — время людей на проверку.
Про четвёртую статью скажу жёстко: если вы считаете только лицензию, вы считаете не то. Распознавание не убирает бухгалтера из процесса, оно меняет его работу: вместо набора реквизитов с клавиатуры — проверка красных полей. Как считать окупаемость целиком, с формулами и тремя сценариями внедрения, я уже разбирал в статье окупаемость распознавания первички в 1С. Здесь другой угол: сколько стоит единица работы — тысяча документов — и как сравнить варианты по цене этой единицы.
Отдельно про цену ошибки. В прайсе её нет, но она есть в жизни: неверная сумма или ставка НДС, пройденная в черновике, всплывёт на сверке с поставщиком или при закрытии месяца. Поэтому я никогда не включаю в расчёт «автопроведение»: распознанный документ должен попадать в базу непроведённым, и проводит его человек. Это не мешает экономии, зато экономия получается честной. Принцип подробно описан в статье про черновики вместо проводок.
- Страницы или лицензия: пакет 1С:РПД, тариф сервиса, облачный OCR либо собственный сервер.
- Внедрение: сопоставление контрагентов и номенклатуры, пилот, обучение бухгалтеров проверке.
- Сопровождение: подписка, актуализация справочников, контроль качества.
- Время проверки: минуты на документ, умноженные на ставку часа бухгалтера.
Как посчитать экономию на 1000 документов: формула и пример в цифрах
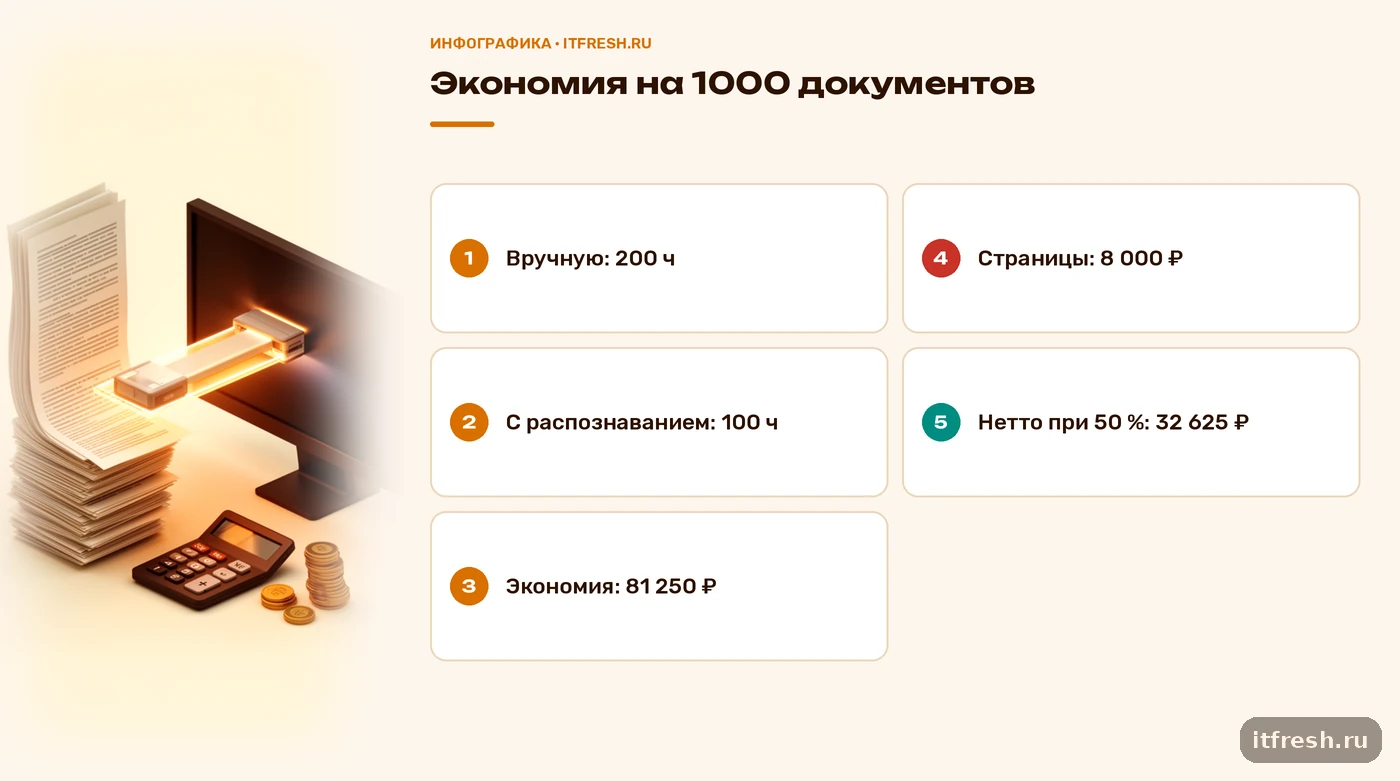
Берите не «общую выгоду за год», а выгоду на тысячу документов: единицу можно перенести на любой объём и на любой вариант. Вводных пять: сколько минут уходит на ручной ввод одного документа, сколько на проверку распознанной карточки, какая доля карточек требует правки и сколько минут занимает правка, сколько страниц в среднем в документе. Плюс ставка часа и цена страницы.
Допущения для примера (замеряйте свои, не верьте моим): ручной ввод — 12 минут на документ, проверка карточки — 3 минуты, правки нужны в 30 % карточек, на правку уходит 10 минут, в документе в среднем 2 страницы. Ставка часа: оклад 100 000 рублей плюс 30 % взносов — 130 000 рублей в месяц, делим на 160 часов, получаем 812,5 рубля в час. Время после распознавания: 3 + 0,3 × 10 = 6 минут на документ. Экономия: 12 − 6 = 6 минут, на тысячу документов — 100 часов, или 81 250 рублей брутто. Страницы: 2 000 × 4 рубля = 8 000 рублей (пакет 10 000 страниц). Нетто при полной реализации — 73 250 рублей на тысячу документов.
Теперь о том, о чём принято умалчивать. Освобождённые часы — не деньги, пока вы не потратили их на что-то полезное: оклад бухгалтера никуда не делся. Деньгами они становятся, если вы не нанимаете человека, не платите сверхурочные или закрываете месяц на два дня раньше. Поэтому я всегда считаю два сценария — реализация 100 % и 50 %. При 50 % экономия на тысячу документов: 81 250 × 0,5 − 8 000 = 32 625 рублей. Считать можно в калькуляторе, а можно одной командой:
# порядок вывода: минут после, часов экономии, брутто, страницы, нетто
awk -v docs=1000 -v pages=2 -v manual=12 -v check=3 -v fix=10 -v share=0.3 -v rate=812.5 -v price=4 -v real=0.5 'BEGIN { after=check+share*fix; saved=docs*(manual-after)/60; gross=saved*rate; fee=docs*pages*price; print after, saved, gross, fee, gross*real-fee }'
На выходе будет «6 100 81250 8000 32625». Меняйте параметры под себя. Для замера реального числа страниц возьмите папку со сканами за месяц (пути подставьте свои; нужен пакет poppler-utils с утилитой pdfinfo):
for f in /srv/scans/*.pdf; do pdfinfo "$f"; done | awk '/^Pages:/ {s+=$2} END {print s}'Если часть документов приходит фотографиями, посчитайте их отдельно: файл с фото — это, как правило, одна страница, но условия подсчёта уточните у партнёра.
Как это считали для отеля «Тихий причал»: 35 рабочих мест и 700 бумажных документов
Отель «Тихий причал» — условный клиент, на нём удобно показать расчёт целиком. Исходные данные: 35 рабочих мест, два бухгалтера и один завхоз-снабженец, «1С:Бухгалтерия» 3.0 на официальной поддержке ИТС. В месяц приходит около 1 000 входящих документов, из них 300 — по ЭДО в XML (их распознавание не касается), 700 — бумага и PDF: продукты, прачечная, химия, хозтовары, ремонты, коммунальные счета, кассовые чеки. В среднем две страницы на документ, то есть 1 400 страниц в месяц и около 16 800 в год. Летом объём выше, поэтому пакет я бы брал с запасом.
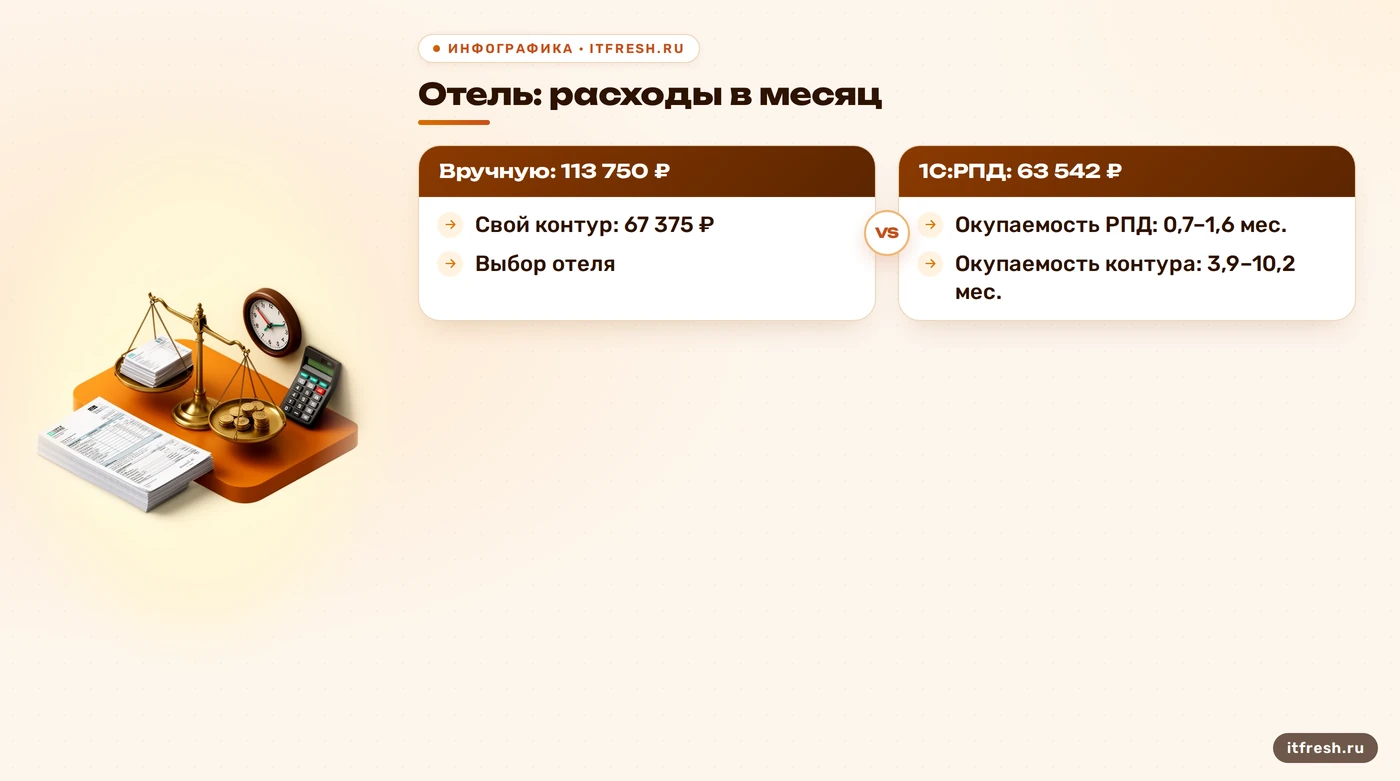
Сравнивали три варианта. А — пакеты 1С:РПД: два по 10 000 страниц, 80 000 рублей в год, 6 667 рублей в месяц. Я считаю так, исходя из того, что пакеты можно докупать, но у партнёра это нужно подтвердить. Б — собственный контур на сервере отеля с распознаванием на CPU: сервер 4 000, облачные модели по необходимости 500, сопровождение 6 000, в сумме 10 500 рублей в месяц, внедрение 150 000 рублей (нижний из сценариев, которые я описывал в статье про окупаемость). В — ничего не менять. Время бухгалтеров считаем по тем же допущениям: 12 минут вручную против 6 минут с распознаванием. | Вариант | Деньги в месяц | Часы бухгалтеров | Итого в месяц | |---|---|---|---| | В. Вручную | 0 | 140 | 113 750 | | А. 1С:РПД | 6 667 | 70 | 63 542 | | Б. Свой контур | 10 500 | 70 | 67 375 | Часы переведены в рубли по 812,5 рубля. Разница с «вручную»: у варианта А — 50 208 рублей в месяц брутто, у варианта Б — 46 375.
Разовые расходы. У варианта А: настройка и пилот на нашей стороне — 24 000 рублей (допущение кейса) плюс 12 часов бухгалтеров на сверку справочников — 9 750 рублей, итого 33 750. У варианта Б: 150 000 плюс 40 часов бухгалтеров — 32 500, итого 182 500. Окупаемость при полной реализации времени: А — 0,7 месяца, Б — 3,9 месяца. При реализации 50 %: выгода А — 28 437 − 6 667 = 21 771 рубль в месяц, срок 1,6 месяца; выгода Б — 28 437 − 10 500 = 17 937 рублей в месяц, срок 10,2 месяца. Первый год у варианта А при 50 % даёт около 227 500 рублей чистой выгоды (261 250 за двенадцать месяцев минус 33 750 разовых).
Что выбрал отель. Вариант А. Не потому что он «лучше», а потому что при 700 документах в месяц постоянные 10 500 рублей собственного контура съедают половину выгоды, а страницы по 4 рубля — нет. Важная оговорка: отель не обрабатывает массивы персональных данных гостей через первичку, поэтому вопрос локальности сканов для него не стоял. Если у вас в сканах договоры с физлицами, паспортные данные, трудовые документы — читайте разбор про локальное распознавание и 152-ФЗ: там цена вопроса другая. Пилот у отеля запланирован на две недели в режиме без записи в базу, на 10–20 типичных документах.
Облако, свой контур или ручной ввод: где точка пересечения по цене
Постраничная оплата и фиксированная абонентка — это две разные кривые, и они пересекаются. Страницы стоят пропорционально объёму: удвоился поток — удвоился счёт. Собственный контур стоит почти одинаково при 500 и при 3 000 документов. Для моих допущений точка пересечения по текущим расходам такая: 10 500 рублей в месяц делим на 4 рубля за страницу, получаем 2 625 страниц, или примерно 1 300 документов в месяц по две страницы. Ниже этого порога дешевле пакеты, выше — выгоднее свой сервер, но без учёта 150 000 рублей внедрения.
Это только деньги. Решение определяют три вещи, не связанные с ценой страницы: куда уходят сканы, какие у вас формы документов и кто будет держать систему. Собственный контур даёт контроль над данными и свободу в настройке, но требует сервера и сопровождения. Движки сами по себе бесплатны: Tesseract и PaddleOCR распространяются под лицензией Apache 2.0, GPU для печатных документов, как правило, не нужен. Какой движок брать — отдельная тема, я вынес её в сравнение Tesseract, PaddleOCR и LLM.
Качество входного скана тоже влияет на цену, хотя в прайсе этого нет. Документация Tesseract прямо пишет, что движок лучше всего работает с изображениями не ниже 300 dpi, а перекос страницы и шум заметно ухудшают результат. Плохая фотография с телефона означает больше красных полей, больше правок и меньше экономии. На практике самое дешёвое улучшение — поставить в бухгалтерии сканер с автоподачей и договориться, что фото от поставщиков принимаем только в крайнем случае.
Когда распознавание не окупается: пять ловушек в расчёте
Первая ловушка — считать все документы. Если 70 % и более входящих приходит по ЭДО в XML, распознавание нужно только для остатка бумаги: подробнее об этом я писал в статье про остаток бумаги при ЭДО. Вторая — не учитывать долю правок. Если из-за нетиповых бланков правки нужны в 60 % карточек, а не в 30 %, то выгода в моей формуле падает почти вдвое. Третья — купить пакет «с запасом» и не использовать. В отеле из кейса загрузка пакета в 20 000 страниц — около 84 %, поэтому реальная цена страницы 80 000 / 16 800 = 4,76 рубля, а не 4,00.
Четвёртая ловушка — рукописные исправления и мятые чеки. Печатный текст распознаётся хорошо, рукописные пометки поверх печати — плохо, и такие документы дешевле вводить руками, чем исправлять. Пятая — считать выгоду до запуска без замеров. Пока вы не засекли секундомером ввод десяти документов, цифры 12 и 6 минут — гипотеза. Замеры занимают полдня, а ошибка в этих двух числах меняет итог в разы.
Практический порядок действий такой. Сначала замер ручного ввода на десяти документах. Затем пилот на тестовых 250 страницах: этого хватит примерно на 125 двухстраничных документов. Я рекомендую запускать пилот без записи в базу и смотреть не на красивую точность, а на долю карточек, которые прошли без единой правки. О том, что мерить в пилоте, у меня есть отдельный разбор — пилот распознавания в режиме dry-run. Если доля чистых карточек ниже половины, причина обычно в разнородных бланках нескольких крупных поставщиков, а не в движке.
С чего начать: план на неделю для директора и главбуха
Первый день — собрать вводные. Сколько входящих документов за последние три месяца, сколько из них бумажных, сколько страниц (команда для подсчёта PDF выше), сколько бухгалтеров этим занимается и какая у них ставка часа. Второй день — замер ручного ввода на десяти документах разных типов: типовая накладная, акт, чек, нетиповой бланк. Это даст честные 12 минут вместо чьей-то оценки «на глаз».
Третий день — тестовый пакет. Проверьте, что программа на официальной поддержке, активируйте тест и прогоните 10–20 документов. На четвёртый день посчитайте экономию по формуле из третьего раздела в двух сценариях, 100 % и 50 %, и сравните с ценой пакета. На пятый — решение: берём пакет, строим собственный контур или оставляем ручной ввод. Все три варианта легитимны. Единственное, что я не считаю нормальным, — покупать решение без замеров, потому что «все так делают».
Если нужен посторонний взгляд, мы в АйТи-Фреш делаем такой расчёт за один день на ваших документах и честно говорим, когда распознавание не окупается. Чаще всего это бывает, когда бумаги мало, а ЭДО уже закрывает основной поток.
Частые вопросы
Сколько стоит распознавание одного документа?
Сервис 1С:РПД тарифицируется в страницах: от 6 рублей за страницу в пакете на 100 страниц до 4 рублей в пакете на 10 000 страниц. Для двухстраничного документа это примерно 8–12 рублей по пакетам до 10 000 страниц. Реальная цена выше, если часть пакета не будет использована.
Есть ли бесплатный пробный период 1С:РПД?
Да, на официальных страницах 1С указан бесплатный тестовый пакет на 250 страниц для пользователей локальных версий на официальной поддержке. Срок действия на разных страницах ИТС описан по-разному, поэтому проверьте условия при активации. В 1С:Фреш страницы включены в тариф: 250 в год на ПРОФ, КОРП, СПЕЦ и ERP, 30 — на «Базовом» и «Рознице».
С какого объёма документов распознавание окупается?
Универсального порога нет. Для сервиса с оплатой за страницу порога по лицензии нет, а смысл определяют время ввода и доля правок. По моей практике, ощутимая экономия начинается от нескольких сотен бумажных документов в месяц. Меньше — проще считать вручную.
Нужна ли подписка ИТС для распознавания?
Для 1С:РПД программа должна быть на официальной поддержке. Подробные требования к подписке в открытых материалах не раскрыты, их уточняют у партнёра 1С. Сторонние сервисы и собственный контур от ИТС не зависят.
Можно ли доверять распознаванию и сразу проводить документы?
Нет. Распознанный документ должен попадать в базу черновиком, а проводит его бухгалтер после проверки полей. Экономия достигается за счёт отказа от набора реквизитов, а не за счёт отказа от проверки.
Источники
- Сервис ИТС 1С:Распознавание первичных документов — цена — Проверены пакеты страниц и годовые цены от 100 до 1 000 000 страниц и строка тестового пакета на 250 страниц: https://v8.1c.ru/its/services/1s-raspoznavanie-pervichnykh-dokumentov/cena-1s-raspoznavanie-pervichnykh-dokumentov/
- Портал 1С — 1С:Распознавание первичных документов — Проверены поддерживаемые типы документов и форматы файлов, годовой срок платных пакетов, условия для 1С:Фреш (250 и 30 страниц в год): https://portal.1c.ru/applications/1C-Document-Recognition
- ИТС — Тестовый тариф 1С:РПД — Проверен объём тестового тарифа (250 страниц) и ограничение для пользователей 1С:Фреш (30 страниц): https://its.1c.ru/db/content/recognition/src/%D1 %82 %D0 %B5 %D1 %81 %D1 %82 %D0 %BE%D0 %B2 %D1 %8B%D0 %B9 %20 %D1 %82 %D0 %B0 %D1 %80 %D0 %B8 %D1 %84.htm
- Tesseract OCR — документация — Проверены рекомендация не менее 300 dpi, влияние перекоса и шума, методы бинаризации в версии 5.0.0: https://tesseract-ocr.github.io/tessdoc/ImproveQuality.html
- Tesseract OCR — репозиторий — Проверены лицензия Apache 2.0, дата релиза 5.0.0 (30.11.2021) и нейросетевой движок LSTM: https://github.com/tesseract-ocr/tesseract
- PaddleOCR — репозиторий — Проверены лицензия Apache 2.0 и поддержка работы на CPU: https://github.com/PaddlePaddle/PaddleOCR