
ВМ в Proxmox HA стоит, а свободный узел простаивает: ищем strict affinity и конфликтные правила
Если Proxmox HA не запускает ВМ на свободном узле, почти всегда виновата не нехватка памяти, а правила: строгая node affinity с одним допустимым узлом или конфликт, из-за которого правило молча отключено. Ниже порядок проверки командами, разбор на кластере школы из 17 рабочих мест и таблица «симптом — причина — действие».
Почему ВМ не стартует там, где полно места: три механизма вместо одного
Меня зовут, когда кластер из трёх узлов «упал», хотя на двух живых узлах свободны и память, и процессор. Диагноз «не хватает ресурсов» ставят в девяти случаях из десяти, и в девяти из десяти он неверный. Я обслуживаю виртуализацию и серверы малых офисов больше пятнадцати лет и давно перестал начинать с графиков загрузки: сначала смотрю правила размещения, потом всё остальное.
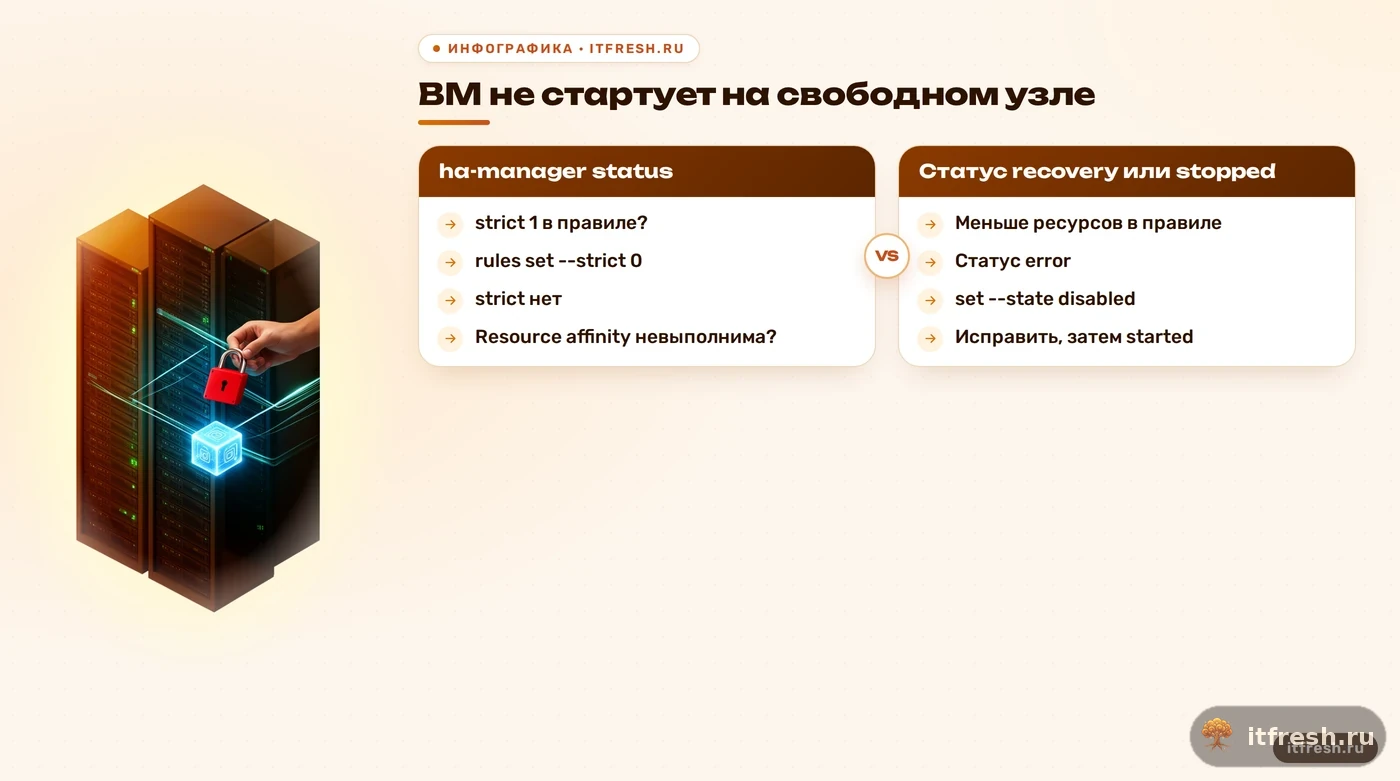
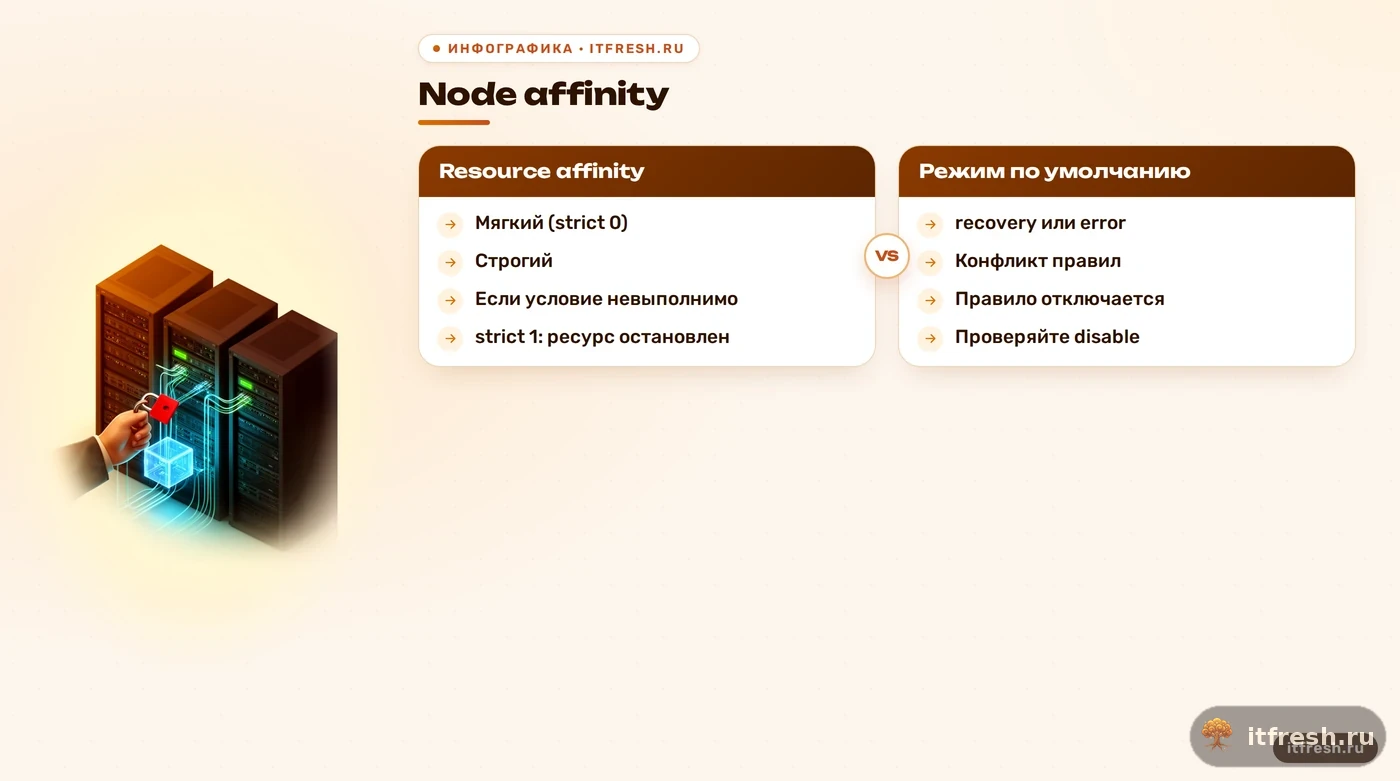
Механизмов, которые не пускают ВМ на свободный узел, ровно три, и лечатся они по-разному. Первый: строгая node affinity (strict 1), у которой допустимых узлов меньше, чем осталось живых. По документации, если ни один из перечисленных в строгом правиле узлов недоступен, ресурс будет остановлен. Не перенесён «куда-нибудь», а именно остановлен. На практике после отказа узла такой ресурс сначала проходит через fence и recovery, и в ha-manager status вы чаще увидите именно recovery: менеджер ищет узел с учётом правил и не находит. Второй: правила, не прошедшие проверку допустимости. Такие правила отключаются, пока конфликт не устранён, и вы получаете размещение не по тем правилам, которые видите глазами в конфиге. Третий: resource affinity, которая по умолчанию строгая; если условие нельзя выполнить, ресурс уходит в recovery при отказе узла или в error в остальных случаях.
Про сам эффект «правило важнее ресурсов» я уже писал, когда разбирал аварию на трёх узлах с ошибкой «нет узла для восстановления». Здесь другой угол: не история одной аварии, а инструкция по проверке. Какие команды выполнить, что в их выводе считать подозрительным, как отличить строгое правило от отключённого и что менять, чтобы не сделать хуже. Если у вас сейчас горит и ВМ лежит, перейдите сразу к таблице в последнем разделе, а читать остальное будете потом, с чаем.
- строгая node affinity: допустимые узлы мертвы или в обслуживании, ресурс висит в recovery или остаётся остановленным;
- правило отключено из-за конфликта: ограничение не действует так, как вы задумали;
- строгая resource affinity: условие невыполнимо при меньшем числе живых узлов, ресурс в recovery или error.
Как проверить strict node affinity: команды и что искать в выводе
Начинайте с кворума, потому что без него всё остальное бессмысленно, и дальше идёте от общего к частному. Сначала состояние кластера и HA, потом конфигурация ресурсов, потом правила для конкретной ВМ. Команды выполняются на любом узле, правила лежат в кластерной файловой системе и видны везде:
pvecm status
ha-manager status
ha-manager config
ha-manager rules list --resource vm:101
ha-manager rules config --type node-affinity
cat /etc/pve/ha/rules.cfg
Ключ --resource в rules list и rules config показывает только правила, затрагивающие нужный ресурс, а --type фильтрует по типу (node-affinity или resource-affinity). Параметры сверены со справочником ha-manager для Proxmox VE 9; в своей версии посмотрите ha-manager rules list --help, формат вывода я не пересказываю.
В выводе ищите три вещи. Первая: strict 1 в правиле с вашей ВМ. Вторая: список узлов nodes, в котором один узел или все они недоступны. Третья: узлы с приоритетами вида pve-01:2,pve-02:1, где администратор думал, что приоритеты и есть запрет, а строгость на самом деле живёт в соседнем флаге. Приоритеты сами по себе ничего не запрещают: без strict ресурс при недоступности перечисленных узлов может уйти на любой другой. Запрещает только strict 1. Эту разницу путают постоянно, и поэтому я всегда спрашиваю клиента, кто и зачем ставил галку «Strict» в окне правила.
Типичное происхождение строгого правила: «привяжем 1С к узлу с быстрыми дисками» или «этот узел единственный видит USB-ключ». Задача понятная, но цена привязки не озвучена: на время простоя этого узла ВМ вне игры. Это нормально, если вы знаете об этом и приняли как условие. Ненормально, когда правило пережило причину, по которой его создали, и о нём забыли. Ключ вынули, диски выровняли, а галка живёт и ждёт первой аварии. Меня до сих пор веселит формулировка в комментариях: «временно».
Если разрешённых узлов должно быть больше, чем один, достаточно перечислить их все в nodes, строгость при этом можно оставить. Если привязка не нужна вовсе, снимайте строгость минимальным изменением, не удаляя правило, чтобы приоритеты остались:
ha-manager rules set node-affinity ha-vm101 --strict 0Имя ha-vm101 здесь условное, подставьте своё из вывода rules list. Если правило не нужно совсем, ha-manager rules remove <имя> уберёт его. Любое такое изменение я записываю в журнал работ: кто, когда, зачем. Через полгода это спасает от вопроса «кто это сломал».
Конфликты правил: какие проверки есть и как найти отключённое правило
Перед применением HA Manager проверяет правила на допустимость. Документация перечисляет, что именно не пропускается: ресурс может входить только в одно правило node affinity; негативное правило node affinity не может содержать приоритеты и не может перечислять все узлы; правило resource affinity требует минимум два ресурса; негативное правило resource affinity не может содержать больше ресурсов, чем есть узлов; одни и те же ресурсы нельзя одновременно положить в положительное и отрицательное правило resource affinity. Есть и перекрёстные проверки: ресурсы из положительного правила resource affinity могут входить максимум в одно правило node affinity, а ресурсы из негативного правила не могут быть ограничены меньшим числом узлов, чем самих ресурсов.
Что происходит с правилом, не прошедшим проверку? В документации сказано прямо: оно отключается, пока конфликты и ошибки не устранены. Ключевое слово «отключается». Не «выдаёт ошибку на экране», не «блокирует сохранение». Вы создаёте второе правило для той же ВМ «на время обновления», сохраняете, всё выглядит нормально, а на самом деле одно из пары уже не действует. Как это отображается в веб-интерфейсе, документация не уточняет, поэтому не полагайтесь на значки и проверяйте через CLI и rules.cfg: у правила есть свойство disable, описанное как «отключено ли правило HA», и именно его вы ищете.
Для быстрой ревизии вытащите все правила и пройдитесь глазами по трём пунктам. Один ресурс в нескольких node-affinity правилах? Негативное resource-affinity на N машин при N узлах или меньше? Положительная связка машин, которые разведены по разным правилам узлов? Это короткий список, и на кластере малого офиса на нём находится почти всё:
ha-manager rules config
ha-manager config
Сопоставьте идентификаторы vm:NNN из второй команды с resources из первой. Ресурс, который присутствует в двух правилах одного типа, это ваш подозреваемый номер один. Какое именно из пары отключил менеджер, я по документации сказать не могу, так что смотрите на disable и не гадайте.
Отдельный совет: не лечите конфликт добавлением третьего правила «поверх». Так делают, когда хочется быстро, и получают клубок, который через год никто не распутает. Конфликтующие правила нужно объединить в одно или удалить лишнее. Если правило нужно сохранить на будущее, но сейчас оно мешает, отключите его явно:
ha-manager rules set node-affinity ha-vm101-old --disable 1Ключа enable/disable у подкоманд rules нет, включение и выключение делается именно параметром --disable в rules set.
Resource affinity и арифметика узлов: сколько их нужно на самом деле
Resource affinity по умолчанию строгая, и это самое неприятное отличие от node affinity, которая по умолчанию мягкая. Любимая ситуация: администратор хочет, чтобы две ВМ с контроллерами домена и сервер резервной DNS не жили на одном узле, ставит негативное правило на три ресурса, всё чудесно, пока узлов три. Узел вышел из строя, живых два, а правило требует развести три ресурса. Условие невыполнимо, и менеджер по документации переводит ресурс в состояние recovery при отказе или в error в остальных случаях. Свободные ресурсы вы увидите, а запуска не получите.
Арифметика простая и скучная, поэтому её всегда забывают. Негативное правило на N ресурсов, которое должно переживать потерю одного узла, требует минимум N+1 узлов в кластере. Для двух контроллеров домена на трёх узлах всё в порядке. Для трёх реплик чего-либо на трёх узлах вы строите ловушку: проверка допустимости пропустит правило, потому что узлов формально хватает, а при первом же отказе оно перестанет выполняться. Встроенная проверка защищает от невозможных правил, но не от невозможных сценариев отказа. Это разные вещи, и красивая зелёная галочка тут ничего не доказывает.
Положительное правило (держать вместе) устроено своим способом. Перекрывающиеся положительные правила объединяются в одно, а если ресурсы такой связки сейчас бегут по разным узлам, их перенесут на тот узел, где уже работает большинство; при равенстве выбирается узел, первый по алфавиту. Вывод практический: «держать вместе» на практике означает «одним куском умирают и одним куском переезжают», и если для всех вместе не хватает ресурсов на живом узле, рассчитывать на аккуратный частичный запуск не стоит, как поведёт себя ваша версия при нехватке памяти, проверьте на учениях. Проверяйте суммарную память связки, а не каждой ВМ по отдельности.
Из этого следуют два правила, которые я выдаю клиентам. Негативные связки: число ресурсов строго меньше числа узлов. Положительные: суммарные потребности связки помещаются на любой из оставшихся узлов, иначе привязка превращается в самосаботаж. И то и другое надо пересматривать при каждом изменении состава кластера: добавили узел, убрали узел, переехали на другое железо. Правило, написанное для пяти узлов, на трёх живёт своей жизнью.
Разбор на кластере музыкальной школы «Крещендо»: 35 минут без 1С
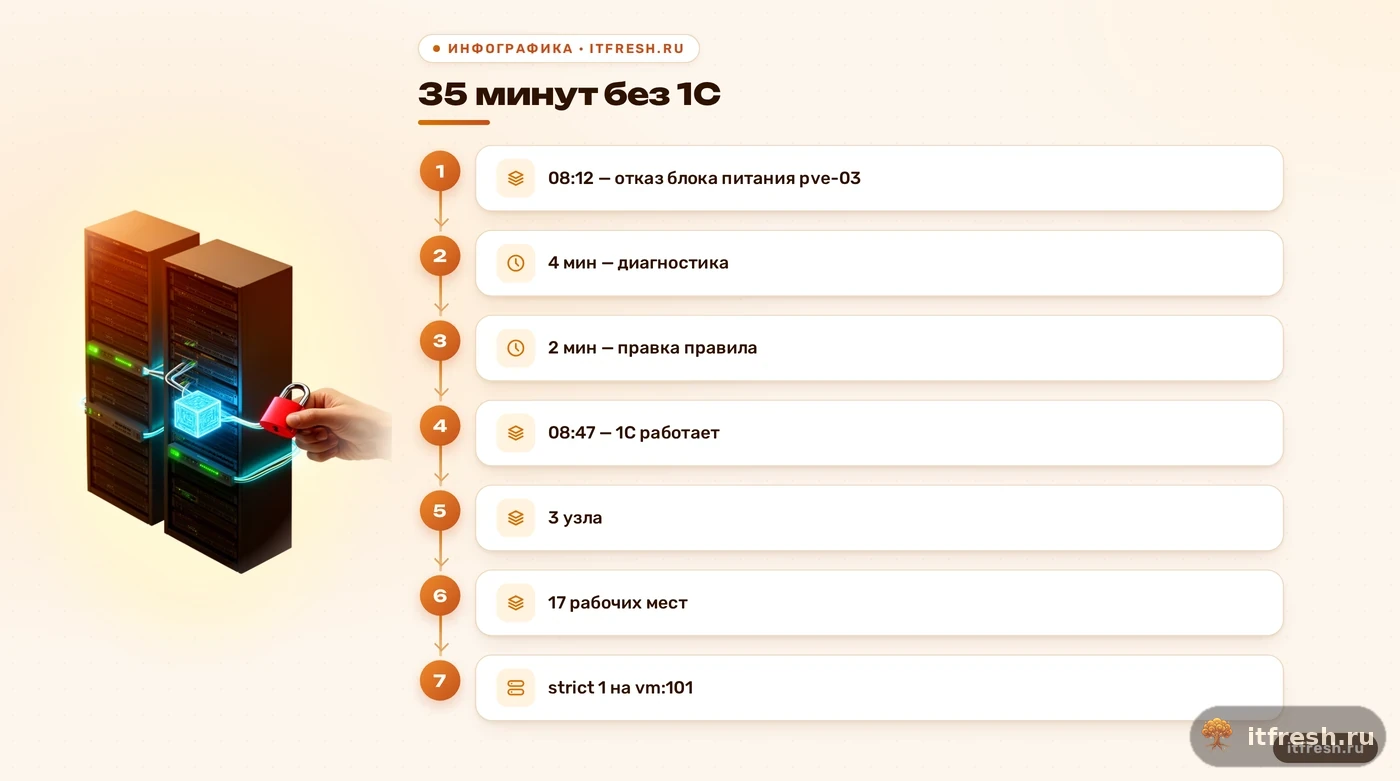
Клиент: музыкальная школа «Крещендо», 17 рабочих мест, кластер из трёх узлов pve-01, pve-02, pve-03 на Proxmox VE 9. На кластере три ВМ под HA: vm:101 с 1С, vm:102 файловый сервер и vm:103 контроллер домена. Утром в начале рабочего дня отказал блок питания на pve-03. Кворум остался (два из трёх), оба живых узла загружены примерно на треть, и администратор школы, человек не из ИТ, но добросовестный, был уверен, что «кластер сам всё поднимет». Не поднял: 1С лежала с 08:12 до 08:47, то есть 35 минут. Бухгалтерия звонила мне на третьей минуте.
Диагностика заняла около четырёх минут по порядку из второго раздела. pvecm status показал кворум, ha-manager status показал, что vm:102 и vm:103 переехали, а vm:101 после fence висит в recovery, при том что памяти на pve-01 и pve-02 хватало с запасом. В rules.cfg нашёлся node-affinity с nodes pve-03, resources vm:101, strict 1. Правило создали два года назад, когда на pve-03 стоял единственный локальный NVMe с базой 1С. Диск давно заменили общим хранилищем, правило осталось. Рядом нашлась вторая мина: файловый сервер vm:102 по недосмотру сидел сразу в двух правилах node affinity, новом и старом. Один ресурс в двух правилах node affinity — тот самый конфликт, при котором правила отключаются, так что в этот раз vm:102 переехал скорее по везению, чем по замыслу.
Исправление заняло две минуты: ha-manager rules set node-affinity <имя> --strict 0, дубль для vm:102 я удалил ha-manager rules remove, затем ha-manager rules list для проверки. Простой в итоге: 35 минут, из них на сам ремонт правила ушли две, остальное — получить удалённый доступ, дождаться, пока администратор школы доберётся до серверной и подтвердит, что pve-03 действительно мёртв, и убедиться, что дело не в общем хранилище. Потом мы с администратором школы выключили pve-02 в рабочее время, после занятий, и посмотрели, что будет. ВМ переехали за несколько минут, а не за тридцать пять. Теперь такие учения идут раз в квартал.
Из этого кейса важно вот что: никакой «магии» и никакого сбоя Proxmox тут не было. HA сделал ровно то, что ему написали в конфиге, просто конфиг устарел вместе с оборудованием. Бэкап в таких историях ничего не спасает, он нужен для другого, а когда падает блок питания, спасает только правильно подготовленная конфигурация. Кстати, базовый вопрос «а бэкап ВМ вообще есть и восстанавливается» я для школы закрыл отдельно через Proxmox Backup Server, но это уже другая история.
Что делать прямо сейчас, если ВМ не стартует
Алгоритм у меня одинаковый для любого кластера. Первое: убедиться, что кворум есть, а не что «в интерфейсе всё зелёное». Второе: посмотреть состояние ресурса в ha-manager status: recovery лечится правилами, error требует ручного цикла. Третье: выгрузить правила для этой ВМ и найти strict 1, дубли и disable. Четвёртое: ослабить или убрать то правило, которое не пускает. Журналы пригодятся, чтобы убедиться, что менеджер действительно перепланировал ресурс:
journalctl -u pve-ha-crm -u pve-ha-lrm --since '-30min' --no-pagerУ служб HA именно такие имена: pve-ha-crm отвечает за менеджер кластера, pve-ha-lrm за локальный менеджер ресурсов узла.
Если ресурс ушёл в error, правило тут не поможет. По документации единственный выход из этого состояния: перевести ресурс в disabled, исправить причину и потом снова запросить запуск:
ha-manager set vm:101 --state disabled
ha-manager set vm:101 --state started
Не пытайтесь запускать такую ВМ командой qm start в обход HA, пока не поймёте, почему менеджер её остановил: для ресурса под HA штатные команды управления автоматически передаются в HA-стек, и qm start просто выставит запрошенное состояние started. Правила он не обходит, так что ВМ останется там же, где была, а вы потеряете время.
Если нужно вывести узел на обслуживание, пользуйтесь штатным режимом вместо ручного выключения. Включение переносит HA-службы на другие узлы и запоминает исходный, чтобы вернуть службы обратно:
ha-manager crm-command node-maintenance enable pve-03
ha-manager crm-command node-maintenance disable pve-03
Статус maintenance у LRM появляется сразу, как узел принял запрос, а не после окончания миграции, и режим переживает перезагрузку, пока вы не выключите его вручную. Строгое правило на этот узел в режиме обслуживания, понятное дело, остаётся тем же капканом: проверьте правила до того, как нажимать «обслуживание».
Если не хотите разбираться самому в разгар простоя, это нормальное решение. Могу посмотреть ваш кластер удалённо: правила, дубли, арифметику узлов. Обычно хватает одного рабочего дня, чтобы вернуть кластеру предсказуемое поведение при отказе.
Как не возвращаться к этому: ревизия правил, failback и учения
Правила размещения нужно ревизовать так же, как права доступа. По расписанию и при каждом изменении состава кластера. Для каждого строгого правила в журнале должна быть запись: что физически не позволяет запустить ВМ на другом узле и когда эта причина исчезнет. Нет физической причины, нет строгости. Есть физическая причина, подумайте, должна ли такая ВМ вообще быть под HA, потому что HA для ресурса, который нельзя запустить нигде, кроме одного узла, это красивое название для «ничего не делает».
Отдельно проверьте параметр failback. Для ресурса он по умолчанию равен 1: ресурс возвращается на узел с высшим приоритетом по правилам node affinity, когда тот снова в строю. Для офиса это часто не нужно: лишняя миграция посреди дня никому не радость. Отключается он так:
ha-manager set vm:101 --failback 0Свойства ресурса в этой версии сверьте по ha-manager set --help, значения по умолчанию, которые я привёл, взяты из справочника для Proxmox VE 9. Если вы только строите кластер, правила стоит продумать ещё на этапе установки, в моём руководстве по настройке Proxmox VE об этом тоже сказано.
Единственная проверка отказоустойчивости, которой я доверяю, это учения: выключить узел в окно обслуживания и посмотреть, что реально произошло. Ни одна схема на бумаге этого не заменит. Обычно после первых учений находится одно-два правила, о которых все забыли. Ниже сводная таблица для быстрой диагностики.
| Симптом | Вероятная причина | Что сделать |
|---|---|---|
| ВМ в recovery или stopped, свободные узлы есть | strict 1, допустимые узлы недоступны | rules set node-affinity <имя> --strict 0 или добавить узлы в nodes |
| Ресурс в recovery после отказа узла | строгая resource affinity невыполнима на оставшихся узлах | уменьшить число ресурсов в негативном правиле или добавить узел |
| Правило «не работает», хотя в конфиге есть | отключено после проверки допустимости | найти конфликт, объединить или удалить дубль |
| Ресурс в error | ошибки LRM, ручной цикл | set --state disabled, исправить причину, --state started |
| ВМ вернулась на «старый» узел | failback равен 1 | set vm:NNN --failback 0 |
Частые вопросы
Как понять, что ВМ не стартует из-за правила, а не из-за нехватки ресурсов?
Выполните ha-manager status, затем ha-manager rules list --resource vm:NNN и посмотрите rules.cfg. Если у ВМ есть правило с strict 1 или в ресурсе стоит recovery при свободной памяти на живых узлах, причина в правилах.
Что делает strict в правиле node affinity?
По умолчанию значение 0, правило мягкое: если перечисленные узлы недоступны, ресурс может уйти на любой другой. При strict 1 ресурс, согласно документации, будет остановлен, если ни один из указанных узлов недоступен.
Что происходит с конфликтующими правилами?
Правила, не прошедшие проверку допустимости, отключаются до устранения конфликта. Например, ресурс не может входить в два правила node affinity. Проверяйте свойство disable через ha-manager rules config.
Как отключить правило, не удаляя его?
Командой ha-manager rules set node-affinity <имя> --disable 1. Отдельных подкоманд enable и disable у rules нет.
Сколько узлов нужно для негативного resource affinity?
Правило не может перечислять больше ресурсов, чем есть узлов. Чтобы пережить потерю одного узла, нужно минимум N+1 узлов на N ресурсов, иначе правило станет невыполнимым при первом отказе.
Поможет ли qm start, если HA не запускает ВМ?
Нет. Для ресурса под HA команда qm start передаётся в HA-стек и лишь выставляет запрошенное состояние started, правила она не обходит. Надёжнее устранить причину в правилах или состоянии ресурса и только потом запускать ВМ.
Источники
- Proxmox VE: High Availability, правила и состояния — Проверены правила node affinity и resource affinity, значение strict, отключение правил при конфликтах, состояния recovery и error, режим обслуживания: https://pve.proxmox.com/pve-docs/chapter-ha-manager.html
- Proxmox VE: справочник ha-manager — Проверены подкоманды rules add/set/list/config/remove, параметры --disable, --strict, --affinity, --resource, --type, ресурсные опции --failback, --state, --max_relocate, --max_restart: https://pve.proxmox.com/pve-docs/ha-manager.1.html
- pve-docs: ha-manager.adoc (исходник документации) — Проверены примеры команд rules add, формат /etc/pve/ha/rules.cfg и список проверок допустимости правил: https://github.com/proxmox/pve-docs/blob/master/ha-manager.adoc