
В Proxmox HA есть свободные ресурсы, но ВМ не запускается: как проверить запреты affinity rules
Если в Proxmox HA памяти и процессора хватает, а ВМ не стартует, её держит не нехватка ресурсов, а запрет: строгое правило node affinity, невыполнимое resource affinity, узел в режиме обслуживания или исчерпанная политика перезапуска. Ниже порядок проверки по состоянию службы и команды, которыми я нахожу виновника за десять минут.
Почему свободная память не запускает ВМ, если HA её не разрешил
Фраза «ресурсы же есть» звучит в каждой второй аварии на кластерах Proxmox, которые я разбираю. Админ смотрит на график соседнего узла, видит 60 % свободной памяти и искренне не понимает, почему HA не поднимает машину. Логика проста, и она неверна: свободные ресурсы нужны планировщику только на последнем шаге, когда из узлов-кандидатов уже выбирают самый подходящий. А кто попадёт в кандидаты, решают правила. Если вы строите отказоустойчивость для небольшой компании и хотите, чтобы её проверил человек, который уже ломал такие кластеры, посмотрите, как мы подходим к ИТ-аутсорсингу для офисов до 50 рабочих мест.
Документация Proxmox VE описывает это прямо. Когда узел выпал из кворума и был отгорожен (fenced), служба переходит в состояние recovery, и менеджер HA ищет для неё новый узел. Он учитывает только узлы, которые онлайн и входят в кворум, затем фильтрует их правилами node affinity, потом правилами resource affinity, и лишь из остатка берёт наименее загруженный. Если после фильтров остаётся ноль узлов, служба просто висит в recovery. Память к этому моменту ещё никого не интересовала.
У этой темы уже есть два моих разбора, и повторяться я не буду. Про механику строгих правил и арифметику N+1 для отрицательного resource affinity я писал в статье про то, как affinity блокирует аварийный перенос. Здесь другой угол: у вас на руках конкретная ВМ, которая не запускается, и нужен алгоритм «от симптома к причине», причём правила в нём лишь одна из веток. Остальные ветки в чужих инструкциях почему-то опускают, хотя на практике они встречаются не реже.
С чего начать: что говорит ha-manager status о состоянии службы
Первое действие всегда одно: посмотреть, в каком состоянии HA считает службу. Не открывать консоль ВМ и не жать «Старт» по кругу: для ресурса под управлением HA и кнопка в интерфейсе, и qm start лишь передают менеджеру запрос на запуск, а если узел не разрешён правилами, запрос так и будет висеть. Состояние службы определяет, куда копать дальше, и экономит полчаса случайных попыток.
pvecm status
ha-manager status
ha-manager config
journalctl -u pve-ha-crm --since '-30min' --no-pager
journalctl -u pve-ha-lrm --since '-30min' --no-pager
Команда pvecm status показывает кворум, ha-manager status отдаёт кворум HA, текущего мастера CRM, состояние каждого LRM и каждой службы вида service vm:100 (node1, started). Журнал менеджера HA пишет все его действия: смотреть CRM нужно на узле, который сейчас мастер, а LRM, на узле, где служба должна работать. Начиная с Proxmox VE 9.2 отдельно проверьте строку статуса отказоустойчивости: armed означает, что CRM управляет службами, а disarmed означает, что автоматического fencing, failover и recovery не будет вообще. ВМ, которая «не едет» при disarmed-кластере, ничем не нарушает правил, просто ей никто не должен помогать.
Дальше читаем состояние службы. Я держу в голове короткую таблицу, она сократила мне диагностику с часа до десяти минут.
| Состояние службы | Что это значит | Где искать причину |
|---|---|---|
| fence | Узел вне кворума, HA ждёт его отгораживания | Кворум, сеть corosync, watchdog |
| recovery | Менеджер ищет новый узел и не находит подходящего | Правила node/resource affinity, число живых узлов, режим обслуживания |
| freeze | Служба заморожена на время перезагрузки узла или рестарта LRM | Ждать возврата узла либо политика выключения |
| error | Служба отключена из-за ошибок LRM | Журнал LRM, затем ручной перевод через disabled |
| started, но ВМ не работает | Старт не удался, идут рестарты и релокации | max_restart, max_relocate, хранилище, конфиг ВМ |
| stopped/disabled | Запрошенное состояние, а не авария | Запрошенное состояние в resources.cfg |
Обратите внимание на последние строки: часть «аварий» оказывается чьим-то аккуратно выставленным state disabled. Бывает и так, что у ресурса стоит ignored, тогда менеджер его вообще не трогает, а при отказе узла он не переезжает. Меня до сих пор веселит, как легко «временное» отключение из прошлого квартала превращается в постоянный диагноз.
Как проверить запреты affinity rules и найти правило, которое держит ВМ
С Proxmox VE 9.0 прежние HA Groups заменены правилами, и лежат они в файле /etc/pve/ha/rules.cfg. Типов два: node-affinity (на каких узлах ресурсу можно быть) и resource-affinity (с какими ресурсами ему можно или нельзя быть вместе). Читать файл руками безопасно, и я начинаю с него, потому что он показывает правила все разом, включая те, о которых админ забыл.
cat /etc/pve/ha/rules.cfg
ha-manager rules list
ha-manager rules list --resource vm:101
ha-manager rules config
У ha-manager rules list два фильтра, --type и --resource, а ha-manager rules config выводит таблицу с колонкой состояния, где правило с конфликтом помечено как «ignored (conflicts)». Подкоманды rules появились только в ветке 9.x, так что на своей версии сверьте синтаксис через ha-manager help rules. Теперь о том, что именно искать, в порядке убывания частоты в моей практике.
Первое: node affinity с strict 1. По умолчанию правило нестрогое: ресурс предпочитает указанные узлы, но при их отсутствии уйдёт на другие. Строгое правило (ha-manager rules set node-affinity <имя> --strict 1) означает, что при недоступности всех перечисленных узлов ресурс будет остановлен. Классика: правило создали под локальный диск, под USB-ключ или под лицензию, потом железо выкинули, а правило осталось. Приоритеты в списке узлов (node1:2,node2:1) ничего не запрещают, они лишь задают порядок предпочтения; запрещает только strict. Лечится снятием строгости: ha-manager rules set node-affinity <имя> --strict 0.
Второе: resource affinity, строгая по умолчанию. Это ловушка, потому что нестрогость узловых правил приучила всех думать, что и остальное «мягкое». Нет. Если условие resource affinity невыполнимо, документация обещает ровно это: ресурс уйдёт в recovery при failover или в error в остальных ситуациях. Отрицательное правило («держать врозь») на N ресурсов требует минимум N узлов в кластере, а чтобы оно пережило отказ одного узла, нужно N+1. Положительное правило («держать вместе») требует, чтобы вся группа поместилась на один узел, и если в одном из членов группы есть node affinity, он передаётся остальным членам.
Третье: правило отключено из-за конфликта. Менеджер проверяет допустимость правил до применения, и не прошедшие проверку отключаются, пока конфликт не устранён. Среди проверок: ресурс может входить только в одно правило node affinity, у отрицательного node affinity не может быть приоритетов, отрицательное resource affinity не может перечислять больше ресурсов, чем есть узлов в кластере, а такие ресурсы нельзя ограничить node affinity до меньшего числа узлов, чем ресурсов. Правило, отключённое по конфликту, перестаёт работать без громких ошибок в журнале, поэтому ищите его в выводе ha-manager rules config (состояние «ignored (conflicts)») и в разделе правил веб-интерфейса, а не листайте journalctl.
Главная засада в том, что допустимость правила проверяют на полном составе кластера. Правило «врозь» для трёх ВМ на трёх узлах выглядит безупречно, пока все три узла живы. Умирает один узел, и условие уже не выполнить: два узла на три ресурса. Я называю это «правилом хорошей погоды»: оно проверено в солнечный день, а работать должно в грозу. Подробный разбор этой арифметики есть в статье о запуске ВМ на свободном узле, повторять её не стану.
Если читать rules.cfg в одиночку и в разгар аварии не хочется, пришлите нам выгрузку: мы разберём правила и скажем, какое из них держит вашу ВМ. Для кластера из трёх узлов это обычно вопрос часа, а не дня.
Не только правила: режим обслуживания, политика выключения и лимиты перезапуска
Если в rules.cfg чисто, а ВМ всё равно стоит, переходим ко второй группе причин, которую в большинстве руководств пропускают. Самая коварная из них — режим обслуживания узла. Его включают командой ha-manager crm-command node-maintenance enable <узел>, и LRM помечает узел недоступным: службы с него переезжают, и на него не размещаются новые. Документация отдельно подчёркивает, что режим сохраняется после перезагрузки и сбрасывается только командой disable или ручной очисткой состояния менеджера. То есть узел, который вы вчера обновили и перезагрузили, может спокойно лежать в обслуживании неделю и числиться в кластере, не принимая нагрузку. А кластер из трёх узлов с одним спрятанным в обслуживании ведёт себя как кластер из двух.
ha-manager crm-command node-maintenance disable pve-02
ha-manager status
Проверить, не забыли ли вы такой узел, можно по ha-manager status: в строке LRM этого узла будет видно maintenance mode, а по журналу CRM виден момент включения режима. После выключения режима службы, которые стояли на узле в момент включения обслуживания, возвращаются обратно. Для этого не нужно ничего перезагружать, и это хорошая новость.
Вторая причина лежит в политике выключения узла. В datacenter.cfg её задаёт ключ ha: shutdown_policy=<значение>, а значений четыре: migrate, failover, freeze и conditional (последнее стоит по умолчанию ради обратной совместимости). С политикой migrate узел при остановке переносит свои HA-службы на другие, и тут документация прямо предупреждает: строгие правила node affinity говорят менеджеру, что служба не может работать вне выбранного набора узлов, а если ни один из них недоступен, выключение зависает до вмешательства человека. С политикой freeze службы замораживаются и не восстанавливаются, пока узел не вернётся. Поэтому «узел перезагрузили, а ВМ не поднялась на соседе» может быть не аварией, а штатным поведением freeze или conditional при перезагрузке, а значит ждать нужно возврата узла, а не искать запреты.
Третья причина — исчерпанная политика перезапуска. Если ВМ сама не стартует (повреждённый конфиг, недоступное хранилище, отсутствующий ISO в приводе), менеджер сначала перезапускает её на текущем узле до max_restart раз (по умолчанию 1), затем переносит на другой узел до max_relocate раз (по умолчанию 1). Счётчик релокаций сбрасывается только после хотя бы одного успешного старта. Если причина осталась, а попытки кончились, служба уходит в error. Тут уже не поможет ни правка правил, ни режим обслуживания, надо открывать журнал LRM и искать, почему ВМ физически не запускается.
Отдельно упомяну выбор узла планировщиком. Режим CRS по умолчанию называется basic, и он выбирает узел с наименьшим числом активных гостей, а не с наибольшим запасом памяти. Режим static-load опирается на настроенные квоты CPU и памяти активных гостей, а появившийся в 9.2 dynamic-load добавляет к ним средние фактические нагрузки; в статусе технологического превью у них остаётся только перебалансировка при старте (rebalance on start). Поэтому «на втором узле свободно больше памяти, а ВМ выбрала первый» — не баг. Если же вам важно, чтобы планировщик смотрел на память, читайте про автобалансировку без переноса ВМ в Proxmox VE 9.2 и проверяйте, что режим не меняет поведения при аварии.
Разбор: «Тёплые руки», 29 рабочих мест и узел, забытый в обслуживании
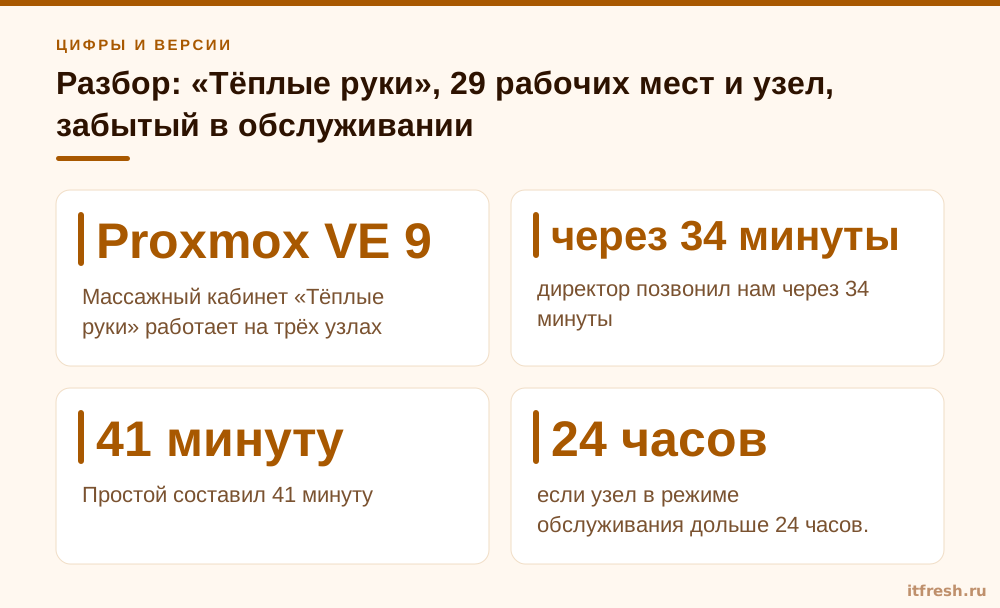
Массажный кабинет «Тёплые руки» работает на трёх узлах Proxmox VE 9 с общим хранилищем, 29 рабочих мест. В HA четыре ВМ: vm:101 (запись клиентов и касса), vm:102 (файловый сервер), vm:103 (контроллер домена) и vm:104 (видеонаблюдение). Администратор приходящий, раз в неделю. В понедельник он обновил pve-02, включил для этого режим обслуживания, перезагрузил узел, убедился, что тот вернулся в кластер, и закрыл консоль. Выключить режим обслуживания в чек-листе не было, ведь узел виден и зелёный.
Через девять дней у pve-03 отказал блок питания. Кворум остался, fencing отработал, vm:102 и vm:103 спокойно переехали на pve-01, а vm:101 с кассой, жившая на pve-03, повисла в recovery. Свободной памяти на pve-01 было с запасом, и именно это ввело в заблуждение: директор позвонил нам через 34 минуты, после того как администратор безуспешно нажимал «Старт» в веб-интерфейсе. Запись клиентов не работала, касса переключилась на бумажные чеки, и ни один сотрудник не мог открыть расписание.
Диагностика заняла около пяти минут. ha-manager status показал службу vm:101 в recovery и LRM узла pve-02 в maintenance mode. В rules.cfg нашлось отрицательное resource affinity для vm:101 и vm:104, поставленное, чтобы касса и видеонаблюдение не жили на одном узле. Само правило корректное: две ВМ на трёх узлах переживают отказ одного, арифметика N+1 сходится. Но после отказа pve-03 в кластере жили pve-01 и pve-02, причём pve-02 всё ещё сидел в обслуживании: фактически принимающий узел был один, на нём уже работала vm:104, и посадить к ней кассу правило не давало. Выключение режима командой ha-manager crm-command node-maintenance disable pve-02 вернуло в работу второй узел, и vm:101 поднялась на нём через пару минут. Правило мы оставили: оно защищало ровно то, что должно, а сломал всё забытый режим.
Простой составил 41 минуту, а при нормальном порядке действий уложился бы в 3–4 минуты. Мы сделали три вещи. Во-первых, добавили в чек-лист любых работ на узле последним пунктом ha-manager status и проверку отсутствия узлов в обслуживании. Во-вторых, настроили оповещение в мониторинге, которое срабатывает, если узел в режиме обслуживания дольше 24 часов. В-третьих, провели учения: выключили узел по плану и засекли время переезда ВМ, повторяем их раз в квартал. Ничего революционного, обычная гигиена, но «бэкап делают все, проверяет его почти никто» относится и к кластеру: HA настраивают все, а вот проверяют его только аварии.
Что делать прямо сейчас, если ВМ не запускается, и как не вернуться сюда снова
Порядок действий в аварии я свёл к последовательности без импровизации. Сначала убедитесь, что кластер в кворуме и менеджер в состоянии armed (pvecm status, ha-manager status). Затем найдите состояние службы по таблице выше. Для recovery проверьте узлы в обслуживании и выключите режим, если он больше не нужен, потом читайте rules.cfg: строгие node affinity, отрицательные resource affinity, отключённые по конфликту правила. Для error читайте журнал LRM, исправляйте физическую причину и переводите ресурс через disabled в started. Не долбите qm start, он всё равно уйдёт запросом к HA, и не правьте файлы вручную в обход ha-manager: каталог /etc/pve кластерный, и ошибка размножится на все узлы.
ha-manager rules set node-affinity <имя_правила> --strict 0
ha-manager set vm:101 --state disabled
ha-manager set vm:101 --state started
Снятие строгости разумно, если правило устарело, и вредно, если оно защищает лицензию или данные: ВМ с привязкой к узлу не обязана уезжать на любой другой. Сначала поймите, зачем правило создавали. Эту работу лучше проделать до аварии, а не во время неё, ведь в 03:00 с директором на линии принимать решения о лицензиях неприятно.
Профилактика у меня состоит из четырёх вещей. Первая: ревизия rules.cfg при каждом изменении состава кластера, включая добавление узла, вывод из эксплуатации и перенос хранилища. Вторая: для каждого отрицательного правила арифметика N+1 и честный ответ на вопрос, что случится при выпадении одного узла. Третья: мониторинг узлов в обслуживании и служб, висящих в recovery или error дольше пяти минут, на практике это отдельные триггеры в системе мониторинга. Четвёртая: плановые учения раз в квартал, потому что статус «правила допустимы» не доказывает, что ВМ переедет. Если у вас всего два узла и QDevice, прочитайте ещё и про флаги QDevice и кворум в Proxmox: без устойчивого кворума все остальные проверки теряют смысл. А итоговый план действий при падении всего кластера стоит держать в виде плана аварийного восстановления на одну страницу.
Частые вопросы
Почему ВМ в Proxmox HA не запускается, если на узле достаточно памяти?
Потому что узел-кандидат выбирают по правилам и состоянию кластера, а память учитывается в последнюю очередь. Проверьте строгое node affinity, resource affinity, отключённые по конфликту правила, узлы в режиме обслуживания и политику перезапуска.
Где в Proxmox VE 9 хранятся правила affinity?
В файле /etc/pve/ha/rules.cfg. Правила node-affinity заменили прежние HA Groups. Просмотреть их можно командой cat /etc/pve/ha/rules.cfg, а также в разделе HA веб-интерфейса.
Чем отличается состояние recovery от error в Proxmox HA?
В recovery менеджер ищет подходящий узел и не находит его, чаще всего из-за правил или нехватки живых узлов. Error означает отключение службы из-за ошибок LRM. Выйти из него можно только через перевод ресурса в disabled и затем в started.
Строгая ли resource affinity по умолчанию?
Да, в отличие от node affinity, она строгая по умолчанию. Если условие нельзя выполнить, ресурс уходит в recovery при failover или в error в остальных ситуациях.
Может ли узел в режиме обслуживания мешать запуску ВМ после перезагрузки?
Может. Режим обслуживания сохраняется после перезагрузки и сбрасывается только командой ha-manager crm-command node-maintenance disable или очисткой состояния менеджера. Пока он включён, узел не принимает службы.
Источники
- Proxmox VE Documentation: High Availability — Проверены правила node affinity и resource affinity, проверки допустимости, состояния служб, max_restart и max_relocate, режим обслуживания, shutdown_policy, режимы CRS. https://pve.proxmox.com/pve-docs/chapter-ha-manager.html
- Proxmox pve-docs: ha-manager.adoc (исходник документации) — Проверен раздел Rules: невыполнимое resource affinity ведёт к recovery при failover или к error в остальных случаях, список проверок допустимости. https://github.com/proxmox/pve-docs/blob/master/ha-manager.adoc
- Proxmox pve-ha-manager: исходник CLI ha-manager — Проверены подкоманды rules list/config/add/set/remove, состояние «ignored (conflicts)», crm-command node-maintenance enable/disable. https://github.com/proxmox/pve-ha-manager/blob/master/src/PVE/CLI/ha_manager.pm
- Proxmox: пресс-релиз Proxmox VE 9.2 — Проверено появление в 9.2 разоружения и повторного взведения HA (armed/disarmed) по всему кластеру. https://www.proxmox.com/en/about/press-releases/proxmox-virtual-environment-9-2