
Как включить автобалансировку Proxmox VE 9.2 и исключить важную ВМ
Типичная картина: администратор выбирает для CRS режим Dynamic, видит перекос между узлами и ждёт миграций. Час проходит — ничего. Причина обычно не в неисправности: динамический расчёт нагрузки и автоматическая перебалансировка включаются разными параметрами. Я, Семёнов Евгений Сергеевич, покажу рабочую конфигурацию, объясню пороги планировщика и отдельно разберу правильное исключение чувствительной ВМ — без удаления её из HA и без ненужной привязки к одному хосту.
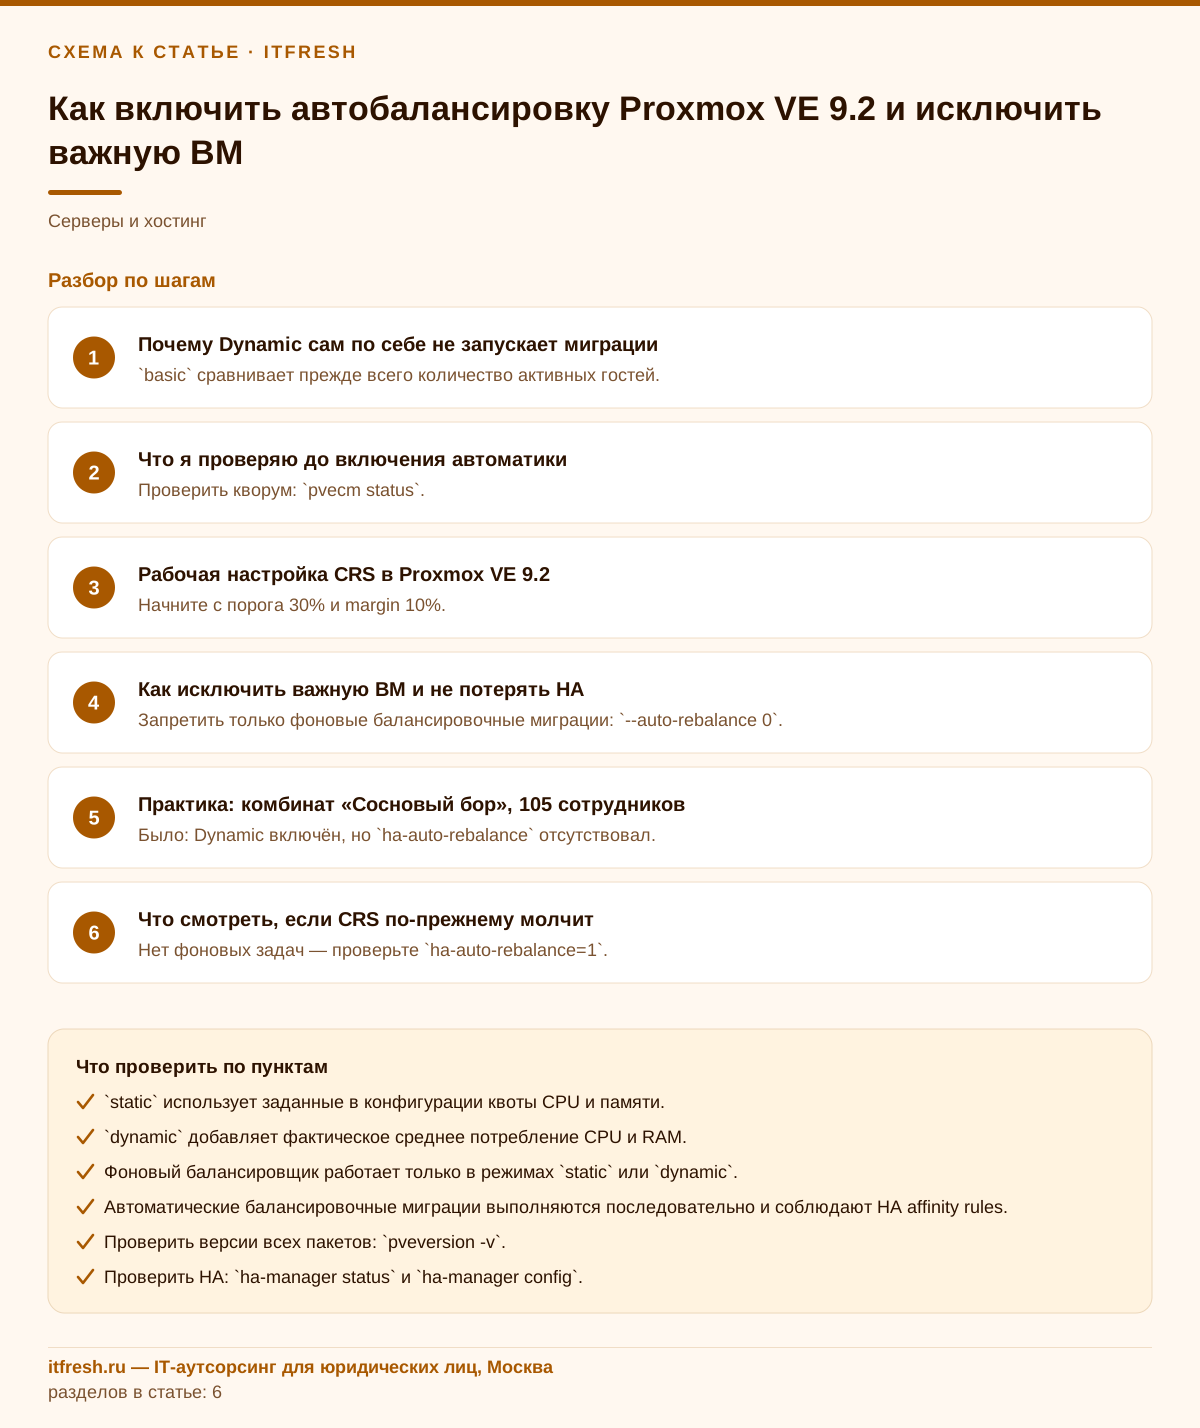
Почему Dynamic сам по себе не запускает миграции
В Proxmox VE 9.2 появился полноценный динамический балансировщик Cluster Resource Scheduler. Релиз вышел 21 мая 2026 года. В режиме dynamic планировщик учитывает не только выделенные гостям CPU и RAM, но и фактическую загрузку узлов и виртуальных машин. Однако параметр ha=dynamic выбирает способ расчёта нагрузки, а не разрешает фоновые миграции. Автоматическая перебалансировка включается отдельно параметром ha-auto-rebalance=1; по умолчанию он равен нулю. Вот на этом месте настройка чаще всего и ломается.
Есть ещё один похожий флажок — ha-rebalance-on-start. Он заставляет CRS подобрать подходящий узел, когда HA-ресурс переходит из остановленного состояния в запущенное. Уже работающие ВМ из-за него периодически перераспределяться не будут. Более того, для режимов static и dynamic эта функция в документации 9.2 всё ещё обозначена как technology preview. Я её без конкретной необходимости не включаю. Для постоянного выравнивания кластера нужен именно новый автоматический load balancer.
Миграционными кандидатами могут быть только ВМ и контейнеры, добавленные в HA. При этом в режиме dynamic загрузка узла оценивается по его активным гостям, а не только по HA-ресурсам. Получается важная тонкость: не-HA машина способна сделать хост перегруженным, но перенести её CRS не сможет — будет искать подходящий HA-ресурс рядом. В документации прямо сказано, что включение не-HA гостей в балансировку только планируется. Если подходящего кандидата нет или перенос не даст требуемого улучшения, внешне планировщик выглядит бездействующим, хотя расчёт выполняется примерно каждые десять секунд.
- `basic` сравнивает прежде всего количество активных гостей.
- `static` использует заданные в конфигурации квоты CPU и памяти.
- `dynamic` добавляет фактическое среднее потребление CPU и RAM.
- Фоновый балансировщик работает только в режимах `static` или `dynamic`.
- Автоматические балансировочные миграции выполняются последовательно и соблюдают HA affinity rules.
Что я проверяю до включения автоматики
Начинаю с базы: минимум три узла для надёжного кворума, одинаково доступное общее хранилище и исправный HA. Именно такие требования приводит Proxmox. Corosync не должен конкурировать с Ceph или миграциями за перегруженный интерфейс. Синхронизация времени, watchdog и резервирование питания тоже не декоративные пункты. Если кластер уже теряет кворум или периодически подвисает на storage, автобалансировщик лишь начнёт чаще попадать в существующую неисправность.
Затем вручную переношу тестовую ВМ между каждой парой разрешённых узлов. Проверяю bridge, VLAN, доступность дисков, пропускную способность migration network и совместимость CPU. В неоднородном кластере модель процессора host нередко мешает переезду на более старый сервер. Проблемы создают и локальные ISO, физические устройства, USB или PCI passthrough. Для таких зависимостей Proxmox рекомендует resource mappings либо строгие node affinity rules, ограничивающие список допустимых хостов.
Последняя проверка — запас N+1. Мне неинтересен красивый баланс, при котором после отказа одного узла оставшиеся два уходят в swap. Суммарные рабочие ВМ должны помещаться на оставшихся серверах с разумным резервом памяти. CPU допустимо переподписать осторожнее, а память — нет: сам Proxmox при оценке размещения придаёт ей больший вес как действительно ограниченному ресурсу. Если резерва нет, сначала уменьшаю аппетиты гостей или добавляю RAM, и только потом разрешаю автомиграции.
- Проверить кворум: `pvecm status`.
- Проверить версии всех пакетов: `pveversion -v`.
- Проверить HA: `ha-manager status` и `ha-manager config`.
- Выполнить ручную live migration тестовой ВМ во всех направлениях.
- Убедиться, что после отказа одного узла кластер не исчерпает RAM.
Рабочая настройка CRS в Proxmox VE 9.2
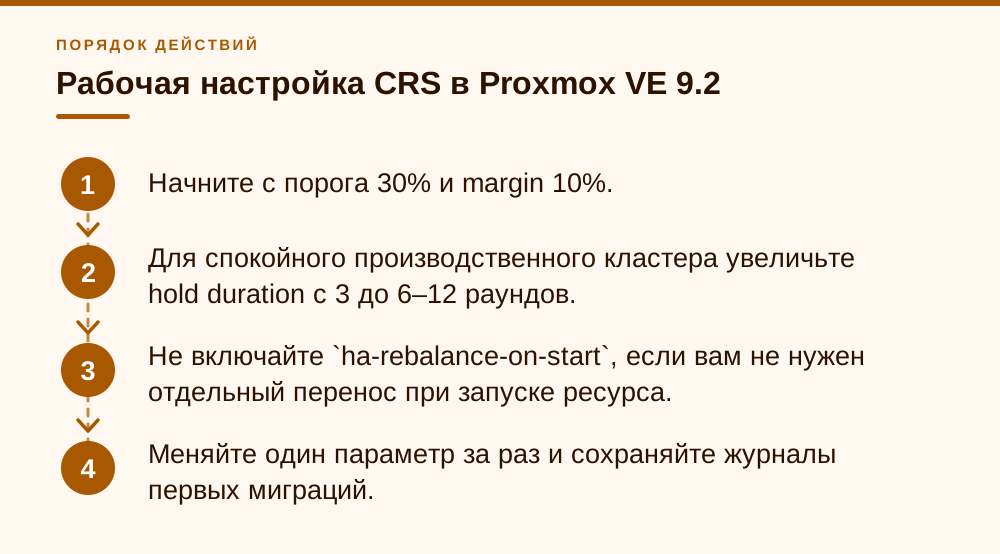
В GUI нужное окно находится в Datacenter → Options → Cluster Resource Scheduling. Я выбираю Dynamic, включаю Automatic Rebalance, оставляю метод bruteforce, порог дисбаланса 30 % и минимальное улучшение 10 %. Значения 30 и 10 — штатные значения по умолчанию версии 9.2. Порог относится не к загрузке отдельного CPU, а к кластерному показателю дисбаланса, рассчитанному из среднего и стандартного отклонения нагрузок узлов и нормализованному в диапазон 0–100 %. Поэтому «на одном сервере CPU 70 %» само по себе ничего не гарантирует.
Стандартная hold duration равна трём раундам HA, то есть примерно 30 секундам. На производстве я ставлю шесть раундов. Минута ожидания ничего не ломает, зато отсекает часть коротких всплесков. Метод bruteforce для кластера на несколько десятков гостей оставляю штатным: менять его на topsis только потому, что название выглядит умнее, смысла не вижу. Порог и margin в ноль тоже не ставлю. При нулевом пороге CRS будет искать миграцию после каждого периода ожидания, а нулевой margin разрешит перенос без ожидаемого улучшения баланса.
То же самое можно настроить через API CLI. Команду выполняют на одном узле: /etc/pve реплицируется кластерной файловой системой. После изменения я сразу читаю результат и сам конфигурационный файл.
pvesh set /cluster/options --crs 'ha=dynamic,ha-auto-rebalance=1,ha-auto-rebalance-threshold=30,ha-auto-rebalance-hold-duration=6,ha-auto-rebalance-margin=10,ha-auto-rebalance-method=bruteforce'
pvesh get /cluster/options --output-format yaml
grep '^crs:' /etc/pve/datacenter.cfg
В /etc/pve/datacenter.cfg получится одна кластерная строка:
crs: ha=dynamic,ha-auto-rebalance=1,ha-auto-rebalance-hold-duration=6,ha-auto-rebalance-margin=10,ha-auto-rebalance-method=bruteforce,ha-auto-rebalance-threshold=30- Начните с порога 30 % и margin 10 %.
- Для спокойного производственного кластера увеличьте hold duration с 3 до 6–12 раундов.
- Не включайте `ha-rebalance-on-start`, если вам не нужен отдельный перенос при запуске ресурса.
- Меняйте один параметр за раз и сохраняйте журналы первых миграций.
Как исключить важную ВМ и не потерять HA
Для запрета именно балансировочных миграций в Proxmox VE 9.2 есть отдельное свойство HA-ресурса auto-rebalance. Оно включено по умолчанию. Для чувствительной ВМ я выключаю его, а саму машину оставляю в HA. Это точнее и безопаснее, чем удаление из HA или жёсткая привязка к единственному узлу. В GUI откройте Datacenter → HA → Resources, выберите ВМ, нажмите Edit и снимите разрешение автоматической перебалансировки.
Через CLI настройка занимает одну команду. Допустим, важная машина имеет VMID 220:
ha-manager set vm:220 --auto-rebalance 0
ha-manager config
Соответствующий фрагмент /etc/pve/ha/resources.cfg выглядит так:
vm: 220
        auto-rebalance 0
        state started
После этого vm:220 не рассматривается как кандидат фонового load balancer. Если она входит в положительное resource affinity rule, из автобалансировки исключается весь связанный набор ресурсов: иначе CRS не смог бы сохранить требование совместного размещения.
Здесь важно не обещать лишнего. auto-rebalance 0 не прибивает машину гвоздями к хосту. HA всё ещё может восстановить её на другом узле после отказа, администратор может выполнить ручную миграцию, а другие точки планирования — изменение affinity rule, обслуживание или отдельная логика запуска — продолжают действовать. Я считаю это правильным поведением: плановые фоновые переезды запрещены, аварийное восстановление сохранено.
Если требование буквально звучит как «эта ВМ никогда и ни при каких обстоятельствах не должна оказаться на другом сервере», создайте строгую положительную node affinity rule с единственным узлом. Но тогда при его отказе HA остановит ресурс, потому что разрешённого места больше нет. Это уже осознанный отказ от автоматического failover. Для обычной чувствительной базы я выбираю auto-rebalance 0; строгую привязку оставляю для локального оборудования и лицензий, действительно завязанных на хост.
- Запретить только фоновые балансировочные миграции: `--auto-rebalance 0`.
- Запретить любое размещение вне выбранного хоста: strict node affinity.
- Удалить из HA: исчезнут и автобалансировка, и автоматическое восстановление.
- Проверить положительные resource affinity rules: исключение одной ВМ может исключить весь связанный набор.
Практика: автосервис «Ремзона на Южной», 18 рабочих мест
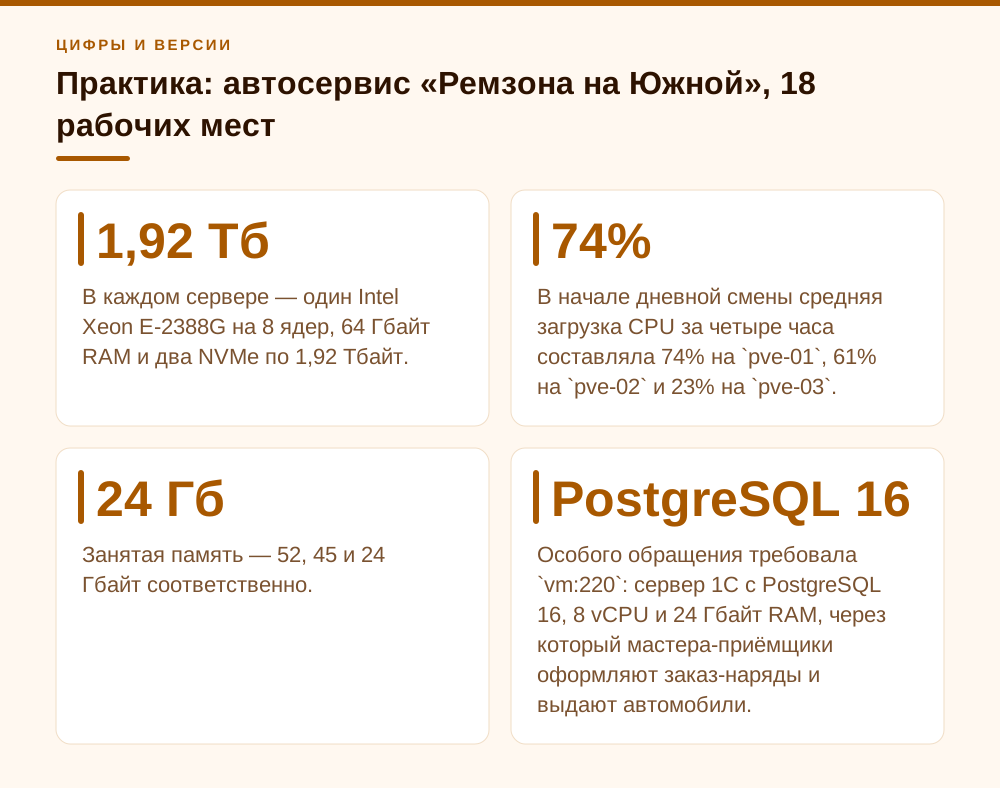
Название компании условное, характеристики проекта обезличены. У автосервиса «Ремзона на Южной» на 18 рабочих мест работали три компактных узла PVE 9.2 с актуальными на момент настройки пакетами, ядром 7.0, QEMU 11.0 и Ceph Squid 19.2.3. В каждом сервере — один Intel Xeon E-2388G на 8 ядер, 64 Гбайт RAM и два NVMe по 1,92 Тбайт. Ceph и migration network шли по двум 10GbE-интерфейсам, corosync — по отдельной резервированной сети. На кластере находились 9 ВМ: сервер 1С с учётом заказ-нарядов, терминальный сервер, файловый сервер, IP-телефония, видеонаблюдение и служебные машины; 7 из них управлялись HA.
В начале дневной смены средняя загрузка CPU за четыре часа составляла 74 % на pve-01, 61 % на pve-02 и 23 % на pve-03. Занятая память — 52, 45 и 24 Гбайт соответственно. Администратор уже выбрал Dynamic и включил Rebalance on Start, поэтому был уверен, что CRS работает. В конфигурации мы увидели следующее:
crs: ha=dynamic,ha-rebalance-on-start=1Фоновой перебалансировки здесь нет. Дополнительно два самых тяжёлых сервера — видеонаблюдение и терминальный — не состояли в HA: их нагрузка влияла на оценку узлов, но сами они не могли стать кандидатами на перенос.
Особого обращения требовала vm:220: сервер 1С с PostgreSQL 16, 8 vCPU и 24 Гбайт RAM, через который мастера-приёмщики оформляют заказ-наряды и выдают автомобили. Во время закрытия смены и массового проведения документов СУБД интенсивно меняла память. На предварительном ручном тесте завершающая фаза live migration дала прикладной тайм-аут на 11 секунд, хотя сама ВМ не выключалась. Для бухгалтерии это мелочь, а у стойки приёмки — зависший заказ-наряд, ошибка печати и клиент, ждущий ключи. Мы договорились: при аварии HA имеет право поднять сервер на другом узле, но фоновая миграция в течение смены запрещена. Поэтому я применил ha-manager set vm:220 --auto-rebalance 0, а не strict affinity.
Для кластера включили dynamic auto-rebalance с порогом 30 %, margin 10 % и hold duration шесть раундов. За первые 36 часов CRS последовательно перенёс три обычные ВМ; вся серия заняла 12 минут. vm:220 осталась на pve-01. Во вторую дневную смену четырёхчасовые средние значения CPU составили 51 %, 47 % и 43 %, а максимум занятой памяти на одном узле снизился с 52 до 44 Гбайт. После недели наблюдения незапланированных повторных переездов не было. Для меня хороший результат именно такой: не идеальная симметрия, а снятый перегруз, сохранённый N+1 и понятное исключение для важного сервиса.
- Было: Dynamic включён, но `ha-auto-rebalance` отсутствовал.
- Исправили: включили автоматический балансировщик и увеличили hold duration до минуты.
- Для `vm:220` отключили только участие в фоновой перебалансировке.
- Итог: три миграции, более ровная загрузка и ни одного переноса чувствительной ВМ.
Что смотреть, если CRS по-прежнему молчит
Диагностику я начинаю не с перезапуска служб, а с ограничений. Проверяю, включён ли глобальный ha-auto-rebalance, состоит ли нужная ВМ в HA, не снят ли у неё auto-rebalance, допускают ли affinity rules хотя бы один другой узел. Затем смотрю RAM, CPU-совместимость, storage и сетевые bridge. CRS всегда подчиняется правилам размещения и не обязан находить миграцию в заведомо тесном кластере.
Минимальный набор команд следующий:
pveversion -v
pvecm status
ha-manager status
ha-manager config
pvesh get /cluster/options --output-format yaml
ha-manager rules config
journalctl -u pve-ha-crm --since '-2 hours' --no-pager
Если в вашей сборке ha-manager не знает параметр --auto-rebalance, сначала обновите пакеты ветки 9.2 и повторно проверьте pveversion -v. Не вписывайте неизвестное свойство руками в cluster filesystem. Ориентир для статьи — документация Proxmox VE 9.2.10, обновлённая 8 сентября 2026 года.
Если автоматическая задача начинается, но падает, CRS свою часть уже выполнил. Дальше исследуйте task log миграции: несовместимый CPU-флаг, локальный диск, отсутствующий bridge, passthrough или недостаточная скорость сети. Когда задач нет вообще, смотрите порог, hold duration, margin и список кандидатов. Короткий всплеск или перенос, улучшающий расчётный дисбаланс лишь на 7 % при margin 10 %, корректно остаётся без реакции.
И последнее. Не снижайте пороги только ради демонстрации движения. Каждая миграция нагружает сеть, хранилище и CPU, а у активно меняющей память ВМ способна затянуться. Я сначала исключаю чувствительные сервисы, затем включаю балансировщик со спокойными значениями и наблюдаю минимум сутки. На разницу CPU в десять процентных пунктов можно не обращать внимания. На swap, миграционный пинг-понг и отсутствие аварийного резерва — нельзя.
- Нет фоновых задач — проверьте `ha-auto-rebalance=1`.
- В расчёте мало кандидатов — проверьте членство ВМ в HA и их `auto-rebalance`.
- Кандидат некуда переносить — разберите affinity rules и зависимости гостя.
- Миграция падает — читайте полный task log и проверяйте инфраструктуру.
- Переездов слишком много — увеличьте threshold, margin или hold duration.
Частые вопросы
Почему после выбора Dynamic ни одна ВМ не мигрирует?
Режим `dynamic` определяет способ расчёта нагрузки. Для фоновых миграций отдельно включите `ha-auto-rebalance=1`. Кроме того, кандидат должен быть HA-ресурсом, иметь `auto-rebalance=1` и допустимый целевой узел.
Можно ли исключить ВМ из автобалансировки, но сохранить HA?
Да. Выполните `ha-manager set vm:220 --auto-rebalance 0`. ВМ перестанет быть кандидатом фонового балансировщика, но сохранит аварийное восстановление и возможность ручной миграции.
Будет ли CRS учитывать нагрузку ВМ, не добавленных в HA?
Загрузка узла в режиме `dynamic` считается по его активным гостям, поэтому такая ВМ влияет на картину. Однако автоматически мигрировать не-HA гостей балансировщик 9.2 не может — по документации это только запланировано.
Как полностью запретить ВМ запускаться на других узлах?
Создайте strict node affinity rule с единственным разрешённым узлом. Учтите, что после его отказа HA не сможет запустить ВМ где-либо ещё.
Какие пороги выбрать для начала?
Я начинаю со штатных 30 % для imbalance threshold и 10 % для minimum improvement, а hold duration увеличиваю с трёх до шести раундов. Затем корректирую значения по журналам и поведению конкретного кластера.
Может ли исключённая ВМ всё равно переехать?
Да. `auto-rebalance 0` запрещает только фоновые балансировочные миграции. Восстановление после отказа, ручная миграция и действия, вызванные другими HA-правилами, остаются возможными.
Источники
- Proxmox VE 9.2 release notes — Proxmox VE Roadmap, разделы “Proxmox VE 9.2”, “Highlights” и “HA Manager”; релиз 21 мая 2026 года. https://pve.proxmox.com/wiki/Roadmap#Proxmox_VE_9.2
- Proxmox VE Administration Guide 9.2.10 — Глава High Availability, разделы Requirements, Cluster Resource Scheduling, CRS Scheduling Mode, CRS Scheduling Points и CRS Load Balancer; обновлено 8 сентября 2026 года. https://pve.proxmox.com/pve-docs/chapter-ha-manager.html
- datacenter.cfg(5), Proxmox VE 9.2 — Раздел параметра `crs`: режимы HA, `ha-auto-rebalance`, threshold, hold duration, margin, method и `ha-rebalance-on-start`. https://pve.proxmox.com/pve-docs/datacenter.cfg.5.html
- ha-manager(1), Proxmox VE 9.2 — Команды управления HA-ресурсами и свойство `--auto-rebalance`, включённое по умолчанию. https://pve.proxmox.com/pve-docs/ha-manager.1.html
- Proxmox Cluster File System — Описание pmxcfs, репликации `/etc/pve`, файлов `datacenter.cfg`, `ha/resources.cfg` и `ha/rules.cfg`. https://pve.proxmox.com/pve-docs/chapter-pmxcfs.html
- Proxmox VE 9.2 press release — Proxmox Server Solutions, «Proxmox Virtual Environment 9.2 with Dynamic Load Balancer released», 21 мая 2026 года. https://proxmox.com/en/about/company-details/press-releases/proxmox-virtual-environment-9-2