
Pacemaker не запускает ресурсы без STONITH: чем на самом деле кончается stonith-enabled=false
Pacemaker не запускает ресурсы, потому что fencing включён по умолчанию, а устройства изоляции нет. Лечится это настройкой STONITH, а не строкой stonith-enabled=false, которая открывает дорогу split-brain. Ниже разбираю, что ломается без изоляции, реальный инцидент с двойной записью, рабочую конфигурацию и изменения Pacemaker 3.0.
Почему Pacemaker не запускает ресурсы без STONITH
Картина всегда одинаковая. Собрали двухузловой кластер, corosync поднялся, pcs status показывает оба узла Online, а ресурсы висят в Stopped. Так выглядит почти каждый свежий кластер под 1С и PostgreSQL, который собирают по короткой инструкции из интернета. Идём проверять конфигурацию и получаем ровно тот текст, с которого начинается вся история.
crm_verify -L -V
# error: Resource start-up disabled since no STONITH resources have been defined
# error: Either configure some or disable STONITH with the stonith-enabled option
# error: NOTE: Clusters with shared data need STONITH to ensure data integrity
Это не баг сборки и не кривой пакет. Свойство stonith-enabled (в ветке 3.0 — fencing-enabled) по умолчанию равно true, и так сделано намеренно: кластер не должен начинать работу раньше, чем у него появится физическая возможность выключить сбойный узел. Планировщик видит, что изоляция включена, а ни одного fence-устройства в CIB нет. Значит, в момент, когда узел перестанет отвечать, кластер не сможет сделать ничего безопасного. И он честно отказывается стартовать, вместо того чтобы стартовать и потом испортить данные.
Дальше из раза в раз происходит одно и то же: человек копирует текст ошибки в поиск, первая же ссылка предлагает pcs property set stonith-enabled=false, ресурсы поднимаются, тикет закрыт. Я разбирал этот сценарий у клиентов не один раз, и почти всегда флаг ставил не текущий админ, а подрядчик, который «поднимал кластер» год-два назад. Никто не помнит, почему он там. Никто не проверяет, что он там. До первого сетевого моргания.
Сама документация ClusterLabs в руководстве Clusters from Scratch пишет об этом без дипломатии: отключение fencing совершенно неприемлемо для продуктивного кластера, оно заставляет кластер притворяться, что сбойные узлы безопасно выключены, а часть вендоров отказывается поддерживать кластеры с выключенной изоляцией. Я бы добавил только одно: даже на тестовом стенде без fencing вы не проверите настоящие сценарии отказа, то есть тестируете не тот кластер, который пойдёт в работу.
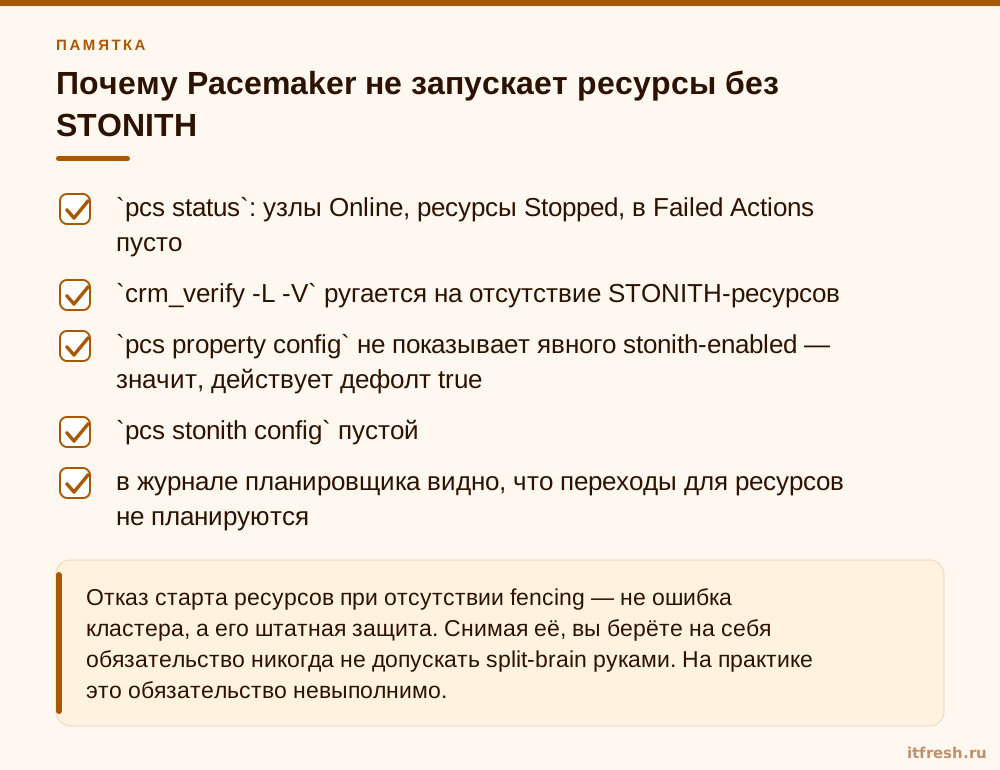
- `pcs status`: узлы Online, ресурсы Stopped, в Failed Actions пусто
- `crm_verify -L -V` ругается на отсутствие STONITH-ресурсов
- `pcs property config` не показывает явного stonith-enabled — значит, действует дефолт true
- `pcs stonith config` пустой
- в журнале планировщика видно, что переходы для ресурсов не планируются
Чем опасен stonith-enabled=false: что ломается без изоляции узла
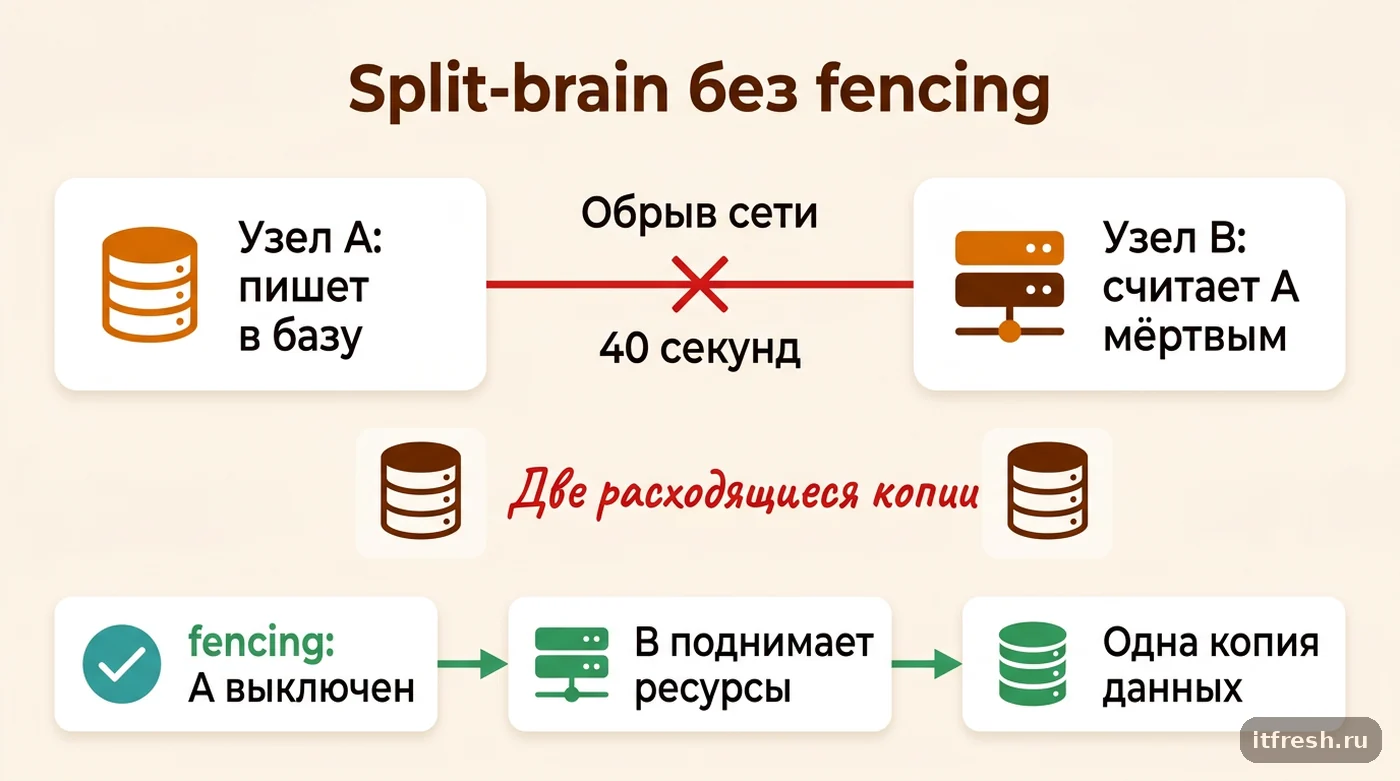
Мысль, которую надо один раз понять: кластер физически не способен отличить «узел выключился» от «узел жив, но до него не доходят пакеты». Из corosync обе ситуации выглядят одинаково — узел пропал из членства. Разница только в последствиях: в первом случае ресурсы на нём мертвы, во втором они прекрасно работают и продолжают писать на диск.
Fencing превращает предположение в факт. Кластер не гадает: он берёт устройство изоляции (BMC, гипервизор, SCSI-резервации, watchdog) и отключает подозрительный узел. И только получив подтверждение, что узел выключен, разрешает поднять его ресурсы в другом месте. Альтернатива описана в документации прямо: если бы кластер просто считал неотвечающие узлы выключенными, несколько экземпляров одного ресурса запускались бы на разных узлах.
Именно это и делает stonith-enabled=false. Он не «выключает лишнюю проверку», а заставляет кластер считать отвалившийся узел обесточенным. Дальше начинается арифметика: плавающий IP поднимается на втором узле, хотя первый его не отпускал; блочное устройство монтируется вторым узлом, хотя первый держит на нём открытые файлы; PostgreSQL стартует как основной поверх копии, у которой уже есть свой основной. В DRBD это заканчивается split-brain и StandAlone, в СУБД — двумя разъехавшимися базами, которые нельзя просто «слить обратно».
Честно про масштаб риска. Если ваш ресурс — stateless-сервис за балансировщиком, катастрофы не будет, максимум некрасиво. Но как только под кластером появляется общий LUN, DRBD, GFS2/OCFS2 или СУБД с реплицируемым томом, фраза «пусть поработает без fencing» превращается в вопрос времени, а не вероятности. Я видел это в живую, и ниже расскажу, как именно.
- Общий LUN / iSCSI / FC — двойное монтирование ФС, не рассчитанной на кластерный доступ, повреждение метаданных
- DRBD — split-brain, StandAlone, ручной выбор «жертвы» и потеря части изменений
- PostgreSQL с данными на реплицируемом томе — два основных сервера, расхождение, ручная сверка
- Плавающий IP — дубль адреса в сети, ARP-флаппинг, клиенты попадают то на один узел, то на другой
- Очереди и брокеры — дублирование обработки, которое всплывает у бизнеса, а не в мониторинге
Разбор из практики: «Душевный баланс», два узла, 1С и PostgreSQL
Центр психологического консультирования «Душевный баланс», 50 рабочих мест: администраторы записи, психологи, бухгалтерия. Вся запись клиентов, расписание кабинетов и расчёты живут в 1С на PostgreSQL. Конструкция типовая для компании такого размера: две виртуальные машины на двух разных хостах ESXi, AlmaLinux 9, Pacemaker из ветки 2.1, corosync 3, DRBD 9 под каталог данных PostgreSQL, поверх — сервер 1С. Группа ресурсов: DRBD в роли Primary, файловая система, PostgreSQL, VIP, служба 1С. Собирал это сторонний интегратор, дальше кластер жил сам по себе и честно переживал плановые переключения.
Когда нас позвали разбирать инцидент, первое, что я увидел: pcs property config со строкой stonith-enabled: false и ни одного stonith-ресурса в CIB. Второе: оба хоста были подключены к одному стековому коммутатору, кластерная сеть и сеть управления шли по одному линку. Третье: в DRBD стояла политика fencing resource-and-stonith с обработчиками crm-fence-peer, но без работающего STONITH в Pacemaker она мало что гарантирует — подтвердить изоляцию соседа некому.
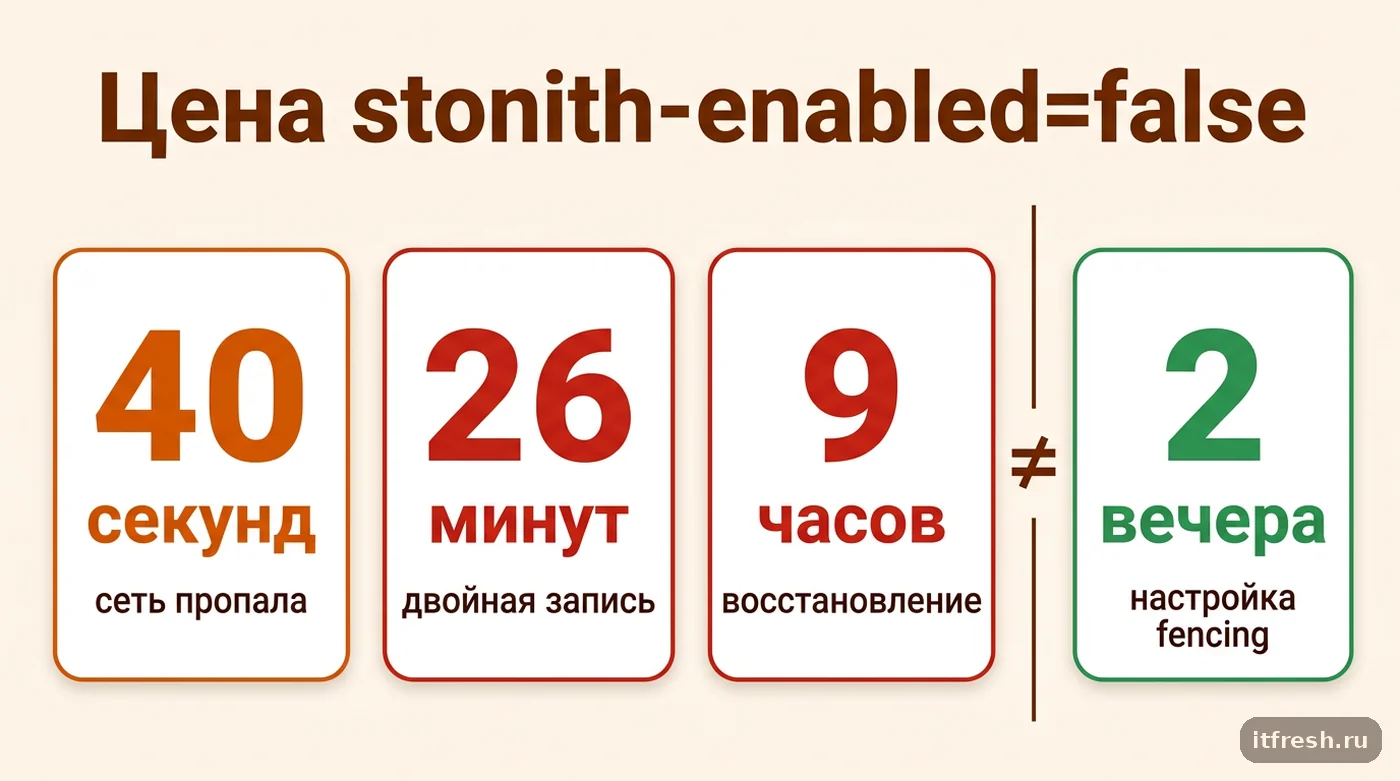
Сам инцидент: провайдер перепрошивал коммутатор, кластерная сеть пропала примерно на сорок секунд. Узел B перестал видеть узел A, посчитал его мёртвым (fencing выключен — подтверждать нечего), перевёл DRBD в Primary, смонтировал ФС, запустил PostgreSQL и VIP. Узел A при этом ничего не терял: работал со своей копией, своим PostgreSQL и своим адресом. Сорок секунд сетевой слепоты превратились в 26 минут параллельной записи в две расходящиеся базы — пока администраторы записи не начали жаловаться, что «клиент записан, а потом запись пропала», и мы не остановили обе стороны вручную.
Итог: DRBD в StandAlone, выбор стороны-победителя руками, сброс изменений второй стороны и ручной разбор записей и оплат, созданных за эти 26 минут. Полное восстановление заняло около девяти часов, из них шесть — сверка данных администраторами и бухгалтером, а не работа админа. Лечение инфраструктуры обошлось несопоставимо дешевле, два вечера работы: fence-агент через vCenter, второй уровень изоляции напрямую через ESXi, разведённые задержки и тест «выстрелом» с обеих сторон. Отдельно добавили проверку восстановления из резервной копии — про то, чем бэкапить Linux-серверы, я уже писал, здесь повторяться не буду.
- Причина инцидента — не сеть и не DRBD, а отсутствие подтверждённой изоляции узла
- Симптом у бизнеса — «записи пропадают», симптом в логах — split-brain DRBD
- 26 минут двойной записи; около 9 часов восстановления, из них 6 — ручная сверка
- Флаг stonith-enabled=false поставил подрядчик при сборке и никому не сказал
Как настроить fencing в Pacemaker: устройство, уровни, проверка
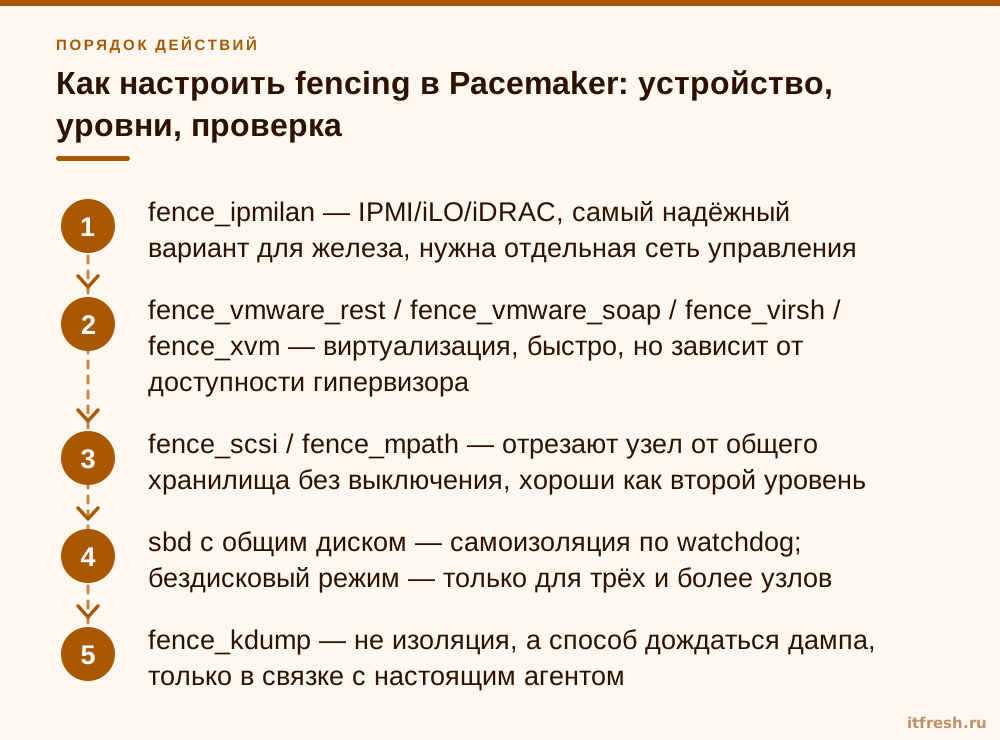
Устройства изоляции делятся на три группы, и выбирать надо не «что проще», а «что останется работать, когда узлу станет плохо». Первая — питание и BMC: fence_ipmilan для IPMI/iLO/iDRAC, управляемые PDU. Вторая — гипервизор: fence_vmware_rest для vCenter, fence_vmware_soap (умеет работать и с отдельным ESXi), fence_virsh и fence_xvm для KVM. Третья — хранилище и самоизоляция: fence_scsi и fence_mpath снимают SCSI-резервации, то есть отрезают узел от данных, не выключая его, а sbd заставляет узел перезагрузить сам себя по watchdog. Если кластер живёт на гипервизоре с собственным HA, помните, что у того свои правила размещения — как это мешает переезду ВМ, я разбирал на примере, где ВМ в Proxmox HA не запускается.
Для «Душевного баланса» мы взяли fence_vmware_rest через vCenter как первый уровень и fence_vmware_soap напрямую к каждому ESXi как второй. Логика простая: vCenter сам виртуальная машина и может оказаться недоступен ровно тогда, когда он нужен, а хосты ESXi отвечают независимо от него. Бездисковый sbd мы сознательно не ставили: и Red Hat, и SUSE допускают его только для кластеров из трёх и более узлов, потому что он опирается на потерю кворума. Уровни fencing topology пробуются по возрастанию индекса (допустимы значения от 1 до 9), следующий включается, если предыдущий не сработал.
# 1-й уровень: изоляция через vCenter
pcs stonith create fence-vc fence_vmware_rest \
  ip=vcenter.example.local ssl_insecure=0 \
  username=svc-fencing@vsphere.local password='********' \
  pcmk_host_map="node-a:DB-A;node-b:DB-B" \
  pcmk_delay_base="node-a:0s;node-b:5s" \
  op monitor interval=120s

# 2-й уровень: напрямую к ESXi, где живёт каждая ВМ
pcs stonith create fence-esx-a fence_vmware_soap \
  ip=esx-a.example.local ssl_insecure=1 username=fence password='********' \
  pcmk_host_map="node-a:DB-A"
pcs stonith create fence-esx-b fence_vmware_soap \
  ip=esx-b.example.local ssl_insecure=1 username=fence password='********' \
  pcmk_host_map="node-b:DB-B"

pcs stonith level add 1 node-a fence-vc
pcs stonith level add 2 node-a fence-esx-a
pcs stonith level add 1 node-b fence-vc
pcs stonith level add 2 node-b fence-esx-b

pcs property set stonith-enabled=true
Параметры конкретного агента в вашей сборке всегда сверяйте через pcs stonith describe fence_vmware_rest: набор опций у fence-agents меняется между версиями. Под учётку для fencing я завожу отдельного пользователя с правами только на питание нужных ВМ, а не администратора vCenter.
И обязательно — проверка. Не «конфиг применился», а «узел действительно перезагрузился». Я делаю это в окно обслуживания и по очереди с обоих узлов: pcs stonith fence node-b, смотрю на консоль ВМ, потом pcs stonith history show node-b. Если fencing ни разу не проверяли выстрелом, считайте, что его нет: в большинстве разборов, которые я видел, stonith-ресурс выглядел правильно, но с устаревшим паролем или неверным pcmk_host_map, и молча возвращал ошибку ровно в тот момент, когда был нужен.
- fence_ipmilan — IPMI/iLO/iDRAC, самый надёжный вариант для железа, нужна отдельная сеть управления
- fence_vmware_rest / fence_vmware_soap / fence_virsh / fence_xvm — виртуализация, быстро, но зависит от доступности гипервизора
- fence_scsi / fence_mpath — отрезают узел от общего хранилища без выключения, хороши как второй уровень
- sbd с общим диском — самоизоляция по watchdog; бездисковый режим — только для трёх и более узлов
- fence_kdump — не изоляция, а способ дождаться дампа, только в связке с настоящим агентом
Почему после включения STONITH перезагружаются оба узла
Включённый STONITH — ещё не работающий STONITH. Есть набор значений по умолчанию, которые в двухузловом кластере ведут себя не так, как ожидает человек. По документации Pacemaker Explained: тайм-аут операций fencing (fencing-timeout, он же stonith-timeout) — 60 секунд; действие (fencing-action / stonith-action) — reboot, допустимы reboot и off; число неудачных попыток, после которого кластер перестаёт немедленно повторять (fencing-max-attempts), — 10; реакция узла на известие о собственной изоляции (fencing-reaction) — stop; startup-fencing — true; priority-fencing-delay — 0. У самих устройств pcmk_delay_base и pcmk_delay_max по умолчанию 0s, pcmk_reboot_timeout — 60s.
Главная ловушка двух узлов — нулевые задержки. При разрыве связи оба узла одновременно решают изолировать друг друга, и иногда им это удаётся обоим: кластер целиком уходит в перезагрузку. Лечится разведением задержек: статическим перекосом через pcmk_delay_base (с версии 2.1.2 можно задать разные значения для разных узлов в одном устройстве, синтаксис node-a:0s;node-b:5s), случайной задержкой pcmk_delay_max или priority-fencing-delay, которая даёт фору узлу с наибольшим суммарным приоритетом ресурсов. На нагруженных стендах я предпочитаю последний вариант: выживает тот, на ком крутится прод, а не тот, кто первым успел.
Второй слой — кворум. В двухузловом кластере в corosync.conf почти всегда стоит two_node: 1, и по документации votequorum это автоматически включает wait_for_all. Следствие: после полной остановки кластер станет кворумным, только когда оба узла хотя бы раз увидят друг друга одновременно. Значительная часть обращений «после планового выключения кластер не поднимается» — это именно wait_for_all, а не поломка. no-quorum-policy по умолчанию stop; допустимы ignore, freeze, stop, demote, fence и suicide. Значение ignore в двухузловой конфигурации с общими данными без fencing — прямая дорога к инциденту из предыдущего раздела.
# /etc/corosync/corosync.conf
quorum {
    provider: corosync_votequorum
    two_node: 1
    # wait_for_all включается автоматически вместе с two_node
}

# что я проверяю на каждом кластере
# pcs property config --all | grep -Ei 'fenc|stonith|quorum'
# corosync-quorumtool -s
Про действие fencing. Дефолтный reboot удобен: узел вернулся, кластер сам решил, что с ним делать. Но если у вас общий сторадж и вы не уверены, что узел после перезагрузки не полезет обратно к данным раньше, чем кластер разберётся, ставьте off и поднимайте узел руками. Позиция спорная: часть коллег считает, что off превращает автоматический кластер в полуручной. Мой опыт такой: в двухузловых сценариях с общими данными лишний ручной шаг дешевле повторного расхождения.
- fencing-timeout (stonith-timeout) — 60s; увеличивайте, если BMC или vCenter отвечают медленно
- fencing-action (stonith-action) — reboot; off, если боитесь возвращения узла к общим данным
- pcmk_delay_base / pcmk_delay_max — 0s; в двух узлах нужен перекос, иначе взаимная изоляция
- priority-fencing-delay — 0; включайте, чтобы выживал узел с приоритетными ресурсами
- fencing-max-attempts — 10; startup-fencing — true; без причины не трогать
- no-quorum-policy — stop; two_node: 1 автоматически включает wait_for_all
stonith-enabled или fencing-enabled: что изменилось в Pacemaker 3.0
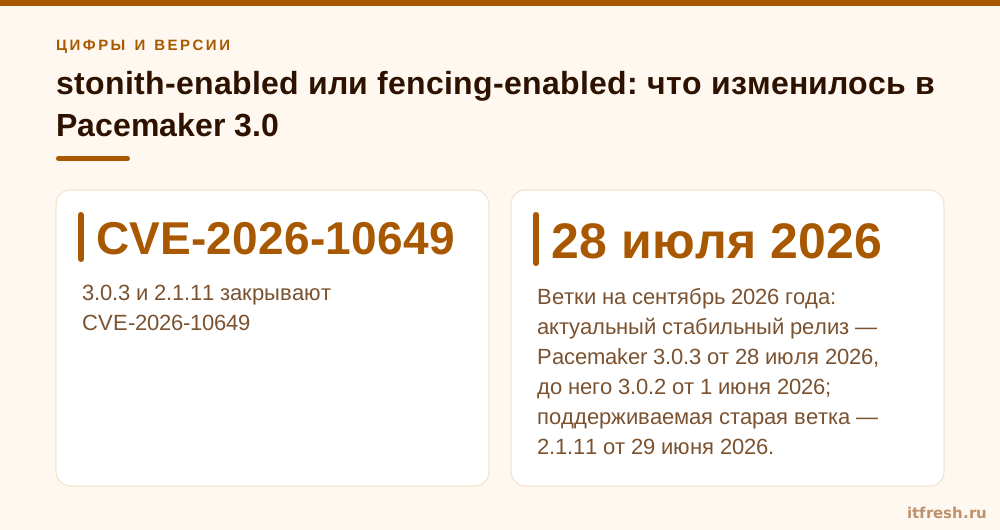
Ветки на сентябрь 2026 года: актуальный стабильный релиз — Pacemaker 3.0.3 от 28 июля 2026, до него 3.0.2 от 1 июня 2026; поддерживаемая старая ветка — 2.1.11 от 29 июня 2026. И 3.0.3, и 2.1.11 содержат важное исправление безопасности CVE-2026-10649, так что обновиться стоит в любом случае. Документация на сайте ClusterLabs генерируется из конкретной версии, поэтому при чтении мануала смотрите, для какой ветки страница, — дефолты и имена параметров между 2.1 и 3.0 различаются.
Главное практическое изменение для нашей темы: в ветке 3.0 канонические имена — fencing-enabled, fencing-action, fencing-timeout. Привычные stonith-enabled, stonith-action и stonith-timeout в метаданных pacemaker-schedulerd помечены как устаревшие и заменённые новыми именами. Паника не нужна: старые плейбуки не рассыплются. Новые конфиги я уже пишу на fencing-*, а в старых оставляю комментарий, чтобы через год никто не гадал, почему в одном кластере одно имя, а в другом другое.
# на узле с Pacemaker 3.0
pcs property config --all | grep -Ei 'fencing-|stonith-'
man 7 pacemaker-schedulerd   # имена и дефолты именно вашей сборки

pcs property set fencing-enabled=true
pcs property set priority-fencing-delay=15s
Про апгрейд на 3.0 отдельно: релиз 3.0.0 убрал целый пласт устаревшего. Ушли классы ресурсов nagios и upstart, узлы типа ping, rkt в bundle-ресурсах, опции crmd-*-timeout и значение poweroff у stonith-action. Если кластер собран по инструкции десятилетней давности, перед обновлением прогоните crm_verify -L -V на тестовой копии CIB с новым пакетом: узнать про несовместимость до переключения дешевле, чем во время.
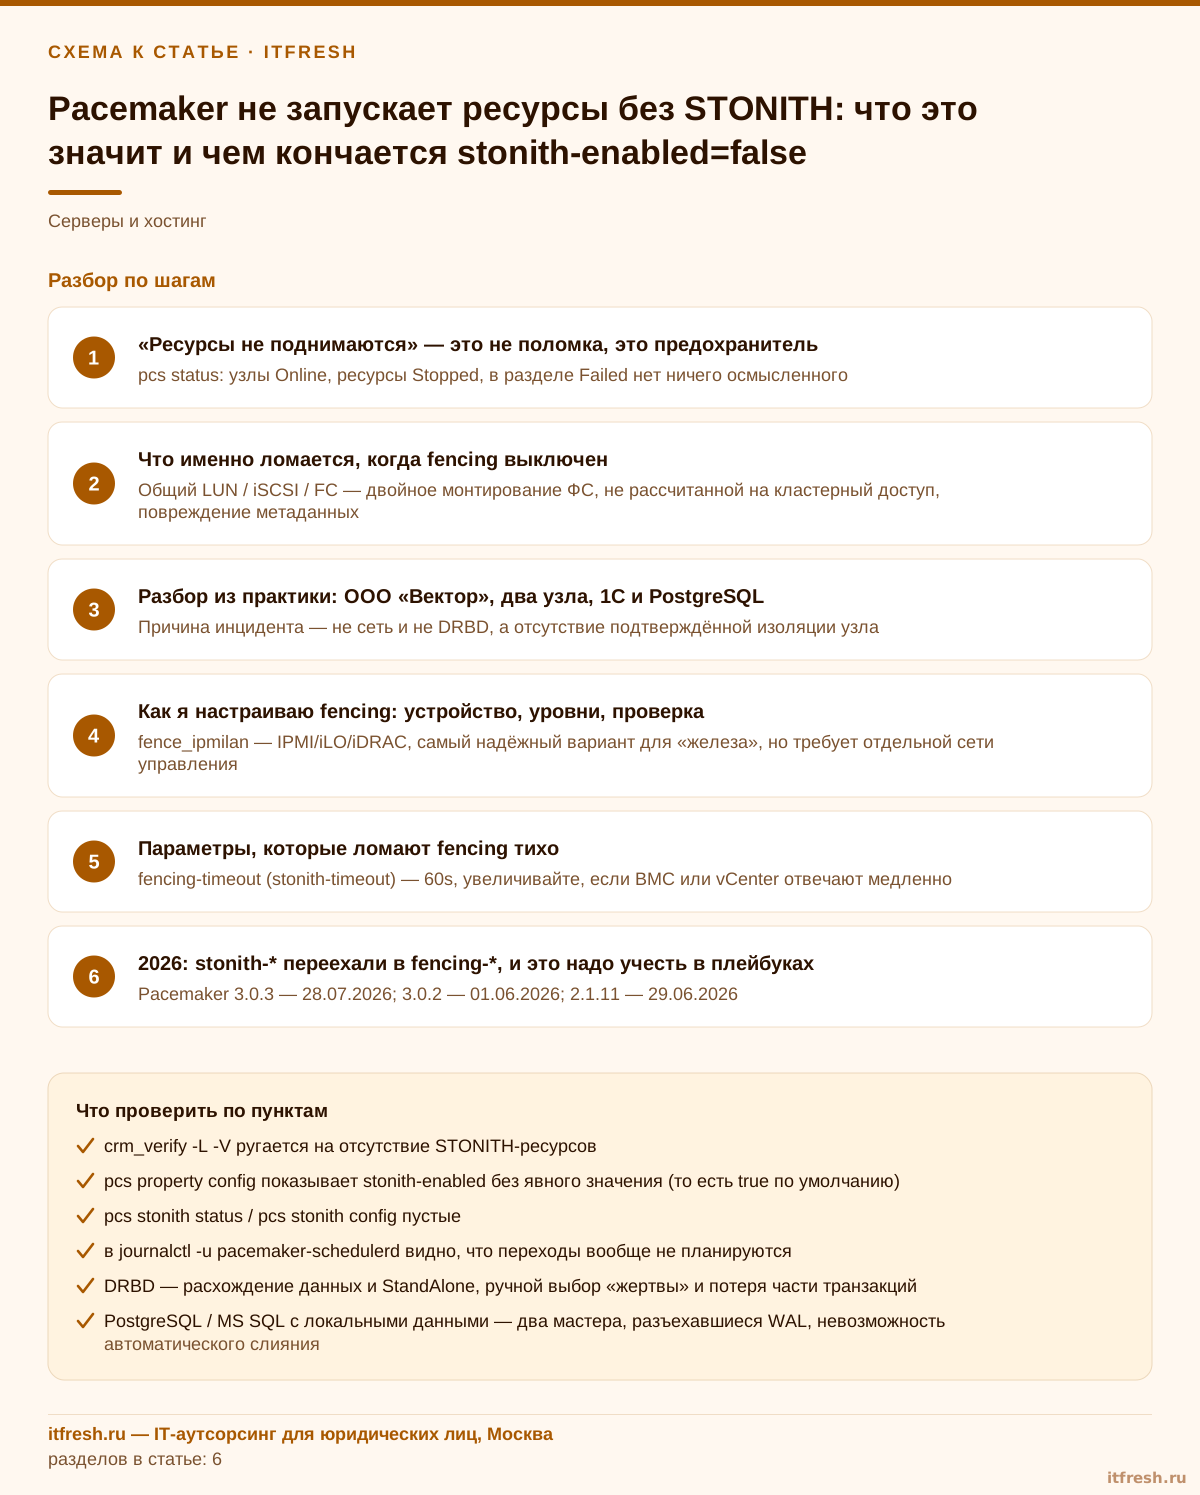
- Pacemaker 3.0.3 — 28.07.2026; 3.0.2 — 01.06.2026; 2.1.11 — 29.06.2026
- 3.0.3 и 2.1.11 закрывают CVE-2026-10649
- В 3.0 канон — fencing-enabled / fencing-action / fencing-timeout; stonith-* устарели, но работают
- 3.0.0 удалил nagios/upstart, ping-узлы, rkt в bundle и значение poweroff
- Источник истины про дефолты вашей сборки — man 7 pacemaker-schedulerd на узле
Когда без fencing можно жить и что делать в первую очередь
Буду честен: есть случаи, когда stonith-enabled=false нормально. Лабораторный стенд, который вы разберёте завтра. Демо для обучения. Кластер из stateless-сервисов без общего хранилища, где худший исход — лишний экземпляр приложения за балансировщиком. Там я сам ставлю false, чтобы не тратить время. Но обязательно пишу это в описании стенда, иначе через полгода «временный» окажется в проде — это происходит чаще, чем хочется признавать. И если вам нужна отказоустойчивость только для PostgreSQL, посмотрите, подходит ли автоматический failover через Patroni: там изоляция устроена иначе, через DCS и watchdog, и Pacemaker может оказаться лишним.
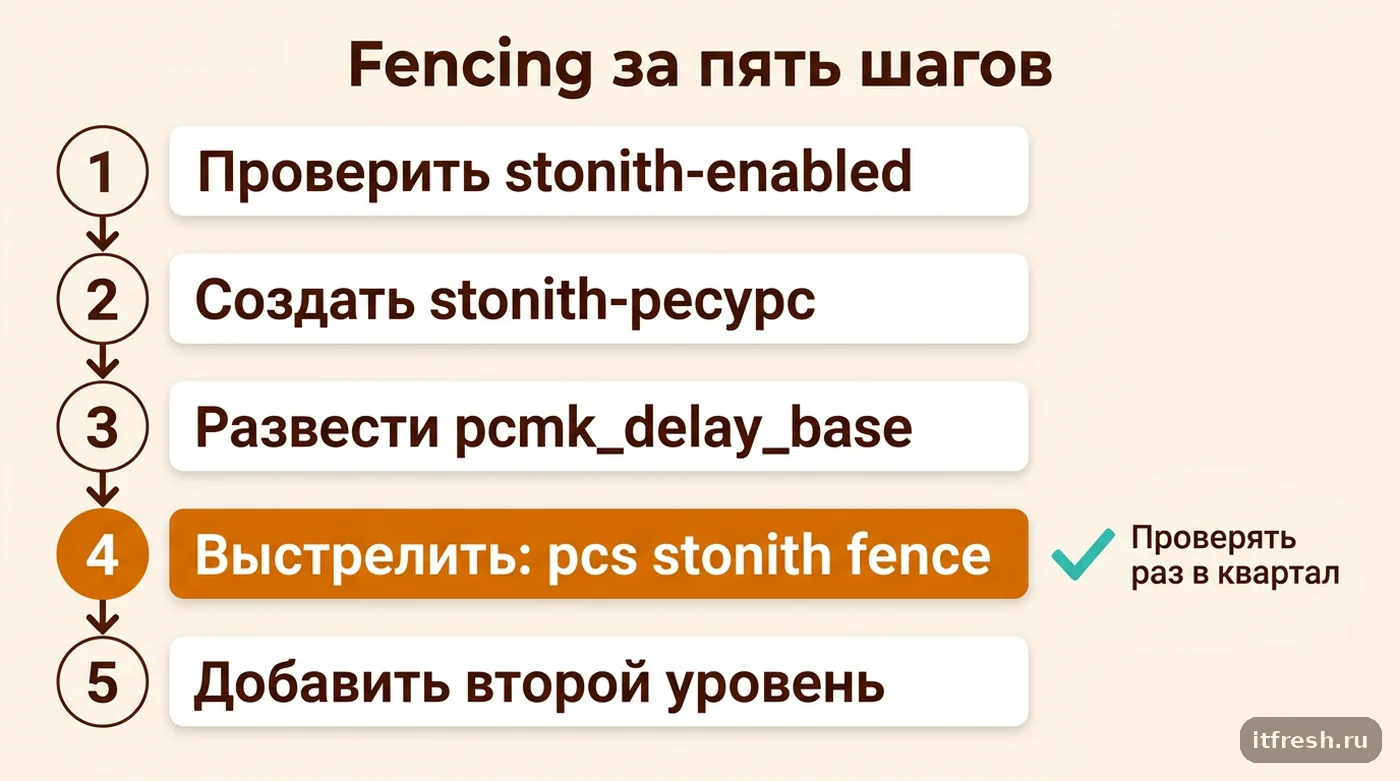
Всё остальное — общий LUN, DRBD, кластерные ФС, любая СУБД, сервер 1С с базой на реплицируемом томе — требует fencing без разговоров. Приоритеты простые. Первое: узнать, включён ли он вообще (две команды, пять минут). Второе: если выключен — не включать сразу, а сначала настроить устройство изоляции, иначе ресурсы остановятся. Третье: развести задержки. Четвёртое: выстрелить и убедиться. Пятое, и только пятое, — второй уровень, priority-fencing-delay и прочая тонкая настройка.
На что можно спокойно не тратить время, пока не сделано главное: подбор fencing-max-attempts, переезд на имена fencing-*, оптимизация интервалов monitor у stonith-ресурсов. Всё это имеет смысл, когда базовая изоляция уже работает и проверена. Пока она не работает, вы занимаетесь отделкой дома без фундамента. В «Душевном балансе» вся базовая часть заняла два вечера, а проверку fencing мы внесли в квартальный регламент рядом с тестовым восстановлением из бэкапа.
- `pcs property config` — узнать, чему равен stonith-enabled / fencing-enabled
- `pcs stonith config` — убедиться, что устройство изоляции заведено
- Выбрать агента под платформу (BMC / гипервизор / SCSI / sbd с диском) и создать stonith-ресурс
- Развести pcmk_delay_base между узлами или включить priority-fencing-delay
- Проверить выстрелом: `pcs stonith fence <узел>` в окно обслуживания, с обеих сторон
- Добавить второй уровень через `pcs stonith level add`
- Записать проверку fencing в регламент — раз в квартал, вместе с проверкой бэкапов
Частые вопросы
Можно ли оставить stonith-enabled=false, если нет IPMI и управляемой розетки?
Только если под кластером нет общих данных. Без управления питанием есть другие агенты: fence_vmware_rest/fence_vmware_soap и fence_virsh для виртуальных машин, fence_scsi и fence_mpath для общего хранилища, sbd с общим диском. Отсутствие IPMI — аргумент за другой агент, а не за выключенный fencing.
Я включил STONITH, и при обрыве линка перезагружаются оба узла. Что не так?
pcmk_delay_base и pcmk_delay_max по умолчанию равны 0s, и оба узла начинают изоляцию одновременно. Задайте разные задержки (`pcmk_delay_base="node-a:0s;node-b:5s"`, с Pacemaker 2.1.2) или включите priority-fencing-delay. Выключать fencing не нужно.
Чем отличаются stonith-enabled и fencing-enabled?
Это одно и то же свойство. В Pacemaker 3.0 каноническим стало fencing-enabled, а stonith-enabled помечен как устаревший, но работает. То же с парами stonith-action/fencing-action и stonith-timeout/fencing-timeout.
Подойдёт ли бездисковый sbd для двухузлового кластера?
Нет. Бездисковый (watchdog-only) sbd опирается на потерю кворума, и Red Hat и SUSE поддерживают его только для кластеров из трёх и более узлов. Для двух узлов нужен sbd с общим диском или другой агент изоляции.
После выключения обоих узлов кластер не поднимается. Это fencing?
Скорее всего, нет. two_node: 1 в corosync.conf автоматически включает wait_for_all: кластер станет кворумным только после того, как оба узла одновременно увидят друг друга. Поднимите второй узел — и ресурсы стартуют.
Как проверить, что fencing реально работает?
Только выстрелом. В окно обслуживания выполните `pcs stonith fence <узел>`, убедитесь, что узел действительно перезагрузился, и посмотрите `pcs stonith history show`. Проверять с обеих сторон и повторять раз в квартал: пароли и имена ВМ меняются молча.
Источники
- ClusterLabs — Pacemaker Explained 3.0, Cluster Options — Дефолты fencing-enabled (true), fencing-action (reboot/off), fencing-timeout (60s), fencing-max-attempts (10), fencing-reaction (stop/panic), priority-fencing-delay (0), startup-fencing (true), допустимые значения no-quorum-policy. https://clusterlabs.org/projects/pacemaker/doc/3.0/Pacemaker_Explained/html/cluster-options.html
- ClusterLabs — Pacemaker Explained 3.0, Fencing — pcmk_delay_base с синтаксисом node1:0s;node2:5s (с 2.1.2), дефолты pcmk_delay_max и pcmk_reboot_timeout, уровни fencing topology 1–9. https://clusterlabs.org/projects/pacemaker/doc/3.0/Pacemaker_Explained/html/fencing.html
- ClusterLabs — Clusters from Scratch 2.1, Configure Fencing — Предупреждение о недопустимости stonith-enabled=false в продуктиве, команды pcs stonith list / describe / create / fence. https://clusterlabs.org/projects/pacemaker/doc/2.1/Clusters_from_Scratch/html/fencing.html
- ClusterLabs/pacemaker — Releases на GitHub — Даты 3.0.3 (28.07.2026), 2.1.11 (29.06.2026), 3.0.2 (01.06.2026), исправление CVE-2026-10649; список удалённого в 3.0.0. https://github.com/ClusterLabs/pacemaker/releases
- votequorum(5) — two_node: 1 автоматически включает wait_for_all, его можно явно переопределить. https://www.mankier.com/5/votequorum
- SUSE Linux Enterprise HA 15 SP6 — Storage protection and SBD — Режимы sbd, требования к watchdog, ограничение бездискового sbd кластерами из трёх и более узлов. https://documentation.suse.com/sle-ha/15-SP6/html/SLE-HA-all/cha-ha-storage-protect.html