
Двухузловой Proxmox VE 9.2: QDevice пингуется, а кворума нет — разбираем флаги A/NA и V/NV
Классическая ловушка двухузлового кластера: QDevice развёрнут, порт открыт, арбитр отвечает на ping, в выводе pvecm status гордо стоит буква A — и всё равно, стоит выключить один узел на профилактику, второй уходит в «Quorate: No», веб-интерфейс перестаёт стартовать виртуалки, а вы стоите с ключом от серверной и без кластера. Ниже — что на самом деле означают флаги A/NA и V/NV, почему доступность арбитра и выдача им голоса это две разные вещи, как за пятнадцать минут отличить одно от другого и что я делаю у себя, чтобы такая ночь не повторялась.
Арбитр отвечает на ping — и это вообще ни о чём не говорит
Каждый раз одна и та же картина. Админ поднял двухузловой Proxmox, прочитал в мануале, что для чётного числа узлов нужен внешний арбитр, поставил corosync-qnetd на какую-нибудь маленькую виртуалку или на старый мини-ПК, выполнил pvecm qdevice setup, увидел, что «Expected votes» стал 3 вместо 2, и закрыл вопрос. Проверка работоспособности сводится к ping до арбитра и к тому, что в статусе есть строчка Qdevice. Через месяц приходит время обновлять один из узлов — и выясняется, что оставшийся узел не имеет кворума.
Причина в том, что ping проверяет ровно одно: что IP-адрес жив и ICMP до него доходит. Он не проверяет, слушает ли corosync-qnetd свой TCP-порт 5403. Не проверяет, договорились ли узел и арбитр по TLS. Не проверяет, валидны ли сертификаты в NSS-базах, которые pvecm разложил при настройке. И уж точно он не проверяет, что qnetd согласился отдать голос именно этой части кластера. Между «арбитр доступен» и «арбитр голосует за меня» лежит целый слой логики, и именно там всё и ломается.
Хуже того: сам corosync в своём выводе честно разделяет эти два состояния — просто мало кто читает флаги внимательно. Флаг A (Alive) и флаг V (Vote) выводятся отдельно, через запятую, и они независимы друг от друга. Состояние A,NV — то есть «арбитр жив, но голос не выдан» — совершенно штатно отображается и означает, что вы находитесь ровно в одном шаге от потери кворума при первом же обслуживании. Я видел кластеры, которые ездили в таком виде по полгода и узнавали об этом в самый неподходящий момент.
- ping до арбитра — проверяет ICMP и не проверяет ничего из механики кворума
- наличие строки Qdevice в статусе — говорит лишь о том, что device прописан в corosync.conf
- Expected votes: 3 — голос учтён в расчёте, но это не значит, что он реально отдан
- флаг A — связь с qnetd есть; флаг V — голос выдан. Смотреть надо на второй
Арифметика кворума и что на самом деле значат A, V и MW
Corosync считает кворум по простому большинству: нужно строго больше половины ожидаемых голосов. Два узла дают expected votes = 2, кворум = 2. Выключаем один — остаётся один голос из двух, это ровно половина, а не большинство. Кластер честно объявляет себя неквалифицированным: pmxcfs переводит /etc/pve в режим только для чтения, HA-стек уходит в защиту, новые виртуалки не стартуют. Это не баг, а защита от split-brain: система физически не может отличить «сосед выключен» от «сосед жив, но я его не вижу», а два независимых узла, одновременно запустившие одну и ту же ВМ с общего хранилища, — это гарантированно убитая файловая система гостя.
QDevice добавляет в расчёт голос внешней, не входящей в кластер стороны. Для двухузлового кластера он даёт один дополнительный голос: expected votes становится 3, кворум остаётся 2, и выживший узел набирает 1 (свой) + 1 (арбитр) = 2 из 3. В документации Proxmox VE это раздел Corosync External Vote Support, там прямым текстом: QDevice поддерживается для кластеров с чётным числом узлов и рекомендуется для двухузловых, а чётный кластер получает ровно один дополнительный голос. Сборка предельно простая:
# на внешней машине-арбитре
apt install corosync-qnetd

# на каждом узле кластера
apt install corosync-qdevice

# один раз, с любого одного узла (нужен root по SSH на арбитр)
pvecm qdevice setup 10.10.10.50
Root по SSH нужен только на время настройки — pvecm сам разложит на арбитре NSS-базу и сертификаты, после чего доступ можно закрывать обратно: рабочий обмен идёт по 5403, а не по 22.
Теперь про флаги, которые сбивают с толку. Они приезжают в pvecm status прямо из corosync-quorumtool, и в исходниках corosync строка собирается из трёх независимых пар: VOTEQUORUM_INFO_QDEVICE_ALIVE даёт A или NA, VOTEQUORUM_INFO_QDEVICE_CAST_VOTE — V или NV, VOTEQUORUM_INFO_QDEVICE_MASTER_WINS — MW или NMW. Ни один из этих флагов не выводится из другого. A/NA — Alive / Not Alive: в документации Proxmox это признак того, что связь с внешним corosync-qnetd работает. Технически бит выставляет локальный демон corosync-qdevice через heartbeat к votequorum (Red Hat так его и описывает), поэтому NA бывает не только при закрытом порте, но и при упавшей службе corosync-qdevice на самом узле. V/NV — состояние решения: qnetd рассмотрел ситуацию и выдал (или не выдал) голос именно этому разделу кластера. MW/NMW — режим master_wins, в типовой установке Proxmox он выключен, и NMW тут нормальное значение, пугаться его не надо. Есть и четвёртый вариант, о котором мало кто знает: если бит VOTEQUORUM_INFO_QDEVICE_REGISTERED не выставлен, вместо трёх флагов corosync-quorumtool печатает одно NR — QDevice на этом узле вообще не зарегистрирован в votequorum. Обычно это значит, что пакет corosync-qdevice не установлен на узле, служба не запущена или конфиг не доехал.
Здоровое состояние двухузлового кластера в выводе выглядит примерно так — обратите внимание, что строка QDevice идёт отдельно от узлов и имеет node id 0 (в реальном выводе PVE идентификаторы печатаются в hex, 0x00000001, 0x00000000):
Votequorum information
----------------------
Expected votes:   3
Highest expected: 3
Total votes:      3
Quorum:           2
Flags:            Quorate Qdevice

Membership information
----------------------
    Nodeid      Votes    Qdevice Name
         1          1   A,V,NMW pve-01 (local)
         2          1   A,V,NMW pve-02
         0          1            Qdevice
Если в этой строке стоит A,NV — кластер уже сломан, просто пока об этом не знает: оба узла на месте, большинство набирается и без арбитра. Проверка «выключим один узел» в этот момент даст «Quorate: No» и заблокированный /etc/pve на выжившем.
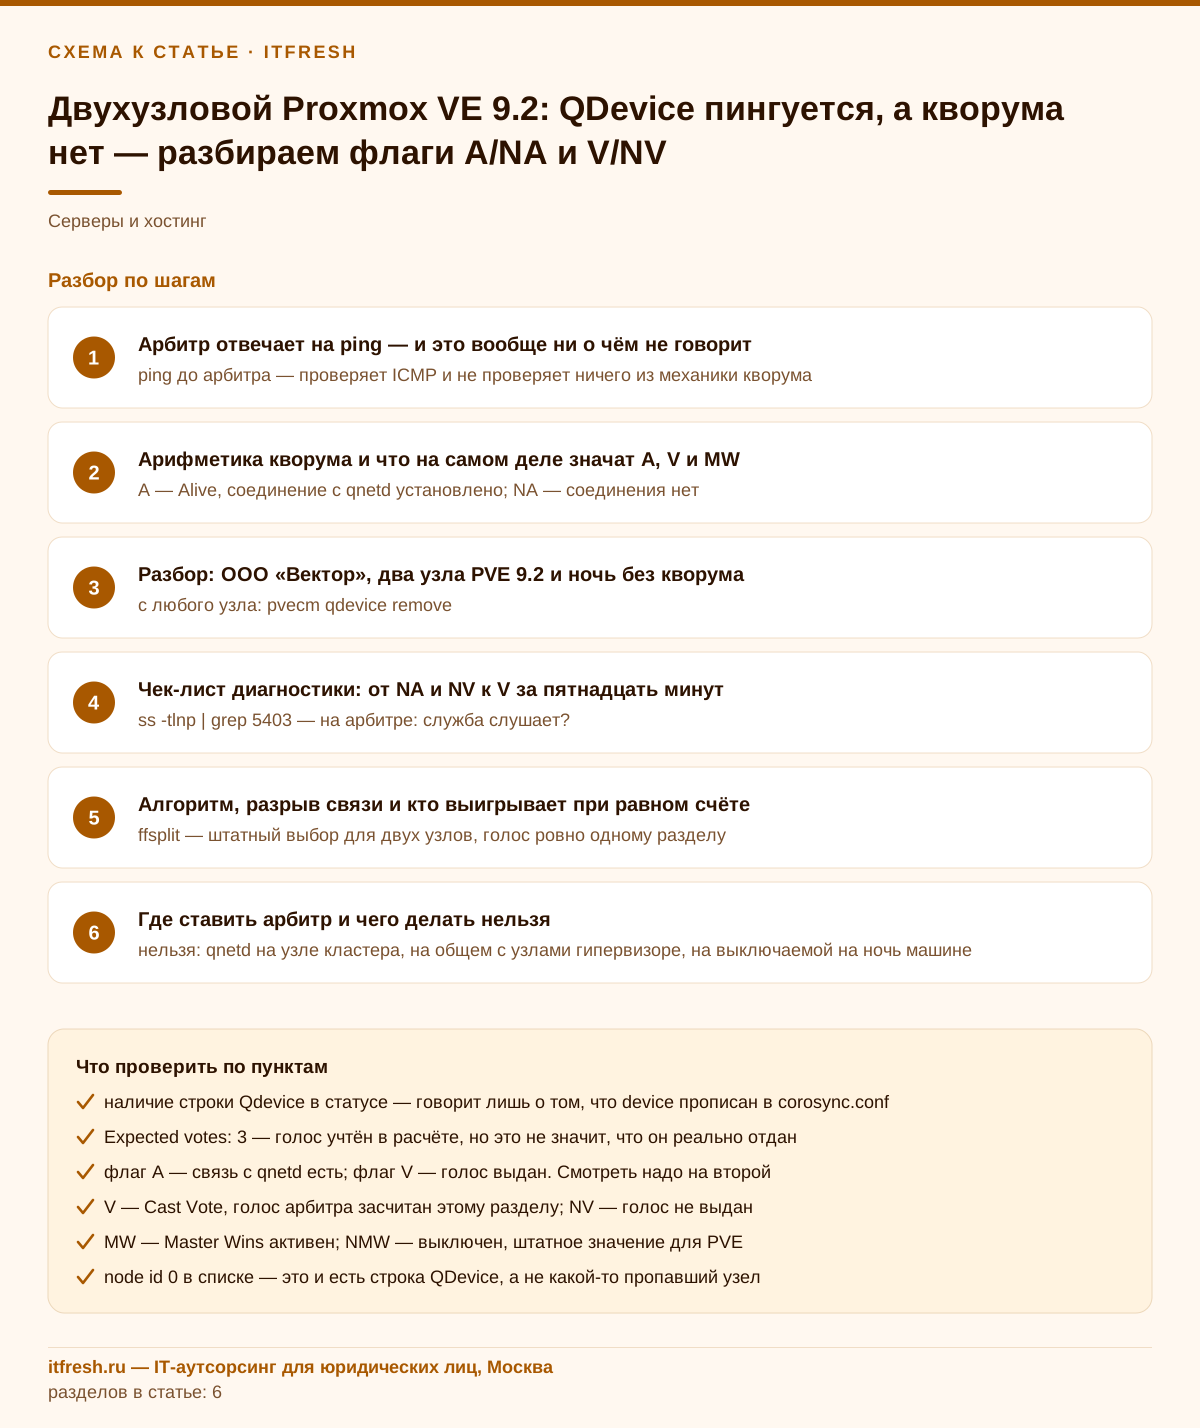
- A — Alive, соединение с qnetd установлено; NA — соединения нет
- V — Cast Vote, голос арбитра засчитан этому разделу; NV — голос не выдан
- MW — Master Wins активен; NMW — выключен, штатное значение для PVE
- NR — Not Registered: corosync-qdevice на узле не зарегистрирован (пакет не стоит, служба не запущена)
- node id 0 в списке — это и есть строка QDevice, а не какой-то пропавший узел
- pvecm qdevice remove — снять арбитр (обязательно перед добавлением или удалением узла)
Разбор: «Чистый квартал», два узла PVE 9.2 и ночь без кворума
Стенд у клиента — клининговая компания «Чистый квартал», 28 рабочих мест в офисе плюс выездные бригады, которым диспетчеры раздают заявки. Два узла Proxmox VE 9.2 (релиз от 21 мая 2026, ядро 7.0, QEMU 11.0), общее хранилище по iSCSI, на нём терминальный сервер, 1С с зарплатой и учётом расходников и CRM с графиком выездов — то есть ровно те машины, без которых диспетчерская утром не может отправить бригады на объекты. Арбитром служила отдельная маленькая виртуалка на Debian, физически стоявшая вне кластера, на офисном NAS с гипервизором. Настройку делали не мы: кластер достался нам на сопровождение вместе со всем остальным хозяйством.
Заявка звучала как «обновляем узел — всё падает». Действительно: гасим node2 на обновление, node1 через несколько секунд теряет кворум, /etc/pve уходит в read-only, поднять что-либо руками невозможно. При этом pvecm status показывал Expected votes: 3, Quorum: 2, строку Qdevice, арбитр пинговался с обоих узлов, подключение на 5403 проходило. Формально всё было настроено. Смотрим на флаги — а там A,NV, а при повторном запуске через полминуты на секунду мелькнуло NA,NV. То есть TCP до арбитра доходит, соединение то поднимается, то рвётся, а голоса нет, и нет его уже давно.
Дальше журналы арбитра. На qnetd-виртуалке ровным потоком шло «Unhandled error when reading from client. Disconnecting client (-12271): SSL peer cannot verify your certificate» — qnetd принимает TCP, на TLS-рукопожатии отвергает клиента и разрывает соединение. Это ровно тот сценарий, который разбирали в профильной ветке форума Proxmox по двухузловому кластеру с qdevice: соединение устанавливается, стороны не сходятся на сертификатах, qnetd видит клиента, но голос не отдаёт (в той ветке pvecm status показывал у Qdevice ноль фактических голосов и Activity blocked). Причина в конкретном случае была прозаичная — арбитра когда-то переставляли, NSS-базу /etc/corosync/qnetd/nssdb перенесли со старой машины, а на узлах в /etc/corosync/qdevice/net/nssdb остались ключи от другой инсталляции.
Что важно и что стоило нам лишних минут: простой цикл pvecm qdevice remove → pvecm qdevice setup проблему не вылечил, потому что старые NSS-базы остались на диске и переиспользовались. Помогло только полное вычищение и установка с нуля — к тому же выводу пришли и в форумной ветке. После переустановки флаг сменился на A,V,NMW, контрольное выключение node2 прошло штатно: node1 остался Quorate: Yes, виртуалки стартовали. Суммарно ушло около сорока минут, из них тридцать пять — на то, чтобы догадаться посмотреть в лог qnetd, а не в pvecm.
- с любого узла: pvecm qdevice remove
- на арбитре: systemctl stop corosync-qnetd, затем apt purge corosync-qnetd, затем rm -rf /etc/corosync/qnetd
- на обоих узлах: apt purge corosync-qdevice и rm -rf /etc/corosync/qdevice
- обратно: apt install corosync-qnetd на арбитре, apt install corosync-qdevice на узлах
- с одного узла: pvecm qdevice setup 10.10.10.50
- контроль: pvecm status — должно стать A,V,NMW, и обязательно контрольный shutdown узла
Чек-лист диагностики: от NA и NV к V за пятнадцать минут
Порядок действий у меня жёсткий и всегда один. Сначала определяем, в какой из двух категорий проблема — транспорт (NA) или голосование (NV), — и только потом лезем глубже. Это экономит уйму времени: в первом случае вы ищете сеть и службу, во втором сертификаты и алгоритм, и это совершенно разные ветки расследования. Смешивать их — верный способ потратить вечер.
Если NA — работаем по сети и службам; документация Proxmox прямо говорит: при NA проверьте, что TCP-порт 5403 на внешнем сервере достижим. Но сначала за секунду убедитесь, что на самом узле жива служба corosync-qdevice, — при NR это вообще единственная причина. На арбитре смотрим, что служба поднята и слушает 5403; с каждого узла отдельно проверяем, что порт достижим. Не забывайте, что фаервол в Proxmox VE может быть включён на уровне датацентра, а у арбитра часто своя политика или он вообще стоит за отдельным маршрутизатором. В PVE 9 бэкенд фаервола может быть как iptables-, так и nftables-based — посмотрите настройки датацентра, а не гадайте по памяти.
Если A, но NV — сеть в порядке, копаем логику. Ключевой инструмент — corosync-qnetd-tool на арбитре. Ключ -l выводит список подключённых клиентов, -v добавляет подробности: имя кластера, алгоритм (для PVE это Fifty-Fifty split, то есть ffsplit), node id клиентов, ring id, состояние TLS и — самое ценное — какой последний голос был отправлен клиенту, ACK или NACK. NACK при живом соединении и есть ваш NV, а рядом в журнале почти всегда лежит причина:
# на арбитре
ss -tlnp | grep 5403
systemctl status corosync-qnetd
corosync-qnetd-tool -l -v
journalctl -u corosync-qnetd -n 200 --no-pager

# на каждом узле
nc -zv 10.10.10.50 5403
corosync-qdevice-tool -s
journalctl -u corosync-qdevice -n 200 --no-pager
pvecm status
Отдельно проверьте, что имя кластера и node id не менялись после настройки арбитра. Клиентский сертификат qdevice выпускается на имя кластера, а qnetd группирует клиентов по этому имени; если узел переустанавливали и вводили обратно с другим id или подсовывали NSS-базу от другого кластера, арбитр видит клиента как чужого и голос не отдаёт. Это второй по частоте после сертификатов источник состояния A,NV — и самый обидный, потому что видимых ошибок в сети при этом нет вообще.
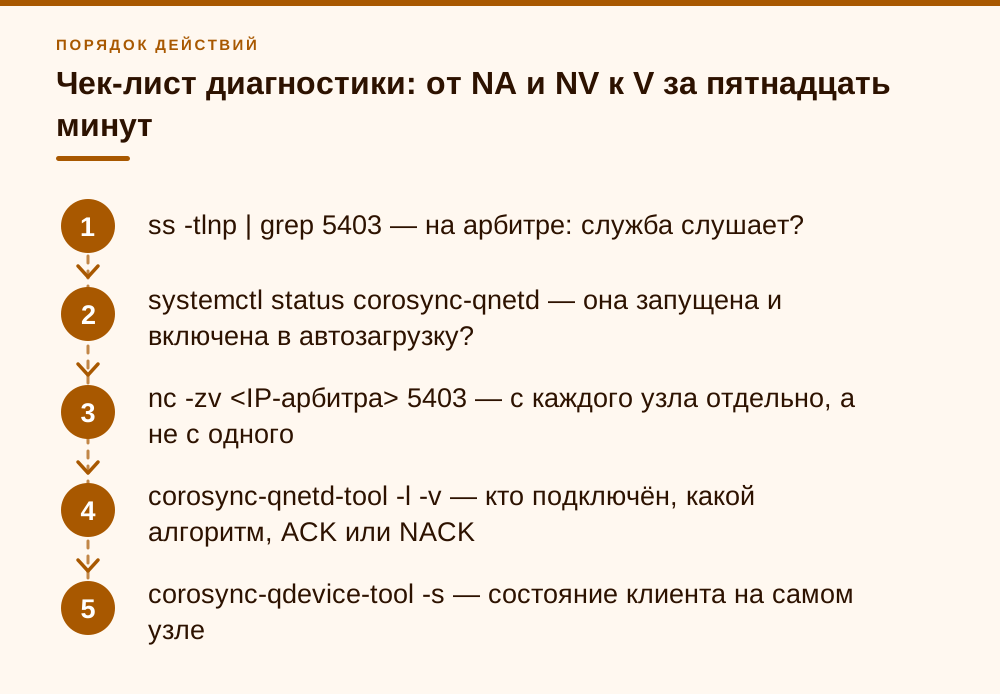
- ss -tlnp | grep 5403 — на арбитре: служба слушает?
- systemctl status corosync-qnetd — она запущена и включена в автозагрузку?
- nc -zv <IP-арбитра> 5403 — с каждого узла отдельно, а не с одного
- corosync-qnetd-tool -l -v — кто подключён, какой алгоритм, ACK или NACK
- corosync-qdevice-tool -s — состояние клиента на самом узле
- pvecm status — контрольный просмотр флагов после каждого шага
Алгоритм, разрыв связи и кто выигрывает при равном счёте
Для кластера с чётным числом узлов pvecm настраивает алгоритм ffsplit — fifty-fifty split. Работает он так: голос отдаётся ровно одному разделу кластера — тому, где больше активных узлов и лучше результат эвристик. Если разделы равны (а для двух узлов, разошедшихся по сети, они равны всегда — по одному узлу в каждом), решает tie_breaker. Значение по умолчанию — lowest, то есть голос уходит разделу с наименьшим node id; так это описано и в FAQ Proxmox. Поменять можно опцией tie_breaker (lowest, highest или конкретный node id), после чего нужно перезапустить corosync-qdevice.service на всех узлах. Именно поэтому при обрыве линка между узлами кластер не разваливается на два кворумных куска: арбитр детерминированно выбирает одну сторону.
Конфиг, который пишет pvecm, живёт в разделе quorum файла corosync.conf. Ключ tie_breaker явно не пишется — работает значение по умолчанию:
quorum {
  provider: corosync_votequorum
  device {
    model: net
    votes: 1
    net {
      algorithm: ffsplit
      host: 10.10.10.50
      tls: on
    }
  }
}
Второй алгоритм, lms (last man standing), в двухузловом сценарии не нужен: его pvecm выбирает для кластеров с нечётным числом узлов, и там QDevice даёт уже не один голос, а N−1. Кластер может пережить падение всех узлов, кроме одного, но если в этот момент упадёт сам qnetd, недопустим отказ ни одного узла — арбитр становится почти единой точкой отказа. Поэтому Proxmox использование QDevice в нечётных кластерах официально не рекомендует, и pvecm qdevice setup на таком кластере без --force не пройдёт. Не путайте алгоритм lms у qdevice с одноимённой опцией votequorum. В man votequorum прямо сказано: если в corosync.conf указаны last_man_standing или auto_tie_breaker, quorum device будет отключён. Если вы когда-то руками включали ATB или LMS «чтобы работало», а потом сверху накатили QDevice — арбитр молча не работает. two_node и wait_for_all man формально несовместимыми не называет, но у себя я перед настройкой арбитра убираю все ручные кворум-хаки: pvecm их не пишет, и сочетание с QDevice только усложняет разбор.
И про порядок правки. corosync.conf руками трогать можно, но каждое изменение обязано сопровождаться увеличением config_version, иначе узлы не примут новую конфигурацию. Правится файл на одном узле в /etc/pve/corosync.conf — он реплицируется через pmxcfs, — а не в /etc/corosync/corosync.conf: последний перезаписывается автоматически, и ваша правка там просто исчезнет. Перед правкой сделайте копию: восстанавливать кластер по кускам из бэкапа виртуалок гораздо дороже.
- ffsplit — штатный выбор для двух узлов, голос ровно одному разделу
- tie_breaker по умолчанию lowest — при равных разделах выигрывает наименьший node id
- смена tie_breaker — перезапуск corosync-qdevice.service на всех узлах
- last_man_standing и auto_tie_breaker в votequorum отключают QDevice; алгоритм lms самого qdevice — для нечётных кластеров, не для двух узлов
- правим только /etc/pve/corosync.conf и всегда поднимаем config_version
Где ставить арбитр и чего делать нельзя
Главное правило: арбитр должен отказывать независимо от узлов кластера. Звучит банально, но именно здесь я вижу больше всего халтуры. QDevice-виртуалка на одном из двух узлов кластера — не арбитр, а декорация: падает узел, вместе с ним падает арбитр, и выживший остаётся с одним голосом из трёх. QDevice на NAS, который питается от того же ИБП и стоит в той же стойке, — на полшага лучше. QDevice на офисной рабочей станции, которую вечером выключают, — источник ночных алертов и утренних разбирательств.
Что реально годится: отдельная маленькая ВМ на третьем, независимом гипервизоре; физический мини-ПК или тонкий клиент в другой стойке с отдельным питанием; для распределённых кластеров — виртуалка в ЦОД. Требования к железу смешные: qnetd потребляет считанные мегабайты памяти и почти не грузит процессор, ему хватит одного ядра и 512 МБ. С каналом проще, чем с самим corosync: QDevice подключается по TCP/IP, документация Proxmox прямо разрешает держать арбитр вне LAN кластера и не требует от него низких задержек corosync-кольца. Но потери пакетов и регулярные обрывы канала всё равно дают периодические NA и, соответственно, окна без арбитра — нестабильный домашний интернет на площадке с арбитром не лучший выбор.
Отдельно про то, чего делать нельзя категорически. Нельзя добавлять или удалять узлы кластера, пока настроен QDevice: документация Proxmox прямо требует сначала выполнить pvecm qdevice remove, провести операцию с узлами и настроить арбитр заново. Пренебрежение этим правилом ломает конфигурацию так, что чинить приходится руками в corosync.conf на каждом узле, причём в состоянии, когда кластер уже частично неработоспособен. И нельзя ставить qnetd на узел того же кластера — это не поддерживается и не имеет смысла.
Мой практический приоритет, если ресурсов на всё сразу нет. Сначала вынести арбитр за пределы отказовой зоны узлов. Потом настроить мониторинг флага V. И только потом заниматься красотой вроде отдельного VLAN под corosync. Арбитр, который лежит вместе с узлом, не спасёт вас никогда; арбитр в общем с продакшеном VLAN спасёт в девяти случаях из десяти. Порядок именно такой, а не наоборот.
- нельзя: qnetd на узле кластера, на общем с узлами гипервизоре, на выключаемой на ночь машине
- можно: третий независимый гипервизор, мини-ПК в другой стойке, ВМ в ЦОД
- обязательно: pvecm qdevice remove перед любым добавлением или удалением узла
- после установки: root по SSH на арбитре можно и нужно закрыть обратно
Регламент: как сделать, чтобы это не сломалось снова
После починки я всегда закрываю вопрос двумя вещами: мониторингом флага и учениями. Мониторинг — простейший скрипт, который раз в пять минут дёргает pvecm status, ищет qdevice-строку и алертит, если в ней нет ровно «A,V». Не наличие строки, не Expected votes, а буква V. Это тридцать строк на bash, кладётся в cron или systemd-timer, шлёт в Telegram или в вашу систему мониторинга — у нас это Zabbix с item по агенту. Именно такой проверки не было у «Чистого квартала», и именно поэтому кластер полгода ездил в состоянии A,NV.
Учения — контролируемая проверка отказа. Раз в квартал, в окно обслуживания, гасим один узел полностью (не suspend и не миграцию, а именно shutdown) и убеждаемся, что на выжившем pvecm status показывает Quorate: Yes, /etc/pve доступен на запись и виртуалки стартуют. Потом возвращаем узел, дожидаемся схождения кластера и повторяем со вторым. Это тридцать минут работы в квартал, которые заменяют собой все теоретические рассуждения о том, правильно у вас всё настроено или нет.
Отдельным пунктом — фиксация конфигурации в базе знаний: IP арбитра, где он физически стоит, чей это гипервизор, кто его администрирует, какой node id у какого узла и на какой площадке. Когда через год кто-то будет переезжать со старого NAS на новый, эта запись — единственное, что не даст ему молча унести с собой арбитр вместе с NSS-базой. Из практики: половина сломанных QDevice ломается не сама, а руками смежников, которые не знали, что незаметная виртуалка на 512 МБ памяти держит кворум продакшена.
И честно про спорное. Есть распространённое мнение, что двухузловой кластер с арбитром — вообще неправильная архитектура и надо ставить три полноценных узла. По деньгам для компании вроде «Чистого квартала» на 28 рабочих мест третий узел с лицензиями, дисками и местом в стойке часто неоправдан, а мини-ПК за пару десятков тысяч под qnetd закрывает ровно ту же задачу голосования. Так что схема рабочая — при одном условии: вы понимаете разницу между A и V и проверяете отказ, а не пинг.
- мониторинг: алерт на отсутствие «A,V» в qdevice-строке pvecm status, интервал 5 минут
- учения: раз в квартал полный shutdown каждого узла по очереди с проверкой Quorate
- документация: IP и владелец арбитра, node id узлов, привязка к площадкам
- после любых работ с узлами или арбитром — контрольная проверка флага V
Частые вопросы
В pvecm status стоит A,NV. Кластер сейчас работает — это срочно?
Работает он потому, что оба узла на месте и большинство набирается без арбитра. Как только вы выключите один узел, второй потеряет кворум и /etc/pve уйдёт в read-only. Это не аварийная, но приоритетная задача: чинить надо до ближайшего окна обслуживания, а не после того, как вы уже нажали shutdown.
Почему pvecm qdevice remove и повторный setup не помогают?
Потому что удаляется запись в corosync.conf, но остаются NSS-базы с сертификатами: /etc/corosync/qnetd на арбитре и /etc/corosync/qdevice на узлах. Если проблема в сертификатах, при повторной настройке переиспользуются старые ключи и вы снова получаете A,NV. Помогает полный apt purge пакетов с удалением этих каталогов на всех трёх машинах и установка с нуля.
Можно ли поставить corosync-qnetd на один из узлов кластера, чтобы не заводить третью машину?
Нет. Это не поддерживается и лишено смысла: при отказе такого узла вы теряете одновременно и его голос, и голос арбитра, то есть остаётесь с одним голосом из трёх и без кворума. Арбитр обязан быть вне отказовой зоны узлов — подойдёт даже мини-ПК или тонкий клиент, требования к ресурсам минимальные.
Что произойдёт, если оборвётся линк между узлами, но оба будут видеть арбитр?
Голос получит ровно один раздел. При алгоритме ffsplit разделы сравниваются по числу активных узлов и результатам эвристик, а при равенстве (для двух узлов это всегда так) решает tie_breaker, значение по умолчанию lowest — выигрывает узел с наименьшим node id. Второй останется без кворума. Проверьте заранее, что наименьший node id у того узла, чью площадку вы считаете основной.
Достаточно ли мониторить доступность порта 5403, чтобы не повторить эту историю?
Нет, порт закрывает только половину задачи — состояние A. Ситуация «TCP-соединение есть, TLS не сошёлся, голос не выдан» проверкой порта не ловится вообще. Мониторить надо результат: наличие ровно «A,V» в qdevice-строке вывода pvecm status. Это несколько строк скрипта в cron или systemd-timer.
Нужно ли что-то делать с QDevice перед добавлением третьего узла в кластер?
Да, обязательно. Документация Proxmox требует сначала выполнить pvecm qdevice remove, затем добавлять или удалять узлы, и только потом при необходимости настраивать арбитр заново. Если добавить узел при настроенном QDevice, конфигурация кворума ломается, и восстанавливать её придётся правкой corosync.conf руками на каждом узле.
В колонке Qdevice вместо флагов стоит NR — что это?
NR — Not Registered: на этом узле corosync-qdevice не зарегистрирован в votequorum. Чаще всего пакет corosync-qdevice не установлен именно на этом узле или служба не запущена. Проверьте systemctl status corosync-qdevice и журнал службы; если узел добавляли после настройки арбитра, правильный путь — pvecm qdevice remove и повторный pvecm qdevice setup при всех узлах онлайн.
Источники
- Proxmox VE Administration Guide — Corosync External Vote Support — Раздел Cluster Manager, «Corosync External Vote Support»: поддерживаемые конфигурации (чётное число узлов — один дополнительный голос, нечётное — N−1 голосов, не рекомендуется), установка corosync-qnetd/corosync-qdevice, pvecm qdevice setup <QDEVICE-IP>, пример pvecm status, расшифровка флагов A/NA, V/NV, MW/NMW, NR, порт 5403, tie breaking по наименьшему node id, снятие QDevice перед добавлением/удалением узлов. https://pve.proxmox.com/pve-docs/chapter-pvecm.html#_corosync_external_vote_support
- pvecm(1) — Proxmox VE Cluster Manager, справка по командам — Синтаксис pvecm qdevice setup <address> с ключами --force и --network, pvecm qdevice remove, pvecm status. https://pve.proxmox.com/pve-docs/pvecm.1.html
- corosync-quorumtool — исходный код формирования флагов QDevice — Флаги печатаются только при бите VOTEQUORUM_INFO_QDEVICE_REGISTERED (иначе NR) и собираются из VOTEQUORUM_INFO_QDEVICE_ALIVE (A/NA), VOTEQUORUM_INFO_QDEVICE_CAST_VOTE (V/NV), VOTEQUORUM_INFO_QDEVICE_MASTER_WINS (MW/NMW). https://github.com/corosync/corosync/blob/main/tools/corosync-quorumtool.c
- Red Hat Enterprise Linux 8 — Configuring quorum devices — Расшифровка флагов A/NA (heartbeat между qdevice и corosync), V/NV, MW/NMW и пример вывода статуса qnetd с «Vote: ACK (ACK)». https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/8/html/configuring_and_managing_high_availability_clusters/assembly_configuring-quorum-devices-configuring-and-managing-high-availability-clusters
- corosync-qdevice(8) — man page, Debian unstable — Описание алгоритмов ffsplit (ровно один голос разделу с наибольшим числом активных узлов) и lms, опция tie_breaker со значениями lowest / highest / конкретный node id и значением по умолчанию lowest, механизм эвристик, взаимодействие с corosync-qnetd по порту 5403. https://manpages.debian.org/unstable/corosync-qdevice/corosync-qdevice.8.en.html
- corosync-qnetd-tool(8) — man page, Debian unstable — Ключи -l (список подключённых клиентов), -s (статус демона), -v (подробный вывод); в подробном выводе — имя кластера, алгоритм «Fifty-Fifty split», node id, ring id, состояние TLS и последний отправленный клиенту голос (ACK/NACK). https://manpages.debian.org/unstable/corosync-qnetd/corosync-qnetd-tool.8.en.html
- votequorum(5) — man page, Debian unstable — «ATB is incompatible with quorum devices - if auto_tie_breaker is specified in corosync.conf then the quorum device will be disabled» и «LMS is also incompatible with quorum devices». https://manpages.debian.org/unstable/corosync/votequorum.5.en.html
- Proxmox Support Forum — «2-node cluster with qdevice: quorum lost when one of the 2 nodes is down» — Тред с симптомом «Qdevice votes 1, но фактически 0 голосов», ошибками «SSL peer cannot verify your certificate» в логах qnetd и решением через полную переустановку corosync-qnetd/corosync-qdevice — обычный цикл remove/setup не помогал. https://forum.proxmox.com/threads/2-node-cluster-with-qdevice-quorum-lost-when-one-of-the-2-nodes-is-down.172244/
- Proxmox — пресс-релиз Proxmox Virtual Environment 9.2 — Выпуск 21 мая 2026: Debian 13.5 Trixie, ядро Linux 7.0 по умолчанию, QEMU 11.0. https://proxmox.com/en/about/company-details/press-releases/proxmox-virtual-environment-9-2