
Zimbra настроили, а почта тормозит: как принять работу
Ускорение Zimbra нужно проверять повтором тех же операций при сопоставимой нагрузке: вход, открытие письма, поиск и доставка. Одного зелёного графика недостаточно. Я покажу, как связать замеры с журналами, отделить проблему ящика от общей нехватки ресурсов и принять результат настройки или замены диска без выдуманных процентов.
Что считать ускорением Zimbra и с чем сравнивать
Я начинаю приёмку с действий сотрудника. Отдельно проверяю вход, открытие уже полученного письма, поиск по известной фразе и доставку тестового сообщения. У каждого действия своя цепочка зависимостей, поэтому одна цифра «скорость почты» мало что объясняет. При обслуживании корпоративной почты я заранее записываю, какое действие мешает работе и по какому признаку мы признаем его восстановленным. Открытие большого вложения через медленное соединение нельзя сравнивать с поиском короткого слова на самом сервере: получится эффектная таблица с бесполезным выводом.
В карточке проверки я фиксирую ящик, клиент, время, часовой пояс, выполняемое действие и текущую нагрузку. Для поиска беру одну и ту же фразу и область поиска; для открытия — одно и то же письмо. Доступность проверяю с обычного рабочего места, а серверные показатели снимаю одновременно. Если сравнивать утро после перезагрузки с концом рабочего дня во время резервного копирования, разницу нельзя целиком приписать настройке. Отдельно отмечаю первый запуск и повторные обращения: прогретый кэш способен улучшить результат без устранения исходной причины.
Первичный поиск неисправности разобран в статье про три команды диагностики Zimbra. Здесь моя задача другая: проверить уже выполненное ускорение и понять, можно ли закрыть работу. Я прошу сохранить исходные наблюдения до вмешательства. Если их нет, не рисую исторические значения задним числом: повторяю доступный проблемный сценарий и начинаю сравнение с него. При невозможности воспроизвести жалобу в отчёте остаётся именно этот статус, а не победное заявление об исправленной причине.
Число жалоб тоже записываю, но не превращаю в диагноз. Один медленный ящик может указывать на его индекс, тяжёлую операцию, клиент или конкретный путь подключения. Общий диск и сеть при этом не оправданы автоматически: большой ящик способен заметить общую задержку раньше остальных. Поэтому я выбираю контрольную учётную запись и проверяю одинаковые действия с одного рабочего места. Затем меняю только один элемент сравнения. Такой порядок позволяет отделить свойство ящика от свойства браузера или соединения и сохранить понятную цепочку доказательств.
- Одинаковые действия, письма и условия сравнения.
- Время операции и серверные показатели за тот же интервал.
- Контрольный ящик и проверка с рабочего места сотрудника.
- Исходные данные, внесённое изменение и критерий приёмки.
Почему зелёные графики ещё не доказывают результат
Для короткого снимка ресурсов я использую free -m, vmstat 1 10 и iostat -x -y 1 10. Это команды чтения состояния Linux, а не настройки Zimbra. iostat входит в sysstat; отсутствие утилиты ещё не означает, что у почтового сервера сломана зависимость. Ключ -x включает расширенную статистику устройств, -y убирает первый отчёт со средними значениями с загрузки системы. Интервал здесь — секунда, число отчётов — десять. Такой снимок нужен для ориентира; редкую или периодическую задержку по нему исключать нельзя. Я повторяю наблюдение именно во время воспроизводимой жалобы.
В iostat смотрю задержки чтения и записи, очередь запросов и объём работы устройства. Поле await, если оно есть в выводе, показывает среднее время запроса с ожиданием в очереди и обслуживанием; отдельные поля r_await и w_await разделяют чтение и запись. Единица измерения задержки — миллисекунда. Значение %util около 100 % нельзя объявлять универсальным пределом производительности: документация sysstat отдельно оговаривает устройства с параллельным обслуживанием запросов, включая RAID и современные SSD. Мне нужна связь роста задержек с медленной операцией пользователя. Один процент без контекста — отличный способ заказать ненужный диск.
С памятью такая же дисциплина. В free -m я смотрю прежде всего available, то есть оценку памяти, доступной новым приложениям без подкачки. Занятый swap сам по себе не доказывает, что система прямо сейчас задыхается. В последовательных отчётах vmstat поля si и so показывают обмен со swap; первый отчёт по активности усреднён с загрузки, поэтому его не сравниваю с текущей секундой. Устойчивый обмен, нехватка доступной памяти и одновременная задержка дают основание проверять давление на память. Простое равенство «swap занят — добавить RAM» такого основания не даёт.
Показатель wa в top или vmstat я использую как подсказку об ожидании ввода-вывода. Он не измеряет здоровье конкретного накопителя и не означает, что все ядра буквально стоят в очереди к диску. Документация ядра предупреждает об ограничениях учёта iowait, особенно на многоядерных системах. Для виртуальной машины я дополнительно сверяю наблюдения с нагрузкой хранилища у гипервизора: гостевая система видит свою часть картины. Покупку SSD обосновываю фактическими задержками и профилем работы. Само наличие HDD не доказывает неисправность, а установка SSD не отменяет проверку результата.
Условный разбор: один ящик в «Мастерской 17»
Покажу порядок на условной ремонтной мастерской «Мастерская 17» в Подмосковье: 33 рабочих места, жалоба инженера на поиск, остальные 32 сотрудника о задержке не сообщают. Для учебного сценария беру схему Zimbra 10.1 из руководства администратора. Цифра сотрудников здесь задаёт масштаб офиса, а не норму нагрузки для сервера. В карточке обследования я фиксирую установленную сборку, расположение данных и время жалобы. Без этой записи легко сравнить разные состояния системы и приписать эффект не тому изменению. Разбор начинаю с проверки воспроизводимости поиска, чтобы выбрать адресное действие и способ его приёмки.
Я предлагаю сначала проверить открытие известного письма и поиск фразы из него в одном и том же диапазоне папок. Затем повторить проверку в контрольном ящике, где тоже есть письмо с этой фразой. Если задержка связана с рабочим местом, проверка того же ящика на другом компьютере поможет отделить клиентскую часть. Если она остаётся за ящиком, сопоставляю время поиска с журналом mailbox и дисковой активностью. Вариант «у остальных всё хорошо» сужает круг, но не заменяет контрольный опыт. При расхождении результатов я сохраняю оба наблюдения вместо выбора удобного.
Я не принимаю объяснение «антиспам обучается на каждом входящем письме, поэтому любое перемещение запускает полную пересортировку» без проверки конкретной настройки. В штатной схеме Zimbra для SpamAssassin используются специальные ящики spam и ham: пометка сообщения как спама или не спама в веб-клиенте передаёт пример для обучения. Это не основание обвинять любое движение письма между папками. Если подозрение касается именно обучения, я проверяю /opt/zimbra/log/spamtrain.log и настройки установленной системы. Защиту не отключаю ради красивого времени открытия папки: так можно получить другую проблему вместо ответа на исходную.
Итог этого учебного разбора — правило выбора следующего действия. Подтверждённая ошибка индекса позволяет планировать его восстановление; рост дисковых задержек при фоновой работе требует отдельной проверки этой нагрузки; проблема рабочего места уводит исследование к клиенту и соединению. Ни одна из этих веток не доказывает остальные. Для поиска есть отдельный разбор о том, почему индекс не находит письмо. После выбранного исправления я возвращаюсь к исходной операции и контрольному ящику. Без такого повтора итог остаётся гипотезой, даже если пользователь успел закрыть браузер и ушёл на обед.
- 33 рабочих места — условие учебного сценария.
- Один проблемный ящик и контрольная учётная запись.
- Одинаковая фраза, область поиска и рабочее место.
- Итог выбирается по свидетельствам, без придуманных замеров.
Какими журналами подтвердить причину задержки
У Zimbra нельзя искать все события в одном придуманном файле. По умолчанию действия mailbox, включая поиск и работу с ящиком, записываются в /opt/zimbra/log/mailbox.log. Для MTA и LDAP в штатной конфигурации нужен /var/log/zimbra.log; локальный /opt/zimbra/log/audit.log помогает разбирать аутентификацию. На нескольких узлах я проверяю, где работает нужный компонент и куда настроена отправка журналов. Отсутствие записи в каталоге на соседнем сервере ещё ничего не доказывает. Выписываю время попытки, учётную запись и связанную ошибку; старое предупреждение вне интервала жалобы не превращаю в причину сегодняшнего торможения.
Дальше строю короткую связь между наблюдением и действием. Если не проходит вход, проверяю цепочку аутентификации и доступность используемого каталога. Медленный LDAP способен задерживать связанные операции, но фраза «LDAP тормозит — весь интерфейс обязательно завис» слишком груба. Если тормозит поиск, сопоставляю сообщения индекса с работой конкретного ящика. Если задерживается доставка, прослеживаю тестовое письмо по журналам MTA. При включении дополнительного журналирования заранее определяю срок и способ возврата уровня логирования: постоянный подробный вывод сам добавляет работу и мешает находить существенные события.
На узле MTA под учётной записью zimbra я просматриваю очередь командой mailq, используя окружение установленной Zimbra. У Postfix тот же просмотр предоставляет postqueue -p. В выводе ищу возраст сообщений, получателей и причину последней неудачной попытки, если она записана. Размер очереди без этих сведений не объясняет задержку. Отдельное отложенное письмо не обязано парализовать доставку остальной почты. После устранения причины проверяю движение тестового сообщения и изменение очереди. Массовое удаление писем ради пустого списка уничтожает обязательство по доставке, а частое принудительное повторение неудачных доставок может ухудшить обслуживание другой почты.
DNS проверяю по назначению: корректность MX важна для маршрутизации почты домена, разрешение имён узлов — для соединений между компонентами. Ошибка MX сама по себе не доказывает причину медленного входа в веб-клиент. Для вывода о DNS нужны повторяемая задержка разрешения имени и её совпадение с проблемной операцией. Я сравниваю ответ с самого почтового узла и условия, в которых выполняется запрос приложения. Перезагрузка LDAP или правка записей наугад только смешивают причины. Сначала сохраняю наблюдения, затем выбираю проверяемое изменение; после аварийного восстановления возвращаюсь к разбору, пока временное облегчение не объявили постоянным решением.
Что менять и как не испортить проверку
Перед переносом на быстрый накопитель я составляю карту хранения. В Zimbra Store разделены база данных MariaDB, файлы сообщений и поисковые индексы Lucene. В стандартной локальной схеме сообщения лежат в /opt/zimbra/store, индексы — в /opt/zimbra/index, файлы базы — в /opt/zimbra/db. База содержит метаданные и связи с расположением сообщений; перенос только каталога писем не означает перенос всей дисковой нагрузки. Фактические тома сверяю с конфигурацией: после предыдущих переносов и добавления хранилищ они могут отличаться от стандартных. До изменения проверяю резервное копирование и план возврата. Новый накопитель без понятной карты данных — дорогое упражнение на внимательность.
Если свидетельства указывают на индекс, я выбираю окно работ и проверяю возможности именно установленной версии. Штатная команда zmprov verifyIndex user@example.com проверяет индекс конкретного ящика, но блокирует его на время проверки. Вендор не рекомендует запускать её регулярно по расписанию. Поэтому совет «проверяйте все индексы каждую ночь» я заменяю диагностикой по показаниям. Перед этой операцией оцениваю текущую нагрузку и предупреждаю о возможном влиянии на поиск. Отсутствие жалоб не требует профилактически трогать работающий индекс. Проверка должна уменьшать неопределённость, а не создавать вечернюю очередь собственных задач.
После подтверждения необходимости восстановления под пользователем zimbra на сервере нужного ящика можно запустить zmprov reIndexMailbox user@example.com start, затем проверять ход через zmprov reIndexMailbox user@example.com status. Адрес здесь учебный, его заменяют нужной учётной записью. В руководстве также указан режим cancel; встречающийся в сторонних шпаргалках stop нельзя автоматически считать правильным синтаксисом. Переиндексация создаёт дополнительную работу, поэтому я не запускаю её одновременно для всех сотрудников. Завершение операции подтверждает окончание задачи, но ещё не доказывает восстановление поиска. Для этого нужны те же запросы и письма, с которых началось обследование.
Я разделяю изменения на проверяемые шаги: сначала устраняю подтверждённую причину, потом повторяю замеры. Одновременные переиндексация, перенос файлов и обновление системы оставляют слишком много объяснений результата. Если нагрузка совпадает с резервным копированием, сравниваю сопоставимые интервалы и согласовываю расписание, сохраняя само копирование. Если не хватает пространства или есть ошибки хранения, сначала решаю эту проблему. По одному успешному показателю SMART нельзя закрыть весь вопрос о дисковом тракте; универсальную дефрагментацию SSD в план ускорения тоже не включаю. Пакеты и обновления веду отдельным изменением с собственным планом проверки.
Когда я принимаю работу и что оставляю под наблюдением
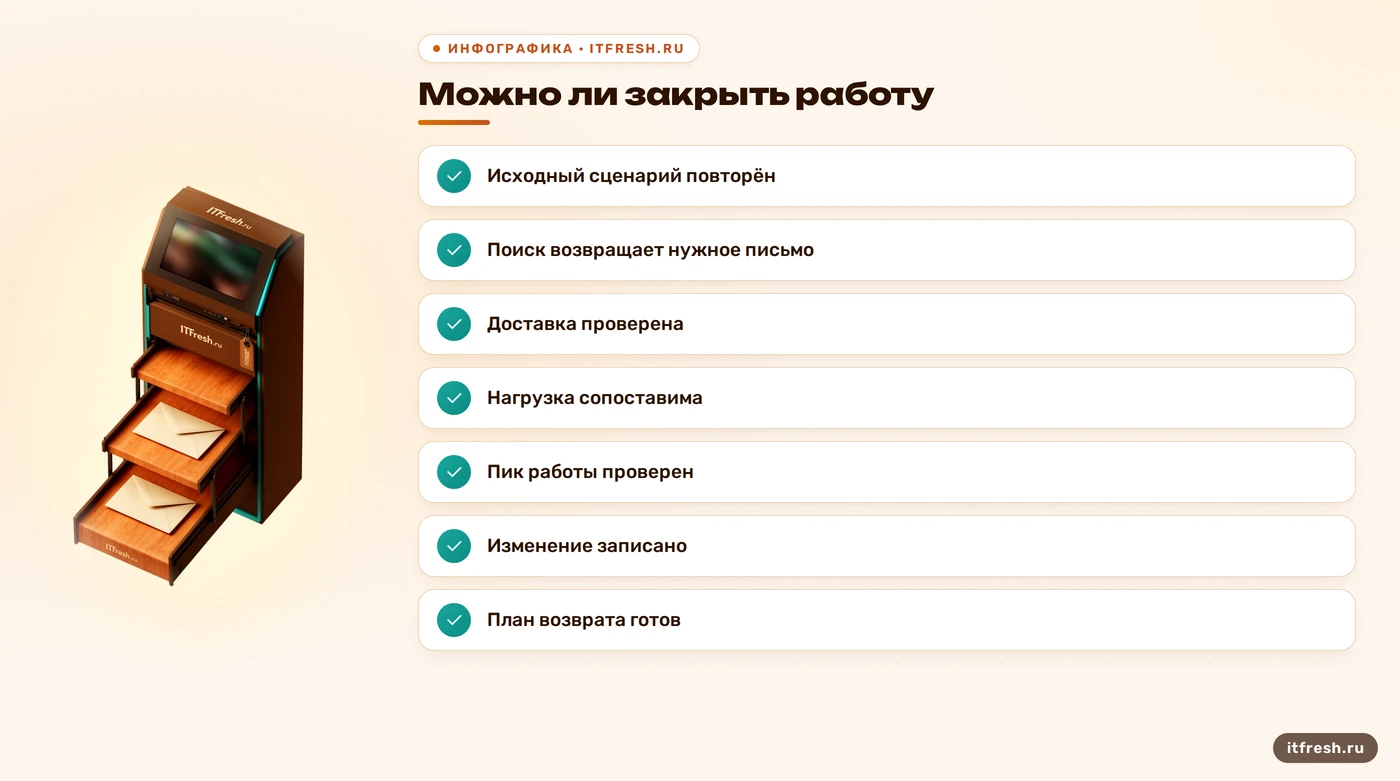
В приёмке я повторяю согласованный набор действий после завершения фоновых работ. Сравниваю результаты при похожем числе активных сотрудников, на тех же письмах и с тем же способом подключения. Отдельно проверяю, что поиск возвращает ожидаемое письмо, а тестовая доставка доходит до получателя. Мгновенный ответ без нужного результата успехом не считаю. Для операций, зависящих от кэша, отмечаю первый и повторные запросы отдельно. Если до ремонта успели собрать только жалобу без замеров, вывод ограничиваю текущей проверкой: восстановление сценария можно подтвердить, точный процент ускорения — нельзя.
Следующий контроль я назначаю на период обычной рабочей нагрузки и на запуск задач, с которыми совпадала проблема. Это может быть рабочее утро или окно резервного копирования; календарный срок выбираю по повторяемости сбоя. Универсального обещания «вылечим за 30 минут» здесь нет. Редкая задержка не обязана попасть в короткий снимок, а длительность переиндексации зависит от содержимого ящика и ресурсов. Если проблему не удалось воспроизвести после исправления, фиксирую условия проверки и продолжаю наблюдение. Формулировка «жалоб пока нет» допустима, пока её не выдают за доказанную первопричину.
На выходе я оставляю запись: исходный симптом, подтверждающие события, выполненное изменение, результат повторной проверки и условия отката. Для мониторинга выбираю показатели, связанные с жалобой: задержки хранилища, доступную память, возраст очереди, ошибки поиска и свободное место на нужных томах. Пороги задаю по нормальной работе конкретной системы и допустимому времени операции, а не по случайной красивой цифре. Границы ответственности удобно закрепить в перечне того, что входит в обслуживание сервера. Тогда понятно, кто заметит повторение и какие данные сохранит для разбора.
Работу закрываю, когда исходная операция выполняется корректно, контрольные проверки проходят, а повтор жалобы имеет понятный маршрут расследования. Если для вывода не хватает периода нагрузки, это остаётся открытым пунктом с назначенной проверкой. Если требуются новые ресурсы, показываю связь между их нехваткой и конкретной задержкой. Руководителю нужен этот вывод и согласованный следующий шаг; администратору — исходные записи и воспроизводимый сценарий. Так решение о дальнейших расходах можно проверить. Красивый скриншот из мониторинга оставляю приложением к отчёту: выполнять работу за почтовую систему он всё равно не умеет.
- Повторить исходное действие и проверить правильность результата.
- Сравнить сопоставимые интервалы и контрольный ящик.
- Проверить поиск и доставку после окончания вмешательства.
- Повторить наблюдение в обычный пик и проблемное окно.
- Записать изменение, результат, ответственного и план возврата.
Частые вопросы
Как доказать, что настройка Zimbra помогла?
Повторить те же действия при сопоставимой нагрузке, проверить правильность поиска и доставки, сопоставить время операций с журналами и метриками. Сохранить условия сравнения и выполненное изменение.
Занятый swap означает, что почте не хватает памяти?
Сам по себе — нет. Я проверяю доступную память, текущий обмен со swap и совпадение этих признаков с задержкой. Объём занятых страниц без динамики не объясняет жалобу.
Означает ли %util около 100 %, что SSD надо менять?
Универсального вывода нет: для SSD и RAID с параллельной обработкой этот показатель не отражает предел производительности. Нужны задержки, очередь запросов и связь с операцией пользователя.
Где искать ошибки LDAP и почтовой доставки?
По умолчанию в /var/log/zimbra.log на соответствующем узле. Действия mailbox проверяют в /opt/zimbra/log/mailbox.log. При централизованном журналировании нужно учитывать фактическую настройку вывода.
Нужна ли переиндексация при любом медленном поиске?
Нет. Сначала проверяю запрос, область поиска, журналы и нагрузку. verifyIndex блокирует индекс на время проверки и не предназначен для регулярного запуска. Восстановление выполняют по подтверждённым показаниям, затем повторяют поиск.
Источники
- Zimbra — руководство администратора — Проверены состав Store, MariaDB, раздельное хранение сообщений и индексов, стандартные каталоги, обучение spam/ham, reIndexMailbox start/status/cancel и ограничения verifyIndex. https://zimbra.github.io/documentation/zimbra-10/adminguide.html
- Zimbra — журналы компонентов — Проверены mailbox.log, audit.log, spamtrain.log и системный журнал MTA; журналирование LDAP дополнительно сверено с https://wiki.zimbra.com/wiki/LDAP . Основной источник: https://wiki.zimbra.com/wiki/Log_Files
- sysstat — руководство iostat — Проверены ключи -x и -y, интервал и число отчётов, смысл await, r_await, w_await и ограничение %util для SSD и RAID. https://github.com/sysstat/sysstat/blob/master/man/iostat.in
- procps-ng — руководства free и vmstat — Проверены free -m, available, vmstat с интервалом и числом отчётов, первый отчёт и поля si/so. https://github.com/procps-ng/procps/blob/master/man/free.1 ; https://github.com/procps-ng/procps/blob/master/man/vmstat.8
- Linux Kernel — файловая система /proc — Проверено ограничение интерпретации iowait: этот показатель нельзя считать точной оценкой ожидания конкретного устройства или всех процессоров. https://www.kernel.org/doc/html/latest/filesystems/proc.html
- Postfix — просмотр очереди и архитектура — Проверены mailq, postqueue -p, причина неудачной доставки и вред частого принудительного повтора: https://www.postfix.org/postqueue.1.html . Отдельная deferred-очередь: https://www.postfix.org/OVERVIEW.html