
Как я проверяю бэкап Zimbra: стенд, письма и протокол
Проверить бэкап Zimbra можно только восстановлением и проверкой данных на изолированном стенде. Я начинаю с редакции системы и способа копирования, затем проверяю письма, вложения и доступ пользователей. В статье даю порядок приёмки копии, безопасную диагностику и пример расчёта времени для условной фотолаборатории «Кадр и цвет».
Что именно должно восстановиться из бэкапа Zimbra
Я начинаю проверку с результата: сотрудник должен войти в ящик, открыть старое письмо с вложением, найти нужный заказ и продолжить переписку. Размер архива этого не доказывает. При обслуживании корпоративной почты я заранее согласовываю, какие функции должны вернуться после отказа и кто их примет. Фраза «почта запустилась» слишком удобна: под неё подходит даже пустой веб-интерфейс.
Затем выясняю, чем создана копия. Штатные legacy-инструменты zmbackup и zmrestore описаны для Network Edition; переносить эту инструкцию на любую установку Zimbra нельзя. В Open Source Edition применяют отдельно выбранный способ резервирования. Сторонний скрипт с названием zmbackup — другой инструмент со своими ключами. У модулей Backup NG и других дополнений тоже собственные процедуры. Я записываю название, версию и формат копии до первого восстановления.
Восстанавливать нужно согласованный набор компонентов. В документации Zimbra описаны отдельные хранилища сообщений, метаданных и индексов; учётные записи и конфигурация связаны с LDAP. Для Zimbra 9 руководство указывает MariaDB, поэтому я не называю внутреннюю базу любой версии просто MySQL. Копия одних файлов писем не подтверждает восстановление учётных записей, настроек и доступа к общей папке. Состав комплекта сверяю со способом резервирования и реальной конфигурацией.
Обычное копирование каталога /opt/zimbra во время записи данных не доказывает согласованность базы и файлов сообщений. Для холодной файловой копии нужен предусмотренный процедурой останов служб; для другого способа — его механизм согласования. Снимок виртуальной машины тоже требует понимания состояния приложений и внешних томов. Права доступа проверяю отдельно: неверный владелец может помешать чтению, но сам по себе не доказывает повреждение таблиц. Архиватор ведь не знает, что вы обещали директору.
- Редакция и версия Zimbra, способ и время создания копии.
- Состав комплекта: сообщения, метаданные, каталог учётных записей, необходимые настройки.
- Зависимости: внешние тома, дополнения, сертификаты и доступ к хранилищу.
- Критерии приёмки: вход, чтение, поиск, вложения и нужные общие ресурсы.
Условный кейс: «Кадр и цвет», 10 рабочих мест
Разберу учебный сценарий для условной фотолаборатории «Кадр и цвет» из Подмосковья: 10 рабочих мест, заказы и согласование макетов идут через почту. Это пример планирования, а не отчёт о реальной аварии. Задам исходные условия: копия создаётся ночью, доступ к отдельному хранилищу есть, комплект установки сохранён, а директор допускает два часа на возврат почты. Версию и патч в настоящем протоколе переписывают с сервера; придумывать их для убедительности я не стану.
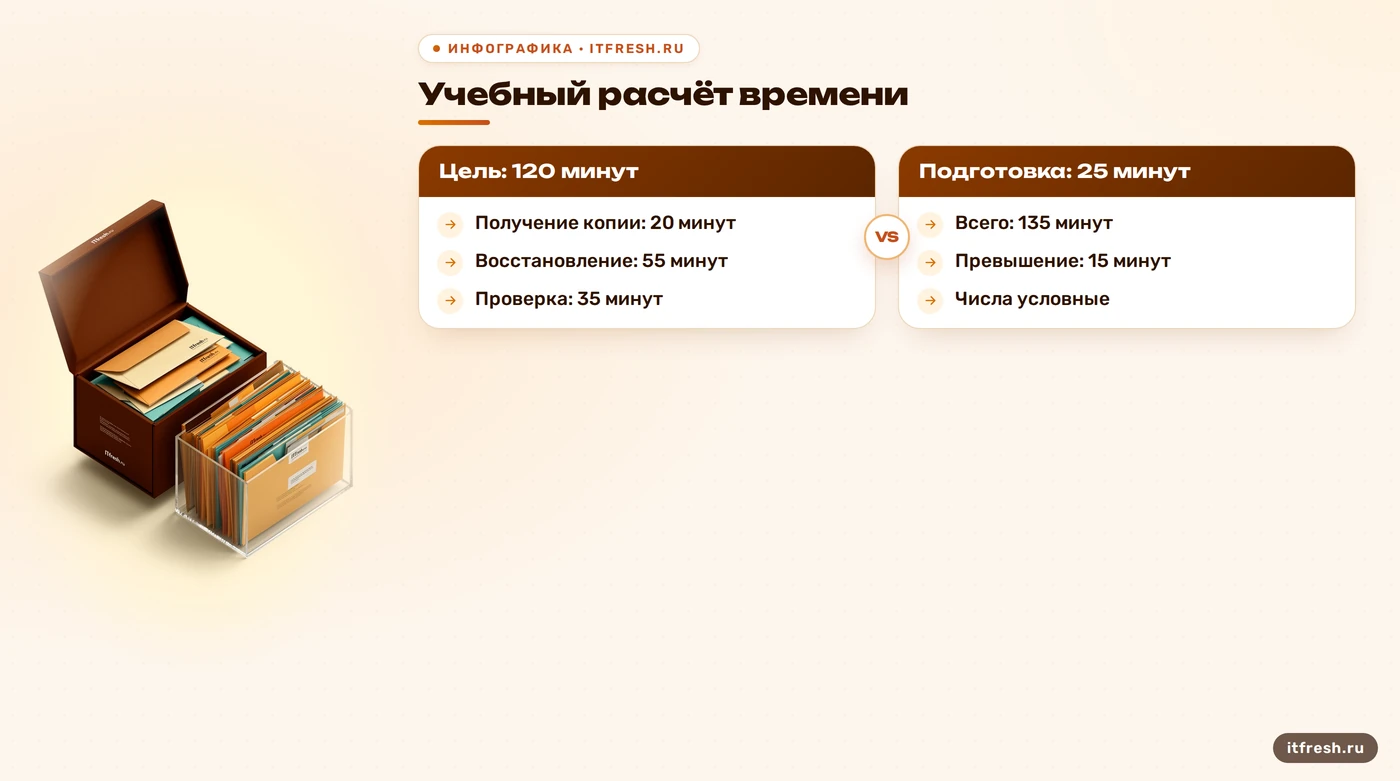
Допустим, при пробном восстановлении получилось так: подготовка окружения заняла 25 минут, получение копии — 20, восстановление данных — 55, проверка пользователей — 35. Всего 135 минут, или 2 часа 15 минут. Я считаю от начала согласованного сценария до приёмки сервиса, включая получение копии и проверки. Если начать секундомер после установки и остановить до открытия вложений, отчёт получится красивее. Рабочий день от этого короче не станет.
В таком примере превышение цели составляет 15 минут. Я сначала смотрю на операции: что можно подготовить заранее, где ждём доступ к хранилищу и сколько занимает проверка. Уменьшать список проверок ради проходного результата бессмысленно. Для повторного прогона можно заранее подготовить совместимый шаблон стенда, но в протоколе нужно указать, что он был готов. Если при настоящей аварии этого шаблона нет, время такого прогона не описывает весь сценарий.
Теперь о свежести данных. Предположим, отказ имитируют в 10:00, а последняя подтверждённая восстановлением точка данных — 02:00 того же дня. Получается восьмичасовой разрыв; письма после 02:00 могут отсутствовать в этой копии. Фактический набор недостающих сообщений зависит от активности и других сохранённых данных. Я отдельно спрашиваю, устраивает ли бизнес такое окно. Быстрый запуск вчерашней почты не решает задачу сохранения сегодняшних заказов.
- Исходная цель примера: вернуть сервис за 120 минут.
- Расчёт примера: 25 + 20 + 55 + 35 = 135 минут.
- Отклонение: на 15 минут дольше согласованной цели.
- Точка данных 02:00, имитация отказа 10:00: разрыв 8 часов.
Как подготовить стенд и не выпустить копию в сеть
Для первого теста я выбираю восстановление в совместимое окружение по инструкции именно используемого средства резервирования. При файловом переносе совпадение версии Zimbra принципиально; патч, ОС и зависимости тоже фиксирую и сверяю с выбранной процедурой. У некоторых средств есть поддерживаемый перенос между версиями, но это отдельный сценарий. Сначала доказываю возврат исходной системы, затем проверяю обновление. Иначе в одном провале смешаются несовместимость и качество копии.
На работающем источнике версию можно получить командой ниже от пользователя zimbra. Я сохраняю её вывод вместе с датой копии, сведениями об ОС, дополнениях и расположении данных. Одной надписи Zimbra на виртуальной машине недостаточно. Если для запуска нужны установочные файлы, лицензия или отдельные учётные данные, проверяю доступ к ним до аварии. В протокол не кладу пароли; указываю, где уполномоченный сотрудник сможет их получить.
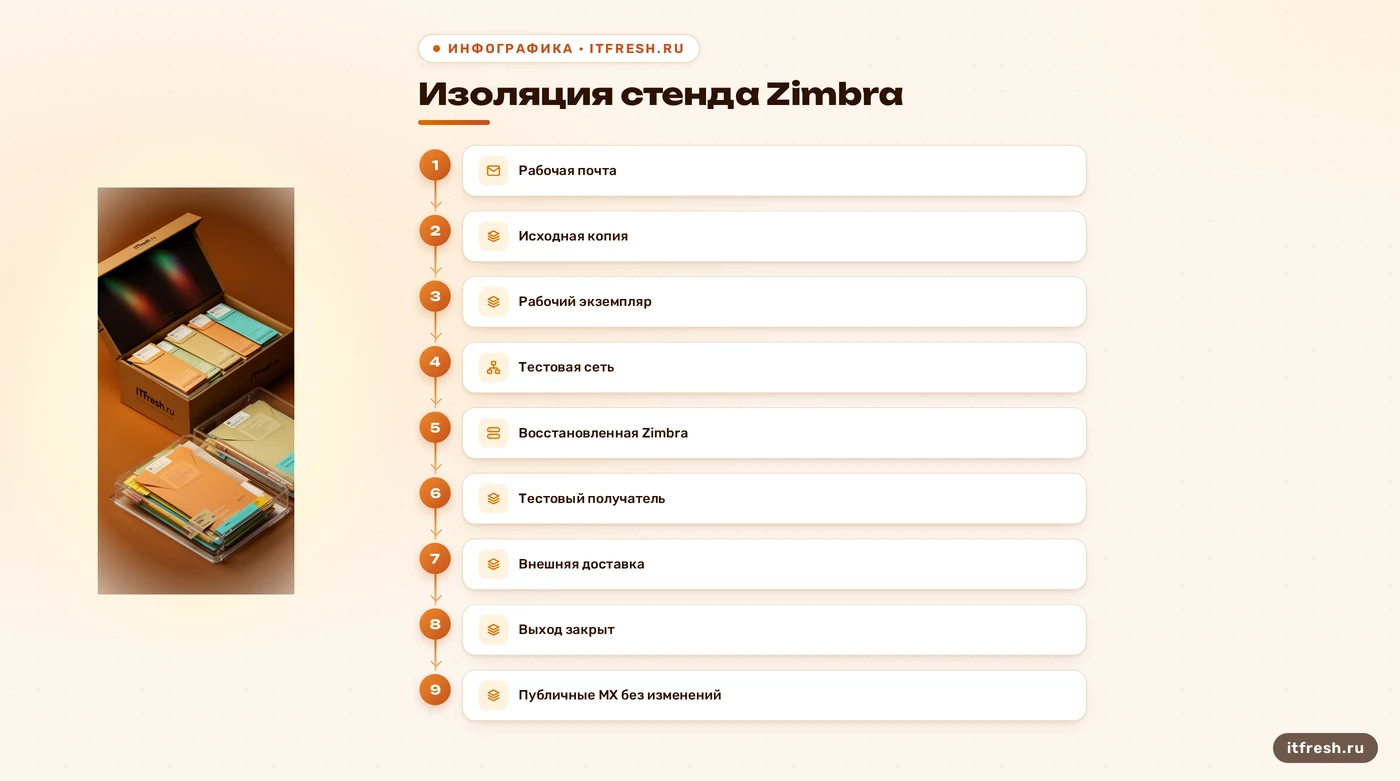
zmcontrol -vДругой адрес сети ещё не делает стенд изолированным. До запуска восстановленной системы я закрываю на границе тестовой сети доступ к рабочей среде и внешним почтовым узлам. Публичные MX-записи не меняю. Внутри стенда настраиваю разрешение имён по требованиям процедуры восстановления, а тестовых отправителей и получателей размещаю там же. Отдельно проверяю, что копия не сможет отправить наружу очередь писем, автоответы или уведомления календаря. Клон с рабочей очередью — слишком деятельный участник учений.
Я переношу в стенд рабочий экземпляр резервного комплекта, а исходную копию сохраняю отдельно от изменений при восстановлении. Нужны место под восстановленные данные и временные операции, подходящие права и контролируемый доступ. Небольшая виртуальная машина годится для части функциональных проверок, но её результат по времени нельзя переносить на другое оборудование. Подробности подготовки тестового стенда полезны и здесь; сценарий аварийного возврата при этом проверяю отдельно.
- Записать версию, патч, способ резервирования и условия совместимости.
- Проверить изоляцию до запуска копии и оставить публичные MX без изменений.
- Подготовить локальное разрешение имён и внутренний обмен тестовыми письмами.
- Сохранить исходный комплект и описать ресурсы стенда для оценки времени.
Как восстановить данные и проверить их без авторемонта
Сначала я проверяю доступность файлов комплекта, журнал задания, завершённость копии и наличие зависимых частей. Если при создании копии сохранены контрольные суммы, сверяю их: это помогает обнаружить изменения файлов, но не подтверждает логическую целостность почты. Для legacy-бэкапов важно различать полный набор и последующие инкременты. В штатном zmrestore ключ -rf означает восстановление только полного бэкапа, без последующих инкрементальных данных. Случайно добавить его — значит проверить более старую точку, чем планировали.
Порядок загрузки каталога, конфигурации и почтовых данных беру из документации своего средства. У штатного legacy-инструмента аккаунт задаётся через -a; это не инструкция для стороннего одноимённого скрипта. Сначала я восстанавливаю контрольный ящик, затем отдельно проверяю весь нужный объём: успех на маленьком ящике не доказывает возврат сервера. Административный аккаунт не считаю представительной выборкой. Для приёмки нужны используемые папки, вложения, контакты, календари и общие ресурсы, если они входят в задачу.
В восстановленной системе я отдельно проверяю базу. Для установки, где доступна эта утилита, запускаю её от пользователя zimbra по примеру ниже. Ключ -r сюда не добавляю: документация описывает его как попытку автоматического ремонта таблиц. Утилита проверяет базу через mysqlcheck и создаёт нагрузку на диски; это не проверка всего резервного комплекта. Ремонтировать данные по первой строке ошибки без разбора причины — плохой способ сохранить доказательства.
/opt/zimbra/libexec/zmdbintegrityreportПри ошибках запуска, входа и поиска я сохраняю журналы. По умолчанию журнал приложения находится в /opt/zimbra/log/mailbox.log; он помогает сопоставить действие и сбой. Невозможность запустить службы не исключает дефект копии: возможны также несовместимость окружения, недостающие файлы или неверные права. Если поиск не находит письмо, сначала проверяю наличие самого письма и сообщения журнала. Перестроение индекса выбираю после диагностики: отсутствующее сообщение оно не вернёт.
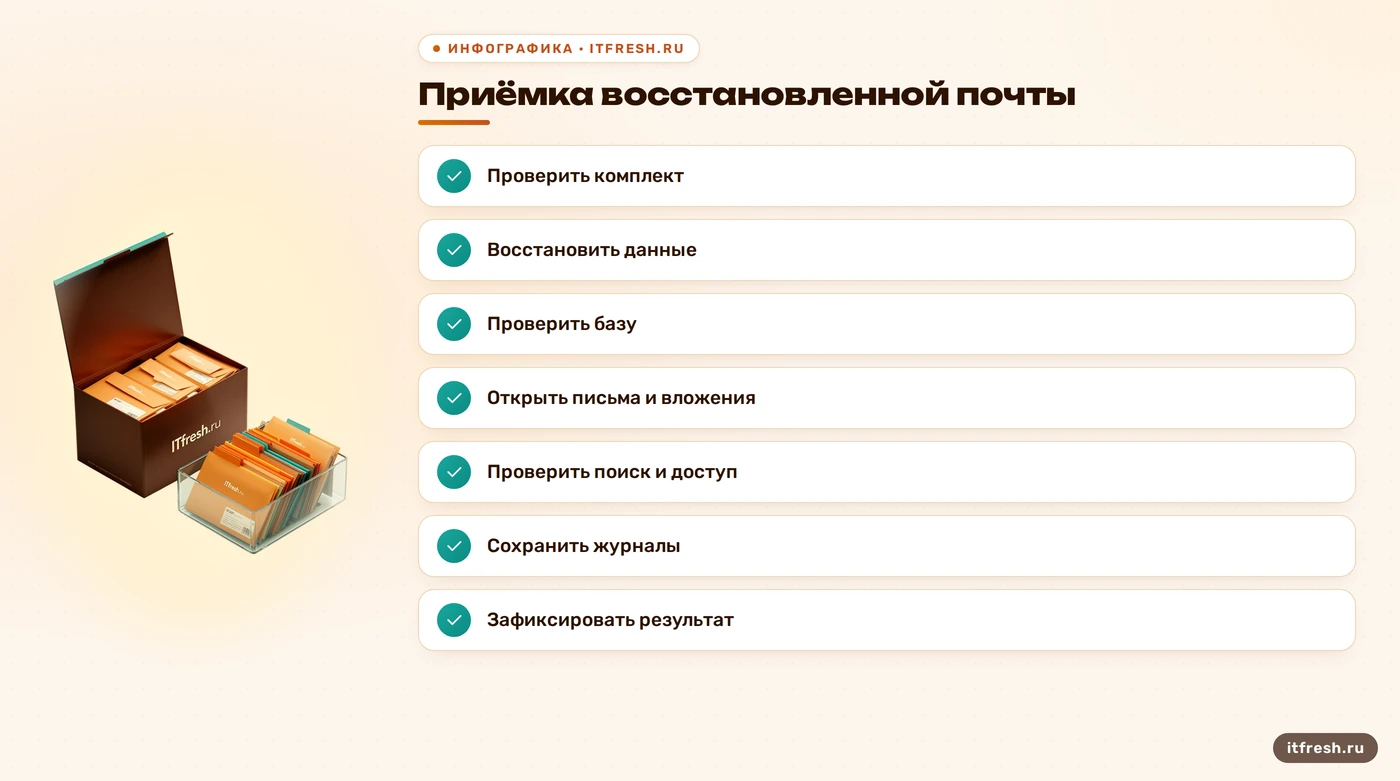
- Проверить комплект и выбранную точку восстановления.
- Выполнить восстановление средствами и в порядке своей версии.
- Проверить базу без автоматического ремонта, сохранить результат.
- Открыть контрольные данные и собрать журналы ошибок с отметками времени.
Что записать в протокол: приёмка, RTO и RPO
В протоколе я различаю требование и измерение. RTO — согласованная цель по времени возврата сервиса; фактическую длительность получаю на учениях и сравниваю с этой целью. Границы замера задаю заранее: подготовка ресурсов, получение комплекта, восстановление и приёмка должны быть учтены либо явно вынесены за пределы конкретного теста. В учебном кейсе цель — 120 минут, результат — 135. Я записываю превышение, а не переименовываю результат в новый удобный RTO.
RPO задаёт допустимую точку возврата данных относительно отказа; в рабочем обсуждении это удобно выражать допустимым окном потери изменений. Его нельзя вычислить из длительности импорта. Я фиксирую время имитируемого отказа, последнюю подтверждённую восстановлением точку и разницу между ними. Дата файла архива не всегда равна точке данных. Для проверки свежести использую заранее согласованные контрольные сообщения с известным временем, а возможность применить более поздние журналы проверяю отдельно.
Проверять ящик только по размеру и общему числу писем слабо. Я сверяю папки и контрольные сообщения на дату выбранной копии, открываю вложения, проверяю поиск, вход и используемые общие ресурсы. Изменяющийся рабочий ящик не обязан совпасть с ночной копией: поступившая после неё почта объясняет часть расхождений. Приёмы сверки почтовых данных помогают составить выборку. Каждое расхождение всё равно получает объяснение, а не отметку «примерно похоже».
Я веду короткую таблицу с проверяемым результатом. Ниже — шаблон для заполнения своими данными. Отдельно храню журналы с ограниченным доступом: они могут содержать адреса и сведения о переписке. | Поле протокола | Что я записываю | |---|---| | Система | Редакция, версия, патч, средство резервирования | | Комплект | Идентификатор копии и необходимые зависимые части | | Стенд | Ресурсы, окружение, способ изоляции | | Время | Начало и конец этапов, цель и отклонение | | Данные | Подтверждённая точка, контрольные письма и расхождения | | Приёмка | Какие функции проверены, результат и ответственный | | Доработки | Причина отказа, действие и дата повторной проверки |
- Принято: согласованные данные и функции доступны, ограничения указаны.
- Не принято: есть необъяснённые расхождения или не проходит нужная функция.
- Время и свежесть данных оцениваются отдельно от функциональной приёмки.
- Исправление считается проверенным после повторного прогона.
Как часто повторять проверку и кто отвечает за результат
Единого обязательного для всех интервала «раз в квартал» я не назначаю. Частота зависит от изменений, ценности переписки, возможностей площадки и согласованного окна потерь. Как отправную точку для небольшого офиса можно обсудить квартальную полную проверку, но это организационный выбор. После смены способа резервирования, существенного обновления или переноса хранилища я планирую внеочередной тест. Результат старого окружения не подтверждает работу новой схемы.
Между полными прогонами я слежу за результатами заданий, доступностью хранилища и сохранением нужных частей комплекта. Выборочное восстановление помогает заметить проблему раньше, но в расписании оставляю и возврат сервиса целиком. Отдельная копия вне основного сервера полезна только вместе с проверенным доступом к ней. Диск может пережить аварию, а инструкция входа — остаться на выключенной машине. У регламента тоже бывает единственный экземпляр.
Я назначаю исполнителя и принимающего результат. Один готовит стенд, выполняет восстановление и сохраняет журналы; другой проверяет согласованные функции и ограничения. По возможности повторный прогон проходит другой администратор по записанным шагам. Так обнаруживаются пропущенные зависимости: где взять установщик, кто выдаёт доступ к хранилищу, как получить необходимые учётные данные. Важна воспроизводимая процедура, которую можно выполнить без устных подсказок автора скрипта.
После проверки я убираю восстановленные данные со стенда по принятому в компании порядку и подтверждаю, что он не стал второй рабочей почтовой системой. Итог отдаю в понятной форме: какая копия восстановлена, какие функции приняты, сколько занял сценарий и какое окно данных подтверждено. Для каждой недоработки нужны ответственный и повторная проверка. Следующий тест должен отвечать на конкретный вопрос — например, уложились ли мы теперь в согласованное время после подготовки окружения.
- Согласовать периодичность и события для внеочередного теста.
- Назначить исполнителя, принимающего и место хранения инструкции.
- Проверять доступ к копии и зависимостям независимо от основного сервера.
- Закрывать замечания повторным восстановлением, затем очищать стенд.
Частые вопросы
Подходит ли команда zmrestore для любой Zimbra?
Нет. Штатная legacy-команда описана для Network Edition. Для Open Source Edition, сторонних скриптов и других модулей нужна инструкция именно выбранного средства резервирования.
Нужно ли добавлять -r к zmdbintegrityreport?
Для первичной проверки я не добавляю: -r означает попытку автоматического ремонта таблиц. Эта утилита проверяет базу, а не весь резервный комплект.
Достаточно ли дать стенду другой сетевой адрес?
Нет. До запуска копии нужно проверить сетевую изоляцию от рабочей среды и внешней почтовой доставки. Тестовый обмен проводят внутри стенда.
Чем RTO отличается от RPO?
RTO задаёт цель по времени возврата сервиса. RPO задаёт допустимую точку возврата данных. На тесте отдельно измеряют длительность сценария и подтверждают свежесть восстановленных данных.
Можно ли считать проверку одного ящика успешным тестом сервера?
Только успешным тестом этого ящика в указанных условиях. Возврат всего сервиса требует отдельной проверки полного объёма и согласованных функций.
Как часто проводить тест восстановления?
Периодичность согласуют с учётом изменений и ценности данных. Квартальный тест можно взять за отправную точку; после существенных изменений я планирую дополнительный прогон.
Источники
- Zimbra: CLI zmrestore, Network Edition — Проверены область применения legacy-команды, выбор аккаунта через -a и значение -rf: только полный бэкап без последующих инкрементов. Синтаксис конкретной установки нужно сверять с её документацией. https://wiki.zimbra.com/wiki/CLI_zmrestore_Network_Edition_only
- Zimbra: Zmdbintegrityreport — Проверены путь /opt/zimbra/libexec/zmdbintegrityreport, запуск пользователем zimbra, проверка через mysqlcheck, нагрузка на диски и значение -r как попытки авторемонта. https://wiki.zimbra.com/wiki/Zmdbintegrityreport
- Zimbra: Open Source Edition Backup Procedure — Архивная документация: использована для проверки принципа согласованной холодной файловой копии и совпадения версии при таком восстановлении. Старые скрипты не предлагаются как инструкция для современных установок. https://wiki.zimbra.com/wiki/Open_Source_Edition_Backup_Procedure
- Zimbra Collaboration Administrator Guide — В руководстве для Zimbra 9 подтверждены раздельные хранилища, MariaDB, LDAP, Lucene и диагностика индексов. Добавлены факты из экспертной базы: команда zmcontrol -v для версии, журнал /opt/zimbra/log/mailbox.log, роль LDAP в хранении учётных записей и конфигурации. https://zimbra.github.io/zimbra-9/adminguide.html
- Zimbra Backup Plus: Disaster Recovery — Проверен принцип работы с восстановленным клоном в изолированной сети без доставки входящей и исходящей рабочей почты. Продуктовые команды этой процедуры не переносятся на другие средства. https://wiki.zimbra.com/wiki/Zimbra_Suite_Plus/Zimbra_Backup_Plus/Disaster_Recovery
- NIST SP 800-34 Rev. 1 — Проверены определения RTO и RPO, разделение требований к времени возврата и точке восстановления данных, необходимость планирования и проверки восстановления. https://nvlpubs.nist.gov/nistpubs/legacy/sp/nistspecialpublication800-34r1.pdf