
Как найти узкое место в Zimbra: CPU, диск и службы
Когда Zimbra отвечает медленно, сначала снимите показатели CPU, дисковых операций и состояния служб. Команды top, iostat и zmcontrol status помогут понять, куда копать дальше; сами по себе они не доказывают поломку диска или индекса. Я покажу, что именно смотреть и какие действия безопасно отложить до подтверждения причины.
Почему Zimbra может тормозить без нехватки памяти
Медленная веб-почта — это симптом, а не диагноз. Причина может быть в CPU, задержках хранения, нехватке свободного места, сетевом пути, одном тяжёлом ящике или самой службе mailboxd. Недостаток ресурсов действительно ухудшает работу Zimbra, но из этого не следует, что надо сразу докупать RAM. Сначала смотрю на время появления проблемы и на то, затронут ли один пользователь, поиск или весь сервер. Если медленно только у одного ящика, замена диска всего узла — дорогой способ не ответить на вопрос.
В руководстве Zimbra почтовый сервер включает отдельные хранилища сообщений, данных и поисковых индексов. В актуальной документации для них описаны разные компоненты: SQL-хранилище метаданных, message store и индекс Lucene. Поэтому фраза «база и индексы — одно и то же» технически мимо. Конкретная реализация зависит от версии и конфигурации, а разносить хранилища по дискам без плана миграции не надо. Если нужна помощь с самой платформой, я занимаюсь корпоративной почтой, но в этой статье сначала разбираю самостоятельную проверку.
Как читать top и не перепутать CPU с ожиданием диска
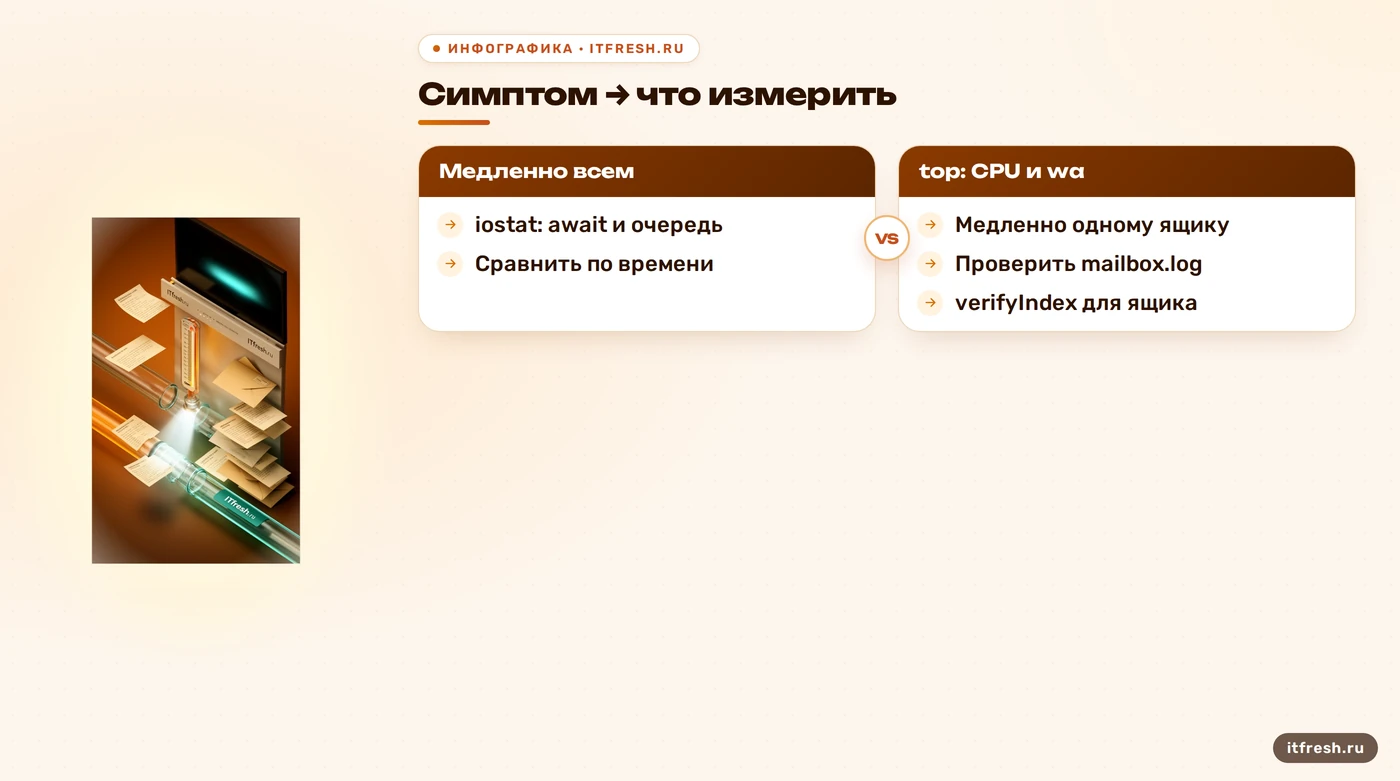
Начните с top и смотрите не на одну цифру, а на картину в течение нескольких интервалов: загрузку CPU, процессы, память и строку CPU с полем wa (ожидание ввода-вывода). Высокая загрузка процесса Java говорит о занятом CPU в момент наблюдения, но не объясняет, почему именно он занят. Низкий CPU при жалобах тоже не доказывает дисковую проблему: проверьте задержки диска и состояние службы отдельно. Команда показывает текущий срез; короткий всплеск не равен устойчивой нагрузке.
Запускайте top с учётной записью, которой разрешено видеть нужные процессы. Переключение на пользователя zimbra не является обязательным условием для диагностики: это зависит от прав и настроек системы. В интерактивном режиме P сортирует процессы по CPU, M — по памяти. Но не делайте вывод «Java съела память» только по %MEM: в Linux важны доступная память, кэш и поведение всего узла. Если нужно сравнить до и после, запишите время, нагрузку и повторите замер в сопоставимый период — скриншот одного пика не история болезни.
- Запустите top и дождитесь нескольких обновлений.
- Посмотрите CPU, поле wa и список процессов.
- Сравните симптомы с другим временем нагрузки.
Что именно показывает iostat при задержках диска
Для устройств хранения используйте iostat -xz 1 5 из пакета sysstat, если он установлен. Ключ -x выводит расширенную статистику, 1 задаёт интервал в секунду, 5 — число отчётов. Первый отчёт может включать средние значения с момента загрузки, поэтому для короткого наблюдения полезен ключ -y, который пропускает его: iostat -xyz 1 5. Названия устройств сверяйте с разметкой и тем, где действительно лежат данные Zimbra. Не угадывайте по имени вроде sda: виртуальные диски, RAID и NVMe могут отображаться иначе.
Смотрите на несколько показателей вместе: await показывает среднее время обслуживания запросов с очередью, aqu-sz — среднюю очередь, а %util — долю времени, когда устройству отправлялись запросы. Значение %util, близкое к 100 %, может говорить о насыщении устройства, обслуживающего запросы последовательно; для RAID и современных SSD оно не измеряет предел производительности напрямую. Высокий iowait в отчёте CPU тоже не является «процентом загрузки диска». Именно поэтому универсального порога вроде «выше 80 % — срочно менять накопитель» нет. Ирония проста: красное число в терминале ещё не заказ-наряд на покупку SSD.
Как проверить службы Zimbra и не искать статус в атрибутах
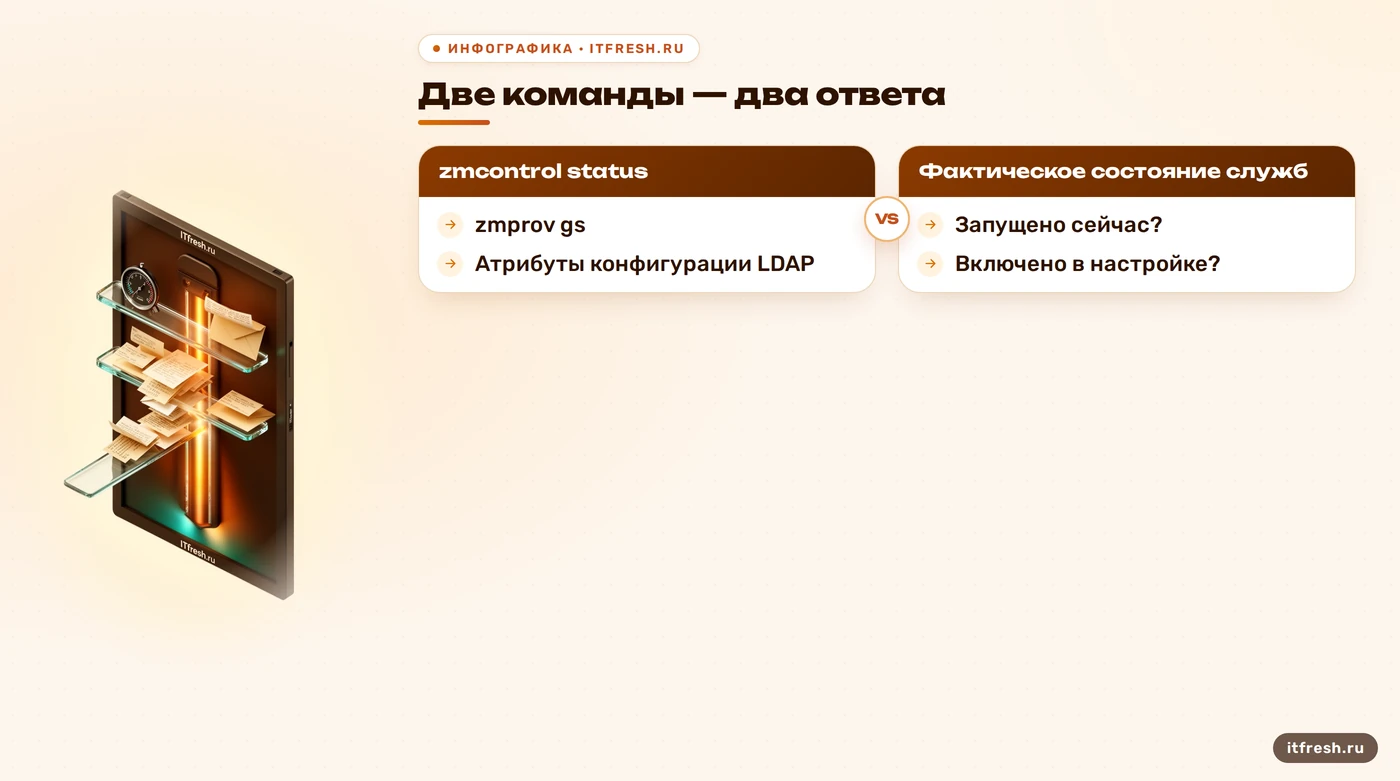
Для фактического состояния служб используйте zmcontrol status от пользователя zimbra. Команда покажет, какие службы Zimbra запущены на этом узле. zmprov gs $(zmhostname) — другая операция: она читает атрибуты конфигурации сервера из LDAP. Например, список включённых служб можно запросить через атрибут zimbraServiceEnabled, но настройка «включено» не равна состоянию процесса «работает сейчас». Это разные ответы на разные вопросы; смешивать их — всё равно что смотреть расписание дежурств вместо отметки о выходе на смену.
Если служба не запущена или перезапускается, зафиксируйте время и изучите соответствующий журнал, прежде чем перезапускать её. Ищите корреляцию: началась ли задержка одновременно с ростом очереди, ошибкой службы или пиком дисковой задержки? В Zimbra разные компоненты отвечают за веб-интерфейс, почтовую доставку, каталог и хранилище; название проблемной службы помогает сузить проверку, но не сообщает первопричину. zmprov getServerAttrs в статье был выдуман как диагностическая команда — такой инструкции здесь больше нет. Для текущего состояния достаточно корректного zmcontrol status и аккуратного чтения логов.
- Проверьте состояние через zmcontrol status.
- Отличайте запущенные службы от LDAP-настроек.
- Сверьте время ошибки с журналами и замерами.
Как проверить индекс конкретного почтового ящика
Подозрение на индекс возникает, когда проблема связана с поиском, а не просто с медленным открытием всей почты. Zimbra пишет предупреждение о повреждённом индексе в mailbox.log; в документации пример сообщения начинается с Possibly corrupt index. Для проверки индекса конкретного ящика предусмотрена команда zmprov verifyIndex. Подставляйте реальный адрес только на своём сервере и с учётом прав администратора. Если индекс в порядке, переиндексация не ускорит диск и не починит сетевую задержку — она добавит серверу работу.
Если проверка подтвердила проблему, администратор может запустить переиндексацию ящика командой zmprov reIndexMailbox user@example.com start, затем контролировать её состояние. Во время операции поиск может не находить письма, которые ещё не попали в индекс; длительность зависит от объёма ящика. Это не команда «перезапустить Zimbra» и не повод перестраивать индексы всем пользователям разом. В статье поиск писем и индекс ящика разобран именно этот симптом. Перезапуск zmmailboxdctl и переиндексация — разные действия, путать их нельзя.
Условный кейс: HDD, лишняя память и поспешный вывод
Рассмотрим условный пример из исходного сценария — компанию «Нерпа-Трейд». На сервере один HDD; сотрудники жалуются на задержки веб-почты, а администратор уже добавил память. Вымышленные точные цифры iowait 90%, %util 100%, прирост «в разы» и обещание починить всё заменой диска я убираю: проверить эти измерения нельзя, а их значение зависит от устройства и интервала наблюдения. В реальном разборе я сначала снимаю top и iostat несколько раз в период жалоб и сравниваю их с журналами и тестом конкретного ящика.
Допустим, замеры показывают устойчиво большую задержку запросов и очередь на устройстве, где хранятся данные; при этом жалобы совпадают по времени с нагрузкой. Это уже основание проверить состояние накопителя, свободное место, виртуализацию и соседние нагрузки. Затем оценивают варианты: устранить конкурирующую нагрузку, проверить хранилище или спланировать перенос на более подходящее устройство. Размещение базы и индексов по разным физическим дискам не универсальное лекарство и может требовать отдельного проекта. Если поиск жалуется лишь на один ящик, сначала читаем журнал и проверяем его индекс, а не меняем всю систему хранения.
Для диагностики сервера я собираю временные замеры, сверяю логи, проверяю службы и оформляю план действий с рисками для почты. Обслуживание сервера стоит от 7 000 ₽ в месяц — это цена из прайса, а не обещание закончить любой аудит за день. После замеров можно предметно решить, нужна ли замена накопителя, настройка размещения данных или восстановление индекса. Регламент проверки Zimbra помогает продолжить контроль после устранения причины.
Что делать после диагностики и чего не менять наугад
Если замеры указывают на накопитель, сначала подтвердите это повторными наблюдениями и проверкой самого хранилища. После этого можно сравнить перенос на более производительное устройство с устранением очереди или конкурирующей нагрузки. Не обещаю «мгновенный прирост»: результат зависит от того, была ли задержка диска главным ограничением и как настроено хранение. Увеличение буфера MariaDB без оценки памяти и нагрузки тоже не бесплатная магия — это конкретная настройка, которой в исходной статье зря советовали крутить вслепую. За деталями хранения сообщений и индексов можно обратиться к руководству администратора Zimbra.
Если проблема в индексе, проверяйте ящик и запускайте поддерживаемую переиндексацию для него; если проблема в службе — разбирайте её журнал и причину остановки. Перезапуск может вернуть службу в работу, но он не заменяет диагноз и способен временно повлиять на пользователей. Не отключайте службы только потому, что их название незнакомо: в Zimbra у каждой есть назначение и зависимости. Не переносите данные между томами без резервной копии и плана возврата. На ошибку 500 в Zimbra стоит смотреть отдельно: похожая жалоба в браузере может иметь другую причину.
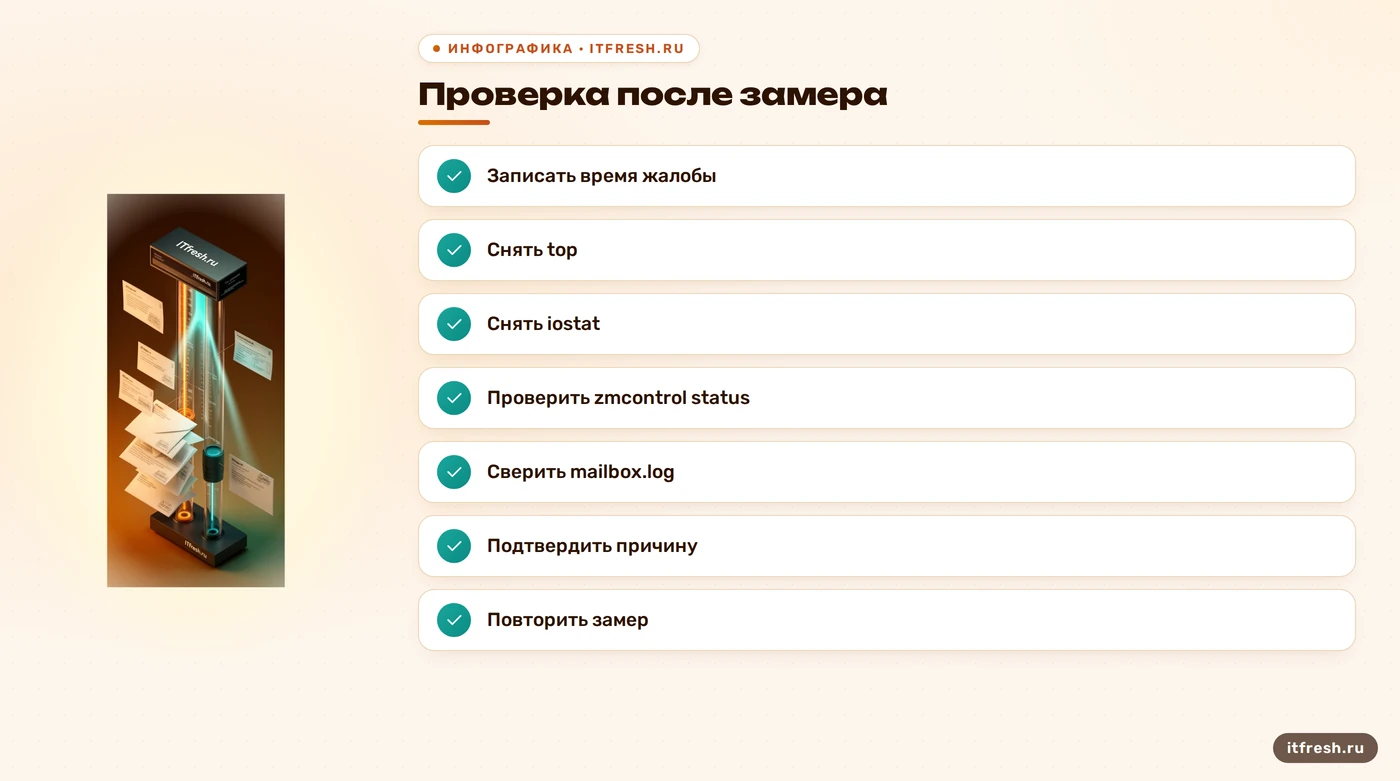
Ведите короткий журнал наблюдений: время жалобы, затронутые пользователи, вывод top, несколько отчётов iostat, состояние zmcontrol status и найденные строки mailbox.log. Это позволяет увидеть, повторяется ли сбой и что меняется одновременно. После исправления повторите те же замеры в сопоставимое время и попросите пользователей проверить именно те операции, которые замедлялись. Если показатели не изменились, пересмотрите гипотезу. Я предпочитаю такой скучный протокол красивому обещанию ускорить почту одной командой: сервер не читает рекламные тексты.
- Сопоставьте симптомы с повторными замерами.
- Исправляйте подтверждённую причину, по одной.
- Проверьте результат тем же способом.
Частые вопросы
Какая команда показывает состояние служб Zimbra?
`zmcontrol status` показывает состояние служб на узле. `zmprov gs` читает конфигурационные атрибуты, а не фактическое состояние процессов.
Что значит высокий iowait?
Это доля времени CPU, проведённая в ожидании ввода-вывода. Сверьте её с задержками и очередью устройств в iostat; сама по себе цифра не доказывает поломку диска.
Всегда ли %util 100 % означает, что диск перегружен?
Нет. Для устройств, обрабатывающих запросы параллельно, включая RAID и современные SSD, этот показатель сам по себе не отражает предел производительности.
Как проверить повреждение индекса Zimbra?
Проверьте `mailbox.log` и запустите `zmprov verifyIndex` для конкретного ящика. Если проблема подтверждена, используйте `zmprov reIndexMailbox <ящик> start`.
Поможет ли перезапуск mailboxd при повреждённом индексе?
Перезапуск службы не переиндексирует ящик. Для этого есть отдельная команда `zmprov reIndexMailbox`; сначала проверьте индекс и журналы.
Источники
- Zimbra Collaboration Administrator Guide — Архитектура mailbox server, message store, data store и index store; статусы и обслуживание. https://zimbra.github.io/adminguide/latest/
- Zimbra Collaboration Administrator Guide 8.8.15 — Проверка повреждённого индекса через verifyIndex и его восстановление через reIndexMailbox; ограничения поиска во время переиндексации. https://zimbra.github.io/adminguide/8.8.15/adminguide-8.8.15.pdf
- sysstat iostat manual — Синтаксис interval/count, значения await, aqu-sz и ограничения интерпретации %util. https://man7.org/linux/man-pages/man1/iostat.1.html
- procps-ng top manual — Интерактивная сортировка top клавишами P и M, отображение процессов и CPU. https://man7.org/linux/man-pages/man1/top.1.html