
Письма застряли в Postfix: диагностика без чистки вслепую
Если очередь Postfix растёт, сначала посмотрите её состав и одинаковые ошибки доставки, затем проверьте DNS, связь с принимающим сервером и свободное место. Команда postqueue -f только повторяет попытки; она не чинит причину. Ниже — порядок проверки, который помогает сохранить письма и быстро сузить поиск.
Что означает растущая очередь Postfix
Сначала разделяю симптомы. Доступный по SSH сервер и работающий процесс Postfix не доказывают, что он может доставить письмо дальше: исходящий SMTP-клиент отдельно разрешает домен получателя, соединяется с MX и ждёт ответ. Для первичной картины использую mailq или postqueue -p: это два способа показать очередь. Смотрю не только на число сообщений, но и на возраст, получателей, повторяющиеся статусы и текст последней ошибки. Если большинство писем ждёт один домен, ищу проблему на его маршруте. Если назначения разные, а причина одна — например, локальная ошибка DNS или нехватка места, — проверяю сам почтовый сервер. В первом абзаце полезно понять, нужна ли вам разовая помощь или постоянное обслуживание корпоративной почты: это разные задачи и разные объёмы работ.
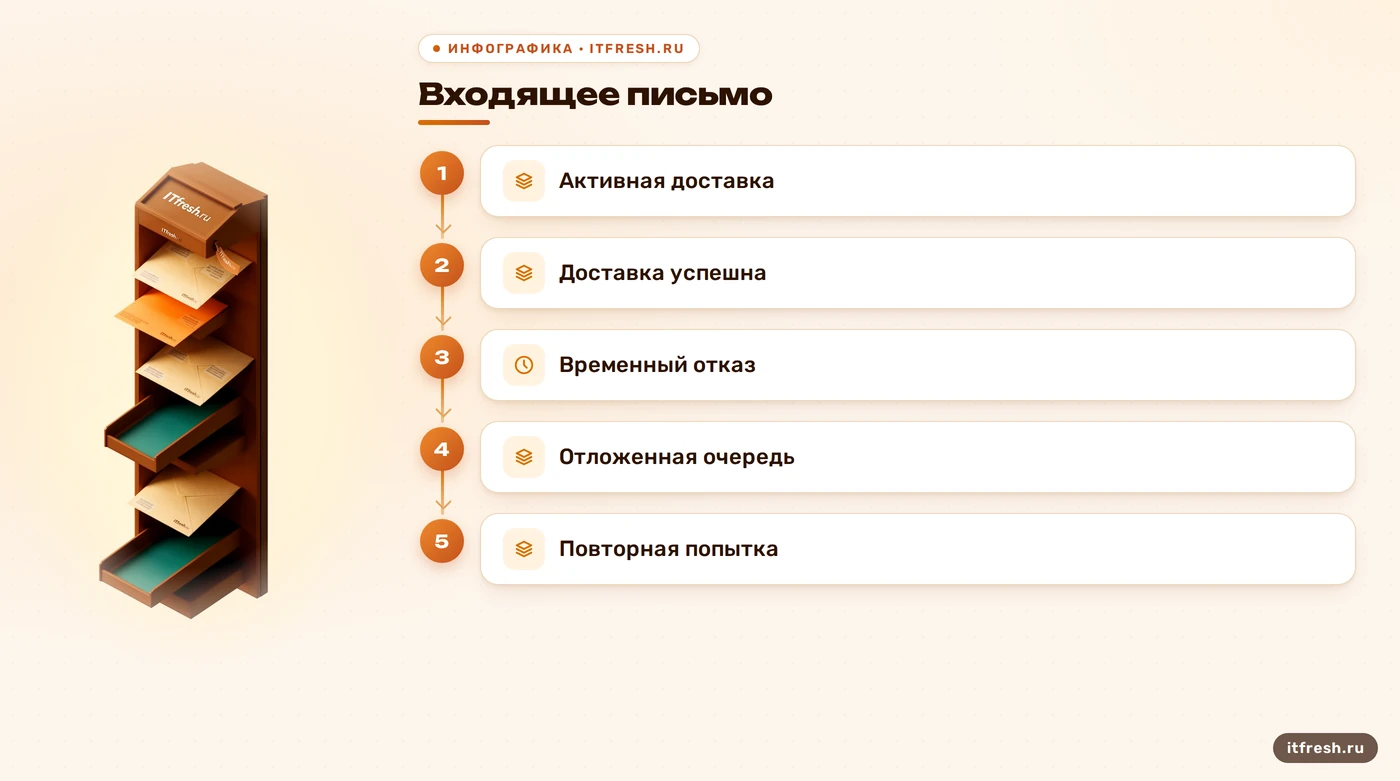
Postfix держит активную очередь ограниченной, а письма с временной ошибкой откладывает в deferred и пробует снова по расписанию. Поэтому наличие писем в deferred само по себе не означает поломку: важны возраст и повторяемость причины. Постоянный 4xx, таймаут или отказ удалённого сервера требуют устранить источник сбоя, а не бесконечно будить очередь. Команда postqueue -f назначает попытку доставки всех писем; документация предупреждает, что частый flush недоставляемых сообщений ухудшает доставку остальных. Ирония короткая: кнопка «повторить» полезна ровно до того момента, пока не заменяет диагностику. Я сохраняю исходные сообщения об ошибках, чтобы сравнить результат до и после исправления.
- Снять состояние очереди: `mailq` или `postqueue -p`
- Сгруппировать ошибки по тексту и домену назначения
- Проверить возраст писем и число повторных попыток
Разбор условного кейса: одинаковый таймаут у разных адресатов
В условной сети «Юпитер» жалоба звучит знакомо: почта не уходит, при этом администратор подключается к серверу, а служба Postfix активна. Я не выдаю такую картину за универсальный сценарий: это рабочая модель диагностики. Сначала фиксируем очередь командой postqueue -p, затем выбираем несколько писем с разными адресатами и сравниваем последние строки журнала. Если у них один внешний домен и одинаковая ошибка, проверяем доступность именно его MX. Если адресаты относятся к разным доменам, но везде повторяется ошибка резолвинга, подозрение смещается на DNS-резолвер или сетевой путь к нему. Само число писем ничего не доказывает: важны распределение по доменам и характер отказа.
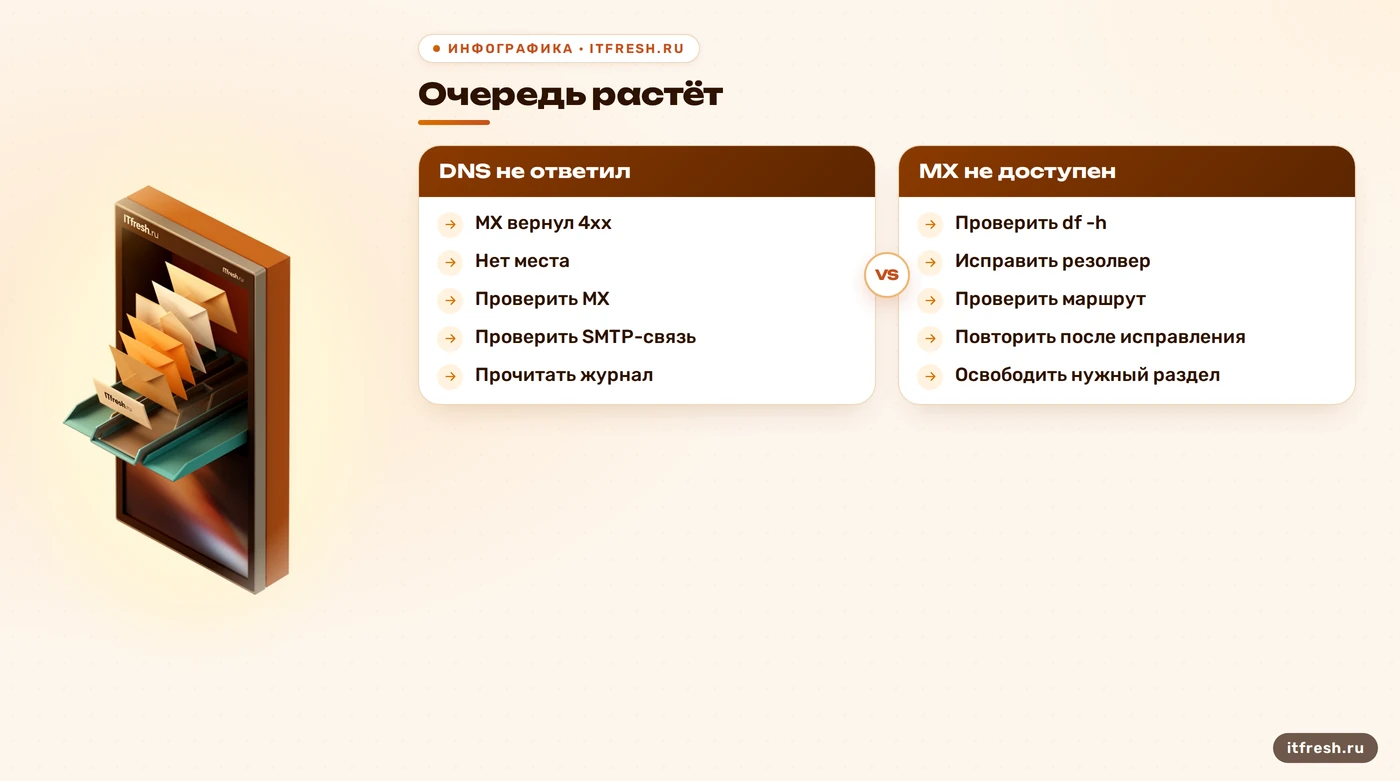
Проверку веду от дешёвой и безопасной к более вмешивающейся. Сначала df -h и журналы, затем DNS-разрешение проблемного домена и сетевое соединение с его MX на настроенном SMTP-порту. Команды dig MX example.com и dig A mx.example.com показывают ответы DNS; подставляйте домен из обезличенного примера на свой проверяемый адрес. Результат сопоставляю с сообщением Postfix, а не трактую отдельно: DNS-ответ может быть корректным, а TCP-соединение — блокироваться межсетевым экраном или не отвечать на удалённой стороне. После исправления причины я проверяю доставку на одном контролируемом письме и наблюдаю, исчезает ли тот же статус у остальных. «Сервер отвечает на ping» — не доказательство, что работает SMTP.
- `postqueue -p` — снимок очереди
- `df -h` — свободное место в файловых системах
- `dig MX example.com` — проверка MX-записи
- Журнал — точная причина последней попытки доставки
Причина первая: DNS не возвращает нужный MX
Для доставки в интернет Postfix обычно получает из DNS MX-записи домена, а затем разрешает имена почтовых узлов в адреса. Таймаут, SERVFAIL, неверный ответ или недоступность резолвера мешают начать SMTP-доставку; временная ошибка оставляет письмо в очереди для следующей попытки. Это не означает, что любой сбой DNS «останавливает Postfix»: локальная почта и уже известные назначения могут вести себя иначе, а конкретный результат зависит от конфигурации. Проверяю ответы из той же системы, где работает Postfix, и учитываю chroot: служба может видеть другой resolv.conf, чем интерактивная оболочка. Путь /etc/resolv.conf распространён, но в контейнерах, системах с systemd-resolved и управляемой сетью файл может быть ссылкой или формироваться автоматически. Ручная правка такого файла иногда переживает ровно до следующего обновления сети.
Сверяю домен из ошибки в журнале, запрашиваю MX и адреса указанных MX-хостов, а затем проверяю достижимость найденного узла. В Postfix нет универсального «DNS-таймаута 300 секунд», который объясняет очередь: конкретные временные параметры относятся к разным этапам SMTP и отличаются по назначению. Поэтому я не предлагаю поднимать таймауты наугад. Если DNS действительно недоступен, проверяю серверы резолвинга, маршрут к ним, фильтрацию UDP/TCP 53 и содержимое конфигурации, доступное процессу Postfix. Для диагностики достаточно зафиксировать, какой запрос не ответил и из какого окружения он выполнен. В официальном руководстве Postfix отдельно сказано, что отсутствие ответа на MX lookup по умолчанию откладывает доставку и приводит к повторной попытке; форсировать A-запрос вместо MX — не безобидный обход, он может направить почту неправильно.
Причина вторая: удалённый SMTP-сервер недоступен или отклоняет письмо
DNS может работать штатно, а соединение с принимающим сервером — нет. В журнале тогда встречаются сообщения о таймауте TCP, отказе в соединении, временном SMTP-ответе или проблеме TLS. Это разные неисправности. Таймаут говорит, что ожидаемого ответа не дождались; 4xx — что удалённая сторона временно не готова; постоянный 5xx обычно требует проверить адрес, политику или содержимое письма, а не повторять доставку до победного. Я сопоставляю текст статуса с конкретным получателем и MX, проверяю исходящий маршрут и правила firewall. Если очередь растёт только к одному домену, изменение глобальной конфигурации Postfix — плохой первый шаг: причина может быть на стороне адресата или на маршруте до него.
Отдельно разбираю таблицы маршрутизации и получателей, чтобы не смешивать похожие названия. relay_recipient_maps — список допустимых адресов для доменов, которые Postfix обслуживает как relay; он помогает отклонить неизвестного получателя при входящем SMTP-сеансе. Ошибка в этой таблице чаще приводит к отказу при приёме, а не объясняет очередь исходящей почты. После изменения обычного текстового файла таблицы может требоваться пересобрать индекс через postmap с типом, настроенным в main.cf, а затем проверить результат. Если задача — выбрать следующий узел доставки, нужно исследовать transport_maps или другие настройки маршрута, а не приписывать эту роль relay_recipient_maps. На практике точное название директивы важнее красивой версии про «ложный релейный хост». Для отдельного разбора входных ограничений пригодится материал о правилах Postfix relay.
- Сопоставьте ответ SMTP с кодом и доменом
- Проверьте доступность нужного MX и исходящий firewall
- Различайте входной контроль `relay_recipient_maps` и маршрут доставки
Причина третья: заканчивается место для очереди или журналов
Если файловая система, где лежит очередь Postfix, исчерпала свободное место или закончились inode, новые операции записи могут завершаться ошибками. Обычно очередь находится в каталоге, заданном параметром queue_directory; /var/spool/postfix — типичное значение по умолчанию, но полагаться на него без проверки нельзя. Узнать настройки установленного экземпляра помогают postconf queue_directory и, в Postfix 3.4 и новее, postconf maillog_file; в старых версиях ориентируйтесь на системный журнал. Для заполнения места проверяю df -h, для исчерпания inode — df -i, затем выясняю, какой каталог вырос. Журнал может лежать в системном журнале, в файле вроде /var/log/maillog или /var/log/mail, либо в отдельном файле Postfix. Точный путь зависит от системы и настройки журналирования; /var/log/mail.log не универсален.
Не удаляйте файлы вручную из каталога очереди и не очищайте активный журнал командой rm: так легко повредить данные или потерять причину сбоя. Сначала найдите крупные файлы, проверьте правила ротации и выясните, кто занимает раздел. Если место заняли старые журналы, штатная ротация и корректное освобождение диска решают именно проблему хранения; после этого перепроверяю очередь и журнал. Само освобождение места не гарантирует немедленную доставку: при оставшемся DNS-сбое или недоступном MX сообщения останутся отложенными. Порог мониторинга выбирают под объём и скорость роста именно этой системы, поэтому универсальные «80 процентов» без учёта нагрузки — красивая, но слабая настройка. Нужны предупреждения заранее и проверка, что они действительно приходят.
Порядок проверки и безопасное восстановление доставки
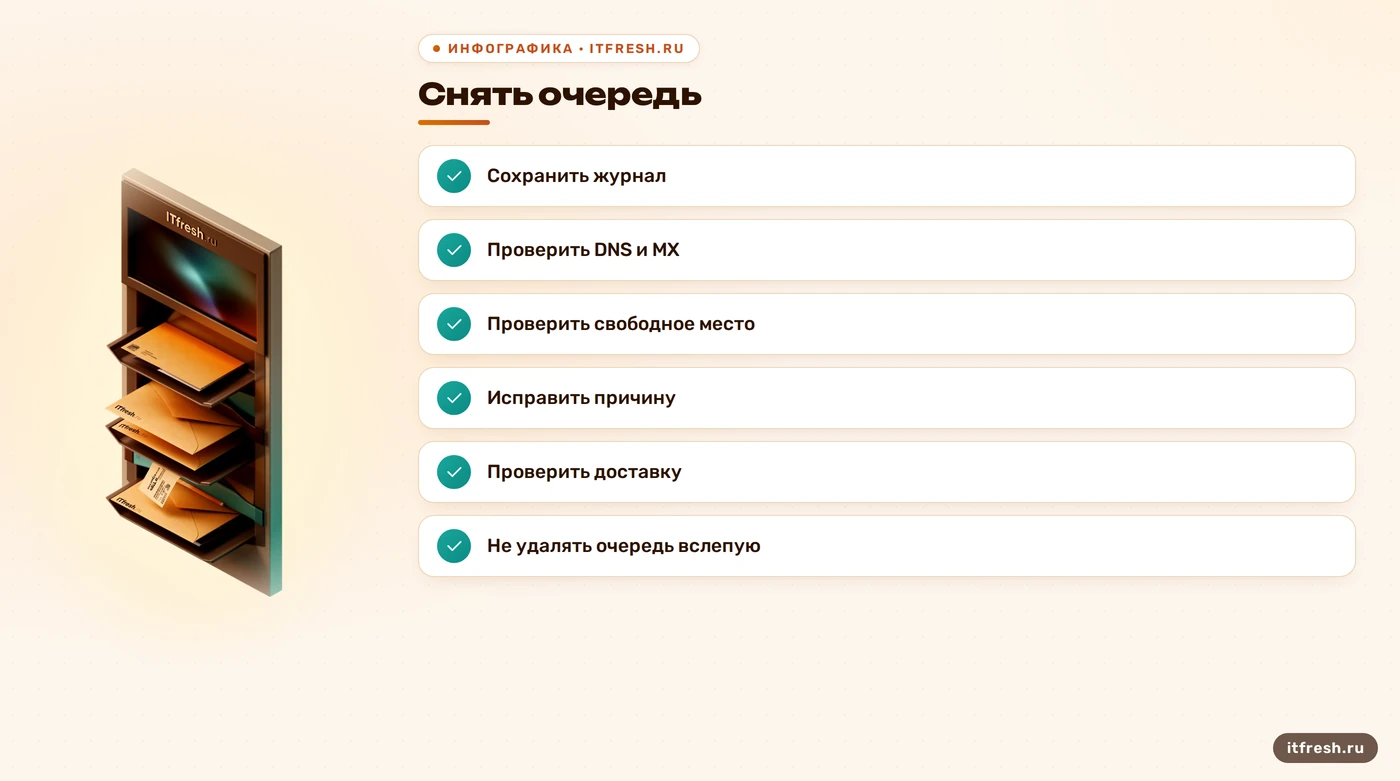
Мой порядок такой: фиксирую очередь и характер ошибки; проверяю место и inode; сверяю DNS-ответы; проверяю соединение с MX; затем изучаю соответствующую настройку Postfix. Для логов ищу первую осмысленную ошибку в цепочке попыток, а не последнюю строку после серии последствий. На разных дистрибутивах это может быть journalctl или системный mail-журнал, поэтому сначала определяю, куда пишет конкретная установка. Если менялась таблица Postfix, проверяю её тип и индекс; если менялся main.cf, проверяю синтаксис и применяю конфигурацию штатной командой для этой установки. После каждого изменения делаю один контрольный шаг и сравниваю новые записи. Такой порядок не гарантирует, что все причины обнаружатся за минуту, зато не добавляет к исходной проблеме удалённые письма и лишние изменения.
Когда причина устранена, postqueue -f можно использовать для повторной попытки доставки. Для одного сообщения существует адресный вариант postqueue -i queue_id; очередь при этом не исчезает мгновенно, если получатель снова отвечает временным отказом. Удаление — отдельное, необратимое действие: postsuper -d queue_id удаляет указанное письмо, а применение команды к ALL может удалить всю очередь. Я использую его только по явному решению владельца почты после проверки состава и сохранения нужной информации. Если письма остаются в hold, их сначала нужно осознанно освободить; повторный flush не равен снятию hold. Разбор команд postqueue и postsuper можно продолжить в материале о relay recipient maps и резервном MX, если проблема связана с приёмом через резервный узел.
- Сохраните очередь и журнал до изменений
- Исправляйте одну подтверждённую причину за раз
- Проверьте доставку и повторяющийся статус после исправления
- Не удаляйте письма ради уменьшения счётчика
Частые вопросы
Как посмотреть очередь Postfix?
Выполните `mailq` или `postqueue -p`. Сгруппируйте сообщения по тексту ошибки, возрасту и домену получателя.
Что делает команда postqueue -f?
Она ставит в очередь попытку доставки всех сообщений. Если причина сбоя не устранена, письма останутся или снова окажутся в deferred.
Почему письма в deferred не уходят?
Это очередь писем с временной ошибкой. Проверьте журнал, DNS, доступность MX, SMTP-ответ и место на файловой системе.
Очищает ли postqueue -f очередь?
Нет. Команда инициирует повторную доставку, а не удаляет письма. `postsuper -d` удаляет сообщения и может привести к потере почты.
Что проверять при заполненном диске?
Проверьте `df -h`, `df -i`, значение `queue_directory` и фактическое место журналов. Не удаляйте файлы непосредственно из очереди.
Источники
- Postfix: postqueue(1) — Просмотр очереди, flush и предупреждение о частом повторе недоставляемой почты: https://www.postfix.org/postqueue.1.html
- Postfix: postsuper(1) — Операции обслуживания очереди и удаление сообщений: https://www.postfix.org/postsuper.1.html
- Postfix: postconf(5) — Назначение relay_recipient_maps, MX lookup и параметры DNS/SMTP: https://www.postfix.org/postconf.5.html
- Postfix: Debugging Howto — Где искать журналы Postfix и как начинать диагностику: https://www.postfix.org/DEBUG_README.html
- Postfix: QSHAPE_README — Механика deferred-очереди и повторных попыток доставки: https://www.postfix.org/QSHAPE_README.html