
Резервный MX на Postfix принимает почту несуществующим сотрудникам и рассылает возвраты чужим людям
Если у вас есть резервный почтовый сервер на Postfix, который «просто стоит на всякий случай», — почти наверняка он принимает письма на любой выдуманный адрес вашего домена, копит их в очереди и потом рассылает возвраты людям, которые вам ничего не писали. Дыре обычно два-три года, обнаруживается она либо по забитому диску, либо по тому, что почта компании внезапно начала падать в спам. Ниже — механика, конкретный разбор с цифрами и рабочая конфигурация, которую я ставлю клиентам.
Что происходит на самом деле: relay_domains без relay_recipient_maps
Резервный MX устроен просто: он объявлен вторым в DNS с большим приоритетом, принимает почту, когда основной сервер недоступен, держит её в очереди и отдаёт, когда основной вернулся. В Postfix за это отвечает класс адресов «relay»: список доменов задаётся параметром relay_domains, доставка идёт транспортом relay_transport, а проверка получателей — параметром relay_recipient_maps. Так вот, relay_recipient_maps по умолчанию пуст (в документации прямо написано «default: empty»), и пока он пуст, SMTP-сервер принимает вообще любого получателя в доменах из relay_domains. Не «иногда», не «в момент недоступности основного» — всегда.
Дальше сценарий разворачивается механически. Спамер или чей-то заражённый хост перебирает адреса вида a.ivanov@, info2@, buh1@ в вашем домене. Основной MX такой мусор отбивает на этапе RCPT TO — там есть список ящиков. Резервный отвечает «250 OK», кладёт письмо в очередь и берёт на себя ответственность за доставку. Потом он тащит письмо на основной сервер, получает «550 User unknown», и теперь по RFC обязан сформировать отчёт о недоставке и отправить его отправителю. Отправитель в конверте подделан — это чужой человек или чужая компания. Вот вам backscatter: ваш сервер рассылает возвраты непричастным людям, и в глазах Mail.ru, Яндекса и Gmail это ровно то же самое, что рассылать спам.
Ключевой момент, который стоит держать в голове: значение имеет то, на каком шаге вы говорите «нет». Пока вы не сказали «250» в ответ на RCPT TO или DATA, отказ несёт подключившаяся сторона — это её проблема и её лог. Как только вы приняли конверт, все последствия ваши: диск, очередь, исходящий трафик, репутация IP и домена. Postfix даёт для отказа на этапе SMTP всё, что нужно, — надо только включить.
Почему такая конфигурация встречается повсеместно? Потому что большинство инструкций по backup MX заканчиваются на двух строчках: relay_domains и transport_maps. Схема «работает» — почта в аварии копится, после аварии доезжает, галочка поставлена. То, что между авариями сервер работает мусоросборником, в тесте не видно. Замечу, что в Postfix начиная с версии 3.0 relay_domains по умолчанию пуст (раньше он наследовал $mydestination), так что сам факт, что домен там прописан, — это уже осознанное действие администратора. А вот второй половины действия — списка получателей — обычно нет.
- relay_domains — какие домены мы соглашаемся принимать и релеить дальше
- relay_recipient_maps — какие адреса в этих доменах существуют (по умолчанию пусто = все)
- relay_transport — чем доставляем (по умолчанию транспорт relay)
- smtpd_reject_unlisted_recipient — по умолчанию yes, то есть механизм отказа уже включён и ждёт непустую таблицу
Разбор из практики: сеть обувных магазинов на 40 рабочих мест
Клиент — магазин обуви «КаблукСтиль»: офис, склад и три торговые точки, 40 рабочих мест, свой домен kablukstyle.example. Основной почтовый сервер — Exchange 2019 в офисе, канал 100 Мбит/с от местного провайдера, падает вместе с электричеством раз в два-три месяца. В 2023 году прошлый подрядчик поднял резервный MX на VPS: Debian 12, Postfix 3.7 из штатного репозитория, две строчки в main.cf, вторая MX-запись в DNS с приоритетом 20. Всё честно работало: когда офис отваливался, почта копилась и потом доезжала.
Пришли ко мне с другой формулировкой проблемы: «письма поставщикам и маркетплейсам стали уходить в спам, а Mail.ru задерживает доставку на часы». Первое, куда я полез, — не в SPF и не в DKIM, а на резервный MX, потому что он в SPF есть и отправляет от имени домена. Картина: /var/spool/postfix занимает 5,9 ГБ, postqueue -p | tail -1 показывает 31 480 сообщений в очереди. Прогон по логам за сутки: около 36 000 входящих RCPT TO на домен, из них порядка 95 % — адреса, которых в Exchange никогда не было: буквенный перебор, имена из старых утечек, служебные вроде admin@, webmaster@, sales2@. Все приняты с кодом 250. Исходящий поток отчётов о недоставке — около 1 000 писем в час, все на подделанные адреса отправителей.
Дальше цепочка очевидна: почтовые системы видят с IP резервного MX постоянный поток непрошеных MAILER-DAEMON, снижают репутацию IP, а через SPF-связку тень ложится и на домен. Отсюда «письма в спам» и «Mail.ru тормозит доставку». Забитый диск — просто побочный эффект, который в тот момент никого не беспокоил, потому что VPS был на 40 ГБ и запас ещё оставался.
Починка заняла минут сорок: выгрузил из Exchange 63 адреса (40 сотрудников плюс общие ящики магазинов и группы), положил в relay_recipients, собрал таблицу, перечитал конфиг, вычистил очередь от заведомо мусорных отправлений. Результат на следующие сутки: очередь 31 480 → 9 сообщений (нормальный рабочий остаток), 4 700 отказов «User unknown in relay recipient table» на этапе RCPT TO, исходящих возвратов — ноль. Репутация подтягивалась медленнее: Mail.ru перестал задерживать доставку примерно через девять дней, и это, честно говоря, самая неприятная часть истории — сломать репутацию можно за неделю, а восстанавливать её приходится вместе с почтовым провайдером, а не конфигом.
- Было: 31 480 писем в очереди, 5,9 ГБ спула, ~1 000 возвратов в час чужим людям
- Стало: 9 писем в очереди, ~4 700 отказов на этапе SMTP в сутки, 0 возвратов
- Время работ: ~40 минут. Время восстановления репутации: 9 дней
Как настроить правильно: пошагово
Основа — непустой relay_recipient_maps. Технически Postfix использует эти таблицы как списки: ему важно только, найден ли ключ, а значение справа он не использует вообще. Поэтому исторически справа пишут «x» — это заглушка, а не какая-то магия. Минимальный рабочий кусок main.cf для резервного MX выглядит так:
# что релеим
relay_domains = kablukstyle.example, corp.kablukstyle.example

# кому релеим — список валидных адресов
relay_recipient_maps = lmdb:/etc/postfix/relay_recipients

# куда отдаём, когда основной вернулся (необязательно, см. ниже)
transport_maps = lmdb:/etc/postfix/transport

# политика релея (Postfix 2.10+)
smtpd_relay_restrictions =
    permit_mynetworks,
    reject_unauth_destination

smtpd_recipient_restrictions =
    permit_mynetworks,
    reject_unknown_recipient_domain,
    reject_unauth_destination
Про тип таблицы: postmap без явного префикса собирает файл типа, зашитого при сборке Postfix, и он бывает разным — lmdb или hash в зависимости от системы. Посмотрите свой командой postconf -d default_database_type и укажите тип в main.cf явно, чтобы не гадать, почему сервер «не видит» таблицу. Список доступных типов покажет postconf -m.
Строка transport_maps для вторичного MX, строго говоря, не обязательна: по документации (STANDARD_CONFIGURATION_README) резервному серверу достаточно relay_domains и списка получателей — домен уходит транспортом relay_transport (по умолчанию relay), а следующий узел Postfix найдёт по MX-записям. Явный транспорт я всё же прописываю, чтобы резервный сервер не зависел от DNS и не пытался доставлять сам себе. Квадратные скобки вокруг имени отключают MX-поиск; после правки файла — тот же postmap.
# /etc/postfix/transport
kablukstyle.example        relay:[mail.kablukstyle.example]
corp.kablukstyle.example   relay:[mail.kablukstyle.example]

postmap lmdb:/etc/postfix/transport
И ещё одно требование из той же документации: домен резервного MX нельзя одновременно указывать в mydestination, virtual_alias_domains или virtual_mailbox_domains — иначе он попадает в другой класс адресов и relay_recipient_maps перестаёт работать.
Сам файл со списком получателей — обычный текст, адрес и заглушка через пробел или табуляцию. Псевдонимы, рассылочные группы, общие ящики (info@, sales@, buh@) обязательно включаем: с точки зрения внешнего мира это полноценные получатели.
# /etc/postfix/relay_recipients
cat > /etc/postfix/relay_recipients <<'EOF'
ivanov@kablukstyle.example      x
petrova@kablukstyle.example     x
info@kablukstyle.example        x
sales@kablukstyle.example       x
buh@kablukstyle.example         x
EOF

# пересобрать индексированную таблицу — обязательно после КАЖДОЙ правки
postmap /etc/postfix/relay_recipients

# проверить, что ключ находится
postmap -q ivanov@kablukstyle.example lmdb:/etc/postfix/relay_recipients

# проверить конфиг и перечитать
postfix check && postfix reload
Проверка результата — не «в логах вроде чисто», а живой SMTP-диалог. Берём swaks или обычный telnet и стучимся с внешней машины на порт 25 резервного MX. На существующий адрес должно прилететь «250», на выдуманный — «550 5.1.1 ... User unknown in relay recipient table». Код отказа задаётся параметром unknown_relay_recipient_reject_code, по умолчанию 550, и менять его не надо. И отдельно проверьте, что после этой правки почта в аварийном режиме реально доезжает: остановите на минуту сервис на основном сервере, отправьте письмо на живой адрес, убедитесь, что оно легло в deferred и потом доехало.
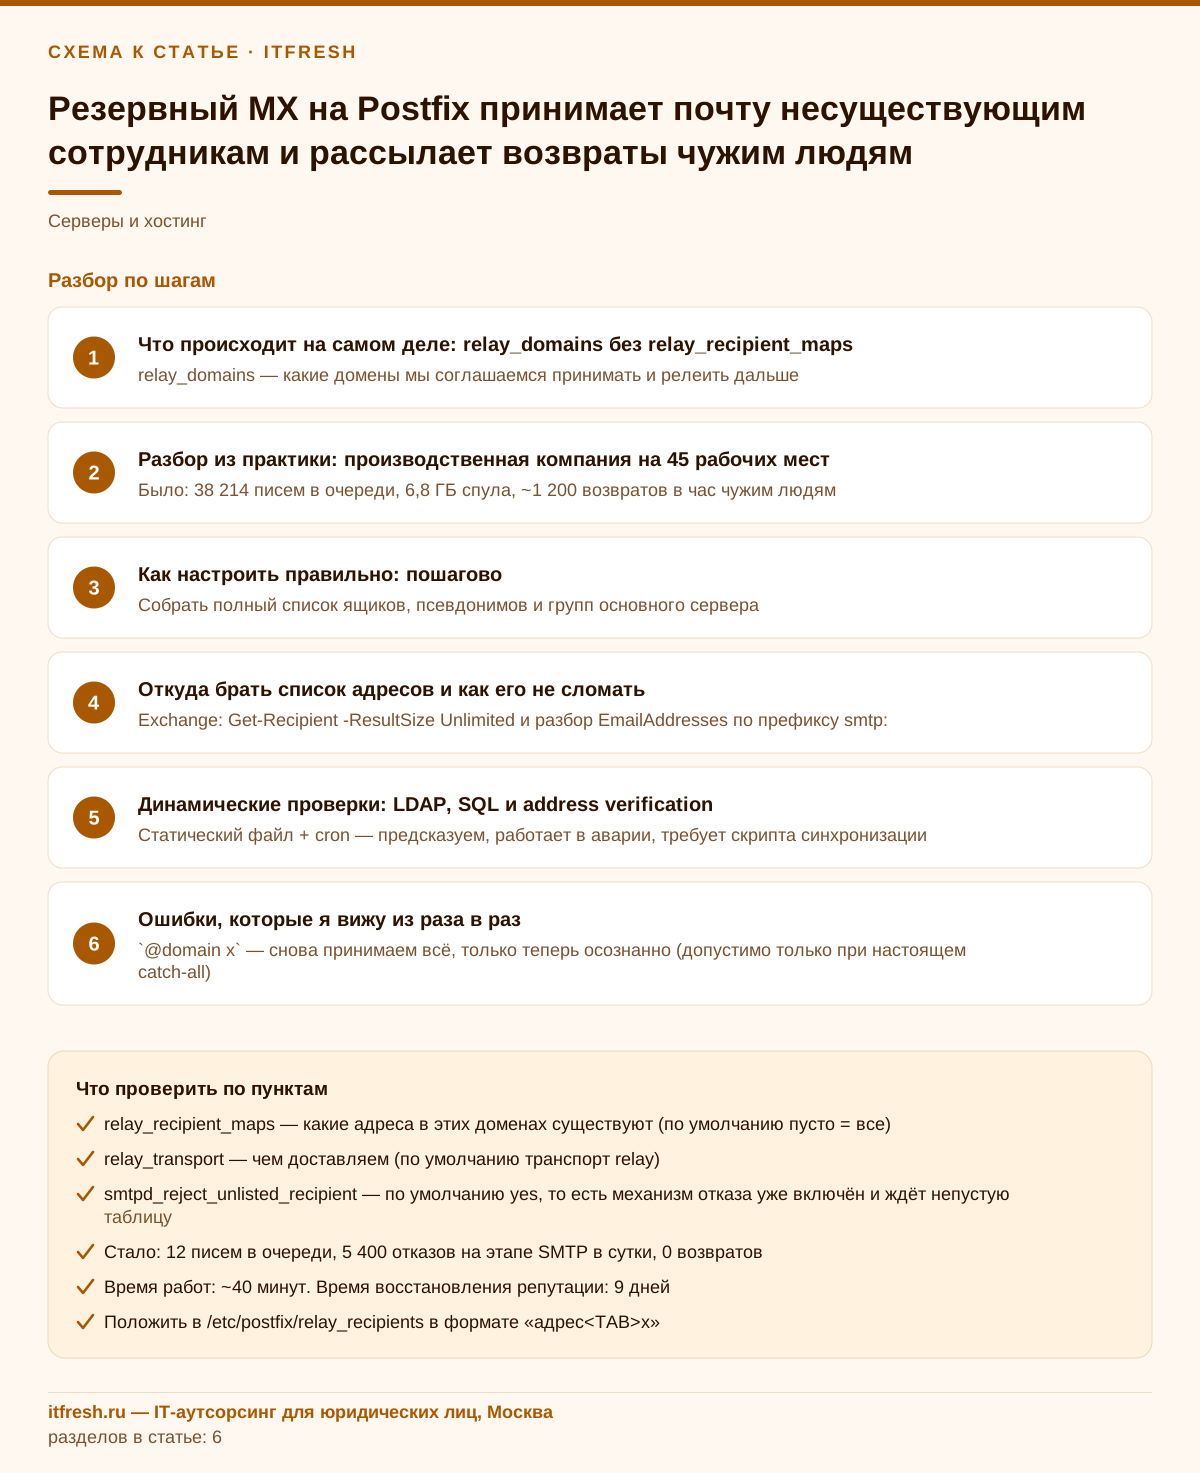
- Собрать полный список ящиков, псевдонимов и групп основного сервера
- Положить в /etc/postfix/relay_recipients в формате «адрес<TAB>x»
- Указать relay_recipient_maps с явным типом таблицы, выполнить postmap
- Проверить внешним SMTP-диалогом: 250 на живой адрес, 550 на выдуманный
- Убедиться, что аварийная очередь по-прежнему работает
Очередь в аварию: relay_transport, maximal_queue_lifetime и что должен уметь основной сервер
Список получателей закрывает приём мусора, но у резервного MX есть вторая половина работы — продержать настоящую почту, пока основной сервер лежит. Письма к relay-доменам уходят транспортом из transport_maps, а если его нет — из relay_transport (по умолчанию relay, отдельная запись в master.cf, чтобы входящий релей не толкался в одной очереди с исходящей почтой). Недоставленное письмо Postfix повторяет с интервалом от minimal_backoff_time (300 с) до maximal_backoff_time (4000 с), то есть примерно раз в час при затяжной аварии.
Главный параметр здесь — maximal_queue_lifetime, по умолчанию 5d. Если основной сервер не поднимется за пять суток, резервный признает письма недоставляемыми и отправит отчёты отправителям; для самих отчётов действует отдельный bounce_queue_lifetime (тоже 5d). Для офиса с падающим электричеством пяти суток хватает с запасом, но если основной сервер стоит в помещении, куда в праздники никто не приедет, я поднимаю срок до недели. Бесконечно растягивать не стоит: письмо, пролежавшее две недели, отправителю уже бесполезно, а честный возврат хотя бы сообщит ему о проблеме. Когда основной сервер вернулся, ждать очередного цикла не нужно — очередь для домена можно протолкнуть сразу: postqueue -s работает для доменов из fast_flush_domains, а по умолчанию это как раз $relay_domains.
# срок жизни писем в очереди резервного MX
postconf -e maximal_queue_lifetime=7d
postconf -e bounce_queue_lifetime=7d
postfix reload

# основной сервер вернулся — отдать почту домена немедленно
postqueue -s kablukstyle.example

# что лежит в очереди и почему отложено
postqueue -p | head -40
Теперь про основной сервер — без его правильной реакции резервный MX работает вполсилы. Во-первых, на несуществующий адрес основной должен отвечать постоянной ошибкой 5xx, а не временной 4xx: при 450 резервный будет держать мусор в очереди все maximal_queue_lifetime, и отказы на входе резервного тут не спасут, если список получателей разошёлся с основным. Во-вторых, IP резервного MX на основном нужно исключить из грейлистинга, DNSBL и проверки SPF по подключающемуся хосту: для основного сервера резервный — это просто чужой хост, который пересылает письма с внешними адресами отправителей, и без исключения основной начнёт откладывать или отбивать законную почту после аварии. В-третьих, антиспам основного должен смотреть в заголовки Received, а не только на IP соединения, — спамеры любят слать сразу на резервный MX, рассчитывая обойти фильтры основного.
Отдельно проверьте фаервол основного: если на периметре порт 25 открыт только «для всех из интернета через балансировщик» или, наоборот, только для конкретного провайдера фильтрации, адрес резервного MX туда часто забывают. Симптом узнаваемый — после аварии очередь резервного не сливается, в postqueue -p висит «connection timed out» до основного хоста.
- maximal_queue_lifetime (5d по умолчанию) — сколько резервный держит письма до возврата; для офисов без круглосуточного доступа разумно 7d
- bounce_queue_lifetime — отдельный срок для самих отчётов о недоставке
- postqueue -s домен — немедленная отдача очереди после восстановления основного (домен должен входить в fast_flush_domains)
- Основной сервер: 5xx на неизвестных получателей, IP резервного — в исключениях грейлистинга, DNSBL и SPF-проверки по клиенту
- Фаервол основного пропускает порт 25 с адреса резервного MX
Откуда брать список адресов и как его не сломать
Руками список ведут ровно до первого нового сотрудника. Дальше он устаревает, и вы получаете вторую беду вместо первой: письма живому человеку отбиваются с 550 на входе, а отправитель видит «User unknown» и звонит вашему директору. Поэтому список надо синхронизировать с основного сервера по расписанию. Механика зависит от того, что у вас стоит: в Exchange — PowerShell-выгрузка всех SMTP-адресов получателей, в mailcow/Postfix+Dovecot — запрос к базе ящиков и алиасов, в связке с AD — выгрузка атрибута proxyAddresses. Формат на выходе один и тот же: адрес, заглушка.
Ключевая деталь, которую пропускают: выгрузка иногда возвращает пустоту или обрубок. Основной сервер лежал, WinRM отвалился, база не ответила — и скрипт бодро перезаписывает relay_recipients пятью строками или нулём строк. Дальше postmap, и резервный MX начинает отбивать 550 вообще всей компании, причём именно в тот момент, когда он единственный принимает почту. Поэтому в скрипте всегда стоит санитарная проверка: абсолютный минимум строк и порог просадки относительно текущего списка. Ниже — форма, которую я ставлю клиентам.
#!/bin/bash
set -euo pipefail

CUR=/etc/postfix/relay_recipients
NEW=$(mktemp)
trap 'rm -f "$NEW"' EXIT

# выгрузка с основного сервера (PowerShell/SQL/LDAP — подставьте своё)
/usr/local/sbin/fetch_recipients.sh > "$NEW"

new_cnt=$(wc -l < "$NEW")
old_cnt=$(wc -l < "$CUR")

# страховка 1: абсолютный минимум
if [ "$new_cnt" -lt 20 ]; then
    echo "relay_recipients: выгрузка слишком короткая ($new_cnt), правка отменена" >&2
    exit 1
fi

# страховка 2: список не мог усохнуть более чем на 20% за сутки
if [ "$new_cnt" -lt $(( old_cnt * 80 / 100 )) ]; then
    echo "relay_recipients: подозрительная просадка $old_cnt -> $new_cnt" >&2
    exit 1
fi

install -m 0644 "$NEW" "$CUR"
postmap "$CUR"
logger -t relay-recipients "обновлено: $old_cnt -> $new_cnt адресов"
Расписание — раз в час через cron или systemd timer, этого достаточно: свежесозданному ящику час задержки не критичен, а нагрузка нулевая. Оба отказных пути (exit 1) обязательно должны докладывать наружу — в Telegram, в почту, в Zabbix. Тихо падающий скрипт синхронизации хуже, чем его отсутствие: вы будете уверены, что список актуален, а он замёрз полгода назад. У себя я такие вещи вешаю на общий канал алертов и раз в квартал проверяю, что сообщение вообще доходит.
- Exchange: Get-Recipient -ResultSize Unlimited и разбор EmailAddresses по префиксу smtp:
- mailcow / Postfix+MySQL: выборка active-ящиков и алиасов из базы
- AD без Exchange: выгрузка proxyAddresses и mail через LDAP
- Обязательно: минимальный порог строк, порог просадки, алерт при отказе
Динамические проверки: LDAP, SQL и address verification
Статический файл — не единственный вариант. Если резервный сервер видит основной по сети (общий VPN, соседний сегмент), relay_recipient_maps можно повесить прямо на LDAP или SQL и проверять получателей в реальном времени. Выглядит красиво: никакой синхронизации, никакого устаревания. Практический минус ровно один и он весомый — резервный сервер начинает зависеть от доступности основного. А резервный сервер существует именно для сценария «основной недоступен». Отвалился канал в офис — и LDAP не отвечает, проверка не проходит, почта отбивается или откладывается. Поэтому я такой вариант ставлю только там, где источник справочника продублирован и живёт отдельно от почтовой системы (например, реплика LDAP на самом резервном хосте).
Второй динамический вариант — встроенная в Postfix верификация адресов: ограничение reject_unverified_recipient. Сервер сам делает пробный SMTP-диалог до основного MX, не доставляя письмо, и по ответу решает, принимать ли конверт. Настраивается тремя строчками, справочник не нужен. Но у метода есть честно описанные в документации ограничения, и их надо знать до внедрения.
smtpd_recipient_restrictions =
    permit_mynetworks,
    reject_unauth_destination,
    reject_unknown_recipient_domain,
    reject_unverified_recipient

# по умолчанию 450 (временный отказ); 550 — только когда доверяете результату
unverified_recipient_reject_code = 450
Ограничения такие. Первое: по умолчанию отказ временный (unverified_recipient_reject_code = 450), то есть отправитель будет ретраить, а вы — снова и снова проверять. Второе: первое обращение к новому адресу добавляет задержку до нескольких секунд, пока идёт проба, дальше работает кэш. Третье, и главное: при словарной атаке или при потоке backscatter ваши пробы превращаются в поток запросов к чужим и своим MTA, и удалённая сторона имеет полное право начать вас блокировать за слишком частые пробы — документация Postfix предупреждает об этом прямым текстом. Кэш верификации хранится в address_verify_map: в версиях до 3.11 это btree:$data_directory/verify_cache, начиная с 3.11 тип берётся из $default_cache_db_type.
Моя позиция без обиняков: для резервного MX небольшой компании статический список плюс ежечасная синхронизация лучше обоих динамических вариантов. Он работает, когда основной сервер лежит, не создаёт исходящего трафика, не зависит от чужих политик и диагностируется одной командой postmap -q. Верификацию адресов имеет смысл включать как дополнение — например, на входящем шлюзе перед несколькими разнородными внутренними серверами, где вести единый список нереально.
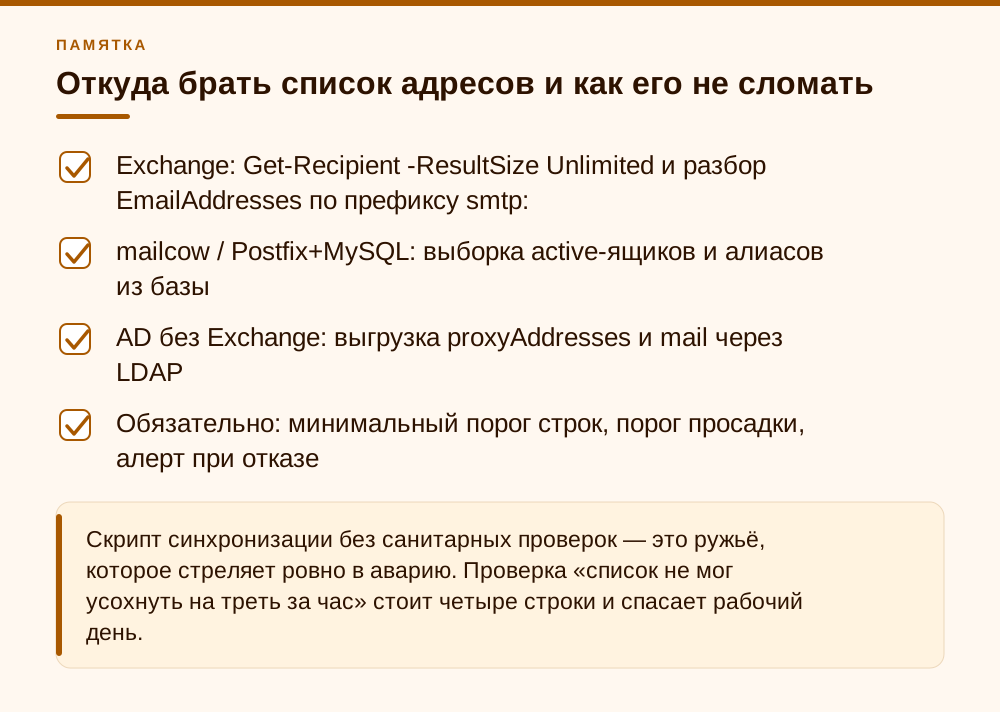
- Статический файл + cron — предсказуем, работает в аварии, требует скрипта синхронизации
- LDAP/SQL в реальном времени — всегда актуален, но завязан на доступность источника
- reject_unverified_recipient — не нужен справочник, но задержки, нагрузка и риск блокировки проб
Ошибки, которые я вижу из раза в раз
Первая и самая распространённая — запись вида @kablukstyle.example x. Формально это разрешено: подстановочный ключ для доменов, у которых нет списка получателей. Фактически это возвращает нас ровно в исходную точку, и документация Postfix формулирует это резче, чем я бы решился: такие домены «становятся источником backscatter-почты: Postfix принимает спам для несуществующих получателей и затем заваливает недоставленной почтой ни в чём не повинных людей». Единственная ситуация, где wildcard оправдан, — домен с настоящим catch-all на основном сервере, то есть когда любой адрес там действительно существует. Тогда возвратов не будет, потому что не будет «User unknown».
Вторая — ограничение permit_mx_backup в smtpd_recipient_restrictions. Идея заманчивая: «принимай почту для любого домена, который указал нас своим MX». На практике вы получаете сервер, чью политику приёма определяет любой человек в интернете, умеющий добавить MX-запись. Один такой стенд у клиента собирал почту для трёх посторонних доменов, о которых никто не знал. Документация postconf(5) сама предупреждает, что permit_mx_backup уязвим для злоупотребления, если не ограничен параметром permit_mx_backup_networks (по умолчанию пуст). Проще и надёжнее не использовать это ограничение вовсе и перечислять домены в relay_domains руками.
Третья группа — путаница в классах адресов. relay_recipient_maps проверяет получателей только в доменах из relay_domains. Если домен указан ещё и в mydestination, работает уже local_recipient_maps (по умолчанию proxy:unix:passwd.byname $alias_maps), если в virtual_alias_domains — virtual_alias_maps. Классика: администратор прописал домен и в mydestination, и в relay_domains, добавил relay_recipients, а отказов нет, потому что домен обрабатывается как локальный. Смотрите вывод postconf -n целиком, а не только ту строку, которую правили.
И мелочи, которые стоят дороже, чем кажется: забытый postmap после правки файла (сервер живёт по старой таблице); попытка «на всякий случай» выставить smtpd_reject_unlisted_recipient = no, хотя по умолчанию там yes и это правильное значение; отсутствие в списке псевдонимов и рассылочных групп — потом ищут, почему письма на sales@ не приходят только с внешних адресов и только когда офис в дауне; и хранение relay_recipients без версионирования, из-за чего после неудачной выгрузки некуда откатиться.
- `@domain x` — снова принимаем всё, только теперь осознанно (допустимо только при настоящем catch-all)
- permit_mx_backup без permit_mx_backup_networks — политику вашего сервера определяет посторонний человек через DNS
- Домен одновременно в mydestination и relay_domains — работает не та таблица
- Забытый postmap, выключенный smtpd_reject_unlisted_recipient, потерянные алиасы и группы
Что мониторить дальше и на что можно забить
После правки нужен не разовый триумф, а две-три метрики, которые скажут, что всё держится. Первая — длина очереди: postqueue -p | tail -1 даёт итоговую строку с количеством запросов и объёмом. На здоровом резервном MX между авариями там единицы сообщений, в аварию — линейный рост, после аварии — быстрый слив в ноль. Порог алерта я ставлю грубо: 200 сообщений вне окна аварии, и этого хватает. Вторая — количество отказов «User unknown in relay recipient table» в логе: их наличие подтверждает, что защита работает, а резкий обвал до нуля обычно означает, что кто-то сломал таблицу или Postfix перестал её видеть.
Третья, самая важная по последствиям, — исходящий поток от MAILER-DAEMON. Правильное значение — около нуля. Любой устойчивый ненулевой поток означает, что вы где-то всё ещё принимаете то, что не сможете доставить. Учтите при подсчёте, что строка from=<> в логе появляется и у входящих чужих возвратов, поэтому смотрите на исходящие: записи smtp-доставки для таких сообщений или сводку pflogsumm по bounced.
# длина очереди
postqueue -p | tail -1

# отказы за сегодня
grep -c 'User unknown in relay recipient table' /var/log/mail.log

# возвраты в логе (входящие и исходящие вместе — для грубой оценки)
grep -c 'from=<>' /var/log/mail.log

# сводка по дню, если стоит pflogsumm
pflogsumm -d today /var/log/mail.log | head -40
Теперь о том, на что можно спокойно забить. Единичные возвраты в логе — это норма: сотрудник ушёл в отпуск с переполненным ящиком, чужой сервер отдал 552 после приёма, письмо не влезло в лимит. Пока это единицы в сутки, никто вам ничего не предъявит. Не нужно и городить дополнительный слой фильтрации header_checks против backscatter, пока источник не устранён, — фильтр по заголовкам полезен для входящих чужих возвратов, но он не лечит вашу собственную рассылку недоставок. Сначала закрываем приём на несуществующие адреса, и только потом, если возвраты всё-таки приходят к вам, — разбираемся с ними на входе.
Отдельно про то, что переоценивают: страх «а вдруг мы отобьём важное письмо». Отобьёте только письмо на адрес, которого нет в вашем справочнике. Если справочник синхронизируется с основным сервером и в нём есть алиасы и группы, ложных отказов не будет вовсе — на моих стендах ложные отказы случались только там, где скрипт выгрузки был написан без санитарных проверок. Это управляемый риск, и лечится он тестом на живом адресе после каждой правки.
- Очередь: алерт при >200 сообщений вне окна аварии
- Отказы «User unknown in relay recipient table»: должны быть, обвал до нуля — повод посмотреть таблицу
- Исходящие from=<> (возвраты): целевое значение — около нуля
- Раз в квартал — контрольный тест: живой адрес принимается, выдуманный отбивается 550
Частые вопросы
Можно ли просто поставить `@mydomain.ru x` и не мучиться со списком?
Технически можно, но это возвращает вас в исходную точку: сервер снова принимает почту на любой несуществующий адрес и потом рассылает возвраты подделанным отправителям. Документация Postfix прямо называет такие домены источником backscatter. Единственный корректный случай для wildcard — когда на основном сервере настроен настоящий catch-all и любой адрес домена действительно существует.
Что будет, если файл relay_recipients окажется пустым или устареет?
Резервный MX начнёт отбивать письма живым сотрудникам кодом 550 «User unknown in relay recipient table», причём именно тогда, когда основной сервер лежит и вся почта идёт через резервный. Поэтому скрипт синхронизации обязан иметь санитарные проверки: минимальное число строк и запрет на резкую просадку списка, с алертом при отказе.
Нужно ли перезапускать Postfix после правки списка получателей?
Нет. После правки текстового файла обязательна команда postmap: Postfix читает индексированную таблицу, а не текст. По DATABASE_README для таблиц, которые использует smtpd(8), postfix reload не нужен — новый список подхватывается новыми процессами. Reload нужен при правке main.cf, и делать его стоит после `postfix check`.
Чем relay_recipient_maps отличается от local_recipient_maps?
Это разные классы адресов. local_recipient_maps проверяет получателей в доменах из mydestination (по умолчанию proxy:unix:passwd.byname $alias_maps), relay_recipient_maps — в доменах из relay_domains, virtual_alias_maps — в virtual_alias_domains. Частая ошибка: домен прописан и в mydestination, и в relay_domains, поэтому relay_recipients просто не участвует в проверке.
Сколько резервный MX будет хранить почту, если основной сервер лежит долго?
По умолчанию пять суток — это параметр maximal_queue_lifetime (5d). Пока срок не вышел, Postfix повторяет доставку с интервалом от 300 до 4000 секунд, после — возвращает письма отправителям. Для офиса, куда в длинные выходные никто не приедет, я выставляю 7d вместе с bounce_queue_lifetime, а после восстановления основного сервера сразу отдаю очередь командой postqueue -s с именем домена.
Стоит ли вместо списка включить проверку адресов через reject_unverified_recipient?
Для резервного MX — обычно нет. Верификация делает пробный SMTP-диалог до основного сервера, а резервный нужен как раз тогда, когда основной недоступен. Плюс задержки на первое обращение, дополнительная нагрузка при словарных атаках и риск попасть в блок у удалённых сторон за частые пробы. Статический список с ежечасной синхронизацией предсказуемее.
Сколько времени восстанавливается репутация домена после потока возвратов?
По моему опыту — от нескольких дней до двух-трёх недель, в зависимости от объёма и провайдера. У клиента из разбора Mail.ru перестал задерживать доставку через девять дней после того, как поток возвратов упал до нуля. Ускорить это конфигом нельзя: нужно устранить источник и подождать, при необходимости заведя обращение в постмастер-службу провайдера.
Источники
- Postfix Configuration Parameters — postconf(5), параметры relay_recipient_maps (default: empty; предупреждение о @domain и backscatter; таблица используется как список, значение не используется), relay_domains (default: Postfix ≥ 3.0 — empty, < 3.0 — $mydestination), smtpd_reject_unlisted_recipient (default: yes), unknown_relay_recipient_reject_code (default: 550), unverified_recipient_reject_code (default: 450), address_verify_map (Postfix ≥ 3.11 — $default_cache_db_type:$data_directory/verify_cache). https://www.postfix.org/postconf.5.html#relay_recipient_maps Там же: relay_transport (default: relay; приоритет transport_maps), maximal_queue_lifetime и bounce_queue_lifetime (default: 5d), minimal_backoff_time (300s), maximal_backoff_time (4000s), fast_flush_domains (default: $relay_domains), permit_mx_backup_networks (default: empty), default_database_type, default_cache_db_type (Postfix ≥ 3.11).
- Postfix ADDRESS_CLASS_README — Раздел «Relay domain class»: связка relay_domains / relay_recipient_maps / relay_transport (default transport: relay), поведение при пустом relay_recipient_maps и текст отказа «User unknown in relay recipient table». https://www.postfix.org/ADDRESS_CLASS_README.html
- Postfix STANDARD_CONFIGURATION_README — Раздел «Configuring Postfix as primary or backup MX host for a remote site»: пример main.cf с relay_recipient_maps = lmdb:/etc/postfix/relay_recipients, формат «user1@the.backed-up.domain.tld x», transport relay:[their.mail.host.tld] (скобки отключают MX-поиск), запрет указывать домен в mydestination/virtual_alias_domains/virtual_mailbox_domains, postmap после каждой правки, postconf -m. https://www.postfix.org/STANDARD_CONFIGURATION_README.html
- Postfix ADDRESS_VERIFICATION_README — Верификация получателей для релея: пример с reject_unverified_recipient, предупреждения о нагрузке на нижестоящие MTA, о риске блокировки за частые пробы и о задержке первого обращения. https://www.postfix.org/ADDRESS_VERIFICATION_README.html
- Postfix Announcements (версии на 2026 год) — Актуальная стабильная ветка Postfix — 3.11.x (3.11.0 — 5 марта 2026, 3.11.7 — 7 сентября 2026), поддерживаемая legacy-ветка — 3.10.x (3.10.14). Postfix 3.10.0 вышел 16 февраля 2025. https://www.postfix.org/announcements.html
- Postfix DATABASE_README — Раздел о правке таблиц на работающем сервере: после postmap для файлов, которые читает smtpd(8), postfix reload не требуется; reload может понадобиться только для долгоживущих процессов вроде trivial-rewrite(8) на нагруженном сервере. https://www.postfix.org/DATABASE_README.html
- Postfix postqueue(1) — Опция -s site: немедленная доставка почты, стоящей в очереди для указанного домена; домен должен подпадать под fast flush (flush(8)). https://www.postfix.org/postqueue.1.html