
Сервер выключили ночью: догонит ли systemd timer пропущенное задание
Ночью вырубили свет, сервер погас, а утром выясняется, что выгрузка не ушла, дамп не снялся и логи не поротировались. Дальше начинается гадание: догонит ли systemd пропущенное, сколько раз он это сделает и почему после включения задание стартует не сразу, а через непонятные полчаса. Разбираю на пальцах и на конфигах: что реально делает Persistent=true, чего он не делает никогда, где систему подводит не systemd, а ваш собственный скрипт, и как я настраиваю ночные задания, чтобы утренних сюрпризов не было.
Никакой очереди пропущенных заданий не существует
Звонок в 10:15 от администратора студии: «На сайте вчерашнее расписание, а девочки на ресепшене продают абонементы по старым ценам». Захожу на сервер — аптайм 47 минут. Ночью в здании отключали ввод, ИБП отработал своё и корректно погасил машину. Выгрузка расписания и прайса, которая должна была уйти в 03:30, не ушла. И вот здесь у половины админов включается надежда: сейчас систему подняли, она сама всё нагонит. Не нагонит. По умолчанию — вообще ничего.
Таймер в systemd — это не запись в базе с расписанием и не список заданий на диске. Это unit, который живёт в памяти первого процесса и держит открытый timerfd. Пока PID 1 работает, ядро в нужную секунду тычет его файловым дескриптором, и systemd активирует связанный сервис. Выключили питание — нет процесса, нет дескриптора, нет тыка. Событие не откладывается в сторонку и не встаёт в очередь, оно просто не происходит. Ровно так же ведёт себя классический cron: если демон не работал в 03:30, строчка из crontab в 03:30 не выполнится никогда.
Единственный механизм в systemd, который умеет заметить «пока меня не было, я должен был отработать» — это Persistent=. И он не включён по умолчанию. Проверьте прямо сейчас свои самописные таймеры: если в секции [Timer] строчки Persistent=true нет, то любое выключение сервера в момент срабатывания означает молча пропущенный запуск. Никакой ошибки в журнале при этом не будет — писать некому.
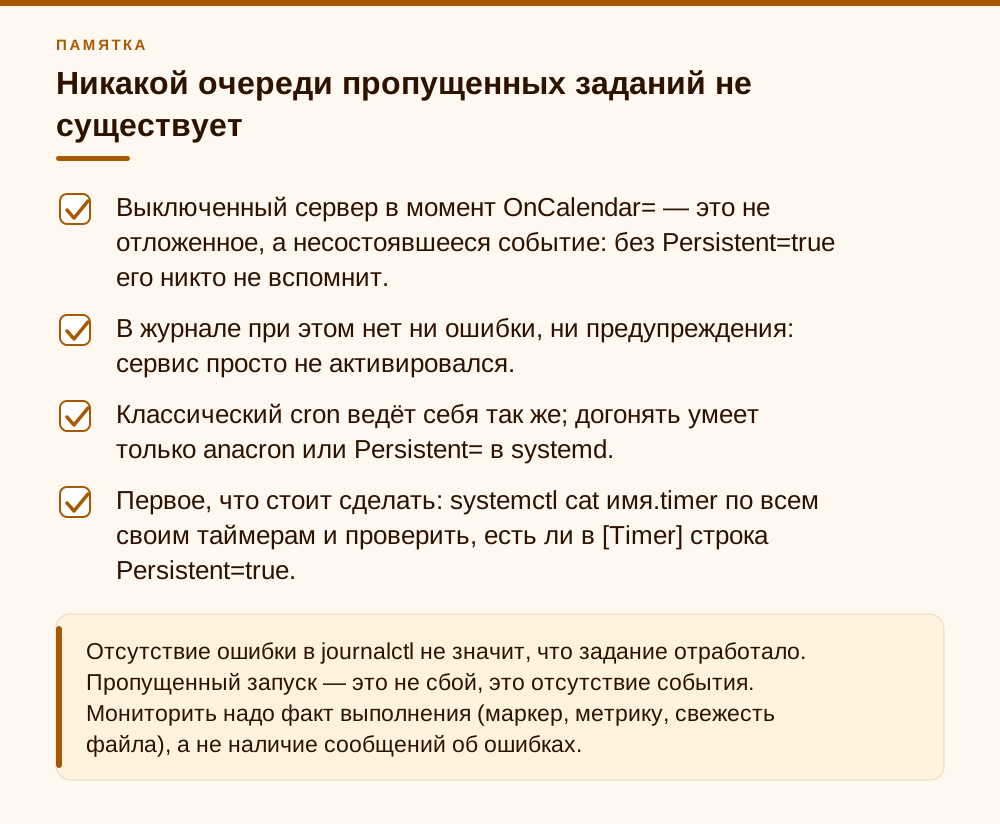
- Выключенный сервер в момент OnCalendar= — это не отложенное, а несостоявшееся событие: без Persistent=true его никто не вспомнит.
- В журнале при этом нет ни ошибки, ни предупреждения: сервис просто не активировался.
- Классический cron ведёт себя так же; догонять умеет только anacron или Persistent= в systemd.
- Первое, что стоит сделать: systemctl cat имя.timer по всем своим таймерам и проверить, есть ли в [Timer] строка Persistent=true.
Что Persistent=true делает — и чего он не делает
Формулировка в systemd.timer(5) короткая и предельно точная (опция существует с systemd 212): если опция включена, время последнего срабатывания сервиса сохраняется на диск; при активации таймера сервис запускается немедленно, если он должен был бы сработать хотя бы один раз за время, пока таймер был неактивен. Ключевые слова — «хотя бы один раз». Не «столько раз, сколько пропустил». Пропустили три ночи подряд на новогодних — получите один догоняющий прогон, а не три. Для выгрузки актуального расписания и свободных мест это ровно то, что нужно. Для задания, которое обязано отработать за каждый календарный день отдельно, это ловушка, и решать её надо не в systemd (об этом ниже).
Вторая половина той же фразы из мана: настройка имеет эффект только для таймеров, сконфигурированных через OnCalendar=. Если у вас OnBootSec=, OnUnitActiveSec= или OnStartupSec= — строчка Persistent=true будет молча проигнорирована. Никакого предупреждения при systemctl daemon-reload вы не увидите, юнит загрузится как валидный. Это, пожалуй, самая частая причина фразы «я же поставил Persistent, а оно не догоняет».
Где systemd хранит отметку времени. Для системного менеджера это /var/lib/systemd/timers/, для пользовательского — $XDG_DATA_HOME/systemd/timers/, а если переменная не задана, то ~/.local/share/systemd/timers/. Имя файла — stamp-имя_юнита.timer. Файлы нулевого размера: в исходниках timer.c момент срабатывания записывается в mtime через touch, а при активации таймера читается обратно через stat. Так выглядит каталог на типовой Ubuntu 24.04 (systemd 255):
$ ls -la --time-style=full-iso /var/lib/systemd/timers/
-rw-r--r-- 1 root root 0 2026-03-25 06:41:12 stamp-apt-daily-upgrade.timer
-rw-r--r-- 1 root root 0 2026-03-25 11:02:37 stamp-apt-daily.timer
-rw-r--r-- 1 root root 0 2026-03-25 00:00:04 stamp-dpkg-db-backup.timer
-rw-r--r-- 1 root root 0 2026-03-22 03:10:51 stamp-e2scrub_all.timer
-rw-r--r-- 1 root root 0 2026-03-25 00:23:40 stamp-logrotate.timer
-rw-r--r-- 1 root root 0 2026-03-25 00:17:09 stamp-man-db.timer

# cat бесполезен, файл пустой. Смотреть надо mtime:
$ stat -c '%n %y' /var/lib/systemd/timers/stamp-logrotate.timer
/var/lib/systemd/timers/stamp-logrotate.timer 2026-03-25 00:23:40.118503211 +0300
Обратите внимание: stamp-файлы появляются только у тех таймеров, у которых в юните прописан Persistent=true и которые хотя бы раз сработали — в Ubuntu это, например, logrotate, apt-daily, apt-daily-upgrade, man-db, dpkg-db-backup, e2scrub_all. Это удобный способ за секунду понять, какие таймеры на машине умеют догонять, а какие нет. Сбросить отметку штатно можно командой systemctl clean --what=state имя.timer: verb clean появился в systemd 243, и в NEWS того релиза прямо сказано, что он удаляет состояние таймеров с Persistent=. Ман отдельно просит делать это перед удалением таймер-юнита, иначе stamp-файл так и останется лежать. Руками удалять файл тоже работает, но лучше не приучаться.
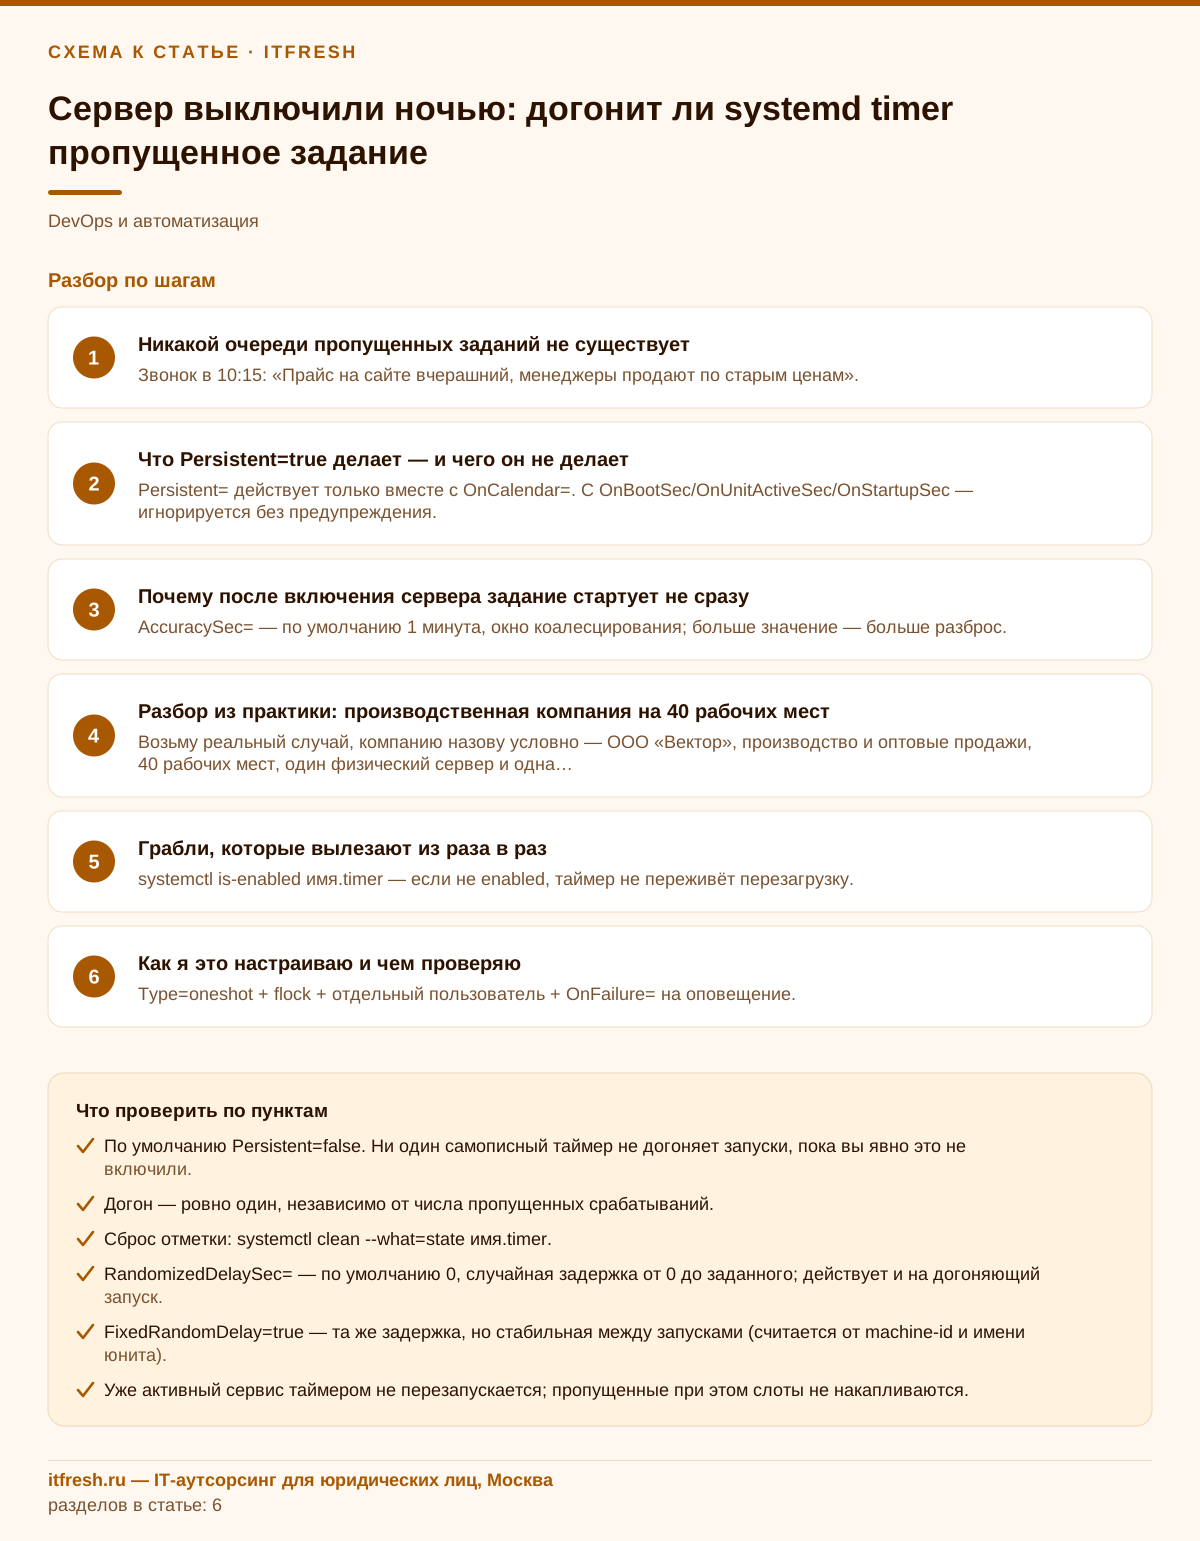
- Persistent= действует только вместе с OnCalendar=. С OnBootSec/OnUnitActiveSec/OnStartupSec — игнорируется без предупреждения.
- По умолчанию Persistent=false. Ни один самописный таймер не догоняет запуски, пока вы явно это не включили.
- Догон — ровно один, независимо от числа пропущенных срабатываний.
- Отметка времени: /var/lib/systemd/timers/stamp-*.timer (система), $XDG_DATA_HOME/systemd/timers/ или ~/.local/share/systemd/timers/ (пользователь). Файлы нулевой длины, время — в mtime.
- Сброс отметки: systemctl clean --what=state имя.timer (systemd 243+), в том числе перед удалением юнита.
Почему после включения сервера задание стартует не сразу
Второй по частоте вопрос: сервер подняли в 09:00, Persistent стоит, а задание дёрнулось в 09:41 — почему? Ответ в том же мане, сразу за фразой про Persistent: «Such triggering is nonetheless subject to the delay imposed by RandomizedDelaySec=» — догоняющее срабатывание всё равно подчиняется случайной задержке. То есть систему подняли, systemd понял, что запуск был пропущен, но не побежал сразу, а честно отсчитал случайную величину от 0 до вашего значения.
Самая яркая иллюстрация — штатный apt-daily.timer в Debian и Ubuntu: OnCalendar=*-*-* 6,18:00, RandomizedDelaySec=12h и Persistent=true. Это сделано, чтобы тысячи машин не долбили зеркала одновременно, и для обновления пакетов абсолютно правильно. Но если вы скопировали этот шаблон под свою ночную выгрузку, не глядя, то получите догоняющий прогон в произвольный момент в течение полусуток после включения — и будете искать мистику. У logrotate.timer разброс скромнее: в актуальном апстримном юните стоит RandomizedDelaySec=1h, а в старых сборках пакета встречается AccuracySec=1h — в любом случае сдвиг до часа. Что именно стоит у вас, покажет systemctl cat logrotate.timer.
По умолчанию AccuracySec=1min, RandomizedDelaySec=0. Если вам нужна предсказуемость — задавайте оба явно. Есть ещё FixedRandomDelay=true: он делает случайную задержку детерминированной, вычисляя её из machine-id, идентификатора пользователя и имени юнита. Задержка остаётся «случайной» в масштабе парка машин, но одинаковой от запуска к запуску на конкретном сервере. Опция появилась в systemd 247 и действует, только если RandomizedDelaySec= больше нуля. В systemd 258 добавили ещё RandomizedOffsetSec= — стабильное случайное смещение самого календарного расписания, только для OnCalendar=, которое сохраняет периодичность и после перезапуска менеджера. На одиночном сервере смысла в этом немного, на парке из полусотни — вещь полезная.
И третий источник задержки, про который забывают: порядок старта. Таймер-юниты по умолчанию упорядочены после sysinit.target и до timers.target, календарные дополнительно получают After=time-set.target и time-sync.target. Но time-sync.target реально ждёт синхронизации часов только если включён systemd-time-wait-sync.service, а сеть, СУБД и сетевые шары таймер не ждёт вообще. Догоняющий запуск случается очень рано: сеть может быть ещё не поднята, PostgreSQL ещё не принимает соединения, шара не примонтирована. Скрипт отработает, честно упадёт с ошибкой подключения, и в журнале вы увидите не «догнали», а «Job failed». Формально таймер сделал всё правильно. Лечится это зависимостями в самом сервисе и ретраями.
Отдельная история — одновременный старт после долгого простоя. Если на машине пять Persistent-таймеров с ночным расписанием, после включения все пять решат, что пропустили срабатывание, и активируются практически в одну секунду: дамп базы, выгрузка на сайт, logrotate, man-db, apt. На слабой виртуалке это пиковая нагрузка на диск ровно в момент, когда люди пришли на работу и открывают программы. Я разношу тяжёлые задания: каждому свой небольшой RandomizedDelaySec=, а те, что мешают друг другу, разделяю через After= между сервисами или общий flock.
- AccuracySec= — по умолчанию 1 минута, окно коалесцирования; больше значение — больше разброс.
- RandomizedDelaySec= — по умолчанию 0, случайная задержка от 0 до заданного; действует и на догоняющий запуск.
- FixedRandomDelay=true — та же задержка, но стабильная между запусками (считается от machine-id и имени юнита).
- Ранний старт после загрузки — добавляйте Wants=/After=network-online.target, After= для СУБД и ExecStartPre с проверкой готовности.
- После простоя все Persistent-таймеры догоняются разом — разносите тяжёлые задания задержкой, flock или порядком между сервисами.
- RandomizedOffsetSec= (systemd 258+) — стабильное смещение календарного расписания, если нужен разброс по парку без плавающей задержки.
Разбор из практики: танцевальная студия на 25 рабочих мест
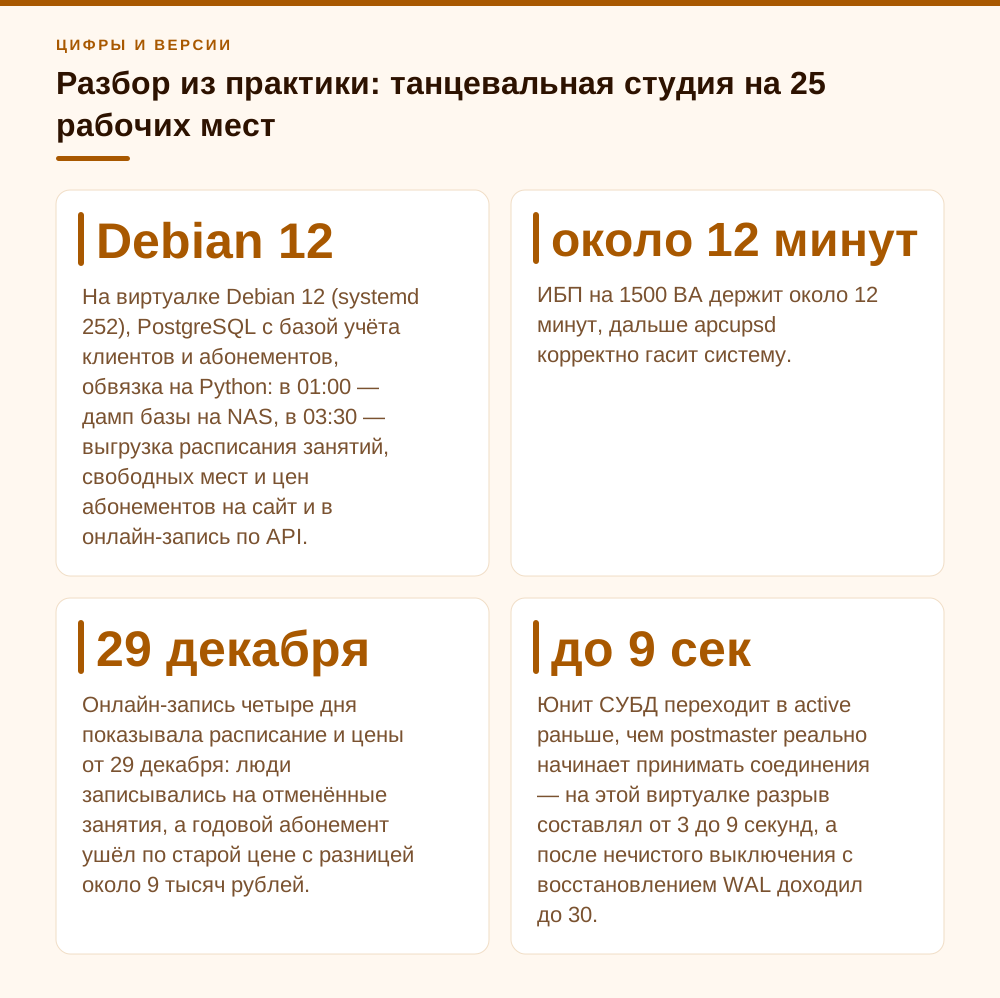
Возьму случай, клиента назову условно — танцевальная студия «Соло и пара»: два зала, ресепшен, тренеры, администраторы и бухгалтерия, всего 25 рабочих мест, один небольшой сервер и одна виртуалка под Linux. На виртуалке Debian 12 (systemd 252), PostgreSQL с базой учёта клиентов и абонементов, обвязка на Python: в 01:00 — дамп базы на NAS, в 03:30 — выгрузка расписания занятий, свободных мест и цен абонементов на сайт и в онлайн-запись по API. Арендодатель раз в квартал вырубает ввод для обслуживания щитовой, плюс за зиму было три незапланированных отключения. ИБП на 1500 ВА держит около 12 минут, дальше apcupsd корректно гасит систему.
Что я застал при подключении к обслуживанию. Оба таймера — с OnCalendar=*-*-* 03:30:00 и OnCalendar=*-*-* 01:00:00, Persistent нигде нет. За новогодние праздники сервер простоял выключенным трое суток. Онлайн-запись четыре дня показывала расписание и цены от 29 декабря: люди записывались на отменённые занятия, а годовой абонемент ушёл по старой цене с разницей около 9 тысяч рублей. Вскрылось, когда в зал на одно место пришли трое. Дамп за эти дни, разумеется, тоже не снимался, но на NAS был недельный retention, и последняя копия оказалась живой.
Первый шаг был очевиден — Persistent=true на оба таймера. Дальше начались нюансы, ради которых я этот кейс и вспоминаю. Ловушка номер один: After=postgresql.service оказалось недостаточно. Юнит СУБД переходит в active раньше, чем postmaster реально начинает принимать соединения — на этой виртуалке разрыв составлял от 3 до 9 секунд, а после нечистого выключения с восстановлением WAL доходил до 30. Догоняющий запуск влетал в этот промежуток и падал. Добавил ExecStartPre с pg_isready и ретраями плюс Restart=on-failure с RestartSec=30 и ограничением попыток.
Ловушка номер два оказалась дороже и не имеет к systemd никакого отношения. Скрипт выгрузки формировал имя файла по текущей дате, а данные забирал за «вчера» относительно момента запуска. Пока он стартовал в 03:30, всё сходилось. Догоняющий прогон 3 января в 09:41 создал файл с датой 3 января, но с данными за 2-е — и сайт принял его как актуальный, показав вчерашние свободные места. То есть Persistent честно починил расписание и ровно этим замаскировал битую логику. Переписали: скрипт больше не смотрит на «сейчас», он читает свой собственный маркер последней успешной выгрузки в БД и работает от него. Итог за восемь месяцев наблюдения — четыре отключения, все догнаны; догоняющий прогон стартует в пределах 1–3 минут после загрузки, с учётом RandomizedDelaySec=2min.
Вот как выглядит связка после переделки. Ничего экзотического, но каждая строчка тут появилась не просто так:
# /etc/systemd/system/studio-export.service
[Unit]
Description=Выгрузка расписания и абонементов на сайт
Wants=network-online.target
After=network-online.target postgresql.service

[Service]
Type=oneshot
User=exporter
ExecStartPre=/usr/bin/timeout 120 /bin/sh -c 'until pg_isready -q -h 127.0.0.1; do sleep 3; done'
ExecStart=/usr/bin/flock -n /run/lock/studio-export.lock /opt/export/run.sh
TimeoutStartSec=1800
Restart=on-failure
RestartSec=30
OnFailure=notify-fail@%n.service
# /etc/systemd/system/studio-export.timer
[Unit]
Description=Ночная выгрузка расписания (03:30)
[Timer]
OnCalendar=*-*-* 03:30:00
Persistent=true
AccuracySec=1min
RandomizedDelaySec=2min
Unit=studio-export.service
[Install]
WantedBy=timers.target- Persistent=true на оба таймера — чтобы выключение ночью не означало молча пропущенную выгрузку.
- After=postgresql.service недостаточно: готовность СУБД проверяется pg_isready в ExecStartPre с таймаутом.
- Restart=on-failure с RestartSec=30 закрывает случай, когда догон всё-таки влетел в неготовую сеть или базу.
- Скрипт работает от маркера последней успешной выгрузки в БД, а не от текущей даты — догон в 09:41 даёт те же данные, что штатный прогон в 03:30.
- flock не даёт ручному запуску администратора и догону таймера пересечься.
Грабли, которые вылезают из раза в раз
Первое место с большим отрывом — systemctl start вместо systemctl enable --now. Таймер запускается, list-timers его показывает, всё прекрасно работает ровно до перезагрузки. После неё юнит не поднимается, потому что симлинка в timers.target.wants нет. Проверяется одной командой: systemctl is-enabled имя.timer. Если ответ static или disabled — вы не пережили следующий ребут.
Второе — поведение, когда сервис ещё работает. В мане это записано прямо: если юнит, который надо активировать, в момент срабатывания таймера уже активен, он не перезапускается, а просто остаётся работать. То есть тяжёлая выгрузка, которая идёт четыре часа при часовом расписании, не будет запущена трижды параллельно — но и пропущенные слоты потом никто не отработает. В systemd 257 (релиз декабря 2024; в Debian 13 — ветка 257.x, в Debian 12 и Ubuntu 24.04 опции ещё нет) появился DeferReactivation= для календарных таймеров: со значением true следующее срабатывание планируется от момента, когда сервис перешёл в неактивное состояние, а не от времени последнего запуска. Полезно ровно тогда, когда задание регулярно вылезает за свой интервал.
Третье — клоны виртуалок и восстановление из бэкапа. Стенд подняли из копии месячной давности, systemd прочитал stamp-файлы, увидел, что все календарные таймеры пропустили срабатывания, и дружно догнал их все сразу. На тестовой машине, которая по недосмотру ходила в боевую БД, это была весёлая ночь. Перед включением клона в сеть — systemctl clean --what=state на все Persistent-таймеры либо просто маскирование ненужных юнитов. То же касается контейнеров и машин, где /var/lib вынесен на tmpfs: stamp-файл там не переживает перезагрузку, и Persistent превращается в декорацию.
Четвёртое — пользовательские таймеры. Они хранят stamp в домашнем каталоге, но живут внутри пользовательского менеджера, который по умолчанию завершается вместе с последней сессией. Без loginctl enable-linger имя_пользователя ночью там не работает ничего. И пятое, мелкое, но обидное: OnCalendar считается в локальном часовом поясе машины. Смена TZ, перенос виртуалки на площадку в другом часовом поясе, страны с переводом стрелок — всё это сдвигает ваши задания. Перед сдачей работы я всегда прогоняю выражение через systemd-analyze calendar, там сразу видно и локальное время, и UTC.
- systemctl is-enabled имя.timer — если не enabled, таймер не переживёт перезагрузку.
- Уже активный сервис таймером не перезапускается; пропущенные при этом слоты не накапливаются.
- Клон/бэкап со старыми stamp-файлами = шторм догоняющих запусков при первом же старте.
- /var/lib на tmpfs или контейнер без persistent state — Persistent не работает в принципе.
- Пользовательские таймеры требуют loginctl enable-linger.
- OnCalendar — локальное время; проверять через systemd-analyze calendar.
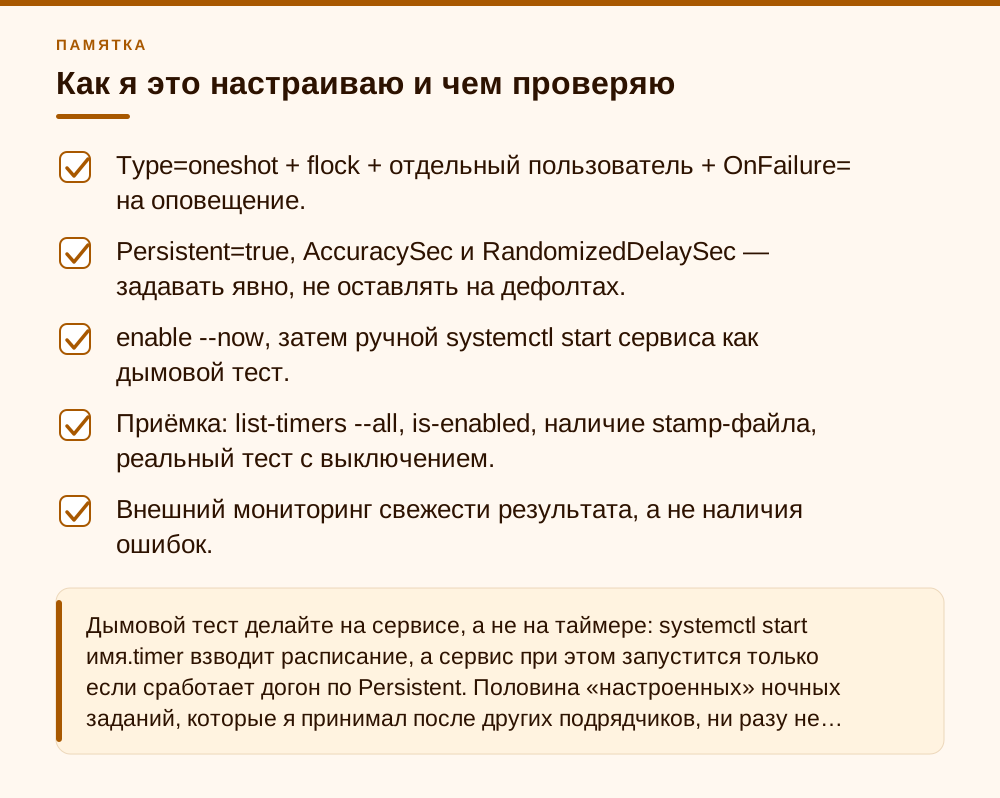
Как я это настраиваю и чем проверяю
Порядок у меня один и тот же для любого клиента. Сначала сервис — обязательно Type=oneshot, отдельный непривилегированный пользователь, flock от параллельных запусков, TimeoutStartSec с запасом и OnFailure= на юнит-оповещалку, которая шлёт сообщение в чат. Потом таймер — OnCalendar, Persistent=true, явные AccuracySec и RandomizedDelaySec. Потом enable --now. И только потом — ручной прогон самого сервиса, чтобы убедиться, что он вообще работает: systemctl start имя.service, а не таймера.
Дальше — приёмка. Смотрю systemctl list-timers --all: там колонки NEXT/LEFT и LAST/PASSED, из них сразу видно, когда таймер сработает и когда срабатывал в прошлый раз. После первого срабатывания проверяю появление stamp-файла — это подтверждение, что Persistent действительно взялся. И обязательно делаю боевой тест на выключение: гашу машину до времени срабатывания, поднимаю после, смотрю журнал.
# приёмка
systemctl enable --now studio-export.timer
systemctl list-timers --all | grep studio-export
systemctl is-enabled studio-export.timer
stat -c '%n %y' /var/lib/systemd/timers/stamp-studio-export.timer

# проверка расписания до запуска
systemd-analyze calendar --iterations=5 '*-*-* 03:30:00'

# что реально произошло ночью
journalctl -u studio-export.service --since '-2 days' --no-pager
Отдельно про мониторинг. Я не полагаюсь на то, что systemd сам расскажет о проблеме — он расскажет только про упавший сервис, но не про сервис, который не запускался. Поэтому в связке всегда есть внешняя проверка свежести результата: возраст выгруженного файла, отметка в БД, метрика в Zabbix. Правило простое — если результат старше полутора интервалов расписания, приходит алерт. Это ловит и выключенный сервер, и снятый enable, и молча сдохший скрипт, и случай, когда кто-то замаскировал юнит и забыл.
- Type=oneshot + flock + отдельный пользователь + OnFailure= на оповещение.
- Persistent=true, AccuracySec и RandomizedDelaySec — задавать явно, не оставлять на дефолтах.
- enable --now, затем ручной systemctl start сервиса как дымовой тест.
- Приёмка: list-timers --all, is-enabled, наличие stamp-файла, реальный тест с выключением.
- Внешний мониторинг свежести результата, а не наличия ошибок.
Когда Persistent — не то, что вам нужно
Скажу прямо: есть класс задач, где Persistent бесполезен, и делать вид, что systemd их решает, нечестно. Если задание обязано отработать за каждый пропущенный период по отдельности — суточные начисления, посменные реестры, помесячная нарезка данных, — один догоняющий прогон вас не спасёт. Тут нужен курсор внутри самого приложения: таблица с отметкой «последний обработанный период», и скрипт в цикле догоняет всё, что отстало, за один запуск. systemd в этой схеме отвечает только за то, чтобы скрипт вообще стартовал; за полноту данных отвечает ваша логика. Никакой настройкой юнита это не заменяется.
Обратная ситуация: задание тяжёлое, а сервер мог простоять несколько суток. Догон в 09:41 положит СУБД в разгар рабочего дня — и вы получите не помощь, а вторую аварию поверх первой. Тут я либо снимаю Persistent совсем (пусть отработает следующей ночью штатно), либо оставляю его, но добавляю в сам скрипт проверку: если сейчас рабочее время — выйти с кодом 0 и ничего не делать. Второй вариант мне нравится больше, потому что решение остаётся в одном месте и видно в коде, а не спрятано в юните.
И честно про приоритеты. Если сервер выключается каждую ночь — это не задача для systemd, это задача для электрики. Persistent тут маскирует симптом: данные вроде бы догоняются, а параллельно у вас нечистые выключения СУБД, износ дисков и рано или поздно битая база. Сначала нормальный ИБП с корректным shutdown и связью с сервером, потом уже тонкости расписания. С другой стороны, риск ночных отключений часто переоценивают: если ИБП живой и гасит систему штатно, а задания идемпотентны, то Persistent=true закрывает вопрос практически полностью, и городить самописный планировщик поверх systemd незачем.
На что можно спокойно забить. WakeSystem= будит систему только из suspend, и то если железо это поддерживает; обратно усыплять машину он не станет, а выключенный по питанию сервер не включит вовсе. На сервере, который не уходит в сон, опция бесполезна, а для включения после отключения света нужен режим «после восстановления питания — включиться» в BIOS/iLO/iDRAC. FixedRandomDelay= имеет смысл на парке от нескольких десятков машин, на одиночном сервере это украшение. Тонкая настройка AccuracySec ради экономии энергии — не ваша задача вообще, поставьте 1min и забудьте. А вот RemainAfterElapse (по умолчанию true, таймер остаётся загруженным и его состояние видно после срабатывания) трогать не надо: именно благодаря этому systemctl list-timers показывает вам колонку LAST, без которой отлаживать ночные задания невозможно.
- Нужна обработка каждого пропущенного периода — курсор в приложении, а не Persistent.
- Тяжёлое задание + долгий простой — либо без Persistent, либо с проверкой рабочего времени внутри скрипта.
- Регулярные отключения питания лечатся ИБП, а не настройками таймера.
- WakeSystem, FixedRandomDelay на одиночном сервере и микронастройка AccuracySec — можно не трогать.
Частые вопросы
Если сервер был выключен трое суток, сколько раз отработает задание с Persistent=true?
Ровно один раз. В systemd.timer(5) сказано: сервис запускается немедленно, если он должен был бы сработать хотя бы один раз за время неактивности таймера. Количество пропущенных срабатываний не учитывается и очередь не накапливается. Если вам нужна обработка каждого пропущенного дня отдельно, ведите отметку последнего обработанного периода внутри самого приложения и догоняйте циклом в одном запуске.
Почему Persistent=true не сработал на моём таймере?
Три самые частые причины. Первая: у таймера не OnCalendar=, а OnBootSec= или OnUnitActiveSec= — тогда Persistent игнорируется без всякого предупреждения. Вторая: таймер запущен через systemctl start, но не enable, и после перезагрузки просто не поднялся. Третья: каталог /var/lib/systemd/timers не переживает перезагрузку (tmpfs, контейнер без сохранения состояния), поэтому stamp-файла нет и сравнивать systemd не с чем.
Задание после включения сервера запустилось спустя полчаса — это нормально?
Да, если у вас задан RandomizedDelaySec. Догоняющий запуск подчиняется той же случайной задержке, что и обычный — это прямо написано в мане. Проверьте значение через systemctl cat имя.timer: например, у штатного apt-daily.timer в Debian и Ubuntu стоит RandomizedDelaySec=12h, у logrotate.timer — до часа. Плюс AccuracySec (по умолчанию 1 минута) добавляет своё окно. Для бизнес-заданий задавайте оба параметра явно и небольшими значениями.
Как посмотреть, когда таймер срабатывал в последний раз?
Команда systemctl list-timers --all показывает колонки NEXT/LEFT и LAST/PASSED по всем таймерам. Точную отметку для Persistent-таймера даёт stat по stamp-файлу: stat -c '%n %y' /var/lib/systemd/timers/stamp-имя.timer. Сам файл нулевой длины, читать его через cat бессмысленно — время хранится в атрибутах файла. Фактический результат работы смотрите через journalctl -u имя.service.
Чем systemd timer лучше cron для ночных заданий?
Главное отличие как раз в Persistent= — cron пропущенный запуск не догоняет никак, для этого нужен отдельный anacron. Плюс у таймера есть журналирование в journald с привязкой к юниту, зависимости от других служб (можно честно дождаться СУБД и сети), ограничения по ресурсам через cgroups, OnFailure= для оповещений и случайная задержка из коробки. Минус — многословнее: вместо одной строки в crontab нужны два файла.
Что делать со stamp-файлами при клонировании виртуалки?
Обязательно чистить до того, как клон получит доступ к боевым данным. Иначе при первом старте systemd увидит, что все календарные таймеры пропустили срабатывания, и запустит их разом. Штатный способ — systemctl clean --what=state имя.timer по каждому Persistent-таймеру (verb clean доступен с systemd 243). Ненужные на клоне задания лучше сразу замаскировать через systemctl mask.
Не положит ли сервер одновременный догон всех заданий после долгого простоя?
Может. Все Persistent-таймеры, пропустившие срабатывание, активируются при загрузке почти одновременно, и штатные logrotate, man-db и apt добавятся к вашим дампам и выгрузкам. Тяжёлым заданиям задайте разные небольшие RandomizedDelaySec=, пересекающиеся по ресурсам сервисы упорядочьте через After= или общий flock, а для задания, которое нельзя запускать днём, добавьте проверку рабочего времени в сам скрипт.
Источники
- systemd.timer(5), официальный man — Секции Persistent=, OnCalendar=, RandomizedDelaySec=, FixedRandomDelay=, AccuracySec=, RemainAfterElapse=, Unit= и примечание о том, что уже активный юнит не перезапускается. Ветка main. https://github.com/systemd/systemd/blob/main/man/systemd.timer.xml
- systemd.timer(5), Debian Manpages — Та же страница руководства в редакции Debian (unstable), формулировка про эффект Persistent только для OnCalendar= и значения по умолчанию (Persistent=false, AccuracySec=1min, RandomizedDelaySec=0). https://manpages.debian.org/unstable/systemd/systemd.timer.5.en.html
- systemctl(1), verb clean — systemctl clean --what=state для удаления stamp-файла таймера с Persistent=; verb clean появился в systemd 243. https://www.freedesktop.org/software/systemd/man/latest/systemctl.html
- systemd NEWS, релиз 257 — Введение опции DeferReactivation= для календарных .timer-юнитов (декабрь 2024). https://github.com/systemd/systemd/releases/tag/v257
- Fedora Magazine — Systemd Timers for Scheduling Tasks — Обзорная статья по таймерам: пример .timer с Persistent=true для догона пропущенных из-за выключения запусков, разбор list-timers. https://fedoramagazine.org/systemd-timers-for-scheduling-tasks/
- Debian: версии пакета systemd — systemd 252.x в Debian 12 bookworm и 257.x в Debian 13 trixie — ориентир по доступности DeferReactivation=. https://packages.debian.org/trixie/systemd
- systemd NEWS, релиз 243 — Новый verb systemctl clean, в том числе для удаления состояния таймеров с Persistent=. https://github.com/systemd/systemd/blob/main/NEWS
- systemd, исходник src/core/timer.c — Пути stamp-файлов (/var/lib/systemd/timers/stamp-*, $XDG_DATA_HOME/systemd/timers, ~/.local/share/systemd/timers) и хранение времени срабатывания в mtime. https://github.com/systemd/systemd/blob/main/src/core/timer.c
- logrotate: examples/logrotate.timer — Апстримный таймер logrotate: OnCalendar=daily, RandomizedDelaySec=1h, Persistent=true. https://github.com/logrotate/logrotate/blob/main/examples/logrotate.timer