
systemctl stop отработал, а порт занят: разбираемся с KillMode и сигналами systemd
Знакомая картина: `systemctl stop` отработал молча, `systemctl status` рисует inactive (dead), а следующий `start` падает с «Address already in use». Или хуже — новая версия сервиса поднялась, а рядом продолжает жить старая: разгребает ту же очередь, пишет в ту же базу, и в отчётах у клиента цифры вперемешку. В девяти случаях из десяти виноват KillMode= — либо он выставлен в process, либо systemd просто не считает главным тот процесс, который вы думаете. Разбираю, что реально делает каждое из четырёх значений, как за минуту доказать, что процессы остались в cgroup службы, какие тайм-ауты и сигналы за этим стоят, и какой набор директив я по умолчанию кладу в юнит клиентского сервиса.
«Служба остановлена» — а кто тогда держит порт
Первое, от чего надо отучиться, — верить строчке в статусе. systemctl status показывает состояние ЮНИТА, а не состояние контрольной группы. «inactive (dead)» означает ровно одно: systemd считает работу законченной — главный процесс вышел, команды ExecStop= отработали, тайм-ауты не сработали. Живут ли при этом ещё пятнадцать процессов в cgroup службы, менеджер вам в этой строчке не скажет. При KillMode=process он вообще не обязан ими интересоваться.
Поэтому диагностику я начинаю не с чтения файла юнита, а с трёх команд. Они занимают полминуты и сразу разводят два принципиально разных диагноза.
# 1. Кто РЕАЛЬНО слушает порт (PID и имя процесса)
ss -ltnp 'sport = :8080'

# 2. Что осталось в контрольной группе службы (cgroup v2)
systemd-cgls -u bindery-api.service
cat /sys/fs/cgroup/system.slice/bindery-api.service/cgroup.procs

# 3. Как юнит настроен ПО ФАКТУ, а не как написано в .service-файле
systemctl show bindery-api.service \
  -p Type -p KillMode -p KillSignal -p SendSIGKILL -p FinalKillSignal \
  -p TimeoutStopUSec -p PIDFile -p ControlGroup
Дальше развилка. Если ss показал живой PID — берём его и смотрим cat /proc/<PID>/cgroup: если там путь вида /system.slice/bindery-api.service, поздравляю, это ваш беглец, и дальше по статье. А вот если ss -ltnp не показывает вообще никого, а bind всё равно падает — это НЕ висящие воркеры. Это либо сокет в TIME_WAIT и приложение не выставляет SO_REUSEADDR, либо порт занял совсем другой юнит (проверьте .socket-юниты), либо вы смотрите не тот сетевой namespace. В KillMode тут лезть незачем — сэкономите себе вечер.
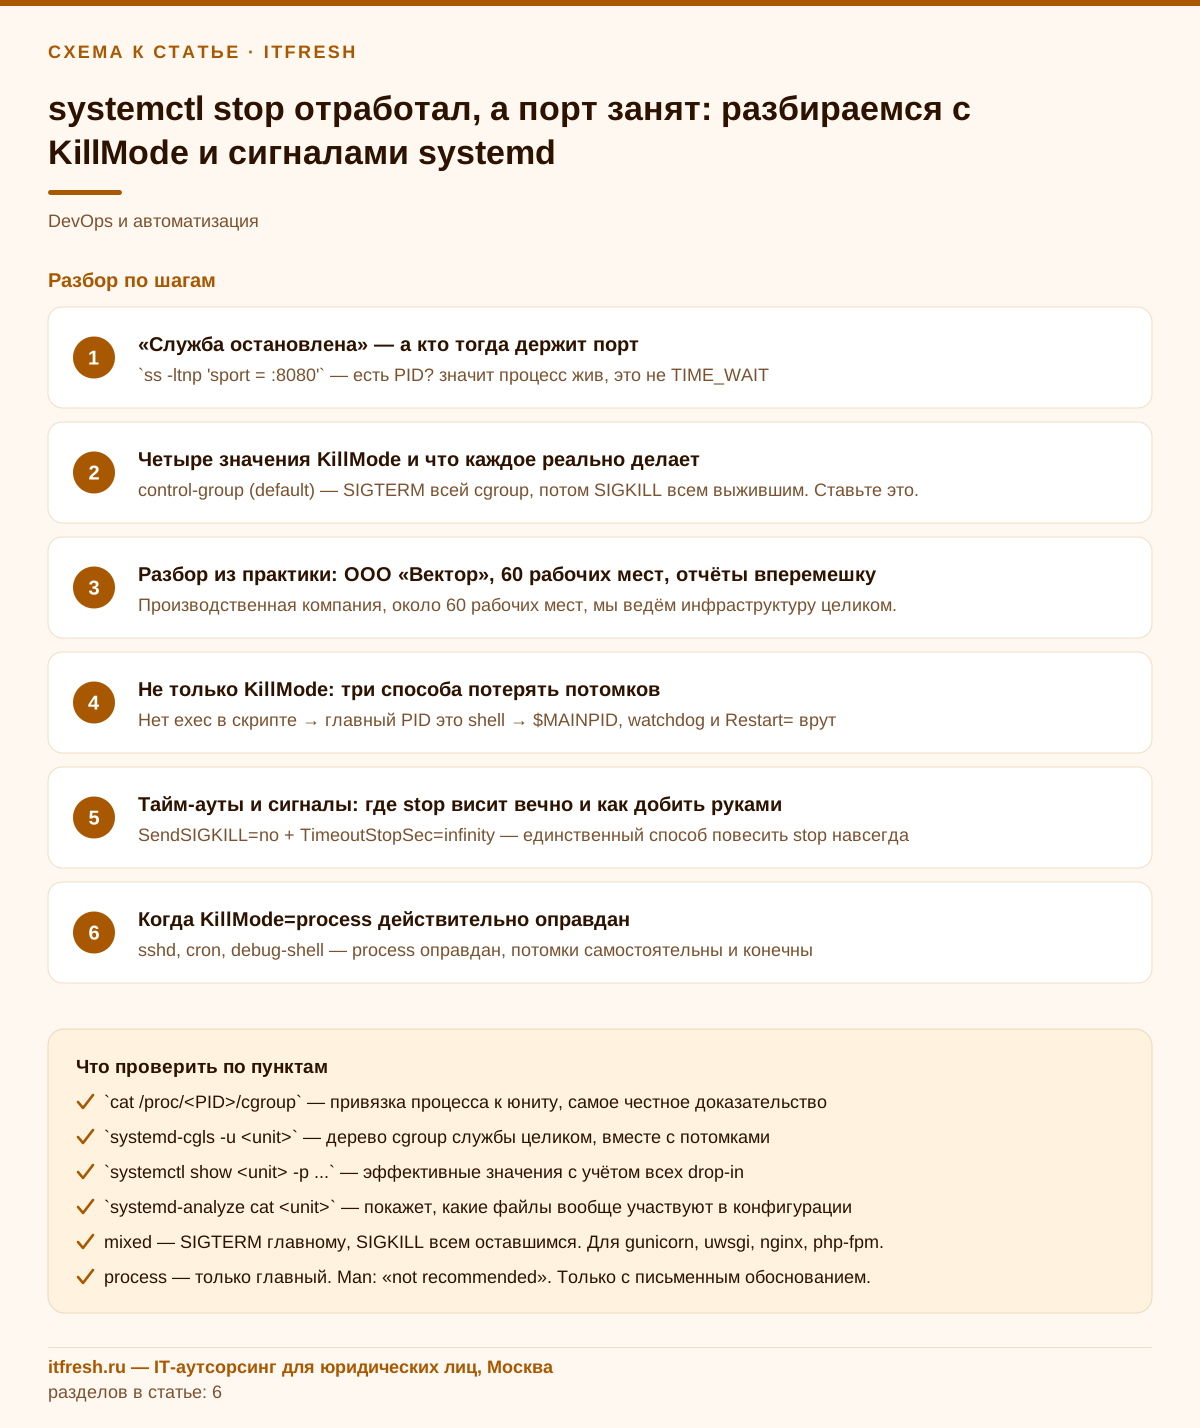
- `ss -ltnp 'sport = :8080'` — есть PID? значит процесс жив, это не TIME_WAIT
- `cat /proc/<PID>/cgroup` — привязка процесса к юниту, самое честное доказательство
- `systemd-cgls -u <unit>` — дерево cgroup службы целиком, вместе с потомками
- `systemctl show <unit> -p ...` — эффективные значения с учётом всех drop-in
- `systemd-analyze cat <unit>` — покажет, какие файлы вообще участвуют в конфигурации
Четыре значения KillMode и что каждое реально делает
**control-group** — значение по умолчанию, и в 95 % случаев правильное. После того как отработали команды ExecStop=, все оставшиеся процессы контрольной группы юнита получают сигнал из KillSignal= (по умолчанию SIGTERM). Дальше, если SendSIGKILL=yes — а он по умолчанию именно yes, — по истечении TimeoutStopSec= выжившим прилетает FinalKillSignal= (по умолчанию SIGKILL). То есть из коробки systemd гарантированно вычищает cgroup. Если у вас что-то переживает стоп при control-group — почти наверняка кто-то трогал тайм-ауты или SendSIGKILL.
**mixed** — компромисс для демонов, которые сами умеют корректно гасить своих детей. Первый сигнал (KillSignal=, по умолчанию SIGTERM) уходит только главному процессу, а SIGKILL (или FinalKillSignal=) — всем оставшимся в cgroup. Важная деталь, которую часто упускают: по man systemd.kill(5) добивание при mixed происходит в двух случаях — когда главный процесс вышел ИЛИ когда истёк TimeoutStopSec=, смотря что наступит раньше. То есть если мастер вышел, не дождавшись воркеров, те получат SIGKILL сразу, без всякого тайм-аута. Поэтому mixed подходит только демонам, у которых мастер завершается последним, после своих детей. Это не экзотика: в upstream-юнитах systemd с KillMode=mixed идут systemd-udevd.service и user@.service.
**process** — гасится только главный процесс, потомки не трогаются вообще. Man-страница systemd.kill(5) комментирует это значение прямо в скобках: «(not recommended!)». **none** — не убивается никто, выполняется только ExecStop=, и там формулировка ещё жёстче: «(strongly recommended against!)». Общее обоснование в документации одно на оба режима: процессы «сбегают» из-под управления жизненным циклом и ресурсами менеджера служб и продолжают работать, пока служба считается остановленной. Со всеми вытекающими: MemoryMax= перестаёт быть гарантией, при выключении машины эти процессы никто корректно не остановит, а systemctl restart перестаёт быть атомарной операцией.
Про предупреждения в журнале — тут много путаницы, поэтому по исходникам. Начиная с systemd 246 при загрузке юнита с KillMode=none в журнал пишется предупреждение: в 246–251 оно начиналось со слов «Unit configured to use KillMode=none», с 252 — «Unit uses KillMode=none. This is unsafe…», и заканчивается фразой «Support for KillMode=none is deprecated and will eventually be removed». Для KillMode=process такого предупреждения нет ни в одной версии — только пометка «not recommended!» в документации, поэтому этот режим годами живёт в юнитах незамеченным. Второй сигнал, который стоит знать в лицо, появился в той же 246-й версии: при старте юнита, в cgroup которого остались процессы прошлого запуска, systemd пишет Found left-over process <PID> (<имя>) in control group while starting unit. Ignoring. Увидели эту строку в journalctl -u <unit> — у вас хвосты, и KillMode первым под подозрением.
Резонный вопрос: если process такой плохой, почему он есть в дистрибутивных юнитах? Есть. В Debian и Ubuntu KillMode=process стоит в пакетных ssh.service и cron.service, а в upstream-поставке systemd — в debug-shell.service. У каждого причина осознанная и специфическая: рестарт sshd не должен рубить вашу текущую SSH-сессию, запущенные cron-джобы должны досчитаться до конца, отладочная консоль не должна умирать вместе с юнитом. Беда в том, что админ видит эту строчку в системном юните, копирует к себе «чтобы рестарт был помягче» — и получает зоопарк осиротевших воркеров.
- control-group (default) — SIGTERM всей cgroup, потом SIGKILL всем выжившим. Ставьте это.
- mixed — SIGTERM главному, SIGKILL остальным сразу после выхода главного или по TimeoutStopSec=. Для gunicorn, uwsgi и подобных мастер-воркерных демонов.
- process — только главный. Man: «not recommended». Предупреждения в журнале НЕ даёт — тем и опасен.
- none — никого. Man: «strongly recommended against». С systemd 246 — предупреждение о небезопасности и грядущем удалении.
- KillSignal= по умолчанию SIGTERM, FinalKillSignal= по умолчанию SIGKILL, SendSIGHUP= по умолчанию no
Разбор из практики: переплётная мастерская на 48 мест и очередь заказов вперемешку
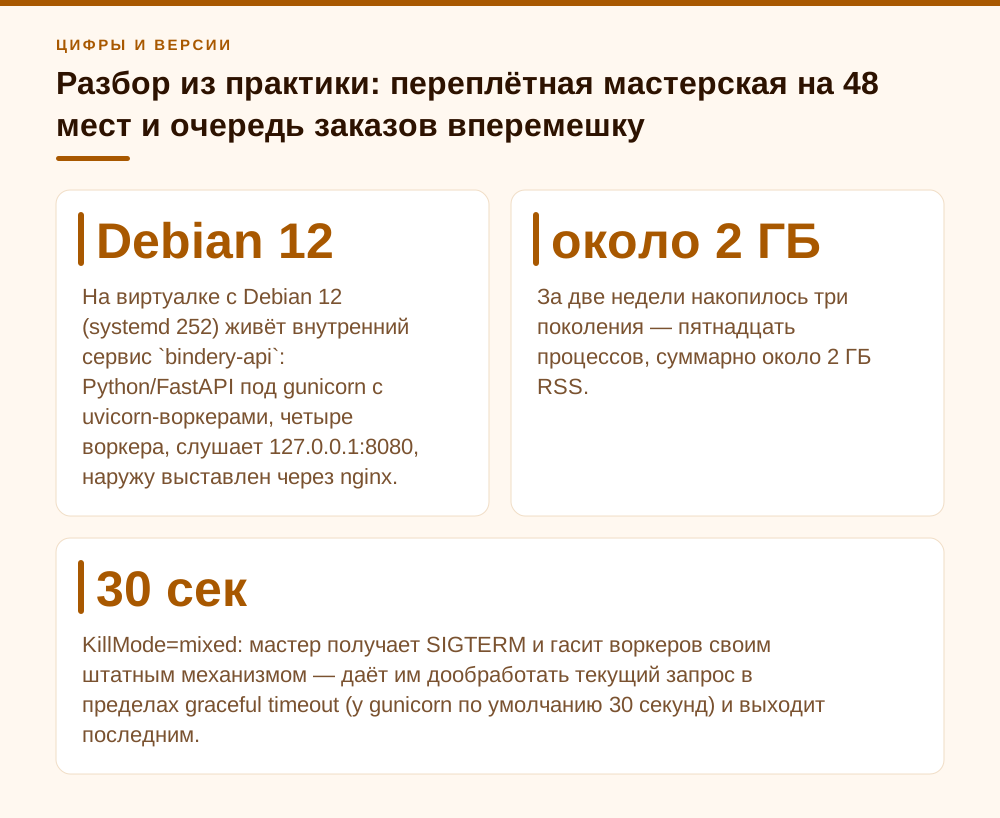
Переплётная мастерская «Книга в обложке»: 48 рабочих мест — менеджеры приёма, цех переплёта и тиснения, бухгалтерия, мы ведём инфраструктуру целиком. На виртуалке с Debian 12 (systemd 252) живёт внутренний сервис bindery-api: Python/FastAPI под gunicorn с uvicorn-воркерами, четыре воркера, слушает 127.0.0.1:8080, наружу выставлен через nginx. Задача сервиса — забирать заказы из 1С и формировать сменные задания для цеха: какие тиражи шить, какие обложки тиснить, в каком порядке. Писал его подрядчик, деплой — ansible-плейбук с systemctl restart.
Симптом, с которым пришли: «после обновления в сменном задании иногда старые позиции». Иногда — это ключевое слово, из-за него проблему несколько месяцев списывали на кэш браузера на планшете мастера цеха. Плюс примерно каждый третий деплой падал на Address already in use, и плейбук просто прогоняли повторно. Юнит выглядел так:
[Unit]
Description=Bindery orders API
After=network-online.target

[Service]
Type=simple
User=bindery
WorkingDirectory=/opt/bindery/api
ExecStart=/bin/bash /opt/bindery/api/run.sh
KillMode=process
Restart=always

[Install]
WantedBy=multi-user.target
А run.sh — вот такой, без exec:
#!/bin/bash
source /opt/bindery/api/.env
/opt/bindery/venv/bin/gunicorn -w 4 -k uvicorn.workers.UvicornWorker \
  -b 127.0.0.1:8080 app.main:app
Здесь два греха накладываются друг на друга и дают ровно тот эффект, который мы видели. Первый: главный процесс службы — это bash, а не gunicorn, потому что в скрипте нет exec. Второй: KillMode=process гасит только главный процесс, то есть этот самый bash. Мастер gunicorn и четыре воркера остаются в cgroup живыми. Systemd честно рапортует «остановлено», ansible тут же запускает новый экземпляр — и дальше как повезёт: если старый мастер ещё держит 8080, новый падает с EADDRINUSE; если по времени успел отпустить (или его прибили руками) — новый поднимается и работает бок о бок со старым.
Замерили. После обычного systemctl stop bindery-api в /sys/fs/cgroup/system.slice/bindery-api.service/cgroup.procs оставалось пять PID: мастер плюс четыре воркера. А в journalctl -u bindery-api при каждом старте висели строки Found left-over process … (gunicorn) in control group while starting unit. Ignoring. — systemd честно предупреждал, просто журнал никто не читал. За две недели накопилось три поколения — пятнадцать процессов, суммарно около 2 ГБ RSS. И главное: старые мастера продолжали брать задачи из общей очереди Redis и перезаписывать свежие сменные задания старой логикой расчёта. Вот вам и «иногда старые позиции» — никакого кэша, просто три версии кода одновременно пишут в одну базу.
Переписали юнит вот так, без промежуточного bash вообще:
[Service]
Type=simple
User=bindery
EnvironmentFile=/opt/bindery/api/.env
WorkingDirectory=/opt/bindery/api
ExecStart=/opt/bindery/venv/bin/gunicorn -w 4 \
  -k uvicorn.workers.UvicornWorker -b 127.0.0.1:8080 app.main:app
KillMode=mixed
KillSignal=SIGTERM
TimeoutStopSec=45
SendSIGKILL=yes
Restart=on-failure
RestartSec=3
Логика простая. Переменные окружения переехали из source .env в EnvironmentFile=, поэтому обёртка стала не нужна и главным процессом стал сам gunicorn. KillMode=mixed: мастер получает SIGTERM и гасит воркеров своим штатным механизмом — даёт им дообработать текущий запрос в пределах graceful timeout (у gunicorn по умолчанию 30 секунд) и выходит последним. Как только мастер вышел, всё, что осталось в cgroup, systemd сразу добивает SIGKILL; если мастер завис — добивание наступит по TimeoutStopSec=45, поэтому этот тайм-аут и выбран заметно больше graceful timeout gunicorn. Restart=always заменили на on-failure, чтобы сбой после ручных манипуляций не поднимал сервис неожиданно. Итог: остановка вместо «висит или не завершается вовсе» занимает 2–6 секунд, cgroup после stop пустая, дубли в сменных заданиях пропали. В плейбук добавили дешёвую проверку, которая ловит регресс сразу, а не через две недели:
systemctl stop bindery-api
test ! -s /sys/fs/cgroup/system.slice/bindery-api.service/cgroup.procs \
  || { echo 'FATAL: в cgroup остались процессы'; exit 1; }
systemctl start bindery-api- Главный процесс службы был `bash`, а не gunicorn — в скрипте запуска не было `exec`
- KillMode=process гасил только этот bash, мастер и воркеры gunicorn оставались в cgroup
- В журнале при каждом старте — `Found left-over process … in control group while starting unit`, которую никто не читал
- Три поколения процессов разбирали одну очередь Redis и перезаписывали сменные задания цеха
- Лечение: ExecStart= напрямую на gunicorn, EnvironmentFile=, KillMode=mixed, TimeoutStopSec=45 больше graceful timeout
- Контроль: проверка пустого cgroup.procs после stop прямо в ansible-плейбуке
Не только KillMode: три способа потерять потомков
**Обёртка без exec.** Разобрали выше, но повторю, потому что это правда номер один. Когда ExecStart= запускает шелл-скрипт, главный процесс службы — это shell. С KillMode=control-group это не смертельно: потомки всё равно в cgroup и умрут. Но главный PID всё равно неверный, а от него зависит многое — переменная $MAINPID в ExecReload=, реакция Restart=on-failure (systemd смотрит код возврата шелла, а не приложения), watchdog через sd_notify. Лечится одной строчкой: exec /path/to/binary ... в конце скрипта.
**Type=forking и кривой PIDFile.** Демон форкается, родитель выходит, systemd должен понять, кто теперь главный. GuessMainPID= по умолчанию yes, но эта догадка игнорируется, если задан PIDFile=. И если PID-файл пишется с задержкой, не тем пользователем или в путь, который systemd не читает — менеджер шлёт сигналы в никуда, ExecStop= уходит впустую, а TimeoutStopSec= честно отрабатывает целиком. Мой порядок предпочтений: Type=notify, если приложение умеет sd_notify; иначе Type=simple/exec и не форкаться вовсе; Type=forking — только для чужого софта, который иначе не умеет.
**ExecStop=/bin/kill -TERM $MAINPID.** Популярный копипаст, который ровно ничего не улучшает: без ExecStop= systemd и так отправит KillSignal= главному процессу. Хуже того, man systemd.service(5) прямо говорит, что после выполнения команд ExecStop= служба считается остановленной, а оставшиеся процессы сразу завершаются согласно KillMode= и KillSignal=. И там же отдельное предупреждение: команда, которая лишь просит сервис завершиться, но не ждёт этого, обычно недостаточна — ExecStop= должен быть синхронным. То есть ваш kill вернул ноль — systemd тут же пошёл по KillMode=, хотя приложение ещё и не начинало выходить. И отдельно: TimeoutStopSec= ограничивает и время каждой команды ExecStop= (при превышении остальные пропускаются и службе уходит SIGTERM), и ожидание завершения самой службы, так что длинный graceful drain в ExecStop= надо соотносить с этим значением.
**Уход из-под юнита.** Если в ExecStartPost= или внутри приложения кто-то делает setsid, nohup & или systemd-run, процесс уезжает в другую cgroup — и он больше не ваш ни при каком KillMode. Это не баг systemd, это ровно то, о чём говорит документация словом «escape». А вот вложенные подгруппы внутри собственной cgroup службы (типичная история для контейнерных рантаймов с Delegate=yes) при control-group накрываются целиком — здесь бояться нечего.
- Нет exec в скрипте → главный PID это shell → $MAINPID, watchdog и Restart= врут
- PIDFile= указывает не туда → сигналы уходят в пустоту, стоп упирается в тайм-аут
- ExecStop= с `kill $MAINPID` → систему обманули: она думает, что стоп уже сделан
- setsid / nohup / systemd-run внутри сервиса → процесс покинул cgroup навсегда
- Забыли `systemctl daemon-reload` → правки в юните вообще не применились
Тайм-ауты и сигналы: где stop висит вечно и как добить руками
Из коробки systemd не висит на остановке вечно: SendSIGKILL=yes, FinalKillSignal=SIGKILL, а DefaultTimeoutStopSec=90s — встроенное умолчание, которое в system.conf показано закомментированной строкой. Вечно висящий systemctl stop получается прежде всего из TimeoutStopSec=infinity: тайм-аут отключён, значит и SIGKILL не наступит никогда, если процесс игнорирует SIGTERM. SendSIGKILL=no ломает иначе: по истечении тайм-аута systemd сдаётся, но процессы остаются в cgroup, и, как предупреждает man systemd.kill(5), служба с control-group или mixed потом не перезапустится, пока там живут процессы прошлого запуска. Отдельный случай — процесс в состоянии D (непрерываемое ожидание ввода-вывода, чаще всего зависший NFS или умирающий диск): его не берёт даже SIGKILL, и тут никакая директива не поможет. Поэтому, когда у клиента стоп висит минутами, я первым делом смотрю не в код приложения, а в systemctl show <unit> -p SendSIGKILL -p TimeoutStopUSec и в ps -o pid,stat,cmd по PID из cgroup.
Дефолтные 90 секунд — величина для десктопа. На сервере это 90 секунд простоя на каждый залипший юнит при shutdown, и если таких юнитов пять, перезагрузка превращается в семь с половиной минут молчания. Я ставлю значения осознанно: веб-воркерам 30–45 секунд (успеть дообработать входящие запросы и не больше), обработчикам очередей 120–180 секунд (задача может быть длинной, обрывать дороже), СУБД — строго по регламенту вендора и точно не меньше. И никогда не ставлю 5 секунд «чтобы быстрее»: это гарантированный SIGKILL посреди записи.
Когда надо вычистить остатки прямо сейчас, руками, не выясняя причину — есть штатный инструмент, который бьёт по всей контрольной группе, а не только по главному процессу:
# мягко — всем процессам cgroup службы
systemctl kill --kill-whom=all --signal=SIGTERM bindery-api.service
sleep 5
# жёстко, если кто-то остался
systemctl kill --kill-whom=all --signal=SIGKILL bindery-api.service

# проверяем, что вычистили
cat /sys/fs/cgroup/system.slice/bindery-api.service/cgroup.procs
Флаг --kill-whom= появился в systemd 252 (Debian 12 — как раз 252, Ubuntu 24.04 — 255); в более старых сборках, например в systemd 247 из Debian 11, он называется --kill-who=, а в свежих версиях старое имя может уже не приниматься — проверяйте systemctl --help. Кроме all он принимает main, control и cgroup. Если приходится делать это регулярно — вы лечите симптом, а болезнь в юните. Из смежного: SendSIGHUP= по умолчанию no, включать его стоит только для шелл-подобных вещей, которым надо сообщить «связь разорвана»; RestartKillSignal= позволяет при рестарте слать другой сигнал, чем при обычном стопе — редкая, но иногда полезная штука для демонов, у которых graceful-перезапуск висит на отдельном сигнале.
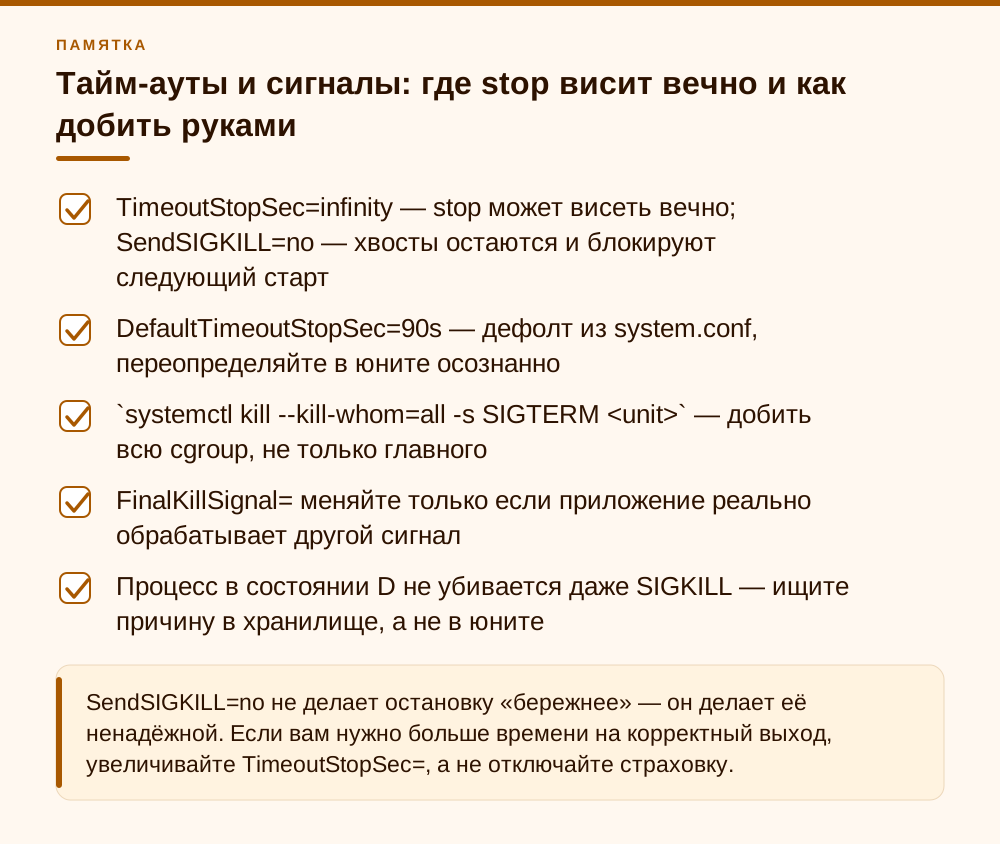
- TimeoutStopSec=infinity — stop может висеть вечно; SendSIGKILL=no — хвосты остаются и блокируют следующий старт
- DefaultTimeoutStopSec=90s — дефолт из system.conf, переопределяйте в юните осознанно
- `systemctl kill --kill-whom=all -s SIGTERM <unit>` — добить всю cgroup, не только главного
- FinalKillSignal= меняйте только если приложение реально обрабатывает другой сигнал
- Процесс в состоянии D не убивается даже SIGKILL — ищите причину в хранилище, а не в юните
Когда KillMode=process действительно оправдан
Первый честный случай — sshd. ssh.service в Debian и Ubuntu идёт с KillMode=process именно для того, чтобы systemctl restart ssh не оборвал вашу текущую сессию и вы не заперли себя снаружи удалённого сервера. Сессии живут как потомки, демон перезапускается, вы продолжаете печатать. Ровно та же логика у пакетного cron.service (запущенные джобы досчитываются до конца) и у debug-shell.service. Обратите внимание на общее: во всех случаях потомки — это осмысленные, самостоятельные, конечные по времени сущности, а не воркеры, которые будут вечно висеть на порту.
Второй случай — socket activation. Systemd сам держит слушающий сокет и передаёт его сервису файловым дескриптором; при рестарте сокет никуда не девается, соединения копятся в ядерной очереди, а старый и новый процессы могут какое-то время сосуществовать и разбирать её оба. Это подход, который подробно разобран у Vincent Bernat на примере Go-сервиса, и там KillMode=process — не костыль, а часть конструкции. Минимальный .socket-юнит выглядит так:
# bindery-api.socket
[Unit]
Description=Bindery orders API socket

[Socket]
ListenStream=127.0.0.1:8080
BindIPv6Only=both

[Install]
WantedBy=sockets.target
Главный бонус здесь даже не в нулевом даунтайме: при socket activation ошибка «Address already in use» не возникает в принципе, потому что порт принадлежит systemd, а не приложению. Но честно скажу: для внутренних сервисов компании до 50 рабочих мест это чаще всего переусложнение. Приложение должно уметь sd_listen_fds, деплой усложняется, а выигрыш — доли секунды простоя раз в неделю. Мы ставим socket activation там, где реально нельзя потерять ни одного запроса: платёжные вебхуки, приём заданий с цехового оборудования. Во всех остальных случаях связка KillMode=mixed + вменяемый TimeoutStopSec= + Restart=on-failure закрывает вопрос полностью и понятна любому админу, который придёт после вас.
- sshd, cron, debug-shell — process оправдан, потомки самостоятельны и конечны
- socket activation — process часть архитектуры, порт держит systemd
- Веб-воркеры, обработчики очередей, самописные демоны — process противопоказан
- Ставите process — напишите прямо в юните комментарий, почему. Через год спасибо скажете
Мой порядок действий: что чинить первым, на что забить
Порядок, по которому я разбираю такие инциденты у клиентов, устоялся и почти не меняется. Сначала — эффективная конфигурация, а не файл юнита: в /etc/systemd/system/<unit>.d/ вполне может лежать drop-in, о котором никто не помнит, и он перекрывает всё. systemd-analyze cat <unit> покажет полный склеенный конфиг с указанием источников, systemctl show — итоговые значения. Только после этого имеет смысл что-то править.
Дальше иду по списку ниже — и именно в таком порядке, потому что каждый следующий пункт имеет смысл только когда закрыт предыдущий. Менять тайм-ауты, пока главным процессом службы остаётся bash-обёртка, бессмысленно: сигналы всё равно придут не тому процессу.
На что можно спокойно забить. Не нужно подбирать экзотические KillSignal= и FinalKillSignal=, если ваше приложение не документирует особую обработку сигналов — SIGTERM/SIGKILL покрывают почти всё. Не нужно писать ExecStop=/bin/kill: систему это только путает. Не нужно бояться control-group — это дефолт, он правильный, и большинство «мягких» альтернатив ему на самом деле просто ломают учёт ресурсов. И не нужно отключать SendSIGKILL= ни при каких обстоятельствах: страховка, которая срабатывает раз в год, стоит дешевле, чем сервер, который не может перезагрузиться.
И последнее, банальное, но именно с этого начинается половина бесплодных расследований: после правки юнита — systemctl daemon-reload. Без него systemd продолжает жить со старой конфигурацией и молча игнорирует ваши изменения. Проверка — снова systemctl show <unit> -p KillMode: если там всё ещё старое значение, значит вы правите файл, а не систему.
- 1. `systemd-analyze cat <unit>` и `systemctl show <unit>` — узнать эффективную конфигурацию, включая drop-in
- 2. Убрать bash-обёртки без exec, вынести переменные в EnvironmentFile=
- 3. Привести Type= в соответствие с реальностью: notify → simple/exec → forking с корректным PIDFile=
- 4. Убрать KillMode=process/none, если нет письменного обоснования; по умолчанию не задавать вообще. Заодно `journalctl -b | grep 'Found left-over process'` по всем юнитам
- 5. KillMode=mixed — только для демонов, которые сами корректно гасят воркеров
- 6. Выставить осознанный TimeoutStopSec=, оставить SendSIGKILL=yes
- 7. Добавить в деплой проверку пустого cgroup.procs после stop
- 8. `systemctl daemon-reload` и перепроверить `systemctl show`
Частые вопросы
Почему systemctl status показывает inactive (dead), а процессы живы?
Потому что статус описывает состояние юнита, а не содержимое его контрольной группы. Systemd считает службу остановленной, когда вышел главный процесс и отработали команды ExecStop=. При KillMode=process потомков он при этом не трогает вообще. Проверяйте `cat /sys/fs/cgroup/system.slice/<unit>/cgroup.procs` или `systemd-cgls -u <unit>` — вот это честная картина.
Какой KillMode ставить по умолчанию?
Никакой. Не задавайте директиву вовсе — значение по умолчанию control-group правильное для подавляющего большинства сервисов: SIGTERM всей cgroup, потом SIGKILL выжившим. Осознанное исключение — KillMode=mixed для мастер-воркерных демонов (gunicorn, uwsgi, php-fpm), которые сами умеют корректно гасить своих детей.
Можно ли поставить KillMode=none, чтобы сервис пережил обновление systemd?
Не надо. Документация формулирует это как «strongly recommended against»: процессы выходят из-под управления жизненным циклом и учёта ресурсов менеджера. Практические последствия — лимиты вроде MemoryMax= перестают что-либо гарантировать, а при shutdown такие процессы никто не остановит корректно. Для переживания рестартов существует socket activation, а не отключение убийства.
Что значит «Found left-over process … in control group while starting unit» в журнале?
Это сообщение systemd (появилось в версии 246): при старте юнита в его cgroup нашлись процессы прошлого запуска. systemd их не трогает («Ignoring») и запускает новый экземпляр рядом. Почти всегда причина — KillMode=process или none, SendSIGKILL=no либо bash-обёртка без exec. Проверьте `systemctl show <unit> -p KillMode -p SendSIGKILL` и содержимое cgroup.procs.
KillMode=process объявлен устаревшим, как и none?
Нет. Предупреждение о небезопасности и грядущем удалении systemd пишет в журнал только для KillMode=none, начиная с версии 246. KillMode=process в документации помечен «not recommended!», но предупреждения при загрузке юнита не вызывает — поэтому такие юниты годами работают незамеченными. Ищите их сами: `grep -r 'KillMode=' /etc/systemd/system`.
Почему systemctl stop висит ровно 90 секунд?
Это DefaultTimeoutStopSec=90s из system.conf. Значит, приложение не вышло по SIGTERM, и systemd честно ждёт тайм-аут, прежде чем послать SIGKILL. Лечится не уменьшением тайм-аута, а выяснением, почему процесс игнорирует SIGTERM: чаще всего он его просто не обрабатывает, либо главным процессом службы оказался shell-скрипт без exec.
Как быстро убить всё, что осталось от службы, не перезагружая сервер?
`systemctl kill --kill-whom=all --signal=SIGTERM <unit>`, через несколько секунд то же самое с SIGKILL. Опция `--kill-whom=` есть в systemd 252 и новее, в более старых сборках она называлась `--kill-who=`. Это разовое лечение симптома: если приходится делать регулярно, чинить надо юнит.
Правда ли, что KillMode=process нужен для sshd?
Да, и это тот редкий случай, когда режим оправдан: пакетный `ssh.service` в Debian и Ubuntu идёт именно с KillMode=process, чтобы `systemctl restart ssh` не обрывал текущие сессии администратора. Та же логика у cron.service. Но копировать эту строку в юнит своего веб-сервиса нельзя — там потомки не завершаются сами, а вечно висят на порту.
Источники
- systemd.kill(5) — KillMode=, SendSIGKILL=, FinalKillSignal= — Мануал systemd (официальная страница freedesktop.org, зеркало man7): значения KillMode= (control-group / mixed / process / none) с пометками «not recommended!» и «strongly recommended against!», условия отправки SIGKILL при mixed, умолчания KillSignal=SIGTERM, SendSIGKILL=yes, SendSIGHUP=no. https://www.freedesktop.org/software/systemd/man/latest/systemd.kill.html ; https://man7.org/linux/man-pages/man5/systemd.kill.5.html
- systemd.service(5) — ExecStop=, TimeoutStopSec=, Type=, GuessMainPID= — Формулировка «After the commands configured in this option are run, it is implied that the service is stopped, and any processes remaining for it are terminated according to the KillMode= setting», поведение TimeoutStopSec= (SIGKILL по истечении) и GuessMainPID= при Type=forking. https://www.freedesktop.org/software/systemd/man/latest/systemd.service.html ; https://man7.org/linux/man-pages/man5/systemd.service.5.html
- systemd-system.conf(5) — DefaultTimeoutStopSec= — Значение по умолчанию DefaultTimeoutStopSec=90s, применяемое ко всем юнитам без явного TimeoutStopSec=. Проверено на Ubuntu 24.04 (systemd 255) командой `systemd-analyze cat-config systemd/system.conf`. https://man7.org/linux/man-pages/man5/systemd-system.conf.5.html
- Vincent Bernat — Integration of a Go service with systemd: socket activation — Разбор socket activation как способа избавиться от «address already in use» при рестарте, синтаксис .socket-юнита (ListenStream=, BindIPv6Only=) и роль KillMode=process в схеме graceful-передачи соединений. https://vincent.bernat.ch/en/blog/2018-systemd-golang-socket-activation
- systemctl(1) — kill, --kill-whom=, --signal= — Описание команды systemctl kill и опции --kill-whom= (main, control, cgroup, all), пометка «Added in version 252». https://www.freedesktop.org/software/systemd/man/latest/systemctl.html
- systemd NEWS — CHANGES WITH 246 — «systemd will now log about all left-over processes remaining in a unit when the unit is stopped. It will now warn about services using KillMode=none». https://github.com/systemd/systemd/blob/main/NEWS