
Поставил maxdelay в logrt Zabbix 7.4 — алерты пошли быстрее, а часть строк исчезла. Агент их не дочитает
Ситуация узнаваемая: элемент logrt[] отдавал ошибки с опозданием на полчаса, вы дописали в ключ maxdelay, и алерты полетели почти мгновенно. Радость длится до первого разбора инцидента, когда выясняется, что в истории нет ровно той строки, ради которой всё и затевалось. Отвечаю сразу на вопрос из заголовка: нет, агент их не дочитает — никогда. Дальше разбираю механику прыжка, показываю, как за две минуты отличить намеренный пропуск от кривой регулярки, привожу разбор случая в компании на 34 рабочих места, где отставание в 40 минут лечилось вообще другими параметрами, и даю чек-лист: что крутить в первую очередь, а на что можно забить.
maxdelay — это не ускорение, это разрешение не читать
Начну с главного, чтобы дальше читалось спокойно. maxdelay в ключах log[] и logrt[] работает не по принципу «читай быстрее», а по принципу «если не успеваешь — не читай». Значение по умолчанию 0 пропуск запрещает: агент дочитает журнал целиком, пусть даже с отставанием в час. Любое значение больше нуля — это ваша письменная санкция на потерю строк. В документации Zabbix это написано прямым текстом, отдельным предупреждением: указание maxdelay > 0 может привести к игнорированию важных записей журнала и пропущенным оповещениям.
Механика такая. На каждой проверке агент запоминает три величины: сколько байт он обработал, сколько байт осталось до конца файла и сколько секунд на обработку ушло. Из них считается оценочная задержка — примерное число секунд, которое понадобится, чтобы разобрать весь хвост. Если оценка укладывается в maxdelay, агент читает файл обычным порядком. Если не укладывается — он вычисляет новую позицию в файле, такую, чтобы остаток разобрался за отведённое время, и переставляет туда свой указатель. Потом сдвигается вперёд до начала ближайшей целой строки, чтобы не отхватить пол-записи.
И вот ключевой момент, из-за которого и возникает вопрос «а он их потом дочитает?». Пропущенный кусок не попадает ни в какой буфер. Это не очередь и не отложенная задача. Агент физически не читает эти байты — он только двигает offset. Догонять нечего: с точки зрения агента этих строк не существовало. Ни через минуту, ни после перезапуска службы, ни после zabbix_agentd -R log_level_increase. Единственное место, где они остались, — сам файл на диске.
Порядок параметров стоит держать перед глазами, потому что maxdelay сидит седьмым и его легко воткнуть не в ту позицию (а лишняя запятая молча превращает элемент в неподдерживаемый):
log[file,<regexp>,<encoding>,<maxlines>,<mode>,<output>,<maxdelay>,<options>,<persistent dir>]
logrt[file regexp,<regexp>,<encoding>,<maxlines>,<mode>,<output>,<maxdelay>,<options>,<persistent dir>]
log.count[file,<regexp>,<encoding>,<maxproclines>,<mode>,<maxdelay>,<options>,<persistent dir>]
logrt.count[file regexp,<regexp>,<encoding>,<maxproclines>,<mode>,<maxdelay>,<options>,<persistent dir>]
Обратите внимание: у счётных ключей .count нет параметра output, и четвёртый параметр называется maxproclines — это не «сколько отправить», а «сколько разобрать». Путаница между maxlines и maxproclines — вторая по частоте причина того, что «счётчик занижает».
- maxdelay = 0 (по умолчанию) — потерь нет, возможно отставание;
- maxdelay > 0 — отставание ограничено сверху, полнота не гарантируется;
- пропущенные байты не буферизуются и не перечитываются;
- позиция после прыжка выравнивается по началу строки, обрывков не будет;
- параметр действует на конкретный элемент данных, а не на агент целиком.
Как за две минуты отличить прыжок от кривой регулярки
Когда строки «исчезают», гипотез обычно две: агент прыгнул через кусок файла или регулярное выражение просто не матчит. Разводятся они по логу самого агента, и это первое, что я открываю, а не веб-интерфейс Zabbix. Прыжок агент фиксирует явным сообщением примерно такого вида: item:"logrt[...]" logfile:"..." skipping N bytes (from byte X to byte Y) to meet maxdelay. Формулировка «to meet maxdelay» — то, что нужно грепать.
# Linux
grep -n 'to meet maxdelay' /var/log/zabbix/zabbix_agentd.log | tail -n 20

# Windows (агент пишет в C:\Program Files\Zabbix Agent\zabbix_agentd.log)
Select-String -Path 'C:\Program Files\Zabbix Agent\zabbix_agentd.log' -Pattern 'to meet maxdelay' | Select-Object -Last 20
Если такие строки есть — вопрос закрыт, это не баг, это ваша конфигурация. Дальше остаётся посчитать, сколько байт суммарно улетело в никуда: сложите N по всем сообщениям за сутки и сопоставьте с размером журнала. Я обычно делаю это один раз, чтобы показать заказчику цифру. Когда человек видит, что мониторинг официально не посмотрел 40 % журнала, дискуссия про «зато быстро» заканчивается сама.
Если строк про maxdelay нет вообще, а данных всё равно не видно — причина другая, и maxdelay тут ни при чём. Уровня логирования DebugLevel=3 хватает, чтобы увидеть сам факт прыжка; поднимать до 4 или 5 имеет смысл только когда нужно видеть, где именно агент стоит в файле и как он трекает ротацию. Делается это на лету, без перезапуска службы: zabbix_agentd -R log_level_increase, и обязательно верните обратно через log_level_decrease — на четвёрке шумный агент способен за ночь налить гигабайт собственного лога, и я такое чинил дважды.
- элемент в статусе «не поддерживается» — текст ошибки виден прямо в свойствах элемента данных, читайте его первым;
- нет прав на чтение файла у пользователя zabbix — классика после смены владельца каталога при деплое;
- mode=skip при первом запуске — агент честно начал с конца файла, старое он и не должен был читать;
- ротация copytruncate без options=copytruncate в ключе logrt[] — агент видит усечённый файл и может перечитать его с начала или потерять хвост;
- неверная кодировка (UTF-16 у Windows-приложений) — строки читаются, но регулярка по ним не срабатывает;
- регулярка написана для «содержит», а по факту требует полного совпадения из-за якорей ^ и $.
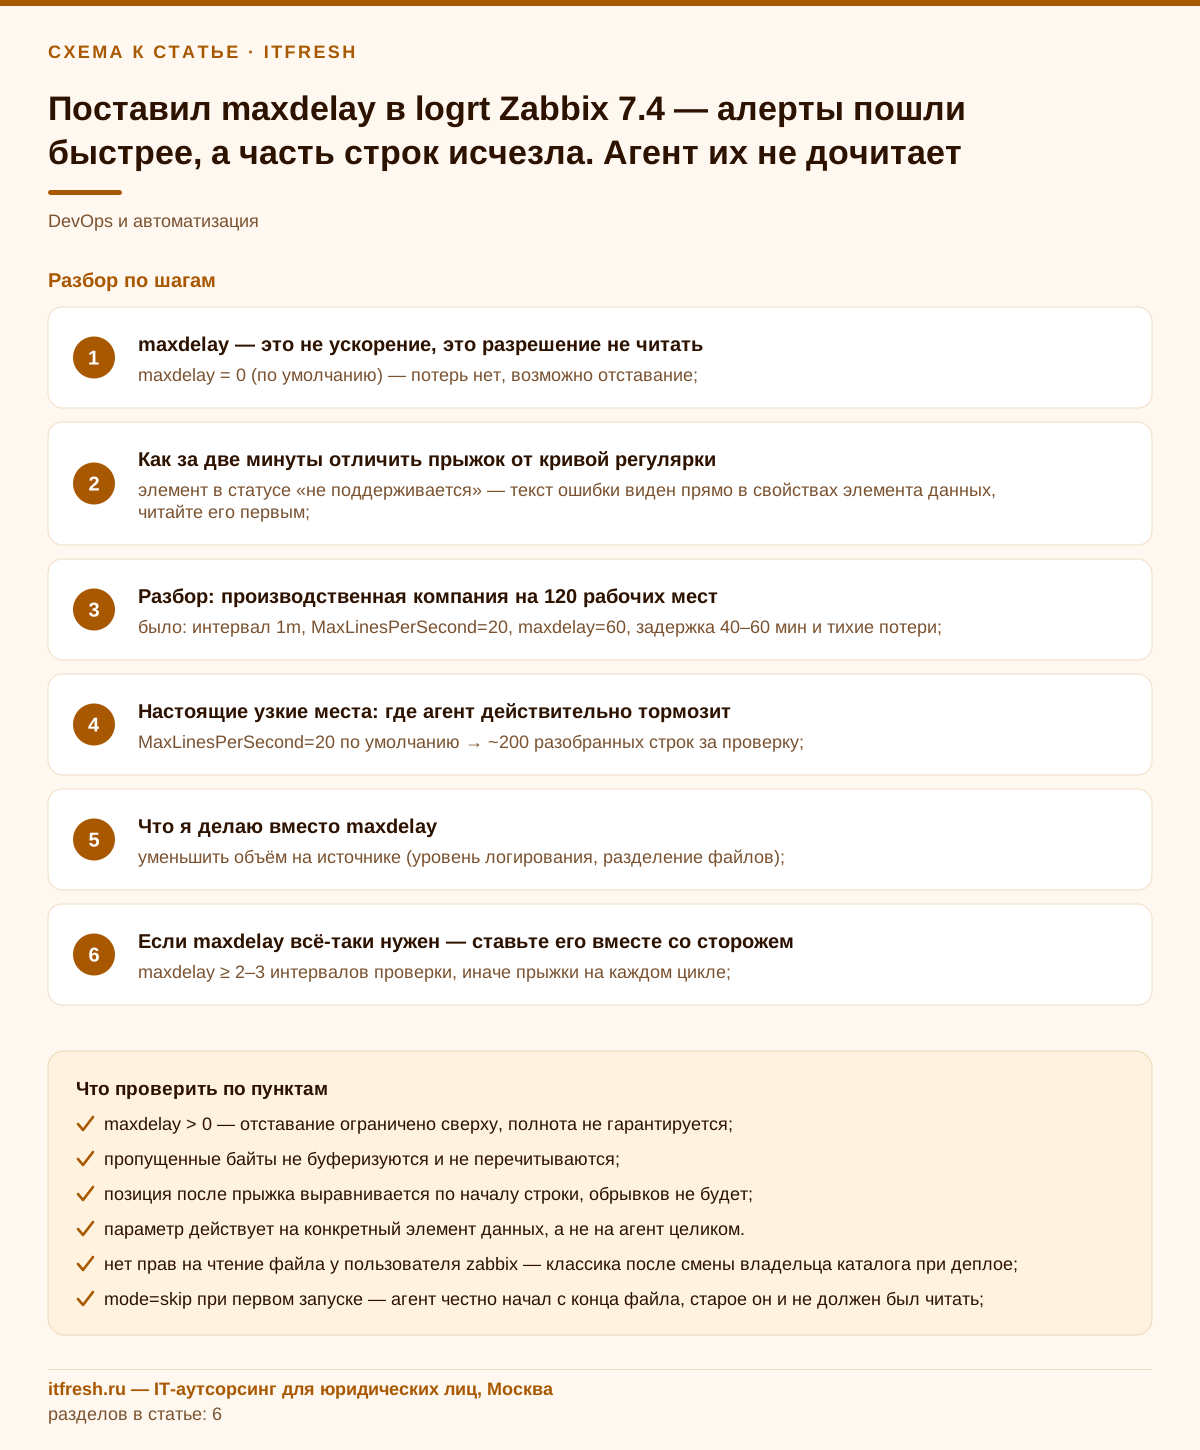
Разбор: «ФитоГрад», озеленение офисов, 34 рабочих места
Условный клиент — компания по озеленению офисов «ФитоГрад», 34 рабочих места: менеджеры, выездные флористы с планшетами, склад растений и небольшая бухгалтерия. Серверов немного: два узла на Debian — интернет-витрина с калькулятором фитостен и сервис обмена заказами между сайтом, 1С и банк-клиентом. Zabbix 7.4, агенты работают в активном режиме и ходят прямо на сервер, прокси нет. Прикладной журнал сервиса обмена — один файл в сутки по маске app-YYYYMMDD.log, порядка 450 тыс. строк за сутки: сервис пишет каждую синхронизацию остатков и каждый опрос банка. Жалоба звучала так: «сообщение о падении обмена с банком приходит через 40–60 минут, к этому моменту оплаты от клиентов уже не разнесены, а флористы едут на объекты без подтверждённых заказов». Приходящий админ нашёл maxdelay, поставил 60 — и стало приходить за минуту. Все выдохнули. Через три недели обмен упал снова, а в истории элемента не оказалось ни одной строки об этом.
Считаем арифметику, из-за которой всё и поехало. Интервал обновления элемента стоял 1m — «чтобы не грузить сервер». MaxLinesPerSecond в конфиге агента не трогали, то есть работал дефолт 20. По документации агент для поиска нужных строк анализирует вдесятеро больше, чем разрешено отправить, — при дефолтах это около 200 записей за одну проверку. Поток приложения — 450 тыс. строк в сутки, это ~312 строк в минуту в среднем, а в утренний пик синхронизации складских остатков и вдвое больше. Итог: агент разбирает 200 строк в минуту при поступлении 312. Отставание росло в среднем на 110 строк каждую минуту и никогда бы не рассосалось само. Сорок минут задержки — это просто накопленный с утреннего пика хвост.
Лечение заняло полчаса и maxdelay в нём не участвовал. Интервал элемента поставил 1s — да, именно так, это не опечатка и не нагрузка: агент начинает читать мелкими порциями и перестаёт устраивать всплески раз в минуту. MaxLinesPerSecond поднял до 100. Элемент разбил на два: узкий по ERROR|FATAL с отправкой строк и счётный logrt.count по WARN, чтобы видеть динамику без перекачки текста. Плюс persistent_dir: позицию в файле сервер и так хранит и отдаёт агенту при старте, а постоянные файлы закрывают случай, когда агент перезапустился, не успев отправить буфер, — без них в истории появляются повторы или дыра.
# /etc/zabbix/zabbix_agentd.conf
ServerActive=10.20.0.11
MaxLinesPerSecond=100
BufferSize=1000     # у zabbix_agentd по умолчанию 100, у agent 2 уже 1000
BufferSend=1
Timeout=10
logrt["/var/log/fitograd/app-[0-9]{8}\.log","(ERROR|FATAL)",,1000,skip,,0,,/var/lib/zabbix/logpos]
logrt.count["/var/log/fitograd/app-[0-9]{8}\.log","WARN",,10000,skip,0,,/var/lib/zabbix/logpos]Результат: при интервале 1s потолок разбора по основному элементу — до 10 000 строк за секундную проверку (maxlines=1000, умноженное на десять), против поступающих в пик 10–12 строк в секунду; запас многократный, отставание после разгона хвоста стабильно держится в пределах 3–5 секунд. maxdelay вернули в 0. Нагрузка на сервер Zabbix, вопреки опасениям, не выросла: вместо минутных пачек пошёл ровный тонкий поток. Одну вещь я не отдал: заказчик хотел собирать в Zabbix ещё и INFO «на всякий случай». Отговорил. Zabbix — не syslog-сервер и не хранилище логов, для этого рядом ставится нормальный сборщик, а в мониторинг тянутся только события, на которые есть реакция.
- было: интервал 1m, MaxLinesPerSecond=20, maxdelay=60, задержка 40–60 мин и тихие потери;
- стало: интервал 1s, MaxLinesPerSecond=100, maxlines=1000 в ключе, maxdelay=0, задержка 3–5 секунд, потерь нет;
- разделение на logrt[] по критике и logrt.count[] по шуму убрало 90 % трафика элемента;
- persistent_dir закрыл повторы и дыры при перезапуске агента с неотправленным буфером.
Настоящие узкие места: где агент действительно тормозит
Первое и главное — потолок разбора. MaxLinesPerSecond в конфиге агента по умолчанию 20, и это ограничение на отправку. Разбирает агент вдесятеро больше — в документации это сформулировано прямо: при дефолтах не более 200 проанализированных и не более 20 отправленных записей за проверку. Для log.count[] и logrt.count[] свой параметр maxproclines: по умолчанию 10×MaxLinesPerSecond, максимум 10 000. Параметр maxlines в самом ключе переопределяет MaxLinesPerSecond для конкретного элемента — это удобнее, чем крутить глобальный конфиг, потому что поднимать потолок обычно нужно для одного шумного журнала, а не для всех.
Второе — интервал. Здесь у людей стойкая интуиция наоборот: «поставлю пореже, чтобы не грузить». На мониторинге логов это работает ровно наоборот, и рекомендация ставить активным log-элементам интервал 1 секунда звучит и в материалах самих разработчиков Zabbix. При редком интервале агент вынужден за одну проверку вычитывать всё, что накопилось, и упирается в потолок строк; при секундном — идёт равномерно и потолка не касается вовсе.
Третье — буферы, и тут есть неочевидная разница между классическим агентом и агентом 2. У zabbix_agentd BufferSize по умолчанию 100 значений, у агента 2 — 1000; BufferSend у обоих 5 секунд. В агенте 2 и лимит строк называется иначе — Plugins.Log.MaxLinesPerSecond. Классический zabbix_agentd умеет выгружать данные прямо во время сбора и освобождать буфер по ходу дела. Агент 2, как сказано в документации, останавливает сбор журнала, пока данные не будут выгружены и буфер не освободится, а выгрузка идёт асинхронно. На спокойных логах разницы не заметите, на шумных — агент 2 начинает пилообразно отставать, и это лечится увеличением BufferSize и уменьшением BufferSend, а не maxdelay. Ещё одна деталь: persistent_dir поддерживается только классическим zabbix_agentd на Unix-системах, агентом 2 — нет.
Четвёртое — регулярки и ротация. Жадные выражения вида .*(ERROR|FATAL).* на длинных строках стоят лишнего CPU: убирайте крайние .*, они ничего не добавляют, потому что поиск и так идёт по вхождению. Строки длиннее 256 КБ агент при сопоставлении с регуляркой всё равно обрезает до первых 256 КБ. Про ротацию: на Unix агент опознаёт файл по inode и MD5 первых 512 байт, в Windows на NTFS — по 64-битному индексу файла, на ReFS — по 128-битному ID. Документация отдельно просит не менять время модификации журнала и не подменять его копированием — иначе Zabbix посчитает файл новым и начнёт с начала. Классическая картина: раз в сутки в 03:00 в истории всплеск старых событий.
Для logrt[] и logrt.count[] схему ротации можно указать в options: rotate (по умолчанию — файл переименовывают, пишут новый) или copytruncate (logrotate копирует файл и усекает оригинал). Ограничение из документации: copytruncate нельзя сочетать с maxdelay > 0 и с persistent_dir. Встречаются ещё mtime-reread и mtime-noreread — они управляли реакцией на смену времени модификации, но mtime-noreread в документации помечен устаревшим с 5.0.2, и в новых элементах я на эти значения не опираюсь. Мой выбор по умолчанию — ротация через create/rename, а copytruncate только там, где приложение не умеет переоткрывать файл.
- MaxLinesPerSecond=20 по умолчанию → ~200 разобранных строк за проверку;
- maxlines в ключе переопределяет глобальный лимит точечно;
- интервал 1s для активных log-элементов, а не 1m;
- BufferSize побольше и BufferSend=1 на шумных журналах, особенно для агента 2 (у него дефолт BufferSize уже 1000);
- logrotate — лучше create/rename; если нужен copytruncate, укажите его в options и помните, что тогда нельзя maxdelay > 0 и persistent_dir;
- маска в logrt должна быть узкой: широкая заставляет агент сканировать каталог целиком на каждой проверке.
Что я делаю вместо maxdelay
Мой порядок действий, ровно в этой последовательности — сверху то, что даёт эффект сразу и почти бесплатно, снизу то, до чего доходят единицы. Первое: фильтровать на источнике. Если приложение сыплет отладкой в прод, вопрос не к Zabbix. Снизьте уровень логирования, разведите потоки по разным файлам, вынесите access-лог отдельно от error-лога. Одно это решение обычно снимает 80 % объёма и вместе с ним всю проблему.
Второе: сузить регулярку в самом ключе, чтобы агент отбрасывал строки как можно раньше. Третье: разделить один жирный элемент на несколько узких — по критике отдельный log[] со строками, по массовым событиям logrt.count[], который отдаёт только число и не таскает текст через прокси. Четвёртое: интервал 1s и maxlines под реальный поток. Пятое: persistent_dir на Unix-агентах, чтобы рестарт или обновление агента с неотправленным буфером не давали повторов или дыры в истории. Шестое: mode=skip на новых элементах, чтобы при первом запуске не втянуть в историю весь архив.
На что можно забить. Не гонитесь за отдельным прокси ради логов — на потоке, характерном для офиса до 50 рабочих мест, он не нужен. Не переписывайте всё на агент 2 только ради логов: там, где важна равномерность на шумных журналах, классический агент ведёт себя предсказуемее, и persistent_dir у него есть. И не пытайтесь сделать из Zabbix хранилище логов с полнотекстовым поиском — это разные инструменты, а попытка совместить заканчивается раздутым history_log и жалобами на тормоза фронтенда.
- уменьшить объём на источнике (уровень логирования, разделение файлов);
- сузить regexp, убрать лишние .* и жадные группы;
- разделить элементы: log[] по критике + log.count[]/logrt.count[] по шуму;
- интервал 1s, maxlines под реальный поток строк;
- persistent_dir (только zabbix_agentd на Unix) для корректной позиции при перезапуске с неотправленным буфером;
- mode=skip на вновь создаваемых элементах.
Если maxdelay всё-таки нужен — ставьте его вместе со сторожем
Честно: сценарии, где maxdelay оправдан, существуют. Самый реальный — приложение, которое иногда уходит в цикл и за минуту наливает гигабайт однотипных строк. В такой ситуации важнее знать «что происходит прямо сейчас», чем «что было полтора часа назад», и полнота вам всё равно недоступна: сотни тысяч одинаковых записей никто читать не будет. Второй сценарий — временный отладочный журнал, который вы подключили на неделю и точно снимете. Всё остальное, что я видел, — это попытка параметром прикрыть неправильно настроенный интервал.
Если ставите — ставьте не меньше двух-трёх интервалов проверки, иначе агент будет прыгать почти на каждом цикле, и заведите отдельный элемент, который следит за самим фактом прыжка. Логика простая: агент честно пишет о пропуске в свой лог, значит, этот лог тоже надо мониторить. Это тридцать секунд работы и полностью снимает эффект «мы думали, всё видим».
logrt.count["/var/log/zabbix/zabbix_agentd\.log.*","to meet maxdelay",,1000,skip,0]Маска zabbix_agentd\.log.* нужна, чтобы не терять сообщения при встроенной ротации лога агента (LogFileSize переименовывает файл в .old). И триггер на любое ненулевое значение, с текстом, который через полгода поймёт дежурный, а не только автор: «Агент на {HOST.NAME} пропустил часть журнала из-за maxdelay — данные за период неполные».
Дальше по вкусу: вывести этот счётчик на дашборд рядом с самим элементом логов и раз в месяц смотреть, растёт он или нет. Если растёт — значит, поток приложения увеличился и пора возвращаться к разделу выше. Если стабильно ноль — maxdelay можно смело убирать в 0, он вам больше не нужен.
- maxdelay ≥ 2–3 интервалов проверки, иначе прыжки на каждом цикле;
- обязательный элемент-сторож по логу агента на строку «to meet maxdelay»;
- триггер с понятной формулировкой про неполноту данных;
- ревизия раз в месяц: счётчик прыжков растёт — чините поток, стабильный ноль — снимайте maxdelay.
Короткий чек-лист
Если вы дочитали до сюда с открытым конфигом, вот сжатая последовательность. Сначала грепните лог агента на «to meet maxdelay» — это ответ на вопрос, теряете вы строки или нет, и он занимает десять секунд. Потом посмотрите статус элемента данных: неподдерживаемый элемент напишет причину сам. Затем посчитайте свой поток: строк в сутки делим на 1440, получаем строки в минуту и сравниваем с 200 (дефолтный потолок разбора за проверку при интервале 1m). Если ваш поток больше — вы нашли причину, и maxdelay тут не нужен.
После этого меняйте интервал на 1s, поднимайте maxlines в ключе, разделяйте элементы на критику и счётчики, добавляйте persistent_dir. И возвращайте maxdelay в 0 — с чистой совестью, потому что отставание вы к этому моменту уже убрали по-настоящему, а не спрятали. Если после всего этого агент всё равно не успевает — проблема не в мониторинге, а в приложении, которое пишет столько, что его журнал не читается в реальном времени. Это отдельный разговор с разработчиком, и он полезнее любых параметров.
- 1. grep 'to meet maxdelay' в логе агента — есть потери или нет;
- 2. статус и текст ошибки элемента данных;
- 3. посчитать поток строк в минуту и сравнить с потолком разбора;
- 4. интервал 1s, maxlines, узкая регулярка;
- 5. persistent_dir и корректная ротация: create/rename или options=copytruncate в ключе;
- 6. maxdelay вернуть в 0 либо оставить со сторожем.
Частые вопросы
Агент дочитает пропущенные строки позже, когда нагрузка спадёт?
Нет. При срабатывании maxdelay агент не читает пропущенные байты вообще — он только переставляет позицию в файле. Эти строки не попадают в буфер и не образуют очередь, поэтому дочитывать нечего ни через минуту, ни после перезапуска агента. Единственный способ их увидеть — открыть сам файл на диске.
Как понять, что строки пропали именно из-за maxdelay, а не из-за регулярки?
Грепните лог агента на подстроку «to meet maxdelay»: при прыжке агент пишет сообщение с именем элемента, именем файла и числом пропущенных байт (skipping N bytes from byte X to byte Y). Если таких записей нет, причина другая — смотрите статус элемента данных, права на файл, кодировку и схему ротации.
Какое значение maxdelay безопасно?
Безопасное значение только одно — 0, оно же по умолчанию. Любое положительное значение по определению разрешает потери. Если вы всё-таки его ставите, берите не меньше двух-трёх интервалов проверки и обязательно заводите парный элемент, который считает сообщения о прыжках в логе агента.
Почему интервал 1 секунда не грузит сервер сильнее, чем 1 минута?
Потому что объём данных задаёт приложение, а не интервал опроса. При интервале 1 минута агент раз в минуту вычитывает накопившуюся пачку и упирается в потолок разбора (около 200 строк при MaxLinesPerSecond=20), а при 1 секунде читает тонким ровным потоком без всплесков. На практике нагрузка на прокси при переходе на 1s обычно снижается.
Чем отличается maxlines от maxproclines?
maxlines в ключах log[] и logrt[] ограничивает число строк, отправляемых на сервер за секунду, и переопределяет MaxLinesPerSecond для конкретного элемента. У счётных ключей log.count[] и logrt.count[] четвёртый параметр называется maxproclines и ограничивает число обрабатываемых строк — именно поэтому при дефолтах счётчик может занижать реальное количество событий.
Работает ли всё это одинаково в Zabbix agent и agent 2?
Не совсем. Классический агент умеет выгружать данные во время сбора, а агент 2, по документации, останавливает сбор журнала, пока данные не выгружены и буфер не освобождён. У агента 2 другие дефолты и имена: BufferSize по умолчанию 1000 вместо 100, лимит строк задаётся как Plugins.Log.MaxLinesPerSecond. persistent_dir поддерживается только классическим агентом на Unix. На шумных журналах я предпочитаю классический zabbix_agentd.
Можно ли включить copytruncate и maxdelay в одном элементе?
Нет. В документации Zabbix прямо сказано, что options=copytruncate нельзя использовать вместе с maxdelay > 0 и с persistent_dir. Если logrotate настроен на copytruncate, либо переведите ротацию на create/rename, либо откажитесь от maxdelay и постоянных файлов в этом элементе.
Источники
- Zabbix 7.4 — Log file monitoring — Официальная документация Zabbix 7.4, раздел «Log file monitoring», подраздел «Using maxdelay parameter» (алгоритм расчёта задержки, прыжок по файлу, предупреждение о пропуске записей, сообщение «skipping … bytes … to meet maxdelay»): https://www.zabbix.com/documentation/7.4/en/manual/config/items/itemtypes/zabbix_agent/log_items
- Zabbix 7.4 — Zabbix agent item keys — Официальная документация Zabbix 7.4, раздел «Zabbix agent» — синтаксис ключей log[], log.count[], logrt[], logrt.count[] с полным порядком параметров, описание options и persistent_dir: https://www.zabbix.com/documentation/7.4/en/manual/config/items/itemtypes/zabbix_agent
- Zabbix 7.4 — Zabbix agent configuration file — Официальная документация Zabbix 7.4, приложение «zabbix_agentd» — параметры MaxLinesPerSecond, BufferSize (по умолчанию 100, диапазон 2–65535), BufferSend (по умолчанию 5, диапазон 1–3600): https://www.zabbix.com/documentation/7.4/en/manual/appendix/config/zabbix_agentd
- Zabbix Blog — Zabbix Log File Monitoring (Dmitry Lambert) — Статья Дмитрия Ламберта в официальном блоге Zabbix (2019) о мониторинге журналов: активный режим агента, рекомендация интервала 1 секунда, maxlines переопределяет MaxLinesPerSecond (по умолчанию 20): https://blog.zabbix.com/zabbix-log-file-monitoring/7378/
- Zabbix 7.4 — Zabbix agent 2 configuration file — Официальная документация Zabbix 7.4, приложение «zabbix_agent2» — BufferSize (по умолчанию 1000), BufferSend, Plugins.Log.MaxLinesPerSecond, EnablePersistentBuffer: https://www.zabbix.com/documentation/7.4/en/manual/appendix/config/zabbix_agent2