
Почему служба systemctl --user работает только после входа по SSH и как оставить её жить после выхода
Знакомая картина: сервис поднят через systemctl --user enable --now, всё зелёное, вы выходите из SSH — и секунд через десять выгрузка из 1С молчит. А после планового ребута она не поднимается вообще, пока утром кто-нибудь не зайдёт на сервер. Разбираю механику: почему пользовательский менеджер systemd умирает вместе с вашей сессией, что реально делает loginctl enable-linger, почему enable — это не про автозапуск при загрузке, и в каких случаях пользовательскую службу лучше вообще не заводить.
Служба живёт ровно столько, сколько живёт ваш логин
Классика жанра из моей практики: администратор разворачивает небольшой демон под непривилегированным пользователем, потому что «не хочу гонять это от root». Кладёт unit в ~/.config/systemd/user, делает systemctl --user daemon-reload, systemctl --user enable --now exporter.service, видит active (running), радуется и закрывает терминал. Через пару минут звонит бухгалтерия: выгрузка не приходит. Админ заходит обратно по SSH — сервис снова работает. И вот тут начинается мистика на два дня, хотя всё абсолютно детерминировано.
Механика простая. Когда вы логинитесь по SSH, PAM-модуль pam_systemd просит systemd-logind создать вам сессию. Logind заводит две вещи: session-N.scope, в который попадают процессы вашей оболочки, и user@UID.service — тот самый пользовательский менеджер systemd, который и запускает ваши --user юниты. Когда вы выходите, logind закрывает сессию. И, если у пользователя не включён linger, после закрытия последней сессии останавливается и user@UID.service — не мгновенно, а через UserStopDelaySec= из logind.conf, по умолчанию 10 секунд (это страховка на случай быстрого перелогина). Все ваши пользовательские юниты уезжают вместе с ним. Не «падают», не «крешатся» — их корректно останавливают, ровно так, как задумано.
Добивает картину настройка KillUserProcesses= в logind.conf: при значении yes процессы в scope-юните сессии убиваются при logout. Здесь важен нюанс, на котором путаются даже опытные люди. В апстримном systemd и в man logind.conf по умолчанию стоит yes, но дистрибутив может собрать пакет с другим значением — в Debian 13, например, страница руководства прямо говорит «Defaults to no». Поэтому сначала смотрите, что написано в man именно на вашей машине и в /etc/systemd/logind.conf.d/, а не в статье из интернета. Именно из-за этого параметра в своё время начали разбегаться tmux и screen, и на него чаще всего грешат, когда отваливается пользовательская служба. Но в нашем случае виноват не он: даже с KillUserProcesses=no пользовательский менеджер всё равно остановится после выхода, если нет linger. Это два разных механизма, и лечить надо второй.
# кто сейчас залогинен и какие сессии живы
loginctl list-sessions

# состояние пользовательского менеджера (UID подставьте свой)
systemctl status user@1002.service

# журнал именно менеджера — здесь видно Stopped User Manager for UID 1002
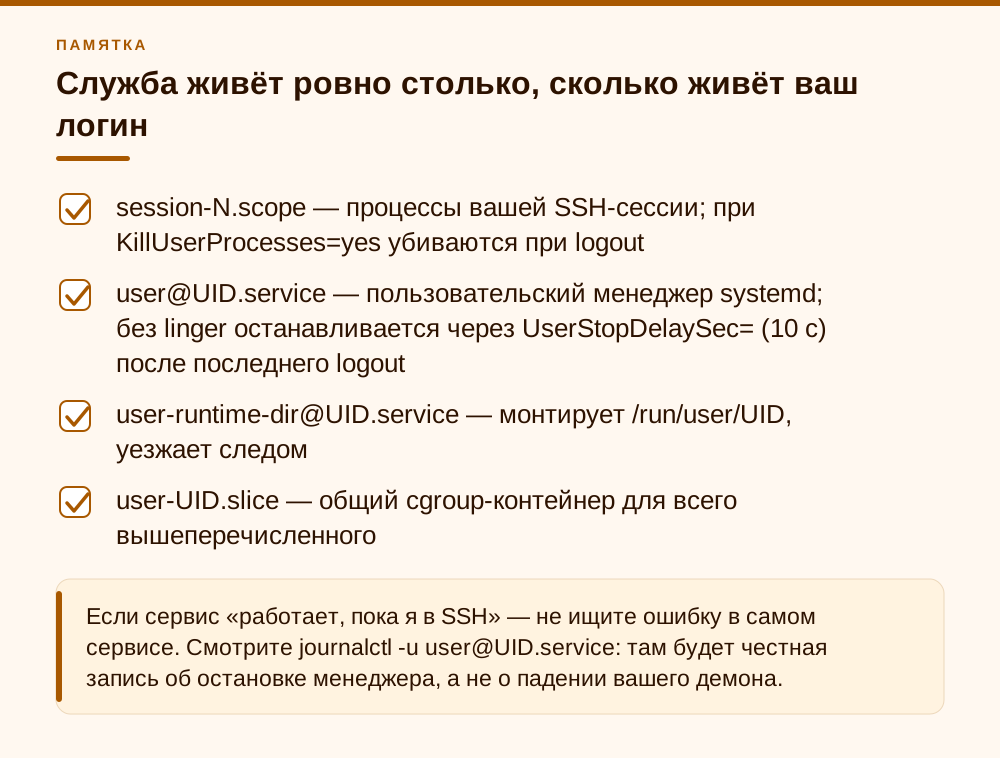
journalctl -u user@1002.service -b --no-pager | tail -30- session-N.scope — процессы вашей SSH-сессии; при KillUserProcesses=yes убиваются при logout
- user@UID.service — пользовательский менеджер systemd; без linger останавливается через UserStopDelaySec= (10 с) после последнего logout
- user-runtime-dir@UID.service — монтирует /run/user/UID, уезжает следом
- user-UID.slice — общий cgroup-контейнер для всего вышеперечисленного
loginctl enable-linger — одна команда, которая закрывает 90 % вопроса
Linger (буквально «задержаться») — это флаг у пользователя, который говорит logind две вещи сразу. Первое: запускать user@UID.service при загрузке системы, не дожидаясь ничьего входа. Второе: не останавливать его после выхода последней сессии. В мануале это сформулировано без лишних слов: «If enabled for a specific user, a user manager is spawned for the user at boot and kept around after logouts». Команда существует в systemd очень давно и есть везде, где вы сегодня можете оказаться — от Ubuntu 24.04 LTS (systemd 255) до Debian 13 trixie (systemd 257) и RHEL 10. Если аргумент не указан, linger включается для пользователя текущей сессии.
Команда принимает как имя пользователя, так и числовой UID. Технически включение linger — это создание пустого файла /var/lib/systemd/linger/<username>. Я специально это упоминаю, потому что при разборе чужой инфраструктуры быстрее один раз посмотреть содержимое каталога, чем опрашивать logind по каждому пользователю: сразу видно, для кого автозапуск предусмотрен, а для кого нет.
Проверять состояние надо машинно-читаемым способом, а не глазами по выводу status. Для этого есть loginctl show-user с ключом --property=: он отдаёт пары ключ=значение и отлично ложится в скрипты мониторинга. Я держу такую проверку в чек-листе приёмки сервера: если у сервисного пользователя Linger=no, а на нём висят --user юниты — это готовый инцидент, который выстрелит на ближайшем ребуте.
Есть и второй эффект, о котором вспоминают редко, а он влияет на поведение приложений. С включённым linger каталог /run/user/UID монтируется при загрузке системы и существует постоянно, а не появляется на время сессии и не сносится при выходе. Всё, что ваш демон складывает в XDG_RUNTIME_DIR — сокеты, pid-файлы, кэш, — перестаёт исчезать за спиной. На практике именно это чаще всего и объясняет плавающие баги вида «после моего захода на сервер первая обработка идёт втрое дольше»: пока linger выключен, рантайм-каталог обнуляется на каждом logout, и каждый новый вход начинается с холодного кэша. Учтите только, что это tmpfs: после перезагрузки содержимое всё равно пропадает. Проверить элементарно: ls -ld /run/user/1002 сразу после перезагрузки, не заходя в систему под этим пользователем.
# включить (для чужого пользователя нужен root или polkit-разрешение)
sudo loginctl enable-linger deploy

# проверить машинно-читаемо
loginctl show-user deploy --property=Linger
# Linger=yes

# то же самое «сырым» способом
ls -l /var/lib/systemd/linger/

# выключить
sudo loginctl disable-linger deploy- enable-linger применяется к пользователю, а не к службе — включили один раз, работает для всех его --user юнитов
- После включения /run/user/UID создаётся при загрузке и живёт постоянно, а не только на время сессии
- Флаг переживает перезагрузку: это файл на диске, а не рантайм-состояние
- Для своего собственного пользователя команда обычно проходит без sudo — через polkit
systemctl --user enable — это не «стартовать при загрузке»
Вторая половина проблемы — путаница с целями. Люди берут привычный системный шаблон, где в секции [Install] написано WantedBy=multi-user.target, копируют его в ~/.config/systemd/user и удивляются, что юнит «включён», но при старте менеджера не поднимается. Причина в том, что в пользовательском экземпляре systemd никакого multi-user.target нет — это цель системного менеджера. У пользовательского свой набор специальных юнитов (они перечислены в man systemd.special): default.target, sockets.target, timers.target, paths.target, shutdown.target, graphical-session.target и ещё несколько. В документации прямо сказано, что default.target — главная цель пользовательского менеджера и аналог multi-user.target системного, только это настоящий юнит, а не алиас. Так что для --user юнита правильная строка ровно одна: WantedBy=default.target.
Соответственно, systemctl --user enable exporter.service просто создаёт симлинк ~/.config/systemd/user/default.target.wants/exporter.service. Если WantedBy указывает на несуществующую цель, symlink уедет в каталог, который никто не вызывает, и юнит будет числиться enabled, оставаясь мёртвым. Проверяется это за секунду — посмотрите глазами, куда легла ссылка. Та же ловушка с After=network-online.target: этой цели в пользовательском менеджере тоже нет, поэтому такая строка в --user юните ничего не упорядочивает. Если скрипт должен дождаться сети, надёжнее научить его повторять попытки (Restart= с RestartSec= как раз для этого) или сделать службу системной. Кстати, RHEL в своих сгенерированных юнитах для rootless-контейнеров пишет WantedBy=multi-user.target default.target именно для того, чтобы один и тот же файл годился и в системном, и в пользовательском режиме.
Каталоги поиска пользовательских юнитов стоит держать в голове, потому что при разборе чужого сервера файл обнаруживается совсем не там, где вы его ищете. Если отбросить служебные каталоги для transient-юнитов, настроек через D-Bus (user.control) и генераторов, порядок приоритета сверху вниз такой: ~/.config/systemd/user ($XDG_CONFIG_HOME), $XDG_CONFIG_DIRS/systemd/user (по умолчанию /etc/xdg/systemd/user), /etc/systemd/user, $XDG_RUNTIME_DIR/systemd/user, /run/systemd/user, ~/.local/share/systemd/user ($XDG_DATA_HOME), $XDG_DATA_DIRS/systemd/user, /usr/local/lib/systemd/user и /usr/lib/systemd/user. Юниты из каталогов выше перекрывают одноимённые из каталогов ниже. Отдельно отмечу /etc/systemd/user — это способ раздать пользовательский юнит централизованно, из конфигурации, а не из домашнего каталога, что удобно, когда домашние каталоги на NFS или пересоздаются.
# ~/.config/systemd/user/exporter.service
[Unit]
Description=Выгрузка расписания из 1С в CSV
# After=network-online.target здесь бесполезен: в --user менеджере этой цели нет

[Service]
Type=simple
ExecStart=/opt/exporter/venv/bin/python /opt/exporter/run.py
Restart=always
RestartSec=10
Environment=PYTHONUNBUFFERED=1

[Install]
WantedBy=default.target- systemctl --user daemon-reload — обязателен после правки файла, иначе systemd работает по старой копии
- systemctl --user list-unit-files --state=enabled — что реально включено
- ls -l ~/.config/systemd/user/default.target.wants/ — куда легли симлинки
- systemctl --user cat exporter.service — какой файл системой реально прочитан, с учётом drop-in
Разбор с производства: студия звукозаписи «ЗвукГрад», 16 рабочих мест
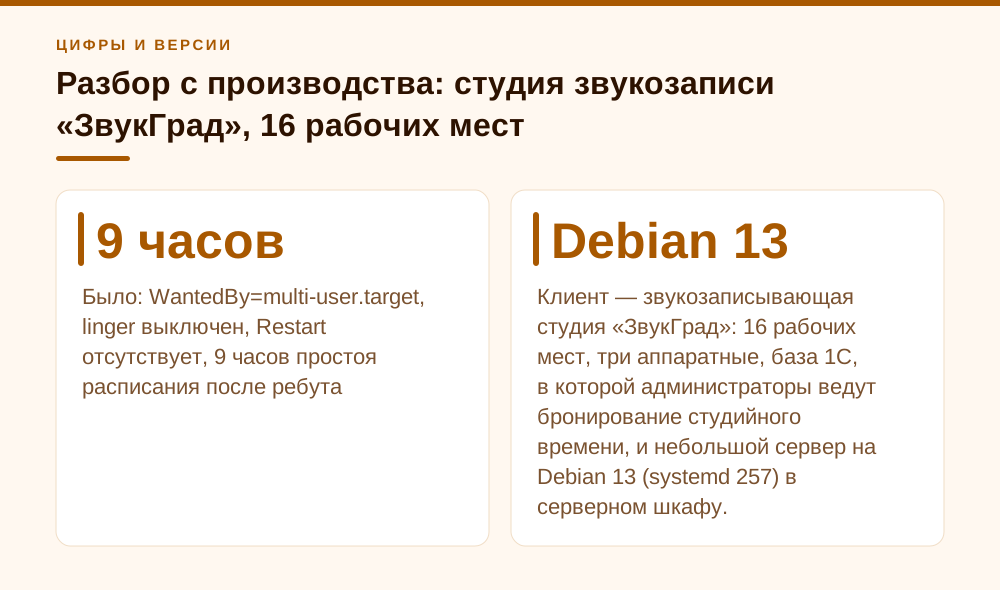
Клиент — звукозаписывающая студия «ЗвукГрад»: 16 рабочих мест, три аппаратные, база 1С, в которой администраторы ведут бронирование студийного времени, и небольшой сервер на Debian 13 (systemd 257) в серверном шкафу. Раз в пять минут на нём скрипт забирает брони из 1С по OData и складывает CSV, из которого строится расписание на планшетах у дверей аппаратных. Скрипт написал приходящий подрядчик, запустил под пользователем deploy (UID 1002) как пользовательскую службу — вполне здравое решение, чтобы не давать процессу лишних прав. Работало полтора месяца, потому что подрядчик после каждого визита оставлял открытую SSH-сессию в screen, и менеджер systemd для deploy жил за счёт неё.
Дальше произошло очевидное. Плановое обновление ядра, ребут в 03:40, никто не заходит на сервер до 12:50. Девять часов выгрузка не идёт, планшеты показывают вчерашнее расписание, и обнаружилось это самым неприятным способом: в полдень в одну аппаратную пришли два клиента с бронью на одно и то же время. Диагностика заняла минут пятнадцать: systemctl --user выдавал Failed to connect to bus, потому что я зашёл через sudo -u deploy, а не полноценной сессией; journalctl -u user@1002.service показал, что менеджер вообще ни разу не стартовал после загрузки. Каталог /var/lib/systemd/linger был пуст. В [Install] стояло WantedBy=multi-user.target, то есть даже если бы менеджер поднялся, служба не запустилась бы.
Что я сделал. Включил linger для deploy, переписал [Install] на default.target, пересоздал симлинк через disable/enable (важно: старый симлинк в multi-user.target.wants остался бы висеть мусором), убрал бесполезный After=network-online.target и добавил Restart=always с RestartSec=10 — у скрипта была привычка умирать на таймауте OData, а Restart в исходном юните отсутствовал вовсе. Сверху повесил простую проверку в мониторинг: раз в час от root выполняются loginctl show-user deploy --property=Linger и systemctl --user -M deploy@ is-active exporter.service. Итог за четыре месяца: пять перезагрузок сервера, ноль простоев выгрузки, три автоматических рестарта по таймауту OData, о которых никто даже не узнал.
Отдельная деталь, которая всплыла в процессе и стоила ещё часа. Скрипт складывал промежуточные файлы в /run/user/1002/exporter. Пока linger не был включён, этот каталог создавался при входе и уничтожался при выходе — его обслуживает системный юнит user-runtime-dir@1002.service, который удаляет /run/user/1002 при своей остановке. Кэш обнулялся, и первая после логина выгрузка всегда шла полным объёмом за квартал, около двух минут вместо двадцати секунд. С включённым linger каталог /run/user/1002 существует с момента загрузки системы. Но помните: это tmpfs, после перезагрузки он всё равно пуст, так что кэш, который должен переживать ребут, место в ~/.cache или StateDirectory=, а не в XDG_RUNTIME_DIR.
- Было: WantedBy=multi-user.target, linger выключен, Restart отсутствует, 9 часов простоя расписания после ребута
- Стало: WantedBy=default.target, Linger=yes, Restart=always/RestartSec=10, проверка linger и is-active в мониторинге
- Побочный выигрыш: /run/user/1002 не сносится при logout, первая выгрузка после входа ушла с двух минут до двадцати секунд
Грабли доступа: Failed to connect to bus в скриптах и Ansible
Самая частая вторичная проблема: вы всё настроили правильно, но проверить не можете. Заходите под root, делаете sudo -u deploy systemctl --user status exporter — и получаете Failed to connect to bus: $XDG_RUNTIME_DIR not defined либо No medium found / Permission denied. Причина в том, что sudo -u и su не регистрируют для целевого пользователя новую сессию в logind: pam_systemd либо вообще не стоит в их PAM-стеке, либо не создаёт сессию внутри уже существующей. Переменные XDG_RUNTIME_DIR и DBUS_SESSION_BUS_ADDRESS остаются от root или не выставляются вовсе, и systemctl не понимает, к какой шине пользовательского менеджера подключаться. Сам менеджер при этом жив и прекрасно работает — вы просто до него не достучались.
Лечится это тремя способами, и я использую все три в разных ситуациях. Самый переносимый — руками выставить XDG_RUNTIME_DIR и адрес шины. Самый честный — machinectl shell deploy@, который создаёт полноценную сессию через logind со всем положенным окружением (в Debian утилита лежит в отдельном пакете systemd-container). Самый короткий для одиночной проверки — systemctl --user -M deploy@: в man systemctl синтаксис ключа -M описан как имя контейнера с необязательным префиксом «пользователь@», а пустая правая часть означает локальный хост. Обратите внимание: первый способ работает только если /run/user/UID существует, то есть после включения linger или при активной сессии пользователя — иначе подключаться просто некуда.
В Ansible ровно та же история. Модуль ansible.builtin.systemd_service со scope: user требует, чтобы у become_user было валидное окружение сессии. Я в плейбуках задаю переменные окружения задачи явно и первым шагом всегда включаю linger — до того, как пытаться что-либо enable. Порядок здесь принципиален: если сначала делать enable, а linger включать после, то на «чистой» машине без интерактивного входа задача упадёт, и половина ролей об это спотыкается.
- export XDG_RUNTIME_DIR=/run/user/$(id -u deploy) и DBUS_SESSION_BUS_ADDRESS=unix:path=$XDG_RUNTIME_DIR/bus
- machinectl shell deploy@ — полноценная сессия со всем окружением
- systemctl --user -M deploy@ status exporter — обращение к чужому пользовательскому менеджеру от root
- В Ansible: сначала loginctl enable-linger, потом systemd_service со scope: user, не наоборот
Rootless-контейнеры: тот же linger, но цена ошибки выше
Отдельный класс ситуаций — rootless-контейнеры: Podman и rootless Docker. Здесь пользовательские юниты не экзотика, а основной рабочий сценарий, и забытый linger означает, что после перезагрузки хоста у вас не поднимется вообще ничего из контейнерной нагрузки. Red Hat в документации к RHEL 10 пишет об этом прямым текстом: чтобы служба стартовала при загрузке системы и переживала logout, нужен loginctl enable-linger. Всё остальное — enable, зависимости, targets — работает по тем же правилам, что и для обычных юнитов.
С rootless Docker картина та же. Установщик dockerd-rootless-setuptool.sh install заводит пользовательскую службу docker.service, управлять ей предлагается через systemctl --user start|stop|restart docker.service, а для старта при загрузке документация Docker прямо велит выполнить sudo loginctl enable-linger с именем пользователя. Клиенту при этом нужно указать сокет из рантайм-каталога — DOCKER_HOST=unix:///run/user/UID/docker.sock, — и это ещё одна причина, по которой без linger и /run/user/UID ничего не работает после ребута.
Что изменилось к 2026 году и о чём стоит знать, если вы переносите старые конфигурации: команда podman generate systemd объявлена устаревшей. Её не удаляют, критические баги чинят, но новых возможностей не будет, и рекомендуемый путь — Quadlet. Это генератор systemd, встроенный в сам Podman начиная с 4.4 (документация RHEL 10 ведёт отсчёт от поставляемой в дистрибутиве 4.6): вы кладёте короткий декларативный файл с расширением .container, .pod, .network, .volume, .kube, .image, .build или .artifact, а Quadlet при каждом daemon-reload превращает его в настоящий .service. Для rootless Quadlet ищет файлы в $XDG_RUNTIME_DIR/containers/systemd/, ~/.config/containers/systemd/, а для централизованной раздачи — в /etc/containers/systemd/users/${UID} и /etc/containers/systemd/users/.
Практический нюанс: юниты, порождённые Quadlet, нельзя enable в привычном смысле: документация Podman называет их transient с точки зрения systemd и прямо говорит, что systemctl enable к ним неприменим. Автозапуск задаётся секцией [Install] внутри самого .container-файла, и после daemon-reload сгенерированный сервис оказывается в default.target.wants уже в рантайме. Поэтому диагностика через ls ~/.config/systemd/user/default.target.wants/ тут не сработает — смотрите systemctl --user list-unit-files и /run/user/UID/systemd/generator/.
- podman generate systemd — deprecated, новые возможности не добавляются
- Quadlet — рекомендуемый путь начиная с Podman 4.4 (в RHEL — с 4.6), штатный в 5.x
- Rootless-каталоги Quadlet: $XDG_RUNTIME_DIR/containers/systemd/, ~/.config/containers/systemd/, /etc/containers/systemd/users/${UID}
- Rootless Docker: systemctl --user enable docker плюс sudo loginctl enable-linger USER, иначе демон не поднимется после ребута
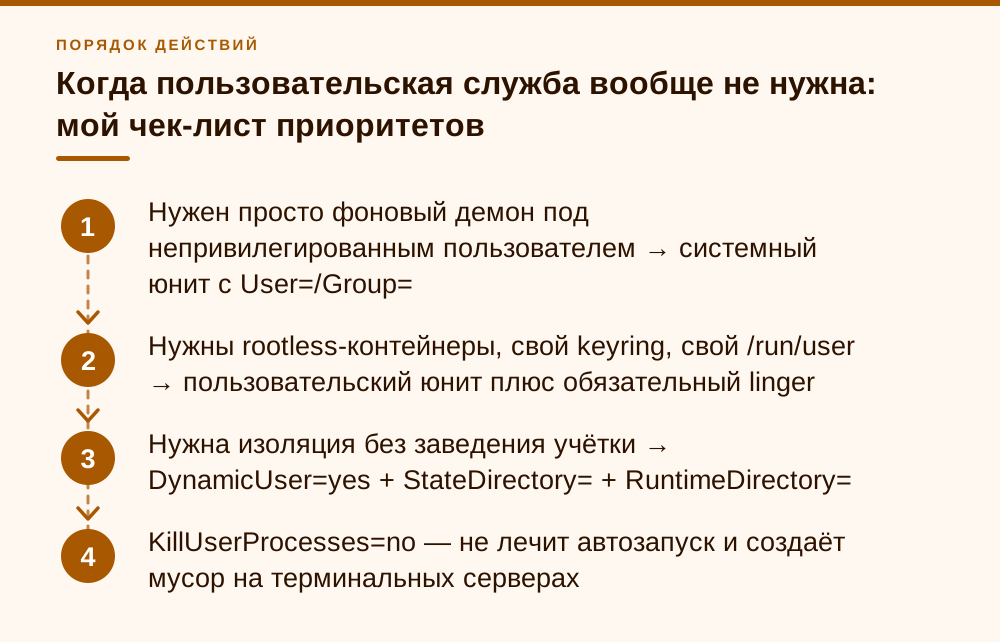
Когда пользовательская служба вообще не нужна: мой чек-лист приоритетов
Скажу прямо, потому что здесь единого мнения в сообществе нет и не будет. Пользовательские юниты — отличная штука для рабочих станций, для разработчиков, для rootless-контейнеров и для случаев, когда процессу реально нужны сессионные вещи вроде своего keyring или собственного /run/user. Но на боевом сервере, где нужен один фоновый демон под непривилегированным пользователем, я в девяти случаях из десяти беру обычный системный юнит с User= и Group=. Он стартует до всякого logind, не зависит от linger, не ломается при sudo -u, нормально виден в journalctl -u без плясок с шиной и не удивляет коллегу, который придёт разбираться после вас.
Ещё жёстче: если сервису не нужен домашний каталог, стоит посмотреть в сторону DynamicUser=yes вместе с StateDirectory= и RuntimeDirectory=. Systemd сам заведёт учётную запись на время работы юнита, сам создаст и почистит каталоги с правильными правами, и вам не придётся вообще заводить пользователя в системе. По изоляции это лучше, чем «сделал юзера deploy и положил всё в его домашний каталог». Спорный момент, о котором честно предупреждаю: DynamicUser плохо дружит со сценариями, где данные должны переживать смену UID или лежать в шаре, — там придётся возвращаться к статическому пользователю.
И про риск, который часто преувеличивают. Иногда предлагают «решить» проблему выхода из SSH настройкой KillUserProcesses=no в /etc/systemd/logind.conf. На Debian это и так значение по умолчанию — и служба всё равно умирает, что лучше любых аргументов показывает, что дело не в нём. Это не решение задачи автозапуска вообще: менеджер всё равно не поднимется при загрузке без linger. Плюс вы получаете побочный эффект — процессы пользователей перестают убираться после выхода, и на терминальном сервере это со временем превращается в свалку из брошенных ssh-agent и питоновских скриптов. Точечная альтернатива, если очень надо: KillExcludeUsers= для конкретной учётной записи. Root там исключён по умолчанию.
Мой порядок действий, когда прилетает задача «сделай, чтобы работало после ребута»: сначала выяснить, точно ли нужна именно пользовательская служба; если да — включить linger и проверить его машинно; затем привести [Install] к default.target и пересоздать симлинк; добавить Restart и RestartSec, потому что их забывают всегда; и только потом заводить мониторинг. На что можно забить: на тонкую настройку зависимостей внутри пользовательской иерархии и на попытки поймать порядок старта относительно системных юнитов — пользовательский менеджер всё равно не видит системных целей вроде network-online.target, так что в подавляющем большинстве случаев хватает корректного Restart= с разумным RestartSec= и повторных попыток в самом скрипте.
- Нужен просто фоновый демон под непривилегированным пользователем → системный юнит с User=/Group=
- Нужны rootless-контейнеры, свой keyring, свой /run/user → пользовательский юнит плюс обязательный linger
- Нужна изоляция без заведения учётки → DynamicUser=yes + StateDirectory= + RuntimeDirectory=
- KillUserProcesses=no — не лечит автозапуск и создаёт мусор на терминальных серверах
Частые вопросы
Чем systemctl --user enable отличается от loginctl enable-linger?
Это две независимые настройки. systemctl --user enable создаёт симлинк в ~/.config/systemd/user/default.target.wants/ и говорит пользовательскому менеджеру, что запускать при своём старте. loginctl enable-linger заставляет сам менеджер user@UID.service запуститься при загрузке системы и не останавливаться после выхода пользователя. Без linger enable отработает только тогда, когда вы залогинитесь, — то есть автозапуска при ребуте не будет.
Как проверить, включён ли linger, из скрипта мониторинга?
Командой loginctl show-user <имя_или_UID> --property=Linger — она отдаёт строку вида Linger=yes и предназначена именно для машинного чтения. Быстрая альтернатива при разборе чужого сервера: посмотреть содержимое каталога /var/lib/systemd/linger, где для каждого пользователя с включённым linger лежит пустой файл с его именем.
Почему systemctl --user выдаёт Failed to connect to bus, хотя служба работает?
Потому что вы попали в оболочку через sudo -u или su, а они не регистрируют новую logind-сессию целевого пользователя и не выставляют XDG_RUNTIME_DIR и адрес D-Bus. Сам менеджер при этом жив. Решения: выставить XDG_RUNTIME_DIR=/run/user/UID и DBUS_SESSION_BUS_ADDRESS вручную, зайти через machinectl shell user@ (пакет systemd-container) либо от root обратиться напрямую — systemctl --user -M user@ status unit.
Какой WantedBy писать в пользовательском юните?
WantedBy=default.target. Цели multi-user.target в пользовательском экземпляре systemd нет — это цель системного менеджера, и симлинк уедет в каталог, который никто не активирует. Если правите WantedBy у уже включённого юнита, обязательно сделайте systemctl --user disable, а затем enable, иначе останется висеть старый симлинк.
Поможет ли KillUserProcesses=no вместо linger?
Нет. Этот параметр влияет только на убийство процессов в scope-юните сессии, но не отменяет остановку пользовательского менеджера после последнего logout и уж точно не запускает его при загрузке. В Debian он и так по умолчанию no. На терминальных серверах выключение оставляет мусор из брошенных процессов. Если очень нужно исключение при KillUserProcesses=yes — точечно используйте KillExcludeUsers= для конкретной учётной записи.
Когда лучше вообще не использовать пользовательскую службу?
Когда вам нужен обычный фоновый демон под непривилегированной учётной записью. В этом случае системный юнит с User= и Group= проще: он стартует до logind, не зависит от linger, нормально читается в journalctl и не ломается при заходе через sudo -u. Пользовательские юниты оправданы для rootless-контейнеров, собственного keyring и сценариев, где процессу нужен свой /run/user.
Нужен ли linger для rootless Docker и Podman?
Да. И rootless Docker (docker.service в пользовательском менеджере), и Podman с Quadlet работают как --user юниты. Документация Docker и Red Hat прямо требует loginctl enable-linger для старта при загрузке. Для Quadlet автозапуск задаётся секцией [Install] с WantedBy=default.target в самом .container-файле, systemctl enable к сгенерированным юнитам неприменим.
Источники
- loginctl(1), man7.org — Команды enable-linger / disable-linger («a user manager is spawned for the user at boot and kept around after logouts»), show-user с --property=, terminate-user. https://man7.org/linux/man-pages/man1/loginctl.1.html
- logind.conf(5), man7.org (апстрим) — KillUserProcesses= (апстримный дефолт yes), KillOnlyUsers=/KillExcludeUsers= (root исключён по умолчанию), UserStopDelaySec= (10s), RuntimeDirectorySize=. https://man7.org/linux/man-pages/man5/logind.conf.5.html
- logind.conf(5), Debian 13 trixie — Сборка Debian: KillUserProcesses= «Defaults to no». https://manpages.debian.org/trixie/systemd/logind.conf.5.en.html
- systemd.special(7) — Раздел об юнитах пользовательского менеджера: default.target как главная цель --user, network-online.target только в системном менеджере. https://man7.org/linux/man-pages/man7/systemd.special.7.html
- systemd.unit(5), раздел «Unit File Load Path» — Полный список и порядок приоритета каталогов пользовательских юнитов. https://man7.org/linux/man-pages/man5/systemd.unit.5.html
- user@.service(5), Debian 13 trixie — user@UID.service запускается PID 1, user-runtime-dir@UID.service создаёт и удаляет /run/user/UID. https://manpages.debian.org/trixie/systemd/user@.service.5.en.html
- systemctl(1), Debian 13 trixie — Ключ -M/--machine= с синтаксисом «пользователь@контейнер» и .host. https://manpages.debian.org/trixie/systemd/systemctl.1.en.html
- RHEL 10, Building, running, and managing containers — Раздел «Porting containers to systemd by using Podman»: loginctl enable-linger <username>, WantedBy=multi-user.target default.target, Quadlet начиная с Podman v4.6. https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/building_running_and_managing_containers/porting-containers-to-systemd-using-podman
- podman-systemd.unit(5) — Quadlet — Каталоги поиска для rootless, расширения .container/.pod/.network/.volume/.kube/.image/.build/.artifact, невозможность systemctl enable для сгенерированных юнитов. https://docs.podman.io/en/latest/markdown/podman-systemd.unit.5.html
- podman-generate-systemd(1) — Уведомление о статусе deprecated и рекомендация Quadlet. https://docs.podman.io/en/latest/markdown/podman-generate-systemd.1.html
- Docker Docs — Rootless mode — systemctl --user для docker.service, sudo loginctl enable-linger для старта при загрузке, DOCKER_HOST=unix:///run/user/UID/docker.sock. https://docs.docker.com/engine/security/rootless/