
Как ограничить память одной Linux-службы, чтобы она не утянула за собой весь сервер
Если у вас на сервере живёт один прожорливый сервис — самописный сборщик, экспортёр, конвертер, кривой воркер на Python — рано или поздно он утащит за собой соседей. Причём убьют обычно не его, а базу: ядру всё равно, что для вас важно. В статье показываю, чем MemoryHigh отличается от MemoryMax и MemorySwapMax на уровне cgroup v2, как подобрать конкретные цифры вместо «ну поставим два гига», почему лимит иногда не работает (привет, родительский slice) и что делать после срабатывания OOM. С разбором стенда в коворкинге, конфигами и командами.
Три настройки, которые все путают
Ночью в субботу на сервере клиента упал PostgreSQL. Не потому что с базой что-то случилось — просто она была самым жирным процессом на машине, и когда самописный сборщик метрик в очередной раз распух до десяти гигабайт, ядро выбрало жертву по своим правилам. Ядру безразлично, что база — единственное, ради чего этот сервер вообще существует. Оно смотрит на oom_score и убивает того, кто освободит больше всего памяти за один раз. После пары таких ночей я перестал надеяться, что «оно само разрулится», и стал ставить лимиты руками.
Дальше начинается путаница. В systemd есть три директивы, которые на вид делают одно и то же, а на деле — совершенно разное. MemoryHigh= пишется в файл memory.high контрольной группы, MemoryMax= — в memory.max, MemorySwapMax= — в memory.swap.max. Это разные ручки ядра с разной семантикой, и подменять одну другой нельзя.
Формулировки из документации ядра стоит выучить наизусть. Про memory.high: «Memory usage throttle limit. If a cgroup's usage goes over the high boundary, the processes of the cgroup are throttled and put under heavy reclaim pressure» — и отдельно: «Going over the high limit never invokes the OOM killer and under extreme conditions the limit may be breached». То есть это тормоз, а не стена. Процессы начинают тупить, ядро агрессивно вычищает из группы страничный кэш и свопит анонимную память, но никого не убивает. И да — при особо злой утечке порог может быть пробит, это штатное поведение, а не баг.
Про memory.max формулировка другая: «Memory usage hard limit… If a cgroup's memory usage reaches this limit and can't be reduced, the OOM killer is invoked in the cgroup». Ключевое — «in the cgroup». Убивать будут внутри вашего юнита, а не по всей машине. Именно этого мы и добиваемся: пусть падает виновник, а не сосед. MemorySwapMax= стоит особняком — он ограничивает только своп и никак не участвует в подсчёте memory.max; значение infinity снимает ограничение полностью.
# /etc/systemd/system/telemetry-collector.service.d/limits.conf
[Service]
MemoryAccounting=yes
MemoryHigh=2G
MemoryMax=3G
MemorySwapMax=512M- MemoryHigh= → memory.high → троттлинг и агрессивный reclaim, без убийства, порог может быть превышен
- MemoryMax= → memory.max → жёсткий потолок, при недостижимости — OOM killer внутри юнита
- MemorySwapMax= → memory.swap.max → отдельный лимит именно на своп, infinity = без лимита
- MemoryMin= / MemoryLow= → memory.min / memory.low → наоборот, защита от вытеснения, а не ограничение
Сначала измерить, потом ограничивать
Самая частая ошибка, которую я вижу: админ читает статью, лезет в юнит и с ходу пишет MemoryMax=2G, потому что «два гига этой штуке точно хватит». Через неделю сервис начинает молча падать по ночам под нагрузкой, никто не понимает почему, лимит снимают — и всё возвращается к исходной точке. Так делать не надо. Сначала неделя наблюдений, потом цифры.
Проверьте, что вы вообще на cgroup v2: stat -fc %T /sys/fs/cgroup должно вернуть cgroup2fs. Все настройки, о которых идёт речь, работают в unified-иерархии; legacy-опция MemoryLimit= работала только с контроллером памяти cgroup v1, давно объявлена устаревшей в пользу MemoryMax= и в актуальной man-странице systemd.resource-control уже не описана — если встретите её в старом юните, переписывайте на MemoryMax=, а не надейтесь на совместимость. Учёт памяти задаётся DefaultMemoryAccounting= в systemd-system.conf, и в современных версиях он по умолчанию включён; на старых сборках проверьте это командой systemctl show -p DefaultMemoryAccounting и при необходимости пропишите MemoryAccounting=yes в самом юните.
Дальше смотрим факты. systemctl status в современных версиях показывает не только текущее потребление, но и пик за время жизни юнита — это самая полезная строчка в выводе. Более точные данные лежат прямо в файловой системе контрольных групп.
# что творится прямо сейчас, по группам
systemd-cgtop -m

# текущее и пиковое потребление конкретного юнита
systemctl status telemetry-collector.service | grep -i memory

# то же самое напрямую из cgroup v2
CG=/sys/fs/cgroup/system.slice/telemetry-collector.service
cat $CG/memory.current   # сколько занято сейчас, байт
cat $CG/memory.peak      # исторический максимум (если файла нет — ядро старое)
cat $CG/memory.events    # счётчики срабатываний high/max/oom/oom_kill
cat $CG/memory.pressure  # PSI: насколько сильно процессы стоят из-за памяти
Файл memory.events — это ваш детектор лжи. В нём шесть счётчиков, и два из них надо снимать в мониторинг обязательно: high («число раз, когда процессы группы были затроттлены и отправлены в прямой reclaim») и oom_kill («число процессов этой группы, убитых любым OOM-киллером»). Третий полезный счётчик — max: сколько раз потребление упиралось в memory.max и ядру пришлось чистить память прямо на границе. Учтите, что memory.events иерархический и включает события всех потомков; только собственные события группы лежат в memory.events.local. Если high растёт, а oom_kill стоит на нуле — лимиты подобраны нормально, сервис иногда прижимают, но не убивают. Если растёт oom_kill — вы задушили сервис слишком сильно.
- Неделя наблюдений через memory.peak или systemd-cgtop до любых лимитов
- memory.events.high — сколько раз сервис троттлили; memory.events.oom_kill — сколько раз убивали
- memory.pressure (PSI) — доля времени, которое процессы простояли в ожидании памяти
- Прогон вживую без правки юнита: systemd-run --scope -p MemoryMax=2G -p MemoryHigh=1G --unit=probe /path/to/binary
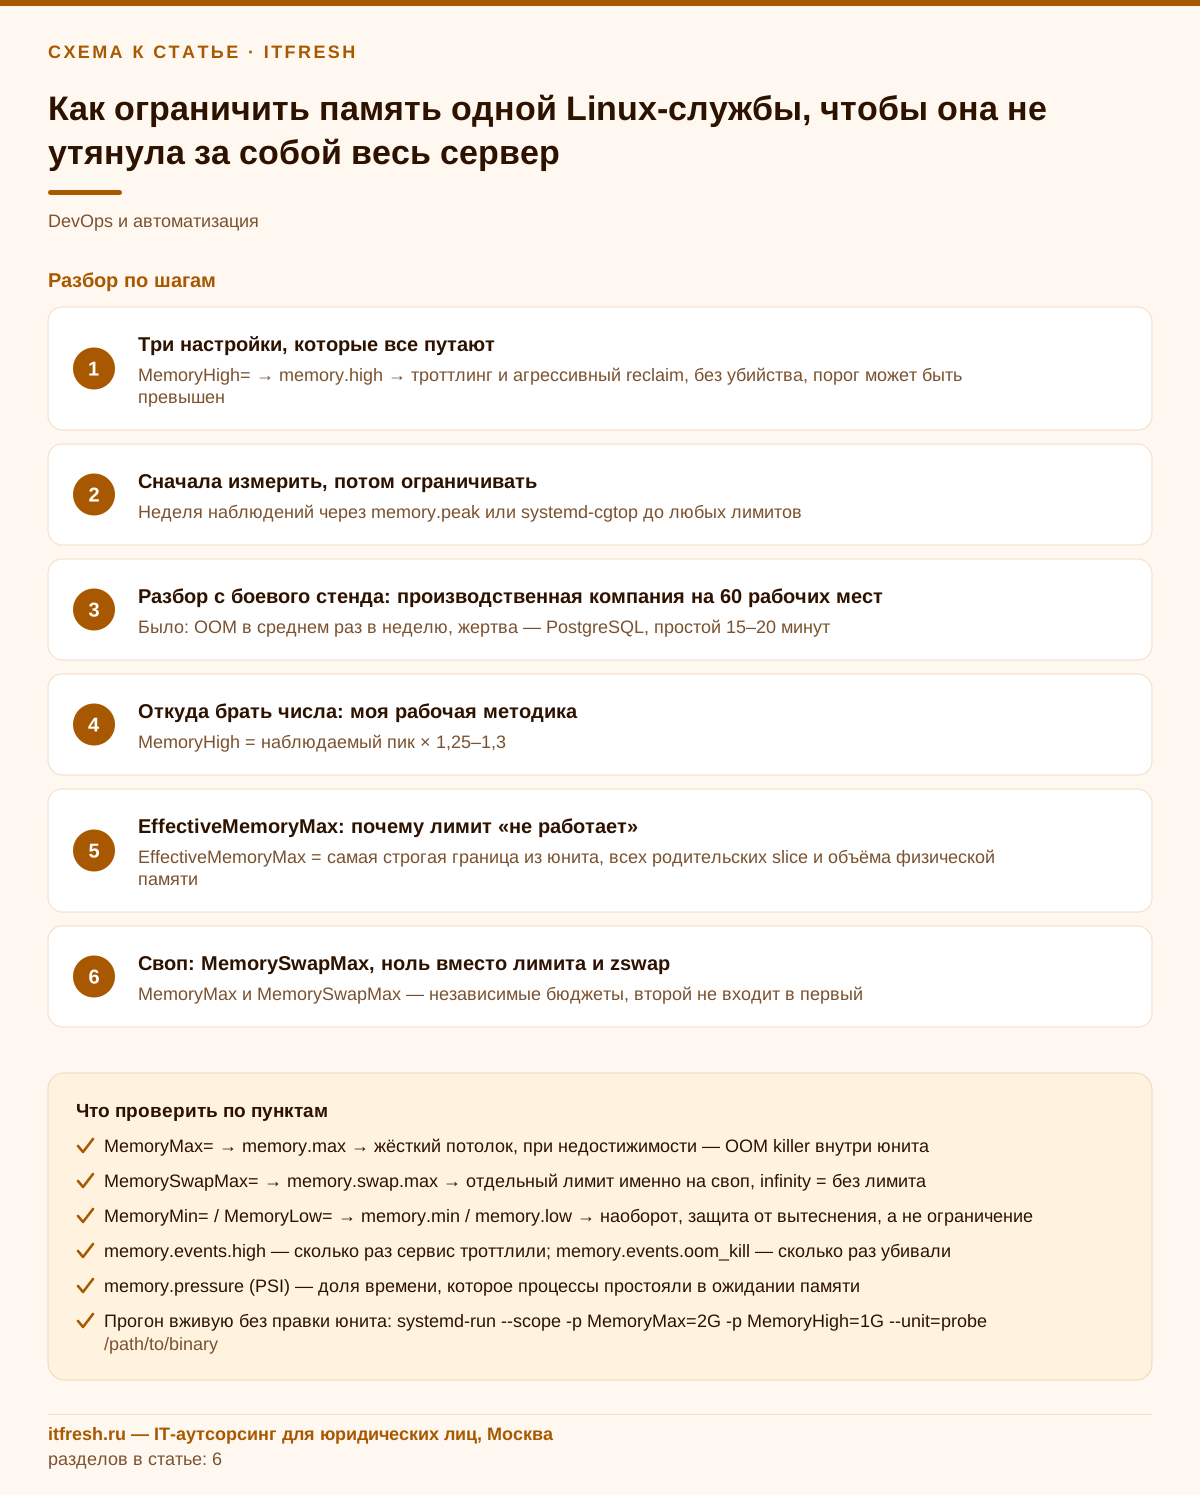
Разбор со стенда: коворкинг «ОткрытыйОфис» на 28 рабочих мест
Клиент — коворкинг «ОткрытыйОфис» на 28 рабочих мест: переговорки, СКУД на входе, гостевой Wi-Fi, пара МФУ и система бронирования. Виртуалка мониторинга на арендованном хосте в московском дата-центре: 4 vCPU, 16 ГБ RAM, Debian 13 trixie, systemd 257, cgroup v2 из коробки. На ней крутились PostgreSQL 16 под базу Zabbix (shared_buffers 4 ГБ), сам Zabbix server, nginx с фронтендом и наш самописный сборщик telemetry-collector.service — питон, requests плюс pandas, опрашивает контроллеры СКУД, точки доступа, МФУ и API бронирования и складывает агрегаты.
Симптом был такой: примерно раз в неделю, чаще под утро, в dmesg появлялась запись об OOM, а в логе PostgreSQL — «server process was terminated by signal 9: Killed» и уход всей базы в recovery. Простой 15–20 минут, мониторинг слепой, а утром администратор коворкинга звонит с вопросом, почему не приходят алерты о зависшем турникете. Разбор показал банальную утечку в коллекторе: он не освобождал накопленные DataFrame между циклами и за трое-четверо суток раздувался с 600 МБ до 10–11 ГБ. Ядро честно выбирало самого жирного — но самым жирным к этому моменту становился уже postgres со своим кэшем, и убивало именно его в половине случаев.
Чинить утечку в чужом коде — это отдельный проект на недели. Мне нужно было закрыть простои в тот же день. Я сделал две вещи: посадил коллектор в клетку и защитил базу от вытеснения. Наблюдения за семь дней дали честный рабочий пик коллектора 1,6 ГБ (без учёта утечки — это уже видно по форме графика: ровное плато плюс линейный рост сверху). Отсюда и цифры.
# /etc/systemd/system/telemetry-collector.service.d/limits.conf
[Service]
MemoryAccounting=yes
MemoryHigh=2G
MemoryMax=3G
MemorySwapMax=512M
OOMPolicy=stop
Restart=on-failure
RestartSec=15

[Unit]
# лимит частоты рестартов — это опции секции [Unit], не [Service]
StartLimitIntervalSec=600
StartLimitBurst=5
# /etc/systemd/system/postgresql@16-main.service.d/protect.conf
[Service]
MemoryAccounting=yes
MemoryMin=5G
MemoryLow=7G
ManagedOOMPreference=avoid# /etc/systemd/system/system.slice.d/protect.conf
# защита работает, только если такой же объём выделен предкам
[Slice]
MemoryMin=5G
MemoryLow=7GРезультат за полгода наблюдений: ни одного OOM-убийства postgres. Коллектор перезапускается сам примерно раз в трое-четверо суток, в журнале это видно строкой о срабатывании OOM внутри юнита, метрики теряются на 30–40 секунд — клиент этого не замечает. По memory.events за месяц: high около 4100 срабатываний, oom_kill — 9. То есть девять раз в месяц сервис доезжает до жёсткого потолка, а всё остальное время просто притормаживается на подходе к нему и отдаёт память обратно. Это ровно тот режим, к которому надо стремиться.
Отдельно про MemoryMin=5G на базе. Эта настройка не ограничивает postgres, а наоборот — защищает: пока потребление группы укладывается в эту границу, ядро не отбирает у неё память ни при каких условиях (memory.min — «hard memory protection»), а MemoryLow= даёт такую же защиту в режиме best-effort — страницы забирают у незащищённых соседей в первую очередь. Тонкость, на которой я сам споткнулся: по man systemd.resource-control защита, как правило, действует, только если соответствующий объём выделен и всем предкам, кроме корневого slice. Поэтому второй drop-in на system.slice — не украшение, без него эффективная граница у базы окажется нулевой. Без неё под давлением у базы отбирали page cache, и после каждого эпизода она минут двадцать заново читала с диска. С ней — не отбирают.
- Было: OOM в среднем раз в неделю, жертва — PostgreSQL, простой 15–20 минут
- Стало: жертва — только виновник, простой 30–40 секунд, автоперезапуск
- Утечку в коде это не чинит и не должно — это ремень безопасности, а не ремонт двигателя
- MemoryMin= на критичном сервисе даёт больше, чем MemoryMax= на нём же — но только вместе с такой же защитой на родительском slice
Откуда брать числа: моя рабочая методика
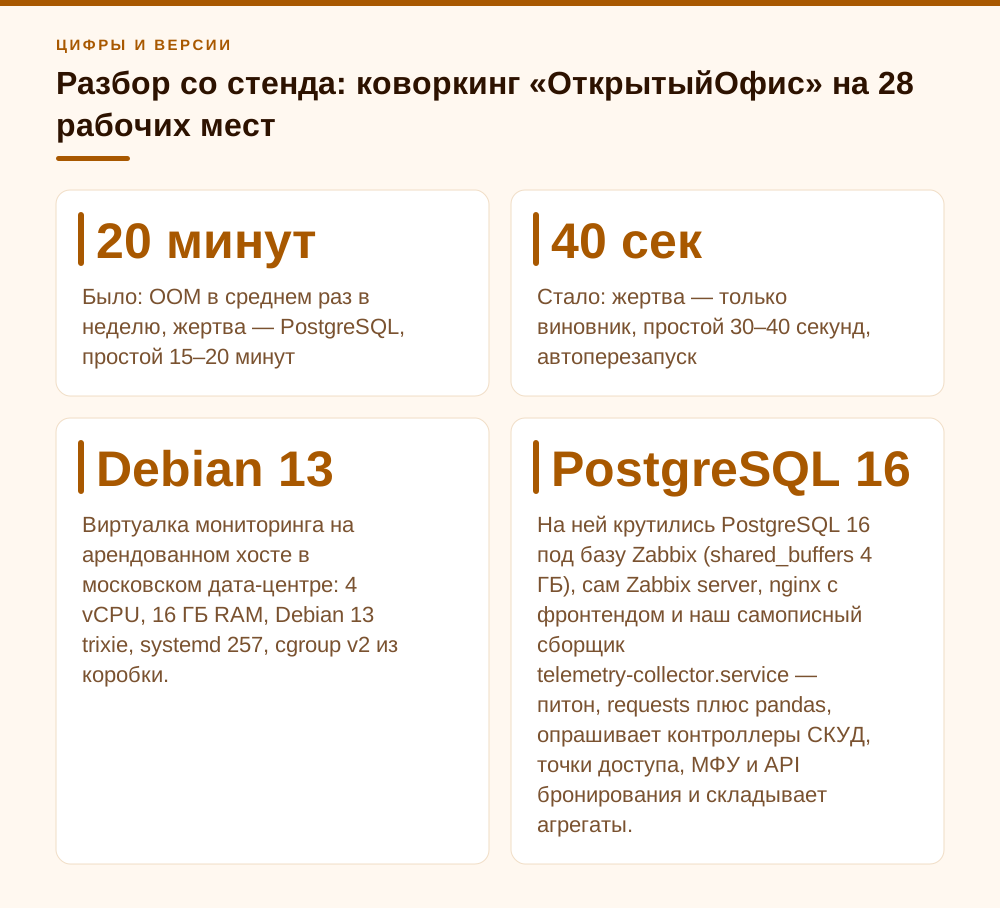
Я считаю так. Берём наблюдаемый пик за неделю с захватом самой тяжёлой нагрузки — в бухгалтерских конторах это закрытие месяца, на производстве конец смены, у веба вечерний прайм. Это база. MemoryHigh ставлю в 1,25–1,3 от этого пика: сервис в нормальной жизни туда не упирается, а при аномалии начинает буксовать заметно раньше, чем становится проблемой для соседей. MemoryMax — примерно в 1,5 от MemoryHigh, но никогда не ближе, чем полтора пика.
Зазор между High и Max важен принципиально. По моему опыту, если поставить их вплотную (скажем, 2G и 2,1G), троттлинг не успевает отработать: между «начали тормозить» и «убили» останутся доли секунды, и вы получите обычный OOM, только теперь ещё и настроенный своими руками. Если развести слишком далеко (2G и 16G), MemoryMax перестаёт быть защитой — до него никогда не дойдёт, а тормозить сервис будет часами.
Проценты вместо байтов — удобная штука для шаблонов: MemoryHigh=15% считается от установленной физической памяти системы. Я пользуюсь этим в ansible-ролях, которые едут на разнокалиберные машины. Но осторожно: на 8-гигабайтной VM пятнадцать процентов — это 1,2 ГБ, а на 128-гигабайтной — 19 ГБ. Один и тот же шаблон даст совершенно разное поведение. Если сервис потребляет фиксированный объём независимо от размера машины, пишите абсолютное значение.
И честно о том, где я лимиты не ставлю. На PostgreSQL, MS SQL, сервер 1С:Предприятие и вообще на всё, что имеет собственный менеджер памяти, MemoryMax я не вешаю. У них своя внутренняя бухгалтерия, и внешний обрубок приводит к странным падениям в самый неподходящий момент вместо аккуратной деградации. Там правильный инструмент — настройки самого продукта (shared_buffers, max server memory, лимит рабочих процессов) плюс MemoryMin= снаружи как защита. Лимиты имеет смысл ставить на всё остальное: воркеры, экспортёры, самописные сервисы, конвертеры, cron-задачи, обёрнутые в юнит, — то есть на код, который вы не контролируете и не собираетесь переписывать.
- MemoryHigh = наблюдаемый пик × 1,25–1,3
- MemoryMax = MemoryHigh × 1,5 (и не меньше пика × 1,5)
- Разрыв между High и Max меньше 30 % на практике почти бесполезен — троттлинг не успевает сработать (эмпирика, не норма документации)
- Проценты (`MemoryHigh=15 %`) считаются от физической памяти хоста — опасно в разнородном парке
- СУБД и сервер 1С — не трогать MemoryMax, только собственные настройки продукта плюс MemoryMin= снаружи
EffectiveMemoryMax: почему лимит «не работает»
Классическая ситуация, которая съедает у людей полдня. Поставили MemoryMax=8G, перезапустили, а сервис всё равно душится где-то на двух гигабайтах и в memory.events растёт high. Смотрят в юнит — там честные 8G. Смотрят в /sys/fs/cgroup — там memory.max=8589934592. Всё правильно, а работает не так.
Причина почти всегда в родительской иерархии. Контрольные группы вложенные: ваш юнит лежит в system.slice, а тот, в свою очередь, может иметь собственный лимит — например, кто-то до вас положил в /etc/systemd/system/system.slice.d/ файлик с MemoryMax=2G, или сервис вынесен в отдельный slice через Slice=. Ограничивает всегда самая строгая граница по всей цепочке вверх.
Именно для этого в systemd есть read-only свойства EffectiveMemoryHigh= и EffectiveMemoryMax=. Они показывают итог: наиболее строгий лимит самого юнита и всех родительских slice, плюс потолок по объёму физической памяти. Это первое, что надо смотреть при разборе.
systemctl show telemetry-collector.service \
  -p MemoryAccounting -p MemoryCurrent -p MemoryPeak \
  -p MemoryHigh -p MemoryMax -p MemorySwapMax \
  -p EffectiveMemoryHigh -p EffectiveMemoryMax

# кто ещё стоит над юнитом
systemd-cgls /sys/fs/cgroup/system.slice | head -30
systemctl show system.slice -p MemoryMax -p MemoryHigh
Отдельный slice под группу сервисов — вещь полезная, я так изолирую весь «зоопарк самописного» одним общим потолком. Смысл в том, чтобы пять кривых воркеров суммарно не съели больше, чем им отведено, даже если каждый по отдельности в свой лимит укладывается. Делается это одним файлом.
# /etc/systemd/system/apps.slice
[Unit]
Description=Slice for in-house workers
Before=slices.target

[Slice]
MemoryAccounting=yes
MemoryHigh=6G
MemoryMax=8G
# в каждом юните группы
[Service]
Slice=apps.sliceМенять лимиты на живом сервере удобно через systemctl set-property — он сам пишет drop-in и делает reload. Без ключей файл ложится в /etc/systemd/system.control/ и переживает перезагрузку; с ключом --runtime он оказывается в /run/systemd/system.control/ и исчезает после ребута. Второй вариант я использую при отладке: если подобрал лимит неудачно и намертво задушил сервис, достаточно перезагрузить машину, чтобы вернуться к исходному состоянию.
- EffectiveMemoryMax = самая строгая граница из юнита, всех родительских slice и объёма физической памяти
- `systemctl set-property foo.service MemoryMax=4G` — постоянный drop-in в /etc/systemd/system.control/
- `systemctl set-property --runtime foo.service MemoryMax=4G` — до ближайшей перезагрузки, /run/systemd/system.control/
- Общий slice поверх группы сервисов — единственный способ ограничить их суммарный аппетит
Своп: MemorySwapMax, ноль вместо лимита и zswap
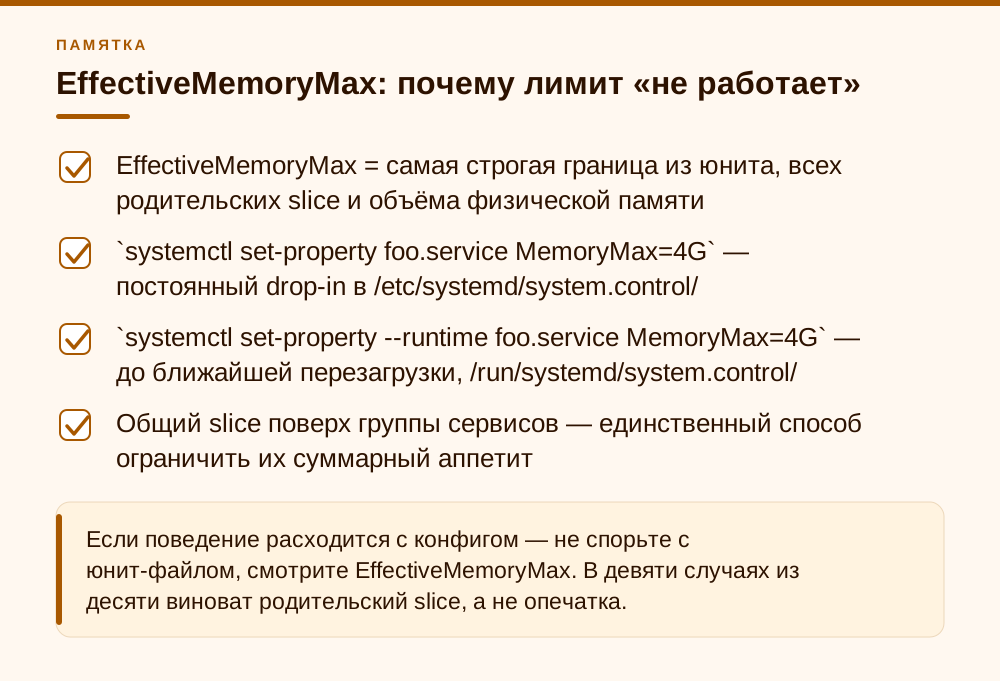
MemorySwapMax= управляет отдельным файлом memory.swap.max и живёт своей жизнью. Важный момент, который путают постоянно: MemoryMax не включает в себя своп. Это два независимых бюджета. Сервис с MemoryMax=3G и MemorySwapMax=infinity при активном свопе может суммарно занимать сильно больше трёх гигабайт — просто часть будет лежать на диске.
Отсюда самый частый выстрел в ногу: MemorySwapMax=0. Логика вроде понятная — «свопиться медленно, пусть лучше сразу падает». На практике это означает, что у ядра отбирают последний механизм отсрочки, и OOM внутри юнита приходит заметно раньше и резче. Для latency-критичного сервиса, где полсекунды задержки хуже перезапуска, это осмысленно. Для фонового воркера, который раз в сутки на минуту раздувается, — вредительство: без свопа он умрёт, со свопом переживёт пик и вернётся в норму.
Я обычно ставлю MemorySwapMax в небольшую конечную величину — 256–512 МБ на сервис. Это даёт запас на короткий всплеск, но не позволяет утёкшему процессу расписать в своп десяток гигабайт и утопить дисковую подсистему. Если свопа на машине нет вообще, настройка ни на что не влияет и её можно не писать.
Из свежего: MemoryZSwapMax= (появилась в systemd 253) ограничивает объём сжатого кэша zswap для юнита, а MemoryZSwapWriteback= (systemd 256) булевым флагом разрешает или запрещает выгрузку сжатых страниц на диск. Вторая штука точечно полезна для сервисов, которые сами интенсивно молотят диск: сжатие в памяти оставляем, а лишний ввод-вывод убираем. Обе доступны далеко не везде — на Debian 13 с systemd 257 они есть, на машинах с более старыми сборками их не будет, проверяйте перед раскаткой.
- MemoryMax и MemorySwapMax — независимые бюджеты, второй не входит в первый
- MemorySwapMax=0 ускоряет приход OOM — осознанный выбор, а не «безопасная настройка по умолчанию»
- Рабочий компромисс: 256–512 МБ свопа на сервис
- MemoryZSwapMax= с systemd 253, MemoryZSwapWriteback= с systemd 256 — проверяйте версию
Что делать после срабатывания: OOMPolicy, рестарты и systemd-oomd
Лимит сработал, процесс убит. Дальше поведение юнита определяет OOMPolicy= (появилась в systemd 243) — она говорит менеджеру служб, как реагировать, когда процесс юнита прибил ядерный OOM-киллер или systemd-oomd. Три значения. continue — событие пишется в журнал, юнит продолжает работать; для многопроцессных сервисов это часто означает наполовину живой сервис, который никого не обслуживает, но и не падает. stop — событие логируется, а оставшиеся процессы юнита штатно завершает сам менеджер служб. kill — ядру выставляется memory.oom.group=1, и оно добивает все остальные процессы юнита вместе с убитым. В обоих последних случаях служба оказывается в состоянии failed с результатом oom-kill, после чего может отработать Restart=.
Я в подавляющем большинстве случаев ставлю OOMPolicy=stop вместе с Restart=on-failure. Для обычных служб значение берётся из DefaultOOMPolicy= в systemd-system.conf, но я всё равно пишу его явно — чтобы поведение не зависело от глобального конфига конкретной машины. Логика простая: если один рабочий процесс убит из-за переполнения памяти, состояние остальных недоверенное, и честнее перезапустить сервис целиком, чем гадать. Исключение — юниты с Delegate=yes (контейнерные рантаймы и подобное), у них по умолчанию continue, и это правильно: они сами разбираются со своими потомками.
И обязательно ограничивайте частоту рестартов. Без StartLimitIntervalSec= и StartLimitBurst= (обе живут в секции [Unit]) сервис с утечкой, которая проявляется за секунды, войдёт в петлю «старт — сожрал память — убит — старт» и будет молотить диск и логи, пока кто-нибудь не заметит. Мой дефолт — не больше пяти стартов за десять минут, дальше systemd оставляет юнит в failed, а мониторинг присылает алерт живому человеку.
# что именно случилось и когда
journalctl -u telemetry-collector.service -b --grep 'oom|killed|memory' --case-sensitive=false

# ядерная версия событий
journalctl -k -b --grep 'Out of memory|oom-kill'

# счётчик убийств по юниту, для мониторинга
awk '/^oom_kill /{print $2}' /sys/fs/cgroup/system.slice/telemetry-collector.service/memory.events
Отдельный разговор — systemd-oomd. Это пользовательский демон, который не ждёт исчерпания памяти, а смотрит на давление PSI и убивает cgroup заранее. Дефолты по oomd.conf: SwapUsedLimit=90 %, DefaultMemoryPressureLimit=60 %, DefaultMemoryPressureDurationSec=30s. Чтобы он вообще смотрел на ваш юнит, нужно явно указать ManagedOOMMemoryPressure=kill (по умолчанию auto — «сам не мониторю, но могу быть выбран, если это включено у предка»). Обратная ручка — ManagedOOMPreference=avoid или omit: так я прошу oomd выбирать базу только в крайнем случае или не трогать её вовсе. В Ubuntu демон, как правило, включён из коробки, в Debian его чаще приходится ставить и включать отдельно — проверьте systemctl status systemd-oomd.
Моё мнение здесь спорное, скажу прямо. Я не считаю systemd-oomd заменой жёстким cgroup-лимитам и не ставлю его первой линией обороны. Он работает по статистике давления всей системы и иногда убивает не то, что вы бы выбрали руками, — а разбираться, почему прибили именно этот юнит, приходится по PSI-графикам постфактум. Конкретные MemoryHigh/MemoryMax на конкретной службе предсказуемее: вы точно знаете, кто умрёт и при каком числе. Oomd имеет смысл как второй эшелон на машинах с десятками разнородных сервисов, где расставить лимиты на каждый физически некому.
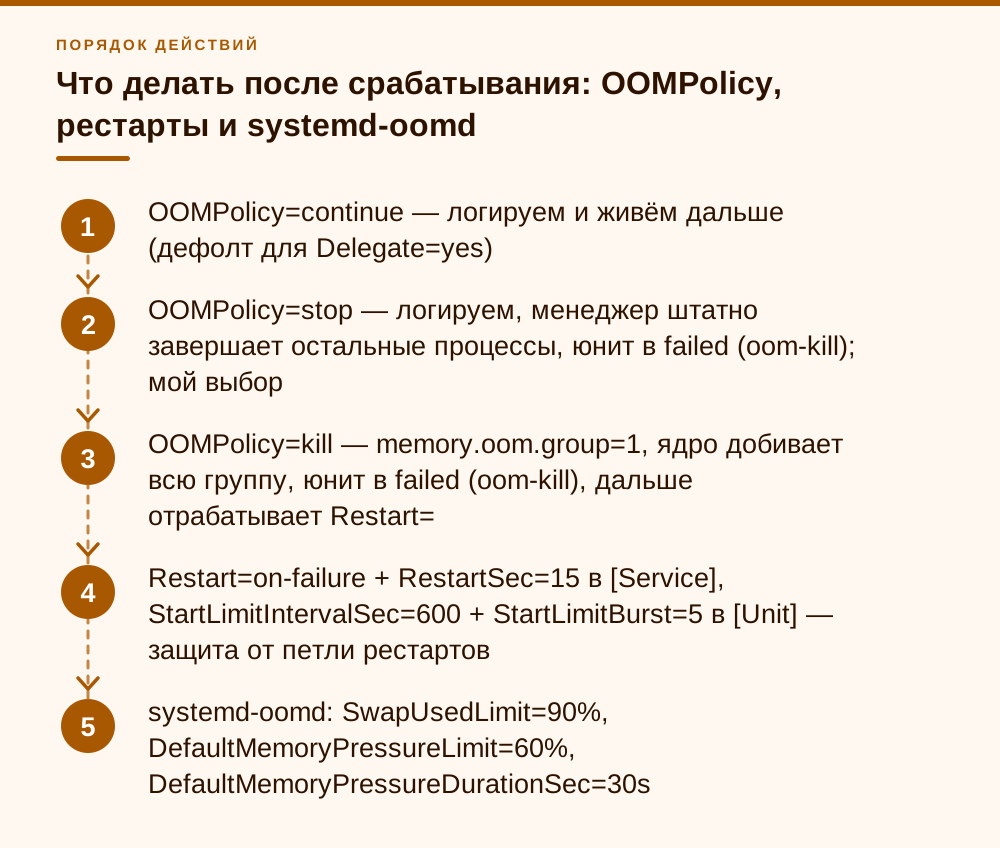
- OOMPolicy=continue — логируем и живём дальше (дефолт для Delegate=yes)
- OOMPolicy=stop — логируем, менеджер штатно завершает остальные процессы, юнит в failed (oom-kill); мой выбор
- OOMPolicy=kill — memory.oom.group=1, ядро добивает всю группу, юнит в failed (oom-kill), дальше отрабатывает Restart=
- Restart=on-failure + RestartSec=15 в [Service], StartLimitIntervalSec=600 + StartLimitBurst=5 в [Unit] — защита от петли рестартов
- systemd-oomd: SwapUsedLimit=90 %, DefaultMemoryPressureLimit=60 %, DefaultMemoryPressureDurationSec=30s
Чек-лист: с чего начать и на что можно забить
Если времени мало, а сервер уже падает, порядок действий такой. Первое — найти виновника: systemd-cgtop -m, посмотреть, кто растёт линейно. Второе — защитить главное, то есть повесить MemoryMin= на базу или на то, ради чего сервер существует; это одна строчка и она даёт эффект сразу. Третье — посадить виновника в клетку с MemoryHigh/MemoryMax по пику наблюдений и OOMPolicy=stop с Restart=on-failure. Четвёртое — вывести memory.events.oom_kill в мониторинг. Всё, авария закрыта, дальше можно спокойно ставить задачу на исправление утечки.
На что можно забить со спокойной совестью. Не надо расставлять лимиты на все юниты подряд — это создаёт больше проблем, чем решает, и через год никто не помнит, почему у ssh стоит потолок в 128 МБ. Не надо трогать системные юниты дистрибутива, их авторы обычно знают, что делают. Не надо гнаться за zswap-настройками, пока у вас не выжат обычный своп. И не надо изобретать обвязку на скриптах, которая убивает процессы по крону, — cgroup v2 делает это надёжнее и без гонок.
Про версии. Всё описанное работает на любой актуальной системе с cgroup v2: MemoryHigh= и MemoryMax= есть с systemd 231, MemorySwapMax= — с 232, OOMPolicy= — с 243, MemoryMin=/MemoryLow= — с 240. Практически это значит, что на Debian 13 (systemd 257), Ubuntu 24.04 (systemd 255) и более новых выпусках, на RHEL 9 (systemd 252) и новее ничего доустанавливать не нужно. Дополнительно проверяйте только свежие опции вроде MemoryZSwapWriteback=, которая появилась лишь в systemd 256.
- Найти виновника: systemd-cgtop -m, memory.peak по юнитам
- Защитить критичное: MemoryMin= на базу или ключевой сервис плюс такая же защита на родительском slice
- Ограничить виновника: MemoryHigh = пик×1,3, MemoryMax = High×1,5, OOMPolicy=stop, Restart=on-failure
- Вывести memory.events.oom_kill и memory.pressure в мониторинг
- Не ставить лимиты на СУБД, сервер 1С и системные юниты дистрибутива
Частые вопросы
Чем MemoryHigh отличается от MemoryMax простыми словами?
MemoryHigh — это тормоз, MemoryMax — стена. При превышении MemoryHigh ядро агрессивно отбирает у сервиса память и притормаживает его процессы, но никого не убивает; сам порог при этом может быть кратковременно пробит. При достижении MemoryMax, если потребление уменьшить не удалось, внутри контрольной группы юнита вызывается OOM killer. Рекомендованная схема из документации: MemoryHigh как основной механизм, MemoryMax как последний рубеж.
Я поставил MemoryMax=8G, а сервис душат на двух гигабайтах. Почему?
Почти наверняка ограничивает родительский slice. Действует всегда самая строгая граница по всей цепочке контрольных групп вверх. Посмотрите `systemctl show <unit> -p EffectiveMemoryMax -p EffectiveMemoryHigh` — эти свойства показывают итоговый эффективный лимит с учётом всех родителей и объёма физической памяти. Затем проверьте `systemctl show system.slice -p MemoryMax` и содержимое /etc/systemd/system/system.slice.d/.
Стоит ли ставить MemorySwapMax=0, чтобы сервис не свопился?
Только осознанно. Ноль полностью запрещает юниту уходить в своп, а значит лишает ядро последнего способа пережить кратковременный всплеск — OOM внутри юнита приходит раньше и резче. Для latency-критичных сервисов это оправдано, для фоновых воркеров чаще вредно. Я обычно ставлю конечную небольшую величину, 256–512 МБ: всплеск переживём, а утечка не распишет в своп десяток гигабайт.
Можно ли ограничить память сервису без перезапуска?
Да: `systemctl set-property foo.service MemoryMax=4G` применяет свойство на лету и сам пишет drop-in в /etc/systemd/system.control/ с последующим reload. С ключом --runtime настройка ложится в /run/systemd/system.control/ и исчезает после перезагрузки — удобно для отладки, когда есть риск задушить сервис неудачным значением. Для разового теста без правки конфигов подойдёт `systemd-run --scope -p MemoryMax=2G -p MemoryHigh=1G --unit=probe <команда>`.
Нужен ли systemd-oomd, если я уже расставил MemoryHigh и MemoryMax?
Как правило, нет — по крайней мере не как первая линия обороны. systemd-oomd действует по давлению памяти PSI (дефолты: SwapUsedLimit=90 %, порог давления 60 % на протяжении 30 секунд) и решает сам, какую контрольную группу убить, что менее предсказуемо, чем явный лимит на конкретной службе. Он полезен как второй эшелон на машинах с десятками разнородных сервисов, где физически некому расставить лимиты поимённо. Учтите, что мониторить ваш юнит он начнёт только при явном ManagedOOMMemoryPressure=kill.
Как понять, что лимиты подобраны правильно?
Смотрите /sys/fs/cgroup/system.slice/<unit>/memory.events. Счётчик high показывает, сколько раз сервис троттлили, oom_kill — сколько процессов убили. Здоровая картина: high потихоньку растёт, oom_kill близок к нулю или отражает известные аномалии. Если растёт oom_kill — лимит слишком жёсткий. Если оба счётчика нули месяцами — лимит стоит слишком высоко и защиты фактически нет.
У меня в старом юните стоит MemoryLimit=. Его можно оставить?
Лучше переписать. MemoryLimit= относится к контроллеру памяти cgroup v1, давно объявлен устаревшим в пользу MemoryMax= и в актуальной документации systemd.resource-control уже не описан. На системах с чистой cgroup v2 полагаться на него нельзя: замените на MemoryMax= (жёсткий предел) и при необходимости добавьте MemoryHigh= как троттлинг, затем `systemctl daemon-reload` и проверка через `systemctl show <unit> -p EffectiveMemoryMax`.
Источники
- systemd.resource-control(5) — Раздел «Memory Accounting and Control» — MemoryAccounting=, MemoryMin=, MemoryLow=, MemoryHigh= (added in version 231), MemoryMax= (231), MemorySwapMax= (232), MemoryZSwapMax= (253), MemoryZSwapWriteback= (256), EffectiveMemoryHigh=/EffectiveMemoryMax=, ManagedOOM*. https://man7.org/linux/man-pages/man5/systemd.resource-control.5.html
- Linux kernel documentation — Control Group v2 — Раздел «Memory Interface Files»: memory.high, memory.max, memory.swap.max, memory.events, memory.peak, memory.pressure, memory.oom.group. https://docs.kernel.org/admin-guide/cgroup-v2.html
- systemd.service(5) — Описание OOMPolicy= (значения continue/stop/kill, added in version 243) и его связи с DefaultOOMPolicy= и Restart=. https://man7.org/linux/man-pages/man5/systemd.service.5.html
- oomd.conf(5) — Дефолты systemd-oomd: SwapUsedLimit=90 %, DefaultMemoryPressureLimit=60 %, DefaultMemoryPressureDurationSec=30s. https://man7.org/linux/man-pages/man5/oomd.conf.5.html
- systemctl(1) — Команда set-property: «The changes are applied immediately, and stored on disk for future boots, unless --runtime is passed». https://man7.org/linux/man-pages/man1/systemctl.1.html
- systemd.unit(5) и journalctl(1) — StartLimitIntervalSec=/StartLimitBurst= — опции секции [Unit]; journalctl --grep и --case-sensitive. https://man7.org/linux/man-pages/man5/systemd.unit.5.html , https://man7.org/linux/man-pages/man1/journalctl.1.html