
Поставил work_mem=256MB — и сервер ушёл в OOM: как на самом деле считается память тяжёлых запросов в PostgreSQL 18
История, которую я вижу примерно раз в квартал. Ночной отчёт строился одиннадцать минут, админ поднял work_mem до 256MB, отчёт стал строиться сорок секунд, все довольны и никто не вспоминает об этом две недели. А потом в понедельник в десять утра сервер уходит в OOM, ядро убивает бэкенд, postmaster роняет все остальные соединения и уходит в crash recovery. В статье разбираю, что именно ограничивает work_mem в PostgreSQL 18, откуда берётся множитель в десять и двадцать раз, как я считаю бюджет памяти под тяжёлые запросы, почему выдавать память надо адресно, а не глобально, и чем это всё мерить, чтобы не гадать.
work_mem ограничивает операцию, а не запрос и не сессию
Это главное недоразумение, из которого растут все остальные. Документация PostgreSQL 18 формулирует прямо: work_mem задаёт «base maximum amount of memory to be used by a query operation (such as a sort or hash table) before writing to temporary disk files». Ключевых слов здесь два — base и operation. Не «на запрос», не «на сессию», не «на соединение». На одну операцию. Значение по умолчанию — 4MB, и оно действительно маленькое для любого современного сервера, но поднимать его вслепую нельзя именно потому, что это не потолок, а множимое.
Операция в этом контексте — это узел плана, которому нужна рабочая память: Sort, Incremental Sort, Hash (внутри Hash Join), HashAggregate, Materialize, Memoize, WindowAgg, а также HashSetOp для EXCEPT и INTERSECT. Один нетривиальный аналитический запрос спокойно содержит пять-восемь таких узлов, и каждый из них получает собственный бюджет в work_mem. Дальше документация добавляет второй множитель: «several running sessions could be doing such operations concurrently. Therefore, the total memory used could be many times the value of work_mem». То есть авторы Postgres прямым текстом предупреждают, что суммарный расход будет кратно больше — а мы это предупреждение стабильно пролистываем.
Отсюда типовая ошибка планирования: администратор берёт max_connections, умножает на work_mem, получает «ну максимум 200 × 256 МБ, но у нас же реально 30 сессий, значит 7,5 ГБ, влезаем». На самом деле 7,5 ГБ — это не верхняя граница, а очень грубая нижняя оценка, причём заниженная в разы. И вторая важная деталь: work_mem ничего не резервирует заранее. Это не пул и не квота, это разрешение выделить память по факту. Пока запросы лёгкие, вы вообще не видите проблемы — она проявится ровно в тот момент, когда несколько тяжёлых планов совпадут по времени.
Практическое следствие: рост work_mem не даёт линейного ухудшения. Он даёт спокойные недели, а потом одномоментный отказ. Именно поэтому такие инциденты всегда выглядят внезапными, хотя мина была заложена в момент правки конфига.
- Sort и Incremental Sort — каждый узел свой work_mem
- Hash в Hash Join — лимит work_mem × hash_mem_multiplier
- HashAggregate (GROUP BY, DISTINCT по хешу) — тоже с множителем
- Materialize — work_mem; Memoize — хеш-таблица, поэтому с множителем
- Bitmap Heap Scan — битмап ограничен work_mem, но при превышении не уходит на диск, а становится lossy (перепроверка строк на странице)
- Material, Window Aggregate и CTE — в PG 18 EXPLAIN ANALYZE наконец показывает их расход памяти и диска
Арифметика: откуда берётся расход в двадцать раз больше
Множителей три, и они перемножаются. Первый — количество узлов в плане, о нём выше. Второй — hash_mem_multiplier. Документация PG 18: «The final limit is determined by multiplying work_mem by hash_mem_multiplier. The default value is 2.0, which makes hash-based operations use twice the usual work_mem base amount». То есть при work_mem = 256MB один-единственный Hash Join имеет полное право взять 512 МБ, и это штатное поведение по умолчанию, а не аномалия. Множитель поставили 2.0 не случайно: хеш-узлы гораздо болезненнее реагируют на нехватку памяти, чем сортировки, и разработчики сознательно дали им больше воздуха.
Третий множитель — параллелизм, и он самый недооценённый. По умолчанию max_parallel_workers_per_gather = 2, max_parallel_workers = 8. Документация про параллельные запросы: «Resource limits such as work_mem are applied individually to each worker, which means the total utilization may be much higher across all processes than it would normally be for any single process. For example, a parallel query using 4 workers may use up to 5 times as much CPU time, memory, I/O bandwidth, and so forth as a query which uses no workers at all». Пять раз, а не четыре, потому что лидирующий процесс тоже выполняет свою часть плана и тоже держит свои хеш-таблицы.
Соберём это в одну прикидку худшего случая на один запрос. Пусть в плане три хеш-узла и два узла сортировки, work_mem = 256MB, hash_mem_multiplier = 2.0, два параллельных воркера. Получаем (3 × 512 МБ + 2 × 256 МБ) = 2048 МБ на один процесс, и это надо умножить на три процесса (лидер плюс два воркера) — почти 6 ГБ на один отчёт. Пять таких отчётов, запущенных дашбордом одновременно, дают 30 ГБ. На сервере с 32 ГБ RAM, у которого 8 ГБ уже забраны shared_buffers, финал предсказуем.
Формула для быстрой прикидки, которую я держу в голове: пик ≈ N_сессий × (1 + workers) × (N_hash × work_mem × hash_mem_multiplier + N_sort × work_mem). Худший случай достигается редко — реальные хеш-таблицы часто меньше лимита, а планировщик не всегда берёт максимум воркеров. Но проектировать надо от него, потому что цена ошибки здесь не «медленно», а «сервер лёг».
- Множитель 1: количество memory-узлов в плане (обычно 3–8 у аналитики)
- Множитель 2: hash_mem_multiplier, по умолчанию 2.0 для всех хеш-операций
- Множитель 3: (1 + число параллельных воркеров), по умолчанию до 3
- Множитель 4: количество одновременных тяжёлых сессий
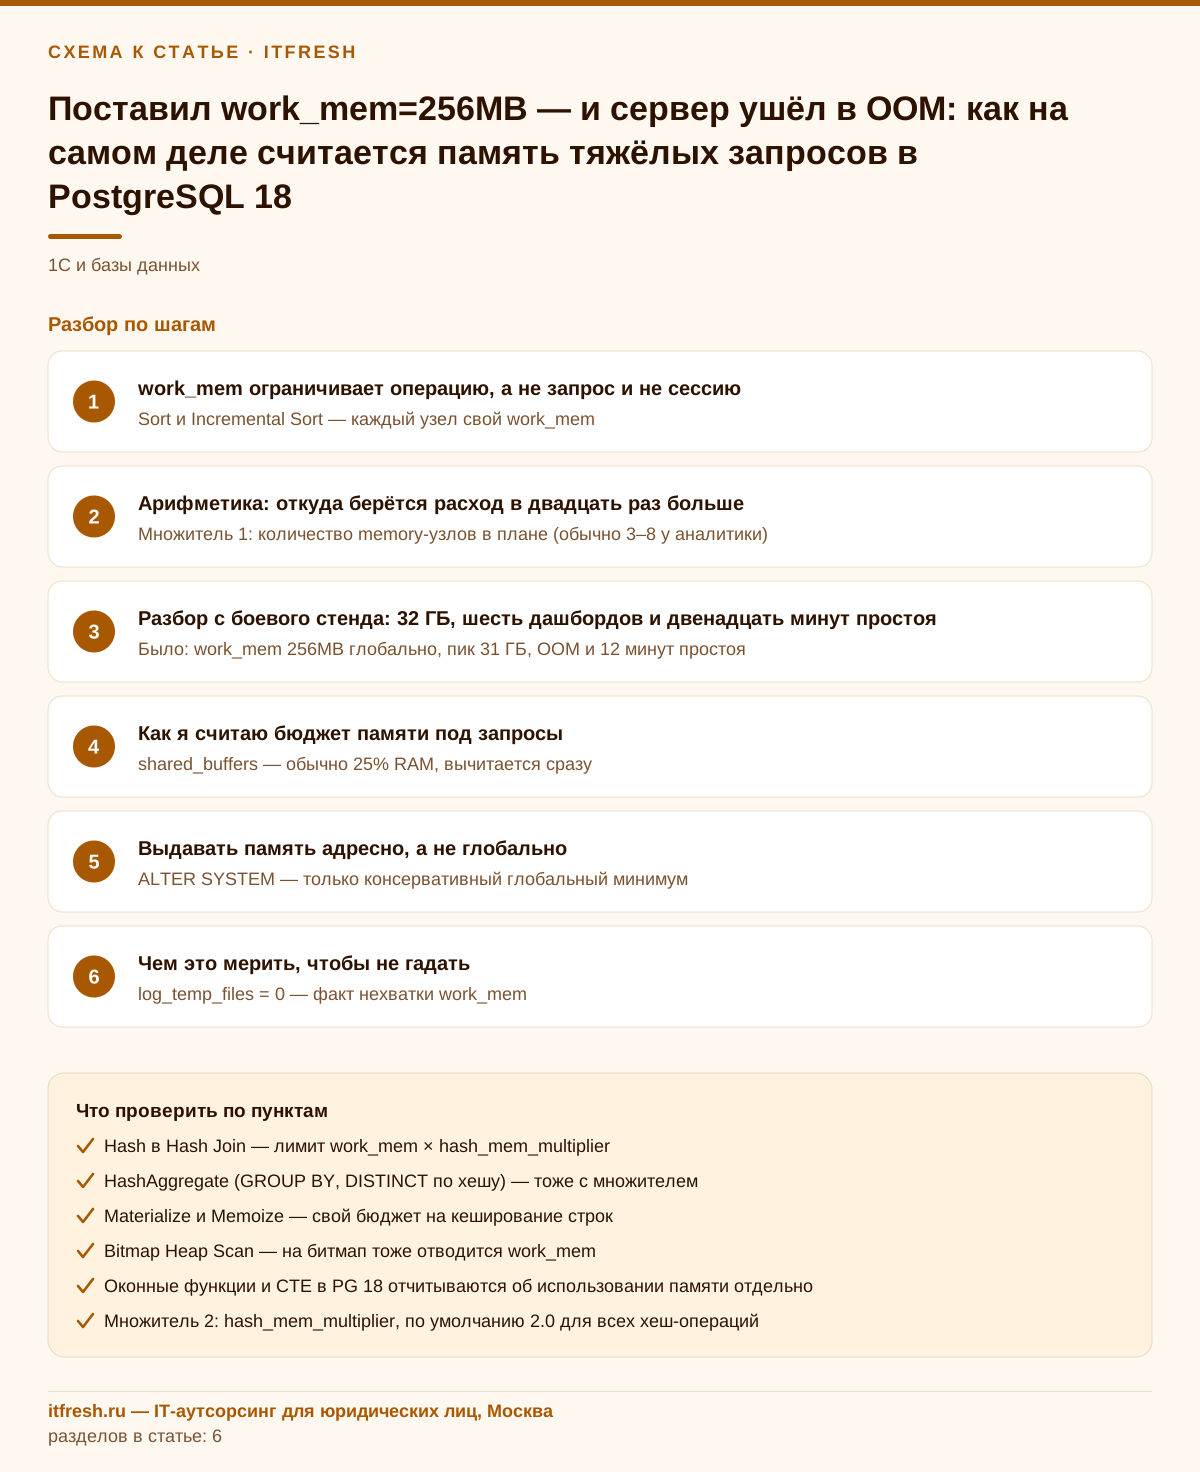
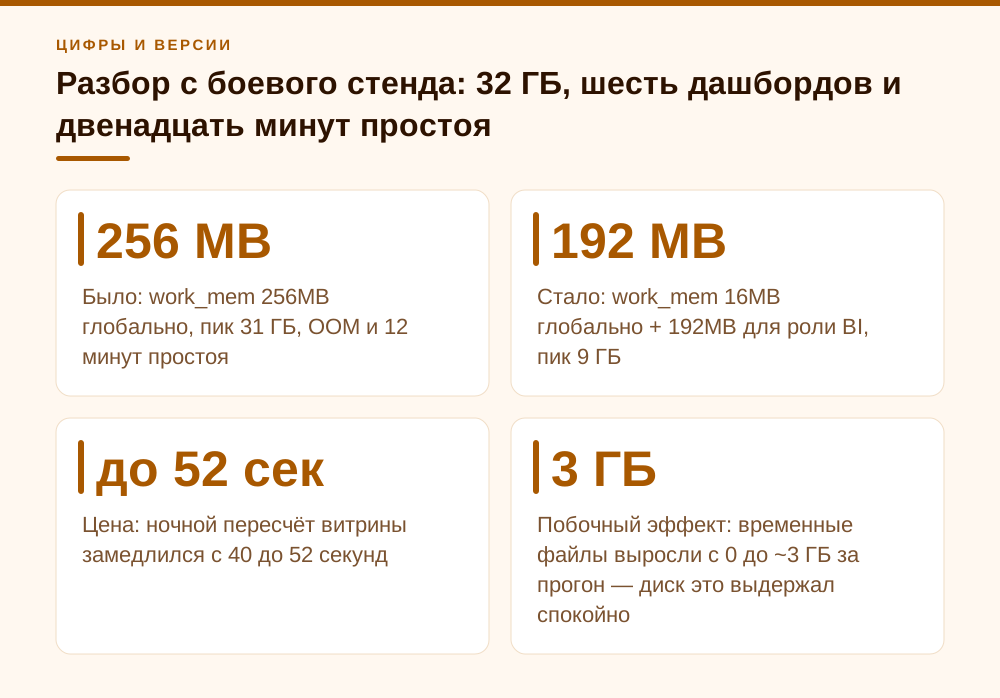
Разбор с боевого стенда: 32 ГБ, шесть дашбордов и двенадцать минут простоя
Клиент — маркетинговое агентство «Маркетинговая мастерская», 49 рабочих мест. Кроме 1С у них есть своя аналитика: выгрузки из рекламных кабинетов, CRM и коллтрекинга складываются в отдельную базу, над которой висит BI-панель для аккаунт-директоров и руководителей клиентских групп. База живёт на отдельной виртуалке: 8 vCPU, 32 ГБ RAM, NVMe, PostgreSQL 18 на Debian. Профиль нагрузки — витрины сквозной аналитики по кампаниям и клиентам, 20–30 активных сессий, из них тяжёлых обычно две-три, но по понедельникам утром, перед планёрками по клиентам, все открывают дашборды одновременно.
Исходный конфиг был почти дефолтный: shared_buffers = 8GB, effective_cache_size = 24GB, max_connections = 200, work_mem = 4MB. Ночной пересчёт витрины расходов и лидов по кампаниям шёл 11 минут и писал во временные файлы порядка 14 ГБ — классическая картина недостатка work_mem. Приходящий админ, который вёл этот сервер до нас, сделал ровно то, что советует любая статья из первой десятки выдачи: ALTER SYSTEM SET work_mem = '256MB'; и перезагрузил конфиг. Отчёт стал строиться 40 секунд. Победа держалась девять дней.
На десятый день, в 09:41 понедельника, в логе появилось «server process was terminated by signal 9: Killed», следом «terminating any other active server processes» и уход в crash recovery. В dmesg — oom-killer, жертвой оказался бэкенд с RSS около 5 ГБ. Все клиентские соединения оборвались, восстановление заняло около двух минут, но реальный простой с учётом холодного кеша и повторного захода пользователей вышел примерно двенадцать минут. Разбор по логам показал: в 09:40 стартовали шесть сессий BI, у каждой в плане два Hash Join, один HashAggregate и один Sort, планировщик брал по два воркера. Считаем: (3 × 512 + 1 × 256) = 1792 МБ на процесс, × 3 процесса = 5,25 ГБ на сессию, × 6 сессий ≈ 31 ГБ. Плюс 8 ГБ shared_buffers. При 32 ГБ физической памяти.
Итоговый рабочий конфиг этой виртуалки выглядит так — привожу целиком, потому что важен именно набор, а не отдельная строка:
# postgresql.conf
shared_buffers = 8GB
effective_cache_size = 24GB
work_mem = 16MB                     # глобально — консервативно
hash_mem_multiplier = 2.0
maintenance_work_mem = 1GB
autovacuum_work_mem = 256MB         # чтобы 3 воркера не съели 3 ГБ
max_parallel_workers = 8
max_parallel_workers_per_gather = 2
temp_file_limit = 16GB
log_temp_files = 0
и адресная выдача памяти отчётной роли:
ALTER ROLE bi_reports SET work_mem = '192MB';
ALTER ROLE bi_reports SET max_parallel_workers_per_gather = 1;
ALTER ROLE bi_reports SET temp_file_limit = '8GB';
Что сделали. Глобальный work_mem вернули на 16MB — этого хватает подавляющему большинству OLTP-запросов и не создаёт риска. Для роли, под которой ходит BI, выдали память адресно: 192MB и один воркер вместо двух. Ограничили временные файлы через temp_file_limit, включили log_temp_files, добавили ограничение параллелизма на уровне кластера. Итог: тот самый ночной пересчёт стал строиться 52 секунды вместо 40 — потеряли двенадцать секунд, зато пиковое потребление памяти в понедельник упало с 31 до 9 ГБ, и за последующие полгода OOM не случился ни разу. Двенадцать секунд против двенадцати минут простоя — по-моему, размен очевидный.
- Было: work_mem 256MB глобально, пик 31 ГБ, OOM и 12 минут простоя
- Стало: work_mem 16MB глобально + 192MB для роли BI, пик 9 ГБ
- Цена: ночной пересчёт витрины замедлился с 40 до 52 секунд
- Побочный эффект: временные файлы выросли с 0 до ~3 ГБ за прогон — диск это выдержал спокойно
Как я считаю бюджет памяти под запросы
Я не пользуюсь популярной формулой вида (RAM × 0.25) / max_connections. Она игнорирует и множители из плана, и hash_mem_multiplier, и параллелизм, а заодно исходит из фантазии, что все сто соединений одновременно сортируют по гигабайту. В реальности картина другая: тяжёлых запросов одновременно почти всегда единицы, зато каждый из них жирнее, чем кажется. Поэтому считать надо от вопроса «сколько одновременно тяжёлых запросов я готов обслужить», а не от max_connections.
Мой порядок действий такой. Сначала считаю, сколько памяти вообще доступно под запросы: RAM минус shared_buffers, минус запас на страничный кеш и ОС (я оставляю 15–20 % — Postgres очень зависим от page cache, и отдавать его целиком нельзя), минус autovacuum_max_workers × maintenance_work_mem, минус память под сами процессы бэкендов (грубо 5–10 МБ на соединение плюс кеш планов). То, что осталось, делю на планируемое число тяжёлых сессий, потом ещё на (1 + workers) и на ожидаемое количество memory-узлов с учётом множителя. Получается консервативная цифра — и это правильно, потому что ошибка в консервативную сторону стоит секунд, а в другую — минут простоя.
Отдельно про maintenance_work_mem. По умолчанию это 64MB, и его почти всегда поднимают ради скорости VACUUM и CREATE INDEX. Логика документации здравая: «Since only one of these operations can be executed at a time by a database session, and an installation normally doesn't have many of them running concurrently, it's safe to set this value significantly larger than work_mem». Но у autovacuum есть свои воркеры, и если autovacuum_work_mem не задан, каждый из них берёт maintenance_work_mem. Ставите 2GB при трёх воркерах — получаете 6 ГБ невидимого расхода, который в вашей табличке бюджета не учтён. Я обычно задаю autovacuum_work_mem отдельно и меньшим значением.
Пример счёта для той же машины на 32 ГБ: 32 − 8 (shared_buffers) − 5 (запас ОС и page cache) − 1,5 (autovacuum) − 1,5 (бэкенды) ≈ 16 ГБ на запросы. Планируем 6 одновременных тяжёлых сессий и один воркер на запрос: 16 / 6 / 2 ≈ 1,3 ГБ на процесс. При четырёх memory-узлах, из которых три хеш-овые: 1,3 ГБ / (3 × 2.0 + 1) ≈ 185 МБ. Отсюда и взялись те самые 192MB для роли BI — цифра не с потолка, а из арифметики.
- shared_buffers — обычно 25 % RAM, вычитается сразу
- page cache и ОС — оставляю 15–20 % RAM, не трогаю
- autovacuum_max_workers × autovacuum_work_mem (или maintenance_work_mem, если не задан)
- ручные VACUUM / CREATE INDEX / REINDEX — ещё по maintenance_work_mem на каждый
- 5–10 МБ на каждое соединение просто за факт существования бэкенда
- и только остаток — под work_mem с учётом всех множителей
Выдавать память адресно, а не глобально
Главный практический вывод из всей этой арифметики: work_mem почти никогда не надо крутить глобально. Глобальное значение должно быть таким, чтобы его не жалко было умножить на все возможные множители — 8–32 МБ для типичного сервера под смешанную нагрузку. А память тяжёлым запросам выдаётся точечно, на трёх уровнях: роль, база и транзакция. Это ровно тот случай, когда правильное решение не сложнее неправильного, просто про него реже пишут.
Уровень роли — мой рабочий инструмент номер один. Заводится отдельная роль для BI, ETL или ночных регламентов, ей выдаются повышенный work_mem и одновременно урезанный параллелизм, и всё остальное приложение живёт на скромном глобальном значении. Уровень транзакции нужен, когда тяжёлый запрос запускается разово или из скрипта: SET LOCAL действует до конца транзакции и гарантированно откатывается, что бы ни случилось. Одна деталь, о которую спотыкаются: значения из ALTER ROLE ... SET и ALTER DATABASE ... SET применяются только при старте новой сессии. Уже открытые соединения пула продолжают жить со старым work_mem, пока их не переоткрыть, — проверять результат надо через SHOW в свежей сессии, а не в той, где вы только что выполнили ALTER ROLE.
И тут же ловушка, на которой я видел несколько инцидентов подряд. Если между приложением и базой стоит PgBouncer в режиме transaction pooling, обычный SET work_mem прилипает к серверному соединению и утекает следующему клиенту, который об этом не просил. Через полчаса у вас половина пула ходит с чужим work_mem = 512MB, и никто не понимает, откуда пик памяти. В transaction pooling допустим только SET LOCAL внутри явной транзакции — либо настройки через ALTER ROLE, которые применяются при установке серверного соединения корректно.
hash_mem_multiplier тоже стоит воспринимать как ручку, а не как константу. Если в ваших отчётах доминируют сортировки, а не хеш-соединения, снижение множителя до 1.0 для конкретной роли режет пиковое потребление почти вдвое и часто вообще не заметно по времени. Обратная ситуация — тяжёлые HashAggregate по большому GROUP BY: там множитель лучше не трогать, иначе агрегат уйдёт на диск и вы потеряете больше, чем сэкономите.
- ALTER SYSTEM — только консервативный глобальный минимум
- ALTER ROLE / ALTER DATABASE — для BI, ETL, ночных регламентов
- SET LOCAL внутри транзакции — для разовых тяжёлых запросов и скриптов
- за PgBouncer в transaction pooling — только SET LOCAL, никогда просто SET
Чем это мерить, чтобы не гадать
Первое, что я включаю на любом сервере, где вообще заходит разговор про work_mem, — это log_temp_files. По умолчанию параметр равен -1, то есть логирование выключено. Документация: «A value of zero logs all temporary file information, while positive values log only files whose size is greater than or equal to the specified amount of data». Ставлю 0 и получаю честный поток фактов: какой запрос, какого размера файл, когда. Это дешевле, чем кажется, и это единственный прямой сигнал, что work_mem мал. Обратный сигнал — рост RSS бэкендов в мониторинге; если временных файлов нет, а RSS процессов уходит за гигабайт, значит, work_mem уже избыточен.
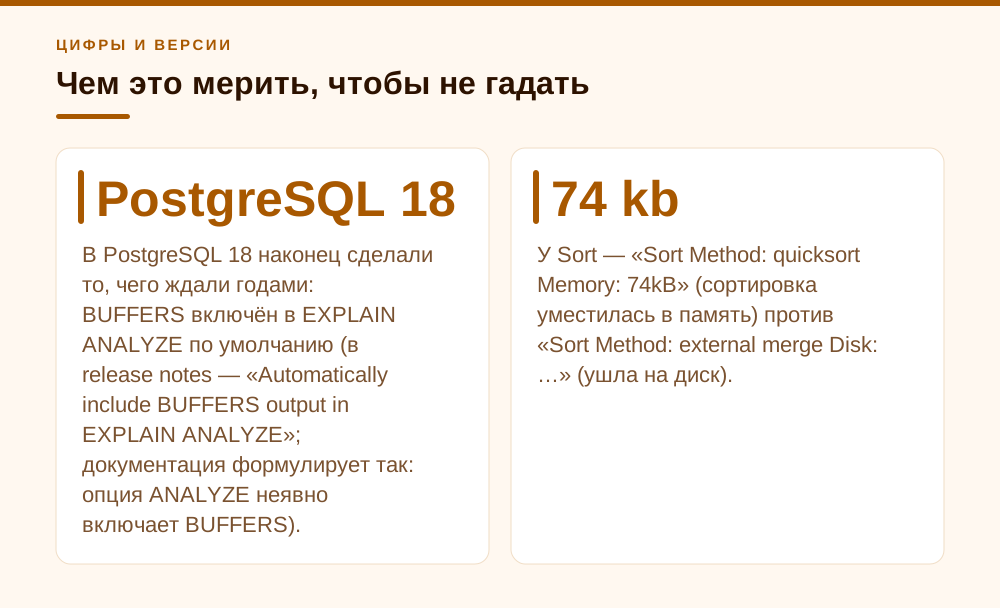
Второе — EXPLAIN. В PostgreSQL 18 наконец сделали то, чего ждали годами: BUFFERS включён в EXPLAIN ANALYZE по умолчанию (в release notes — «Automatically include BUFFERS output in EXPLAIN ANALYZE»; документация формулирует так: опция ANALYZE неявно включает BUFFERS). На более старых версиях по-прежнему пишите EXPLAIN (ANALYZE, BUFFERS) явно. Плюс в PG 18 добавили сведения о расходе памяти и диска для узлов Material, Window Aggregate и CTE. Смотреть надо на конкретные строки. У Sort — «Sort Method: quicksort Memory: 74kB» (сортировка уместилась в память) против «Sort Method: external merge Disk: …» (ушла на диск). У Hash — «Buckets: … Batches: … Memory Usage: …», где Memory Usage — пиковый объём хеш-таблицы. Если Batches больше единицы, хеш-таблица не влезла в лимит и часть данных писалась во временные файлы — документация прямо оговаривает, что этот расход диска в плане не показывается. У HashAggregate смотрите Batches, Memory Usage и Disk Usage. Это и есть кандидат на повышение work_mem, но только для этого запроса.
EXPLAIN (ANALYZE, BUFFERS)
SELECT client_id, sum(cost)
FROM ad_spend
GROUP BY client_id
ORDER BY 2 DESC;
Третье — pg_stat_statements. Колонки temp_blks_read и temp_blks_written дают агрегированную картину без разбора отдельных планов, а temp_blk_read_time и temp_blk_write_time (при track_io_timing = on) показывают, сколько времени на этом реально теряется. Топ-20 по temp_blks_written — это готовый список запросов, которым стоит выдать память адресно. Именно так я обычно и нахожу те два-три отчёта, ради которых кто-то собирался поднять work_mem всему кластеру.
Четвёртое, для нетривиальных случаев — pg_backend_memory_contexts. В PG 18 в этом представлении появились колонки type и path, а колонку parent убрали. Пригождается, когда память жрёт вовсе не work_mem: раздутый кеш планов, тысячи секций у партиционированной таблицы, prepared statements в долгоживущих соединениях. Признак простой — RSS бэкенда растёт монотонно и не падает между запросами; work_mem так себя не ведёт: память исполнителя освобождается вместе с контекстом запроса после его завершения.
- log_temp_files = 0 — факт нехватки work_mem
- EXPLAIN (ANALYZE, BUFFERS) — Sort Method, Batches и Memory Usage у Hash, Disk Usage у HashAggregate
- pg_stat_statements — temp_blks_written, temp_blk_write_time
- pg_stat_database — temp_files и temp_bytes для общего тренда
- pg_backend_memory_contexts — когда виноват не work_mem
Если под PostgreSQL работает 1С: что меняется в расчёте
У того же агентства на соседней виртуалке крутится 1С, и там арифметика work_mem устроена иначе, чем у BI. Сервер 1С ходит в базу через рабочие процессы rphost, соединения долгоживущие, и все пользователи информационной базы приходят под одной и той же ролью PostgreSQL. Значит, развести память «бухгалтерии» и «отчётов руководителя» через ALTER ROLE не получится: для базы это один и тот же пользователь. Разделять можно только по базам или ролям разных информационных баз — через ALTER DATABASE ... SET или ALTER ROLE ... IN DATABASE ... SET.
Вторая особенность — временные таблицы. Платформа активно создаёт их в запросах, и расходуют они temp_buffers и место на диске, а не work_mem. Важная деталь из документации: temp_file_limit считает только временные файлы исполнителя (сортировки, хеши, удерживаемые курсоры), а место под явные временные таблицы в этот лимит не входит. Поэтому temp_file_limit не спасёт от распухания временных таблиц 1С — за свободным местом на томе с базой придётся следить отдельно, мониторингом.
Третья — число соединений. У 1С max_connections обычно выставляют с запасом, и формула max_connections × work_mem выглядит пугающе. Но большинство соединений 1С в каждый момент простаивает или выполняет короткие OLTP-запросы по индексам, где узлов с сортировками и хешами почти нет. Тяжёлые места — закрытие месяца, отчёты по большим регистрам, обработки с группировками. Считать бюджет я и здесь предпочитаю от числа одновременно тяжёлых операций, а не от max_connections.
Цифры из моей практики для небольшого сервера 1С на PostgreSQL (до полусотни пользователей, 16–32 ГБ RAM), а не официальные рекомендации вендора: work_mem в районе 32–64MB глобально, hash_mem_multiplier по умолчанию, log_temp_files включён с первого дня. Параллельные планы для OLTP-нагрузки 1С часто дают больше конкуренции за ядра, чем выигрыша, поэтому max_parallel_workers_per_gather я проверяю замером и нередко снижаю. Конкретные значения у разных сборок PostgreSQL для 1С и у разных версий платформы отличаются — перед правкой сверяйтесь с документацией именно вашей сборки и смотрите log_temp_files на реальной нагрузке.
- Все пользователи ИБ 1С приходят под одной ролью — адресно разводить память можно только по базам
- Временные таблицы 1С — это temp_buffers и диск, они не входят в temp_file_limit
- Соединения rphost долгоживущие: ALTER ROLE / ALTER DATABASE SET подействует после их переоткрытия
- Бюджет считать от закрытия месяца и тяжёлых отчётов, а не от max_connections
- Параллелизм для OLTP-нагрузки 1С проверять замером, а не включать по умолчанию
Страховка: что ставить, чтобы отказ был мягким
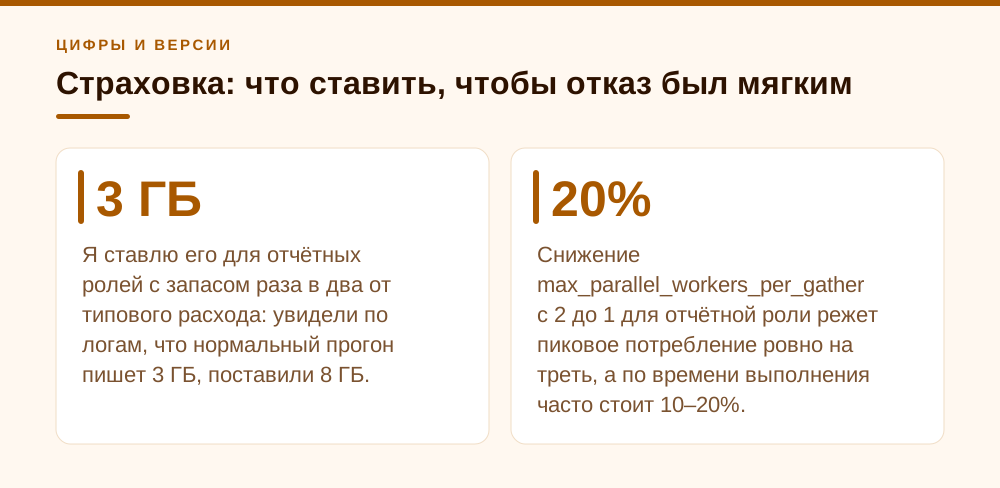
Понижая work_mem, вы переносите нагрузку с памяти на диск — и создаёте вторую проблему на месте первой. Здесь помогает temp_file_limit: по умолчанию -1, то есть без ограничений. Документация описывает его как «maximum amount of disk space that a process can use for temporary files... A transaction attempting to exceed this limit will be canceled». Отмена одной транзакции — намного более приятный сценарий, чем заполненный том с WAL и остановка всего кластера. Я ставлю его для отчётных ролей с запасом раза в два от типового расхода: увидели по логам, что нормальный прогон пишет 3 ГБ, поставили 8 ГБ.
Дальше — параллелизм. Это самый дешёвый и самый недоиспользуемый рычаг. Снижение max_parallel_workers_per_gather с 2 до 1 для отчётной роли режет пиковое потребление ровно на треть, а по времени выполнения часто стоит 10–20 %. На восьмиядерной виртуалке с шестью одновременными отчётами параллелизм вообще редко окупается: воркеры дерутся за те же ядра. На больших машинах картина другая, поэтому решение принимается замером, а не догмой.
Про cgroup скажу честно, потому что здесь единого мнения нет. Жёсткий MemoryMax= на юнит postgresql выглядит логично, но при его достижении OOM-killer сработает внутри cgroup и убьёт бэкенд — а postmaster на это отреагирует ровно так же, как на общесистемный OOM: оборвёт все соединения и уйдёт в recovery. То есть жёсткий лимит не спасает базу, он лишь локализует ущерб для соседей. Поэтому на выделенном сервере БД я обычно ставлю MemoryHigh= (мягкий троттлинг, даёт время среагировать), а MemoryMax= применяю к соседним прожорливым сервисам, а не к самой базе.
Наконец, vm.overcommit. Документация PostgreSQL (раздел про Linux memory overcommit) предлагает на серверах баз данных строгий режим vm.overcommit_memory = 2 и честно оговаривается, что OOM-killer это не исключает полностью, а лишь заметно снижает шансы его вызова; связанный vm.overcommit_ratio она советует подбирать по документации ядра, конкретного значения не даёт. Там же описан второй приём, совместимый с первым: выставить postmaster'у oom_score_adj = -1000, чтобы OOM-killer никогда не выбирал сам postmaster, а дочерним процессам вернуть обычный вес через PG_OOM_ADJUST_FILE и PG_OOM_ADJUST_VALUE. Оговорюсь: строгий overcommit хорошо работает только там, где машина действительно выделена под Postgres и swap настроен осмысленно. На виртуалке, где кроме базы крутится ещё пять контейнеров, я предпочитаю не трогать overcommit, а честно разложить лимиты по cgroup. Кому-то это покажется половинчатым решением — соглашусь, но за пятнадцать лет я видел больше проблем от неудачно выставленного overcommit_ratio, чем от штатного значения 0.
- temp_file_limit — на роль, с запасом ×2 от нормального расхода
- max_parallel_workers_per_gather — самый дешёвый рычаг снижения пика
- MemoryHigh= вместо MemoryMax= для юнита самой базы
- мониторинг RSS бэкендов и temp_bytes — до того, как приедет oom-killer
- vm.overcommit_memory = 2 — только на действительно выделенном сервере БД
Частые вопросы
Есть ли в PostgreSQL 18 параметр, ограничивающий память на весь запрос целиком?
Нет. В ванильном PostgreSQL 18 нет GUC вида query_mem или max_query_memory — лимит по-прежнему применяется к каждой операции плана отдельно, и к каждому параллельному воркеру отдельно. Ближайшие практические заменители: адресный work_mem через ALTER ROLE, ограничение max_parallel_workers_per_gather и temp_file_limit как страховка по диску. Некоторые форки и коммерческие сборки предлагают собственные ограничители, но переносить их поведение на ванильный Postgres нельзя.
Какое значение work_mem поставить на сервере с 32 ГБ RAM?
Не существует одного правильного числа, но порядок такой: из 32 ГБ вычитаем shared_buffers (обычно 8 ГБ), 15–20 % на page cache и ОС, память autovacuum-воркеров и бэкендов — остаётся примерно 16 ГБ. Делим на планируемое число одновременных тяжёлых сессий, потом на (1 + число воркеров) и на количество memory-узлов с учётом hash_mem_multiplier. На практике для смешанной нагрузки получается 16–32 МБ глобально и 128–256 МБ адресно для отчётной роли.
hash_mem_multiplier влияет на сортировки?
Нет, только на операции на основе хеш-таблиц: Hash Join, хеш-агрегацию (HashAggregate), Memoize, HashSetOp и хеш-обработку подзапросов IN. Сортировки используют чистый work_mem без множителя. Поэтому при подсчёте худшего случая узлы надо разделять: хеш-узлы считаются как work_mem × hash_mem_multiplier, сортировки — как work_mem.
Я понизил work_mem — насколько сильно замедлятся отчёты?
Обычно меньше, чем боятся, но цифру надо снимать на своих запросах, а не брать из статей. Внешняя сортировка слиянием в PostgreSQL реализована эффективно, и на быстром NVMe разница часто измеряется десятками процентов, а не разами — в нашем кейсе отчёт замедлился с 40 до 52 секунд. Больше всего страдают хеш-агрегаты по большому GROUP BY: там переход на диск может стоить кратного замедления. Именно поэтому я снижаю глобальный work_mem, но оставляю повышенный для конкретных ролей, где такие агрегаты живут.
Как понять, что памяти не хватает именно на запросы, а не где-то ещё?
Включите log_temp_files = 0 и посмотрите, появляются ли записи о временных файлах и какого размера. Если файлы есть и они большие — не хватает work_mem конкретным запросам. Если временных файлов нет, а RSS бэкендов монотонно растёт и не падает между запросами, дело не в work_mem: смотрите pg_backend_memory_contexts, кеш планов, число секций партиционированных таблиц и prepared statements в долгоживущих соединениях.
Можно ли выдать отдельный work_mem одному пользователю 1С?
Средствами PostgreSQL — нет: сервер 1С подключается к базе под одной ролью для всех пользователей информационной базы, и PostgreSQL их не различает. Можно задать значение для всей базы через ALTER DATABASE ... SET или для роли в конкретной базе через ALTER ROLE ... IN DATABASE ... SET. Если нужно разгрузить один тяжёлый отчёт, эффективнее разбирать его запрос и индексы, чем поднимать память всей базе.
OOM уже случился, база ушла в crash recovery. Что делать в первую очередь?
Сначала снизить глобальный work_mem до безопасного значения и уменьшить max_parallel_workers_per_gather — это останавливает повторение прямо сейчас. Затем по логу postgresql и dmesg восстановить, какие запросы были активны в момент падения, включить log_temp_files и pg_stat_statements, и только после этого возвращать память адресно тем запросам, которым она реально нужна. Возвращать глобально нельзя: вы просто перенесёте аварию на следующий понедельник.
Источники
- PostgreSQL 18: Resource Consumption — Официальная документация PostgreSQL 18, раздел 20.4 Resource Consumption — параметры work_mem (по умолчанию 4MB), hash_mem_multiplier (по умолчанию 2.0), maintenance_work_mem (64MB), temp_file_limit (-1), max_parallel_workers_per_gather (2), max_parallel_workers (8) и примечание про пятикратный расход ресурсов при четырёх воркерах. https://www.postgresql.org/docs/18/runtime-config-resource.html
- PostgreSQL 18: Error Reporting and Logging — Официальная документация PostgreSQL 18, раздел 20.8 — параметр log_temp_files (по умолчанию -1, значение 0 логирует все временные файлы) и log_min_duration_statement. https://www.postgresql.org/docs/18/runtime-config-logging.html
- PostgreSQL 18 Release Notes — Release notes PostgreSQL 18: автоматическое включение BUFFERS в EXPLAIN ANALYZE, добавление сведений о расходе памяти и диска для узлов Material, Window Aggregate и CTE, новые колонки type и path в pg_backend_memory_contexts. https://www.postgresql.org/docs/18/release-18.html
- pg_stat_statements (PostgreSQL 18) — Документация модуля pg_stat_statements: колонки temp_blks_read, temp_blks_written, temp_blk_read_time, temp_blk_write_time (последние две заполняются при track_io_timing = on). https://www.postgresql.org/docs/18/pgstatstatements.html
- The surprising logic of the Postgres work_mem setting, and how to tune it — pganalyze — Разбор от pganalyze: один запрос делает несколько выделений work_mem, каждый параллельный воркер получает полный work_mem, пример (1 лидер + 4 воркера) × 200MB = 1GB на один hash-узел. https://pganalyze.com/blog/5mins-postgres-work-mem-tuning
- PostgreSQL 18: Using EXPLAIN — Официальная документация, раздел 14.1 Using EXPLAIN: строки Sort Method (quicksort Memory / на диске), Buckets, Batches и Memory Usage у узла Hash; ANALYZE неявно включает BUFFERS. https://www.postgresql.org/docs/18/using-explain.html
- PostgreSQL 18: Managing Kernel Resources — Linux Memory Overcommit — Официальная документация, раздел 18.4: строгий режим vm.overcommit_memory = 2, vm.overcommit_ratio, oom_score_adj = -1000 для postmaster и переменные PG_OOM_ADJUST_FILE / PG_OOM_ADJUST_VALUE. https://www.postgresql.org/docs/18/kernel-resources.html