
Почему почтовый сервер тормозит ночью и что проверяю я
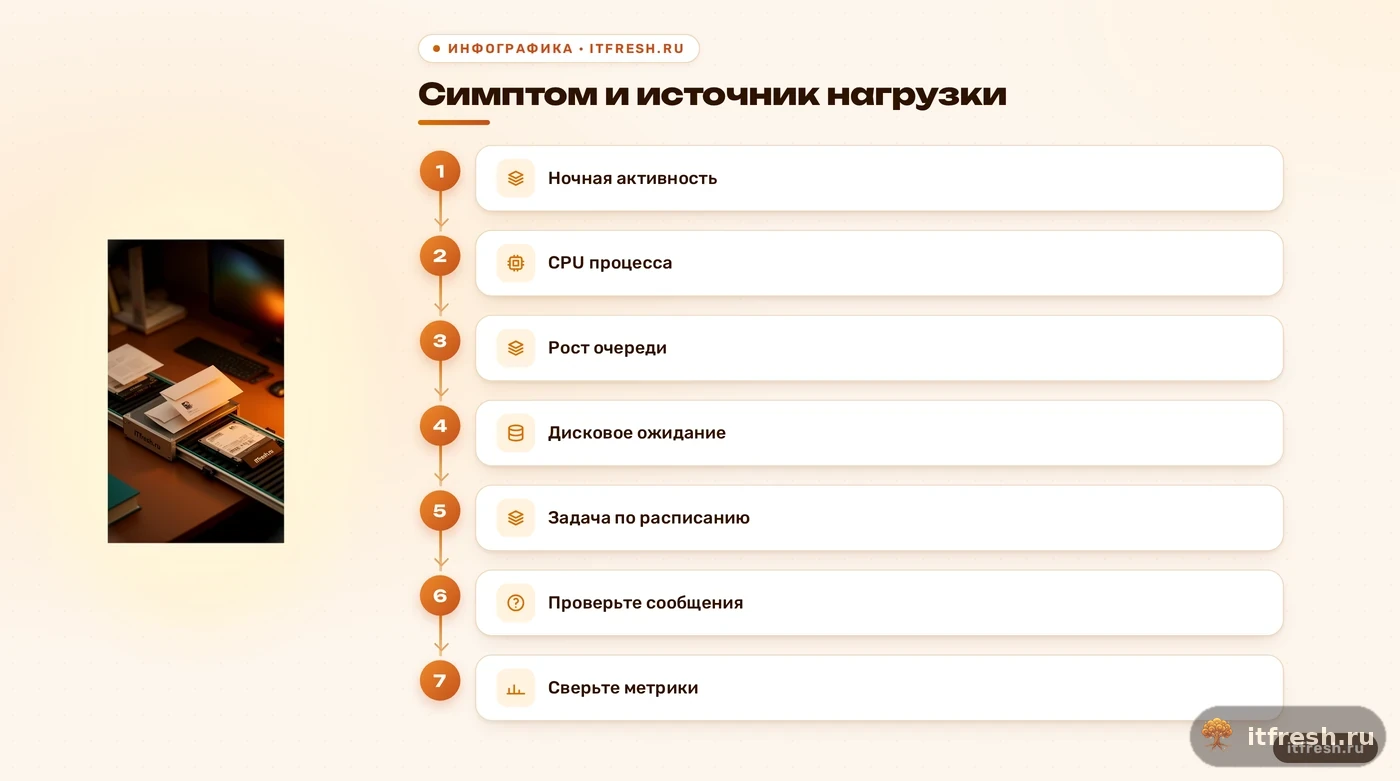
Ночная загрузка процессора сама по себе не доказывает ни атаку, ни неисправность почты. Я сначала связываю график CPU с конкретным процессом, очередью писем и расписанием фоновых задач, а потом проверяю дисковые задержки и сами сообщения. Ниже — порядок проверки и границы безопасных лимитов systemd.
Почему почта грузит CPU именно ночью
Почтовая система — это несколько разных процессов: приём и доставка сообщений, фильтрация, доступ пользователей к ящикам, индексация, резервное копирование. Высокая загрузка может относиться к любому из них, а на одном сервере рядом могут работать и другие службы. Поэтому в обслуживании корпоративной почты я начинаю не с названия продукта, а с вопроса: какой процесс потребил время CPU в тот же интервал, когда пользователи заметили задержку? Совпадение по времени — зацепка, но пока не причина.
Ночь часто выбирают для резервных копий, обслуживания хранилища и других фоновых работ, потому что тогда меньше активных пользователей. Но расписание само по себе не доказывает, что запустилась индексация или антивирус. Я сверяю график с таймерами и заданиями именно этого сервера, а затем смотрю, повторяется ли пик в те же дни и часы. Если нагрузка появляется лишь при обработке новой почты, ответ будет в потоке сообщений; если строго по календарю — ищу плановую задачу. Это два разных маршрута диагностики, и смешивать их невыгодно.
Надпись «CPU 100 %» тоже требует контекста: мониторинг может показывать один занятый поток, суммарную загрузку нескольких ядер либо долю, усреднённую за выбранное окно. На виртуальной машине своё влияние могут иметь конкуренция за ресурсы узла и задержки диска. Я сопоставляю загрузку процессора с временем ожидания дисковых операций, очередью и откликом самой почты. Если CPU свободен, а операции ввода-вывода ждут, лимит процессора не ускорит диск. Иногда график красный, а проблема сидит совсем в другом отделе хозяйства.
Пик не всегда означает неисправность: важны длительность, повторяемость и последствия. Если задача быстро отрабатывает, письма принимаются и пользователи не ждут, один короткий всплеск — повод записать наблюдение, а не перекраивать сервер. Если одновременно растут задержки, очередь и время ответа IMAP, тогда нужно найти общий участок цепочки. Я фиксирую начало и конец симптома, но не превращаю произвольное число процентов в универсальный порог: у разных хранилищ, фильтров и потоков работы запас будет разным.
- Сопоставьте график CPU со временем жалоб и задержек.
- Проверьте фоновые задания и фактическое время их запуска.
- Отделите загрузку CPU от ожидания диска и виртуального узла.
Что очередь писем говорит о нагрузке
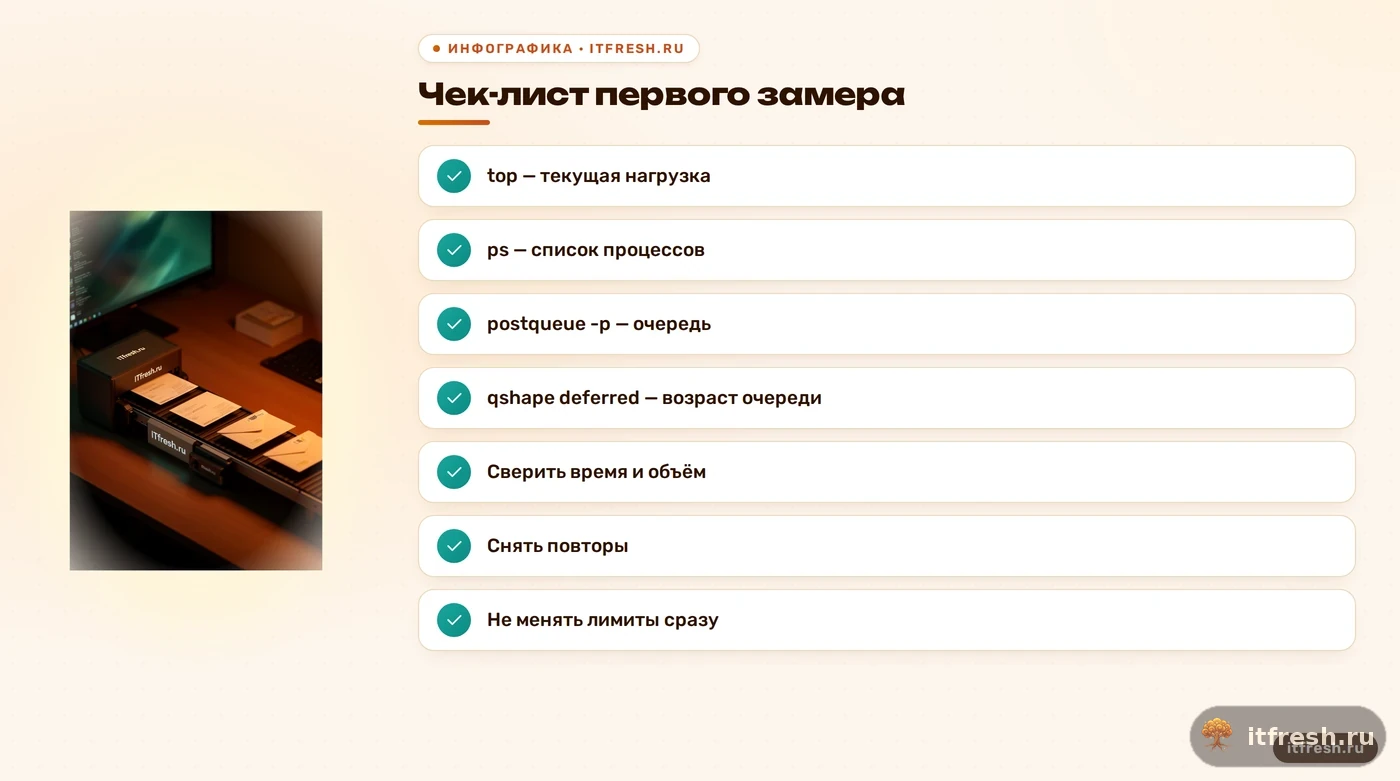
Для Postfix я отдельно смотрю на очередь. Команда postqueue -p показывает ожидающие сообщения; сам размер очереди ничего не говорит о виновнике. Письма могут задерживаться из-за недоступности принимающего сервера, сетевой ошибки, временного отказа или резкого роста входящего потока. Большая очередь способна занять диск и усложнить доставку, но не доказывает, что именно она загрузила CPU. И наоборот: пустая очередь не исключает тяжёлой обработки уже доставленного письма.
Полезно видеть не только число записей, но и распределение по доменам и возрасту. Утилита qshape из набора Postfix строит такое распределение и помогает понять, сосредоточилась ли задержка на отдельных доменах или старых сообщениях. В базе знаний отмечено, что накопившаяся очередь может указывать на проблему сети или сервера получателя; официальная документация Postfix отдельно описывает qshape как инструмент для анализа затора в очереди. Если проблема у одного направления, бессмысленно сразу ограничивать весь почтовый сервис. Я начинаю с точки задержки, а не с самого заметного графика.
Если у вас Zimbra, порядок разбора очереди и статуса служб отличается от Postfix; для этого есть отдельный материал о диагностике очереди почты Zimbra. Не переносите команды одного продукта на другой по созвучию. В смешанной схеме почтовый шлюз, IMAP-сервер и фильтр могут быть разными узлами; метрики каждого нужно связать с тем же интервалом времени. Иначе график одного хоста будут пытаться объяснить событиями другого.
Студия «Нерпа-М» в этом разборе — условный сценарий, а не подтверждённый отчёт о реальном инциденте. У меня нет её журналов, конфигурации и контрольных графиков, поэтому я не буду придумывать часы сбоя, число ящиков или результат «до и после». В таком сценарии я сначала сохраняю размер и возраст очереди, отмечаю, меняются ли они во время пика, а затем сопоставляю картину с загрузкой конкретных процессов. Это и есть проверяемый вывод: можно назвать участок, где накапливается работа, но нельзя объявить его причиной CPU без следующего измерения.
Как найти процесс, который действительно считает
Начните с общего списка процессов, отсортированного по загрузке. top показывает меняющуюся картину, а ps помогает зафиксировать состояние для дальнейшего сравнения. Например, ps -eo pid,ppid,stat,pcpu,pmem,comm,args --sort=-pcpu | head — рабочий способ вывести верхние строки в системах с procps. Это снимок, не история: процент CPU в выводе ps не заменяет наблюдение за процессом во времени. Я повторяю замер во время симптома и после него, иначе можно принять разовый запуск за постоянную нагрузку.
Имя процесса связываю с родителем, аргументами запуска и службой, которой он принадлежит. Один почтовый продукт запускает несколько работников, другой складывает части в контейнеры или отдельные службы. Высокий %CPU у dovecot, postfix или фильтра ещё не означает, что этот компонент неисправен: он может просто выполнять штатную работу, накопившуюся из-за предыдущего простоя. Проверяю, меняется ли число таких процессов, какой из них растёт по CPU и совпадает ли это с очередью либо конкретным действием пользователя. Название в списке — начало расследования, не готовый диагноз.
strace и perf оставляю для случая, когда обычные метрики уже сузили поиск. Первый показывает системные вызовы выбранного процесса, второй помогает исследовать профиль CPU; оба требуют понимания результата и прав на наблюдение. Подключать трассировку к нагруженной службе без необходимости — плохой способ получить ещё больше нагрузки. Я сначала проверяю логи и штатные показатели приложения, затем выбираю короткий интервал наблюдения и только после этого применяю более тяжёлый инструмент. Один осмысленный профиль полезнее длинного файла, который никто не читает.
Чтобы результат можно было перепроверить, сохраняю время замера, имя процесса, его PID, родительский процесс и состояние очереди. При повторе сравниваю ту же службу и тот же тип операции. Если нагрузка переехала на другой процесс, это не означает, что проблема исчезла: возможно, изменился этап обработки. Если процессы выглядят спокойно, а пользователи по-прежнему ждут, проверяю диск, память, сетевую задержку и саму виртуальную машину. Такой порядок защищает от популярной ошибки: лечить единственный показатель, который удобно вывести на экран.
- Снимите несколько замеров во время симптома, а не один после него.
- Сверьте PID, родительский процесс, службу и очередь.
- Проверяйте трассировку только после сужения круга причин.
Что искать в логах и самих сообщениях
Универсального пути к почтовому журналу нет. Он зависит от дистрибутива, настроек системного журнала и способа установки: служба может писать в журнал systemd, отдельный файл или контейнерный сборщик. Я сначала выясняю, где конкретная система хранит события, а не открываю наугад /var/log/mail.log. Такой путь встречается, но выдавать его за обязательный для любого Linux-сервера — плохой совет. Если журнал ротируется или данные уходят в централизованный сборщик, нужное окно ищу там же, где обычно обслуживают эту установку.
В журнале сопоставляю время пика с действиями: доставка, повторная попытка, сканирование, синхронизация или сбой доступа к хранилищу. Счётчик ошибок полезен вместе с контекстом: одна повторяющаяся ошибка часто важнее десятка несвязанных предупреждений. Для Postfix проверяю идентификаторы сообщений и задержки доставки; для IMAP-службы — операции с ящиком и состояние индексов. Не публикуйте журналы целиком в открытых обсуждениях: в них могут оказаться адреса отправителей, получателей, внутренние имена узлов и фрагменты служебной информации.
Есть и менее очевидная причина: тяжёлая обработка самого письма. В экспертной базе отмечен конкретный случай с Dovecot: чрезмерное количество адресных заголовков приводило к непропорциональной загрузке CPU. Вендор описал этот дефект в своих рекомендациях по безопасности и привёл результаты разбора искусственно больших заголовков. Это не означает, что всякая высокая нагрузка вызвана атакой или что обычные письма опасны. Это причина проверить версию и уведомления производителя, если в логах видны необычные сообщения или нагрузка повторяется при разборе отдельных писем.
Если есть признаки необычной отправки или входа, проверяю журналы аутентификации, объём исходящей очереди и учётные записи. Но высокая нагрузка сама по себе не доказывает взлом: тот же симптом дают повторные попытки доставки, некорректное сообщение и резервная копия. Правильная реакция — сохранить данные, подтвердить последовательность событий и только потом ограничивать доступ или останавливать службу. Я разбираю признаки возможного взлома почтового сервера отдельно от обычной диагностики производительности, чтобы не превращать каждый пик в историю про злоумышленника.
Когда системные лимиты помогают, а когда мешают
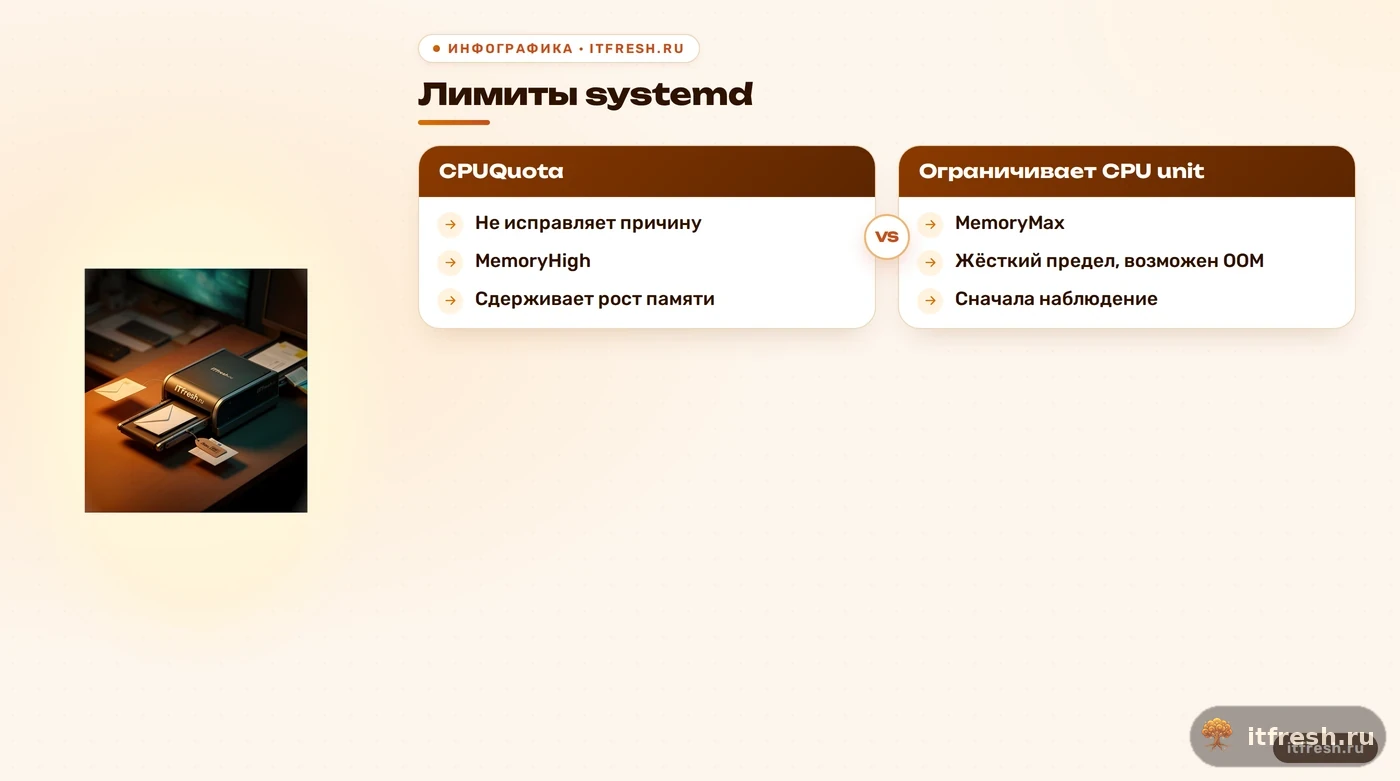
Если причина найдена и задаче действительно нельзя занимать всё доступное время процессора, systemd позволяет задать лимит для unit через CPUQuota=. Здесь важно не перепутать долю времени CPU с числом доступных ядер: процент считается относительно одного CPU, а значение выше ста процентов допускает использование более одного. Лимит ограничивает процессы соответствующей службы в её группе, а не волшебно отделяет «индексацию» от прочей работы внутри того же unit. Если под одной службой живут приём писем и тяжёлый работник, общий предел затронет обоих.
Перед ограничением я выясняю, какую именно службу запускает система и кто входит в её группу процессов. У разных установок Postfix и Dovecot может отличаться схема запуска, а контейнерная почта управляется отдельным слоем. Затем оцениваю допустимую задержку: CPUQuota способен удержать соседние службы от голодания, но сама ограниченная задача будет обрабатываться дольше. Это компромисс, а не исправление первопричины. Не копируйте процент из чужого примера — подберите его на тестовом окне и проверьте приём, отправку и доступ к ящикам.
С памятью осторожнее. MemoryMax= — жёсткий предел для unit; когда процессы не могут уложиться в него, systemd и ядро могут вызвать OOM внутри этой группы. Поэтому документация рекомендует использовать MemoryHigh= как основной механизм давления на потребление, а MemoryMax= оставлять крайней границей. Для почтовой службы случайное завершение процесса может превратиться в задержку доставки или сбой пользовательских сессий. Поставить красивую цифру в конфигурацию легко; объяснить утром, почему фильтр перестал принимать письма, гораздо труднее.
После изменения я проверяю не только график CPU. Смотрю, не растут ли время доставки и возраст очереди, не появились ли ошибки в журналах и не упирается ли служба в память. Если лимит перенёс проблему на другой этап, его корректируют или снимают. Перед правкой сохраняю исходное значение и план возврата, изменение применяю в окно обслуживания, а затем делаю контрольную отправку и получение письма. Для планирования нагрузки на память есть отдельный материал о MemoryHigh и MemoryMax в systemd; лимит без проверки подчинённых unit и их общей нагрузки — лотерея.
- CPUQuota ограничивает CPU-время процессов unit.
- MemoryHigh замедляет и сдерживает рост потребления памяти.
- MemoryMax может привести к OOM внутри группы.
Как закрепить результат и не купить лишние ядра
После устранения причины я сохраняю исходный график, очередь и журналы рядом с результатом контрольного окна. Для повторяющихся фоновых задач записываю их владельца, расписание и ожидаемое время завершения. Если задача начала занимать заметно больше времени, это ранний признак роста объёма писем, проблемы с диском или изменения состава обработки. Ежедневно вручную смотреть все показатели не нужно; важнее иметь оповещение о задержке доставки, устойчивой очереди и исчерпании ресурсов, а затем проверять контекст сигнала.
Новые ядра помогают только тогда, когда узкое место действительно в вычислениях и задача умеет использовать параллелизм. Они не устраняют отказ принимающего сервера, медленный диск, повторную обработку одного сообщения или неверное расписание. Перед расширением ресурса я сравниваю профиль CPU с ожиданием диска, памятью, количеством параллельных работников и скоростью изменения очереди. Если проблема возникает только при отдельной операции, сначала исправляю её или разделяю нагрузку; масштабирование оставляю для подтверждённой нехватки ресурса.
Для небольшого офиса полезнее понятный журнал изменений, чем набор случайных порогов. Записывайте, что меняли, когда начался симптом и что произошло с очередью после изменения. Если сервер ведёт подрядчик, передайте ему интервал события, системные метрики и обезличенные фрагменты журналов. Это быстрее, чем пересказывать по телефону «ночью было медленно». В плане обслуживания собственного почтового сервера эти проверки должны быть частью регулярной работы, а не авральной операцией после жалоб.
Мой порядок простой: подтвердить связь между жалобой и ресурсом, найти процесс, проверить очередь и сообщения, затем менять настройки. Если причина не ясна, не ставлю CPUQuota «на всякий случай» и не объявляю атаку по одному графику. Если причина ясна, сначала исправляю её, а лимит использую как страховку от повторного захвата CPU. Так остаются измеримые выводы: что изменилось, как повела себя доставка и можно ли безопасно вернуть старую настройку. Серверу не нужен героизм. Ему нужны данные до правки и контроль после неё.
Частые вопросы
Почему почта грузит процессор ночью?
Ночью могут запускаться фоновые задания, но одно совпадение по времени не доказывает причину. Сверьте расписание с процессом, очередью и журналами.
Как проверить очередь Postfix?
Команда `postqueue -p` показывает ожидающие письма. Для распределения по доменам и возрасту сообщений используйте `qshape`, если утилита доступна в вашей установке.
Где искать логи почтового сервера Linux?
Универсального пути нет: журнал зависит от дистрибутива и способа установки. Проверьте настройки системного журнала, службы или контейнерной платформы.
Можно ли ограничить CPU через systemd?
Да, `CPUQuota=` задаёт долю CPU-времени для процессов unit. Сначала выясните, какие процессы попадут под общий лимит, и проверьте задержки почты после изменения.
Безопасно ли задать MemoryMax почтовой службе?
Не всегда. При достижении жёсткого предела возможен OOM внутри unit; документация systemd рекомендует рассматривать `MemoryHigh=` как основной механизм ограничения памяти.
Нужно ли сразу добавлять ядра?
Только если замеры показывают нехватку CPU. Сначала исключите ожидание диска, задержку внешнего сервера, рост очереди и тяжёлую обработку отдельных сообщений.
Источники
- Postfix: postqueue(1) — Проверено, что ключ -p выводит очередь ожидающих сообщений. URL: https://www.postfix.org/postqueue.1.html
- Postfix: Postfix Bottleneck Analysis — Проверено применение qshape для поиска причин затора в очереди Postfix. URL: https://www.postfix.org/QSHAPE_README.html
- Dovecot: Security Advisories — Проверен описанный производителем дефект, при котором множество адресных заголовков приводило к чрезмерной загрузке CPU. URL: https://dovecot.org/security/
- systemd: Resource Control — Проверены значения CPUQuota, MemoryHigh и MemoryMax, их область действия и последствия жёсткого лимита памяти. URL: https://www.freedesktop.org/software/systemd/man/latest/systemd.resource-control.html
- Linux man-pages: top(1) — Проверено назначение top для наблюдения за процессами и их ресурсами. URL: https://man7.org/linux/man-pages/man1/top.1.html
- Linux man-pages: ps(1) — Проверены поля процесса и GNU-ключ --sort для сортировки по загрузке CPU. URL: https://man7.org/linux/man-pages/man1/ps.1.html