
Как по логам понять, что почтовый сервер скомпрометирован
Массовая отправка, незнакомые входы и новые правила пересылки — повод проверить почту, но каждый признак по отдельности ещё не доказывает взлом. Сначала я фиксирую время и сохраняю журналы, затем сопоставляю входы, очередь, правила ящиков и изменения на сервере. По этим следам уже выбирают сдерживание и восстановление.
Сначала сохраните журналы и время события
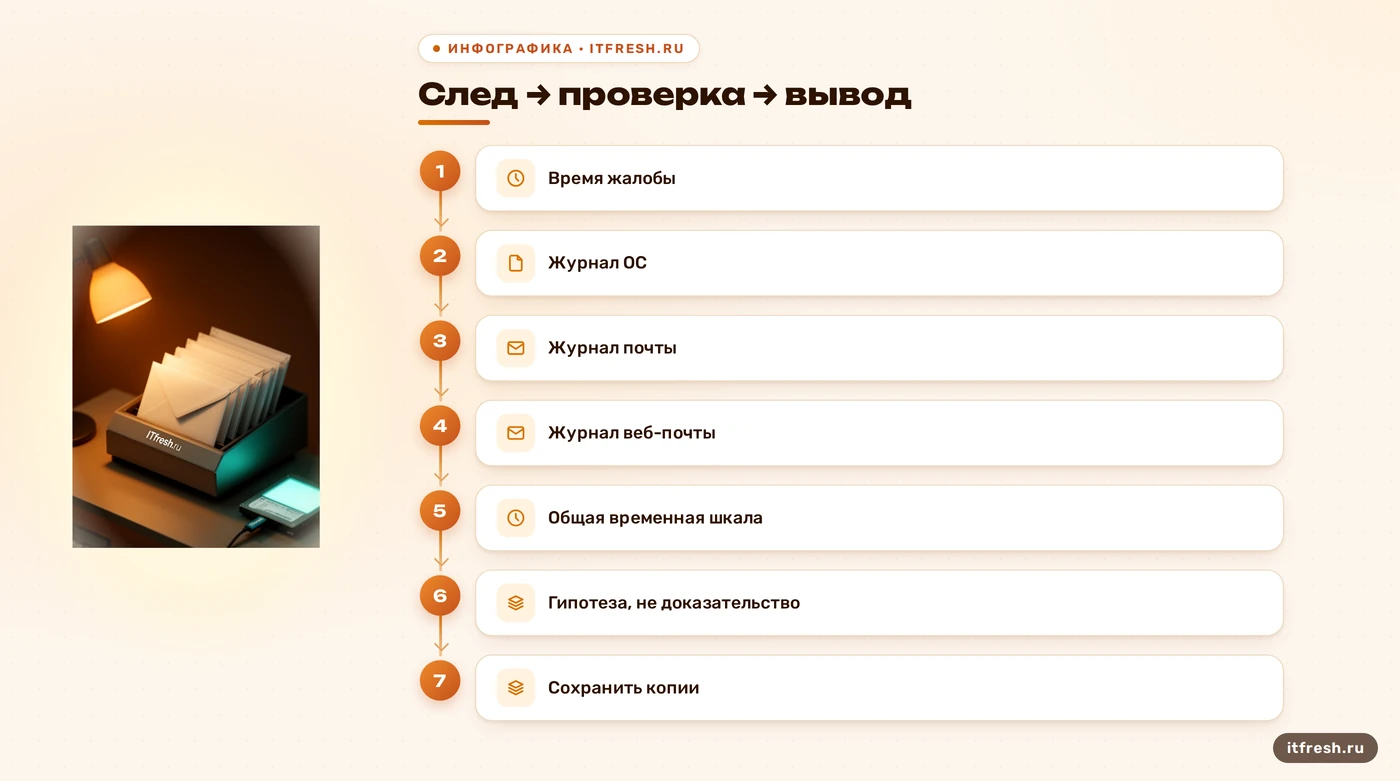
В разборе корпоративной почты первое, что я фиксирую, — не «взлом», а время и наблюдаемый симптом. Запишите, когда пришла жалоба, что именно увидел получатель, кто сообщил, в каком часовом поясе работают сервер и система мониторинга. Время задаёт границы поиска и помогает сопоставить события разных компонентов. Сохраните исходные журналы отдельно и отметьте, кто и когда их скопировал. Не очищайте их ради свободного места и не перезапускайте узел автоматически: часть данных может исчезнуть после рестарта. Но абсолютное «ничего не трогать» тоже плохой совет. Если отправка продолжается, сдерживание согласуют со сбором данных; приоритет зависит от текущего ущерба.
Названия файлов не универсальны. В одних конфигурациях сообщения Dovecot попадают в /var/log/mail.log, в других — в /var/log/maillog; системные события аутентификации могут идти через syslog или системный журнал. На системах с systemd записи могут храниться в journald и читаться через journalctl. Путь определяется настройкой службы и маршрутизацией журналов. Поэтому сначала выясните, куда именно ваша установка пишет события, и проверьте ротацию. Пустой mail.log ещё не доказывает, что почта молчала: файла может не быть, журнал мог уйти в другой канал или старые записи могли уже ротироваться.
Собирайте несколько независимых слоёв: события входа в систему, журналы MTA, аутентификацию IMAP/POP, события веб-почты или панели и сведения мониторинга. Эти журналы отвечают на разные вопросы. В Dovecot ищут события доступа к почтовым ящикам; Postfix показывает работу своей очереди и SMTP-компонентов; веб-интерфейс может отдельно фиксировать вход и изменение пользовательских правил. Универсального файла, где написано «взломал такой-то», нет. Такой файл был бы удобен, но жизнь опять не согласовала требования с производителем.
В условном примере из статьи — школа программирования «Код и дело», 19 рабочих мест. Партнёр сообщает о необычной отправке писем с домена. Это начало проверки, а не доказанный взлом: пока неизвестны ни объём рассылки, ни учётная запись, ни программная причина. Я фиксирую время жалобы, прошу сохранить образцы писем с заголовками и начинаю сопоставлять журналы. Цифры и технические подробности, которых нет в исходных данных, не добавляю: драматургия не заменяет журнал событий.
list
Зафиксируйте время жалобы и часовой пояс.
Сохраните журналы ОС, почты и веб-интерфейса.
Отметьте ротацию и место хранения журналов.
Сохраните образцы подозрительных писем с заголовками.
Сопоставьте входы, а не охотьтесь за одним IP
Поток неудачных входов, за которым следует успешная авторизация той же учётной записи, заслуживает внимания. Но это не автоматическое доказательство взлома. Пользователь может ошибиться в пароле, почтовый клиент — повторять попытки, а несколько сотрудников — выходить через один NAT-адрес. Смотрите на сочетание признаков: имя учётной записи, протокол, время, источник подключения, привычный график и последующие действия. Один необычный адрес может быть поводом задать вопрос; последовательность независимых событий — поводом менять доступ.
Разделяйте IMAP/POP и SMTP. Успешное чтение почты через IMAP не означает, что тот же процесс отправил сообщение через SMTP. Почтовый клиент, сайт, сканер или CRM могут отправлять почту через отдельную учётную запись либо локальный relay. Сопоставляйте журналы соответствующих служб по времени, пользователю и идентификаторам сообщений, если они есть. В документации Dovecot отдельно описаны настройки журналирования аутентификации; фактическая детализация зависит от конфигурации. Дополнительный шум тоже возможен: при высокой интенсивности syslog может ограничивать поток сообщений, поэтому отсутствие записи не всегда равно отсутствию попытки.
В условном примере жалоба партнёра задаёт первую временную границу. Дальше я ищу не «страшный IP», а последовательность: какие учётные записи входили, был ли успешный вход, менялись ли настройки ящика, появились ли необычные отправки. Если входы шли из привычного приложения после смены пароля, причина может быть бытовой. Если после неожиданной авторизации меняются правила и начинается отправка, версия компрометации становится сильнее. Между «похоже» и «доказано» остаётся проверка; пропустить её легко, объяснять потом — долго.
Пошаговый разбор попыток входа пригодится для поиска брутфорса в логах. Здесь важен тот же принцип: не считать каждый отказ атакой и не считать каждый успех нормой. Сравните события с обычной работой конкретной учётной записи и проверьте, какие журналы на этой системе вообще включены. Если детализации не хватает, зафиксируйте это как пробел мониторинга; не включайте подробный debug без оценки риска, объёма и хранения чувствительных данных.
list
Сверьте имя учётной записи и тип протокола.
Сопоставьте неудачные и успешные входы по времени.
Проверьте обычные устройства и интеграции пользователя.
Ищите действия после входа, а не только сам вход.
Проверьте очередь и происхождение отправки
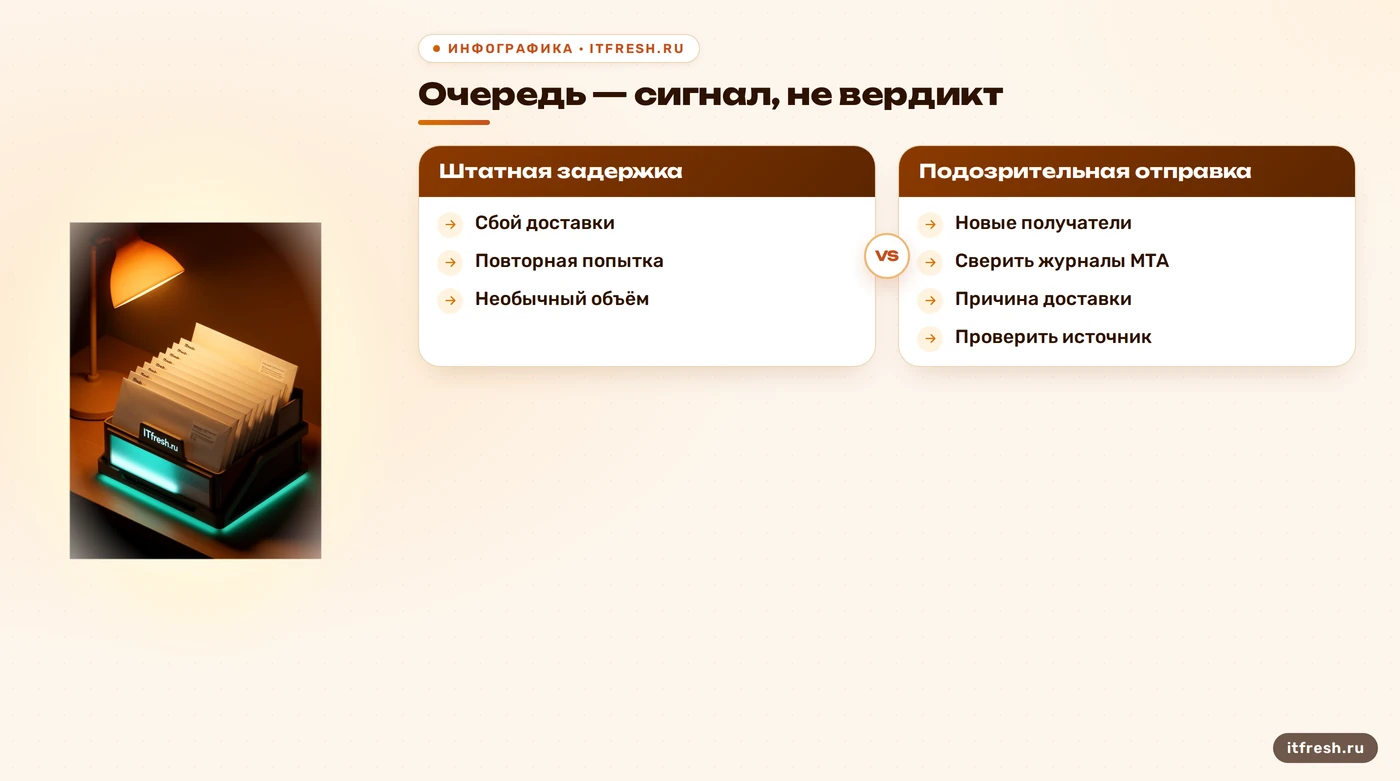
Если подозрение связано с исходящими письмами, проверьте очередь именно того MTA, который установлен. Для Postfix команда postqueue -p выводит список очереди; mailq — совместимый интерфейс Postfix. Это проверка очереди, а не сканер взлома и не способ узнать, что уже доставлено. Для Exim или другой системы нужны её собственные средства. Не запускайте команду вслепую на почтовой платформе в контейнерах: сначала установите, где находится нужный MTA и как администраторы обычно получают к нему доступ.
Рост очереди может означать массовую рассылку, но может быть и следствием проблем доставки: удалённые серверы не отвечают, DNS настроен неверно, получатель временно отклоняет письма. Разберите статусы отложенных сообщений, повторяющиеся домены получателей и время появления очереди. Сравните картину с обычной нагрузкой компании, а не с условной нормой «пятьдесят писем в час». Для небольшого офиса даже несколько сотен уведомлений могут быть штатными после отчёта или сбоя интеграции; один спам-скрипт может, напротив, успеть отправить письма без огромного остатка в очереди.
Свяжите запись очереди с журналом MTA по идентификатору сообщения и времени. Затем проверьте, кто передал письмо: SMTP-аутентифицированный пользователь, приложение, локальный процесс или разрешённый relay. Поле From само по себе слабая улика: видимый отправитель может отличаться от учётной записи, прошедшей аутентификацию. И наоборот, отправка от имени знакомого ящика не доказывает, что его владелец сам нажал кнопку. Если сохранились заголовки полученных писем, изучите служебные поля маршрута вместе с серверными записями.
В школе «Код и дело» нет подтверждённых показаний очереди или журналов MTA, поэтому я не могу повторять историю про точное число писем и объявлять причиной Webmail. Корректный вывод появится только после связи сообщений с конкретными учётными данными и событием отправки. Если журнал показывает только передачу в MTA, он может не раскрыть, какое приложение запустило отправку. Тогда проверяют журналы приложения, учётной записи и планировщика, не дорисовывая источник по одному совпадению.
Диагностику конкретной платформы можно продолжить через материал о проверке очереди почты. Смысл тот же даже при другом MTA: очередь описывает состояние доставки, а не виновника. Не удаляйте подозрительные сообщения до фиксации их идентификаторов и статусов. При подтверждённой массовой отправке ограничивают её безопасным для этой платформы способом и сохраняют нужные данные для разбора; команда очистки очереди может уничтожить часть полезного контекста.
list
Для Postfix проверьте очередь через postqueue -p.
Отделите отложенную доставку от уже отправленных сообщений.
Сопоставьте идентификаторы сообщений и события MTA.
Проверьте пользователя, приложение и relay-узел.
Найдите правила пересылки и изменения ящиков
Проверьте не только письмо «Отправленные», но и настройки самого ящика: автоматическую пересылку, фильтры, автоответчики, дополнительные адреса и делегирование доступа. Пользователь может не увидеть копию письма, если отправка делалась приложением или правило перенаправляло входящие сообщения. Сверьте текущие настройки с сохранённой конфигурацией или с привычными настройками этого пользователя. Изменение незнакомое — это повод установить, кто и когда его сделал, но не основание немедленно объявлять утечку всей почты компании.
Проверяйте правила в том слое, где ваша система их хранит. У веб-почты могут быть пользовательские фильтры; у сервера доставки — алиасы и таблицы маршрутизации. Эти механизмы различаются. Не ищите каждое правило в main.cf Postfix: настройки доставки ящика не обязаны находиться в конфигурации MTA. Сохраните подозрительный фильтр, адрес назначения, время изменения и связанные события входа до того, как будете удалять или отключать правило.
Правило пересылки на внешний адрес создаёт риск раскрытия входящей почты, но не показывает, прочитал ли её кто-то и сколько сообщений ушло. Сначала определите область действия: один ящик, группа или общий маршрут. Затем проверьте, какие сообщения попали под правило, были ли к ним обращения и какие учётные данные управляли ящиком. Если правило легитимное — например, старый адрес бухгалтера, — оставьте его после проверки. Сам факт «внешний адрес» ещё ничего не говорит о владельце и намерении; адресная книга злоумышленника тоже не выдаёт паспорт.
В организациях на Zimbra отдельный журнал действий помогает расследовать изменения настроек; полезен материал про аудит действий администраторов Zimbra. На другой платформе ищите аналогичный журнал аудита и историю настройки ящика. В учебном примере никакой найденной пересылки не задано, поэтому я показываю, что именно следует проверить, а не приписываю компании факт утечки. Это скучнее, чем рассказ про «тайное правило», зато не превращает редакционный пример в фальшивое свидетельство.
list
Проверьте фильтры, автоответы и переадресацию ящика.
Сверьте адреса пересылки и права делегирования.
Изучите алиасы и серверные правила маршрутизации.
Сохраните настройки и время изменения до удаления.
Осмотрите сервер и задания планировщика
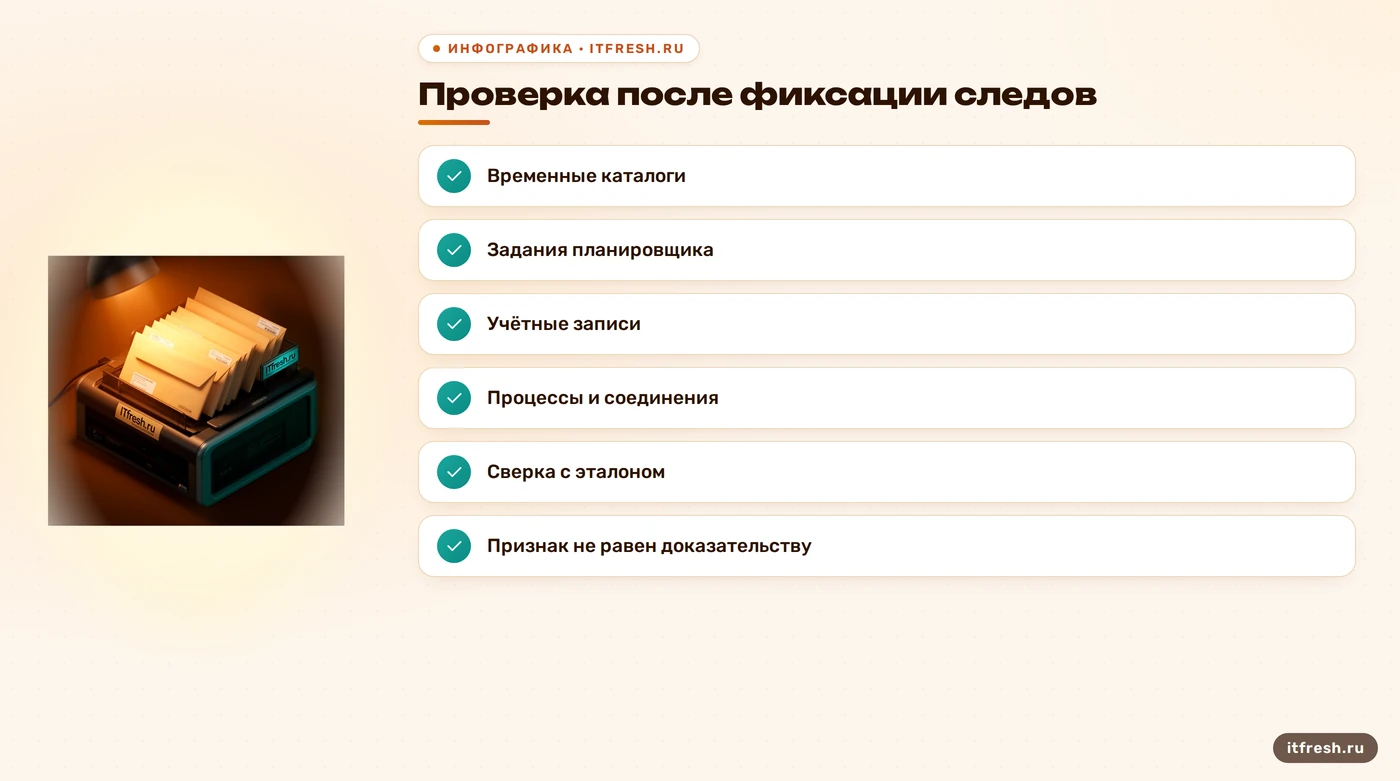
Временные каталоги /tmp и /var/tmp полезно включить в осмотр, как и каталоги приложений, куда веб-почта или вспомогательные сервисы могут записывать файлы. Это стандартные места для временных данных; само наличие там скрипта или исполняемого файла не доказывает заражение. Сначала сравните владельца, время изменения, назначение и содержимое файла с ожидаемым состоянием пакета и приложения. Не запускайте подозрительный файл «посмотреть, что будет» и не удаляйте его до фиксации: так вы и следы испортите, и рискуете выполнить то, что расследуете.
Проверьте новые системные учётные записи, группы с административными правами, ключи удалённого доступа и задания планировщика. Ищите не только cron: в системах с systemd задачу могут запускать таймер и сервисный unit. Сверяйте владельца, команду, путь, время создания и бизнес-причину задания. У неизвестного названия процесса может оказаться штатное объяснение, а вредоносный скрипт вполне способен назваться скучно. Если заранее есть эталон конфигурации или контрольная сумма чистой версии, сравнение полезно; мониторинг целостности, установленный после инцидента, не расскажет, какие файлы были изменены до его установки.
Посмотрите активные процессы и сетевые соединения в контексте конкретного сервиса и его ожидаемых связей. Страна, к которой относится IP, не устанавливает личность пользователя и не доказывает управление сервером: адрес может принадлежать облачному узлу, шлюзу или инфраструктуре подрядчика. Сверяйте соединение с владельцем процесса, временем, назначением и журналами. Если система ничего не записывала о сетевой активности, так и отметьте. Не подменяйте отсутствующие данные уверенным рассказом про «сервер полностью захвачен».
База знаний отдельно предлагает обращать внимание на временные каталоги и лишние задания cron. Это разумные пункты списка проверки, но не готовый диагноз: каталог /tmp используется и легитимными программами, а задания cron есть на обычных серверах. Для учебной школы мы не располагаем подтверждённым PHP-файлом, запуском каждый час или внешним управляющим узлом. Такие детали нельзя писать как результат расследования, пока их не показывают артефакты и журналы.
list
Осмотрите /tmp, /var/tmp и каталоги приложений.
Сверьте cron и systemd timers с известными задачами.
Проверьте новые учётные записи и ключи доступа.
Свяжите процесс, соединение и время события.
Сдержите инцидент и выберите способ восстановления
После первичной фиксации решите, продолжается ли отправка или доступ к почте. Если да — изолируйте подтверждённо затронутую учётную запись, остановите подозрительную интеграцию или ограничьте исходящую отправку штатным для этой инфраструктуры способом. Не копируйте наугад правило iptables: конкретный сервер может управляться другим firewall, nftables, панелью или облачной сетью. Изоляция не должна отрезать единственный канал администрирования и не должна стирать данные, которые ещё можно сохранить. Для решения важны объём текущего ущерба и цена остановки почты.
Смените пароль подтверждённо затронутой учётной записи с чистого устройства, завершите активные сессии и отзовите подозрительные пароли приложений или токены, если система это поддерживает. Отдельно проверьте привилегированные и сервисные учётные записи, но меняйте их с учётом зависимостей интеграций: секрет, обновлённый только в одном месте, способен остановить штатную отправку. Для администраторов включите многофакторную защиту, если её поддерживает выбранная платформа. Затем закройте причину входа обновлением или исправлением настройки, а не ограничивайтесь сменой пароля.
Переустановка — не обязательный ответ на любой инцидент и не магическая гарантия чистоты. Если затронуты права администратора/root, изменены системные компоненты или целостность узла нельзя подтвердить, безопаснее подготовить чистую систему и перенести только проверенные данные и настройки. При подтверждённой компрометации одного почтового ящика без доступа к серверу объём восстановления может быть другим. Сначала сохраните доказательства, определите масштаб, проверьте резервную копию и секреты, затем выбирайте восстановление. После запуска проверьте входящую и исходящую доставку и продолжайте наблюдать за журналами.
В условной истории школы итог расследования пока не задан, поэтому я не обещаю «полностью устранить угрозу» и не утверждаю, что переустановка уже была выполнена. Рабочий план должен перечислять подтверждённые симптомы, неизвестные факты, ответственных и критерии возвращения почты в работу. Отдельный список первых действий есть в статье о том, что делать при взломе почтового ящика. Если случай затрагивает весь почтовый сервер, к плану добавляются журналы MTA, правила маршрутизации, интеграции и контроль доставки.
callout
Сначала локализуйте подтверждённый источник, затем меняйте доступ и настройки. Не удаляйте следы до того, как зафиксировали, что именно нашли.
Частые вопросы
Как понять, что почтовый сервер действительно взломан?
Сопоставьте необычные входы, изменения правил, события MTA и фактические письма. Один признак — сигнал для проверки; вывод делают по совокупности независимых данных.
Где искать логи почтового сервера?
Проверьте настройки журналирования установленной системы. Это могут быть файлы в `/var/log/` или журнал systemd; точный путь зависит от дистрибутива, MTA и конфигурации syslog.
Рост очереди писем означает взлом?
Нет. Для Postfix очередь смотрят через `postqueue -p`, затем сверяют статусы и идентификаторы сообщений с журналами. Очередь может расти и из-за обычного сбоя доставки.
Нужно ли сразу выключать сервер?
Не автоматически. Зафиксируйте доступные данные и оцените, продолжается ли отправка или утечка. При активной угрозе ограничьте подтверждённый источник штатным для инфраструктуры способом.
Обязательно ли переустанавливать сервер после инцидента?
Нет. Решение зависит от масштаба доступа и доверия к целостности системы. При компрометации привилегий или изменении системных компонентов обычно готовят чистое восстановление и переносят проверенные данные.
Источники
- Postfix: руководство postqueue(1) — Проверено: параметр `-p` выводит список очереди Postfix. https://www.postfix.org/postqueue.1.html
- Dovecot: Logging — Проверено: расположение журналов зависит от syslog и конфигурации; раздел описывает журналирование аутентификации и возможную потерю сообщений при ограничении потока. https://doc.dovecot.org/2.3/admin_manual/logging/
- Debian Reference: systemd и системный журнал — Проверено: journald хранит записи в постоянном или временном журнале, просматривать их можно через journalctl; systemd позволяет просматривать системные таймеры. https://www.debian.org/doc/manuals/debian-reference/ch03.en.html
- Filesystem Hierarchy Standard — Проверено: назначение каталогов `/tmp` и `/var/tmp`; содержимое `/var/tmp` рассчитано на сохранение между перезагрузками. https://refspecs.linuxfoundation.org/FHS_3.0/fhs-3.0.html
- NIST SP 800-61 Rev. 3 — Проверено: актуальные рекомендации NIST по подготовке, обнаружению, реагированию и восстановлению после инцидентов; редакция 2025 года заменила Rev. 2. https://csrc.nist.gov/pubs/sp/800/61/r3/final
- NIST SP 800-86: Guide to Integrating Forensic Techniques into Incident Response — Проверено: при сборе свидетельств нужно документировать состояние системы и учитывать изменчивость данных. https://csrc.nist.gov/pubs/sp/800/86/final