
Как я ищу перебор паролей, когда IP меняется каждый час
Чтобы найти брутфорс при смене IP, я сопоставляю запросы к форме входа по времени, пути и результатам авторизации. Адрес оставляю дополнительным признаком. Ниже — порядок сбора журналов, рабочая команда для стандартного формата и проверка, которая помогает отличить перебор от обычных ошибок пользователей.
Какие признаки связывают запросы с разных IP
Я начинаю с событий входа на конкретном сайте: какой аккаунт пытаются открыть, каким способом и с каким результатом. Брутфорс — это подбор учётных данных; огромный поток для него необязателен. Медленный перебор тоже остаётся перебором. При настройке защиты сайта я проверяю не только внешний адрес, но и то, что происходило внутри приложения. Иначе смена IP превращает одну последовательность попыток в несколько безобидных строчек отчёта.
Сначала я отмечаю повторяющиеся POST-запросы к реальной точке авторизации, распределение по времени и число отказов для одного аккаунта. Пути /wp-login.php и /admin/login ниже служат примерами: у вашего сайта маршрут может отличаться. Одинаковый путь сам по себе ничего не доказывает — законные пользователи входят через ту же форму. Меня интересует сочетание признаков: продолжение отказов после смены адреса, однотипные обращения и отсутствие понятной деловой причины для такой последовательности.
Затем разделяю HTTP-ответ и результат проверки пароля. HTTP 200 может означать, что сервер успешно отдал страницу с сообщением об ошибке входа. Код 403 может появиться из-за запрета доступа ещё до проверки учётных данных. Даже перенаправление после POST приходится проверять по логике конкретной формы. Я делаю разрешённый тестовый вход с правильным и неправильным паролем и сопоставляю записи. Угадать поведение приложения по одному коду — бухгалтерия по цвету папки.
У стандартных журналов доступа есть важная граница: тело POST туда обычно не попадает. Логин и пароль из формы нельзя извлечь из обычного combined, если приложение отдельно их не записало. Поэтому обещание найти одинаковые username и password по access.log я сразу вычёркиваю. Пароли вообще не должны становиться материалом для такого расследования. Для связи попыток мне нужен безопасный идентификатор аккаунта из журнала авторизации и результат проверки, а не копия содержимого формы.
Общие способы защиты админки разобраны в статье про атаки на админку CMS. Здесь я решаю более узкую задачу: как связать события, когда адрес источника меняется. Проверяю обе картины: много отказов для одного аккаунта с разных адресов и отказы для множества аккаунтов за общий интервал. Во втором случае отдельная учётная запись может выглядеть спокойно, хотя суммарно сайт получает устойчивую серию попыток.
- Фактическая точка входа и метод запроса
- Время, сайт и результат авторизации
- Один аккаунт с разных адресов
- Множество аккаунтов в общей серии
Какие журналы собрать и что проверить в формате
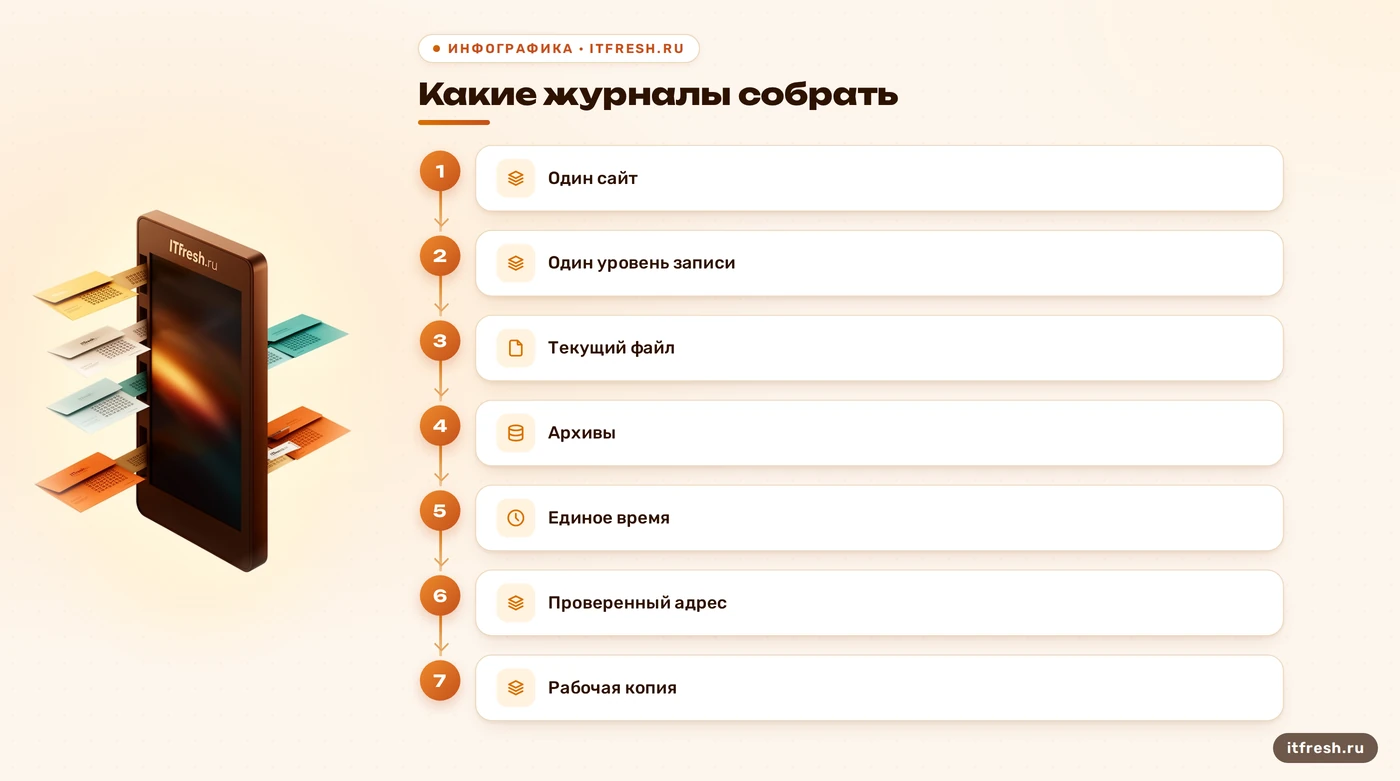
Я сохраняю исходные журналы доступа, события авторизации приложения и доступные записи защитного фильтра за один интервал. Рабочие копии держу отдельно от сайта, с доступом только для тех, кто разбирает инцидент. Сначала записываю, какой файл относится к какому узлу, домену и часовому поясу. Если журналы уже удалены при ротации, честно фиксирую пробел. Поздняя настройка подробного журнала поможет следующему разбору, но прошлые события из воздуха не восстановит.
Я не складываю вслепую журналы Nginx и Apache. Если Nginx передаёт запросы в Apache, один вход может появиться на обоих уровнях. Простое объединение удвоит счётчик. Для первичного подсчёта выбираю один уровень записи, а второй использую для проверки деталей. Журналы разных сайтов также оставляю раздельными, пока не появится надёжное поле домена. Иначе чужой /login легко станет частью нашего инцидента. Цифр будет больше, смысла меньше.
Фактическое расположение файлов я смотрю в настройках access_log у Nginx и CustomLog у Apache. Путь зависит от установки, контейнера и виртуального хоста. В примере дальше используются уже сохранённые копии access.log, access.log.1 и access.log.2.gz в закрытом рабочем каталоге. Это условные имена выбранных файлов, а не обещание, что они существуют на любом сервере. Сжатый архив сначала распаковываю в поток: обычный cat сжатое содержимое не превратит в строки запросов.
Отдельно проверяю адрес клиента за обратным прокси или CDN. Это существенное дополнение из экспертной базы: без корректного восстановления адреса журнал может показывать посредника. В Nginx директива set_real_ip_from задаёт доверенные источники замены адреса, real_ip_header — нужный заголовок. Их выбирают по реальной схеме соединений. Доверять произвольному X-Forwarded-For от посетителя нельзя. При этом график числа запросов можно построить и без IP: адрес нужен для части расследования, а не для самого существования графика.
Перед запуском команд сверяю формат записи с документацией Nginx и Apache. В обычной строке combined запрос заключён в кавычки, после него идут статус и размер ответа. При разбиении такой строки по пробелам $7 обычно содержит цель запроса, а $8 — протокол с закрывающей кавычкой; это не отдельная строка параметров. Время содержит смещение часового пояса. Добавленный в начало домен или нестандартный формат меняет позиции полей, поэтому я сначала проверяю несколько реальных строк.
- Сохранить исходники и сведения об их происхождении
- Выбрать один уровень подсчёта для одного сайта
- Проверить формат, ротацию и часовой пояс
- Установить, чей адрес записан в журнале
Как посчитать запросы без ошибочного хеширования
Для первичной сводки мне достаточно явного ключа: час, смещение времени, метод, путь и HTTP-статус. Команда ниже рассчитана на обычный common или combined с адресом в начале строки и запросом в кавычках, на один сайт и выбранный уровень записи. Перед ней я проверяю успешное чтение каждого файла. Нельзя продолжать анализ, если сбор завершился ошибкой: пустой отчёт о непрочитанном архиве слишком легко принять за отсутствие атаки.
Допустим, в рабочем каталоге лежат именно три проверенные копии из предыдущего раздела. Первой командой я создаю объединённую копию, второй добавляю распакованный архив. Перенаправление > перезаписывает access.all.log; исходники остаются отдельными. Повторно добавлять архив без пересоздания объединённого файла нельзя — появятся дубли. Если выбран другой набор файлов, меняю список явно, а не захватываю всё подряд маской.
cat ./access.log ./access.log.1 > ./access.all.log
gzip -cd -- ./access.log.2.gz >> ./access.all.log
Затем считаю POST к двум условным точкам входа. Список путей нужно заменить на маршруты своего приложения. Разделитель кавычка позволяет сначала выделить запрос, а затем разобрать его части. У строки запроса я убираю query string только для объединения обращений к одному маршруту; исходная запись остаётся в сохранённом журнале.
awk -F'"' '
{
  n = split($2, request, /[[:space:]]+/)
  if (n != 3 || request[1] != "POST") next
  split(request[2], uri, /\?/)
  if (uri[1] != "/wp-login.php" && uri[1] != "/admin/login") next
  split($1, meta, /[[:space:]]+/)
  hour = substr(meta[4], 2, 14)
  zone = meta[5]
  sub(/\]$/, "", zone)
  status = $3
  sub(/^[[:space:]]+/, "", status)
  split(status, response, /[[:space:]]+/)
  print hour, zone, request[1], uri[1], response[1]
}
' ./access.all.log | sort | uniq -c | sort -nr
В результате каждая строка содержит счётчик, час, смещение, метод, путь и статус. Например, 24 25/Oct/2026:02 +0300 POST /wp-login.php 200 означает 24 подходящих HTTP-запроса в этом часовом интервале, а не 24 успешных входа. В стандартной дате журнала substr с длиной 14 сохраняет час; более короткая обрезка может потерять его часть. Смещение я вывожу отдельным полем, чтобы одинаковое местное время с разными поясами не склеилось незаметно. Для общего графика нескольких узлов сначала требуется привести время к единой шкале.
Хеширование здесь не помогает. Вызов md5sum без списка файлов читает стандартный ввод как один поток и выдаёт одну контрольную сумму. Конструкция с ним перед sort и uniq не считает повторения отдельных запросов. Я оставляю ключ читаемым: так можно проверить любую группу по исходникам. Команда не поддерживает произвольные форматы и не определяет аккаунты; для JSON-журнала нужен соответствующий разбор. После настройки сверяю число выбранных строк со сводкой и проверяю, что известный тестовый вход попал в ожидаемую группу.
- Собирать только выбранные файлы без дублей
- Группировать по понятным полям
- Сохранять различия часовых поясов
- Проверять сводку на известном запросе
Как отличить перебор от обычных ошибок входа
После сводки я возвращаюсь к событиям приложения. Минимально полезная запись сообщает время, идентификатор аккаунта, результат проверки и причину отказа. Если есть идентификатор запроса, связываю по нему внешний запрос и событие авторизации. Если его нет, сопоставление по времени и остальным полям менее надёжно — эту неопределённость отмечаю в отчёте. Потерянный журнал нельзя заменить уверенностью редактора, администратора или красивой диаграммы.
Универсального порога вроде ста запросов в сутки или десятикратного превышения среднего я не назначаю. Сначала беру сопоставимые спокойные интервалы: рабочее время, ночные задания, дни рассылок и изменения сайта. Потом смотрю число отказов, долю успешных входов и распределение по аккаунтам. Редкий административный вход и массовая авторизация сотрудников имеют разную норму. Среднее за весь месяц способно спрятать и короткий всплеск, и устойчивую медленную серию.
Я отдельно проверяю объяснения, не связанные с атакой: устаревший пароль интеграции, сломанный вход после обновления, повторные отправки формы или проверку доступности. Одинаковый User-Agent годится как дополнительная подсказка, но не устанавливает личность отправителя. Один внешний IP тоже может принадлежать множеству пользователей. Если вместе с отказами выросли ошибки приложения и жалобы сотрудников, сначала нужно понять, что изменилось в работе сайта. Столбик на графике ещё не признался в преступлении.
Для отчёта я строю рядом запросы к форме, подтверждённые отказы, успешные входы и число затронутых аккаунтов. Часовая сводка показывает общий ход событий; для проверки короткой серии возвращаюсь к более мелкому интервалу и исходным временным меткам. Если подозрительная активность продолжилась после смены набора IP, проверяю, сохранилась ли цель. Продолжение отказов по тому же аккаунту весомее, чем два соседних пика обращений к популярной странице.
Записи с действующей сессией я автоматически не выкидываю. В них может оказаться как обычная работа сотрудника, так и действие после чужого входа. При этом сами пароли, значения cookie и токены в аналитическую выгрузку не переношу. Когда журнал вообще не содержит результата входа, формулирую вывод ограниченно: обнаружены подозрительные обращения к авторизации. Оценить, какие из них завершились доступом, по этим данным нельзя. Такой пробел должен попасть в план настройки журналирования.
- Сопоставить запросы с отказами и успехами
- Проверить изменения сайта и интеграций
- Сравнить одинаковые по смыслу интервалы
- Отметить пробелы, влияющие на вывод
Учебный разбор: адреса сменились, аккаунт остался
Покажу порядок на условной ситуации для студии «Бриз Групп», уже заданной в этой статье. Это учебный пример, не отчёт о реальном клиенте; все количества ниже служат для объяснения расчёта. Допустим, мы сохранили журнал одного сайта в combined и события его авторизации за два соседних часа. На обоих уровнях используется одинаковое смещение +0300. Перед подсчётом я исключаю повторный учёт одного запроса на внешнем сервере и в приложении.
В первый час находится 24 POST к /wp-login.php, во второй — ещё 24. В каждом часе обращения распределены между 12 адресами, по два на адрес; во втором часе набор адресов полностью другой. Итого получается 48 запросов с 24 разных адресов. Это исходные числа учебного набора, не рекомендованный порог защиты. Список самых активных адресов здесь не впечатляет. Зато сводка по маршруту показывает непрерывную активность после смены источников.
Теперь добавляю учебное условие из журнала авторизации: все 48 запросов относятся к одному внутреннему идентификатору аккаунта, 47 завершились отказом, один — успешной проверкой. Сумма сходится: 47 + 1 = 48. Успешное событие отдельно сверяю с владельцем аккаунта и последующими действиями. Оно могло принадлежать законному пользователю, который вошёл во время перебора. Без такой проверки нельзя объявлять компрометацией само соседство успеха и отказов.
Я фиксирую границы вывода: есть серия отказов по одному аккаунту с меняющимися адресами, а принадлежность успешного входа требует проверки. Затем сохраняю относящиеся к нему события, сведения о сессии без её секретного значения и действия после входа. Если обнаруживаются неизвестные изменения, расширяю разбор по порядку аудита сайта. Смена IP не отменяет проверку последствий, но и не даёт права приписать атакующему любую запись рядом по времени.
Практический результат такого разбора — воспроизводимая последовательность: откуда взяты 48 запросов, почему они относятся к одной цели и что известно об успешном входе. В реальной работе к ней добавляются ответственный за решение и список недостающих данных. Я не обещаю остановить тысячи адресов за пару часов: подтверждённых исходников для такого заявления нет. Ценность отчёта в том, что по нему можно выбрать действие и затем проверить его эффект.
- 48 обращений к форме за два часа
- 24 адреса, набор сменился между часами
- 47 отказов и один успех по условию
- Успешный вход проверяется отдельно
Что автоматизировать и чем сдерживать перебор
Первой я автоматизирую доставку проверенного сигнала ответственному: какой сайт, какой аккаунт или группа аккаунтов, за какой интервал и сколько подтверждённых отказов. В отчёте оставляю возможность найти исходные записи. Повторное чтение после ротации не должно создавать новые события, а остановка сборщика — выглядеть как спокойная ночь. Проверяю обе ситуации на копиях журналов. Сводка раз в час удобна для обзора, но это не обещание немедленного обнаружения; допустимую задержку выбираем по задаче.
Три недостающих опоры из базы здесь особенно полезны. Адрес за обратным прокси нужно восстановить корректно — это проверено выше. Второй фактор для административных аккаунтов затрудняет вход с одним подобранным паролем; способ подключения зависит от CMS и используемых расширений. Наконец, у WordPress есть XML-RPC с методами, требующими авторизации: ограничиться наблюдением за браузерной формой недостаточно. Проверяю обращения к /xmlrpc.php и используемые интеграции. Его наличие само по себе не означает уязвимость, а отключение без проверки может сломать рабочую связь.
Сдерживание настраиваю с учётом аккаунта и общей активности входа: одна лишь смена IP не должна обнулять наблюдаемую серию отказов. Это согласуется с рекомендациями OWASP по ограничению попыток. Но жёсткая блокировка аккаунта после чужих ошибок способна закрыть доступ самому владельцу. Поэтому заранее проверяю восстановление доступа и работу законного входа. При выборе фильтра полезен разбор, что реально защищает WAF: настройки должны соответствовать поведению приложения.
Fail2ban я сохраняю как дополнительный инструмент для источников, которые повторяют подтверждённые нарушения. В обычной схеме maxretry задаёт число совпадений с фильтром, findtime — интервал их поиска, bantime — длительность блокировки. Смена адреса раз в час сама по себе не делает его бесполезным: если порог достигнут раньше, правило успеет сработать. Ограничение возникает, когда каждый адрес остаётся ниже порога, а общая серия продолжается. Тогда нужны общие признаки и меры на уровне приложения.
Из исходной рекомендации я убираю автоматическую отправку всех подозрительных адресов в INPUT. Правило iptables с действием DROP само по себе не имеет срока жизни в час; для снятия требуется отдельный механизм. Оно также может затронуть другие обращения с того же адреса. До включения любой автоматической блокировки проверяю область действия, причину срабатывания и способ отмены. Для узла за посредником особенно важно не заблокировать сам посредник. Без проверки происхождения IP такая автоматика способна устроить отказ доступа собственными руками.
Завершаю настройку проверкой обычного входа, серии тестовых отказов, смены источника, уведомления и снятия ограничения. Режим наблюдения позволяет сначала оценить ложные срабатывания. Если эффект подтверждён, сохраняю настройки, порядок отката и критерии пересмотра порогов. При признаках чужого успешного входа отдельно разбираю доступы и действия аккаунта: сокращение числа запросов после фильтра ещё не подтверждает, что последствия устранены. Автоматизация должна повторять понятное решение, а не размножать ошибку быстрее человека.
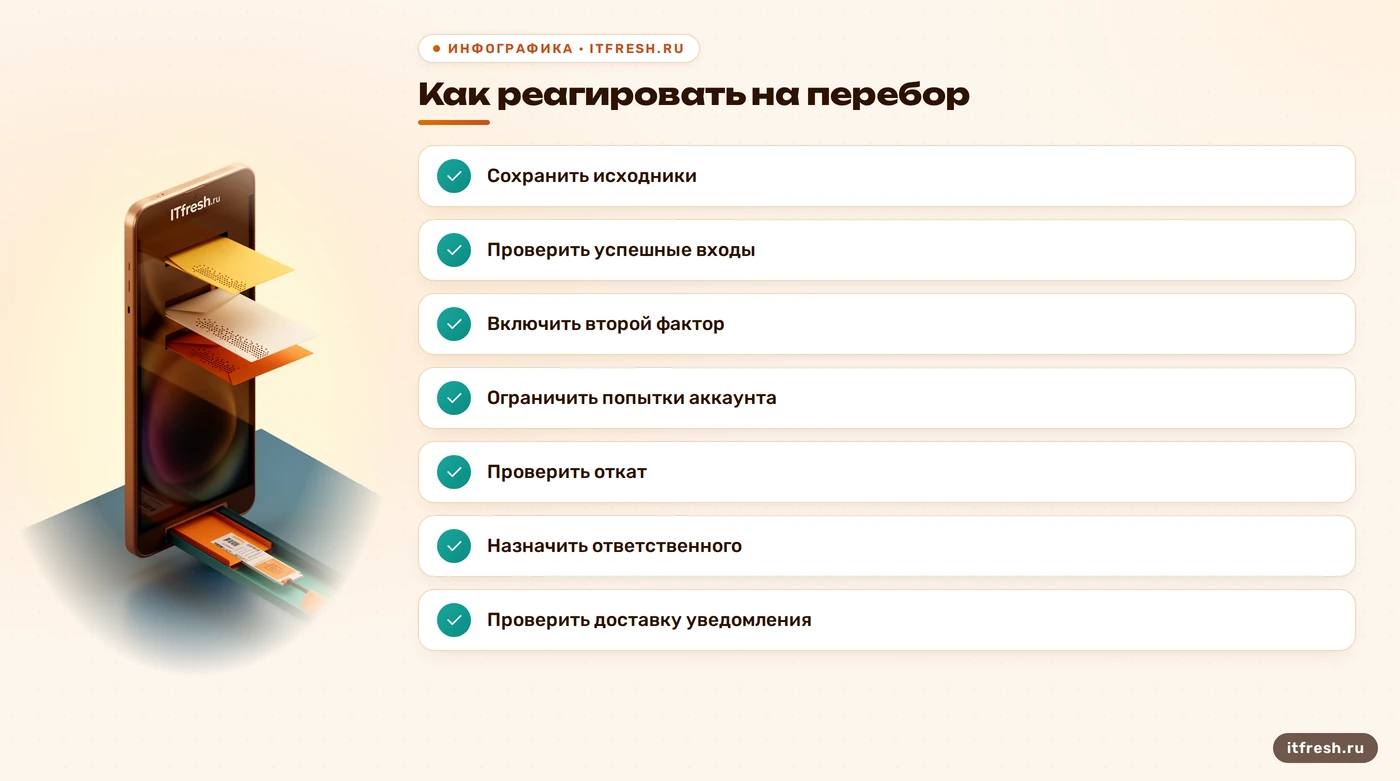
- Сигнал с контекстом и ссылкой на исходники
- Второй фактор и контроль всех способов входа
- Ограничения с проверкой законного доступа
- Испытанный откат и ответственный за реакцию
Частые вопросы
Как найти атаку, если каждый IP делает мало запросов?
Я объединяю события по сайту, точке входа, времени и аккаунту. Смотрю продолжение отказов при смене адресов и общую активность по множеству аккаунтов. Один IP — только дополнительный признак.
Можно ли считать HTTP 200 успешным входом?
Нет. Это может быть страница с сообщением об ошибке пароля. Результат проверяю по событию авторизации и известному поведению конкретного приложения.
Нужно ли хешировать строки запросов?
Для этой сводки нет. Я группирую явные поля через sort и uniq -c. Обычный md5sum в конце потока выдаст одну контрольную сумму, а не частоты отдельных строк.
Поможет ли Fail2ban при смене IP каждый час?
Поможет против источника, который достигнет порога в пределах findtime. Если каждый адрес остаётся ниже порога, его обычной блокировки по IP недостаточно: нужны ограничения и анализ на уровне приложения.
Есть ли обязательный порог количества попыток?
Нет универсального числа для любого сайта. Я выбираю порог по обычной активности и подтверждённым отказам, затем проверяю ложные срабатывания и восстановление законного доступа.
Удалится ли обычное правило iptables через час?
Нет. У правила DROP нет такого срока по умолчанию. Временное ограничение требует отдельного механизма снятия и проверки, что отмена действительно сработала.
Источники
- NGINX: журнал доступа и доверенные адреса — Проверены combined, access_log, поля времени, запроса и статуса: https://nginx.org/en/docs/http/ngx_http_log_module.html ; восстановление адреса только от доверенных источников: https://nginx.org/en/docs/http/ngx_http_realip_module.html . Подтверждение добавленного факта экспертной базы об адресе за обратным прокси.
- Apache HTTP Server: Log Files — Проверены CustomLog, common и combined, состав записи запроса и ротация: https://httpd.apache.org/docs/2.4/logs.html .
- GNU: обработка строк, подсчёт и распаковка — md5sum обрабатывает стандартный ввод как один поток: https://www.gnu.org/software/coreutils/manual/html_node/md5sum-invocation.html ; sort и uniq -c: https://www.gnu.org/software/coreutils/manual/html_node/sort-invocation.html и https://www.gnu.org/s/coreutils/manual/html_node/uniq-invocation.html ; split, substr, sub: https://www.gnu.org/s/gawk/manual/html_node/String-Functions.html ; gzip -c и -d: https://www.gnu.org/software/gzip/manual/html_node/Sample.html .
- OWASP: авторизация и журналирование — Ограничение попыток с учётом аккаунта, риск отказа доступа и второй фактор: https://cheatsheetseries.owasp.org/cheatsheets/Authentication_Cheat_Sheet.html ; результаты входа, исключение паролей и токенов из журналов: https://cheatsheetseries.owasp.org/cheatsheets/Logging_Cheat_Sheet.html . Подтверждение добавленного факта экспертной базы о двухфакторной аутентификации.
- WordPress: XML-RPC и проверка учётных данных — Интерфейс XML-RPC и его назначение: https://developer.wordpress.org/apis/xml-rpc/ ; адрес xmlrpc.php: https://developer.wordpress.org/rest-api/using-the-rest-api/discovery/ ; методы с авторизацией: https://developer.wordpress.org/reference/classes/wp_xmlrpc_server/login/ . Подтверждение добавленного факта экспертной базы об отдельном интерфейсе входа и зависимых интеграциях.
- Fail2ban и Netfilter: блокировка и её длительность — Семантика maxretry, findtime и bantime в официальной конфигурации: https://github.com/fail2ban/fail2ban/blob/master/config/jail.conf ; добавление и удаление правил iptables, действие DROP без автоматического часового срока: https://ipset.netfilter.org/iptables.man.html .