
Как я провожу аудит безопасности сайта небольшой компании: от границ проверки до повторного теста
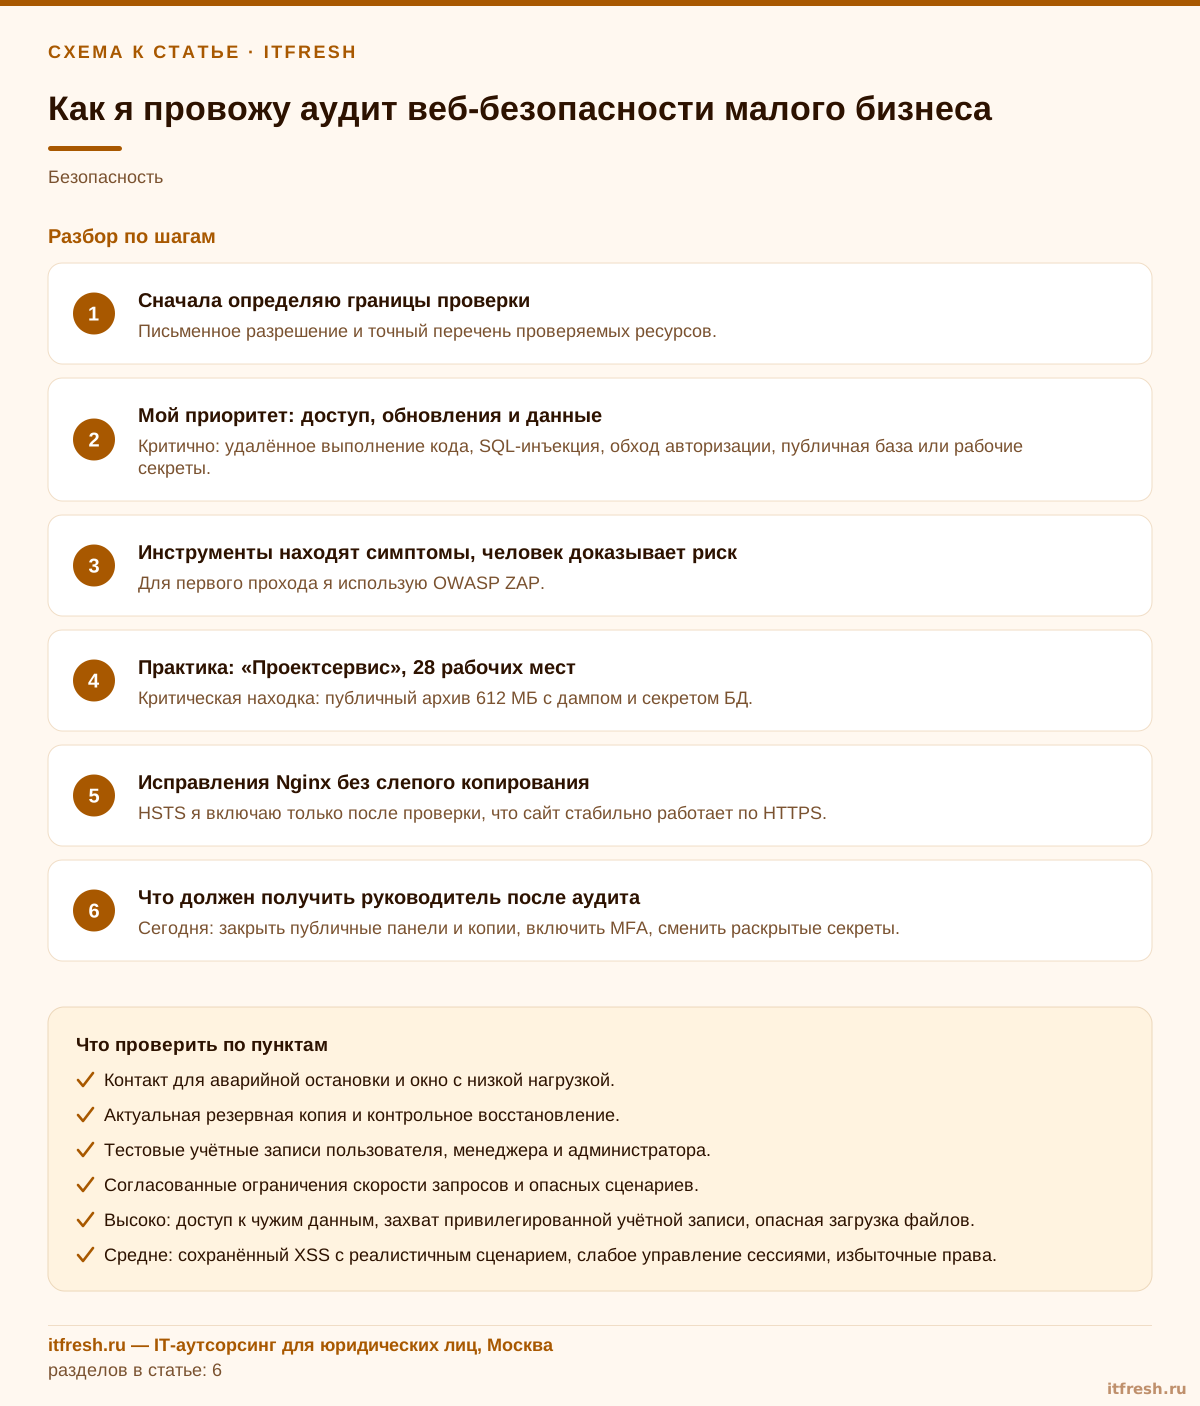
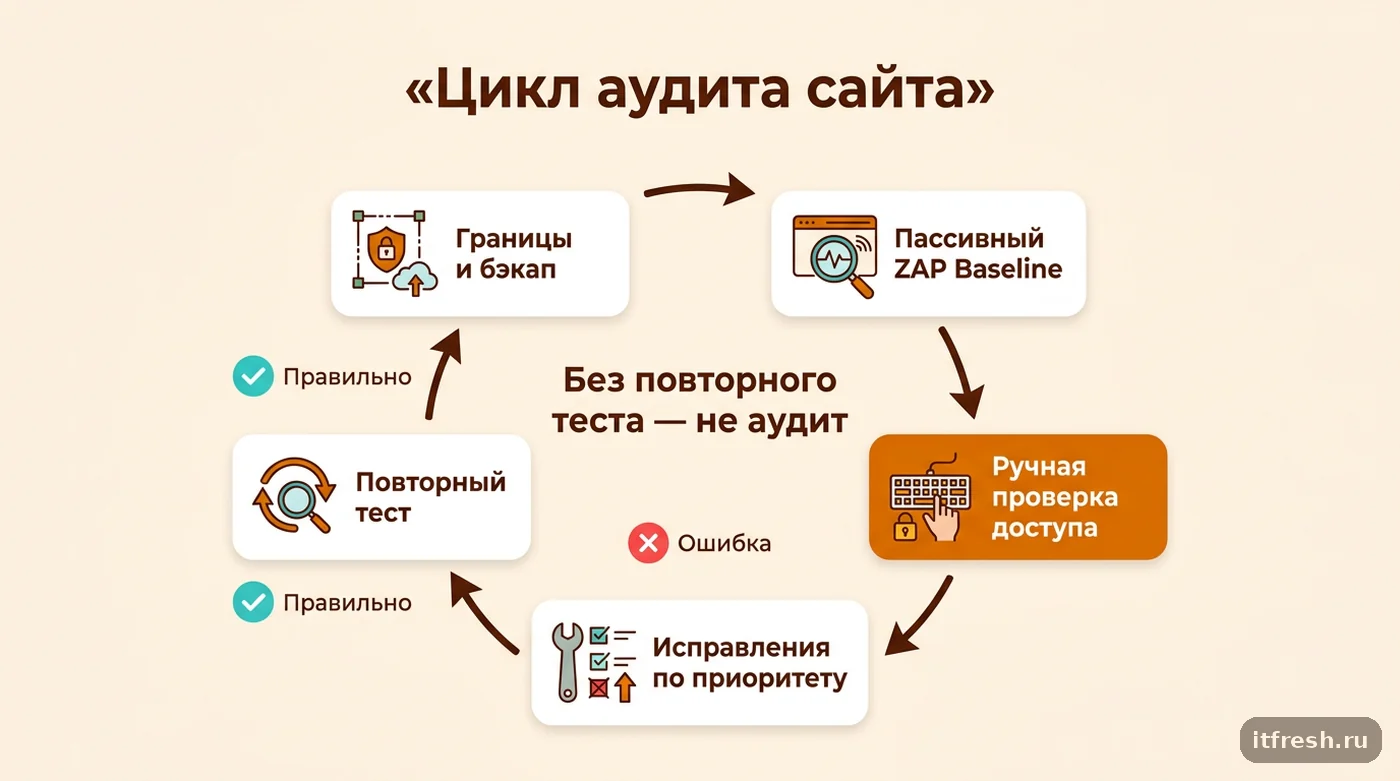
Аудит безопасности сайта — это не прогон сканера, а четыре шага: согласовать границы, найти пути к данным и админке, вручную подтвердить риск и перепроверить исправление. Ниже мой порядок для компании до 50 мест: что проверять первым, как отделять угрозы от шума сканера и какие правки дают максимум.
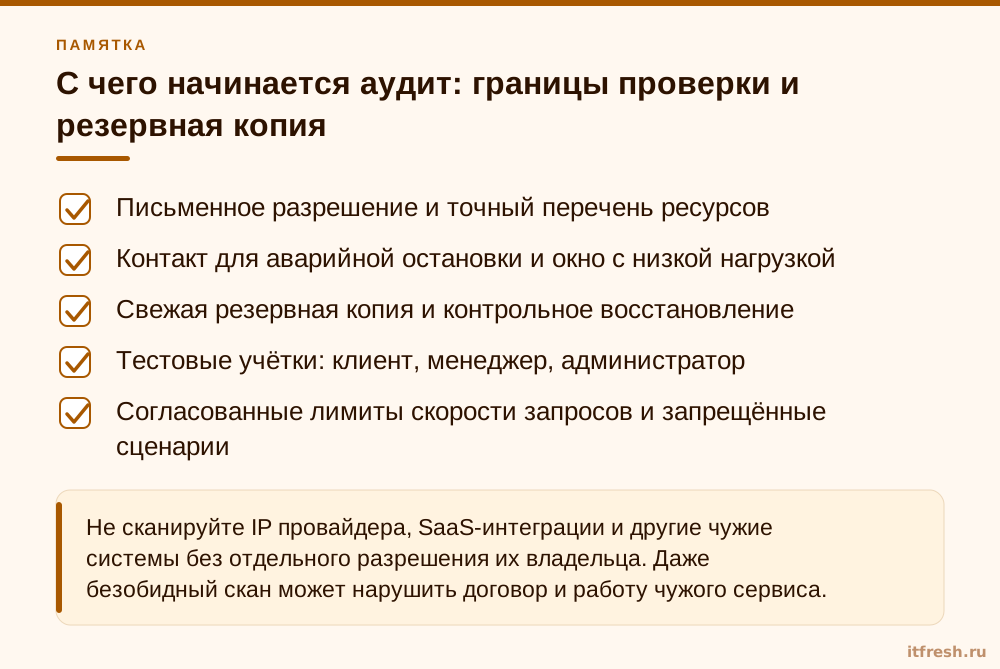
С чего начинается аудит: границы проверки и резервная копия
Сайт открывается, заявки приходят, замок HTTPS горит — и руководитель считает вопрос закрытым. Я начинаю с неприятного уточнения: HTTPS защищает канал, но не спасает от старой CMS, чужих документов в личном кабинете, открытой админки или резервной копии в публичном каталоге. Поэтому аудит информационной безопасности сайта я никогда не начинаю со сканера. Сначала письменно фиксирую домены, IP-адреса, тестовые учётные записи, разрешённые действия и время работ.
Это не бюрократия. Активный сканер отправляет необычные запросы, перебирает параметры и может создавать записи в приложении. На небольшом сайте этого хватает, чтобы засыпать CRM тестовыми заявками, заблокировать пользователя или положить старый PHP-процесс. Проверка без согласованной области опасна даже для собственного сайта, если хостинг и CMS обслуживает подрядчик.
В область я включаю не только основной домен: поддомены, внешний IP, панели управления, API, личный кабинет, формы, интеграции с CRM и почтой, CDN, DNS, хранилище и процесс публикации. Отдельно отмечаю, где лежат персональные данные и у кого административный доступ. У малого бизнеса самая опасная точка часто не на главной странице, а на забытом тестовом поддомене, в старой панели phpMyAdmin или в архиве, который разработчик оставил рядом с сайтом.
До активных тестов делаю резервную копию и проверяю восстановление — именно проверяю, а не верю зелёной галочке в панели. Затем собираю пассивную картину: DNS-записи, сертификаты, HTTP-заголовки, технологии и открытые порты. Если сайт критичен для продаж, активное сканирование провожу на копии, максимально похожей на боевую, а на рабочем сервере подтверждаю только конкретные находки.
Забытые поддомены я ищу не перебором, а по журналам Certificate Transparency: каждый выпущенный публичный сертификат попадает в открытые логи, и поиск по домену на crt.sh за минуту показывает, какие имена когда-либо получали сертификат. В половине проектов там находится что-то вроде test, old или dev, о чём текущий администратор не знает. Второй источник — DNS-зона у регистратора: сверяю её с тем, что реально отвечает, и удаляю записи, которые указывают на чужие или освободившиеся адреса облачных провайдеров.
- Письменное разрешение и точный перечень ресурсов
- Контакт для аварийной остановки и окно с низкой нагрузкой
- Свежая резервная копия и контрольное восстановление
- Тестовые учётки: клиент, менеджер, администратор
- Согласованные лимиты скорости запросов и запрещённые сценарии
Что проверять первым: доступ, обновления и данные
Я начинаю не с HTTP-заголовков и не с красивого отчёта. Сначала ищу пути к административному доступу: слабые и повторно используемые пароли, отсутствие MFA, общие учётные записи, открытые панели, секреты в репозитории, сброс пароля через плохо защищённую почту. Затем сверяю версии CMS, плагинов, веб-сервера и ОС с бюллетенями производителей. Известная уязвимость в доступном из интернета компоненте — работа на сегодня, а не пункт квартального плана.
Следом разбираю функции, через которые идут данные: авторизацию, смену роли, загрузку файлов, поиск, формы, экспорт, API. Опираюсь на OWASP Web Security Testing Guide и OWASP Top 10:2025, где нарушение контроля доступа (Broken Access Control) по-прежнему на первом месте, категория A01. Но чек-лист не заменяет голову: нужно проверить, получит ли обычный пользователь чужой документ, если поменяет идентификатор в URL, и сверяет ли сервер принадлежность объекта. Автоматический сканер такую бизнес-логику понимает плохо — это хорошо видно и в нашем разборе, где мы нашли и устранили 47 уязвимостей в финтех-приложении: самые опасные находки там тоже были ручными.
Только после рисков захвата и утечки занимаюсь шифрами TLS, защитными заголовками и раскрытием версий. Они важны, но приоритет зависит от контекста. Отсутствующий X-Content-Type-Options я исправлю быстро, но не стану выдавать это за неминуемый взлом. Публичная резервная копия базы, пароль администратора без MFA или обход серверной проверки прав требуют реакции в тот же день.
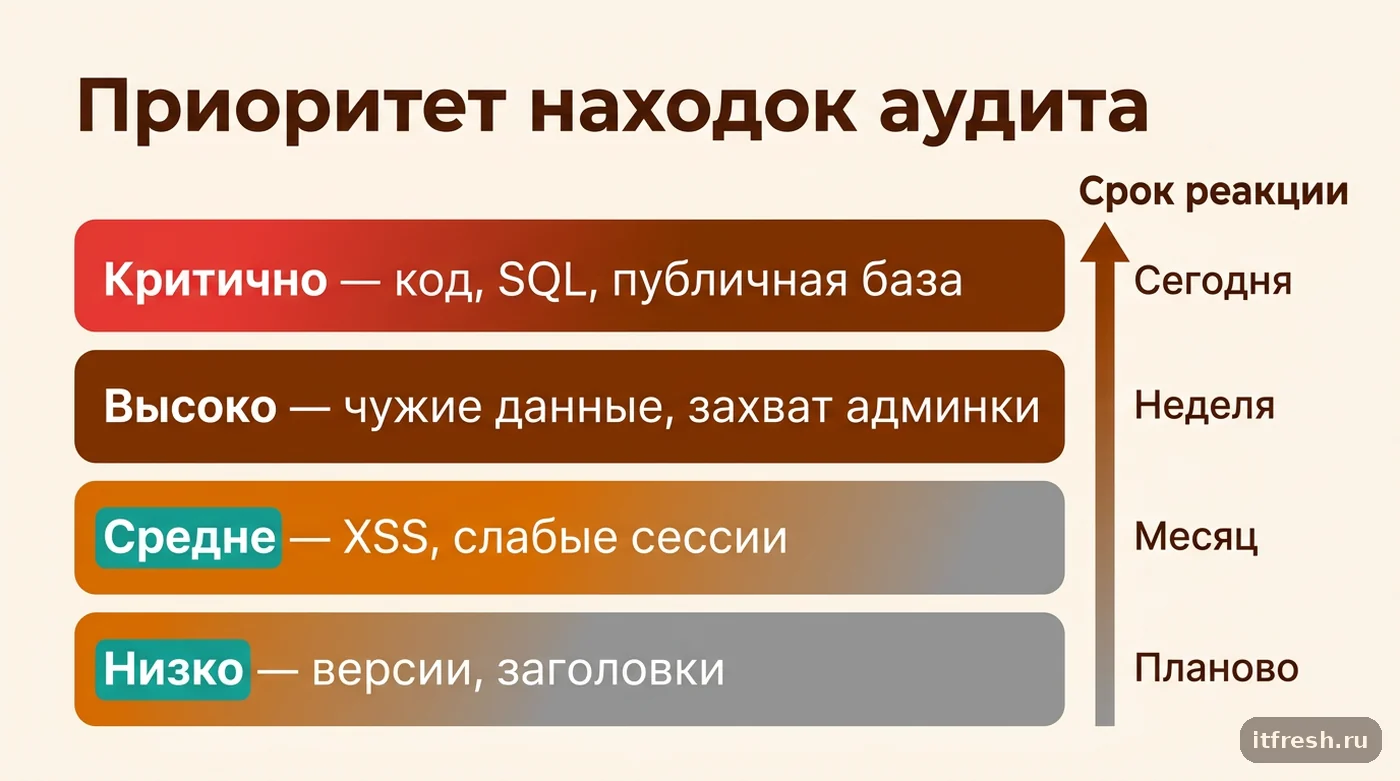
Приоритет я ставлю по простой шкале, а CVSS использую как подсказку, а не как приговор. Атака без авторизации, затрагивающая персональные данные или останавливающая приём заявок, поднимается на уровень выше независимо от «технической» оценки.
Отдельно смотрю на людей и процессы вокруг сайта, потому что взламывают чаще через них, чем через код. Кто из сотрудников и подрядчиков имеет доступ к хостингу, регистратору домена и CMS, есть ли у каждого своя учётная запись, отзывался ли доступ у ушедшего разработчика. Учётка регистратора без MFA — это возможность увести домен целиком, и никакая настройка Nginx от этого не спасёт. Такие находки в отчёт идут наравне с техническими.
- Критично: выполнение кода, SQL-инъекция, обход авторизации, публичная база или рабочие секреты
- Высоко: доступ к чужим данным, захват привилегированной учётки, опасная загрузка файлов
- Средне: сохранённый XSS с реалистичным сценарием, слабое управление сессиями
- Низко: раскрытие версии без применимой уязвимости, отдельные недостающие заголовки
Инструменты: OWASP ZAP находит симптомы, человек доказывает риск
Для первого прохода я использую OWASP ZAP; на сентябрь 2026 года стабильная версия — 2.17.0, а дополнения к ней обновляются отдельно. Baseline Scan обходит сайт spider-ом и делает только пассивный анализ, без атак. Full Scan после обхода запускает активное сканирование и способен повлиять на приложение. Тег контейнера я фиксирую явно, чтобы результат можно было воспроизвести через месяц.
Осторожный пассивный запуск выглядит так. -t задаёт цель, -m ограничивает spider тремя минутами (по умолчанию одна), -r сохраняет HTML-отчёт. Каталог монтируется в /zap/wrk, и он должен быть доступен на запись пользователю внутри контейнера. Даже эту команду нельзя запускать против адреса вне согласованной области.
mkdir -p zap-report && chmod 777 zap-report
docker run --rm -t \
  -v "$(pwd)/zap-report:/zap/wrk/:rw" \
  ghcr.io/zaproxy/zaproxy:2.17.0 \
  zap-baseline.py -t https://example.com -m 3 -r baseline.html
После автоматики вручную прохожу ключевые сценарии через перехватывающий прокси: вход, восстановление пароля, просмотр и изменение объектов, загрузку, экспорт, выход. Проверяю cookies, CSRF-защиту, разграничение ролей и реакцию API на подмену идентификатора. Для набора ручных инструментов подойдёт и дистрибутив, который я описывал в обзоре инструментов пентеста в Kali Linux. Заголовки дополнительно проверяю в Mozilla HTTP Observatory, помня, что сам проект прямо пишет: он не ищет SQL-инъекции, уязвимые плагины и ошибки хранения паролей.
Сырую выгрузку сканера заказчику я не отдаю. Для каждой подтверждённой находки сохраняю запрос и ответ с вычищенными токенами и персональными данными, условия воспроизведения, адрес, возможное влияние и способ исправления. Ложные срабатывания помечаю отдельно. Разработчик получает нормальную задачу, директор — понятный риск вместо 180 страниц красных таблиц.
Full Scan я запускаю только на копии сайта, развёрнутой на отдельной машине с обезличенной базой. Разница в подготовке — пара часов, зато активные проверки не создадут в боевой CRM сотню фиктивных записей и не отправят клиентам письма из формы обратной связи. Если копию сделать нельзя, активные правила включаю выборочно и ограничиваю частоту запросов, а в согласованное окно рядом сидит человек заказчика, который видит журналы приложения.
Разбор из практики: оздоровительный центр «Источник силы», 16 рабочих мест
Оздоровительный центр «Источник силы», 16 рабочих мест. Сайт с онлайн-записью и личным кабинетом, где клиенты скачивают PDF с индивидуальной программой и заключением специалиста по составу тела. Один виртуальный сервер: Ubuntu 22.04 LTS, Nginx 1.18.0 из репозитория дистрибутива, PHP 8.1-FPM, WordPress 6.4.3 и 14 плагинов, два из которых не обновлялись больше года. Сайт стоял за CDN-прокси, но origin-сервер отвечал напрямую по IP, админка WordPress была открыта всему интернету, MFA не было, а плагин резервного копирования складывал архивы в /wp-content/uploads/backup/.
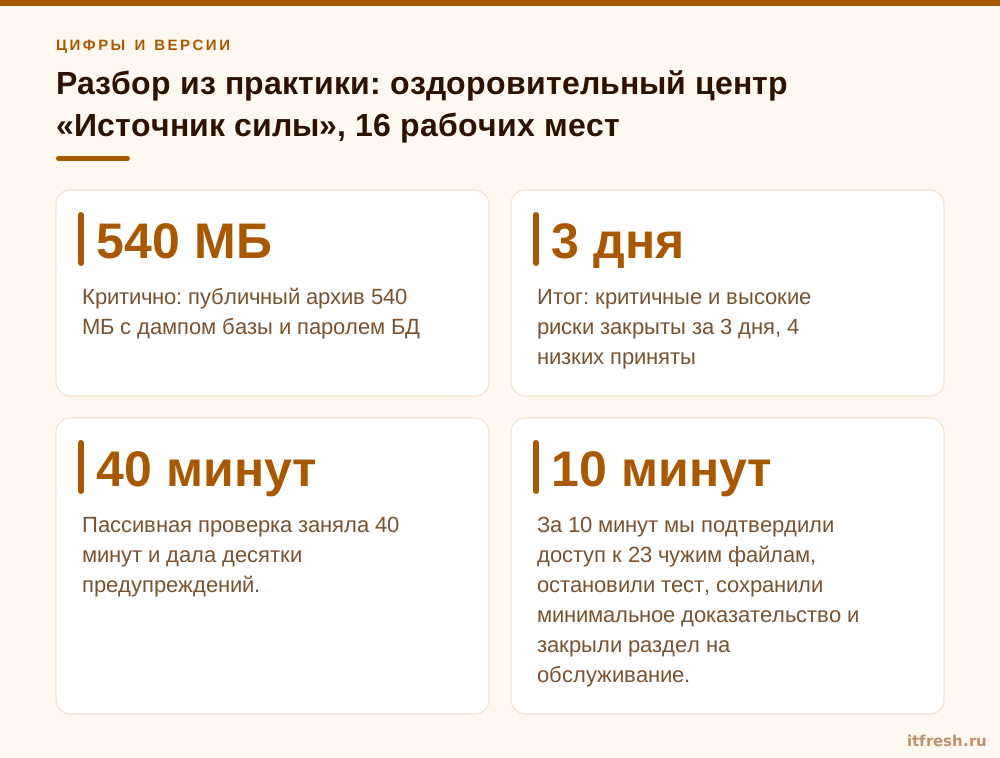
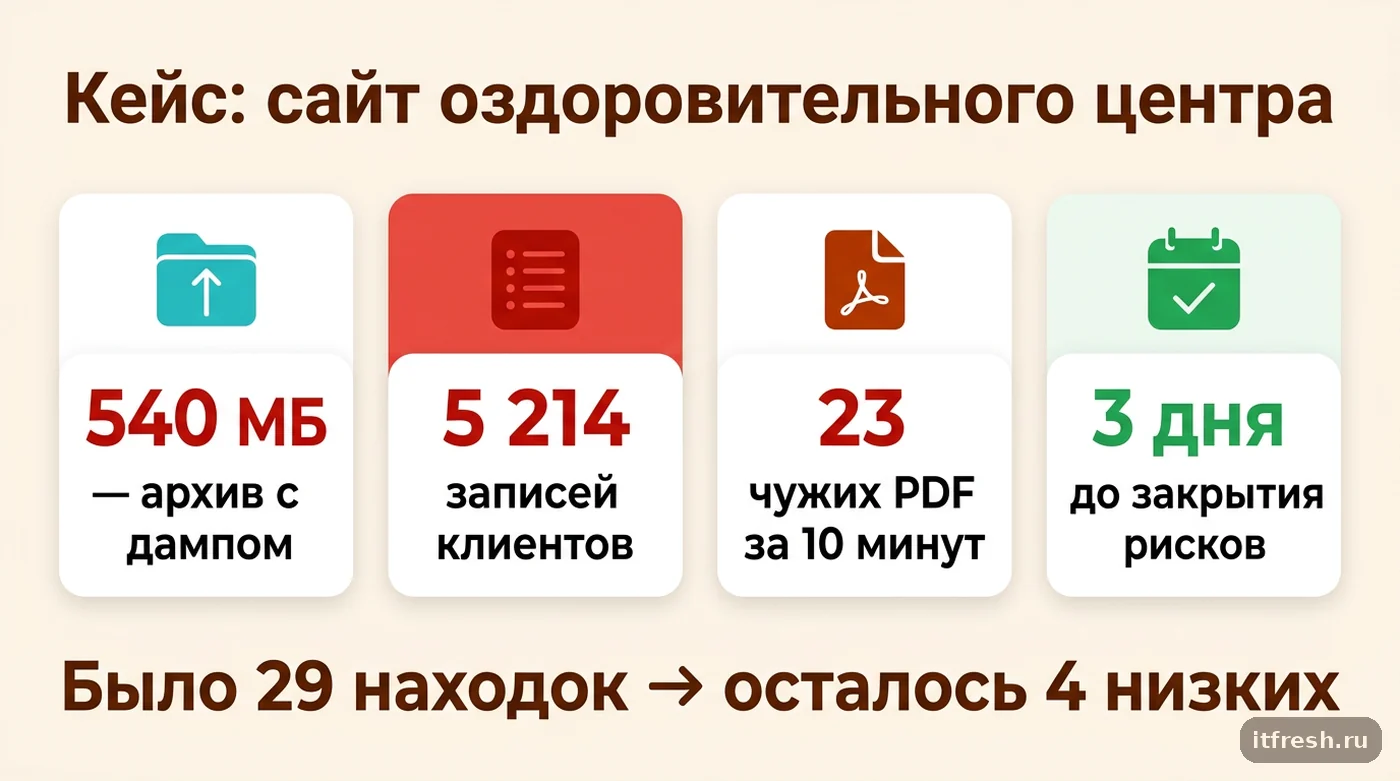
Пассивная проверка заняла 40 минут и дала десятки предупреждений. Действительно важными оказались три: включённый листинг каталога копий, отсутствие HSTS и раскрытие версий в заголовках. В каталоге лежал архив на 540 МБ недельной давности с дампом базы и wp-config.php с паролем БД. К SSH пароль не подошёл, поэтому в отчёте я не писал, что сервер захвачен. Но в базе было 5 214 записей с именами, телефонами и e-mail, а заключения специалиста — это сведения о здоровье, особая категория персональных данных. Уровень — критический.
Ручная проверка личного кабинета нашла второй риск. Ссылка на PDF имела вид /download/?doc=1847, а сервер проверял только наличие сессии. Тестовый клиент менял номер и получал документы других клиентов. За 10 минут мы подтвердили доступ к 23 чужим файлам, остановили тест, сохранили минимальное доказательство и закрыли раздел на обслуживание. Классический IDOR — нарушение контроля доступа. Остальные 26 предупреждений сканера касались заголовков и версий и аварийных действий не требовали.
В первый же день удалили архивы из web-каталога, сменили пароль БД и ключи WordPress, закрыли firewall так, чтобы origin принимал HTTP(S) только от адресов CDN, включили MFA для трёх администраторов и временно отключили выдачу документов. За три дня разработчик добавил серверную проверку принадлежности документа и заменил последовательные номера на непрозрачные идентификаторы. Копии ушли в отдельное хранилище с отдельной учётной записью, плагины обновили после проверки на копии. Повторный тест утечку не воспроизвёл: из 29 пунктов остались четыре низких, принятые до планового релиза. Восстановление тестовой копии теперь занимает 34 минуты.
По трудозатратам аудит занял три рабочих дня: полдня на согласование и копию, день на автоматику и ручную проверку, день на отчёт и повторный тест после исправлений. Для центра на 16 рабочих мест это соразмерно риску: одна утечка заключений клиентов обошлась бы дороже и деньгами, и репутацией. Ещё важнее, что после аудита у клиента появился регламент: кто обновляет плагины, где лежат копии и кто раз в квартал проверяет восстановление.
- Критично: публичный архив 540 МБ с дампом базы и паролем БД
- Высоко: авторизованный клиент читал чужие PDF с заключениями
- Корневая причина: обновления и копии «на подрядчике», результат никто не проверял
- Итог: критичные и высокие риски закрыты за 3 дня, 4 низких приняты
Исправления в Nginx: заголовки, HSTS и CSP без слепого копирования
HSTS включаю только после проверки, что сайт стабильно работает по HTTPS. Параметр always у add_header добавляет заголовок независимо от кода ответа. includeSubDomains опасен, если где-то остался HTTP-поддомен, поэтому сначала ставлю небольшой max-age, наблюдаю, затем увеличиваю срок. Включение домена в preload-список — отдельное решение: быстро отменить его не получится.
Ниже базовый фрагмент для Nginx 1.18.0 со стенда. CSP сначала включаю в режиме Content-Security-Policy-Report-Only, собираю нарушения и лишь затем перевожу в блокирующий режим: иначе старые виджеты, карты, аналитика и inline-скрипты перестают работать. Отдельно закрываю служебные файлы и архивы.
server {
    listen 443 ssl http2;
    server_name example.com;
    autoindex off;

    add_header Strict-Transport-Security "max-age=86400" always;
    add_header X-Content-Type-Options "nosniff" always;
    add_header Referrer-Policy "strict-origin-when-cross-origin" always;
    add_header Permissions-Policy "camera=(), microphone=(), geolocation=()" always;
    add_header Content-Security-Policy-Report-Only "default-src 'self'; object-src 'none'; base-uri 'self'; frame-ancestors 'self'; report-uri /csp-reports" always;

    location ~ /\.(git|env|ht) { deny all; }
    location ~* \.(sql|bak|zip|tar|gz|7z)$ { deny all; }
}
Важная ловушка: если в каком-то location появится свой add_header, заголовки уровня server в нём перестанут отдаваться — директива наследуется только при отсутствии собственных. Как это обходить, я разбирал в статье про наследование add_header в nginx. Для cookies сессии требую Secure, HttpOnly и подходящий SameSite; выбор между Lax, Strict и None зависит от входа через внешнего провайдера. Загрузки храню вне исполняемого каталога, переименовываю на сервере, ограничиваю размер и проверяю формат по содержимому, а не по расширению.
После каждой правки конфигурации порядок один: nginx -t, затем systemctl reload nginx, затем проверка снаружи командой curl -sI https://example.com/ | grep -iE 'strict-transport|content-security|x-content-type' — и та же проверка для страницы ошибки 404 и для файла из uploads. Именно на них чаще всего выясняется, что заголовки отдаются не везде. Отчёты CSP в режиме Report-Only я собираю одну-две недели: за это время проявляются и виджет онлайн-записи, и счётчик аналитики, и чат поддержки, которые надо внести в политику до перевода в блокирующий режим.
На что можно не тратить первые часы: скрытие каждого баннера версии, погоня за максимальной оценкой внешнего сервиса, запрет всех редких методов HTTP без понимания приложения. Это делается планово. Более широкий список мер для корпоративного сайта — HTTPS, обновления, отделение сайта от внутренней сети, бэкапы, защита от ботов — я собрал в чек-листе безопасности корпоративного сайта.
- HSTS: начать с max-age=86400, увеличивать постепенно
- CSP: сначала Report-Only, потом блокирующий режим
- Закрыть .git, .env, архивы и дампы в web-каталоге
- Cookies сессии: Secure, HttpOnly, осознанный SameSite
- Загрузки — вне исполняемого каталога, проверка по содержимому
Что руководитель должен получить после аудита
Хороший итог аудита — не сертификат «сайт безопасен», такой гарантии не существует. Я отдаю реестр активов, перечень подтверждённых находок, доказательства без чувствительных данных, оценку влияния на бизнес, конкретные исправления, ответственных и сроки. Отдельно перечисляю ограничения: что не проверялось, где не было исходного кода или тестовой роли, какие действия запретил владелец. Без этого отчёт создаёт ложную уверенность.
Для компании до 50 рабочих мест выбираю простой ритм: пассивная автоматическая проверка после заметного релиза, ежемесячный контроль обновлений и внешней поверхности, ежеквартальное восстановление копии и ручной аудит критичных сценариев не реже раза в год. После серьёзной переделки авторизации, API, загрузки файлов или оплаты ждать ежегодного аудита нельзя — проверка нужна до публикации.
Каждую критичную и высокую находку закрываю повторным тестом. Скриншота коммита недостаточно: ошибка может остаться в соседнем endpoint или вернуться из-за конфигурации боевого сервера. Владелец риска называется по должности, а не словом «разработчики». Если исправление откладывается, фиксируем временную защиту, дату пересмотра и остаточный риск.
Мой вывод простой: малому бизнесу не нужен бесконечный пентест. Нужны инвентаризация, дисциплина обновлений, MFA, непубличные копии, серверная проверка прав и несколько часов внимательного ручного тестирования там, где лежат данные и деньги. Эти действия снимают основную часть реального риска.
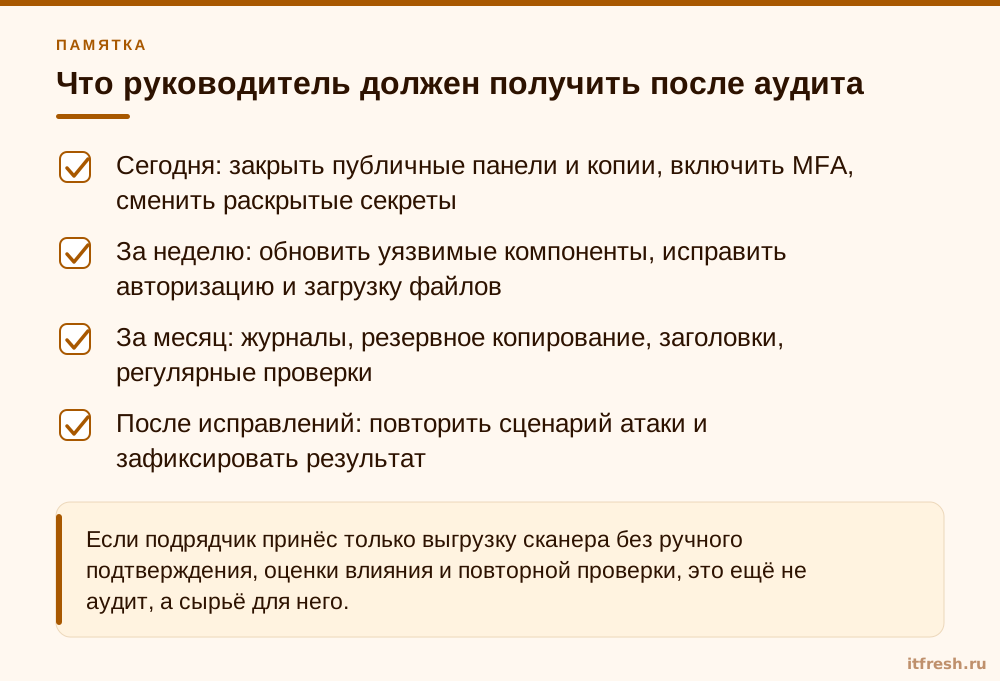
- Сегодня: закрыть публичные панели и копии, включить MFA, сменить раскрытые секреты
- За неделю: обновить уязвимые компоненты, исправить авторизацию и загрузку файлов
- За месяц: журналы, резервное копирование, заголовки, регулярные проверки
- После исправлений: повторить сценарий атаки и зафиксировать результат
Частые вопросы
Можно ли провести аудит безопасности сайта самостоятельно?
Базовую часть — да: инвентаризация, обновления, MFA, поиск публичных копий, заголовки и пассивный ZAP Baseline. Ручную проверку авторизации, API и бизнес-логики лучше доверить специалисту, который подтвердит риск и не повредит данные.
Чем аудит отличается от автоматического сканирования?
Сканер находит технические признаки и известные шаблоны. Аудит добавляет согласованные границы, ручную проверку ролей и бизнес-логики, оценку влияния, приоритеты исправлений и повторный тест.
Опасно ли сканировать рабочий сайт?
Пассивная проверка сравнительно безопасна, хотя spider тоже создаёт нагрузку. Активное сканирование способно менять данные. Нужны резервная копия, окно работ, лимит запросов и план остановки.
Достаточно ли HTTPS и высокой оценки Observatory?
Нет. Они описывают защищённый канал и часть конфигурации, но не находят выдачу чужих документов, слабое восстановление пароля, публичную копию базы или ошибку серверной проверки прав.
Как часто повторять аудит сайта?
Ручную проверку критичных сценариев — после существенных изменений и не реже раза в год. Обновления и внешнюю поверхность — ежемесячно, восстановление копий — ежеквартально.
Источники
- OWASP Web Security Testing Guide — Методика тестирования веб-приложений, разделы по авторизации и контролю доступа. https://owasp.org/www-project-web-security-testing-guide/stable/4-Web_Application_Security_Testing/
- OWASP Top 10:2025 — A01 Broken Access Control — Нарушение контроля доступа — первая категория, включая IDOR. https://owasp.org/Top10/2025/A01_2025-Broken_Access_Control/
- ZAP Docker Baseline Scan — Параметры -t, -m (по умолчанию 1 минута), -r, каталог /zap/wrk; baseline — только пассивное сканирование. https://www.zaproxy.org/docs/docker/baseline-scan/
- ZAP Download — Текущая стабильная версия ZAP 2.17.0 и образы ghcr.io/zaproxy/zaproxy. https://www.zaproxy.org/download/
- nginx — ngx_http_headers_module — Синтаксис add_header, параметр always и правило наследования с уровня выше. https://nginx.org/en/docs/http/ngx_http_headers_module.html
- MDN — Content-Security-Policy-Report-Only — Режим наблюдения CSP и отправка отчётов о нарушениях. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Content-Security-Policy-Report-Only