
pg_upgrade в PostgreSQL 18 переносит статистику — почему ANALYZE всё равно обязателен
Обновили кластер до PostgreSQL 18, увидели в выводе pg_upgrade строчку про перенесённую статистику — и вычеркнули ANALYZE из регламента обновления. Через трое суток прилетает «сводка по отгрузкам грузится почти четыре минуты вместо четырёх секунд», а в плане запроса rows=118 против фактических 21 870. Разбираю, что именно pg_upgrade переносит, какие три категории статистики он не переносит никогда, почему после переезда сутками не просыпается autoanalyze, и какой ровно регламент я гоняю на боевых базах клиентов — в том числе там, где рядом с PostgreSQL живёт 1С.
Что на самом деле переехало: pg_statistic и relpages/reltuples
Начну с хорошего, потому что фича действительно крупная. В PostgreSQL 18 pg_upgrade по умолчанию тащит статистику оптимизатора из старого кластера в новый. Формулировка документации дословная: «Unless the --no-statistics option is specified, pg_upgrade will transfer most optimizer statistics from the old cluster to the new cluster». В релиз-нотах это записано как «Allow pg_upgrade to preserve optimizer statistics» с явной оговоркой «Extended statistics are not preserved». До 18-й версии новый кластер после pg_upgrade поднимался с пустым pg_statistic, и первые полчаса под нагрузкой база честно делала seq scan по многомиллионным таблицам, потому что планировщику было нечем оценивать селективность. Кто хоть раз открывал базу пользователям до окончания ANALYZE — помнит эти ощущения.
Что скрывается за словом «most». Переезжают поколоночные записи pg_statistic — гистограммы распределения, списки самых частых значений (MCV), n_distinct, correlation, доля NULL — и относящиеся к отношению relpages/reltuples/relallvisible в pg_class. Этого набора хватает, чтобы правильно оценить обычный одноколоночный предикат и размер таблицы, а таких предикатов в реальном коде подавляющее большинство. Отсюда и эффект: базовые планы после апгрейда выглядят ровно так же, как до него, и первое впечатление — «всё уже готово, ANALYZE не нужен». Впечатление ложное, но оно очень убедительное, и именно на нём люди и обжигаются.
И сразу ловушка, на которой я видел, как спотыкаются даже аккуратные админы: у pg_dump поведение противоположное. В 18-й версии он получил опции --statistics, --statistics-only и --no-statistics, и документация прямо говорит про последнюю: «Do not dump statistics. This is the default». То есть если вы переезжаете не через pg_upgrade, а через дамп-восстановление — меняете платформу, локаль, сжимаете базу, уходите к другому хостеру — то статистики в новом кластере не будет вообще, если вы явно не написали --statistics. Два разных пути миграции, два противоположных дефолта. Запомните это как отдельный факт.
- pg_upgrade 18: статистика переносится ПО УМОЛЧАНИЮ, отключается флагом --no-statistics.
- pg_dump/pg_dumpall/pg_restore 18: статистика НЕ выгружается по умолчанию, включается флагом --statistics.
- Переезжают per-column записи pg_statistic и relpages/reltuples из pg_class.
- Актуальный минорный релиз ветки 18 на сентябрь 2026 по странице Versioning Policy — 18.6; ветка поддерживается до 14 ноября 2030 года. Обновляться стоит сразу на последний минорный релиз.
Три дыры, которые остаются после pg_upgrade
Документация перечисляет исключения одной фразой, и её стоит прочитать медленно: «This does not transfer all statistics, such as those created explicitly with CREATE STATISTICS, custom statistics added by an extension, or statistics collected by the cumulative statistics system». Три категории. Каждая ломается по-своему, и ни одна не даёт красной лампочки — база просто работает медленнее или обслуживает себя хуже, чем должна.
Первая дыра — расширенная статистика, объекты CREATE STATISTICS. Их заводят ровно там, где колонки скоррелированы: город и регион, склад и статус заказа, тип документа и организация. Без них планировщик перемножает селективности как независимые и получает оценку на порядки ниже реальной, а дальше выбирает Nested Loop там, где нужен Hash Join. Самое неприятное в этой дыре — она невидима при поверхностной проверке: определения объектов переезжают вместе со схемой, \dX в psql их честно показывает, SELECT count(*) FROM pg_statistic_ext возвращает те же цифры, что и на старом кластере. Нет только данных — таблица pg_statistic_ext_data пуста, пока по этим отношениям не отработает ANALYZE. Определение без данных — это худший вариант, потому что любой чек-лист вида «расширенная статистика на месте?» отвечает «да».
Вторая дыра — статистика расширений. Всё, что расширение считает и хранит само: pg_stat_statements, pg_stat_kcache, pg_qualstats, pg_store_plans. После апгрейда это чистый лист. Практический ущерб тут не в планах, а в диагностике: базовую линию «топ-20 запросов по общему времени» вы теряете ровно в тот момент, когда она нужнее всего — чтобы сравнить «до» и «после». Поэтому я всегда снимаю снапшот pg_stat_statements в отдельную таблицу до начала окна.
Третья дыра — накопительная (cumulative) статистика, та самая, что живёт в pg_stat_all_tables. И она бьёт по автоматическому обслуживанию базы. Про неё — отдельный раздел, потому что механику здесь понимают реже всего.
- CREATE STATISTICS — определения переезжают, данные (pg_statistic_ext_data) нет.
- Статистика расширений (pg_stat_statements и его собратья) — обнуляется.
- Накопительная статистика pg_stat_all_tables / pg_stat_user_tables — обнуляется.
- Функции ручной правки статистики в 18-й есть: pg_restore_relation_stats(), pg_restore_attribute_stats(), pg_clear_relation_stats(), pg_clear_attribute_stats() — но это инструмент для точечной хирургии, а не для регламента.
Почему после переезда autoanalyze молчит неделями
Накопительная статистика — это счётчики: n_live_tup, n_dead_tup, n_mod_since_analyze, last_analyze, last_autoanalyze, seq_scan, idx_scan. Документация описывает их жизненный цикл честно: счётчики живут в разделяемой памяти, при штатной остановке сервера сбрасываются в подкаталог pg_stat, а при нештатном старте — из базового бэкапа, после PITR, после immediate shutdown — обнуляются целиком. Новый кластер после pg_upgrade — это ровно такой случай: каталог pg_stat у него свой, пустой. Все счётчики в нуле.
Теперь складываем это с формулами автовакуума. Порог автоанализа: analyze threshold = autovacuum_analyze_threshold + autovacuum_analyze_scale_factor * reltuples, дефолты — 50 кортежей и 0.1. Порог автовакуума в 18-й версии получил ограничитель сверху: vacuum threshold = Minimum(autovacuum_vacuum_max_threshold, autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor * reltuples), дефолты — 100 000 000, 50 и 0.2. Число кортежей в обеих формулах берётся из pg_class.reltuples, а количество изменённых и мёртвых строк — из накопительной статистики.
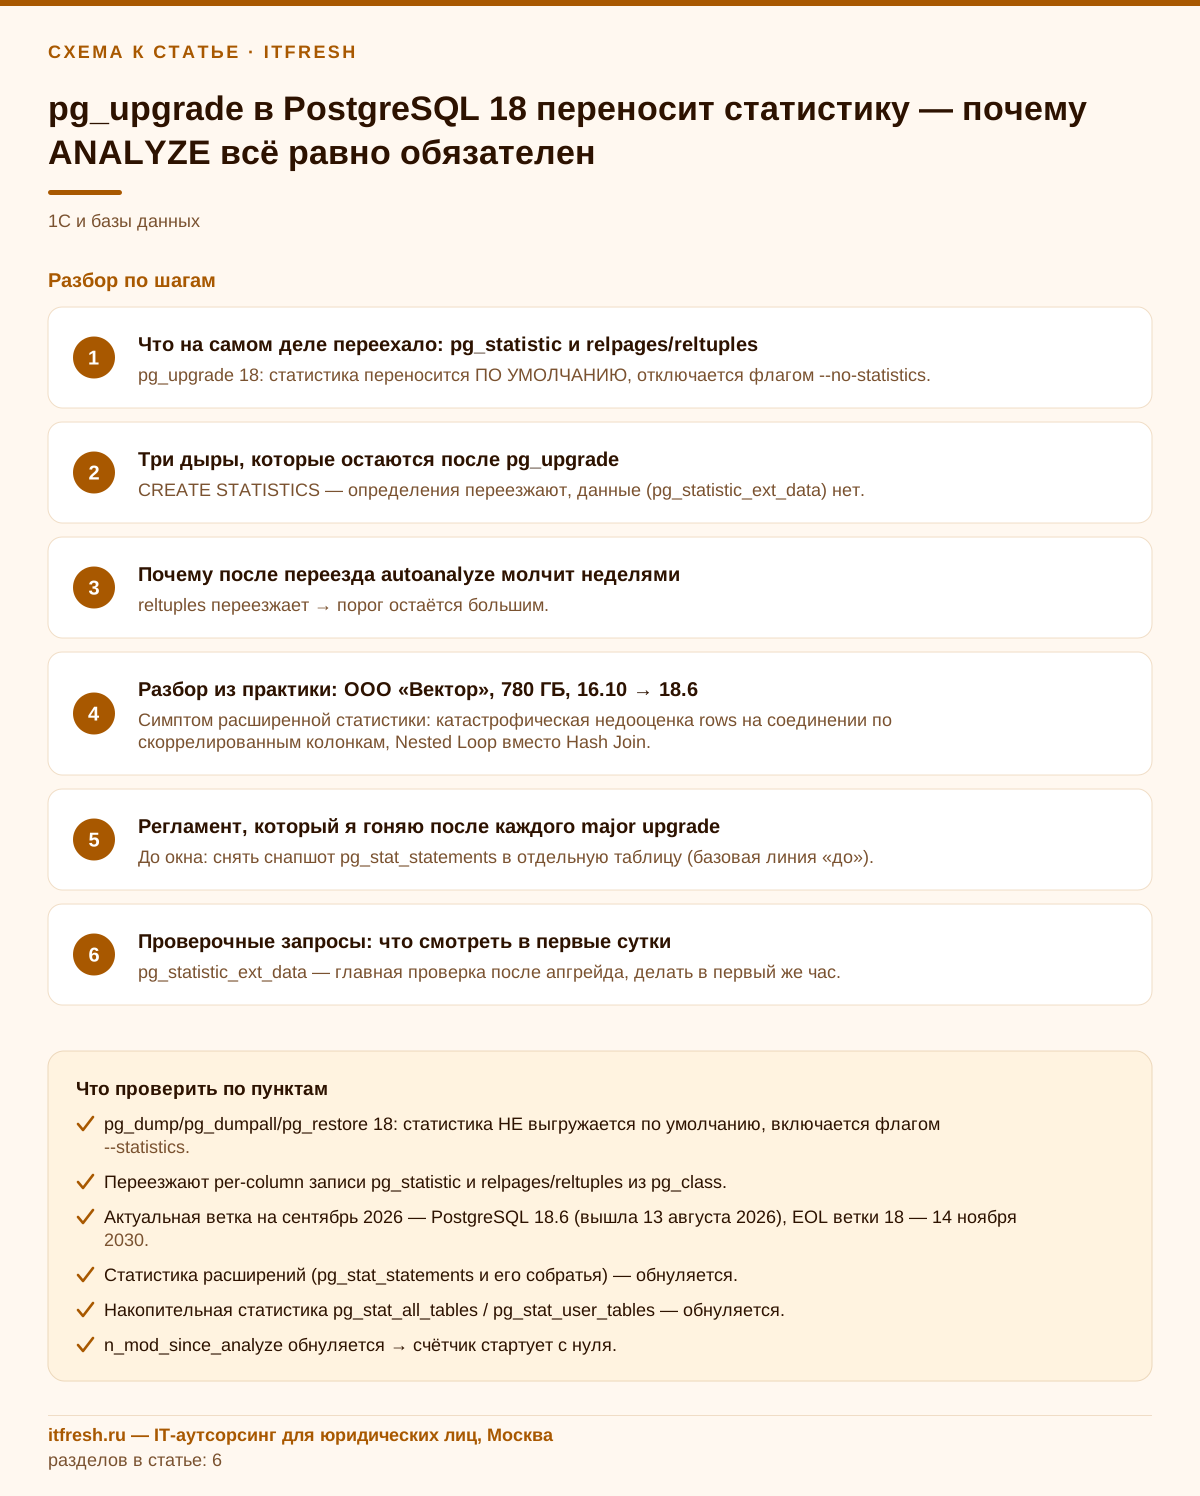
Вот и вся ловушка, в одном предложении: reltuples pg_upgrade перенёс, а n_mod_since_analyze обнулил. Для таблицы на 28 млн строк порог автоанализа получается 2 800 050 изменений, и отсчёт начинается с нуля — с момента апгрейда. Пока в таблицу не прилетит почти три миллиона правок, autoanalyze к ней не подойдёт. На быстро растущем журнале документов это неделя, на справочнике номенклатуры или регистре остатков со средней активностью — месяцы. Всё это время планировщик работает по статистике, снятой в прошлой жизни кластера, и чем дальше, тем сильнее она расходится с реальностью.
Побочный эффект того же обнуления — мониторинг. Шаблоны Zabbix и подобных систем обычно ловят «таблица не анализировалась дольше N дней» по last_analyze/last_autoanalyze. После апгрейда там NULL по всем таблицам. Хороший шаблон завалит вас алертами, плохой посчитает NULL за «нормально» и промолчит именно тогда, когда молчать нельзя. Проверьте свою логику заранее — это две минуты работы.
- reltuples переезжает → порог остаётся большим.
- n_mod_since_analyze обнуляется → счётчик стартует с нуля.
- Итог: чем больше таблица, тем дольше autoanalyze до неё не доберётся.
- n_dead_tup тоже в нуле → автовакуум откладывается, растёт раздувание и с ним время сканов.
Разбор из практики: «Тара Мастер», 16.15 → 18.6
Картонажное производство «Тара Мастер», 31 рабочее место: учёт ведут в 1С на PostgreSQL, а рядом в том же кластере крутится база самописной системы учёта производства — заказы на гофроупаковку, раскрой листа, отгрузки. Кластер около 210 ГБ: база 1С примерно 140 ГБ, производственная — 60 ГБ, 180 таблиц в основной схеме, две крупные партиционированные — отгрузки и журнал производственных документов. Виртуальная машина на 8 vCPU, 32 ГБ RAM, NVMe. Обновляли с 16.15 на 18.6, окно два часа ночью в субботу; предварительно прогнали апгрейд на копии и убедились, что используемая сборка PostgreSQL и версия платформы 1С официально дружат с 18-й веткой. Сам pg_upgrade с --link отработал за 1 минуту 40 секунд.
Дальше — то, чего я делать не должен был. На 16-й версии мы под этот апгрейд всегда закладывали окно на ANALYZE минут на двадцать. В этот раз статистика переехала, мы прогнали три контрольных отчёта, планы совпали с эталонными, и я отдал базу пользователям, отложив полный analyze «на понедельник, вне окна». Логика вроде здравая: зачем гонять тяжёлую операцию ночью, если проверка показывает, что всё в порядке.
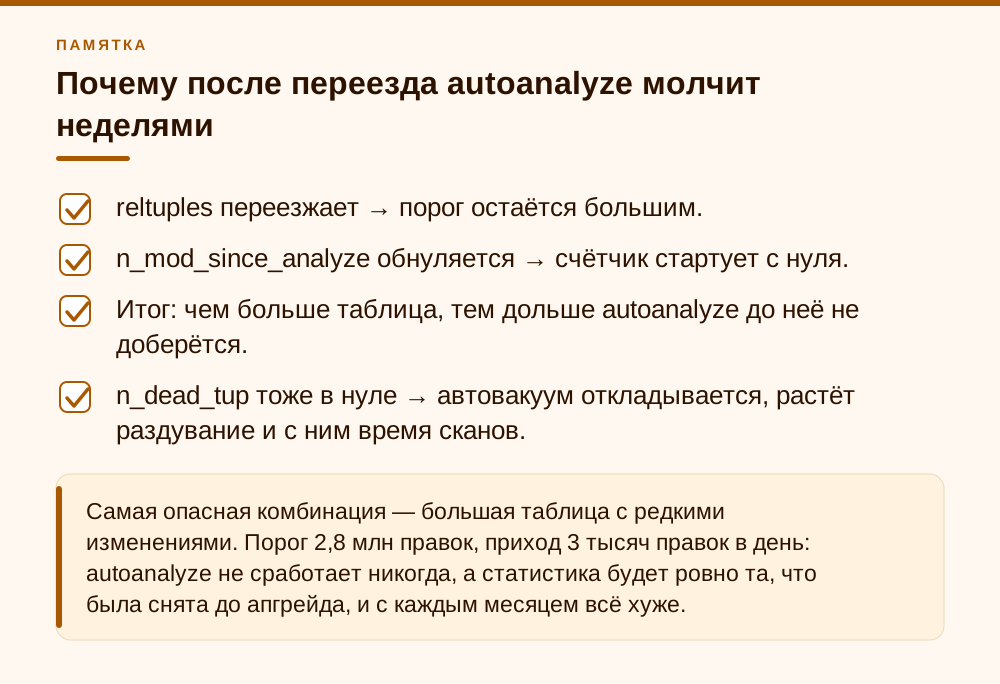
На третьи сутки — обращение: сводка по отгрузкам за месяц вместо четырёх секунд считается три минуты сорок секунд. EXPLAIN (ANALYZE, BUFFERS) показал, что на соединении партиционированной таблицы отгрузок со справочником планировщик оценивает 118 строк при фактических 21 870 и выбирает Nested Loop вместо Hash Join. Полез в каталог: у этой таблицы два объекта CREATE STATISTICS на паре колонок «склад + статус документа» — типы ndistinct и mcv. Определения на месте, \dX их показывает. pg_statistic_ext_data по ним пуст. Обычный ANALYZE по одной этой таблице отработал 38 секунд, план вернулся к Hash Join, отчёт стал считаться 4,1 секунды.
Заодно посмотрел, что происходит с автообслуживанием. За девять суток после апгрейда у 11 таблиц из 180 last_autoanalyze так и остался NULL, при том что журнал производственных документов за это время набрал 410 тысяч новых строк. Причина ровно та, что описана выше: reltuples перенеслись (6,5 млн), порог 650 050, накопитель с нуля. То есть база несколько дней работала на статистике «из прошлой жизни» не потому, что что-то сломалось, а потому что так и задумано — просто регламент был неполный. Дальше сделали правильно: vacuumdb --all --analyze-in-stages --missing-stats-only --jobs 2 прошёл за 2 минуты, потому что трогает только дыры; следом vacuumdb --all --analyze-only --jobs 2 — 17 минут, из которых 11 съели две партиционированные таблицы. В postgresql.conf от прежнего админа остался ненулевой vacuum_cost_delay (10 мс), поэтому с PGOPTIONS='-c vacuum_cost_delay=0' второй прогон уложился в 10 минут. Обе команды гоняли на живой базе в рабочее время — пользователи ничего не заметили.
Отдельно про базу 1С в том же кластере. Платформа 1С объектов CREATE STATISTICS сама не создаёт, поэтому первая дыра её почти не касается, а вот вторая — в полный рост: у крупных таблиц регистров накопления и сведений тоже висел NULL в last_autoanalyze. Пользователи 1С жаловались мягче — «проведение документов стало задумчивым», «оборотно-сальдовая открывается дольше обычного», — но это те же неточные оценки строк на соединениях с таблицами, которые активно пишутся после апгрейда. После второго прогона vacuumdb жалобы ушли. Штатные средства 1С — «Тестирование и исправление», регламентные задания конфигурации — ANALYZE по базе СУБД не запускают, это задача администратора PostgreSQL.
- Симптом расширенной статистики: катастрофическая недооценка rows на соединении по скоррелированным колонкам, Nested Loop вместо Hash Join.
- Симптом накопительной: last_autoanalyze IS NULL у крупных таблиц спустя неделю после апгрейда.
- Диагностика: EXPLAIN (ANALYZE, BUFFERS) на «поехавшем» отчёте плюс запрос к pg_statistic_ext_data.
- Лечение: два прогона vacuumdb в правильном порядке, без окна простоя.
- Для базы 1С: объектов CREATE STATISTICS нет, но «спящий» autoanalyze бьёт по проведению и отчётам по регистрам точно так же.
Регламент, который я гоняю после каждого major upgrade
Документация pg_upgrade даёт готовую последовательность, и я не вижу причин её улучшать — она правильная. Дословно: сначала vacuumdb --all --analyze-in-stages --missing-stats-only, чтобы быстро сгенерировать минимальную статистику для отношений, у которых её нет вообще; затем vacuumdb --all --analyze-only, чтобы у всех отношений была актуальная накопительная статистика для запуска vacuum и analyze. Плюс совет ускоряться через --jobs и через PGOPTIONS, если vacuum_cost_delay ненулевой. Уточню: по умолчанию vacuum_cost_delay для ручных VACUUM и ANALYZE равен нулю, так что PGOPTIONS даёт выигрыш только там, где задержку кто-то уже выставил в конфиге; autovacuum_vacuum_cost_delay (2 мс) на vacuumdb не влияет.
# 1. Закрыть дыры: отношения БЕЗ статистики (в т.ч. объекты CREATE STATISTICS)
PGOPTIONS='-c vacuum_cost_delay=0' \
  vacuumdb --all --analyze-in-stages --missing-stats-only --jobs 4

# 2. Обновить накопительную статистику по ВСЕМ отношениям
PGOPTIONS='-c vacuum_cost_delay=0' \
  vacuumdb --all --analyze-only --jobs 4
Почему именно такой порядок и почему нельзя ограничиться первым шагом. --missing-stats-only описан в документации как «Only analyze relations that are missing statistics for a column, index expression, or extended statistics object» — то есть он трогает только объекты без статистики, и это дёшево. В связке с --analyze-in-stages он ещё и решает старую проблему: обычный analyze-in-stages на первом этапе временно ставит всем минимальный statistics target, из-за чего планы на несколько минут становятся хуже; с --missing-stats-only существующая статистика не затирается. Но накопительные счётчики он не двигает у тех таблиц, где статистика уже есть — а после pg_upgrade это большинство таблиц. Поэтому второй шаг обязателен: именно он проставляет last_analyze и обнуляет n_mod_since_analyze корректно, возвращая автовакуум в рабочий режим.
Две технические детали, о которые спотыкаются. Первая: --missing-stats-only требует прав SELECT на pg_statistic и pg_statistic_ext_data, а они по умолчанию только у суперпользователя — запускайте от postgres, а не от прикладной роли. В управляемых облачных PostgreSQL, где суперюзера вам не дают, эта опция просто не сработает. Тогда запускайте vacuumdb --all --analyze-only без неё, но не голый --analyze-in-stages: документация vacuumdb прямо предупреждает, что на базе с уже существующей статистикой ранние этапы с минимальным statistics target временно ухудшают выбор планов — то есть вы сами сломаете то, что pg_upgrade аккуратно перенёс. Вторая: --jobs открывает столько же соединений, сколько заданий; я беру примерно четверть vCPU и проверяю запас по max_connections. Гнать в 16 потоков по NVMe можно, но вы съедите весь I/O у пользователей — а смысла спешить нет, ANALYZE берёт только ShareUpdateExclusiveLock и чтение-запись не блокирует.
Для кластеров, где живут базы 1С, добавляю к регламенту два пункта. Первый — до апгрейда сверить, что выбранная сборка PostgreSQL 18 поддерживается вашей версией платформы 1С: у 1С свой перечень поддерживаемых СУБД, и ванильная сборка или сборка «не той» минорной версии — это отдельный риск, не связанный со статистикой. Второй — не открывать базу на массовое проведение и закрытие месяца, пока не прошёл второй шаг vacuumdb: именно тяжёлые запросы по регистрам первыми страдают от устаревших оценок строк.
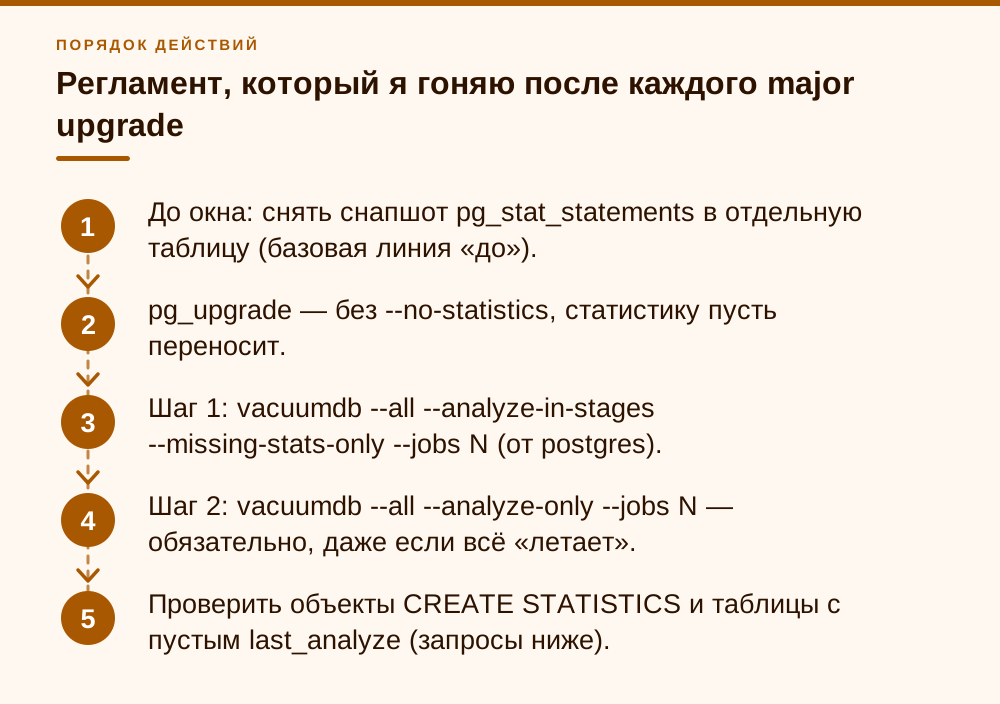
- До окна: снять снапшот pg_stat_statements в отдельную таблицу (базовая линия «до»).
- pg_upgrade — без --no-statistics, статистику пусть переносит.
- Шаг 1: vacuumdb --all --analyze-in-stages --missing-stats-only --jobs N (от postgres).
- Шаг 2: vacuumdb --all --analyze-only --jobs N — обязательно, даже если всё «летает».
- Проверить объекты CREATE STATISTICS и таблицы с пустым last_analyze (запросы ниже).
- Первые сутки: auto_explain или сравнение pg_stat_statements «до/после», разбирать выбросы по mean_exec_time.
Проверочные запросы: что смотреть в первые сутки
Первое, что я проверяю, — объекты расширенной статистики без данных. Запрос ниже показывает определения, по которым ANALYZE ещё не отрабатывал. Чтения pg_statistic_ext_data по умолчанию тоже требуют суперюзера, так что выполняйте от postgres.
-- объекты CREATE STATISTICS, по которым нет данных
SELECT s.stxnamespace::regnamespace AS nsp,
       s.stxname,
       s.stxrelid::regclass AS tbl
FROM pg_statistic_ext s
LEFT JOIN pg_statistic_ext_data d ON d.stxoid = s.oid
WHERE d.stxoid IS NULL
   OR (d.stxdndistinct IS NULL
       AND d.stxddependencies IS NULL
       AND d.stxdmcv IS NULL);
Второе — таблицы, которых ANALYZE в новом кластере ещё не касался. Здесь важно смотреть именно на пару last_analyze / last_autoanalyze: NULL в обеих колонках означает, что в этом кластере таблица не анализировалась ни разу, а значит её накопительные счётчики бесполезны для автовакуума. Сортируйте по n_live_tup — крупные таблицы важнее.
-- таблицы без единого ANALYZE в новом кластере
SELECT schemaname, relname, n_live_tup, n_mod_since_analyze,
       last_analyze, last_autoanalyze
FROM pg_stat_all_tables
WHERE schemaname NOT IN ('pg_catalog', 'information_schema')
  AND last_analyze IS NULL
  AND last_autoanalyze IS NULL
ORDER BY n_live_tup DESC
LIMIT 50;
Третье — точечная проверка колонок без строки в pg_statistic. Оговорюсь честно: запрос ниже даёт ложные срабатывания. Пустая таблица, только что созданная партиция, колонка, по которой статистика физически не нужна, — всё это тоже попадёт в выдачу. Я использую его не как чек-лист «должно быть ноль строк», а как способ быстро увидеть, не выпал ли целый кусок схемы (например, отдельный tablespace или схема, которую в спешке восстанавливали отдельно).
-- колонки без записи в pg_statistic
SELECT c.relname, a.attname
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
JOIN pg_attribute a ON a.attrelid = c.oid
     AND a.attnum > 0 AND NOT a.attisdropped
LEFT JOIN pg_statistic s ON s.starelid = c.oid
     AND s.staattnum = a.attnum
WHERE c.relkind IN ('r', 'm', 'p')
  AND n.nspname NOT IN ('pg_catalog', 'information_schema')
  AND s.starelid IS NULL
ORDER BY c.relname, a.attnum;- pg_statistic_ext_data — главная проверка после апгрейда, делать в первый же час.
- last_analyze/last_autoanalyze IS NULL — индикатор «спящего» автовакуума.
- pg_stat_statements: сравнить top-20 по total_exec_time до и после, разбирать только выбросы.
- Проверить шаблон мониторинга: не трактует ли он NULL в last_autoanalyze как «всё хорошо».
Когда выключать перенос, и где риск преувеличен
Флаг --no-statistics в pg_upgrade есть, и вопрос «а не безопаснее ли всегда переносить статистику заново» задают регулярно. Отвечу прямо: на боевых базах клиентов я его ни разу не применял. Осмысленных сценариев вижу два. Первый — вы точно знаете, что статистика на старом кластере была протухшей или заведомо неверной (базу долго тащили из бэкапов, автовакуум был выключен, регламента не было вообще), и вам проще начать с чистого листа, чем разбираться, что там переехало. Второй — если вы напоролись на конкретный баг переноса в конкретной минорной версии и вам нужен обход прямо сейчас. Во всех остальных случаях перенос — чистый выигрыш: он убирает окно, когда база уже открыта, а планировщик ещё слепой.
Где риск преувеличен. Меня несколько раз спрашивали, не «сломается» ли перенесённая из 16-й или 17-й версии статистика в 18-м планировщике. Нет. Переносится содержимое системных каталогов, привязанное к колонкам и отношениям, а не к версии планировщика; 18-й читает его штатно, это и есть заявленная функциональность. Второй преувеличенный страх — что ANALYZE после апгрейда требует окна простоя. Не требует: ANALYZE берёт ShareUpdateExclusiveLock, читателям и писателям не мешает, конфликтует только с VACUUM, другим ANALYZE и DDL по той же таблице. Единственная реальная плата — дисковый ввод-вывод, и именно её регулируют через --jobs и vacuum_cost_delay.
Где единого мнения действительно нет — это когда гонять второй, тяжёлый шаг. Одни делают его прямо в окне обновления, до открытия базы пользователям, и увеличивают окно на десятки минут. Другие открывают базу сразу и запускают analyze в ближайшее непиковое время. Я держусь простого водораздела: до примерно 500 ГБ — в окне, там это всё равно минуты; больше — сразу после открытия, с ограниченным --jobs, и обязательно в тот же день, а не «в понедельник». Кейс «Тара Мастер» из четвёртого раздела — ровно про цену слова «потом». Универсального ответа тут нет, он зависит от запаса по I/O и от того, насколько ваши пользователи терпимы к десятиминутной просадке.
И про приоритеты, раз уж я про них обещал. На что можно спокойно забить: на ручное восстановление статистики через pg_restore_relation_stats() — это инструмент для очень узких случаев, в регламенте обновления ему делать нечего. На немедленную перегенерацию pg_stat_statements — она наберётся сама, важно лишь снять снапшот «до». На чем экономить нельзя: на втором прогоне vacuumdb и на проверке pg_statistic_ext_data. Эти две вещи занимают вместе меньше часа даже на солидной базе и закрывают все три дыры, которые pg_upgrade оставляет по своему дизайну — а не по недосмотру.
- --no-statistics: применять осознанно, а не «на всякий случай».
- ANALYZE не требует простоя, требует запаса по I/O.
- База до ~500 ГБ — полный analyze в окне; больше — сразу после открытия, в тот же день.
- Забить можно на ручные pg_restore_*_stats() и на баланс pg_stat_statements; забить нельзя на vacuumdb --analyze-only.
Частые вопросы
Если pg_upgrade перенёс статистику, можно ли вообще не запускать ANALYZE?
Нельзя. Не переносятся три вещи: объекты CREATE STATISTICS (переезжают только их определения, без данных), статистика расширений и накопительная статистика pg_stat_all_tables. Последняя нужна автовакууму, чтобы понимать, когда таблицу пора обслуживать. Минимум — прогнать vacuumdb --all --analyze-only после обновления.
Чем отличаются vacuumdb --analyze-in-stages --missing-stats-only и vacuumdb --analyze-only?
Первая команда быстро закрывает только те отношения, у которых статистики нет вообще, и при этом не затирает существующую статистику пониженными таргетами. Вторая проходит по всем отношениям и обновляет в том числе накопительные счётчики, от которых зависит запуск autovacuum и autoanalyze. Документация рекомендует выполнять их именно в этом порядке.
Почему после апгрейда autoanalyze неделями не трогает большую таблицу?
Порог считается как autovacuum_analyze_threshold + autovacuum_analyze_scale_factor * reltuples (по умолчанию 50 + 0.1 * reltuples). Значение reltuples pg_upgrade переносит, а счётчик n_mod_since_analyze обнуляется. Для таблицы на 28 млн строк порог — около 2,8 млн изменений, и отсчёт начинается с нуля с момента обновления.
Нужно ли окно простоя для ANALYZE после обновления?
Нет. ANALYZE берёт ShareUpdateExclusiveLock: чтение и запись не блокируются, конфликт только с VACUUM, другим ANALYZE и DDL по той же таблице. Реальная плата — дисковый ввод-вывод, поэтому ограничивайте --jobs (я беру примерно четверть vCPU) а PGOPTIONS='-c vacuum_cost_delay=0' помогает только если в конфиге выставлен ненулевой vacuum_cost_delay — по умолчанию он и так 0.
Что делать, если у меня управляемый облачный PostgreSQL и нет прав суперпользователя?
Опция --missing-stats-only требует SELECT на pg_statistic и pg_statistic_ext_data, которые по умолчанию доступны только суперпользователю, — в облаке она у вас, скорее всего, не заработает. Тогда достаточно vacuumdb --all --analyze-only от роли-владельца баз, либо точечные ANALYZE по крупным таблицам и по таблицам с объектами CREATE STATISTICS.
А если я мигрирую не через pg_upgrade, а через pg_dump/pg_restore?
Тогда статистики не будет вообще: в PostgreSQL 18 у pg_dump по умолчанию действует --no-statistics, выгрузка включается явным флагом --statistics. И даже с ним расширенная статистика, статистика расширений и накопительные счётчики в дамп не попадут — ANALYZE после восстановления обязателен.
Касается ли всё это баз 1С на PostgreSQL?
Да, но не в равной степени. Объектов CREATE STATISTICS платформа 1С не создаёт, поэтому пустой pg_statistic_ext_data в базе 1С обычно не проблема. Зато обнуление накопительной статистики бьёт по крупным таблицам регистров: autoanalyze до них долго не доходит, и проведение документов и отчёты по регистрам замедляются. Лечится тем же регламентом — vacuumdb --all --analyze-in-stages --missing-stats-only, затем vacuumdb --all --analyze-only. Отдельно до апгрейда проверьте, что сборка PostgreSQL 18 поддерживается вашей версией платформы 1С.
Источники
- PostgreSQL 18 — pg_upgrade, раздел Statistics и опция --no-statistics — PostgreSQL 18 Documentation, pg_upgrade, разделы Options и Statistics: «Unless the --no-statistics option is specified, pg_upgrade will transfer most optimizer statistics…», рекомендованная последовательность vacuumdb --all --analyze-in-stages --missing-stats-only → vacuumdb --all --analyze-only. https://www.postgresql.org/docs/18/pgupgrade.html
- PostgreSQL 18 — vacuumdb, опции --analyze-in-stages, --missing-stats-only, --analyze-only, --jobs — PostgreSQL 18 Documentation, Server Applications → vacuumdb: описание --missing-stats-only («Only analyze relations that are missing statistics for a column, index expression, or extended statistics object»), требование прав SELECT на pg_statistic и pg_statistic_ext_data. https://www.postgresql.org/docs/18/app-vacuumdb.html
- PostgreSQL 18 — pg_dump, опции --statistics / --statistics-only / --no-statistics — PostgreSQL 18 Documentation, pg_dump: «--no-statistics — Do not dump statistics. This is the default», а также примечание о том, что CREATE STATISTICS, статистика расширений и накопительная статистика в дамп не попадают. https://www.postgresql.org/docs/18/app-pgdump.html
- PostgreSQL 18 Release Notes — Release Notes 18.0: «Allow pg_upgrade to preserve optimizer statistics… Extended statistics are not preserved. Also add pg_upgrade option --no-statistics», «Add vacuumdb option --missing-stats-only to compute only missing optimizer statistics», новые опции pg_dump --statistics / --statistics-only / --no-statistics, функции pg_restore_relation_stats() и др. https://www.postgresql.org/docs/release/18.0/
- PostgreSQL 18 — Routine Vacuuming, формулы порогов автовакуума — PostgreSQL 18 Documentation, гл. 24.1.6 The Autovacuum Daemon: analyze threshold = autovacuum_analyze_threshold + autovacuum_analyze_scale_factor * reltuples; vacuum threshold = Minimum(autovacuum_vacuum_max_threshold, autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor * reltuples). https://www.postgresql.org/docs/18/routine-vacuuming.html
- PostgreSQL 18 — Monitoring Database Activity, поведение накопительной статистики — PostgreSQL 18 Documentation, гл. 27.2 The Cumulative Statistics System: копия статистики сохраняется в подкаталог pg_stat при штатной остановке, при нештатном старте «all statistics counters are reset». https://www.postgresql.org/docs/18/monitoring-stats.html
- PostgreSQL Versioning Policy — Таблица поддерживаемых версий: текущий минорный релиз ветки 18 — 18.6, первый релиз 25.09.2025, окончание поддержки — 14.11.2030. https://www.postgresql.org/support/versioning/
- PostgreSQL 18 — Vacuuming, параметры vacuum_cost_delay и autovacuum_* — PostgreSQL 18 Documentation, 19.10 Vacuuming: vacuum_cost_delay по умолчанию 0 (задержка отключена для ручных VACUUM/ANALYZE), autovacuum_vacuum_cost_delay 2 мс, autovacuum_vacuum_max_threshold 100000000, autovacuum_analyze_threshold 50, autovacuum_analyze_scale_factor 0.1. https://www.postgresql.org/docs/18/runtime-config-vacuum.html