
Копия таблицы через LIKE INCLUDING ALL съедает ID оригинала: почему sequence остаётся общей и как это лечить
Ситуация знакомая до зубовного скрежета: разработчик делает копию боевой таблицы одной строкой — CREATE TABLE orders_test (LIKE orders INCLUDING ALL) — гоняет по ней нагрузочный тест, а наутро в боевых заказах дыра в нумерации на несколько миллионов. Копия выглядит независимой: свой файл на диске, свои индексы, свои ограничения. Но serial-столбец у неё продолжает дёргать nextval() исходной последовательности. Ниже — почему так устроено, как за две минуты это воспроизвести и проверить у себя, четыре рабочих способа скопировать структуру без общего генератора ID и отдельно про вторую мину: `DROP ... CASCADE` на таблице-владельце уносит sequence и молча снимает DEFAULT у всех остальных таблиц, которые ею пользовались, — после чего вставки падают на NOT NULL.
serial — это не тип, а три объекта в одном флаконе
Начну с корня проблемы, потому что без него всё остальное выглядит как баг PostgreSQL. Это не баг. serial и bigserial — не типы данных, а синтаксический сахар. Когда вы пишете id serial PRIMARY KEY, сервер разворачивает это в три независимых действия: создаёт отдельный объект-последовательность, объявляет столбец типа integer с ограничением NOT NULL и вешает на него значение по умолчанию — вызов функции, и отдельно привязывает последовательность к столбцу через OWNED BY.
Разворачивается это примерно так:
-- то, что вы написали
CREATE TABLE orders (id bigserial PRIMARY KEY, amount numeric(12,2) NOT NULL);

-- то, что реально выполнил сервер
CREATE SEQUENCE orders_id_seq AS bigint;
CREATE TABLE orders (
    id     bigint NOT NULL DEFAULT nextval('orders_id_seq'::regclass),
    amount numeric(12,2) NOT NULL,
    PRIMARY KEY (id)
);
ALTER SEQUENCE orders_id_seq OWNED BY orders.id;
Ключевое слово здесь — DEFAULT. Дефолт столбца id — это обычное выражение, текстовая строка nextval('orders_id_seq'::regclass), жёстко прибитая к имени конкретной последовательности. Никакой магии, никакой «привязки к таблице» в этом выражении нет. Теперь смотрим, что делает LIKE. По документации PostgreSQL 18 LIKE сам по себе копирует «все имена столбцов, их типы данных и ограничения not-null». Опция INCLUDING DEFAULTS добавляет к этому копирование выражений по умолчанию — и копирует их буквально, символ в символ. То есть в новой таблице появляется столбец с дефолтом nextval('orders_id_seq'::regclass), указывающий на ту же самую последовательность оригинала.
Разработчики PostgreSQL про эту ловушку знают и честно предупреждают прямо в мануале, в описании INCLUDING DEFAULTS: «Note that copying defaults that call database-modification functions, such as nextval, may create a functional linkage between the original and new tables». Перевожу без дипломатии: копируя дефолты, которые вызывают функции, изменяющие базу, вы связываете новую таблицу со старой. А INCLUDING ALL — это, цитирую, «сокращённая форма, выбирающая все доступные отдельные опции», то есть DEFAULTS туда входит по определению. Вы своими руками попросили скопировать дефолт — сервер его и скопировал.
- LIKE без опций: имена столбцов, типы, NOT NULL. Всё. Никаких индексов, дефолтов, комментариев.
- INCLUDING DEFAULTS: выражения DEFAULT переносятся текстом, включая nextval() с именем чужой последовательности.
- INCLUDING IDENTITY: для каждого identity-столбца создаётся ОТДЕЛЬНАЯ новая последовательность — это прямо написано в мануале.
- INCLUDING INDEXES: индексы, PRIMARY KEY, UNIQUE и EXCLUDE переезжают, но имена им назначаются по дефолтным правилам, а не как в оригинале.
- INCLUDING ALL = все категории сразу, включая DEFAULTS. Именно поэтому «самый полный» вариант оказывается самым опасным для serial.
Воспроизводим за две минуты на пустой базе
Не верьте мне на слово, проверьте руками — на это уйдёт меньше времени, чем на чтение этого раздела. Поднимаем чистую базу на PostgreSQL 18 (у меня на стенде актуальный минорный выпуск 18.6, но поведение одинаковое как минимум с PostgreSQL 10, где появились identity-столбцы и опция INCLUDING IDENTITY) и выполняем:
CREATE TABLE orders (
    id     bigserial PRIMARY KEY,
    amount numeric(12,2) NOT NULL,
    ts     timestamptz NOT NULL DEFAULT now()
);

INSERT INTO orders(amount) SELECT 100 FROM generate_series(1, 10);
SELECT last_value FROM orders_id_seq;   -- 10

CREATE TABLE orders_test (LIKE orders INCLUDING ALL);

-- а теперь смотрим, что получилось
\d orders_test
И вот тут вылезает то, ради чего всё затевалось. В описании orders_test вы увидите столбец id с дефолтом nextval('orders_id_seq'::regclass) — с именем последовательности ОРИГИНАЛА, без всяких orders_test_id_seq. Отдельной последовательности для копии не создано вообще: команда \ds покажет ровно один объект последовательности в схеме. Дальше — контрольный выстрел:
INSERT INTO orders_test(amount) SELECT 1 FROM generate_series(1, 100000);

SELECT last_value FROM orders_id_seq;   -- 100010

INSERT INTO orders(amount) VALUES (500) RETURNING id;   -- 100011
Боевая таблица только что перепрыгнула через сто тысяч идентификаторов. Ничего не сломалось, никакой ошибки — просто в нумерации заказов образовалась дыра. Если у вас на этих ID завязана внешняя сверка, человекочитаемые номера документов или, не дай бог, integer вместо bigint с запасом до переполнения на 2,1 миллиарда — вот вам источник ночного инцидента.
Второй маркер, по которому проблему видно моментально, — функция pg_get_serial_sequence(). Для оригинала она вернёт имя последовательности, для копии — NULL:
SELECT pg_get_serial_sequence('orders', 'id');        -- public.orders_id_seq
SELECT pg_get_serial_sequence('orders_test', 'id');   -- NULL
NULL здесь означает не «последовательности нет», а «нет отношения владения». В мануале про эту функцию сказано прямо: она возвращает имя последовательности, ассоциированной со столбцом, и по-хорошему её стоило назвать pg_get_owned_sequence. Копия последовательность использует, но не владеет ею. Запомните этот факт — во втором акте пьесы он выстрелит.
- После `LIKE ... INCLUDING ALL` в `\d копии` у serial-столбца стоит `nextval()` с именем последовательности оригинала — своей sequence у копии нет.
- `\ds` показывает столько же последовательностей, сколько было до создания копии: новый объект не появился.
- `last_value` последовательности оригинала растёт при вставках в копию — это и есть «съеденные» ID боевой таблицы.
- `pg_get_serial_sequence('копия', 'id')` возвращает NULL: копия пользуется последовательностью, но не владеет ею.
- Для сравнения: если оригинал объявлен как `GENERATED BY DEFAULT AS IDENTITY`, та же команда создаёт копии отдельную последовательность, и `last_value` оригинала не меняется.
Разбор из практики: «ЧертёжБюро», 900 тысяч потерянных номеров и вставки, упавшие на NOT NULL
Заказчик — архитектурное проектное бюро «ЧертёжБюро», 30 рабочих мест: архитекторы, конструкторы, ГИПы и небольшой отдел выпуска. Вместе с ними работает самописный реестр выпущенной документации на Python поверх PostgreSQL 18: база около 35 ГБ на отдельной виртуальной машине (4 vCPU, 16 ГБ RAM, SSD), таблица doc_register — примерно 1,9 миллиона строк за двенадцать лет (каждая выдача листа, ревизия и передача заказчику), id bigserial. Регистрационный номер из этого поля печатается в сопроводительной ведомости и уходит заказчику вместе с комплектом, так что на него смотрят живые люди — и в бюро, и у девелопера.
Разработчик-подрядчик готовил новую логику автоматической выдачи комплектов. Сделал ровно то, что делают все и что советует половина интернета: CREATE TABLE doc_register_stage (LIKE doc_register INCLUDING ALL);, залил туда 300 тысяч синтетических записей, прогнал нагрузочный тест, посмотрел планы, удалил таблицу, повторил. Три ночи подряд. К утру четверга номера в реестре прыгнули с 1 214 407 сразу на 2 114 000 с копейками. ГИП пришёл с вопросом «а куда делись выдачи под этими номерами, вы их удалили?». Выдач не было никогда — были съеденные тестами значения последовательности.
Само по себе это ещё терпимо: bigint не переполнится, дыра в нумерации некрасива, но не смертельна. Мы объяснили, что номер — это суррогатный ключ, а не порядковый счётчик, и что дыры в нём законны. Убило другое. Через неделю тот же разработчик решил прибраться и снёс архивную таблицу, сделанную год назад тем же способом: DROP TABLE doc_register_2025 CASCADE;. Команда отработала без ошибок, в выводе мелькнул NOTICE drop cascades to default value for column id of table doc_register, который никто не прочитал. Следующая же регистрация листа упала с ERROR: null value in column "id" of relation "doc_register" violates not-null constraint (SQLSTATE 23502). Выпуск документации встал на 11 минут, пока мы не поняли, что произошло.
А произошло вот что. Последовательность doc_register_id_seq изначально была OWNED BY doc_register.id — так её создал bigserial. Но архивная doc_register_2025 тоже делалась через LIKE INCLUDING ALL, и в какой-то момент кто-то «навёл порядок» и перепривязал владение: ALTER SEQUENCE doc_register_id_seq OWNED BY doc_register_2025.id. Формально всё работало. А DROP честно отработал документированное поведение CREATE SEQUENCE: «if that column (or its whole table) is dropped, the sequence will be automatically dropped as well». Удалили архив — вместе с ним удалилась последовательность. Дефолт nextval('doc_register_id_seq'::regclass) боевой таблицы зависит от этой последовательности, поэтому без CASCADE PostgreSQL отказался бы выполнять DROP и перечислил бы зависимость в DETAIL. С CASCADE он молча снял DEFAULT у doc_register.id: столбец остался NOT NULL, но без значения по умолчанию.
Чинили так: создали последовательность заново с правильным стартом, вернули дефолт и владение — всё одной транзакцией:
BEGIN;
CREATE SEQUENCE doc_register_id_seq AS bigint;
SELECT setval('doc_register_id_seq', (SELECT max(id) FROM doc_register));
ALTER TABLE doc_register ALTER COLUMN id SET DEFAULT nextval('doc_register_id_seq');
ALTER SEQUENCE doc_register_id_seq OWNED BY doc_register.id;
COMMIT;
Дальше — плановая работа в окно 40 минут: перевели doc_register и ещё четыре таблицы с serial на identity, а все staging-копии пересоздали через EXCLUDING DEFAULTS с собственными последовательностями. Прошло полгода — повторов нет. Стоило это одного вечера работы; простой выпуска документации накануне сдачи стадии П обошёлся бы бюро заметно дороже.
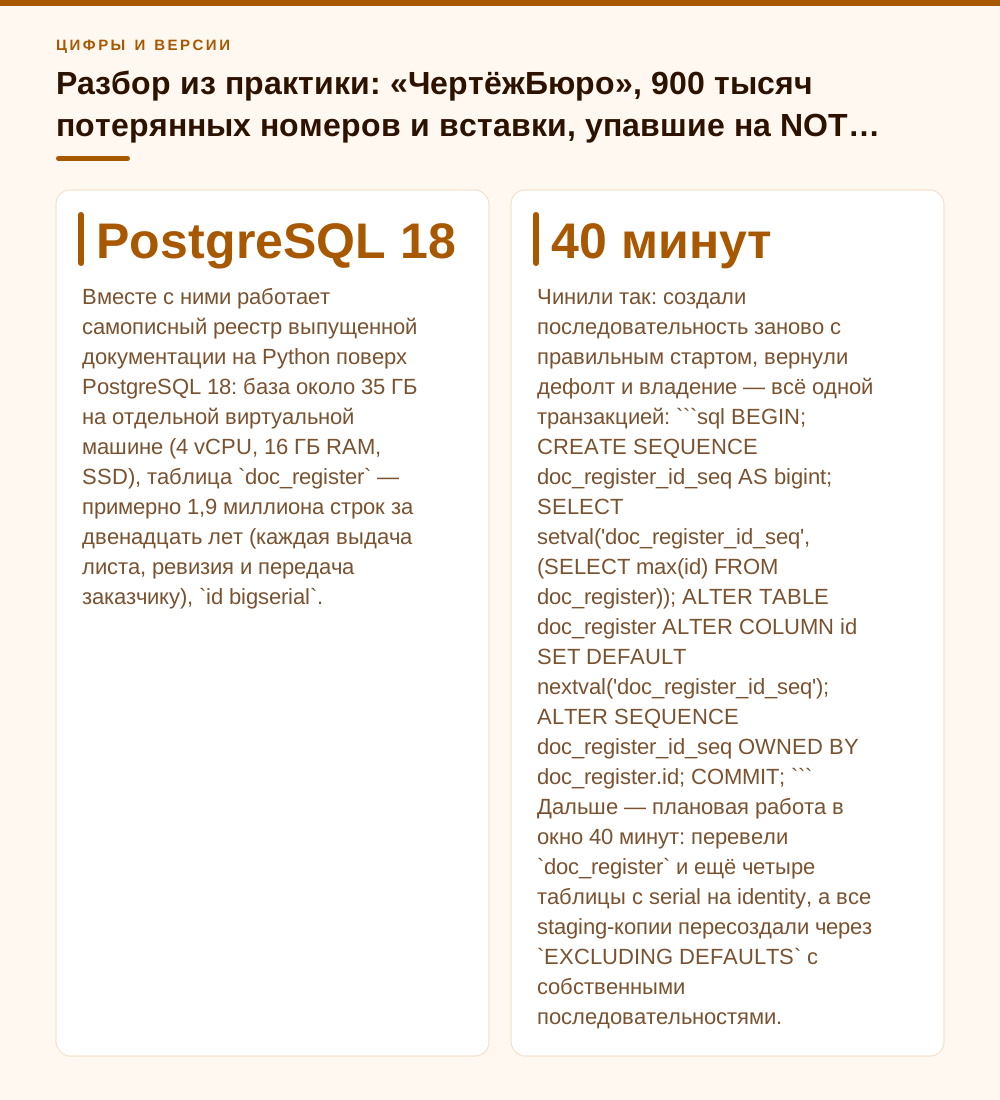
- Симптом №1: дыры в нумерации боевой таблицы после тестовых прогонов — sequence общая.
- Симптом №2: `pg_get_serial_sequence()` возвращает NULL на таблице, у которой в дефолте явно стоит nextval — владения нет, связь односторонняя.
- Симптом №3 (самый злой): `DROP TABLE ... CASCADE` на таблице-владельце уносит последовательность и снимает DEFAULT у всех остальных таблиц, где она стояла в `nextval()`, — вставки падают с `violates not-null constraint` (SQLSTATE 23502) в совершенно другой таблице.
- Косвенный признак: количество объектов-последовательностей в схеме заметно меньше количества таблиц с автоинкрементом.
Диагностика: четыре запроса, которые показывают правду
Прежде чем чинить, надо понять масштаб. У клиента с историей в несколько лет таких «сиамских близнецов» обычно не одна пара. Первый запрос — просто список всех столбцов, у которых дефолт вызывает nextval, с указанием, на какую именно последовательность они смотрят:
SELECT c.table_schema,
       c.table_name,
       c.column_name,
       c.column_default,
       pg_get_serial_sequence(
           quote_ident(c.table_schema)||'.'||quote_ident(c.table_name),
           c.column_name) AS owned_seq
  FROM information_schema.columns c
 WHERE c.column_default LIKE 'nextval(%'
   AND c.table_schema NOT IN ('pg_catalog','information_schema')
 ORDER BY 1,2,3;
Все строки, где owned_seq пустой, а column_default при этом непустой, — кандидаты на разбор. Это ровно те столбцы, которые последовательность используют, но не владеют ею.
Второй запрос точнее: он группирует столбцы по фактически используемой последовательности и показывает те, которыми пользуется больше одной таблицы. Именно эти пары и создают дыры в нумерации.
WITH defs AS (
  SELECT n.nspname   AS schema_name,
         t.relname   AS table_name,
         att.attname AS column_name,
         pg_get_expr(a.adbin, a.adrelid) AS def
    FROM pg_attrdef a
    JOIN pg_class     t   ON t.oid = a.adrelid
    JOIN pg_namespace n   ON n.oid = t.relnamespace
    JOIN pg_attribute att ON att.attrelid = a.adrelid AND att.attnum = a.adnum
   WHERE n.nspname NOT IN ('pg_catalog','information_schema')
)
SELECT (regexp_match(def, 'nextval\(''([^'']+)'''))[1]      AS seq_name,
       count(*)                                          AS users,
       string_agg(table_name||'.'||column_name, ', ')     AS columns
  FROM defs
 WHERE def LIKE 'nextval(%'
 GROUP BY 1
HAVING count(*) > 1
 ORDER BY 2 DESC;
Третий — проверка владения через каталог зависимостей. Он отвечает на вопрос «что произойдёт, если я сделаю DROP TABLE вот на эту таблицу»: если последовательность привязана к ней через deptype = 'a' (auto), она умрёт вместе с таблицей.
SELECT s.relname AS sequence_name,
       t.relname AS owner_table,
       att.attname AS owner_column,
       d.deptype
  FROM pg_depend d
  JOIN pg_class s   ON s.oid = d.objid   AND s.relkind = 'S'
  JOIN pg_class t   ON t.oid = d.refobjid
  JOIN pg_attribute att ON att.attrelid = d.refobjid AND att.attnum = d.refobjsubid
 WHERE d.deptype IN ('a','i')
 ORDER BY 1;
Четвёртый запрос нужен уже после разбора — он показывает, насколько далеко ушла последовательность от реальных данных, то есть сколько ID съедено вхолостую: SELECT last_value, (SELECT max(id) FROM orders) AS real_max FROM orders_id_seq;. Разница в миллионы при таблице на десятки миллионов строк — это и есть отпечаток чужих тестов.
- Запрос №1 (information_schema.columns): все столбцы с дефолтом `nextval()` и признак владения — NULL в `owned_seq` при непустом дефолте означает «пользуется, но не владеет».
- Запрос №2 (pg_attrdef + regexp_match): последовательности, на которые смотрят два и более столбца, — источник дыр в нумерации.
- Запрос №3 (pg_depend, deptype 'a' и 'i'): кто владеет последовательностью и, значит, при DROP какой таблицы она будет удалена.
- Запрос №4 (last_value против max(id)): сколько значений ушло вхолостую — нужен для отчёта, а не для «починки».
- Контрольная проверка перед любым DROP: выполнить его без CASCADE и прочитать DETAIL — PostgreSQL сам перечислит зависимые дефолты.
Как копировать структуру правильно: четыре рецепта
Дальше — то, ради чего вы, скорее всего, и открыли статью. Способов четыре, и я честно скажу, какой использую сам и почему остальные три всё-таки нужны.
Рецепт первый, самый быстрый и на 90 % случаев достаточный — явно выключить дефолты, оставив всё остальное. Работает это благодаря правилу из мануала: «если для одного и того же вида объектов сделано несколько указаний, используется последнее». То есть EXCLUDING после INCLUDING ALL честно перебивает опцию:
CREATE TABLE orders_test (LIKE orders INCLUDING ALL EXCLUDING DEFAULTS);Вы получите копию с индексами, PK, UNIQUE, CHECK, комментариями, сжатием и STORAGE — но со столбцом id без дефолта вовсе. Дальше либо вставляете id явно (в тестах это часто даже удобнее — воспроизводимые данные), либо навешиваете собственный генератор.
Рецепт второй — тот, которым я закрываю задачу «нужна полноценная независимая копия с автоинкрементом». Выключаем дефолты и сразу делаем столбец identity: PostgreSQL создаст для него собственную неявную последовательность, привязанную к новой таблице.
CREATE TABLE orders_test (LIKE orders INCLUDING ALL EXCLUDING DEFAULTS);

ALTER TABLE orders_test
    ALTER COLUMN id ADD GENERATED BY DEFAULT AS IDENTITY;

-- при необходимости сдвинуть старт, чтобы тестовые ID не пересекались с боевыми
ALTER TABLE orders_test ALTER COLUMN id RESTART WITH 1000000000;
Синтаксис здесь ровно из документации ALTER TABLE: ALTER [ COLUMN ] column_name ADD GENERATED { ALWAYS | BY DEFAULT } AS IDENTITY [ ( sequence_options ) ]. Обратите внимание: ADD GENERATED не сработает, пока на столбце висит DEFAULT — сначала DROP DEFAULT, потом identity. Если вы копировали с EXCLUDING DEFAULTS, дефолта там нет изначально и шаг не нужен.
Рецепт третий — не лечить симптом, а убрать причину: перевести оригинал с serial на identity, и тогда LIKE ... INCLUDING ALL начнёт работать так, как вы от него и ждали. Мануал прямым текстом: «INCLUDING IDENTITY — любые спецификации identity копируемых столбцов будут скопированы. Для каждого identity-столбца новой таблицы создаётся новая последовательность, отдельная от последовательностей, связанных со старой таблицей». INCLUDING IDENTITY входит в INCLUDING ALL, так что после конвертации проблема исчезает сама.
BEGIN;
ALTER TABLE orders ALTER COLUMN id DROP DEFAULT;
ALTER SEQUENCE orders_id_seq OWNED BY NONE;
ALTER TABLE orders ALTER COLUMN id ADD GENERATED BY DEFAULT AS IDENTITY;
SELECT setval(pg_get_serial_sequence('orders','id'),
              (SELECT coalesce(max(id), 0) FROM orders) + 1, false);
COMMIT;

DROP SEQUENCE orders_id_seq;   -- отдельным шагом, убедившись, что на неё никто не смотрит
Рецепт четвёртый — на случай, когда копия нужна в другую базу или в другую схему и хочется полного контроля: снять DDL через pg_dump --schema-only --table=public.orders и руками поправить имена. Способ занудный, зато вы своими глазами увидите и CREATE SEQUENCE, и OWNED BY, и все имена индексов — а LIKE INCLUDING INDEXES, напомню, переименовывает индексы по дефолтным правилам, что при переносе между средами иногда ломает чужие миграции.
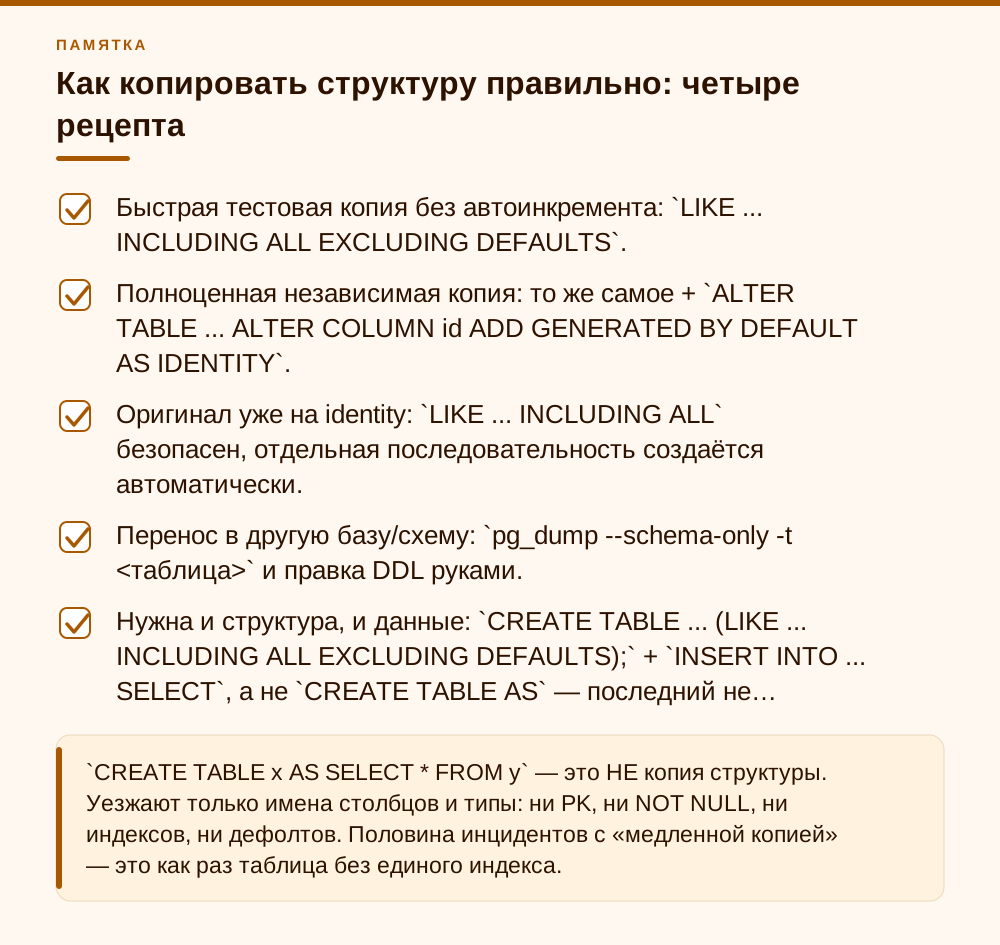
- Быстрая тестовая копия без автоинкремента: `LIKE ... INCLUDING ALL EXCLUDING DEFAULTS`.
- Полноценная независимая копия: то же самое + `ALTER TABLE ... ALTER COLUMN id ADD GENERATED BY DEFAULT AS IDENTITY`.
- Оригинал уже на identity: `LIKE ... INCLUDING ALL` безопасен, отдельная последовательность создаётся автоматически.
- Перенос в другую базу/схему: `pg_dump --schema-only -t <таблица>` и правка DDL руками.
- Нужна и структура, и данные: `CREATE TABLE ... (LIKE ... INCLUDING ALL EXCLUDING DEFAULTS);` + `INSERT INTO ... SELECT`, а не `CREATE TABLE AS` — последний не переносит ни индексы, ни ограничения вообще. Внешние ключи LIKE не копирует ни с какими опциями — их добавляют отдельным `ALTER TABLE ... ADD FOREIGN KEY`.
Вторая мина: OWNED BY и DROP TABLE CASCADE
Общая последовательность — это полбеды, дыры в нумерации переживаются. По-настоящему больно становится, когда кто-то удаляет одну из связанных таблиц. Механика описана в документации CREATE SEQUENCE и звучит однозначно: «Опция OWNED BY делает последовательность связанной с конкретным столбцом таблицы так, что при удалении этого столбца (или всей его таблицы) последовательность будет автоматически удалена. Указанная таблица должна иметь того же владельца и находиться в той же схеме, что и последовательность. OWNED BY NONE — значение по умолчанию — означает отсутствие такой связи».
Разложим по сценариям, потому что путаницы тут больше всего. Сценарий А: у вас orders с serial и копия orders_test, сделанная через INCLUDING ALL. Последовательность принадлежит orders.id. Удаляете orders_test — ничего не происходит, последовательность жива. Удаляете orders без CASCADE — PostgreSQL откажет: ERROR: cannot drop table orders because other objects depend on it, а в DETAIL будет строка про default value for column id of table orders_test. Удаляете orders CASCADE — последовательность уезжает вместе с таблицей, а у orders_test снимается DEFAULT. Сама копия и её данные остаются, но следующая вставка без явного id падает с null value in column "id" ... violates not-null constraint. Это прямое следствие фразы из описания serial-типов: последовательность можно удалить, не удаляя столбец, «but this will force removal of the column default expression».
Сценарий Б, тот самый, что был в «ЧертёжБюро»: кто-то перепривязал владение на копию. Теперь удаление копии с CASCADE снимает дефолт у боевой таблицы. Это худший вариант, потому что удаление staging-таблицы воспринимается как безопасная операция и делается без окна, без предупреждения и часто не тем человеком, который это владение когда-то настроил. Отдельно отмечу: identity-столбцы этой проблемы не имеют — их последовательность внутренняя, принадлежит ровно одному столбцу, и LIKE для копии создаёт свою.
Отсюда простое правило, которое я вбиваю в регламенты у клиентов: перед DROP TABLE любой таблицы с автоинкрементом смотрим, какие последовательности уйдут вместе с ней и кто ещё ими пользуется. Один запрос, десять секунд:
WITH owned AS (
  SELECT s.oid, s.relname AS seq_name
    FROM pg_depend d
    JOIN pg_class s ON s.oid = d.objid AND s.relkind = 'S'
    JOIN pg_class t ON t.oid = d.refobjid
   WHERE t.relname = 'orders_2025' AND d.deptype IN ('a','i')
)
SELECT o.seq_name       AS will_be_dropped_too,
       c.relname        AS table_losing_default,
       att.attname      AS column_name
  FROM owned o
  LEFT JOIN pg_depend dd  ON dd.refobjid = o.oid AND dd.classid = 'pg_attrdef'::regclass
  LEFT JOIN pg_attrdef ad ON ad.oid = dd.objid
  LEFT JOIN pg_class c    ON c.oid = ad.adrelid
  LEFT JOIN pg_attribute att ON att.attrelid = ad.adrelid AND att.attnum = ad.adnum;
Если в table_losing_default есть что-то кроме самой удаляемой таблицы — сначала ALTER SEQUENCE <имя> OWNED BY <живая_таблица>.<столбец>; (владелец должен быть в той же схеме и с тем же владельцем, что и последовательность) или OWNED BY NONE, и только потом DROP — причём без CASCADE.
- Сначала `DROP TABLE имя;` без CASCADE: если есть чужие дефолты на её последовательности, PostgreSQL остановится и перечислит их в DETAIL.
- Владение последовательностью переносится на таблицу, которая переживёт остальные: `ALTER SEQUENCE seq OWNED BY main_table.id;`.
- `OWNED BY NONE` делает последовательность «свободной»: её не удалит ни один DROP TABLE, но и убирать её потом придётся вручную.
- Если CASCADE уже выполнен и вставки падают на NOT NULL — `CREATE SEQUENCE`, `setval()` по `max(id)`, `ALTER COLUMN ... SET DEFAULT nextval(...)`, `OWNED BY`.
- Для identity-столбцов перепривязка через `ALTER SEQUENCE ... OWNED BY` не нужна и не имеет смысла: их последовательность управляется через `ALTER TABLE ... ALTER COLUMN`.
Что делать в первую очередь, а на что можно забить
Расставлю приоритеты, потому что бросаться конвертировать всю базу на identity в понедельник утром не надо. Первым делом — прогоните диагностические запросы из четвёртого раздела и найдите последовательности, которыми пользуется больше одного столбца. Это делается на реплике, за пять минут, без окна и без риска. Если таких нет — вы молодец, дальше можно не читать, просто добавьте в code review проверку на LIKE ... INCLUDING ALL.
Вторым шагом — проверьте владение (deptype 'a' или 'i' в pg_depend) для каждой найденной последовательности. Если владелец — не та таблица, которая должна пережить остальные, переприкрепите: это мгновенная операция под короткой блокировкой, риска практически нет. Именно этот шаг закрывает самый разрушительный сценарий с CASCADE, когда удаление staging-таблицы снимает DEFAULT у боевой. Он важнее, чем починка нумерации.
Третьим — уже спокойно, в плановое окно, переводите таблицы с serial на identity. Тут я честно скажу, где решение спорное: конвертация меняет метаданные, и часть ORM и миграционных фреймворков (особенно старые версии Django, Alembic и всё, что генерирует DDL по своей модели) при следующей автогенерации миграций захочет «вернуть как было». Так что переводить надо не только базу, но и модель в коде, иначе следующая же миграция всё откатит. Если у вас тяжёлая связка с ORM и не хватает рук — не трогайте serial вообще, ограничьтесь правилом «копии только через EXCLUDING DEFAULTS». Это закрывает 95 % риска при нулевых затратах.
На что можно спокойно забить: на существующие дыры в нумерации. Их не надо «заполнять», не надо откатывать sequence назад через setval — это прямой путь к нарушению уникальности PK. Суррогатный ключ не обязан быть непрерывным, и если бизнес требует непрерывной нумерации документов — это отдельное поле с отдельной логикой выдачи номера, а не serial. Ещё можно забить на переименование индексов, которое устраивает INCLUDING INDEXES: на staging-копиях имена индексов не имеют значения, важны они только при переносе DDL между средами.
И последнее, из наблюдений: в 2026 году в новых проектах я не вижу причин использовать serial вообще. Стандарт SQL — это identity, PostgreSQL поддерживает его с десятой версии, поведение при копировании структуры предсказуемое, а GENERATED ALWAYS AS IDENTITY вдобавок защищает от случайной вставки явного ID (переопределить можно только через явное OVERRIDING SYSTEM VALUE). В PostgreSQL 18 к этому добавился ещё и uuidv7() — если вам нужны глобально уникальные и при этом сортируемые по времени ключи, теперь это делается штатной функцией без расширений. serial остаётся только там, где его тащат из легаси.
- Сегодня: найти последовательности с несколькими пользователями (запрос №2 из раздела диагностики).
- Сегодня же: проверить владение и переприкрепить `OWNED BY` на правильную таблицу — это дешевле всего и спасает от CASCADE.
- В ближайшее окно: перевести serial → identity вместе с моделями в коде, а не только в базе.
- В регламент: любая копия структуры делается через `EXCLUDING DEFAULTS`, любой `DROP TABLE` — после проверки pg_depend.
- Забить можно: на дыры в нумерации, на имена индексов в staging-копиях, на «красоту» значений last_value.
Частые вопросы
Почему INCLUDING ALL не создаёт новую последовательность для serial-столбца, если для identity создаёт?
Потому что это разные сущности. У identity-столбца последовательность — часть определения столбца, сервер знает, что её надо пересоздать, и мануал это гарантирует. У serial-столбца последовательность живёт в текстовом выражении DEFAULT: `nextval('orders_id_seq'::regclass)`. INCLUDING DEFAULTS копирует это выражение буквально, вместе с именем чужой последовательности. Сервер не разбирает содержимое дефолта и не догадывается, что вы хотели «свой генератор».
Какой самый короткий безопасный вариант скопировать структуру таблицы?
`CREATE TABLE new_table (LIKE old_table INCLUDING ALL EXCLUDING DEFAULTS);`. Работает благодаря документированному правилу «последнее указание для одной категории побеждает»: EXCLUDING после INCLUDING ALL выключает только дефолты, остальное копируется. Столбец id при этом останется без автоинкремента — если он нужен, добавьте `ALTER TABLE new_table ALTER COLUMN id ADD GENERATED BY DEFAULT AS IDENTITY;`.
Как проверить, не делит ли моя копия последовательность с оригиналом?
Два быстрых способа. Первый: `\d имя_таблицы` в psql — посмотрите на дефолт столбца, если там nextval с именем ЧУЖОЙ таблицы, связь есть. Второй: `SELECT pg_get_serial_sequence('копия','id');` — NULL при непустом дефолте означает, что таблица последовательностью пользуется, но не владеет ею. Массово по всей базе — запросом к information_schema.columns с фильтром `column_default LIKE 'nextval(%'`.
Можно ли откатить последовательность назад, если тесты съели миллионы ID?
Технически да, через `setval()`, но я не советую. Как только выданное значение совпадёт с уже существующим id, вставка упадёт по нарушению уникальности первичного ключа — и упадёт не сразу, а через некоторое время, когда счётчик догонит занятый диапазон. Суррогатный ключ не обязан быть непрерывным. Если бизнесу нужна сплошная нумерация документов — заводите отдельное поле с собственной логикой выдачи номера.
Что произойдёт, если удалить исходную таблицу, а копию оставить?
Если таблица-оригинал владеет последовательностью (OWNED BY), обычный `DROP TABLE` без CASCADE не выполнится: PostgreSQL сообщит, что от последовательности зависит default value столбца копии. С CASCADE последовательность будет удалена, а у копии снят DEFAULT — таблица и данные останутся, но вставка без явного id упадёт с `null value in column "id" ... violates not-null constraint` (SQLSTATE 23502). Перед удалением перенесите владение: `ALTER SEQUENCE имя_последовательности OWNED BY копия.id;` — или заранее сделайте копии независимыми через EXCLUDING DEFAULTS и identity.
Стоит ли переводить существующие serial-столбцы на identity?
В новых проектах — однозначно да, identity это стандарт SQL и предсказуемое поведение при копировании структуры. В существующих — по обстоятельствам. Если у вас ORM, которая генерирует миграции по своей модели (Django, Alembic и подобные), конвертировать надо одновременно в базе и в коде, иначе следующая автогенерируемая миграция вернёт serial обратно. Если рук не хватает — не трогайте, просто закрепите в регламенте правило копировать структуру через EXCLUDING DEFAULTS.
Источники
- PostgreSQL 18 — CREATE TABLE, параметр LIKE и like_option — Описание LIKE source_table [ like_option ... ]: LIKE копирует имена столбцов, типы и not-null; INCLUDING DEFAULTS с явным предупреждением о nextval («may create a functional linkage between the original and new tables»); INCLUDING IDENTITY («A new sequence is created for each identity column of the new table, separate from the sequences associated with the old table»); INCLUDING ALL и правило «if multiple specifications are made for the same kind of object, the last one is used». https://www.postgresql.org/docs/18/sql-createtable.html
- PostgreSQL 18 — ALTER TABLE, формы работы с identity и DEFAULT — Точный синтаксис ALTER [ COLUMN ] column_name ADD GENERATED { ALWAYS | BY DEFAULT } AS IDENTITY [ ( sequence_options ) ], DROP IDENTITY [ IF EXISTS ], SET/DROP DEFAULT. https://www.postgresql.org/docs/18/sql-altertable.html
- PostgreSQL 18 — CREATE SEQUENCE, клауза OWNED BY — «The OWNED BY option causes the sequence to be associated with a specific table column, such that if that column (or its whole table) is dropped, the sequence will be automatically dropped as well… OWNED BY NONE, the default, specifies that there is no such association.» https://www.postgresql.org/docs/18/sql-createsequence.html
- PostgreSQL 18 — System Information Functions, pg_get_serial_sequence() — Функция возвращает имя последовательности, связанной со столбцом, или NULL при отсутствии связи; для identity-столбца — внутреннюю последовательность; связь serial-столбца можно изменить или снять через ALTER SEQUENCE OWNED BY. https://www.postgresql.org/docs/18/functions-info.html
- PostgreSQL 18 — Identity Columns (DDL) — Различия GENERATED ALWAYS и GENERATED BY DEFAULT, поведение OVERRIDING SYSTEM VALUE при явной вставке значения в identity-столбец. https://www.postgresql.org/docs/18/ddl-identity-columns.html
- PostgreSQL — Versioning Policy и Release Notes 18 — Таблица поддерживаемых версий: PostgreSQL 18 — первый выпуск 25 сентября 2025 г., актуальный минорный 18.x, поддержка до ноября 2030 г. https://www.postgresql.org/support/versioning/ ; изменения релиза 18 (виртуальные генерируемые столбцы по умолчанию, uuidv7()): https://www.postgresql.org/docs/18/release-18.html
- PostgreSQL 18 — Serial Types (8.1.4) — Во что разворачивается serial (CREATE SEQUENCE + DEFAULT nextval + OWNED BY); «You can drop the sequence without dropping the column, but this will force removal of the column default expression». https://www.postgresql.org/docs/18/datatype-numeric.html#DATATYPE-SERIAL
- PostgreSQL 18 — Dependency Tracking (5.15) — DROP без CASCADE выдаёт ERROR с DETAIL-списком зависимых объектов; «If you want to check what DROP ... CASCADE will do, run DROP without CASCADE and read the DETAIL output». https://www.postgresql.org/docs/18/ddl-depend.html