
Реплика догнала мастер, а INSERT падает с duplicate key: почему отстали последовательности
Ситуация, которую я видел уже раз пять у разных клиентов: миграция на новый сервер PostgreSQL прошла идеально, лаг репликации нулевой, count(*) по всем таблицам сходится строка в строку, приложение переключили на новый DSN — и через несколько минут перестают создаваться заказы. В логе duplicate key value violates unique constraint. Здесь я разбираю, почему так происходит, показываю на реальном стенде, что именно ломается, и даю тот порядок действий и те скрипты, которыми пользуюсь сам при переключении записи на логическую реплику.
Совпали строки — не значит, что можно писать
Классическая картина: вечер субботы, миграция базы системы приёма заказов с одного сервера на другой через встроенную логическую репликацию. Проверили всё, что обычно проверяют. pg_stat_subscription показывает свежие latest_end_time, отставание по WAL на паблишере — единицы килобайт, скрипт сверки прогнал 118 таблиц и по каждой выдал одинаковый count(*). Формально подписчик — точная копия. Меняем строку подключения в приложении, перезапускаем пул, и первый же пользователь, который жмёт «Создать заказ», получает пятисотку.
В логе PostgreSQL при этом лежит вот такое:
ERROR:  duplicate key value violates unique constraint "orders_pkey"
DETAIL:  Key (id)=(1) already exists.
STATEMENT:  INSERT INTO orders (customer_id, total) VALUES ($1, $2) RETURNING id
Обратите внимание на ключ: (id)=(1). Не 84213, не какое-то близкое к максимуму значение — ровно единица. Это не гонка, не сбой уникальности, не битый индекс. Это последовательность orders_id_seq на подписчике, которая как стояла на стартовом значении с момента создания схемы, так и стоит. Данные приехали, счётчик — нет.
И дальше начинается самое неприятное. Приложение с ретраями будет ломиться дальше и получать duplicate key на 2, на 3, на 4 — пока nextval не проползёт мимо всех уже занятых идентификаторов. Если в таблице сто тысяч строк, оно не проползёт никогда за разумное время. Если в таблице триста строк — оно проползёт, часть заказов даже создастся, и вы получите худший вариант: не явную аварию, а тихую полурабочую систему, где половина операций падает, а половина проходит. Разбирать это потом по логам — отдельное удовольствие.
- нулевой replication lag — это про WAL, а не про готовность к записи;
- совпадение count(*) по таблицам ничего не говорит о состоянии счётчиков;
- ключ ошибки, равный 1 или другому маленькому числу, — почти стопроцентный признак именно этой проблемы;
- страдают все таблицы с serial, bigserial и GENERATED ... AS IDENTITY, то есть практически все справочники и документы.
Почему последовательность не едет вместе с данными
Тут нет бага и нет недосмотра — это документированное ограничение, причём формулировка в мануале не менялась годами. В разделе Logical Replication Restrictions для PostgreSQL 18 написано прямо: «Sequence data is not replicated. The data in serial or identity columns backed by sequences will of course be replicated as part of the table, but the sequence itself would still show the start value on the subscriber». И дальше — ключевое для нас предложение: если планируется switchover или failover на подписчика, последовательности нужно актуализировать, либо скопировав текущие данные с паблишера (например, через pg_dump), либо определив достаточно высокое значение по самим таблицам.
Механика простая, если помнить, как устроена логическая репликация. Публикация публикует таблицы — только таблицы. Декодирование WAL превращает физические записи в логический поток изменений строк: INSERT, UPDATE, DELETE, TRUNCATE. Столбец id при этом едет как обычное значение колонки, наравне с суммой заказа и датой. Объект orders_id_seq — это отдельная сущность, отдельный relation в каталоге, и в поток изменений подписки он не попадает вообще. Более того, физически sequence пишет в WAL не каждый nextval, а раз в 32 значения (SEQ_LOG_VALS) — но нам это даже не важно, потому что до подписчика эти записи в любом случае не доходят.
Убедиться в этом можно за десять секунд. Выполните на обоих серверах одно и то же:
SELECT schemaname, sequencename, last_value
FROM pg_sequences
WHERE schemaname NOT IN ('pg_catalog','information_schema')
ORDER BY 1, 2;
На паблишере вы увидите живые значения — 84213, 15602, 7. На подписчике в большинстве строк будет либо стартовое значение, либо вообще NULL. NULL здесь не ошибка: last_value в представлении pg_sequences читается как null, если последовательность ещё ни разу не читали, если у текущего пользователя нет USAGE или SELECT на неё, либо если последовательность unlogged и сервер — standby. Первый случай — как раз наш: на свежесозданной схеме подписчика никто ни разу не звал nextval.
- публикация в PostgreSQL 18 содержит только таблицы — объекта «последовательность» в ней нет;
- значение колонки id приезжает на подписчика как обычные данные строки, счётчик orders_id_seq остаётся на стартовом значении;
- serial, bigserial и GENERATED ... AS IDENTITY ведут себя одинаково — под каждым лежит обычная sequence;
- last_value = NULL в pg_sequences на подписчике чаще всего означает, что nextval по ней ещё ни разу не вызывали;
- для identity-колонки сдвинуть счётчик можно и через ALTER TABLE ... ALTER COLUMN ... RESTART WITH, но setval проще генерировать пачкой.
Разбор из практики: типография «Оттиск», 18 рабочих мест, 60 ГБ данных
Клиент — типография оперативной печати «Оттиск», 18 рабочих мест: приёмщики, дизайнеры-верстальщики, печатники и бухгалтерия. Заказы принимает самописный портал на PHP — клиент загружает макет, выбирает тираж и бумагу, система считает цену и заводит заказ, дальше статусы идут в производство и выгружаются в 1С. База портала 60 ГБ, из них 45 ГБ — журнал операций и история статусов заказов. Задача: уехать с PostgreSQL 15 на старом сервере (диски начали сыпать SMART-ошибками) на PostgreSQL 18.6 на новом железе. Downtime по договорённости — не больше получаса в ночь с субботы на воскресенье, потому что в понедельник с утра очередь на цифровую печать. Дамп-рестор с апгрейдом по нашим репетициям в окно не влезал, поэтому выбрали логическую репликацию: заранее накатываем схему, поднимаем подписку, несколько дней ждём синхронизации, в окно только переключаемся.
Конфигурация была вполне обычная. На паблишере:
# postgresql.conf, publisher
wal_level = logical
max_wal_senders = 16
max_replication_slots = 16
max_slot_wal_keep_size = -1
На подписчике пришлось учесть новшество восемнадцатой версии — параметр max_active_replication_origins, который в PostgreSQL 18 вынесли отдельно от max_replication_slots:
# postgresql.conf, subscriber (PostgreSQL 18.6)
max_active_replication_origins = 8
max_logical_replication_workers = 8
max_sync_workers_per_subscription = 4
max_worker_processes = 16
Отдельно отмечу ещё одно изменение PostgreSQL 18, о которое можно споткнуться при планировании: значение по умолчанию для опции streaming в CREATE SUBSCRIPTION изменили с off на parallel. Это в целом хорошо — большие транзакции применяются параллельно и не ждут коммита, — но если у вас на подписчике мало worker-процессов, вы это заметите по ошибкам запуска apply-воркеров.
Начальная синхронизация 118 таблиц заняла 1 час 50 минут, дальше пять дней всё догоняло в онлайне без единого сбоя. В ночь переключения по чеклисту: остановили запись в портале, дождались нулевого лага, сверили счётчики строк — всё сошлось. Переключили DSN. Через шесть минут пришёл первый ночной заказ с сайта — и сразу duplicate key на orders_pkey. Дальше посыпалось: order_items_id_seq, customers_id_seq, status_log_id_seq. Всего в базе оказалась 41 последовательность, и ни одна из них не была актуальна.
Лечилось это восемь минут. Сняли с паблишера дамп только последовательностей (он в этот момент был уже переведён в read-only, так что значения были финальные), накатили на подписчика, прогнали проверочный запрос, вернули портал. Итог: вместо получаса даунтайма получилось 38 минут, четыре ночных заказа ушли в ошибку, и утром менеджер завёл их вручную по письмам клиентов. Не катастрофа — но ровно потому, что паблишер ещё стоял живой и не был удалён. Если бы старый сервер уже погасили и стёрли, восстанавливать пришлось бы вторым способом — расчётом по данным, и с гораздо большей нервотрёпкой: номера заказов у «Оттиска» печатаются на бланках и наклейках тиража, дубль номера там сразу виден клиенту.
- паблишер: wal_level = logical, запас max_wal_senders и max_replication_slots под все подписки плюс одну тестовую;
- подписчик на PostgreSQL 18: отдельно проверить max_active_replication_origins и max_worker_processes, иначе apply-воркеры не стартуют;
- streaming = parallel по умолчанию в 18-й версии требует свободных фоновых процессов — считайте их заранее;
- в чеклисте переключения обязательно отдельный пункт «перенос последовательностей» с проверкой, а не пометка «и не забыть sequence»;
- старый сервер остаётся живым и в read-only до конца следующего рабочего дня.
Два рабочих способа перенести последовательности
Первый способ — тот, который рекомендует документация, и тот, которым пользуюсь я, когда паблишер доступен. У pg_dump нет отдельной опции «дампить только последовательности», но есть -t, который умеет выбирать в том числе и sequence, и есть --data-only, который для последовательностей выгружает именно значения — в виде готовых вызовов setval. Список последовательностей проще собрать запросом:
# 1) собираем список последовательностей с паблишера
psql -h pub -d shop -At -F' ' -c "
  SELECT '-t ' || quote_ident(schemaname) || '.' || quote_ident(sequencename)
  FROM pg_sequences
  WHERE schemaname NOT IN ('pg_catalog','information_schema')
  ORDER BY 1" | tr '\n' ' ' > /tmp/seq_args

# 2) снимаем только данные последовательностей
pg_dump -h pub -d shop --data-only $(cat /tmp/seq_args) > /tmp/seq.sql

# 3) смотрим глазами, что получилось, и накатываем
grep -c setval /tmp/seq.sql
psql -h sub -d shop -v ON_ERROR_STOP=1 -f /tmp/seq.sql
Внутри /tmp/seq.sql будут строки вида SELECT pg_catalog.setval('public.orders_id_seq', 84213, true);. Третий аргумент true означает is_called — то есть следующий nextval вернёт 84214, а не 84213. Это ровно то поведение, которое нам нужно.
Второй способ — когда паблишера уже нет, или он недоступен, или вы вообще пришли разгребать чужую миграцию постфактум. Тогда считаем по данным: берём максимум по колонке и ставим последовательность выше него с запасом. Запрос-генератор:
SELECT format(
         'SELECT setval(%L, COALESCE((SELECT max(%I) FROM %I.%I), 0) + 1000, true);',
         pg_get_serial_sequence(format('%I.%I', c.table_schema, c.table_name), c.column_name),
         c.column_name, c.table_schema, c.table_name)
FROM information_schema.columns c
WHERE c.table_schema NOT IN ('pg_catalog','information_schema')
  AND pg_get_serial_sequence(format('%I.%I', c.table_schema, c.table_name), c.column_name) IS NOT NULL
ORDER BY 1;
Результат — готовый набор команд, который сначала читаем, а потом выполняем. pg_get_serial_sequence() корректно работает и для serial, и для identity-колонок: для identity он возвращает ту самую последовательность, которую сервер создал внутри себя. Запас в 1000 я ставлю не из суеверия: он закрывает случай, когда в окно переключения на паблишер всё-таки просочилась пара записей, и случай, когда часть значений была выдана из кэша последовательности и потеряна. Дырки в нумерации — это нормально, задача последовательности не быть плотной, а быть уникальной.
Отдельно про выбор между setval() и ALTER SEQUENCE ... RESTART WITH. Документация PostgreSQL 18 говорит про RESTART, что он транзакционный и блокирует конкурентные транзакции, обращающиеся к последовательности, тогда как setval — нет. Для окна переключения, когда записи всё равно нет, разница невелика, и я беру setval просто потому, что его выдаёт pg_dump и потому что его удобно генерировать пачкой. Если же вы правите последовательность на живой базе под нагрузкой — берите setval сознательно: RESTART под нагрузкой умеет собрать очередь ожидания на ровном месте.
- setval(seq, N, true) — следующий nextval вернёт N+1, блокировок не создаёт, откату транзакции не подчиняется;
- ALTER SEQUENCE ... RESTART WITH N — следующий nextval вернёт N, команда транзакционная и блокирующая;
- ALTER SEQUENCE ... RESTART без значения — откат к стартовому значению, то есть ровно то, чего мы боимся; в скриптах миграции этой формы быть не должно.
Порядок переключения, которым пользуюсь я
Главная идея — последовательности переносятся не «где-то в процессе», а строго после того, как паблишер перестал выдавать новые значения, и строго до того, как приложение получило новый DSN. Между этими двумя точками ничего не должно писать ни туда, ни сюда. Всё остальное — обвязка вокруг этого правила.
Вот чеклист, который я держу распечатанным в окне переключения. Тайминги — из проекта в типографии «Оттиск», база 60 ГБ, 118 таблиц, 41 последовательность.
# 0. Останавливаем запись на стороне приложения (пул в read-only / maintenance page)

# 1. Паблишер в режим только чтения — страховка от «кто-то забыл сервис»
psql -h pub -d shop -c "ALTER DATABASE shop SET default_transaction_read_only = on;"
# и убить существующие сессии приложения
psql -h pub -d shop -c "SELECT pg_terminate_backend(pid) FROM pg_stat_activity
                        WHERE datname='shop' AND usename='app' AND pid <> pg_backend_pid();"

# 2. Ждём нулевого отставания слота
psql -h pub -d shop -c "
  SELECT slot_name, active,
         pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)) AS behind
  FROM pg_replication_slots WHERE slot_type = 'logical';"

# 3. Переносим последовательности (см. предыдущий раздел)

# 4. Контрольный запрос на подписчике — ищем отставшие счётчики
Шаг 4 — тот самый, которого не было в чеклисте у «Оттиска» и который я после того случая добавил всем. Он ищет последовательности, которые стоят ниже максимума в своей таблице:
SELECT c.table_schema, c.table_name, c.column_name, s.seq, s.last_value
FROM information_schema.columns c
CROSS JOIN LATERAL (
  SELECT pg_get_serial_sequence(format('%I.%I', c.table_schema, c.table_name),
                                c.column_name) AS seq
) g
JOIN pg_sequences s
  ON format('%I.%I', s.schemaname, s.sequencename) = g.seq
WHERE g.seq IS NOT NULL
  AND (s.last_value IS NULL OR s.last_value < 100);
Это грубая, но крайне полезная проверка: она вылавливает всё, что осталось на стартовом значении. Для полной сверки надо считать max по каждой таблице — даже на 60 ГБ это долго, поэтому я гоняю точную сверку заранее, на репетиции, а в окне переключения — только вот эту быструю.
И последнее по порядку, но не по важности: репетиция. Логическая репликация даёт роскошную возможность отрепетировать переключение целиком — поднять вторую подписку на тестовый сервер, прогнать по нему весь чеклист, включая перенос последовательностей и запуск приложения, и только потом идти в боевое окно. Все три раза, когда я это делал, репетиция вылавливала что-то своё: то права на схему не доехали, то extension не установлен, то в приложении нашёлся захардкоженный хост. Час репетиции экономит два часа паники.
- запись на паблишере остановлена → лаг нулевой → перенос последовательностей → проверка → новый DSN;
- паблишер переводим в default_transaction_read_only = on, а не гасим;
- подписку на подписчике после переключения не удаляем сразу — держим до конца дня, потом DROP SUBSCRIPTION;
- слот на паблишере удаляем последним, иначе он будет держать WAL и наполнять диск.
Что ещё логическая репликация не привезёт
Последовательности — самая частая, но не единственная мина. В том же разделе ограничений документации PostgreSQL 18 перечислено ещё несколько вещей, которые в моей практике ломали переключения не реже. Первое — DDL: схема и команды изменения схемы не реплицируются вообще. Схему на подписчика вы копируете сами (обычно pg_dump --schema-only) и сами же поддерживаете в актуальном состоянии. Если ваши разработчики за неделю синхронизации выкатили миграцию с новой колонкой, apply-воркер на подписчике встанет колом — и хорошо, если встанет, а не проедет мимо.
Второе — большие объекты (large objects) не реплицируются, обходной путь один: не использовать их, а хранить данные в обычных таблицах. Третье — реплицировать можно только таблицы, включая партиционированные; попытка добавить в публикацию представление, материализованное представление или внешнюю таблицу завершится ошибкой. Четвёртое — TRUNCATE поддерживается, но падает, если у усекаемых таблиц есть внешние ключи на таблицы вне подписки. Пятое — при REPLICA IDENTITY FULL операции UPDATE и DELETE ломаются на таблицах с типами данных без B-tree или Hash operator class (тот же point или box), если нет первичного ключа или заданной replica identity.
Полезное дополнение именно восемнадцатой версии: PostgreSQL 18 начал логировать конфликты при применении изменений логической репликации. Раньше вы видели просто ошибку apply-воркера и гадали, что произошло; теперь в логе подписчика конфликт описан явно, с указанием типа. Диагностику это ускоряет заметно — но, подчеркну, к нашей проблеме с последовательностями это отношения не имеет: там конфликта на apply нет, там ошибка возникает уже от вашего собственного приложения, после переключения.
- DDL и схема — переносите сами, `pg_dump --schema-only`, и заморозьте миграции на время синхронизации;
- large objects — не реплицируются, проверьте pg_largeobject_metadata на непустоту заранее;
- views, matviews, foreign tables — в публикацию не добавляются, matview на подписчике надо будет пересобрать;
- права и роли — GRANT/REVOKE не едут с данными, снимайте `pg_dumpall --roles-only` отдельно;
- extensions — на подписчике их надо поставить и создать до накатывания схемы.
PostgreSQL 19: FOR ALL SEQUENCES и REFRESH SEQUENCES. Ждать или нет
Хорошая новость: в PostgreSQL 19 (на сентябрь 2026 года ветка в статусе beta, релиз ещё не вышел) у логической репликации появился отдельный механизм синхронизации последовательностей. Формулировка в разделе ограничений изменилась с «Sequence data is not replicated» на «Incremental sequence changes are not replicated... On the subscriber, a sequence will retain the last value it synchronized from the publisher». Схема такая: на паблишере последовательности включаются в публикацию предложением ALL SEQUENCES — выбрать отдельные sequence нельзя, только все постоянные последовательности базы разом, и делать это может только суперпользователь. На подписчике значения забираются при CREATE SUBSCRIPTION с copy_data = true, новые последовательности подтягиваются через ALTER SUBSCRIPTION ... REFRESH PUBLICATION, а уже известные пересинхронизируются командой ALTER SUBSCRIPTION ... REFRESH SEQUENCES:
-- паблишер, PostgreSQL 19
CREATE PUBLICATION pub_shop FOR ALL TABLES, ALL SEQUENCES;

-- подписчик, в окне переключения после остановки записи
ALTER SUBSCRIPTION sub_shop REFRESH SEQUENCES;
Синхронизацию выполняет отдельный sequence synchronization worker: он запускается по команде, сверяет определения последовательностей на обеих сторонах и завершается. Число таких воркеров ограничено max_sync_workers_per_subscription, ошибки видны в новой колонке sync_seq_error_count представления pg_stat_subscription_stats.
Плохая новость — это не отменяет ни одного шага из чеклиста выше. Во-первых, синхронизация не непрерывная: инкрементальные изменения по-прежнему не едут, последовательность на подписчике хранит значение с момента последней синхронизации. Значит, вызывать REFRESH SEQUENCES всё равно надо в окне переключения, после остановки записи — ровно там, где сейчас стоит pg_dump. Во-вторых, документация прямо требует, чтобы паблишер работал на PostgreSQL 19 или новее, а команда пересинхронизирует только последовательности, уже известные подписке. Для миграции «с 15-й на 18-ю», как у «Оттиска», это не помогает никак, и даже переезд «с 18-й на 19-ю» останется без этой возможности: на старом сервере 18-я версия, публиковать последовательности она не умеет.
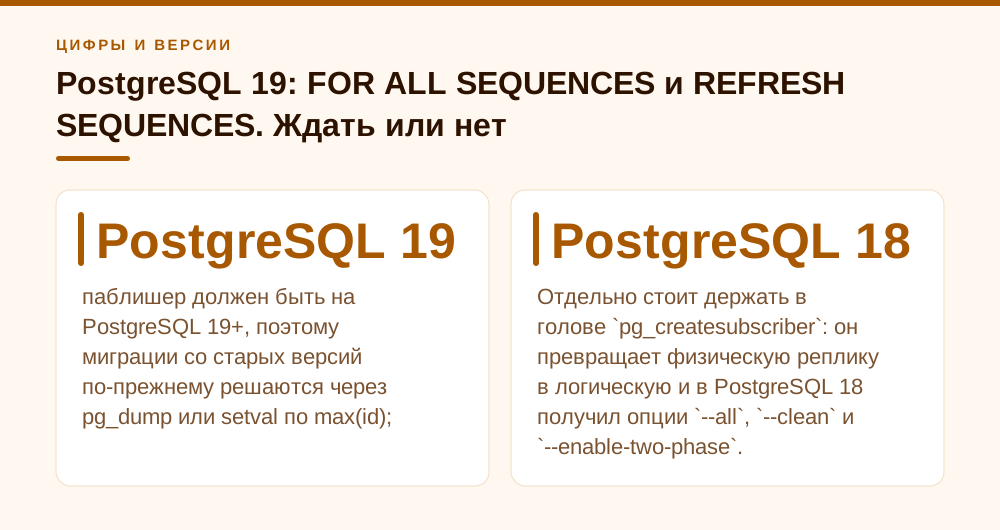
Мой практический вывод: скрипт переноса последовательностей нужно написать один раз и положить в репозиторий рядом с остальной обвязкой миграции. Он не устареет с выходом девятнадцатой версии — он просто станет одной строчкой вместо пятнадцати, когда оба сервера доедут до PG19. Отдельно стоит держать в голове pg_createsubscriber: он превращает физическую реплику в логическую и в PostgreSQL 18 получил опции --all, --clean и --enable-two-phase. Про последовательности его документация не говорит ничего — и это логично, потому что физическая реплика на момент промоута содержит побайтово те же файлы последовательностей, что и мастер. Но именно поэтому там легко расслабиться и забыть про проверку: если между промоутом и переключением записи паблишер продолжал работать, счётчики снова разъедутся. Контрольный запрос из пятого раздела прогоняйте в любом сценарии, он бесплатный.
- `CREATE PUBLICATION ... FOR ALL SEQUENCES` и `ALTER SUBSCRIPTION ... REFRESH SEQUENCES` — это PostgreSQL 19, в 18-й версии их нет;
- публикуются только все постоянные последовательности базы разом; temporary и unlogged не входят, права — суперпользователь;
- синхронизация по запросу, а не потоковая: команду вызывают в окне переключения после остановки записи;
- паблишер должен быть на PostgreSQL 19+, поэтому миграции со старых версий по-прежнему решаются через pg_dump или setval по max(id);
- после REFRESH SEQUENCES контрольный запрос на отставшие счётчики всё равно прогоняется.
А если переезжает база 1С: pg_upgrade или логическая репликация
У «Оттиска» кроме портала есть бухгалтерия на 1С, и вопрос «а базу 1С тоже так переносить?» задают почти всегда. Для базы 1С на PostgreSQL я в первую очередь смотрю на pg_upgrade: он переносит кластер на новую мажорную версию целиком, на уровне файлов, и последовательности в этом сценарии вообще не проблема — они переезжают вместе со всем остальным. С ключом --link апгрейд занимает минуты даже на базе в сотни гигабайт, но цена — старый кластер после запуска нового использовать уже нельзя, так что свежая резервная копия перед этим обязательна. Второе условие: на новом сервере должна стоять сборка PostgreSQL, поддерживаемая вашей версией платформы 1С, со всеми расширениями, которые использует база, — pg_upgrade --check покажет несовпадения до того, как вы что-то сломаете.
# сухой прогон — ничего не меняет, только проверяет совместимость кластеров
/usr/lib/postgresql/18/bin/pg_upgrade \
  -b /usr/lib/postgresql/15/bin -B /usr/lib/postgresql/18/bin \
  -d /var/lib/postgresql/15/main -D /var/lib/postgresql/18/main \
  --link --check
Логическая репликация для 1С — инструмент для случая, когда нужен перенос на другой сервер с минимальным окном и pg_upgrade «на месте» не подходит. Здесь другие подводные камни. Ссылки между объектами 1С хранятся не в serial-колонках, поэтому сама история с duplicate key для базы 1С обычно менее острая — но проверять pg_sequences на подписчике всё равно нужно, а не верить на слово. Острее другое: публикация, реплицирующая UPDATE и DELETE, требует replica identity у каждой таблицы — первичного ключа или явно назначенного уникального индекса. Если его нет, ошибку получит уже паблишер, то есть работающая 1С. Поэтому перед созданием публикации я прогоняю запрос на таблицы без первичного ключа:
SELECT n.nspname, c.relname
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE c.relkind IN ('r','p')
  AND n.nspname NOT IN ('pg_catalog','information_schema')
  AND NOT EXISTS (SELECT 1 FROM pg_constraint k
                  WHERE k.conrelid = c.oid AND k.contype = 'p')
ORDER BY 1, 2;
Для найденных таблиц есть два пути: ALTER TABLE ... REPLICA IDENTITY USING INDEX на подходящий уникальный индекс с NOT NULL-колонками или REPLICA IDENTITY FULL, который пишет в WAL строку целиком и заметно тяжелее на больших регистрах. Если таких таблиц в базе 1С сотни, я обычно возвращаюсь к pg_upgrade или к выгрузке-загрузке средствами платформы в согласованное окно.
Для 18 рабочих мест вроде «Оттиска», где база 1С занимает десятки гигабайт, окно в пару часов ночью почти всегда находится, и тогда pg_upgrade с репетицией на копии проще и безопаснее, чем неделя логической репликации. Логическую репликацию я оставляю для веб-приложений и порталов, где простой в полчаса уже стоит денег, и именно там история с последовательностями стреляет чаще всего.
- pg_upgrade переносит кластер целиком — последовательности, identity-колонки и права едут автоматически;
- `pg_upgrade --check` запускается до апгрейда и ничего не меняет — прогоняйте его на копии;
- `--link` быстрый, но после старта нового кластера старый использовать нельзя — резервная копия обязательна;
- логическая репликация для 1С требует replica identity у всех таблиц с UPDATE/DELETE, иначе ошибка на работающем паблишере;
- сборка PostgreSQL и расширения на новом сервере должны быть совместимы с вашей версией платформы 1С.
Частые вопросы
Можно ли добавить последовательность в публикацию, чтобы она реплицировалась?
В PostgreSQL 18 — нет: в публикацию добавляются только таблицы, включая партиционированные, а объекта «последовательность» в публикации нет. В PostgreSQL 19 (на сентябрь 2026 года — beta) появилось предложение CREATE PUBLICATION ... FOR ALL SEQUENCES: оно публикует сразу все постоянные последовательности базы, требует прав суперпользователя, а значения на подписчике синхронизируются при создании подписки, через REFRESH PUBLICATION и командой ALTER SUBSCRIPTION ... REFRESH SEQUENCES. Непрерывной репликации счётчиков нет и там, а паблишер должен быть на 19-й версии.
Насколько высокий запас ставить при пересчёте последовательностей по данным таблиц?
Я беру max(id) + 1000 для обычных справочников и документов. Этот запас закрывает и значения, потерянные из кэша последовательности (cache_size больше единицы), и пару записей, которые могли просочиться на паблишер уже после сверки. Дырки в нумерации — нормальное поведение последовательностей, задача счётчика в уникальности, а не в плотности. Если по вашей нумерации есть требования регулятора или бухгалтерии, переносите значения с паблишера через pg_dump, а не считайте по максимуму.
Мы используем GENERATED ALWAYS AS IDENTITY вместо serial. Проблема нас касается?
Касается ровно так же. Под identity-колонкой лежит обычная последовательность, которую сервер создал внутри себя, и она точно так же не реплицируется. Найти её можно функцией pg_get_serial_sequence(), которая для identity-колонок возвращает эту внутреннюю последовательность. Все скрипты из статьи с identity работают без изменений.
Что делать, если старый сервер уже удалён, а последовательности не перенесли?
Пересчитывать по данным. Берёте по каждой таблице максимум значения соответствующей колонки, ставите setval выше него с запасом. Перед этим обязательно остановите запись в приложении, иначе будете гоняться за движущейся целью. Отдельно проверьте последовательности, не привязанные к колонкам — генераторы номеров документов и кодов; их надо восстанавливать по максимуму значений в тех полях, куда они пишут, и это придётся делать вручную по знанию предметной области.
Помогает ли pg_createsubscriber избежать проблемы с последовательностями?
Частично и не гарантированно. pg_createsubscriber превращает физическую реплику в логическую, а физическая реплика на момент промоута содержит те же файлы последовательностей, что и мастер, — то есть на этот момент счётчики актуальны. Но если между промоутом и переключением записи паблишер продолжал принимать запись, последовательности снова разъедутся, и в документации инструмента про них ничего не сказано. Контрольную проверку прогоняйте в любом случае.
Как заранее убедиться, что подписчик готов принимать запись?
Три проверки, все в окне переключения после остановки записи: нулевое отставание логического слота на паблишере (pg_wal_lsn_diff между pg_current_wal_lsn() и confirmed_flush_lsn), сверка count(*) по таблицам и — обязательно — сверка last_value из pg_sequences с максимумами в таблицах. Первые две без третьей ничего не значат: именно на этом ловятся почти все неудачные переключения, которые я разбирал.
Переносим базу 1С на новую версию PostgreSQL. Что выбрать — pg_upgrade или логическую репликацию?
Если окно в пару часов находится, я выбираю pg_upgrade с предварительным pg_upgrade --check и репетицией на копии: кластер переезжает целиком, последовательности и identity-колонки не нужно синхронизировать отдельно. Логическую репликацию имеет смысл рассматривать при переносе на другой сервер с минимальным простоем, но сначала проверьте, что у всех таблиц есть первичный ключ или назначенная replica identity, и что сборка PostgreSQL на новом сервере поддерживается вашей платформой 1С.
Нужно ли переносить последовательности после pg_upgrade?
Нет. pg_upgrade переносит системный каталог и файлы данных кластера, последовательности входят в них так же, как таблицы. Проблема с отставшими счётчиками — особенность именно логической репликации и частичных переносов вроде выгрузки отдельных таблиц через COPY. После любого апгрейда я всё равно прогоняю контрольный запрос по pg_sequences — он занимает секунды.
Источники
- PostgreSQL 18 Documentation — Chapter 29.7. Restrictions (Logical Replication) — «Sequence data is not replicated… the sequences would need to be updated to the latest values, either by copying the current data from the publisher (perhaps using pg_dump) or by determining a sufficiently high value from the tables themselves». https://www.postgresql.org/docs/18/logical-replication-restrictions.html
- PostgreSQL devel (19) Documentation — Restrictions — «Incremental sequence changes are not replicated… ALTER SUBSCRIPTION ... REFRESH SEQUENCES only re-synchronizes sequences that are already known to the subscription; it requires the publisher to be running PostgreSQL 19 or later». https://www.postgresql.org/docs/devel/logical-replication-restrictions.html
- PostgreSQL devel (19) Documentation — Replicating Sequences и CREATE PUBLICATION — FOR ALL SEQUENCES (только суперпользователь, только постоянные последовательности), синхронизация при CREATE SUBSCRIPTION, REFRESH PUBLICATION и REFRESH SEQUENCES, sequence synchronization worker. https://www.postgresql.org/docs/devel/logical-replication-sequences.html и https://www.postgresql.org/docs/devel/sql-createpublication.html
- PostgreSQL 18 Release Notes — E.1. Release 18 — изменение значения по умолчанию streaming с off на parallel в CREATE SUBSCRIPTION, новый параметр max_active_replication_origins, логирование конфликтов логической репликации, опции pg_createsubscriber --all / --clean / --enable-two-phase. https://www.postgresql.org/docs/18/release-18.html
- PostgreSQL 18 Documentation — pg_dump и ALTER SEQUENCE — pg_dump, опция -a/--data-only: «Table data, large objects, and sequence values are dumped»; ALTER SEQUENCE … RESTART — «RESTART is a transactional command… it blocks concurrent transactions», в отличие от setval(). https://www.postgresql.org/docs/18/app-pgdump.html и https://www.postgresql.org/docs/18/sql-altersequence.html
- PostgreSQL 18 Documentation — pg_sequences и pg_get_serial_sequence — Представление pg_sequences (колонка last_value и условия, при которых она NULL) и функция pg_get_serial_sequence(), работающая в том числе с identity-колонками. https://www.postgresql.org/docs/18/view-pg-sequences.html и https://www.postgresql.org/docs/18/functions-info.html
- Gadget Engineering Blog — Zero downtime Postgres upgrades using logical replication — практический разбор переключения, включая ручную синхронизацию последовательностей в окне cutover. https://gadget.dev/blog/zero-downtime-postgres-upgrades-using-logical-replication
- PostgreSQL 18 Documentation — Publication и pg_upgrade — Требование replica identity для UPDATE/DELETE в публикации (ошибка на паблишере) и режимы pg_upgrade --check / --link. https://www.postgresql.org/docs/18/logical-replication-publication.html и https://www.postgresql.org/docs/18/pgupgrade.html